Kurs
LLMOps Kavramları
1 sa
19.9K
Moonshot AI, Kimi model serisinin en yeni amiral gemisi ve bugüne kadar yayınlanan en büyük açık-ağırlıklı modelini (2,8 trilyon parametre) Kimi K3'ü duyurdu. Tam ağırlıklar henüz yayımlanmadı. Moonshot, on gün içinde paylaşılacağını söylüyor.
Ancak hikâye sadece parametre sayısı değil. Moonshot, Alibaba tarafından desteklenen (eğer hatırlarsanız Qwen modellerini de yapıyor, en yenisi Qwen 3.7) Pekin merkezli bir girişim ve DeepSeek ile diğer Çinli laboratuvarlar alanı doldurdukça kendine yer açmak için mücadele ediyor.
Ölçek açısından K3, DeepSeek'in V4'ünden kabaca %75 daha büyük. Moonshot'ın kendi kıyaslarında, Claude Opus 4.8 ve GPT-5.5'i geçerken, Claude Fable 5 ve GPT-5.6 Sol'un gerisinde kalıyor.
Asıl sinyal ise fiyatlandırma. K3, en üst seviye fiyatlar talep ediyor. ABD laboratuvarları için sorun şu: Bir Çin modeli aynı fiyatı talep edip benzer düzeyde performans gösterirse, ABD modellerini farklı kılan şeyin premium fiyat olduğu fikrini zayıflatır.
Fiyatlandırma ve geçmişe dair biraz bahsettik. Peki Kimi K3 hakkında, nasıl inşa edildiği ve ne kadar iyi çalıştığı konusunda neler biliyoruz?
Kimi K3, Moonshot'ın "sınır zekâ senaryoları" dediği; uzun vadeli kodlama, bilgi işi ve akıl yürütme için özellikle iyi konumlanmış.
Bu amaçla, 1 milyon tokenlık bir bağlam penceresini ve yerel görsel anlama yeteneğini destekliyor. İkincisi, görüntü ve videoları doğrudan girdi olarak alabileceği anlamına geliyor.
En çok konuşulanlar yüzeyde: bahsettiğim 1 milyon tokenlık bağlam penceresi ve yerel görsel anlama.
Buna ulaşmak için Moonshot, arka planda üç alanda değişiklikler yaptı:
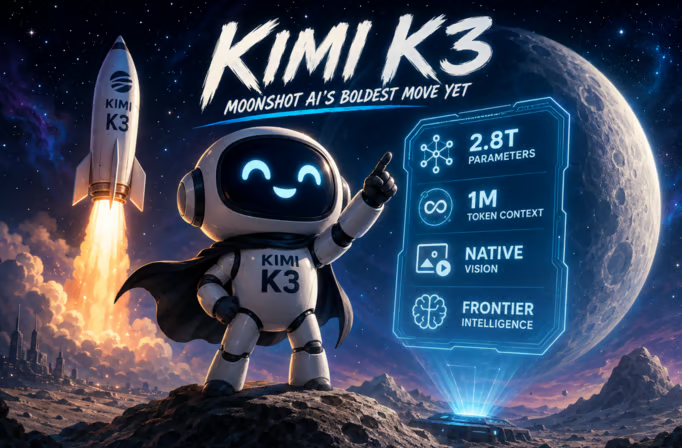
Model iki yeni bileşen etrafında inşa edildi: hibrit bir lineer-dikkat mekanizması olan Kimi Delta Attention (KDA) ve Attention Residuals (AttnRes) adı verilen bir yapı. Her ikisi de bilgilerin uzun diziler ve derin ağlar boyunca daha güvenilir şekilde yayılmasına yardımcı olmayı hedefliyor.
Buna ek olarak Moonshot, Uzman Karışımı (Mixture-of-Experts) düzeninin seyrekliğini, ileri geçiş başına az sayıda uzmanı etkinleştiren "Stabil LatentMoE" çerçevesiyle daha da artırdı. Eğitim ve veri değişiklikleriyle birlikte, Moonshot bunun K3'e selefi K2'ye göre yaklaşık 2,5 kat ölçekleme verimliliği sağladığını iddia ediyor.
Moonshot, K3'ü uzun vadeli mühendislik çalışmaları için güçlü olarak konumlandırıyor: asgari denetimle çok adımlı görevleri sürdürme, büyük kod tabanlarında gezinme ve terminal araçlarını koordine etme.
Ayrıca belirli bir nişi vurguluyor — oyun geliştirme, frontend işi veya CAD görevlerinde ekran görüntüleri ve görsel geri bildirim kullanarak yineleme gibi, kodlamayı görsel akıl yürütme ile birleştirmek. Paper Mario esinli bir oyun, bir uçak teslimat oyunu ve Halo'ya benzeyen bir şey gibi pek çok Kimi K3 oyun geliştirme örneği var.
Moonshot, dahili değerlendirmelerinin (kamusal kıyaslar yerine gerçek ajan-işbirliği iş akışlarından oluşturulmuş) Kimi K3'ün "max" varyantı için üretim tarzı bilgi işi görevlerinde tutarlı kazanımlar gösterdiğini söylüyor.
Bu, modeli gerçekten kullanan herkes için şuna karşılık geliyor: daha uzun belgeler, kod tabanları veya videolar, parçalara bölünüp yeniden birleştirilmek yerine tek bir girdi olarak verilebiliyor ve aynı istekte ek bir tesisata gerek kalmadan metin, görseller ve video birlikte kullanılabiliyor.
Verimlilik kazanımları yerini bulursa, K2'ye kıyasla hesaplama başına daha fazla yetenek anlamına gelmeli.
API dokümantasyonu, modelle gerçekten bir şeyler inşa edenler için nelerin değiştiğine dair daha net bir tablo sunuyor:
Her zaman açık düşünme: K3 varsayılan olarak düşünme modunda çalışır; bu, K2 serisindeki eski thinking bayrağı yerine üst düzey reasoning_effort parametresiyle yapılandırılır. Şimdilik yalnızca max çaba düzeyi destekleniyor.
Ayrıştırılmış akıl yürütme ile akış: Akış yanıtları, modelin düşünmesini göstermek ya da gizlemek için reasoning_content ve nihai yanıt content'i ayrı delta alanları olarak sunar.
Görsel girdi, herkese açık URL yok: Görüntüler base64 olarak veya yüklenmiş bir dosya referansı üzerinden gönderilmelidir; model düz görüntü URL'lerini kabul etmez ve video ayrı bir dosya yüklemesiyle işlenir.
Yapılandırılmış çıktı: JSON Şeması çıktısı strict moduyla desteklenir, ancak bu yalnızca nihai content alanını sınırlar, akıl yürütme izini değil.
Kısmi mod: Asistanın yanıtına sabit bir önekle başlangıç verebilir ve modelin buradan devam etmesini sağlayabilirsiniz. Belirli bir açılışı zorlamak istediğinizde faydalıdır.
Dinamik araç yükleme: Araç tanımları, bir system mesajı aracılığıyla konuşmanın ortasına enjekte edilebilir ve o andan itibaren geçerli olur.
Otomatik bağlam önbellekleme: Önbellekleme otomatiktir ve ekstra parametre gerektirmez.
API'yi entegre edenler için işaretlemeye değer birkaç başka sınır: max_completion_tokens varsayılanı 131.072'dir ve 1.048.576'ya kadar çıkar; temperature ve top_p gibi örnekleme parametreleri yapılandırılabilir değil, sabittir.
Kimi, tarayıcı otomasyonu görevlerinde de çok başarılıdır. Daha fazlası için Kimi tarayıcı uzantısı eğitimimizi okuyun.
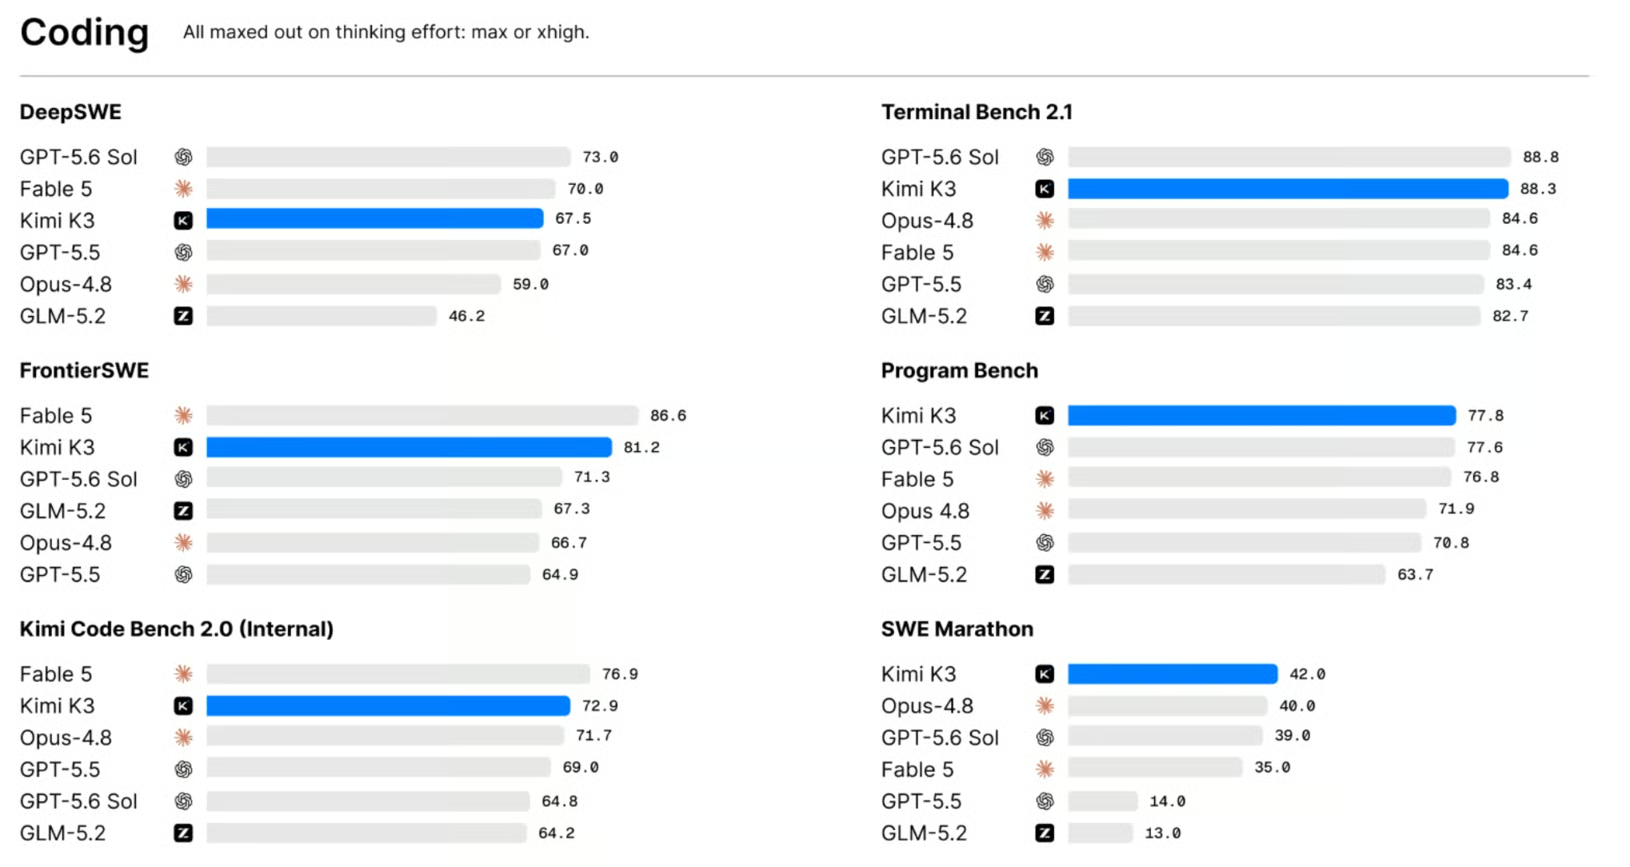
Moonshot'ın lansman materyallerinde artık gerçek kıyas değerleri yer alıyor, ancak farklı modellerin farklı ajan iskeletleriyle test edildiğini akılda tutmak gerekiyor. K3, Moonshot'ın kendi KimiCode'u ile test edildi; Claude modelleri Claude Code veya Terminus 2 ile; GPT modelleri ise Codex ile. Yani bu temiz bir karşılaştırma değil. Her laboratuvarın modeli, kendi en iyi araçlarında test ediliyor.
Üç kategoriye yayılan genel tablo şöyle.
Aşağıdaki grafikte görüldüğü gibi, K3 kodlama kıyaslarında silip süpürmüyor ancak neredeyse her yerde rekabetçi. Program Bench ve SWE Marathon'da açık ara önde, Terminal-Bench 2.1'de GPT-5.6 Sol'un yarım puan gerisinde kalıyor ve bireysel testlerin çoğunda Opus 4.8'i geçiyor. Açıkça kaybettiği yerler ise Fable 5 ve GPT-5.6 Sol'un öne çıktığı DeepSWE ve FrontierSWE.
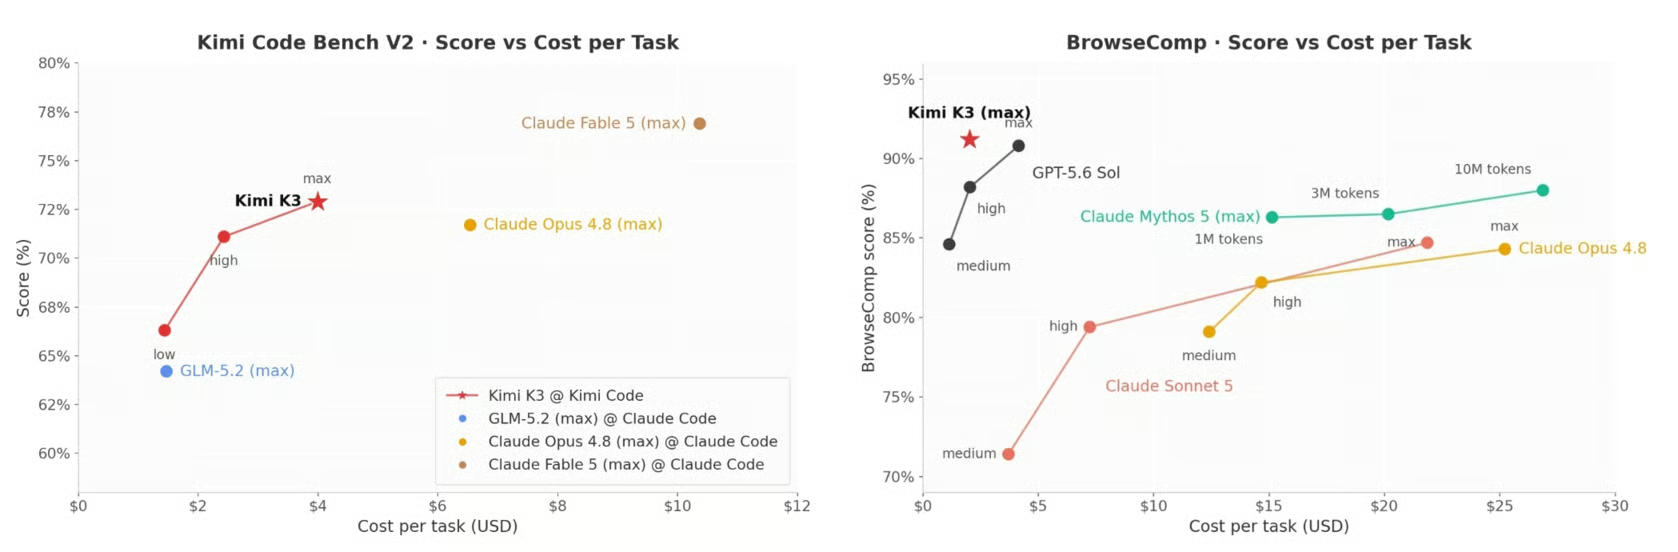
Moonshot'ın kendi Kimi Code Bench V2 grafiğinde, K3 görev başına maliyette kabaca yarısına denk gelirken Opus 4.8'e benzer bir puan alıyor ve birkaç puanlık fazlalık için Fable 5'in yanına bile yaklaşmıyor. BrowseComp grafiği benzer bir hikâye anlatıyor: K3, görev başına maliyeti çok daha düşükken GPT-5.6 Sol ve Claude Fable 5'ten daha yüksek puan alıyor.
Model parametre grafiği ilginç bir bakış sunuyor. Bu yazının başındaki "en büyük açık-ağırlıklı model" iddiasının en net görseli; Moonshot'ın, Kimi K2'nin 1T parametresinden tek bir sürümde DeepSeek, Xiaomi ve diğerlerinin ötesine geçerek 2,8T'ye sıçradığını gösteriyor.
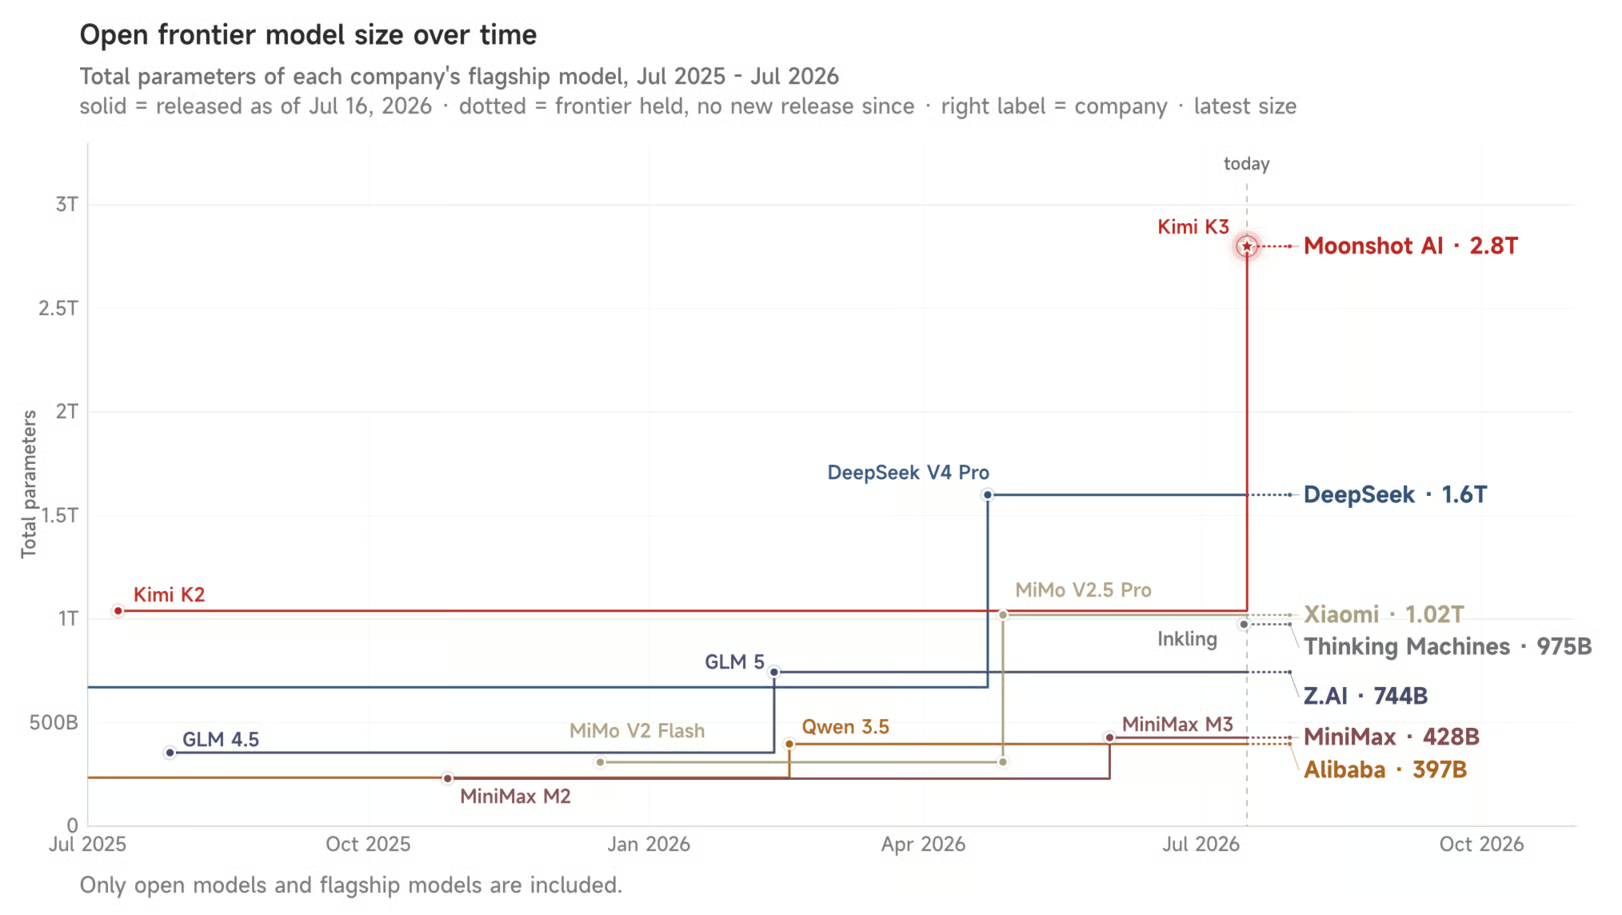
Kimi K3, şu anda model sunan diğer Çinli laboratuvarlarla nasıl kıyaslanıyor? Üst düzeyde bakıldığında, Çin'deki açık-ağırlık alanının ikiye ayrıldığı görülüyor: DeepSeek ve Z.AI gibi laboratuvarlar hâlâ ucuzlukla rekabet ediyor, Moonshot ise daha yüksek fiyat talep etmeye başlıyor.
DeepSeek V4, K3'ten daha küçük ve fiyatı çok daha düşük.
K3 farklı bir iddia ortaya koyuyor: daha büyük ve Moonshot, fiyatta yarışmak yerine buna uygun ücret talep ediyor.
Bu karşılaştırma ilginç çünkü Alibaba hem Moonshot'ı hem de elbette kendi Qwen serisini destekliyor.
Yine de farklılar: Qwen'in amiral gemisi Qwen 3.7 Max hiç açık-ağırlıklı değil. Kapalı, tescilli ve yalnızca Alibaba'nın kendi ürünleri veya üçüncü taraf API sağlayıcıları üzerinden kullanılabiliyor. Alibaba daha küçük açık-ağırlıklı Qwen modellerini yayımlamaya devam ediyor, ancak en üst düzey modeli kapalı kapılar ardına geçmiş durumda.
GLM-5.2, eski Çin açık kaynak oyun planına daha yakın: gerçekten güçlü bir model, MIT lisanslı ve Batılı en üst seviye fiyatların çok altında fiyatlandırılmış. K3'ten daha küçük ve çok daha ucuz; maliyetin küçük bir kısmına yakın-en-üst seviye kodlama performansı şöhreti kazandı.
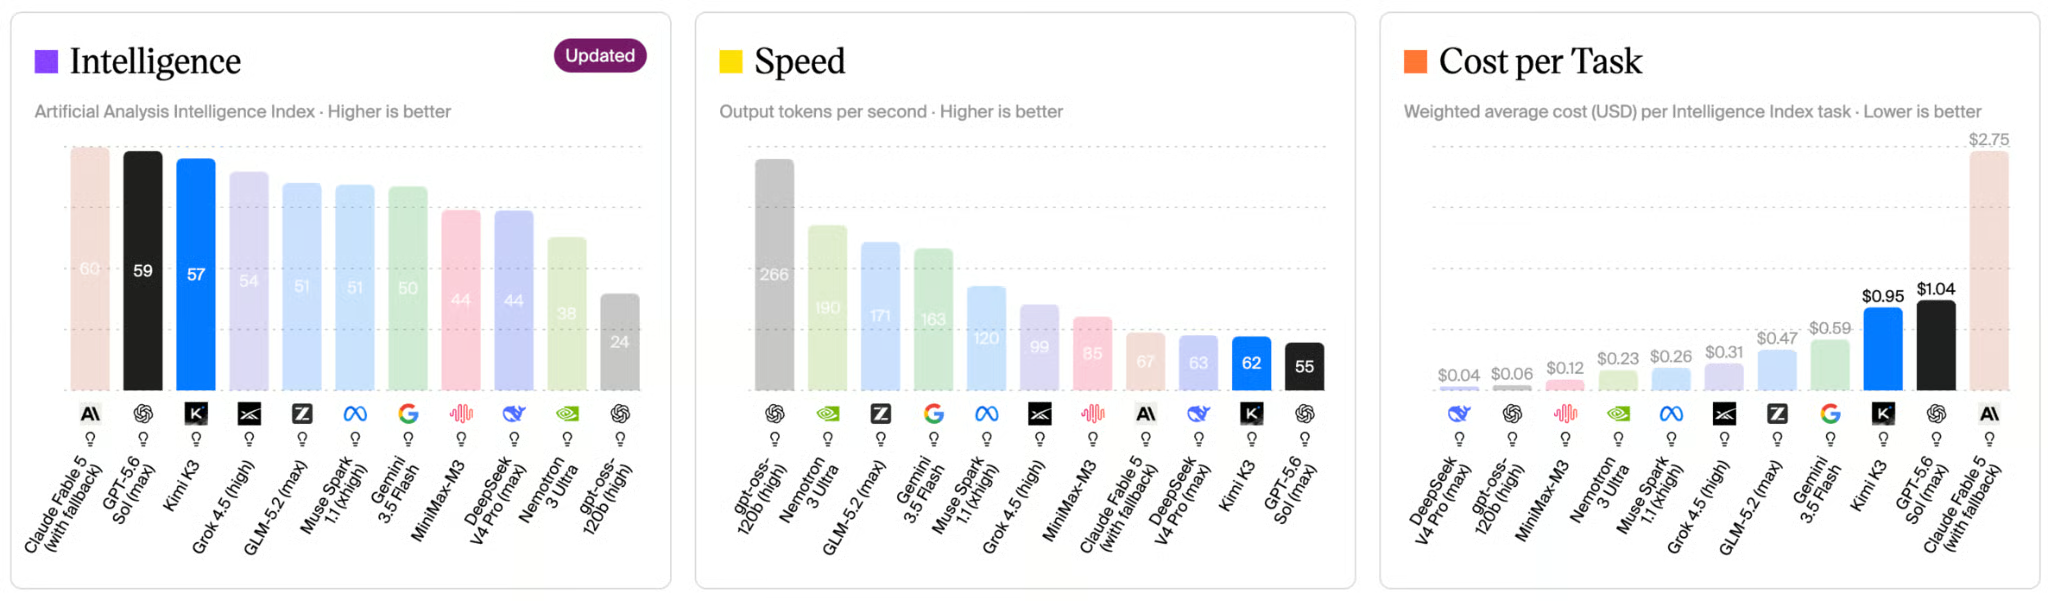
Rakamlar şöyle sıralanıyor; kıstas olarak Artificial Analysis'in Intelligence Index'ini (dokuz kıyastan derlenen ve modeller arasında aynı şekilde çalıştırılan bileşik bir puan) kullandık:
| Model | Parametreler | Yayın Tarihi | Intelligence Index | Terminal-Bench 2.1 | Fiyat ($/M in / out) | Açık-ağırlık mı? |
|---|---|---|---|---|---|---|
| DeepSeek V4 Pro | 1,6T (49B aktif) | 1 Nis 2026 | 44 | Bağımsız olarak listelenmedi | $0,44 / $0,87 | Evet |
| Qwen 3.7 Max (Alibaba) | Açıklanmadı | 20 May 2026 | 56,6 | Doğrudan karşılaştırılabilir değil | $2,50 / $7,50 | Hayır — yalnızca API |
| GLM-5.2 (Z.AI) | 744B (40B aktif) | 13 Haz 2026 | 51 | 78 | $1,40 / $4,40 | Evet |
| Kimi K3 | 2,8T (896 uzmandan 16'sı aktif) | 16 Tem 2026 | 57 | 88,3 | $3,00 / $15,00 | Evet |
İşaretlemeye değer birkaç nokta: Qwen 3.7 Max referans olarak dahil edildi, ancak söylediğim gibi aslında açık-ağırlıklı değil; bu yüzden gerçek bir denk değil, fakat tabloya referans olarak eklemek doğru hissettirdi. Ayrıca bağımsız, üçüncü taraf doğrulama genelde henüz yetişme aşamasında, dolayısıyla hiçbir şey kesin değil.
Sırada, Kimi K3'ün Anthropic ve OpenAI'nin kapalı, tescilli modellerine karşı nasıl durduğunu sormak var.
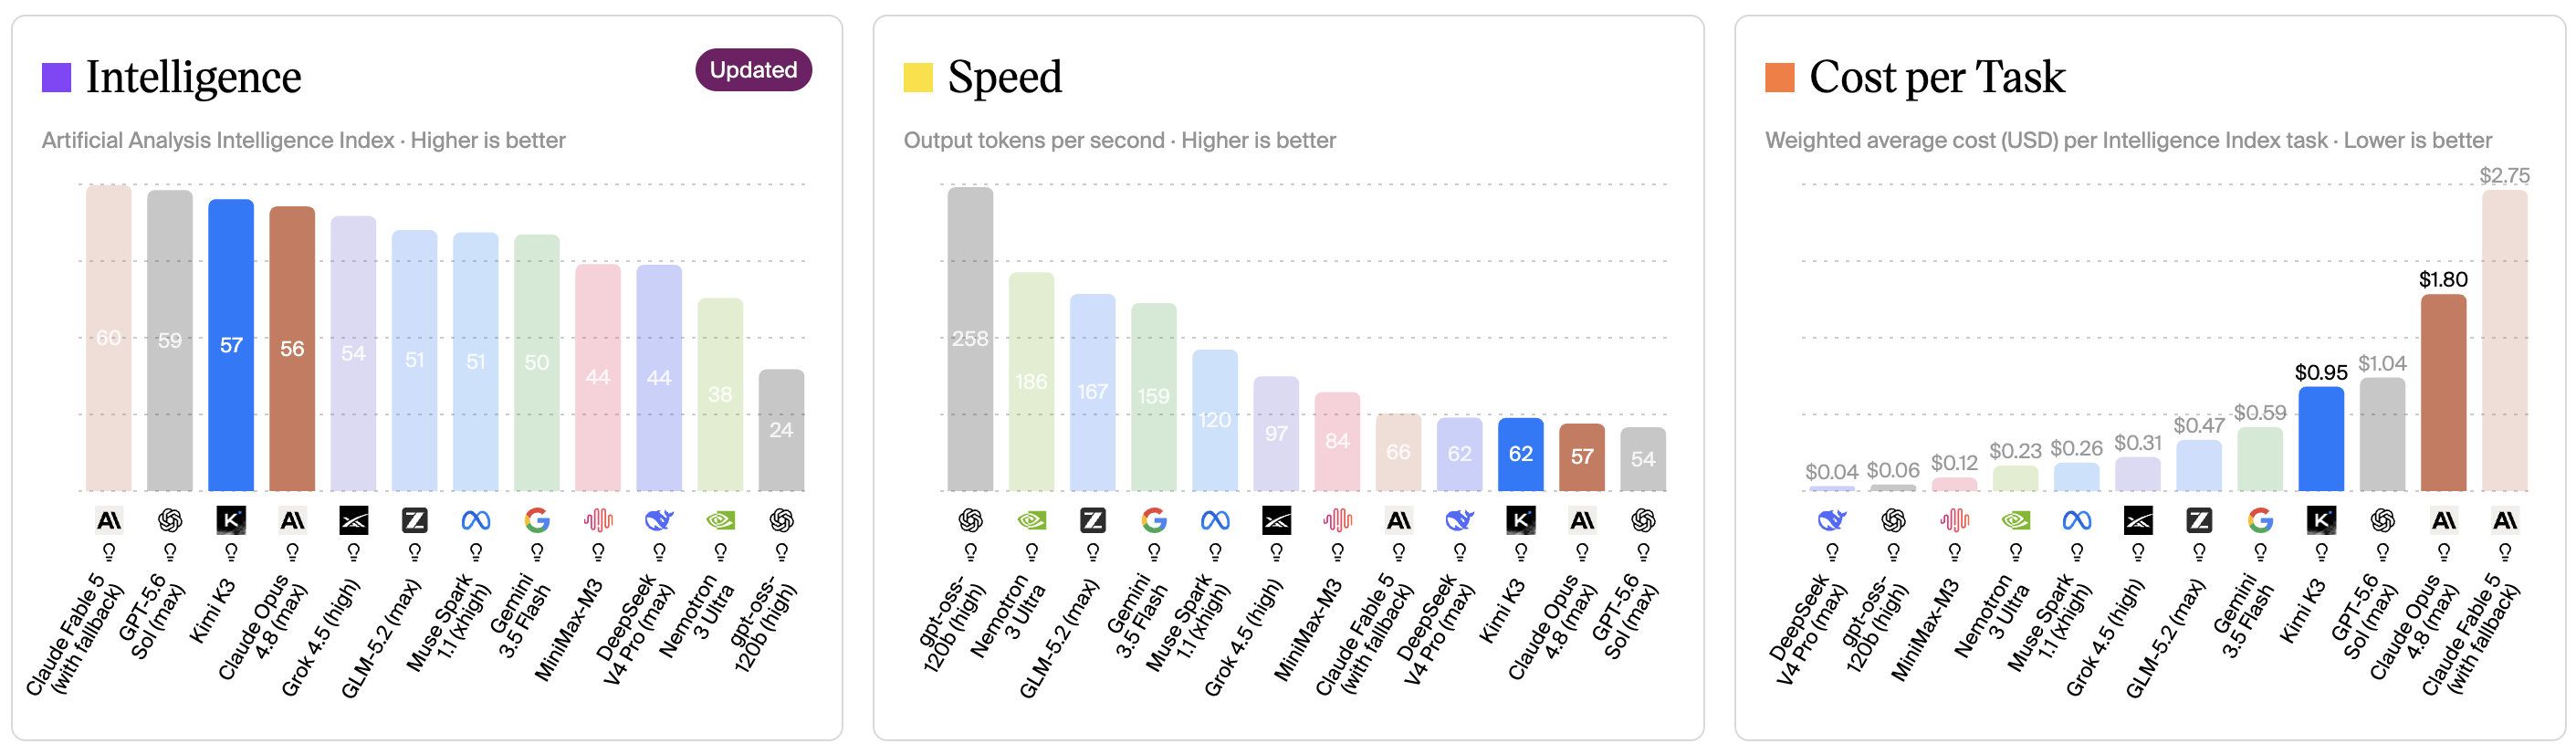
Opus 4.8 aylarca Anthropic'in amiral gemisiydi ve Moonshot'ın kendi sayılarında K3, özellikle kodlamada, bireysel kıyasların birçoğunda onu az farkla geçiyor. K3, Terminal-Bench 2.1'de 88,3 alırken Opus 4.8, 84,6 alıyor.
Ancak daha büyük fark şu: Opus 4.8 kapalı. K3 ise açık-ağırlıklı; bu yüzden ağırlıklar gerçekten yayımlandığında herkes onu kendi sunucusunda barındırabilir, ince ayar yapabilir veya Moonshot'ın sunucularına bağımlı olmadan çalıştırabilir.
Aşağıdaki grafiklerde görüldüğü gibi, K3 Intelligence Index'te Opus 4.8'i bir puanla geçiyor, ancak fark diğer her yerde açılıyor: K3, görev başına yaklaşık yarı fiyatına mal oluyor ve ilk tokena kabaca 20 kat daha hızlı yanıt veriyor.
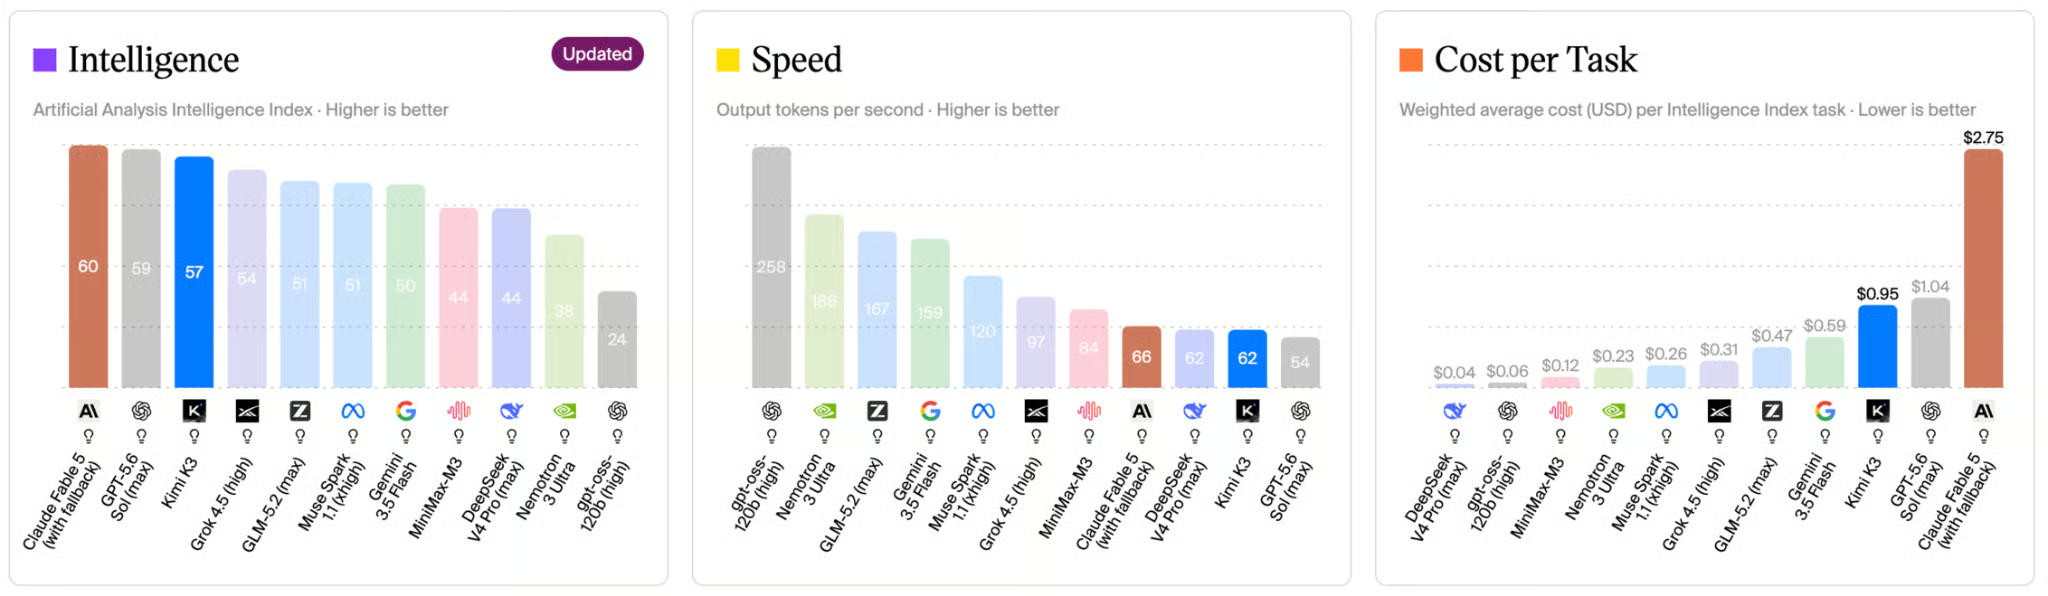
Fable 5, Anthropic'in en yeni ve en yetenekli modeli ve K3'ün yakalayamadığı model. Genel zekâda net bir şekilde önde ve çalıştırma maliyeti de belirgin biçimde daha yüksek. Fable 5, milyon token başına $10/$50 fiyatlandırılırken K3 $3/$15. Ancak K3'ün söylemi burada "Fable 5 kadar iyi" değil. "Fiyatın küçük bir kısmına, yolun büyük bölümünde".
Aşağıdaki grafiklerde görüldüğü gibi Fable 5, Intelligence Index'te rahatça önde ve ham çıktı hızında da K3'ten az biraz daha hızlı. K3'ün öne geçtiği yer maliyet. Görev başına yaklaşık Fable 5'in üçte biri fiyata çalışıyor.
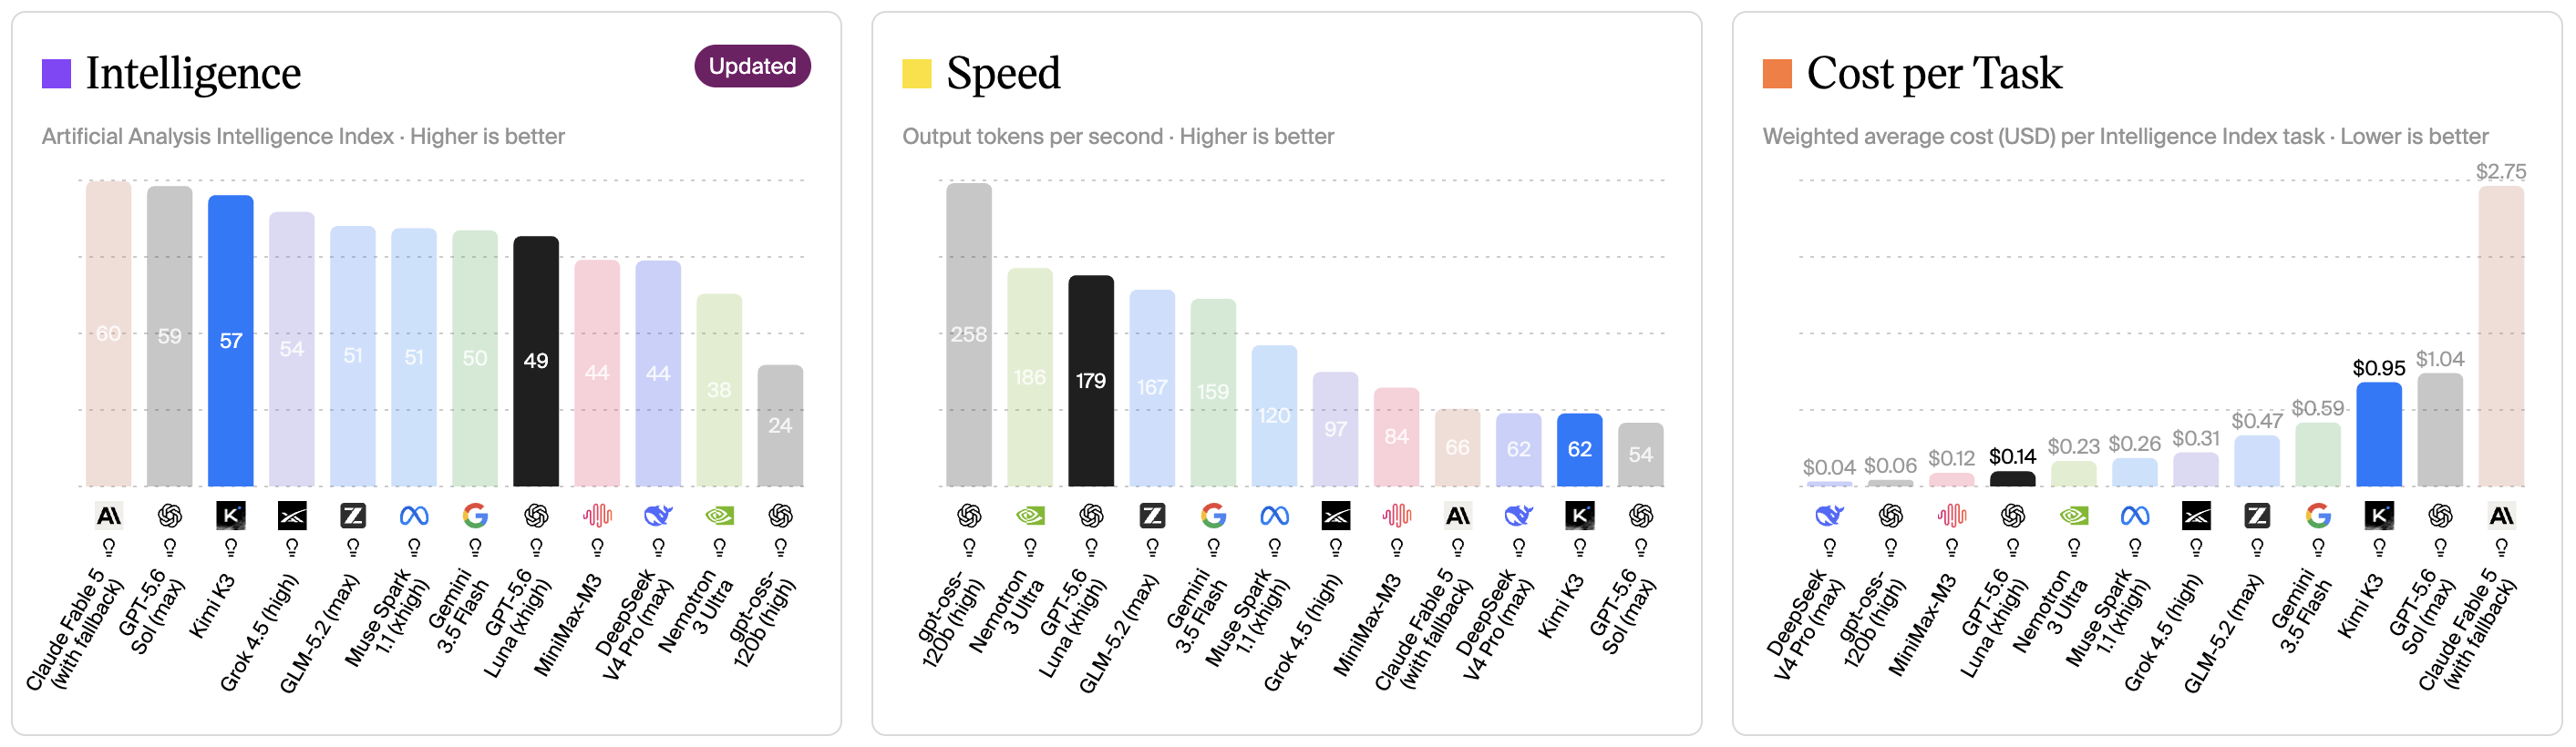
GPT-5.5, Moonshot'ın kendi kıyaslarında K3'ün biraz altında kalıyor ve diğer ABD amiral gemileriyle benzer bir aralıkta fiyatlandırılıyor; K3'ün oldukça üzerinde.
Aşağıdaki grafiklerde görüldüğü gibi K3, Intelligence Index'te GPT-5.5'i az farkla geçiyor ve görev başına biraz daha ucuza mal oluyor. GPT-5.5, çalışmaya başladıktan sonra tokenları biraz daha hızlı üretiyor; dolayısıyla hangisinin sizin için daha önemli olduğuna bağlı olarak ikisi arasında bir denge var.
GPT-5.6 Sol, bu karşılaştırmadaki OpenAI'nin en yeni ve en pahalı modeli ve Terminal-Bench 2.1'de K3 ile esasen başa baş. Sol 88,8 alırken K3 88,3 puan alıyor.
Daha büyük fark, Opus 4.8 ile aynı: Sol kapalı-ağırlık; yalnızca OpenAI'nin kendi ürünleri (ChatGPT, Codex, API) üzerinden kullanabilirsiniz; K3 ise açık-ağırlık. Ağırlıklar yayımlandıktan sonra herkes kendi kendine barındırabilir veya ince ayar yapabilir.
Aşağıdaki grafiklerde görüldüğü gibi Sol, Intelligence Index'te K3'ü az farkla geçiyor, ancak K3 hız ve maliyetin her ikisinde de öne çıkıyor.
Kimi K3 şu anda yayında, sadece tam olarak değil. Modelin kendisi dün piyasaya sürüldü ve bugün kimi.com, Kimi mobil uygulamaları, Kimi Work, Kimi Code ve model kimliği kimi-k3 olan Kimi API aracılığıyla zaten kullanılabiliyor. OpenRouter ve OrcaRouter gibi üçüncü taraf yönlendiricilerde de görünmeye başladı.
Henüz çıkmayan şey ise açık ağırlıkların kendisi. Moonshot, bunların 27 Temmuz 2026'ya kadar yayımlanacağını söylerken, şirket teknik ayrıntıları hizalamak için çıkarım ortakları ve açık kaynak bakımcılarıyla çalışmayı sürdürüyor. O zamana kadar K3'ü Moonshot'ın barındırılan hizmetleri üzerinden kullanabilirsiniz, ancak indirip kendi sunucunuzda barındıramazsınız.
Bunun gibi model sürümlerini takip etmek için haftalık yapay zekâ bültenimiz The Median'a kaydolmanızı öneririz.
Fiyatlandırmada K3, 1M tokenlık pencereye rağmen bağlam uzunluğuna göre kademelendirme yerine düz kullan-öde faturalama kullanıyor. Moonshot'ın resmi tarifeleri, önbellek isabetli giriş için milyon token başına $0,30; önbellek kaçırmalı giriş için milyon token başına $3,00 ve çıktı için milyon token başına $15,00 — tipik kodlama iş yüklerinde %90'ın üzerinde bildirilen bir önbellek isabet oranıyla, pratikte etkin giriş maliyetini düşürüyor.
Moonshot, kendi teknik blogunda sınırlamalar konusunda açık:
Kimi K3, bugüne kadar yayımlanan en büyük açık-ağırlıklı model. Uzun bağlam ve ajan odaklı iş yüklerine doğrudan nişan alan yeni bir dikkat mimarisine sahip. Artık kamuya açık olan kıyaslarda genel olarak mutlak kazanan değil — Fable 5 ve GPT-5.6 Sol onu az farkla geçiyor — ancak kodlama, ajan ve çok kipli görevlerde maliyetin küçük bir kısmına son derece rekabetçi.
Bu makalenin baştan sona ana fikri bu: K3 her kategoriyi kazanmaya çalışmıyor. DeepSeek'in R1 ile ve daha yakın zamanda GLM-5.2'nin yaptığı gibi, fiyat-yetenek değiş tokuşunu görmezden gelmeyi zorlaştırmaya çalışıyor — fark şu ki bu kez Moonshot, bunu indirimli değil, en üst seviye fiyatlarla yapıyor.
DataCamp ile Yapay Zekâ Öğrenin
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme