Kurs
LLMOps-Konzepte
1 Std.
19.9K
Moonshot AI hat Kimi K3 angekündigt, das neueste Flaggschiff seiner Kimi-Modellreihe und das bislang größte veröffentlichte Open-Weight-Modell (2,8 Billionen Parameter). Die vollständigen Gewichte sind noch nicht verfügbar. Moonshot sagt, sie werden in zehn Tagen veröffentlicht.
Die reine Parameterzahl ist aber nicht die ganze Geschichte. Moonshot ist ein in Peking ansässiges Startup, unterstützt von Alibaba (die auch die Qwen-Modelle entwickeln, falls du dich erinnerst, mit Qwen 3.7 als dem neuesten), und kämpft um Aufmerksamkeit, während DeepSeek und andere chinesische Labs das Feld verdichten.
Beim Umfang ist K3 etwa 75% größer als DeepSeeks V4. In Moonshots eigenen Benchmarks schlägt es Claude Opus 4.8 und GPT-5.5, liegt jedoch hinter Claude Fable 5 und GPT-5.6 Sol.
Der eigentliche Fingerzeig ist jedoch der Preis. K3 verlangt Frontier-Tarife. Das ist das Problem für US-Labs: Wenn ein chinesisches Modell denselben Preis verlangen und ähnlich performen kann, unterläuft es die Idee, dass ein Premiumpreis das Differenzierungsmerkmal der US-Modelle ist.
Wir haben schon etwas zu Preis und Hintergrund gesagt. Was wissen wir darüber hinaus über Kimi K3, wie es gebaut ist und wie gut es funktioniert?
Kimi K3 ist besonders gut aufgestellt für das, was Moonshot als "Frontier-Intelligence-Szenarien" bezeichnet: langfristige Coding-Aufgaben, Wissensarbeit und Reasoning.
Dafür unterstützt es ein Kontextfenster von 1 Million Tokens und native visuelle Verarbeitung. Letzteres bedeutet, dass Bilder und Videos direkt als Input akzeptiert werden.
Am meisten diskutiert werden die sichtbaren Upgrades: das Kontextfenster mit 1 Million Tokens und die native visuelle Verarbeitung, die ich bereits erwähnt habe.
Um das zu erreichen, hat Moonshot im Backend an drei Stellen angesetzt:
Das Modell baut auf zwei neuen Komponenten auf: Kimi Delta Attention (KDA), einem hybriden Linear-Attention-Mechanismus, und den sogenannten Attention Residuals (AttnRes). Beide zielen darauf ab, Informationsfluss über lange Sequenzen und tiefe Netze zuverlässiger zu machen.
Darüber hinaus hat Moonshot die Sparsity seines Mixture-of-Experts-Setups mit einem "stabilen LatentMoE"-Framework weiter getrieben, wobei pro Forward-Pass nur ein kleiner Bruchteil der Experts aktiviert wird. Zusammen mit Trainings- und Datenanpassungen reklamiert Moonshot für K3 etwa das 2,5-Fache der Skalierungseffizienz gegenüber seinem Vorgänger K2.
Moonshot positioniert K3 für langfristige Engineering-Arbeit: mehrstufige Aufgaben mit minimaler Aufsicht durchhalten, große Codebasen navigieren und Terminal-Tools koordinieren.
Hervorgehoben wird auch eine spezielle Nische — die Verbindung von Coding und visueller Logik, etwa indem Screenshots und visuelles Feedback genutzt werden, um Game-Development, Frontend-Arbeit oder CAD-Aufgaben iterativ voranzutreiben. Es gibt viele Beispiele für Kimi K3 in der Spieleentwicklung, etwa ein Paper-Mario-inspiriertes Spiel, ein Flugzeug-Liefer-Spiel und etwas, das wie Halo aussieht.
Moonshot sagt, interne Bewertungen (auf Basis realer Agenten-Kollaborations-Workflows statt öffentlicher Benchmarks) zeigen konsistente Zugewinne für die "max"-Variante von Kimi K3 bei produktionsnahen Wissensaufgaben.
Was das für dich in der Praxis bedeutet: Längere Dokumente, Codebasen oder Videos können als einzelner Input hineingegeben werden, statt in Fragmente zerlegt und wieder zusammengesetzt zu werden. Und derselbe Request kann Text, Bilder und Video ohne zusätzlichen Integrationsaufwand mischen.
Wenn sich die Effizienzgewinne bestätigen, bedeutet das außerdem mehr Leistung pro Compute-Dollar als bei K2.
Die API-Dokumentation zeigt klarer, was sich für alle geändert hat, die wirklich mit dem Modell bauen:
Always-on Thinking: K3 läuft standardmäßig im Thinking-Modus, gesteuert über einen Top-Level-Parameter reasoning_effort statt des älteren thinking-Flags aus der K2-Reihe. Aktuell wird nur das Niveau max unterstützt.
Streaming mit getrenntem Reasoning: Streaming-Antworten geben reasoning_content und die finale content-Antwort als separate Deltas aus, sodass du das Denken des Modells ein- oder ausblenden kannst.
Vision-Input, keine öffentlichen URLs: Bilder müssen als Base64 oder über eine hochgeladene Dateireferenz gesendet werden; das Modell akzeptiert keine reinen Bild-URLs, und Video wird über einen separaten Datei-Upload verarbeitet.
Strukturierte Ausgaben: JSON-Schema-Ausgaben werden mit einem strict-Modus unterstützt, der jedoch nur das finale content-Feld einschränkt, nicht die Reasoning-Spur.
Partial Mode: Du kannst die Antwort des Assistenten mit einem festen Präfix anfüttern und das Modell von dort weiterschreiben lassen. Das ist hilfreich, wenn du einen bestimmten Einstieg erzwingen willst.
Dynamisches Tool-Loading: Tool-Definitionen können mitten im Gespräch per system-Nachricht injiziert werden und gelten dann ab diesem Punkt im Verlauf.
Automatisches Kontext-Caching: Caching läuft automatisch und erfordert keine zusätzlichen Parameter.
Ein paar weitere Limits, die du bei der API-Integration beachten solltest: max_completion_tokens ist standardmäßig 131.072 und gedeckelt bei 1.048.576, und Sampling-Parameter wie temperature und top_p sind fest statt konfigurierbar.
Kimi ist außerdem stark bei Browser-Automatisierungsaufgaben. Lies mehr in unserem Kimi-Browser-Extension-Tutorial.
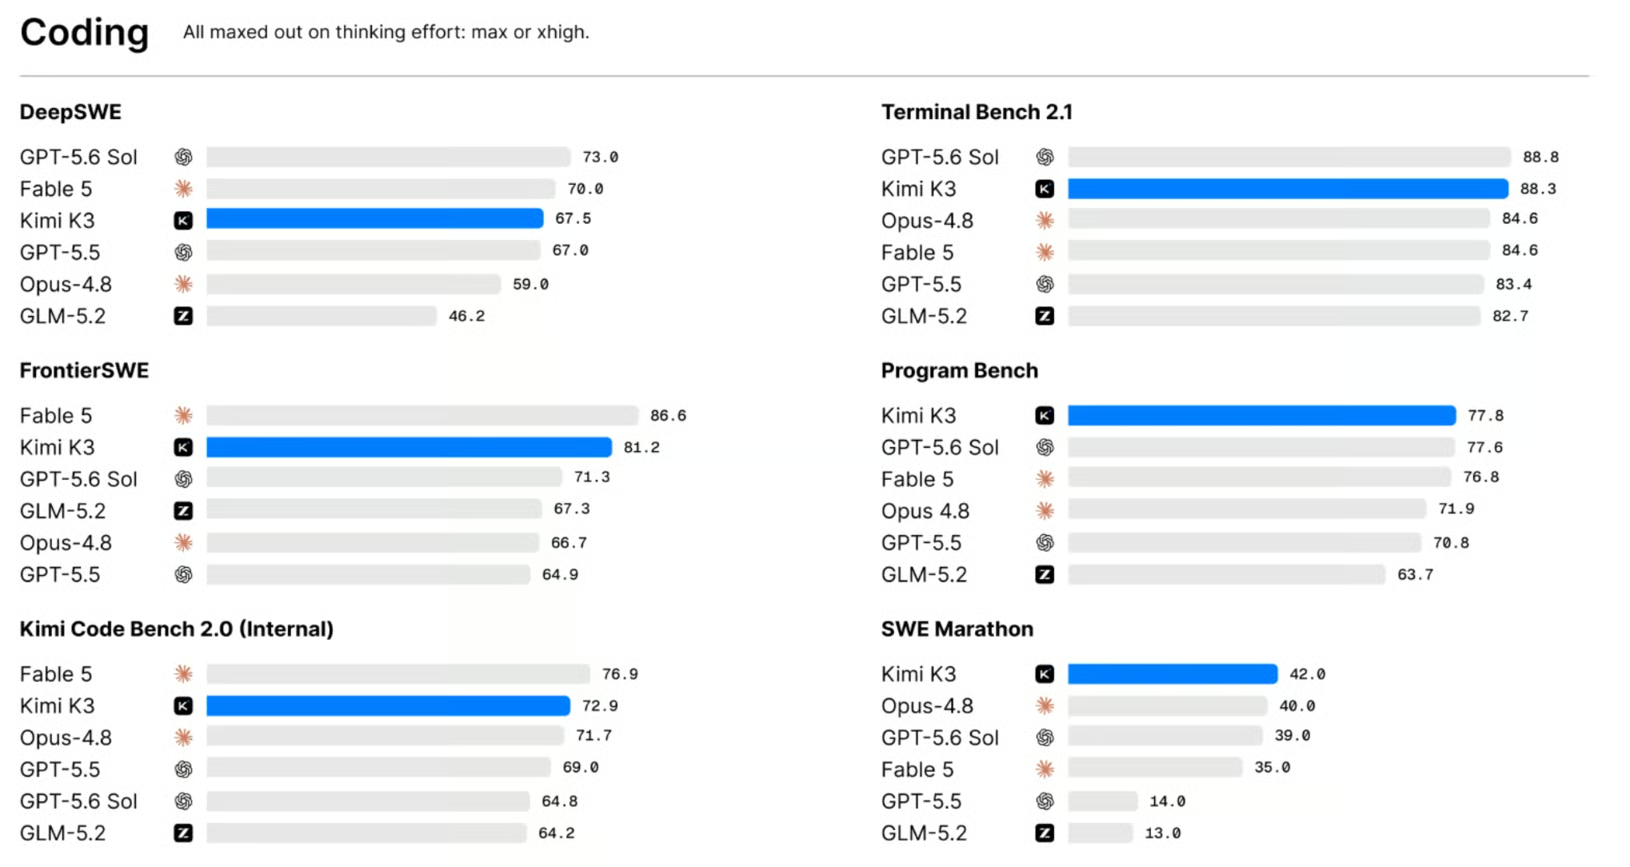
Moonshots Launch-Material enthält inzwischen echte Benchmark-Zahlen, aber man muss berücksichtigen, dass die Modelle in unterschiedlichen Agent-Harnesses gelaufen sind. K3 wurde mit Moonshots eigenem KimiCode getestet; die Claude-Modelle liefen über Claude Code oder Terminus 2; die GPT-Modelle über Codex. Ein sauberer Vergleich ist das also nicht. Jedes Lab testet sein Modell in der jeweils idealen Tooling-Umgebung.
Hier ist das Bild über drei Kategorien hinweg.
Wie im Diagramm unten zu sehen, dominiert K3 die Coding-Benchmarks nicht, ist aber fast überall konkurrenzfähig. Es führt bei Program Bench und SWE Marathon, liegt bei Terminal-Bench 2.1 nur einen halben Punkt hinter GPT-5.6 Sol und schlägt Opus 4.8 in den meisten Einzeltests. Klar verliert es bei DeepSWE und FrontierSWE, wo Fable 5 und GPT-5.6 Sol davonziehen.
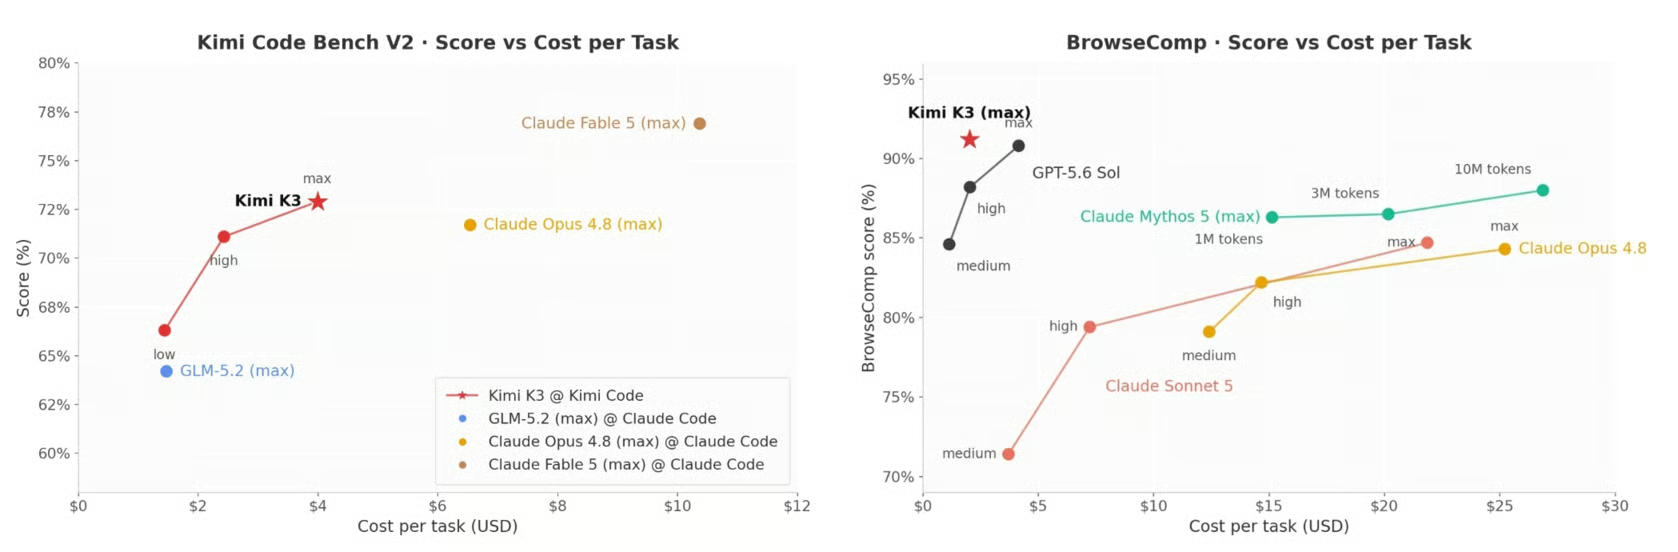
Auf Moonshots eigenem Kimi Code Bench V2 erzielt K3 eine ähnliche Punktzahl wie Opus 4.8 bei etwa halben Kosten pro Aufgabe und weit entfernt von Fable 5, das für ein paar Extra-Punkte deutlich teurer ist. Das BrowseComp-Diagramm erzählt eine ähnliche Geschichte: K3 punktet höher als GPT-5.6 Sol und Claude Fable 5, kostet aber nur einen Bruchteil pro Aufgabe.
Das Parameterdiagramm ist ein interessanter Blick. Es visualisiert am klarsten den weiter oben erwähnten Anspruch des "größten Open-Weight-Modells" und zeigt, wie Moonshot mit einem Sprung von Kimi K2s 1T Parametern an DeepSeek, Xiaomi und allen anderen vorbei auf 2,8T geht.
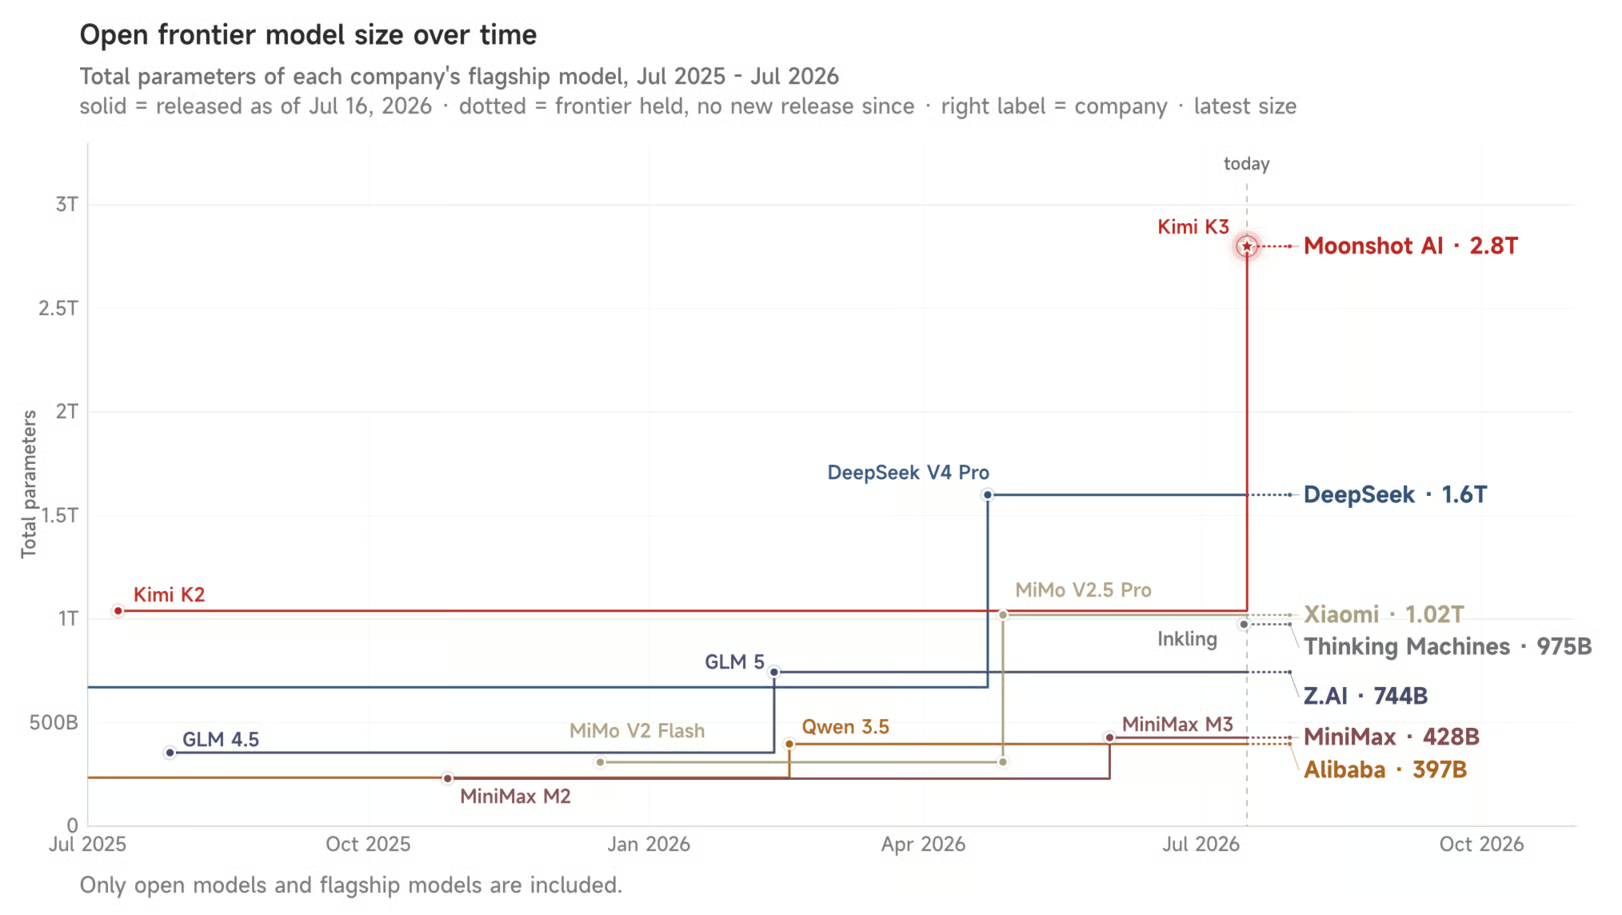
So schneidet Kimi K3 gegenüber anderen chinesischen Labs ab, die aktuell Modelle ausliefern. Insgesamt scheint sich das chinesische Open-Weight-Feld zu teilen: Labs wie DeepSeek und Z.AI konkurrieren weiter über niedrige Preise, während Moonshot beginnt, höhere Tarife zu verlangen.
DeepSeek V4 ist kleiner als K3 und deutlich günstiger bepreist.
K3 setzt auf eine andere Strategie: größer, und Moonshot berechnet den Preis entsprechend statt über den Preis zu gewinnen.
Dieser Vergleich ist spannend, weil Alibaba sowohl Moonshot unterstützt als auch natürlich die eigene Qwen-Reihe.
Sie unterscheiden sich jedoch: Qwens Flaggschiff, Qwen 3.7 Max, ist überhaupt nicht Open-Weight. Es ist geschlossen, proprietär und nur über Alibabas eigene Produkte oder Drittanbieter-APIs nutzbar. Alibaba veröffentlicht weiterhin kleinere Open-Weight-Qwen-Modelle, aber das Topmodell ist hinter verschlossenen Türen.
GLM-5.2 folgt eher dem traditionellen chinesischen Open-Source-Playbook: ein wirklich starkes Modell, MIT-lizenziert und deutlich unter westlichen Frontier-Tarifen bepreist. Es ist kleiner als K3 und viel günstiger und hat sich den Ruf erarbeitet, bei Coding nahezu Frontier-Performance zu einem Bruchteil der Kosten zu liefern.
So sehen die Zahlen nebeneinander aus, gemessen am Intelligence Index von Artificial Analysis (ein Composite-Score aus neun Benchmarks, einheitlich über Modelle hinweg):
| Modell | Parameter | Release-Datum | Intelligence Index | Terminal-Bench 2.1 | Preis ($/M in / out) | Open-Weight? |
|---|---|---|---|---|---|---|
| DeepSeek V4 Pro | 1,6T (49B aktiv) | 1. Apr. 2026 | 44 | Nicht unabhängig gelistet | $0,44 / $0,87 | Ja |
| Qwen 3.7 Max (Alibaba) | Unveröffentlicht | 20. Mai 2026 | 56,6 | Nicht direkt vergleichbar | $2,50 / $7,50 | Nein — nur API |
| GLM-5.2 (Z.AI) | 744B (40B aktiv) | 13. Juni 2026 | 51 | 78 | $1,40 / $4,40 | Ja |
| Kimi K3 | 2,8T (16 von 896 Experts aktiv) | 16. Juli 2026 | 57 | 88,3 | $3,00 / $15,00 | Ja |
Ein paar Hinweise: Qwen 3.7 Max ist der Vollständigkeit halber enthalten, ist aber, wie gesagt, kein Open-Weight-Modell und damit kein echter Peer in diesem Vergleich — als Referenz in der Tabelle passt es dennoch. Außerdem hinken unabhängige Drittverifizierungen noch hinterher, daher ist nichts in Stein gemeißelt.
Als Nächstes die Frage: Wie schlägt sich Kimi K3 gegenüber den geschlossenen, proprietären Modellen von Anthropic und OpenAI?
Opus 4.8 ist seit Monaten Anthropics Flaggschiff, und in Moonshots Zahlen übertrifft K3 es in mehreren Einzelbenchmarks, insbesondere beim Coding. K3 erzielt 88,3 auf Terminal-Bench 2.1 gegenüber 84,6 bei Opus 4.8.
Der größere Unterschied ist jedoch dieser: Opus 4.8 ist geschlossen. K3 ist Open-Weight, sodass, sobald die Gewichte tatsächlich erscheinen, jede Person es selbst hosten, feinabstimmen oder ohne Abhängigkeit von Moonshots Servern betreiben kann.
Wie in den Grafiken unten zu sehen, liegt K3 im Intelligence Index um einen Punkt vor Opus 4.8, doch die Lücke vergrößert sich anderswo: K3 kostet pro Aufgabe etwa die Hälfte und liefert den ersten Token rund 20-mal schneller.
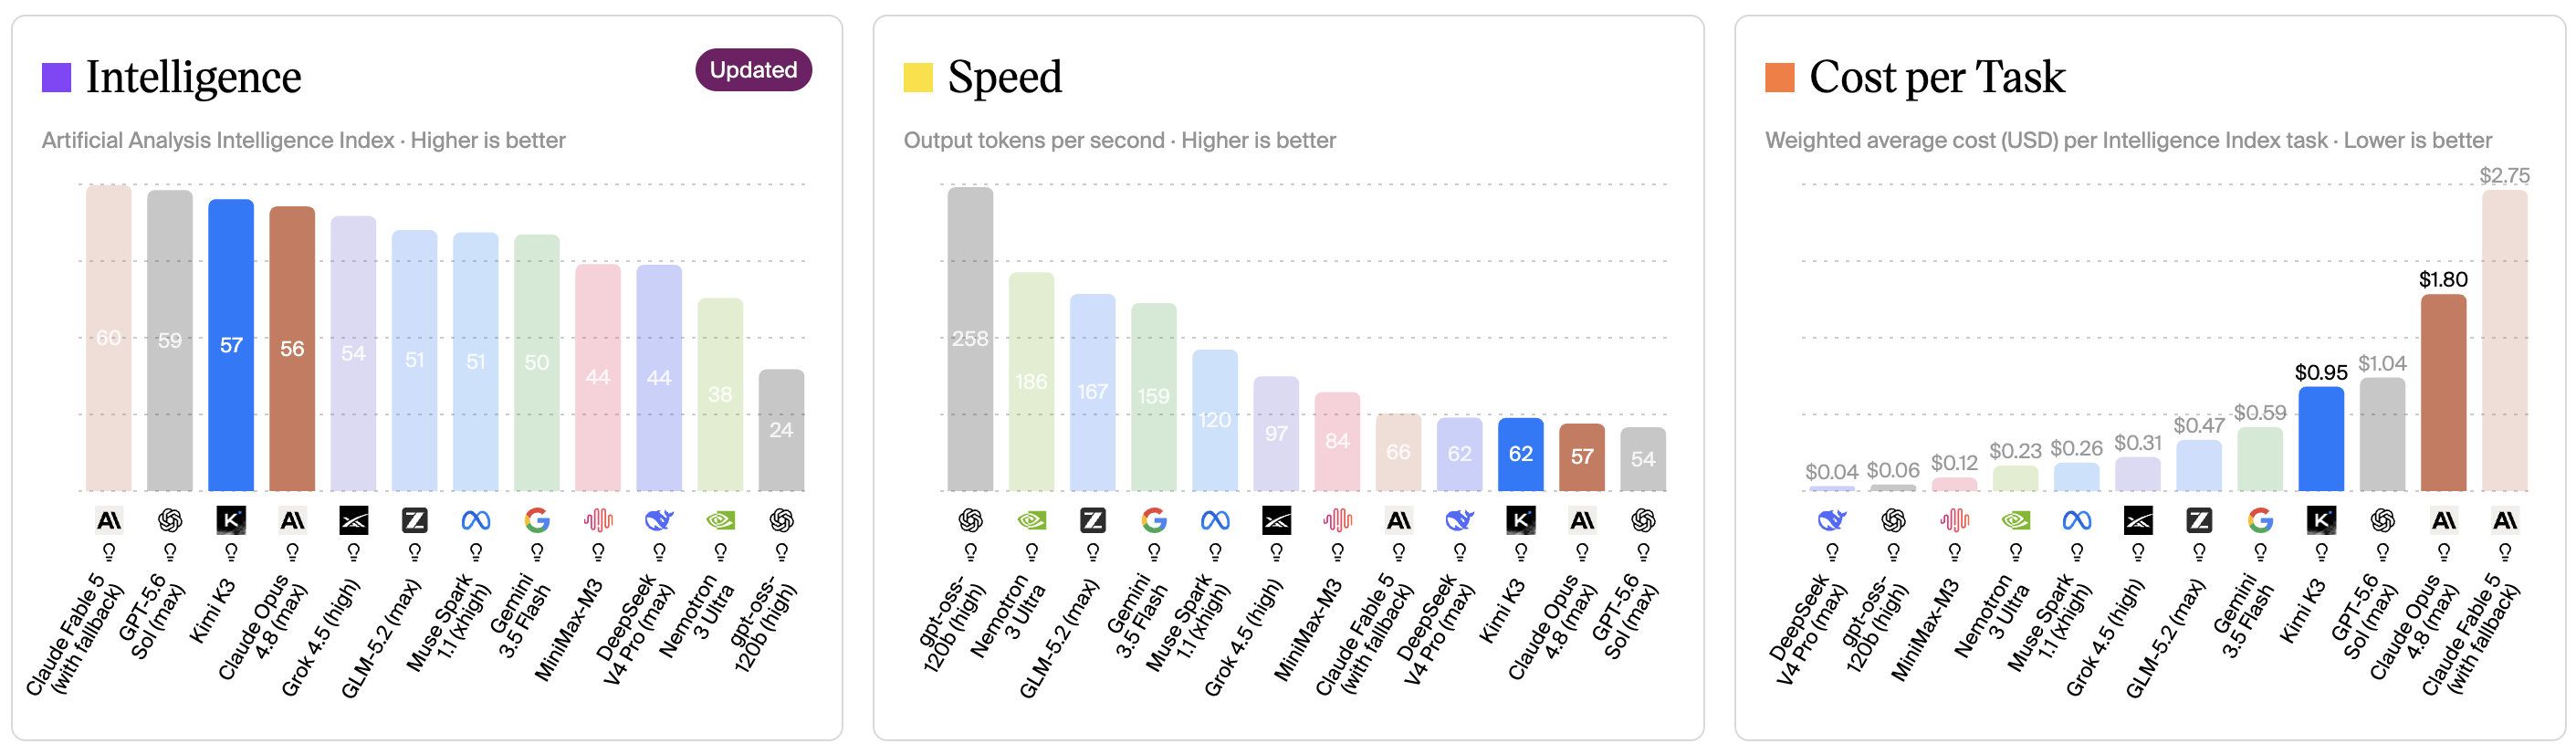
Fable 5 ist Anthropics neuestes und leistungsstärkstes Modell, und das ist das eine, das K3 nicht einholt. Es führt klar bei der Gesamtintelligenz und ist deutlich teurer im Betrieb. Fable 5 kostet $10/$50 pro Million Tokens gegenüber $3/$15 bei K3. K3s Argument ist hier aber nicht "so gut wie Fable 5". Es lautet: "Ein Großteil der Leistung für einen Bruchteil des Preises."
Wie in den Grafiken unten zu sehen, führt Fable 5 im Intelligence Index komfortabel und ist in der Roh-Ausgabegeschwindigkeit sogar einen Tick schneller als K3. Wo K3 vorne liegt, sind die Kosten. Pro Aufgabe läuft es zu etwa einem Drittel des Preises von Fable 5.
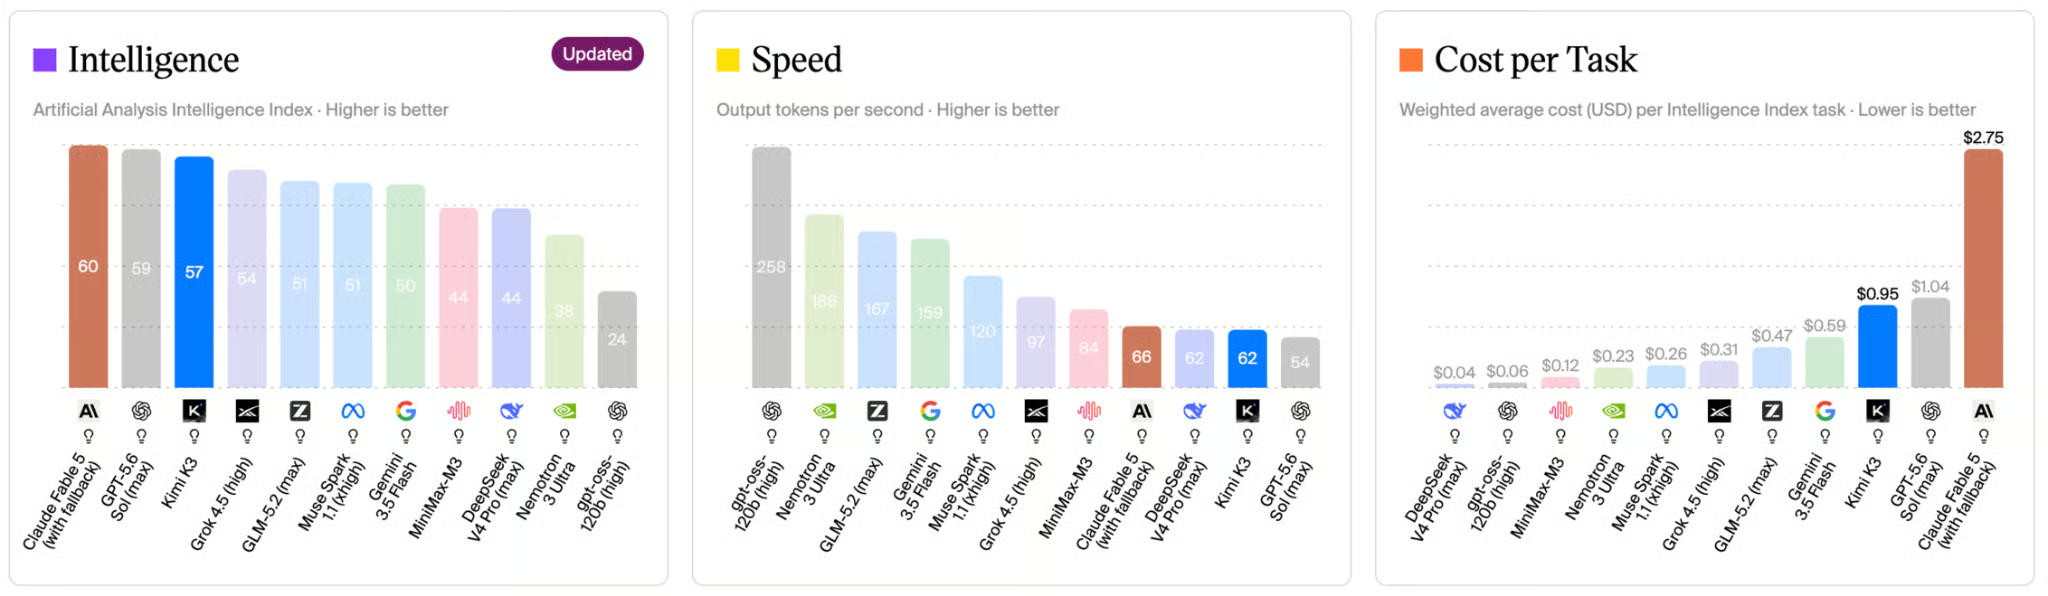
GPT-5.5 liegt in Moonshots eigenen Benchmarks knapp unter K3 und ist preislich auf einem ähnlichen Niveau wie die anderen US-Flaggschiffe und deutlich über K3.
Wie in den Grafiken unten zu sehen, liegt K3 im Intelligence Index knapp vor GPT-5.5 und kostet pro Aufgabe etwas weniger. GPT-5.5 generiert, einmal angelaufen, Tokens etwas schneller, sodass die beiden je nach deinen Prioritäten bei diesen drei Faktoren die Plätze tauschen.
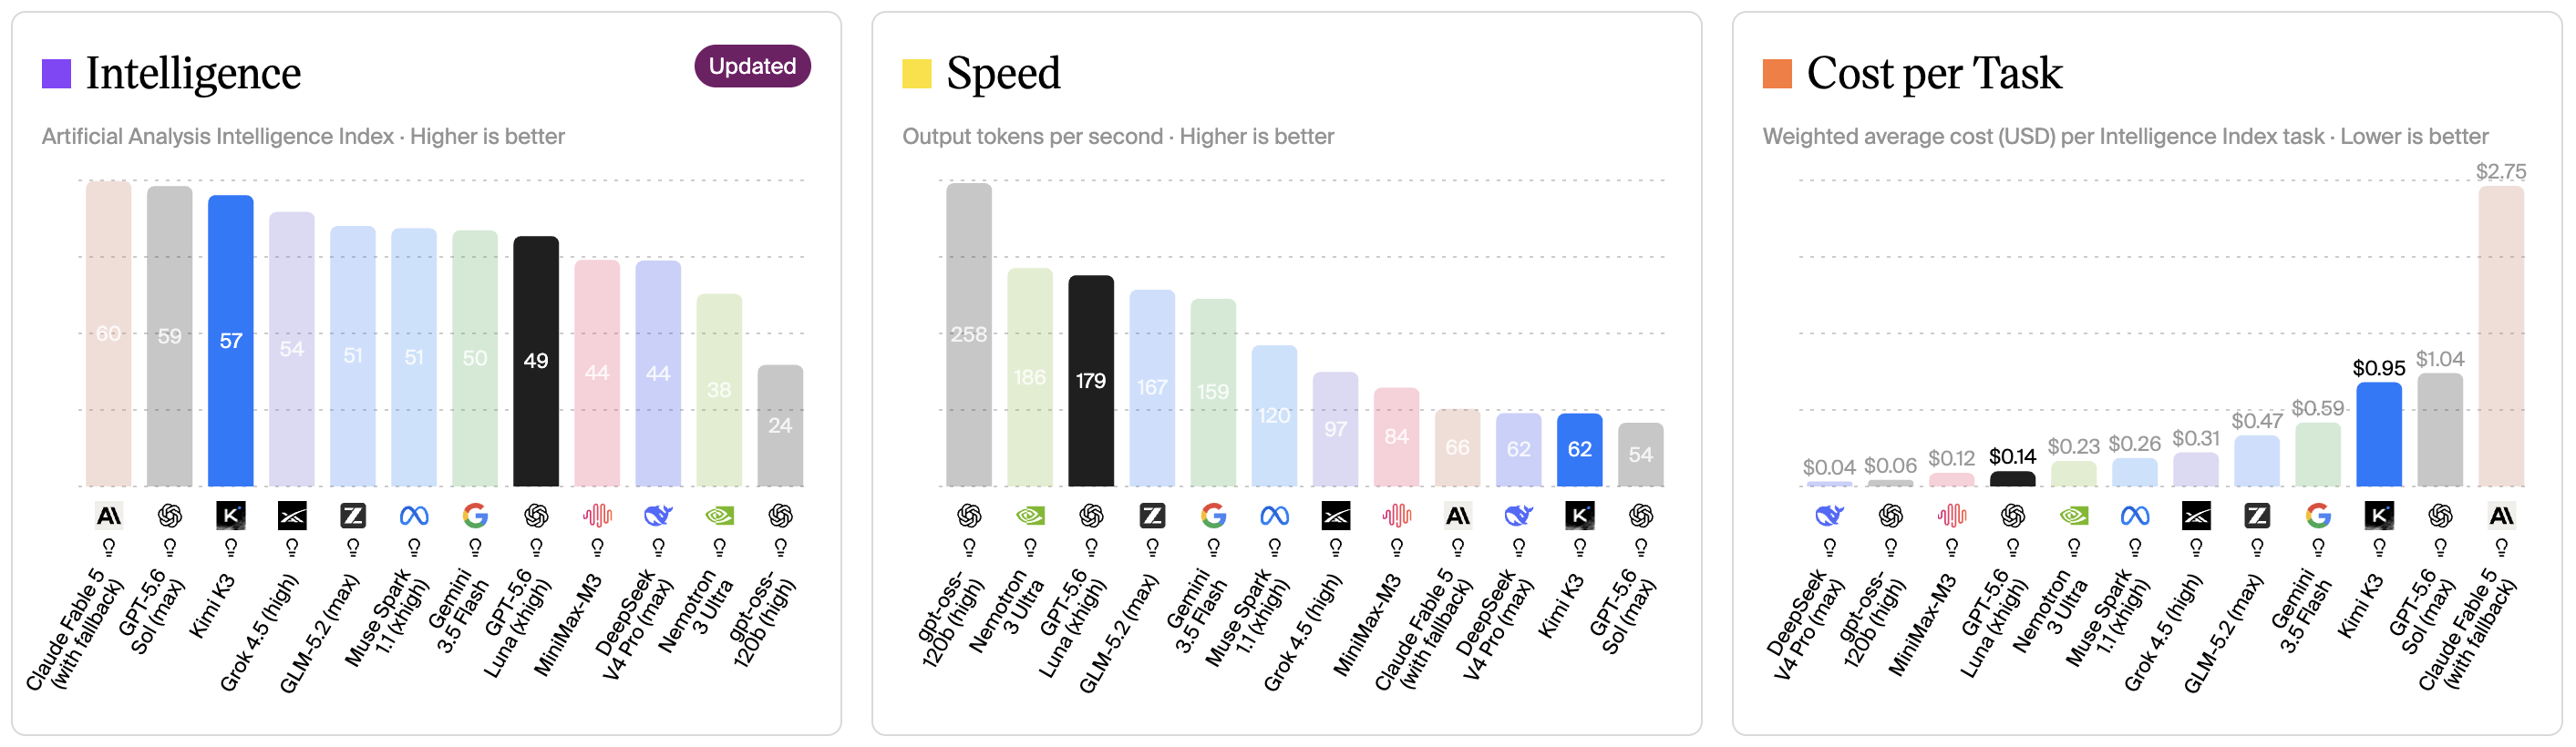
GPT-5.6 Sol ist OpenAIs neuestes und teuerstes Modell in diesem Vergleich, und bei Terminal-Bench 2.1 liegt es praktisch gleichauf mit K3. Sol erzielt 88,8 gegenüber 88,3 bei K3.
Der wichtigere Unterschied ist derselbe wie bei Opus 4.8: Sol ist Closed-Weight und nur über OpenAIs eigene Produkte (ChatGPT, Codex, die API) nutzbar, während K3 Open-Weight ist. Sobald die Gewichte erscheinen, kann es jede Person selbst hosten oder feinabstimmen.
Wie in den Grafiken unten zu sehen, liegt Sol im Intelligence Index knapp vor K3, doch K3 ist sowohl bei Geschwindigkeit als auch Kosten im Vorteil.
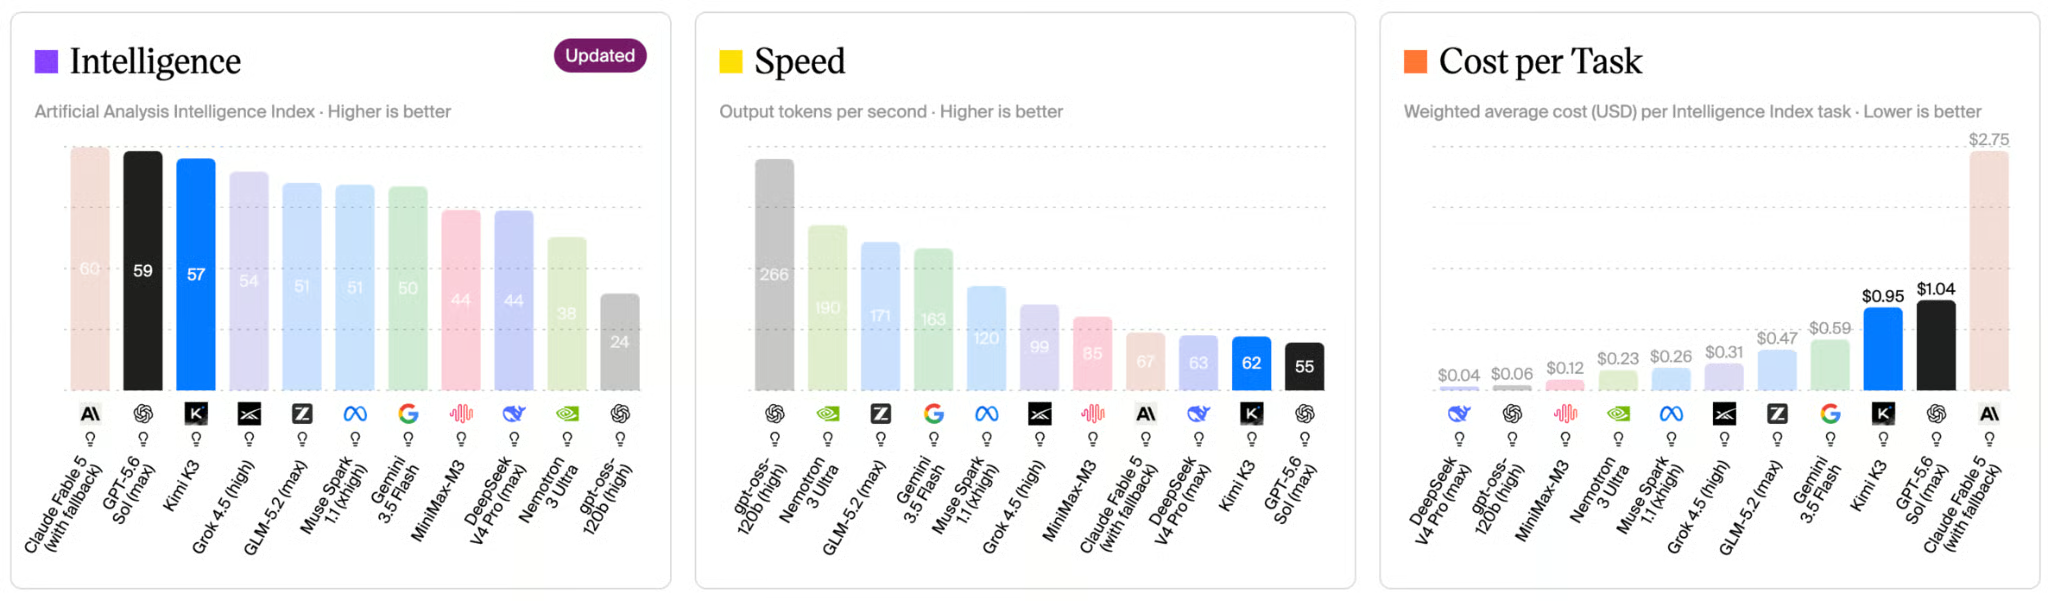
Kimi K3 ist jetzt live, wenn auch noch nicht vollständig. Das Modell selbst wurde gestern gelauncht und ist heute bereits über kimi.com, die Kimi-Mobile-Apps, Kimi Work, Kimi Code und die Kimi API unter der Modell-ID kimi-k3 nutzbar. Es taucht auch auf Drittanbieter-Routern wie OpenRouter und OrcaRouter auf.
Was noch fehlt, sind die Open Weights selbst. Moonshot sagt, sie werden bis zum 27. Juli 2026 veröffentlicht, während das Unternehmen mit Inference-Partnern und Open-Source-Maintainern weiter an der technischen Angleichung arbeitet. Bis dahin kannst du K3 über Moonshots gehostete Services nutzen, es aber nicht herunterladen und selbst hosten.
Wir empfehlen dir, unseren wöchentlichen KI-Newsletter The Median zu abonnieren, um über Modell-Releases wie dieses auf dem Laufenden zu bleiben.
Beim Pricing setzt K3 auf Pay-as-you-go ohne Staffelung nach Kontextlänge, trotz des 1M-Tokens-Fensters. Moonshots offizielle Tarife sind $0,30 pro Million Tokens für Cache-Hit-Input, $3,00 pro Million Tokens für Cache-Miss-Input und $15,00 pro Million Tokens für Output — mit einer gemeldeten Cache-Hit-Rate von über 90% bei typischen Coding-Workloads, was die effektiven Input-Kosten in der Praxis senkt.
Moonshot ist im eigenen technischen Blog offen zu den Limitierungen:
Kimi K3 ist das bislang größte veröffentlichte Open-Weight-Modell. Es bringt eine neue Attention-Architektur, die gezielt auf Long-Context- und agentische Workloads zielt. In den nun öffentlichen Benchmarks ist es nicht der Gesamtsieger — Fable 5 und GPT-5.6 Sol liegen knapp vorn —, aber es ist bei Coding, agentischen und multimodalen Aufgaben extrem konkurrenzfähig, und das zu einem Bruchteil der Kosten.
Das ist der rote Faden dieses Artikels: K3 will nicht jede Kategorie gewinnen. Es will das Preis-Leistungs-Verhältnis schwer zu ignorieren machen — so wie DeepSeek mit R1 und GLM-5.2 kürzlich —, nur dass Moonshot dafür diesmal Frontier-Tarife verlangt statt Dumpingpreisen.
Lerne KI mit DataCamp
Kurs
Kurs
Kurs
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Zoumana Keita
15 Min.
Blog
Nathaniel Taylor-Leach
4 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Josef Waples
8 Min.