
课程
LLMOps 概念
1 小时
19.9K
Moonshot AI 宣布推出 Kimi K3——其 Kimi 模型系列中最新的旗舰,也是迄今发布的最大开源权重模型(2.8 万亿参数)。完整权重尚未公布。Moonshot 表示将在十天内发布。
不过,参数规模并非全部故事。Moonshot 是一家总部位于北京的初创企业,背后有阿里巴巴支持(如果您还记得的话,阿里也做 Qwen 模型,最新的是 Qwen 3.7),在 DeepSeek 等中国实验室扎堆的赛道上,它一直在努力提升存在感。
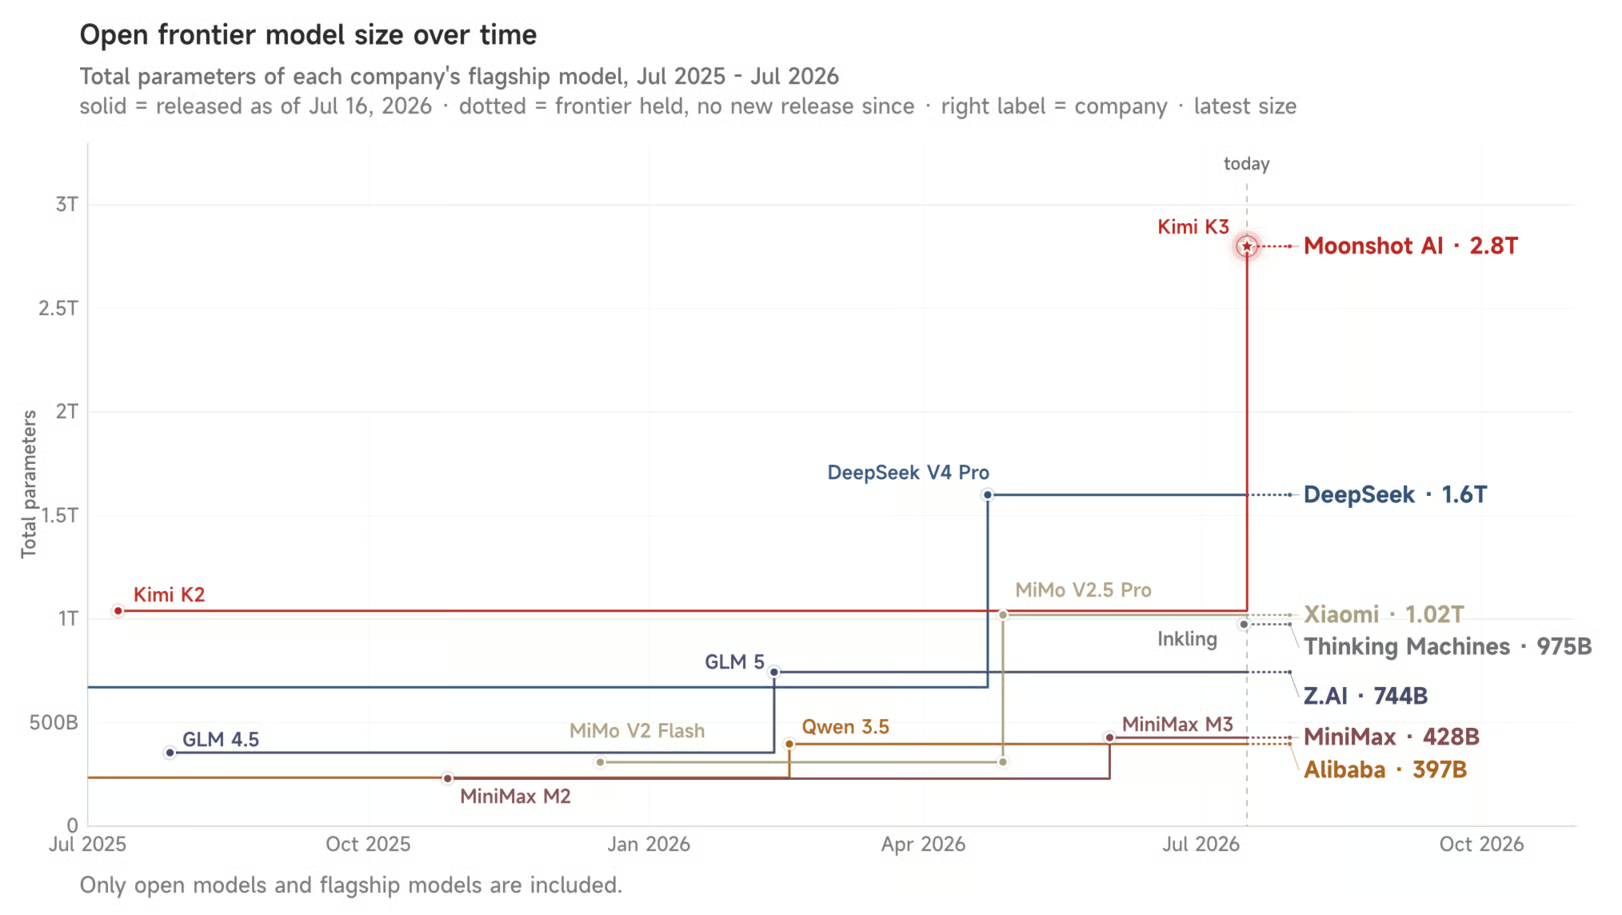
从规模上看,K3 大约比 DeepSeek V4 大 75%。在 Moonshot 自家的基准上,它击败了 Claude Opus 4.8 和 GPT-5.5,但落后于 Claude Fable 5 和 GPT-5.6 Sol。
真正值得关注的是定价。K3 的收费对标最前沿。这对美国实验室来说是个问题:如果一款中国模型能以同样的价格、提供接近的性能,就会动摇“高价即差异化”的假设。
我们前面提到了定价和背景。那么,我们到底知道哪些关于 Kimi K3 的信息——它如何构建,表现如何?
Kimi K3 尤其面向 Moonshot 所称的“前沿智能场景”,也就是长周期编码、知识工作和推理。
为此,它支持 100 万 token 的上下文窗口,以及原生视觉理解。后者意味着它可以直接接收图像与视频作为输入。
讨论最多的是表层能力:100 万 token 的上下文窗口与原生视觉理解,我已经提到过。
为实现这些,Moonshot 在后端三大方面做了改动:
该模型围绕两个新组件构建:Kimi Delta Attention(KDA),一种混合线性注意力机制,以及 Attention Residuals(AttnRes)。二者旨在帮助信息在长序列和深层网络中更可靠地传播。
此外,Moonshot 还在其 专家混合(MoE) 方案中进一步提升稀疏度,采用“稳定的 LatentMoE”框架,每次前向仅激活少量专家。结合训练与数据上的变化,Moonshot 称这使得 K3 的扩展效率约为其前代 K2 的 2.5 倍。
Moonshot 将 K3 定位为擅长长周期工程工作的模型:在最少监督下维持多步骤任务、在大型代码库中导航,以及协同终端工具。
它还强调了一个特定细分场景——将编码与视觉推理结合,比如利用截图和视觉反馈来迭代游戏开发、前端工作或 CAD 任务。网上有不少 Kimi K3 的游戏开发示例,例如一款 纸片马里奥风格的游戏、一款飞机投递游戏,以及看起来像《光环》的作品。
Moonshot 表示,其内部评估(基于真实的代理协作工作流而非公开基准)显示,Kimi K3 的“max”变体在接近生产环境的知识工作任务上有稳定提升。
对于实际使用模型的人来说,这意味着更长的文档、代码库或视频可以作为单个输入提交,而无需切分再拼接;同一次请求也能无缝混合文本、图像和视频,无需额外管道。
如果这些效率增益能站得住脚,也意味着相较 K2,每一美元算力能获得更多能力。
API 文档为实际用它来构建应用的开发者提供了更清晰的变化图景:
始终开启的“思考”模式:K3 默认运行在思考模式,通过顶层参数 reasoning_effort 配置,而不是 K2 系列的旧 thinking 标志。目前仅支持 max 强度。
流式输出且可分离推理:流式响应会分别以增量形式输出 reasoning_content 与最终答案的 content,您可以选择展示或隐藏模型的思考过程。
视觉输入,不支持公共 URL:图像必须以 base64 或上传文件引用的方式发送;模型不接受普通图片 URL,视频需通过单独的文件上传处理。
结构化输出:支持带有 strict 模式的 JSON Schema 输出,但这只约束最终的 content 字段,不约束推理轨迹。
Partial 模式:您可以用固定前缀“种子化”助理回复,并让模型从该处继续。这在您想强制特定开场时很有用。
动态工具加载:可以通过一条 system 消息在对话中途注入工具定义,自该点起在对话中生效。
自动上下文缓存:缓存自动进行,无需额外参数。
集成 API 时还需注意的其他限制:max_completion_tokens 默认 131,072,上限 1,048,576;且 temperature、top_p 等采样参数是固定的,无法配置。
Kimi 也非常擅长浏览器自动化任务。详见我们的Kimi 浏览器扩展教程。
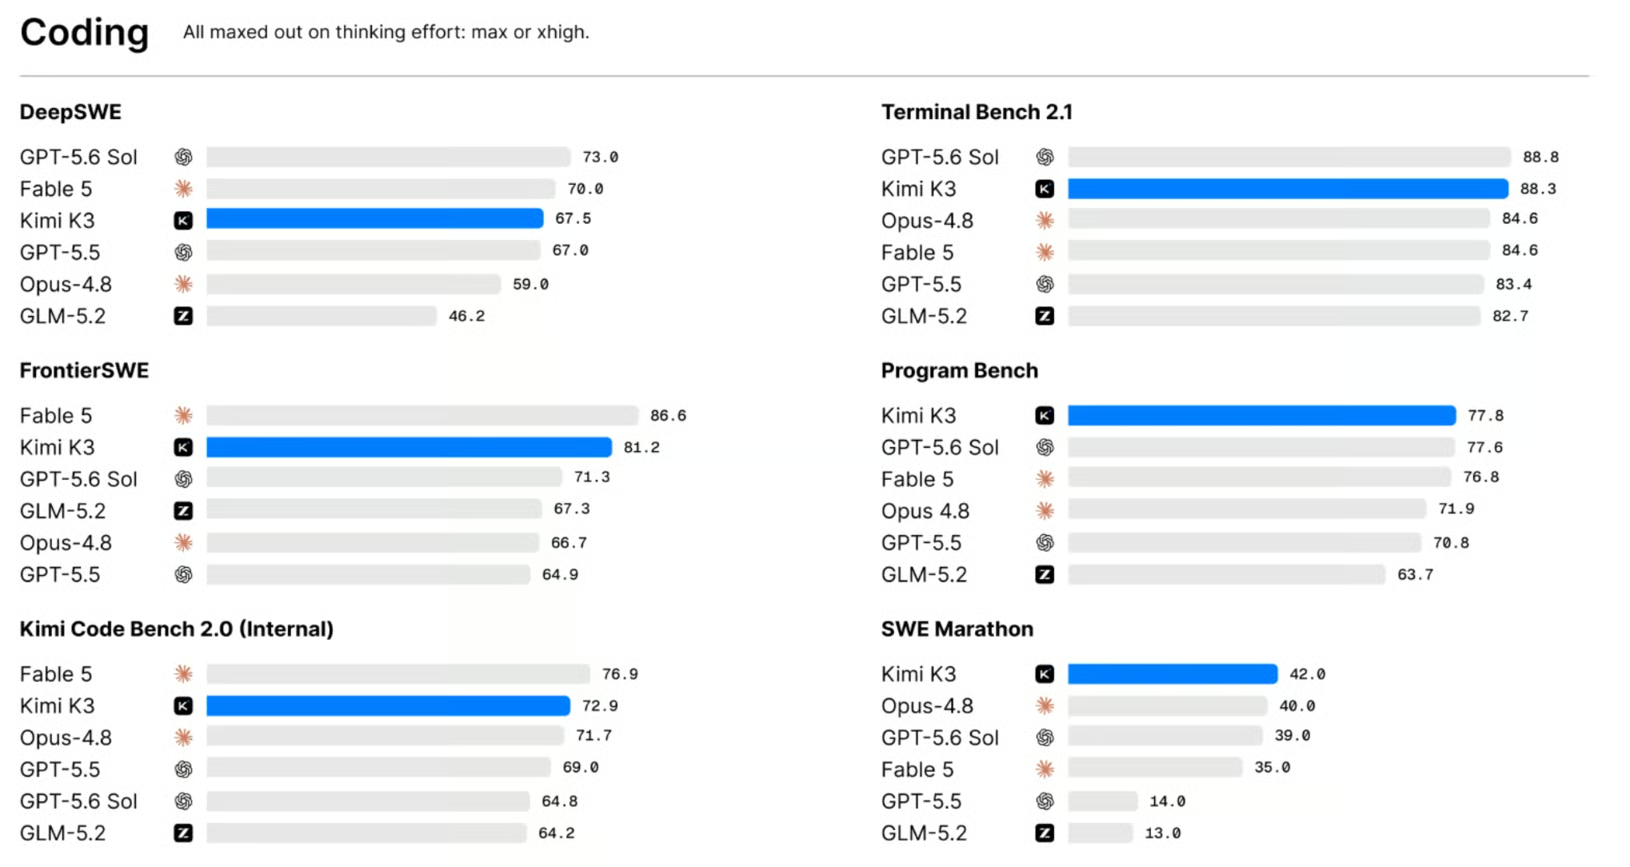
Moonshot 的发布材料现在确实包含真实的基准分数,但需注意,不同模型使用了不同的代理工具框架。K3 用的是 Moonshot 自家的 KimiCode;Claude 系列使用 Claude Code 或 Terminus 2;GPT 系列使用 Codex。因此这并非完全可比。各家模型都在自家最佳工具环境中测试。
以下从三类指标看整体格局。
正如下图所示,K3 并未横扫编码基准,但几乎在各处都具备竞争力。它在 Program Bench 和 SWE Marathon 上领跑,在 Terminal-Bench 2.1 上与 GPT-5.6 Sol 仅差半分,并在大多数单项测试上领先 Opus 4.8。明显落后的地方是 DeepSWE 与 FrontierSWE,上面 Fable 5 和 GPT-5.6 Sol 领先。
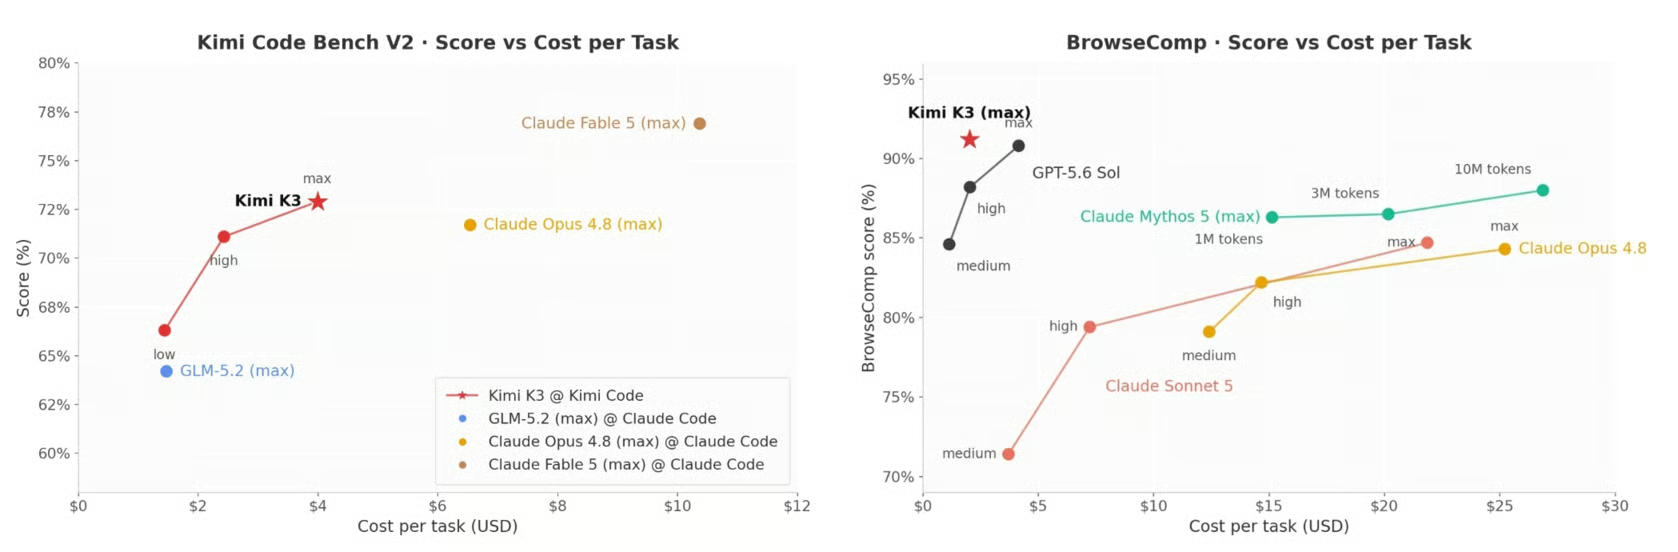
在 Moonshot 自家的 Kimi Code Bench V2 图表中,K3 与 Opus 4.8 得分相近,但每个任务的成本大约是后者的一半;为那几分额外分数,Fable 5 的成本则远高于 K3。BrowseComp 的图表也类似:K3 得分高于 GPT-5.6 Sol 和 Claude Fable 5,但每个任务的成本只是它们的一小部分。
模型参数图颇有意思。它最直观地呈现了前文“最大开源权重模型”的说法:Moonshot 从 Kimi K2 的 1T 参数,一次发布就直接跃过 DeepSeek、小米等,来到 2.8T。
以下是 Kimi K3 与当前国内其他在发模型的对比。总体看,中国开源权重赛道似乎在分化:DeepSeek、Z.AI 等仍在“性价比”维度竞争,而 Moonshot 则开始收取更高价格。
DeepSeek V4 规模小于 K3,定价也远低于 K3。
K3 选择了不同路径:它更大,Moonshot 也相应提高了收费,而不是在价格上求胜。
这个比较有意思,因为阿里同时支持 Moonshot,当然还有自家的 Qwen 系列。
不过二者不同:Qwen 的旗舰 Qwen 3.7 Max 并非开源权重。它是封闭、专有的,只能通过阿里自家产品或第三方 API 托管使用。阿里仍在发布较小的开源权重 Qwen 模型,但其顶级模型已转为闭源。
GLM-5.2 更接近传统的国产开源打法:模型实力强,MIT 许可,定价远低于西方前沿标准。它比 K3 更小,也便宜很多,并以极高性价比、接近前沿的编码性能赢得口碑。
以下用 Artificial Analysis 的 Intelligence Index(由九项基准组成、以相同方式跨模型运行的综合分)作为度量,看看数据对比:
| 模型 | 参数量 | 发布日期 | Intelligence Index | Terminal-Bench 2.1 | 价格($/百万 输入/输出) | 开源权重? |
|---|---|---|---|---|---|---|
| DeepSeek V4 Pro | 1.6T(激活 49B) | 2026 年 4 月 24 日 | 44 | 无独立列示 | $0.44 / $0.87 | 是 |
| Qwen 3.7 Max(阿里巴巴) | 未披露 | 2026 年 5 月 20 日 | 56.6 | 不可直接比较 | $2.50 / $7.50 | 否 — 仅 API |
| GLM-5.2(Z.AI) | 744B(激活 40B) | 2026 年 6 月 13 日 | 51 | 78 | $1.40 / $4.40 | 是 |
| Kimi K3 | 2.8T(896 位专家中激活 16 位) | 2026 年 7 月 16 日 | 57 | 88.3 | $3.00 / $15.00 | 是 |
需要强调两点:Qwen 3.7 Max 这里作为参考包含在内,但正如前面所说,它并非开源权重,因此并非真正的同类对比,只是放表中做个参照。另外,各项独立第三方验证整体仍在跟进中,一切尚未尘埃落定。
接下来,看看 Kimi K3 与 Anthropic、OpenAI 的封闭专有模型相比如何。
Opus 4.8 已作为 Anthropic 旗舰数月;在 Moonshot 提供的数字上,K3 在多个单项基准(尤其是编码)略胜一筹。K3 在 Terminal-Bench 2.1 上得分 88.3,Opus 4.8 为 84.6。
更大的差别在于:Opus 4.8 是闭源的。K3 是开源权重,因此一旦权重放出,任何人都可以自托管、微调,或在不依赖 Moonshot 服务器的情况下运行。
如下图所示,K3 在 Intelligence Index 上以 1 分微弱领先 Opus 4.8,但其他方面差距更大:K3 的单任务成本约为其一半,且首个 token 的响应速度大约快 20 倍。
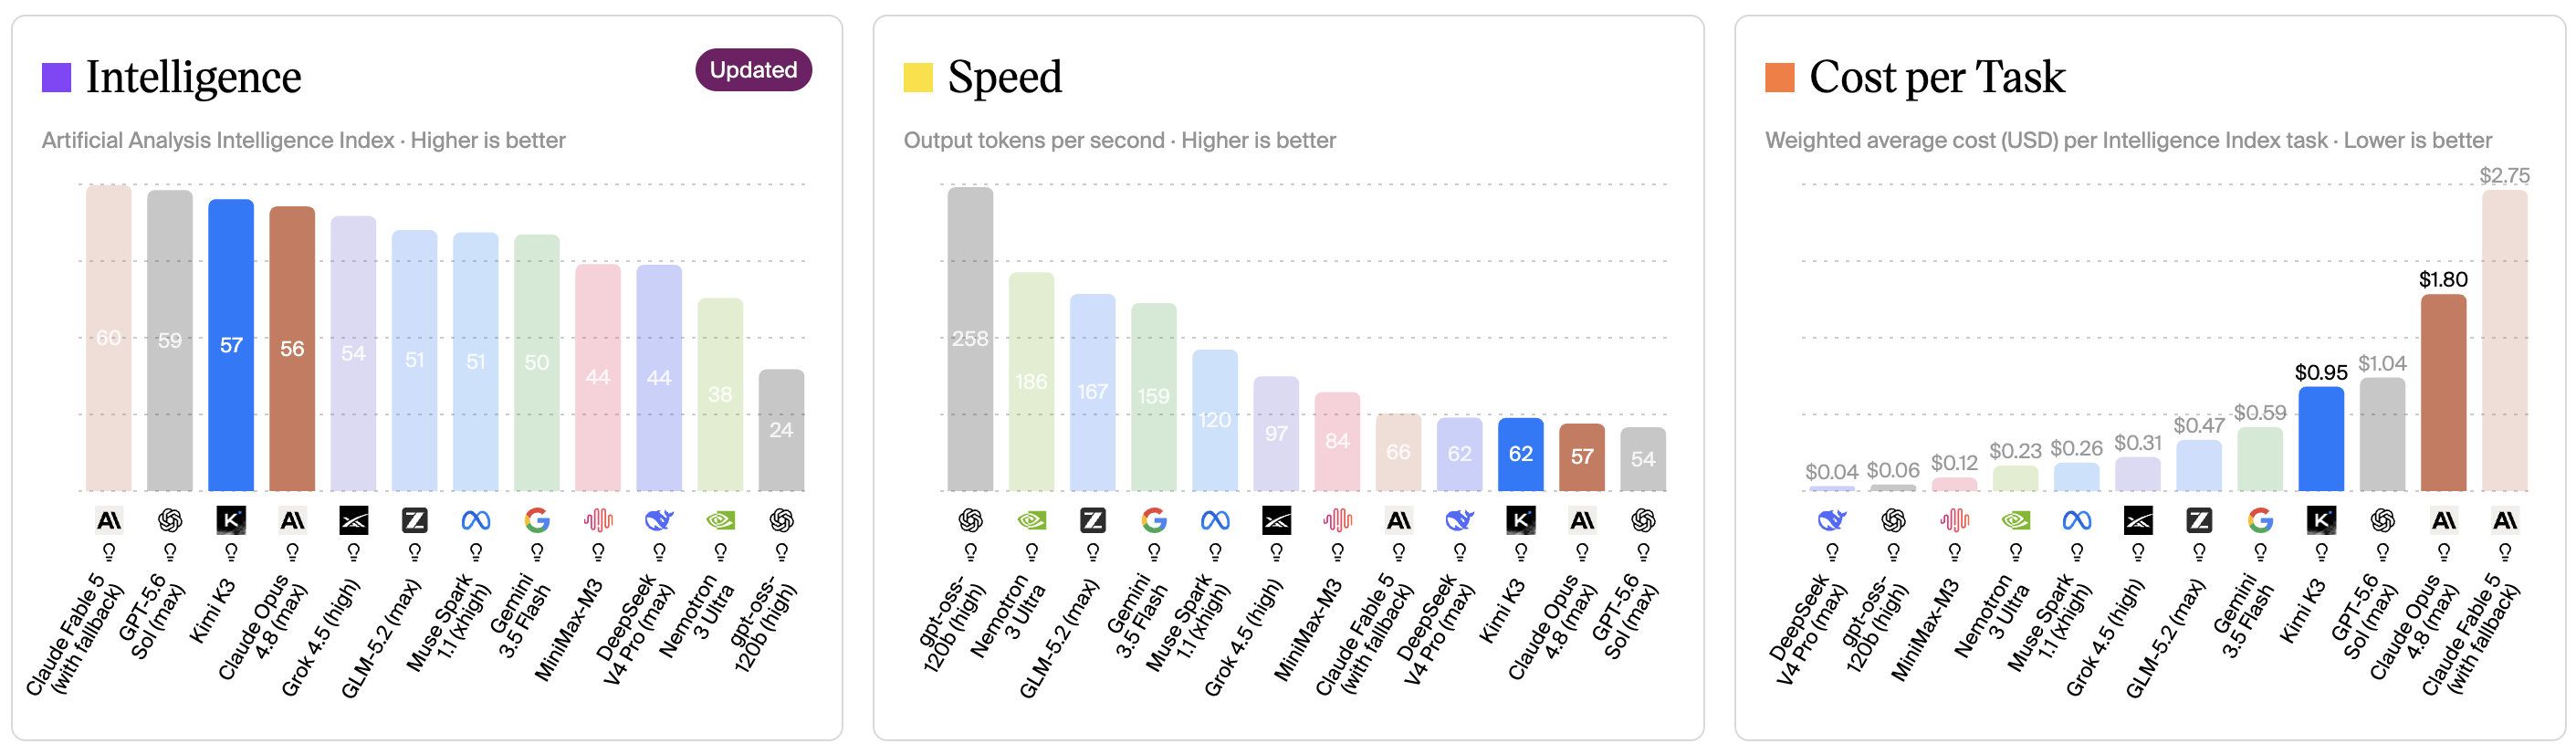
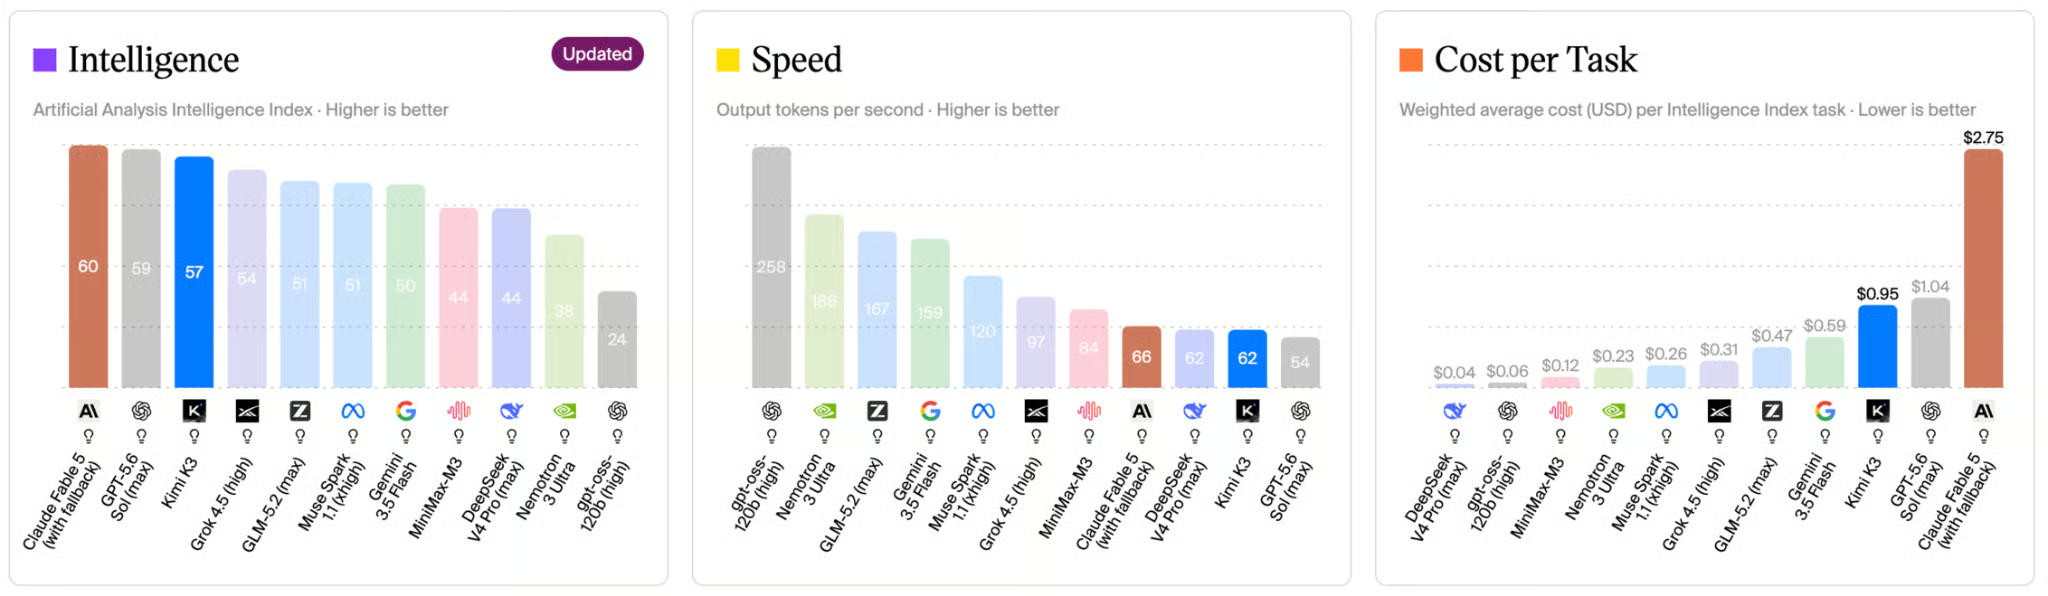
Fable 5 是 Anthropic 最新且最强的模型,也是 K3 尚未追上的那一个。它在总体智能上明显领先,运行成本也高得多。Fable 5 的定价为每百万 token $10/$50,而 K3 为 $3/$15。但 K3 的卖点并非“与 Fable 5 一样好”,而是“用更少的钱,获得大部分能力”。
如下图所示,Fable 5 在 Intelligence Index 上优势明显,原始输出速度上也略快于 K3。K3 的优势在于成本:其单任务成本约为 Fable 5 的三分之一。
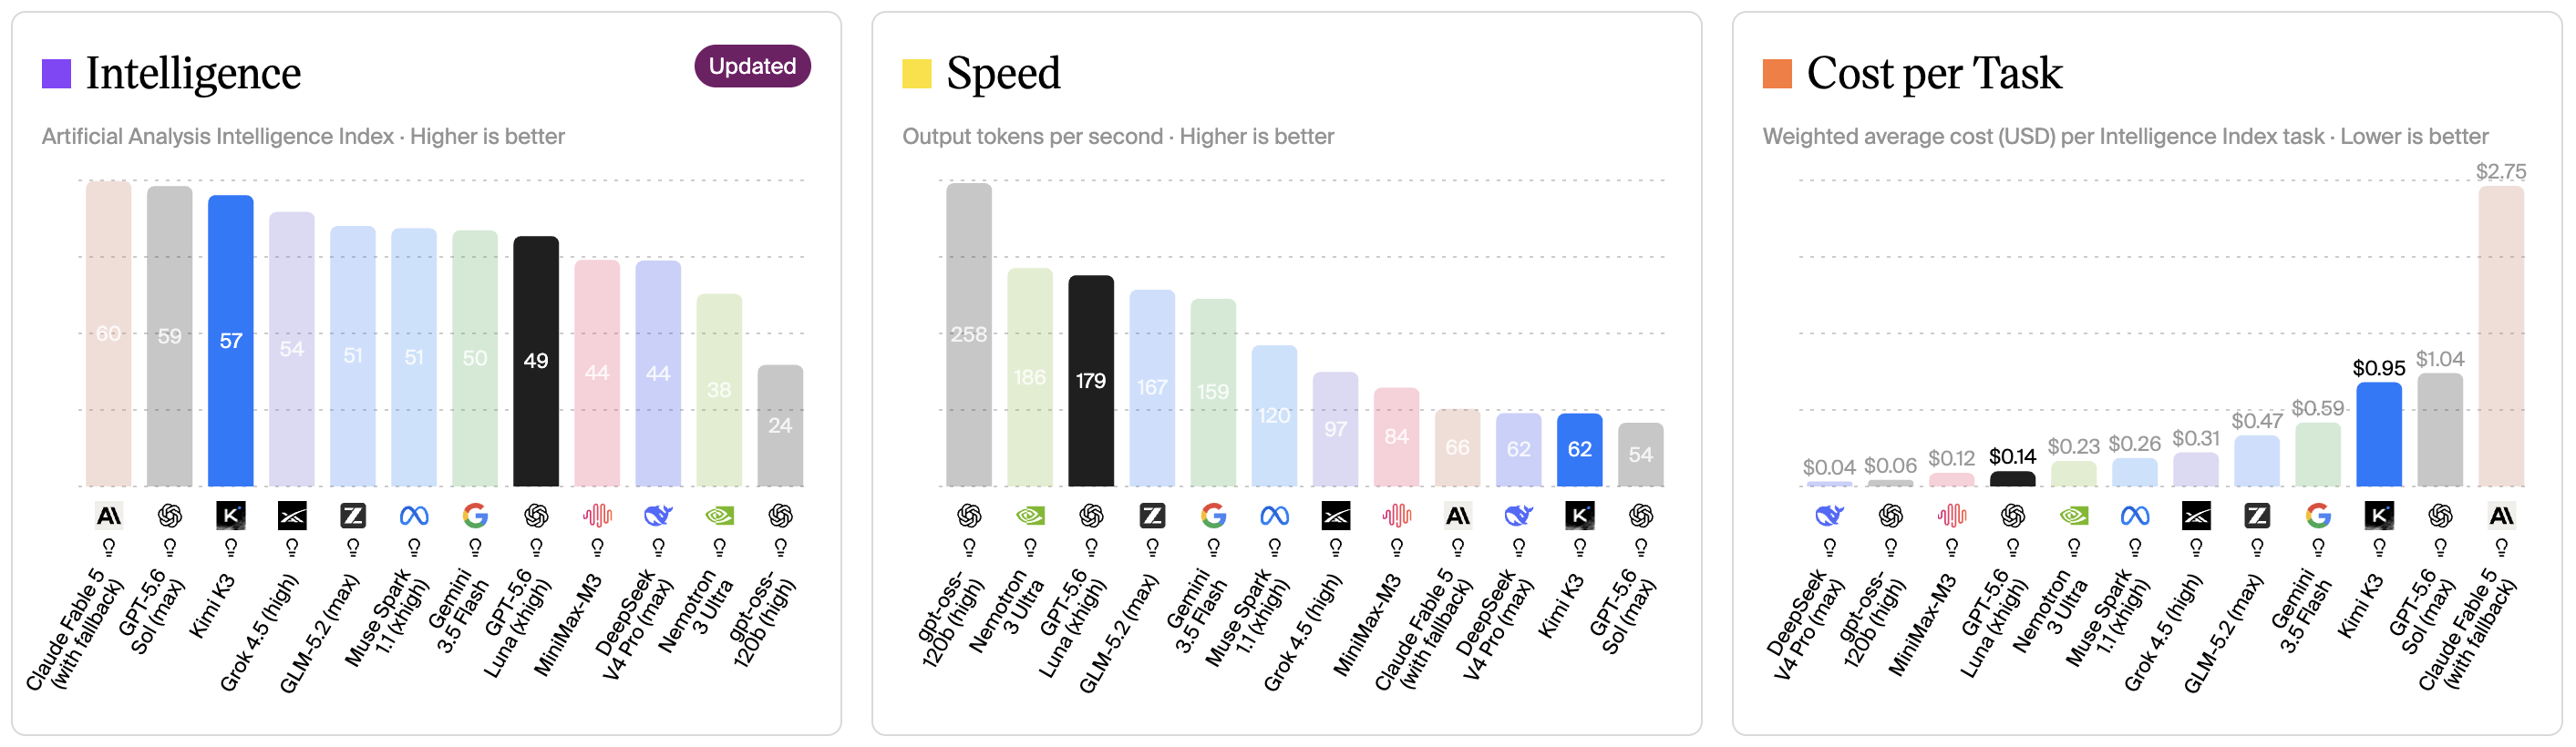
在 Moonshot 自家基准上,GPT-5.5 略低于 K3,且定价与其他美国旗舰相近,明显高于 K3。
如下图所示,K3 在 Intelligence Index 上略胜 GPT-5.5,单任务成本也略低。GPT-5.5 在开始生成后 token 速率稍快,因此两者如何取舍取决于您更看重三者中的哪一项。
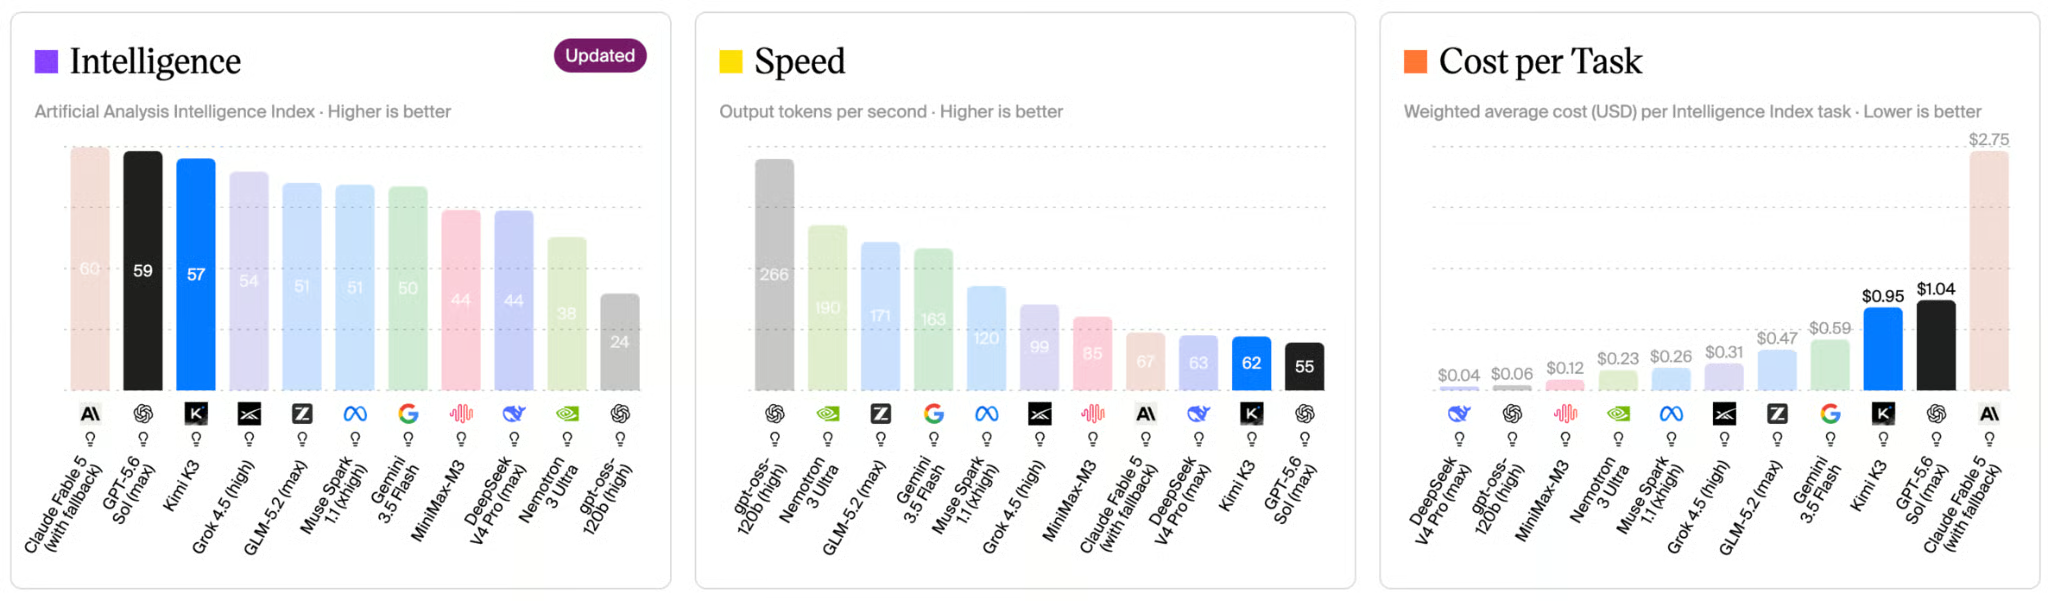
GPT-5.6 Sol 是本次对比中 OpenAI 最新且最昂贵的模型,在 Terminal-Bench 2.1 上它与 K3 基本打平:Sol 得分 88.8,K3 为 88.3。
更大的差异与 Opus 4.8 相同:Sol 是闭源权重,只能通过 OpenAI 自家产品(ChatGPT、Codex、API)使用;而 K3 是开源权重。一旦权重放出,任何人都能自托管或微调。
如下图所示,Sol 在 Intelligence Index 上略胜 K3,但 K3 在速度和成本两项上占优。
Kimi K3 现已上线,但尚未完全放开。模型已于昨日发布,今天即可通过 kimi.com、Kimi 移动应用、Kimi Work、Kimi Code,以及在模型 ID kimi-k3 下的 Kimi API 使用。它也已开始出现在 OpenRouter、OrcaRouter 等第三方路由上。
尚未发布的是开源权重本身。Moonshot 表示将在 2026 年 7 月 27 日前发布,同时公司正与推理合作伙伴和开源维护者协作,协调技术细节。在此之前,您可以通过 Moonshot 的托管服务使用 K3,但无法下载并自托管。
我们建议订阅我们的每周 AI 时事通讯 The Median,便于及时了解此类模型发布动态。
在定价方面,尽管拥有 100 万 token 窗口,K3 采用按量计费的统一价,而非按上下文长度分层。Moonshot 官方费率为:缓存命中输入每百万 token $0.30、缓存未命中输入 $3.00、输出 $15.00——据称在典型编码工作负载中缓存命中率超过 90%,这在实践中能有效降低输入成本。
Moonshot 在其技术博客中坦诚提到了一些局限:
Kimi K3 是迄今发布的最大开源权重模型。它采用全新的注意力架构,直指长上下文与代理类工作负载。在目前公开的基准上,它并非全场最强——Fable 5 和 GPT-5.6 Sol 都略胜一筹——但在编码、代理与多模态任务上竞争力极强,且成本仅为其一部分。
这也是全文的主线:K3 并不试图在每个项目上夺冠,而是要让“价格—能力”的权衡难以忽视,就像当年的 DeepSeek R1 与近期的 GLM-5.2——只不过这次,Moonshot 选择以前沿价位来实现,而非打折价。
在 DataCamp 学习 AI
课程
课程
课程