Corso
Concetti di LLMOps
1 ore
19.9K
Moonshot AI ha annunciato Kimi K3, il nuovo modello di punta della linea Kimi e il più grande modello open-weight rilasciato finora (2,8 trilioni di parametri). I pesi completi non sono ancora disponibili. Moonshot dice che saranno rilasciati tra dieci giorni.
Il numero di parametri però non è la notizia principale. Moonshot è una startup con sede a Pechino supportata da Alibaba (che sviluppa anche i modelli Qwen, se ricordi, con Qwen 3.7 come ultimo), e sta cercando di restare rilevante mentre DeepSeek e altri laboratori cinesi affollano il settore.
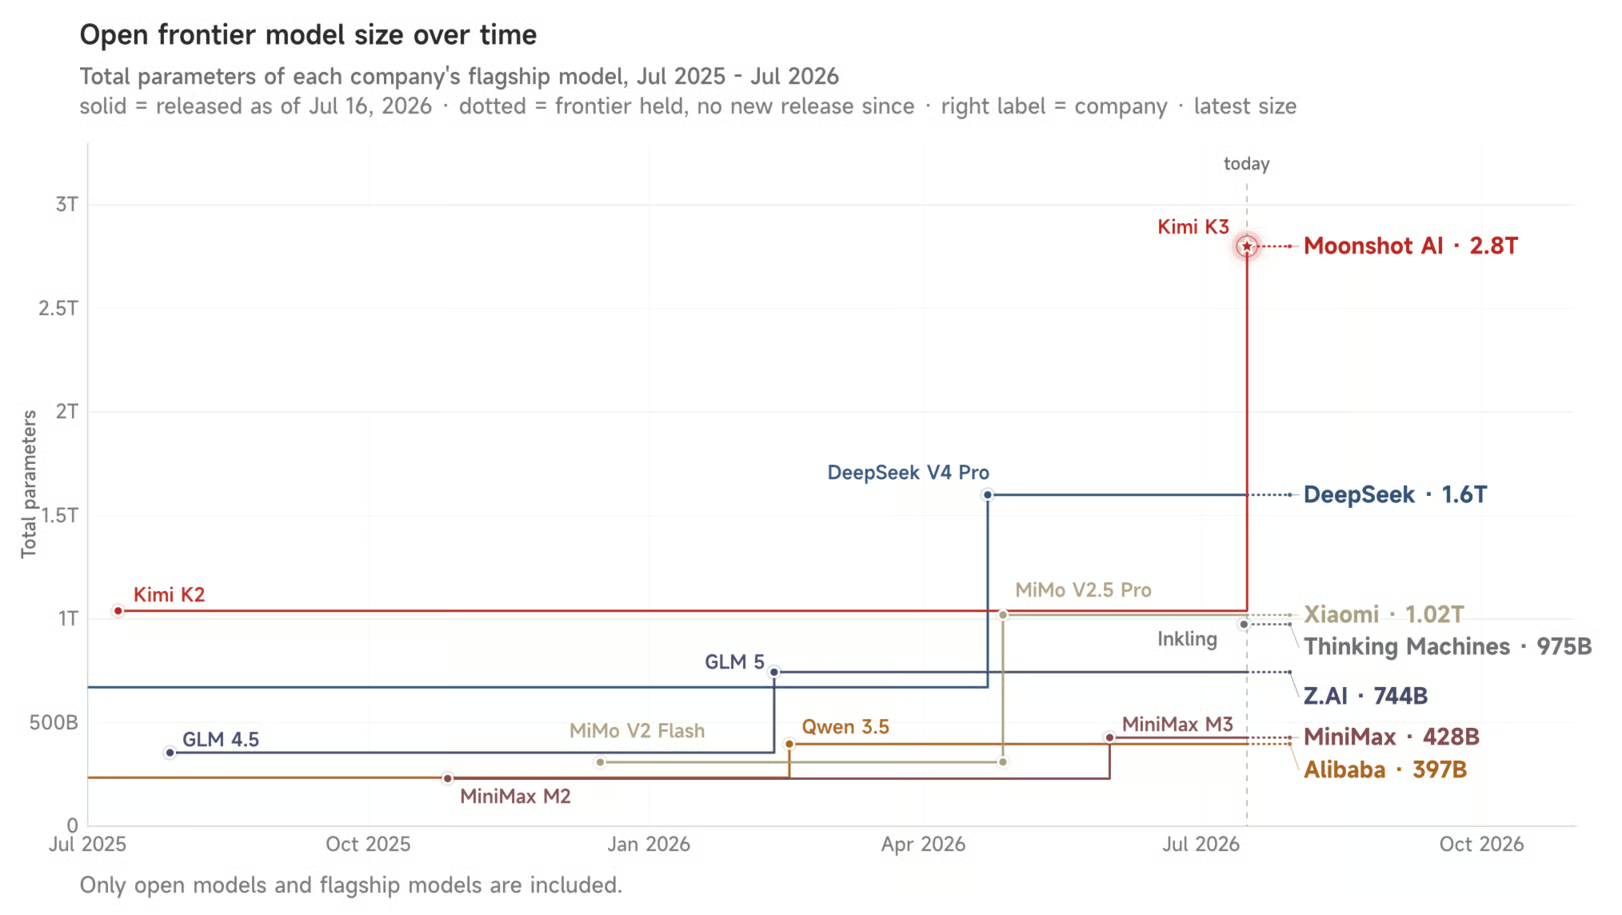
In termini di scala, K3 è circa il 75% più grande di V4 di DeepSeek. Sui benchmark interni di Moonshot, supera Claude Opus 4.8 e GPT-5.5, pur restando dietro a Claude Fable 5 e GPT-5.6 Sol.
Il vero segnale però è il prezzo. K3 applica tariffe da modello di frontiera. Questo è il problema per i laboratori statunitensi: se un modello cinese può chiedere lo stesso prezzo e offrire prestazioni simili, viene meno l’idea che un prezzo premium sia ciò che distingue i modelli USA.
Abbiamo accennato a prezzi e storia. Ma cosa sappiamo di Kimi K3, di come è costruito e di quanto funziona bene?
Kimi K3 è particolarmente adatto a quelle che Moonshot chiama "scenari di intelligenza di frontiera", cioè programmazione su orizzonti lunghi, lavoro cognitivo e ragionamento.
A tal fine, supporta una finestra di contesto da 1 milione di token e una comprensione visiva nativa. Quest’ultimo aspetto significa che può ricevere immagini e video direttamente come input.
Gli aspetti più discussi sono in superficie: la finestra di contesto da 1 milione di token e la comprensione visiva nativa, che ho già menzionato.
Per arrivarci, Moonshot ha apportato modifiche al backend in tre aree:
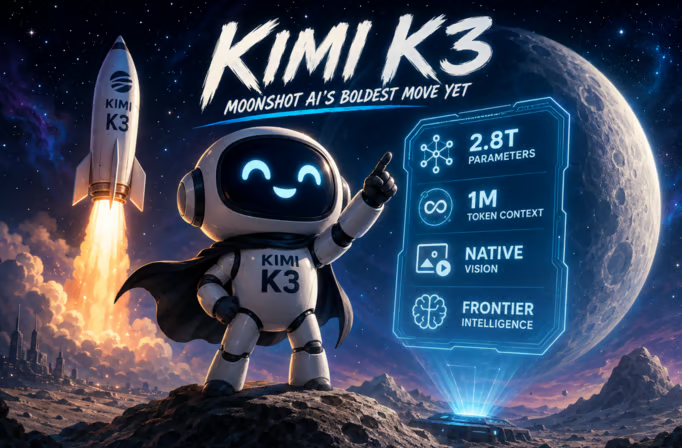
Il modello è costruito attorno a due nuovi componenti: Kimi Delta Attention (KDA), un meccanismo di attenzione lineare ibrido, e i cosiddetti Attention Residuals (AttnRes). Entrambi mirano a favorire una propagazione dell’informazione più affidabile su sequenze lunghe e reti profonde.
Inoltre, Moonshot ha spinto oltre la sparsità della configurazione Mixture-of-Experts con un framework "Stable LatentMoE", attivando una piccola frazione di esperti per passaggio forward. In combinazione con modifiche a training e dati, Moonshot afferma che questo conferisce a K3 un’efficienza di scaling circa 2,5 volte superiore al suo predecessore, K2.
Moonshot presenta K3 come forte nel lavoro di ingegneria a lungo orizzonte: sostenere task multi-step con supervisione minima, navigare codebase estese e coordinare strumenti da terminale.
Evidenzia anche una nicchia specifica — combinare programmazione e ragionamento visivo, ad esempio usando screenshot e feedback visivo per iterare su sviluppo di giochi, lavori di frontend o attività CAD. Ci sono molti esempi di sviluppo di giochi con Kimi K3, come un gioco ispirato a Paper Mario, un gioco di consegne in aereo e qualcosa che ricorda Halo.
Moonshot afferma che le sue valutazioni interne (basate su workflow reali di collaborazione agentica anziché su benchmark pubblici) mostrano guadagni costanti per la variante "max" di Kimi K3 su task di knowledge work in stile produzione.
In pratica, per chi usa il modello: documenti, codebase o video più lunghi possono essere passati come singolo input invece di essere suddivisi e riuniti, e la stessa richiesta può mescolare testo, immagini e video senza integrazioni aggiuntive.
Se si confermano, i guadagni di efficienza dovrebbero anche tradursi in più capacità per dollaro di compute rispetto a K2.
La documentazione dell’API offre un quadro più chiaro di cosa è cambiato per chi costruisce davvero con il modello:
Pensiero always-on: K3 è in thinking mode di default, configurato tramite un parametro di alto livello reasoning_effort invece del vecchio flag thinking della linea K2. Per ora è supportato solo il livello max.
Streaming con ragionamento separato: Le risposte in streaming espongono reasoning_content e il content della risposta finale come delta separati, così puoi mostrare o nascondere il pensiero del modello.
Input visivo, niente URL pubblici: Le immagini devono essere inviate come base64 o tramite un file caricato e referenziato; il modello non accetta URL di immagini in chiaro e i video sono gestiti con un caricamento file separato.
Output strutturato: È supportato l’output in JSON Schema con modalità strict, ma questo vincola solo il campo finale content, non la traccia di ragionamento.
Modalità parziale: Puoi preimpostare la risposta dell’assistente con un prefisso fisso e far continuare il modello da lì. Utile se vuoi imporre un’apertura specifica.
Caricamento dinamico degli strumenti: Le definizioni degli strumenti possono essere iniettate a conversazione in corso tramite un messaggio system, con effetto da quel punto in poi nella conversazione.
Caching del contesto automatico: Il caching è automatico e non richiede parametri extra.
Alcuni altri limiti da segnalare per chi integra l’API: max_completion_tokens predefinito a 131.072 e limite a 1.048.576, e parametri di campionamento come temperature e top_p sono fissi e non configurabili.
Kimi è anche ottimo per task di automazione del browser. Leggi di più nel nostro tutorial sull’estensione browser di Kimi.
I materiali di lancio di Moonshot includono ora numeri di benchmark reali, ma bisogna ricordare che i diversi modelli sono stati eseguiti con diversi agent harness. K3 è stato testato con il KimiCode di Moonshot; i modelli Claude con Claude Code o Terminus 2; i modelli GPT con Codex. Quindi non è un confronto pulito. Ogni laboratorio testa il proprio modello nei suoi strumenti ideali.
Ecco l’andamento in tre categorie.
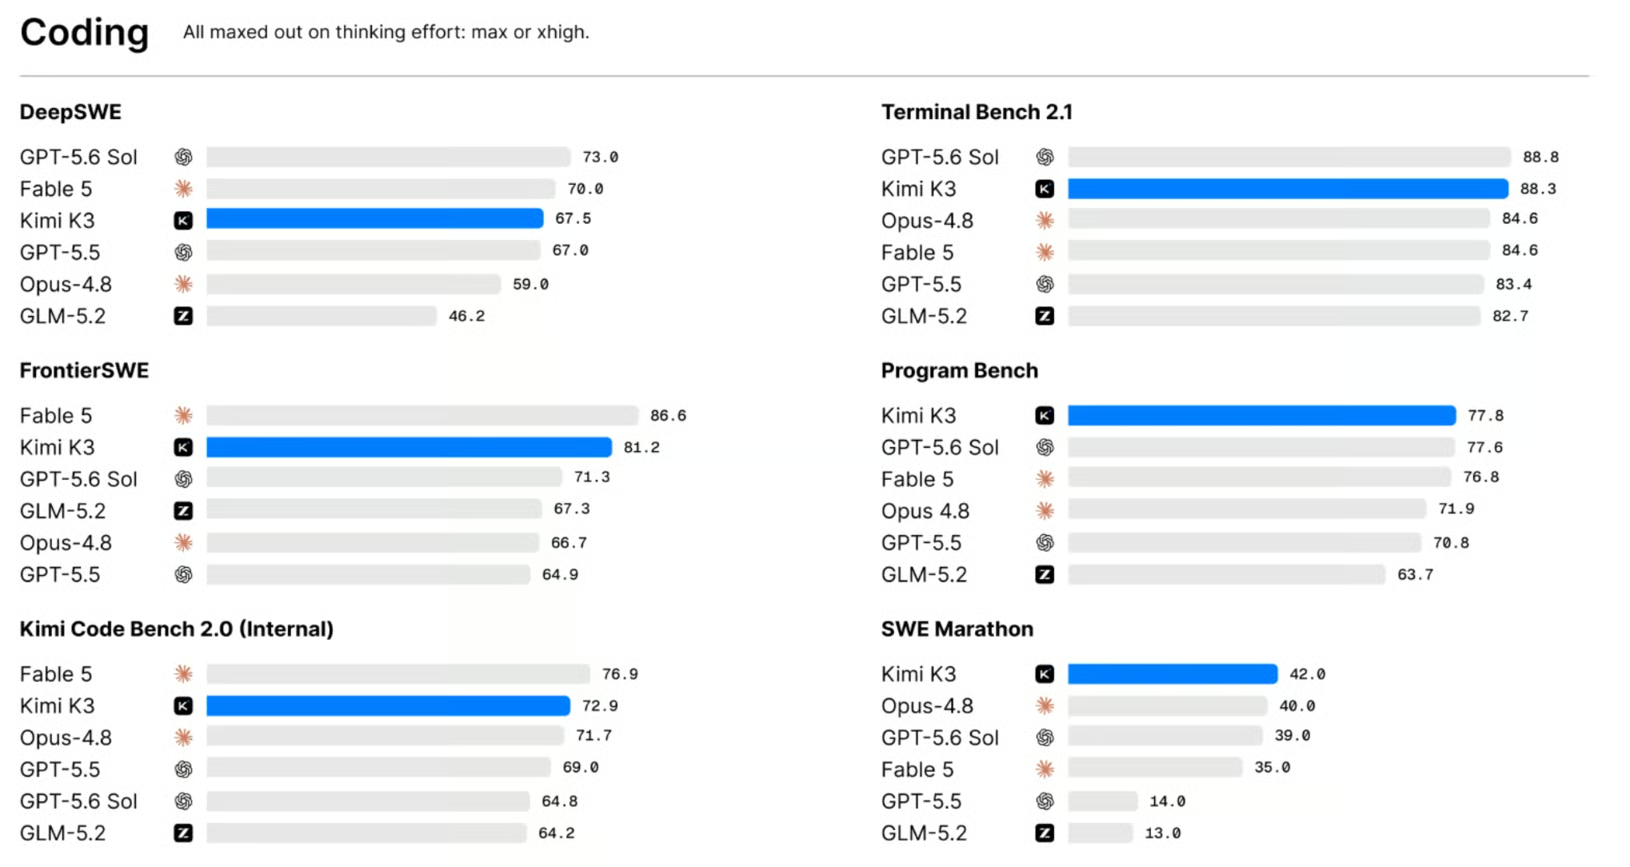
Come si vede nel grafico qui sotto, K3 non domina i benchmark di coding, ma è competitivo quasi ovunque. È in testa su Program Bench e SWE Marathon, arriva a mezzo punto da GPT-5.6 Sol su Terminal-Bench 2.1 e batte Opus 4.8 nella maggior parte dei test individuali. Dove perde chiaramente è su DeepSWE e FrontierSWE, dove Fable 5 e GPT-5.6 Sol prendono il largo.
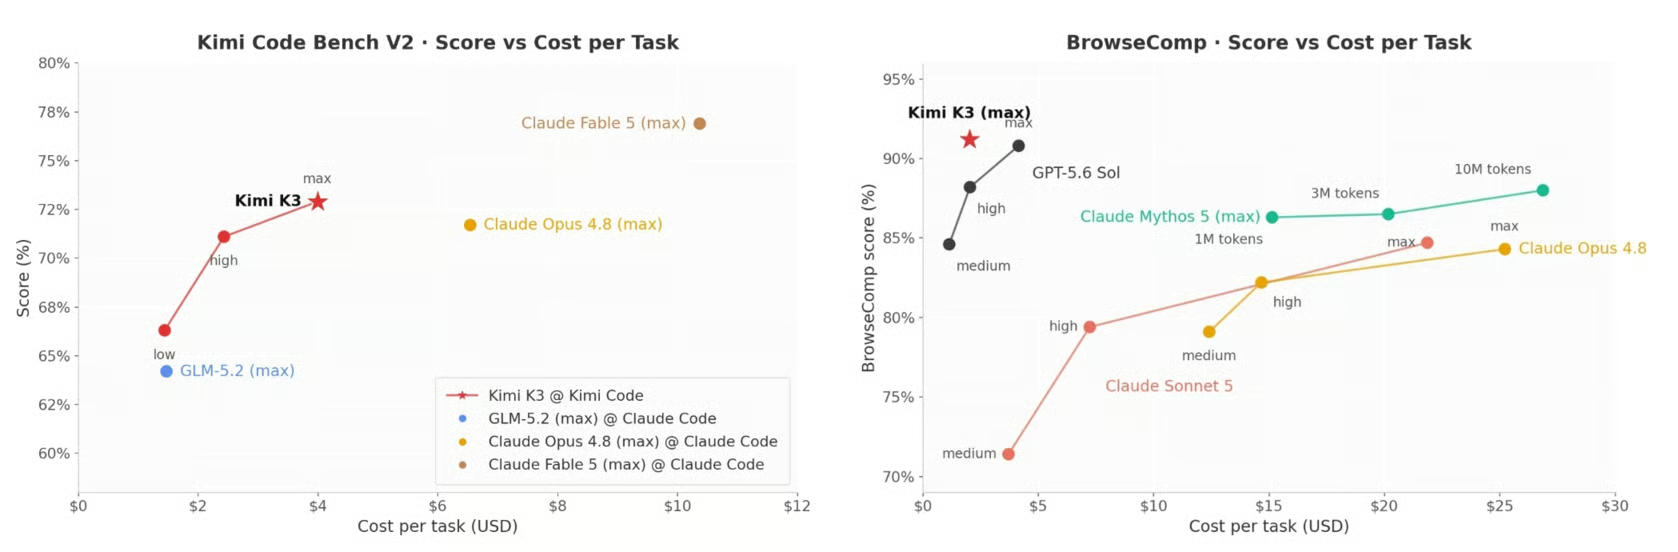
Nel grafico Kimi Code Bench V2 di Moonshot, K3 ottiene un punteggio simile a Opus 4.8 a circa metà del costo per task, lontano da quanto costa Fable 5 per pochi punti in più. Il grafico BrowseComp racconta una storia simile: K3 segna più di GPT-5.6 Sol e Claude Fable 5 costando una frazione per task.
Il grafico dei parametri del modello è interessante. È la visualizzazione più chiara dell’affermazione "il più grande modello open-weight" di cui sopra, e mostra il salto di Moonshot dai 1T parametri di Kimi K2 direttamente oltre DeepSeek, Xiaomi e tutti gli altri fino a 2,8T in un solo rilascio.
Ecco come Kimi K3 si confronta con gli altri laboratori cinesi che rilasciano modelli in questo momento. In sintesi, sembra che il campo open-weight cinese si stia dividendo in due: laboratori come DeepSeek e Z.AI competono ancora sul prezzo basso, mentre Moonshot inizia ad applicare prezzi più alti.
DeepSeek V4 è più piccolo di K3 ed è prezzato ben al di sotto.
K3 sta facendo una scommessa diversa: è più grande e Moonshot chiede di conseguenza, invece di cercare di vincere sul prezzo.
Questo confronto è interessante perché Alibaba sostiene sia Moonshot sia, naturalmente, la propria linea Qwen.
Sono però diversi: il modello di punta di Qwen, Qwen 3.7 Max, non è affatto open-weight. È chiuso, proprietario e utilizzabile solo tramite i prodotti Alibaba o host API di terze parti. Alibaba continua a rilasciare modelli Qwen open-weight più piccoli, ma il suo top di gamma è passato dietro a porte chiuse.
GLM-5.2 è più vicino all’approccio open-source cinese tradizionale: un modello davvero solido, con licenza MIT, e prezzato ben al di sotto delle tariffe occidentali da frontiera. È più piccolo di K3 e molto più economico, e si è guadagnato la reputazione di prestazioni di coding quasi da frontiera a una frazione del costo.
Ecco come si confrontano i numeri, usando come metro l’Intelligence Index di Artificial Analysis (un punteggio composito basato su nove benchmark, eseguiti nello stesso modo sui modelli):
| Model | Parameters | Release Date | Intelligence Index | Terminal-Bench 2.1 | Price ($/M in / out) | Open-weight? |
|---|---|---|---|---|---|---|
| DeepSeek V4 Pro | 1.6T (49B active) | Apr 24, 2026 | 44 | Not independently listed | $0.44 / $0.87 | Yes |
| Qwen 3.7 Max (Alibaba) | Undisclosed | May 20, 2026 | 56.6 | Not directly comparable | $2.50 / $7.50 | No — API only |
| GLM-5.2 (Z.AI) | 744B (40B active) | Jun 13, 2026 | 51 | 78 | $1.40 / $4.40 | Yes |
| Kimi K3 | 2.8T (16 of 896 experts active) | Jul 16, 2026 | 57 | 88.3 | $3.00 / $15.00 | Yes |
Un paio di cose da segnalare: Qwen 3.7 Max è incluso a titolo di riferimento, ma non è in realtà open-weight, come detto, quindi non è un vero pari in questo confronto; è però sembrato giusto includerlo in tabella come riferimento. Inoltre, le verifiche indipendenti di terze parti stanno ancora recuperando terreno per tutti, quindi nulla è definitivo.
Poi chiediamoci come si confronta Kimi K3 con i modelli chiusi e proprietari di Anthropic e OpenAI.
Opus 4.8 è stato il modello di punta di Anthropic per mesi e, secondo i numeri di Moonshot, K3 lo supera in diversi benchmark individuali, soprattutto nel coding. K3 segna 88,3 su Terminal-Bench 2.1 contro 84,6 di Opus 4.8.
La differenza più grande però è questa: Opus 4.8 è chiuso. K3 è open-weight, quindi, quando i pesi saranno effettivamente pubblicati, chiunque potrà auto-ospitarlo, fine-tunararlo o eseguirlo senza dipendere dai server di Moonshot.
Come si vede nei grafici qui sotto, K3 supera Opus 4.8 di un punto sull’Intelligence Index, ma il divario si allarga altrove: K3 costa circa la metà per task e risponde con il primo token circa 20 volte più velocemente.
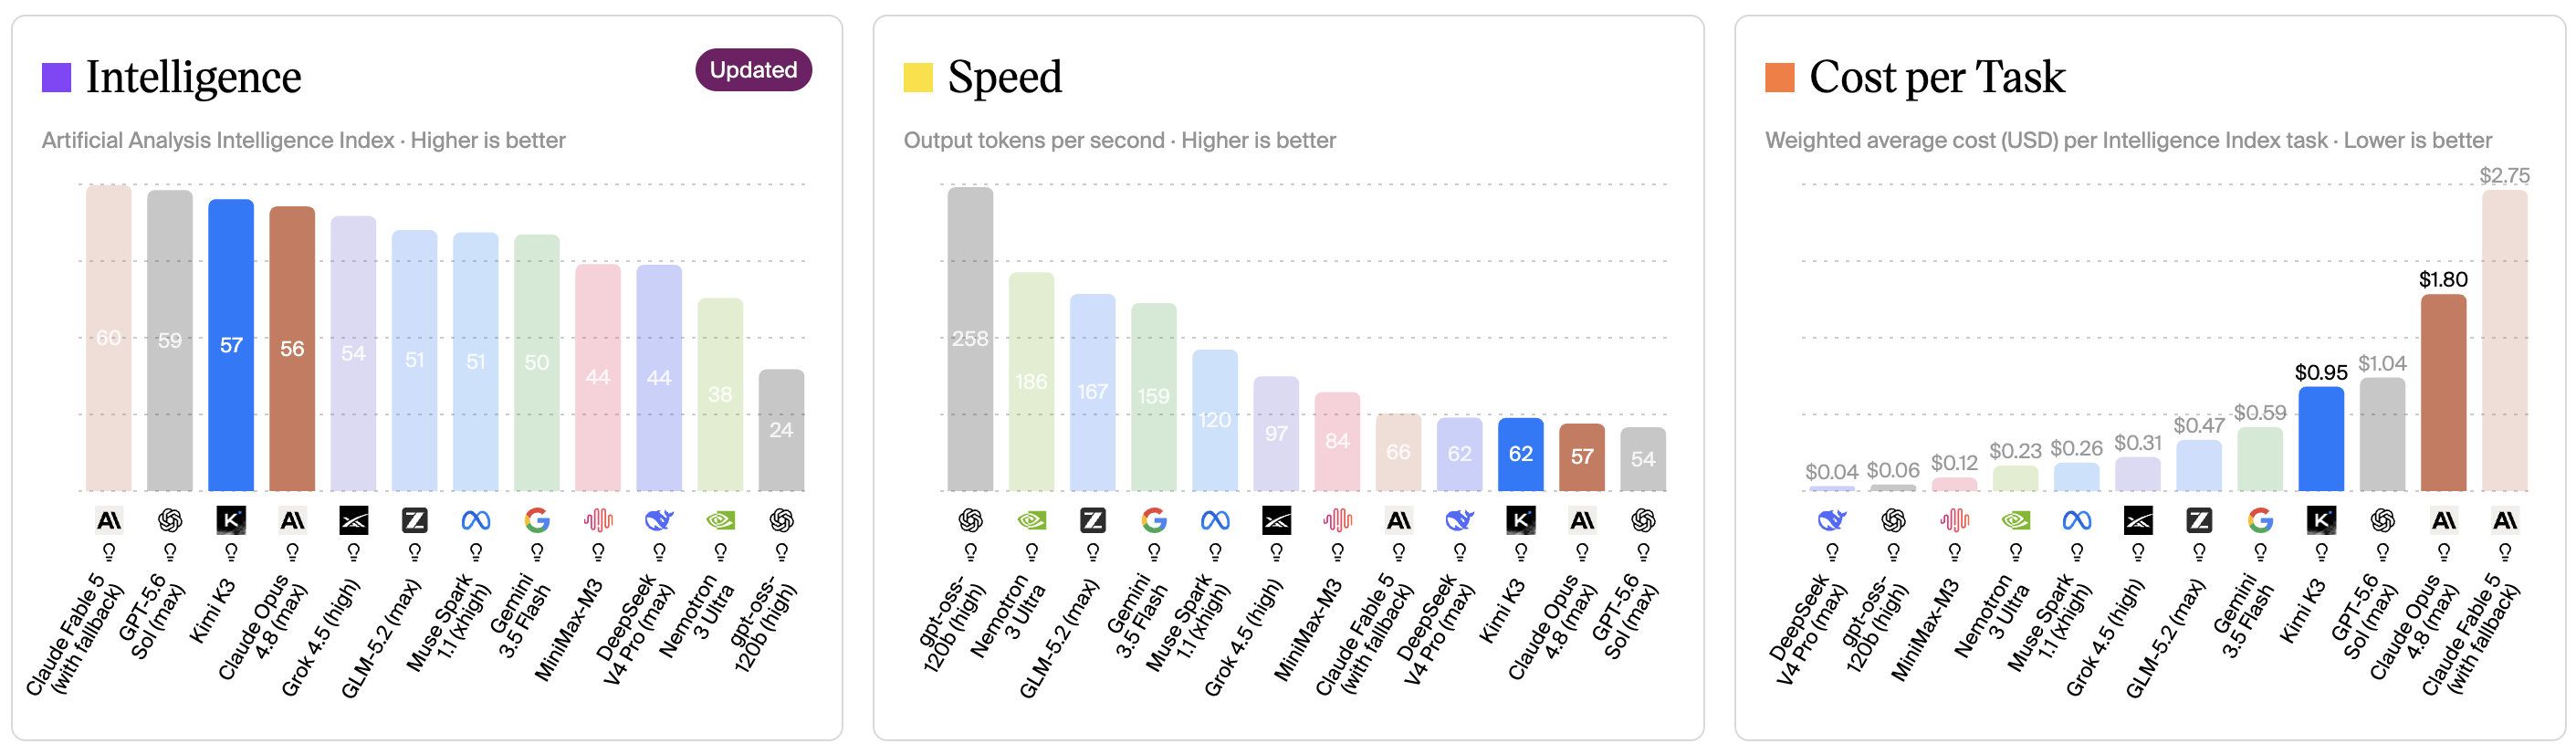
Fable 5 è il modello più recente e capace di Anthropic, ed è quello che K3 non raggiunge. È chiaramente in testa sull’intelligenza complessiva e costa molto di più da eseguire. Fable 5 è prezzato a $10/$50 per milione di token contro i $3/$15 di K3. Ma l’argomento di K3 qui non è "buono quanto Fable 5". È "quasi fino a lì, a una frazione del prezzo".
Come si vede nei grafici qui sotto, Fable 5 è comodamente in testa sull’Intelligence Index ed è anche leggermente più veloce di K3 sulla velocità di output pura. Dove K3 prevale è il costo. Funziona a circa un terzo del prezzo per task di Fable 5.
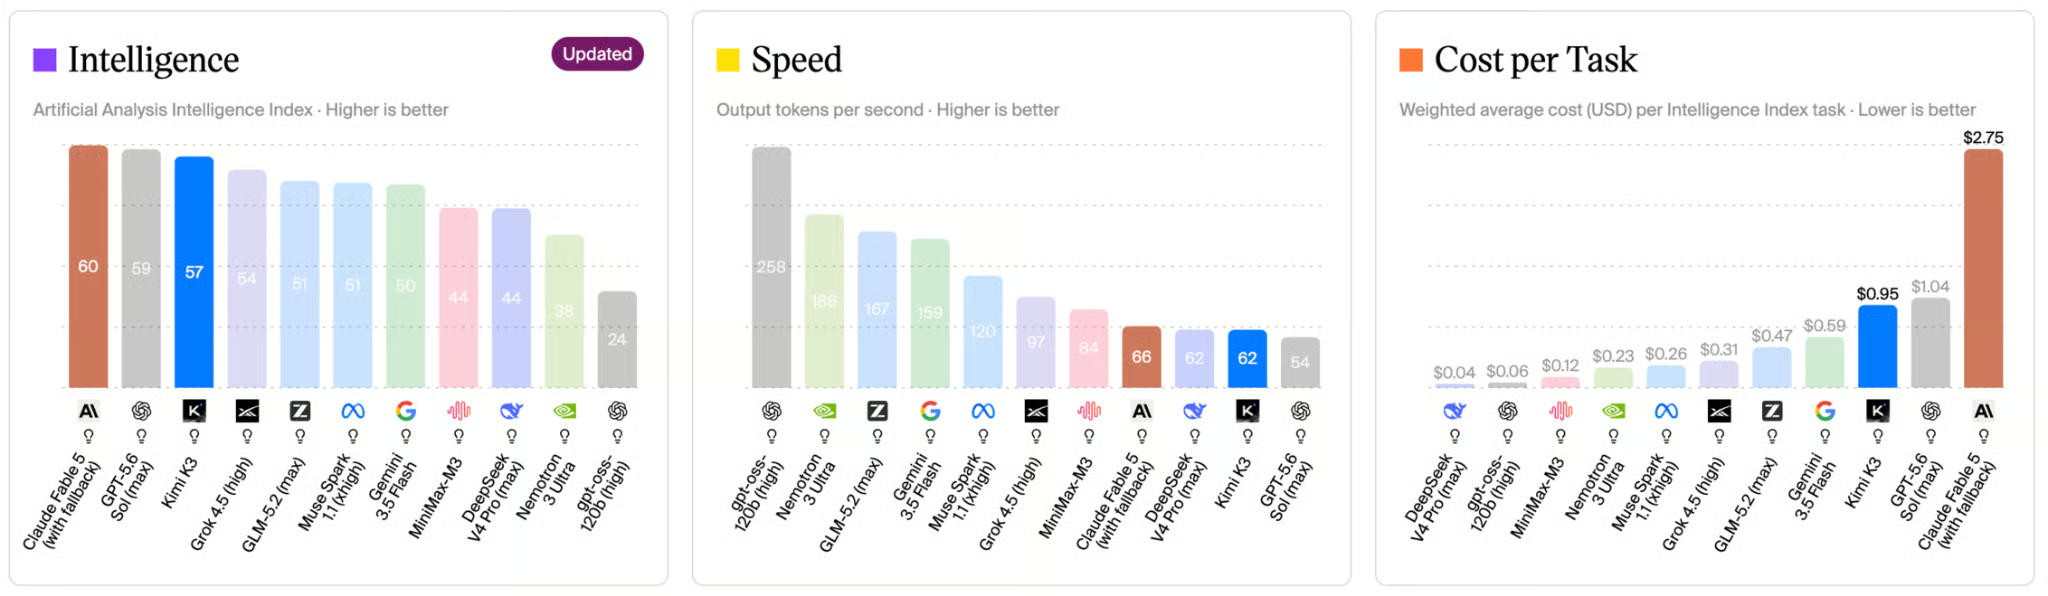
GPT-5.5 si colloca appena sotto K3 nei benchmark di Moonshot, ed è prezzato in linea con gli altri modelli di punta statunitensi e ben al di sopra della tariffa di K3.
Come si vede nei grafici qui sotto, K3 supera di poco GPT-5.5 sull’Intelligence Index e costa un po’ meno per task. GPT-5.5 genera in realtà i token un po’ più velocemente una volta avviato, quindi i due si bilanciano a seconda di quale dei tre aspetti ti interessa di più.
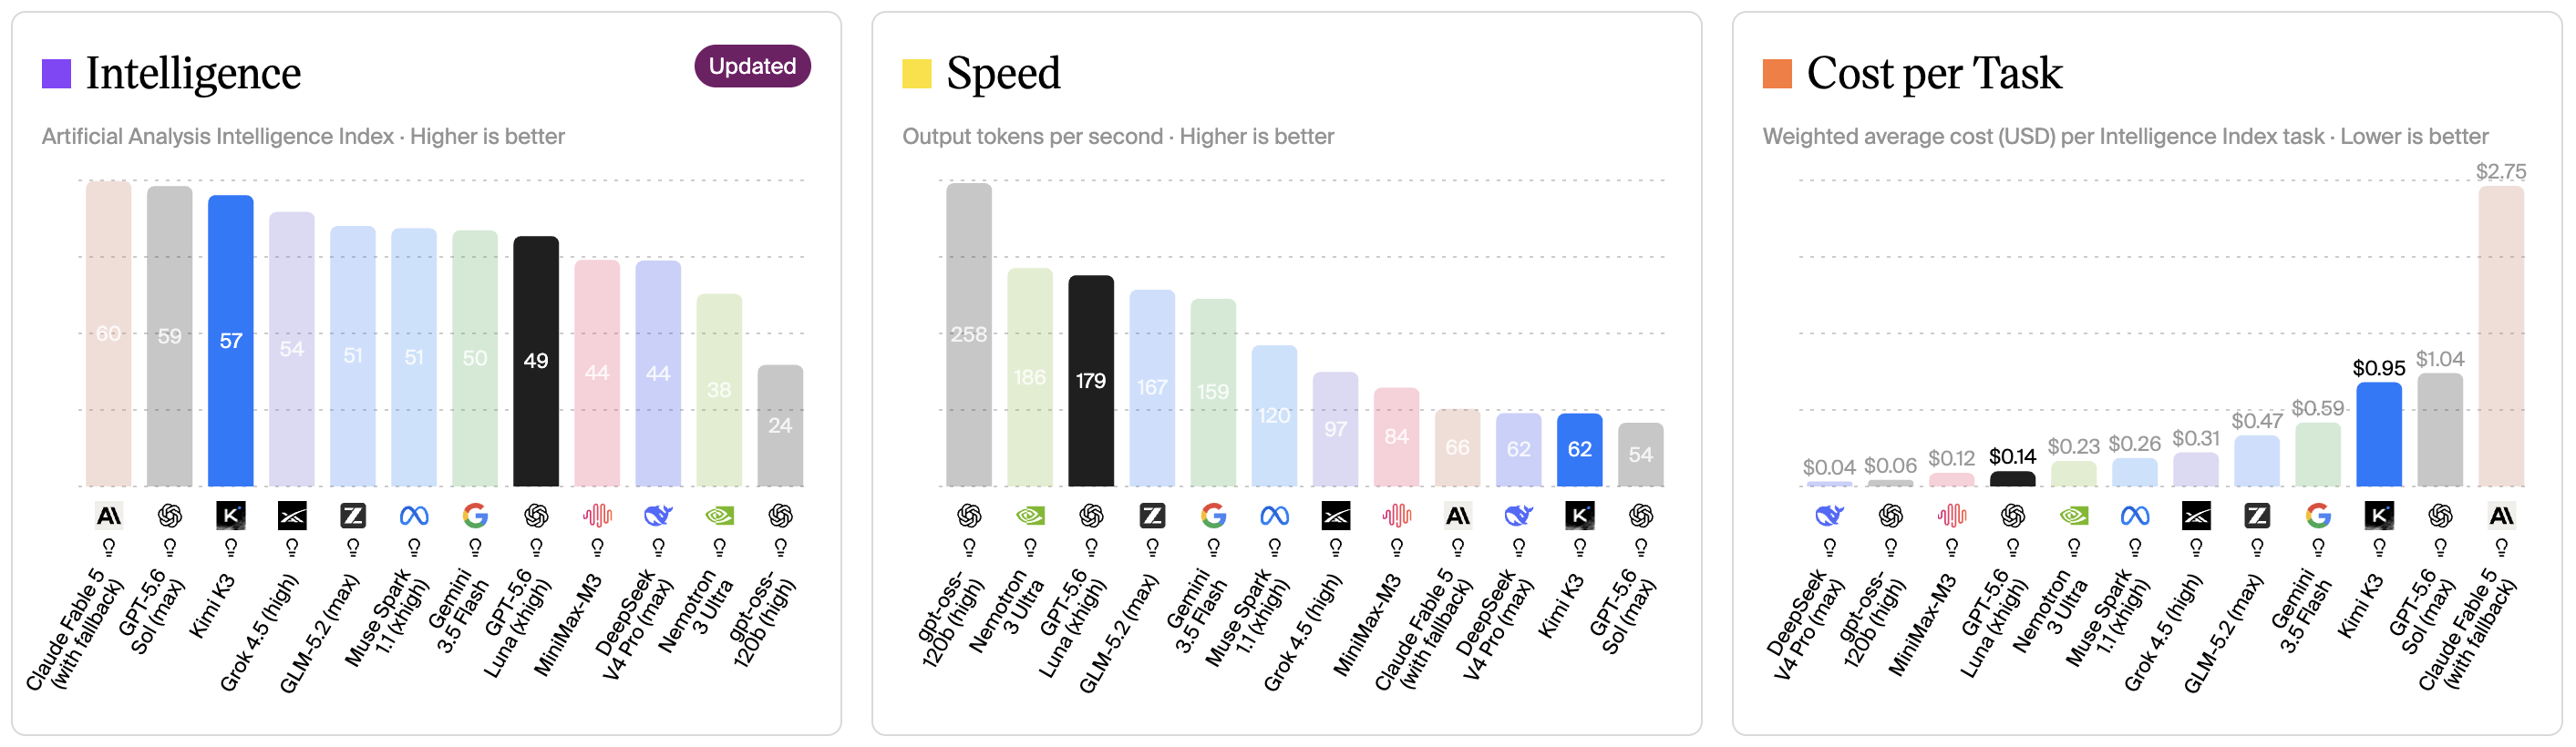
GPT-5.6 Sol è il modello più recente e costoso di OpenAI in questo confronto e, su Terminal-Bench 2.1, è sostanzialmente alla pari con K3. Sol segna 88,8 contro 88,3 di K3.
La differenza più grande è la stessa che con Opus 4.8: Sol è closed-weight, quindi puoi usarlo solo tramite i prodotti di OpenAI (ChatGPT, Codex, l’API), mentre K3 è open-weight. Quando i pesi saranno pubblicati, chiunque potrà auto-ospitarlo o fine-tunararlo.
Come si vede nei grafici qui sotto, Sol supera K3 sull’Intelligence Index, ma K3 prevale su velocità e costo.
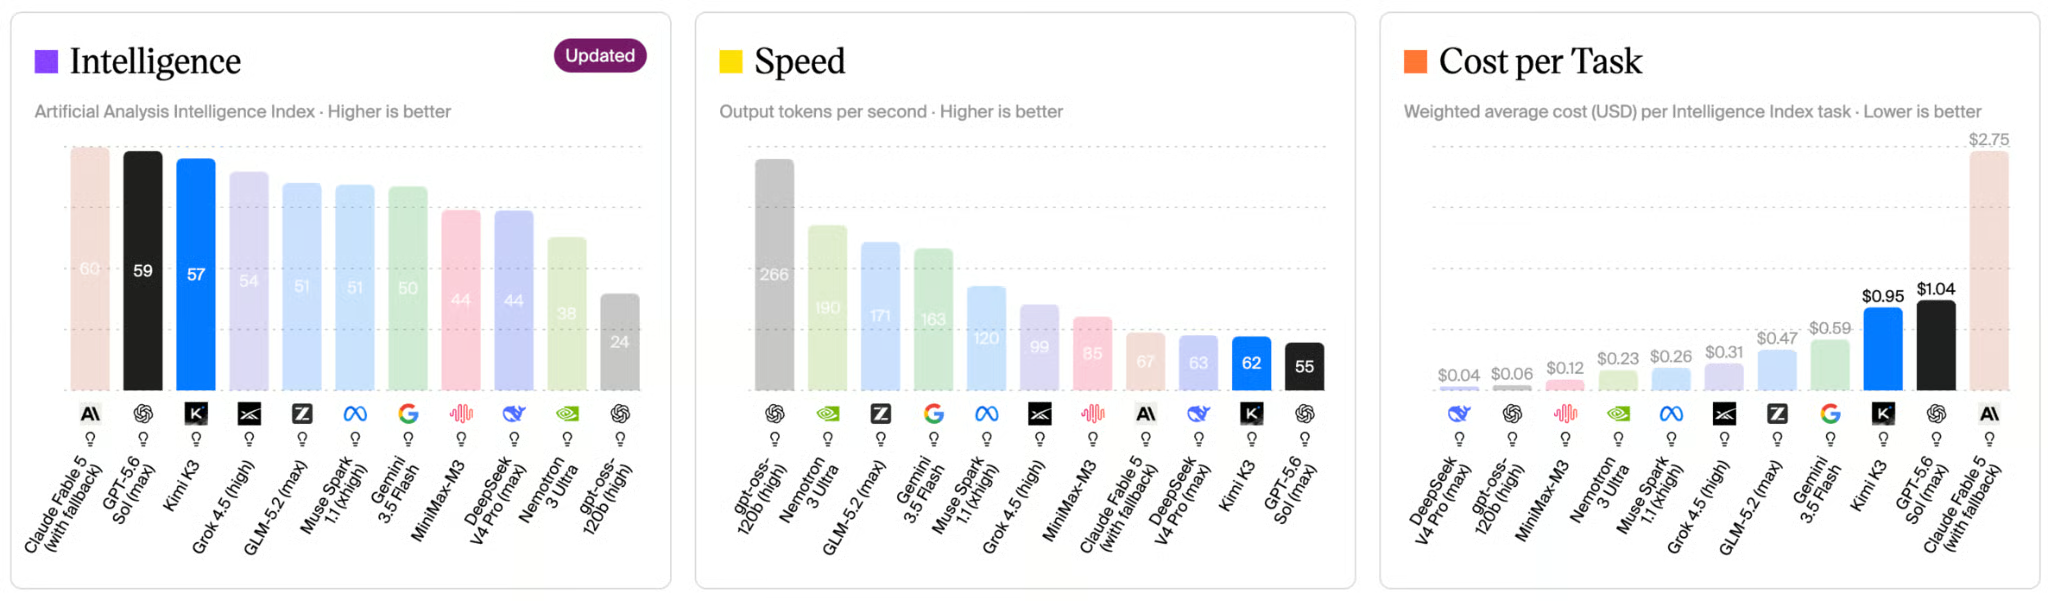
Kimi K3 è già disponibile, anche se non completamente. Il modello è stato lanciato ieri ed è già utilizzabile oggi tramite kimi.com, le app mobili Kimi, Kimi Work, Kimi Code e la Kimi API con ID modello kimi-k3. Sta anche iniziando ad apparire su router di terze parti come OpenRouter e OrcaRouter.
Quello che non è ancora disponibile sono i pesi open. Moonshot afferma che saranno rilasciati entro il 27 luglio 2026, mentre l’azienda continua a collaborare con partner di inference e maintainer open-source per allineare i dettagli tecnici. Fino ad allora, puoi usare K3 tramite i servizi ospitati da Moonshot, ma non puoi scaricarlo e auto-ospitarlo.
Ti consigliamo di iscriverti alla nostra newsletter settimanale sull’AI, The Median, un ottimo modo per restare aggiornato sui rilasci di modelli come questo.
Per i prezzi, K3 utilizza fatturazione pay-as-you-go piatta invece del tiering per lunghezza del contesto, nonostante la finestra da 1M token. Le tariffe ufficiali di Moonshot sono $0,30 per milione di token per input con cache hit, $3,00 per milione di token per input con cache miss e $15,00 per milione di token per l’output — con un tasso di cache hit superiore al 90% riportato per tipici workload di coding, che riduce il costo input effettivo nella pratica.
Moonshot è trasparente, nel proprio blog tecnico, sulle limitazioni:
Kimi K3 è il più grande modello open-weight rilasciato finora. Ha una nuova architettura di attenzione mirata proprio a contesti lunghi e workload agentici. Sui benchmark ora pubblici, non è il vincitore assoluto — Fable 5 e GPT-5.6 Sol lo superano — ma è estremamente competitivo su task di coding, agentici e multimodali a una frazione del costo.
Questo è il filo conduttore dell’articolo: K3 non cerca di vincere ogni categoria. Cerca di rendere il trade-off prezzo/capacità impossibile da ignorare, proprio come ha fatto DeepSeek con R1 e più recentemente GLM-5.2 — solo che questa volta Moonshot applica tariffe da frontiera, non sconti.
Impara l'AI con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min