Kursus
Konsep LLMOps
1 jam
19.9K
Moonshot AI telah mengumumkan Kimi K3, flagship terbaru dalam lini model Kimi dan model open-weight terbesar yang dirilis sejauh ini (2,8 triliun parameter). Bobot penuh belum dirilis. Moonshot mengatakan bobot tersebut akan dirilis dalam sepuluh hari.
Namun, jumlah parameter bukanlah inti ceritanya. Moonshot adalah startup yang berbasis di Beijing dan didukung oleh Alibaba (yang juga membuat model Qwen, jika Anda ingat, dengan Qwen 3.7 sebagai yang terbaru), dan perusahaan ini berjuang untuk relevansi saat DeepSeek dan lab Tiongkok lainnya semakin ramai di bidang ini.
Dari sisi skala, K3 kira-kira 75% lebih besar daripada DeepSeek V4. Pada tolok ukur internal Moonshot, K3 mengungguli Claude Opus 4.8 dan GPT-5.5, meski masih di belakang Claude Fable 5 dan GPT-5.6 Sol.
Namun, harga adalah sinyal yang sebenarnya. K3 mematok tarif frontier. Inilah masalah bagi lab AS: Jika model dari Tiongkok dapat mengenakan harga yang sama dan berkinerja mendekati level yang sama, hal itu melemahkan gagasan bahwa harga premiumlah yang membedakan model-model AS.
Kami sudah menyinggung sedikit tentang harga dan sejarah. Tetapi apa yang kita ketahui tentang Kimi K3, bagaimana model ini dibangun, dan seberapa baik kinerjanya?
Kimi K3 diposisikan khusus untuk apa yang disebut Moonshot sebagai "skenario intelijen frontier," yakni coding jarak-panjang, pekerjaan berbasis pengetahuan, dan penalaran.
Untuk itu, K3 mendukung jendela konteks 1 juta token dan pemahaman visual native. Bagian kedua berarti model ini dapat menerima gambar dan video langsung sebagai input.
Yang paling banyak dibicarakan ada di permukaan: jendela konteks 1 juta token dan pemahaman visual native, seperti yang saya sebutkan.
Untuk mencapainya, Moonshot melakukan perubahan backend di tiga area:
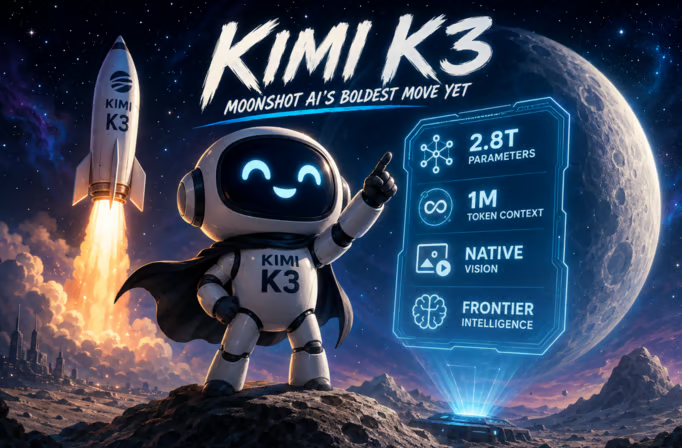
Model ini dibangun di sekitar dua komponen baru: Kimi Delta Attention (KDA), mekanisme atensi linear hibrida, dan sesuatu yang disebut Attention Residuals (AttnRes). Keduanya ditujukan untuk membantu informasi menyebar lebih andal melalui sekuens panjang dan jaringan dalam.
Di atas itu, Moonshot mendorong sparsitas pada setup Mixture-of-Experts-nya lebih jauh dengan kerangka kerja "Stable LatentMoE", mengaktifkan sebagian kecil expert per forward pass. Dikombinasikan dengan perubahan pelatihan dan data, Moonshot mengklaim ini memberi K3 efisiensi skala sekitar 2,5x dari pendahulunya, K2.
Moonshot memposisikan K3 sebagai kuat untuk pekerjaan rekayasa jangka panjang: mempertahankan tugas multi-langkah dengan supervisi minimal, menavigasi codebase besar, dan mengoordinasikan alat terminal.
Moonshot juga menyoroti ceruk spesifik — menggabungkan coding dengan penalaran visual, seperti menggunakan tangkapan layar dan umpan balik visual untuk iterasi pengembangan gim, pekerjaan frontend, atau tugas CAD. Ada banyak contoh pengembangan gim Kimi K3, seperti gim terinspirasi Paper Mario, gim pengantaran pesawat, dan sesuatu yang mirip Halo.
Moonshot mengatakan evaluasi internalnya (dibangun dari alur kerja kolaborasi agen nyata alih-alih tolok ukur publik) menunjukkan peningkatan konsisten untuk varian "max" Kimi K3 di seluruh tugas kerja pengetahuan bergaya produksi.
Dampaknya bagi siapa pun yang benar-benar menggunakan model ini: dokumen, codebase, atau video yang lebih panjang dapat dimasukkan sebagai satu input alih-alih dipotong-potong dan disatukan kembali, dan permintaan yang sama dapat mencampur teks, gambar, dan video tanpa tambahan integrasi.
Jika peningkatan efisiensi tersebut terbukti, ini juga berarti lebih banyak kapabilitas per dolar komputasi dibanding K2.
Dokumentasi API memberi gambaran lebih jelas tentang apa yang berubah bagi orang-orang yang benar-benar membangun dengan model ini:
Thinking selalu aktif: K3 berjalan dalam mode thinking secara default, dikonfigurasi melalui parameter tingkat atas reasoning_effort alih-alih flag thinking yang lebih lama dari lini K2. Untuk saat ini, hanya level max yang didukung.
Streaming dengan penalaran terpisah: Respons streaming mengekspos reasoning_content dan content jawaban akhir sebagai delta terpisah, sehingga Anda dapat menampilkan atau menyembunyikan proses berpikir model.
Input visi, tanpa URL publik: Gambar harus dikirim sebagai base64 atau melalui referensi file yang diunggah; model tidak menerima URL gambar biasa, dan video ditangani melalui unggahan file terpisah.
Output terstruktur: Output JSON Schema didukung dengan mode strict, tetapi ini hanya membatasi field content akhir, bukan jejak penalaran.
Mode parsial: Anda dapat memberi awalan tetap pada balasan asisten dan membiarkan model melanjutkan dari sana. Ini berguna jika Anda ingin memaksakan pembukaan tertentu.
Pemuatan alat dinamis: Definisi alat dapat disuntikkan di tengah percakapan melalui pesan system, dan akan berlaku sejak titik tersebut dalam percakapan.
Caching konteks otomatis: Caching bersifat otomatis dan tidak memerlukan parameter tambahan.
Beberapa batasan lain yang perlu dicatat bagi siapa pun yang mengintegrasikan API: max_completion_tokens default ke 131.072 dan dibatasi hingga 1.048.576, dan parameter sampling seperti temperature dan top_p bersifat tetap dan tidak dapat dikonfigurasi.
Kimi juga unggul untuk tugas otomatisasi peramban. Baca selengkapnya di tutorial ekstensi peramban Kimi kami.
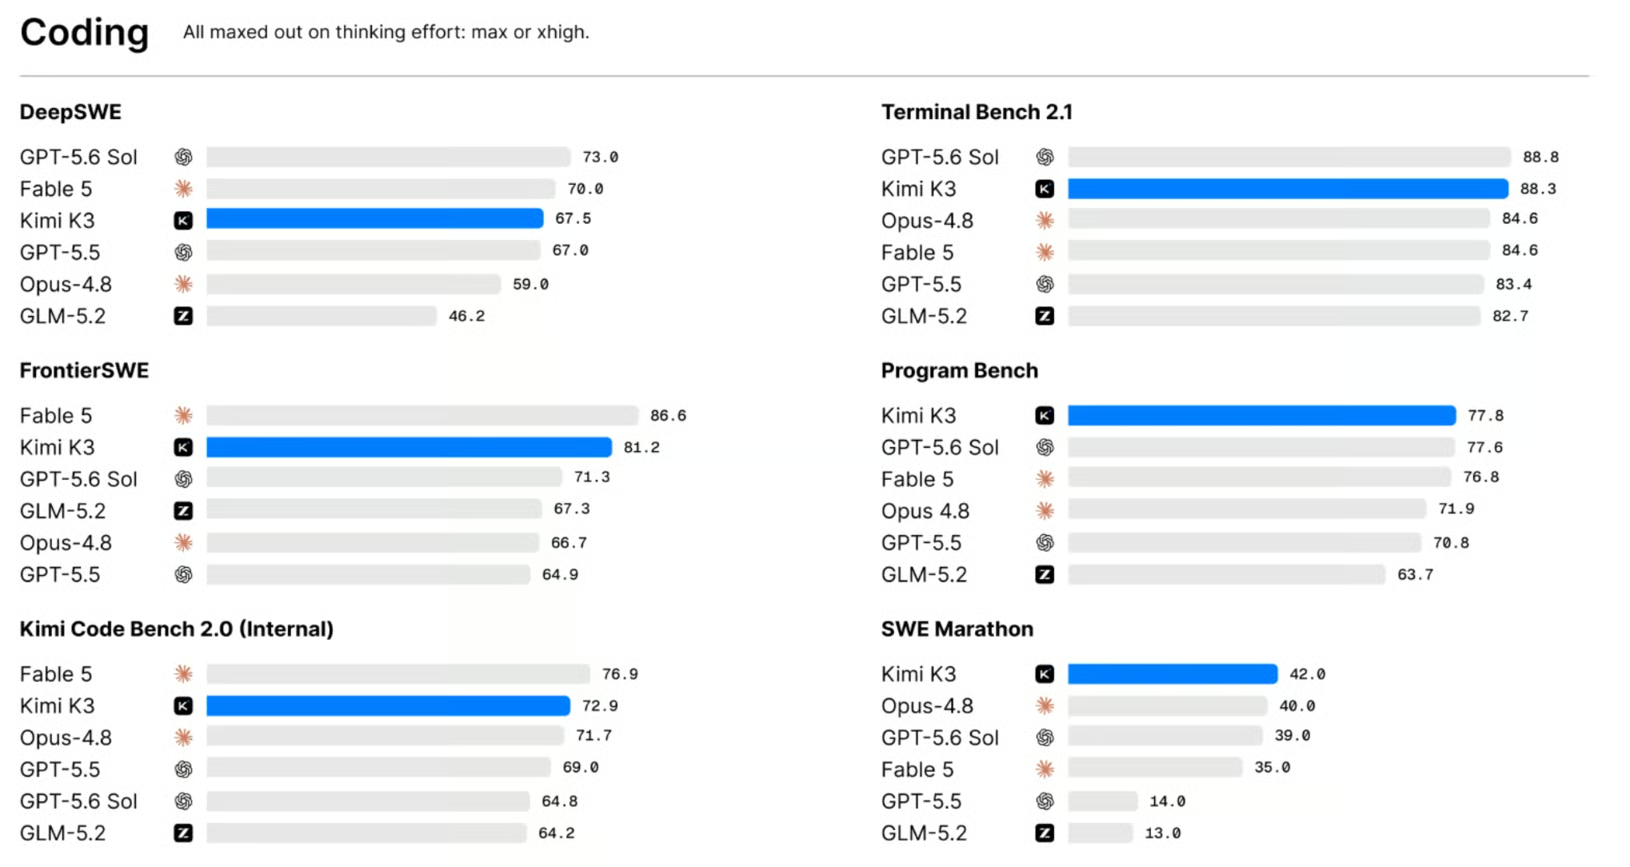
Materi peluncuran Moonshot kini mencakup angka tolok ukur nyata, tetapi kita harus ingat model yang berbeda dijalankan melalui kerangka agen yang berbeda. K3 diuji dengan KimiCode milik Moonshot; model Claude dijalankan melalui Claude Code atau Terminus 2; model GPT dijalankan melalui Codex. Jadi ini bukan perbandingan yang bersih. Model tiap lab diuji dalam perkakas terbaik versi mereka sendiri.
Berikut gambaran umumnya di tiga kategori.
Seperti terlihat pada grafik di bawah, K3 tidak menyapu bersih tolok ukur pemrograman, tetapi kompetitif hampir di semua tempat. K3 memimpin di Program Bench dan SWE Marathon, hanya terpaut setengah poin dari GPT-5.6 Sol pada Terminal-Bench 2.1, dan mengungguli Opus 4.8 pada sebagian besar pengujian individual. Di mana K3 jelas kalah adalah DeepSWE dan FrontierSWE, tempat Fable 5 dan GPT-5.6 Sol unggul.
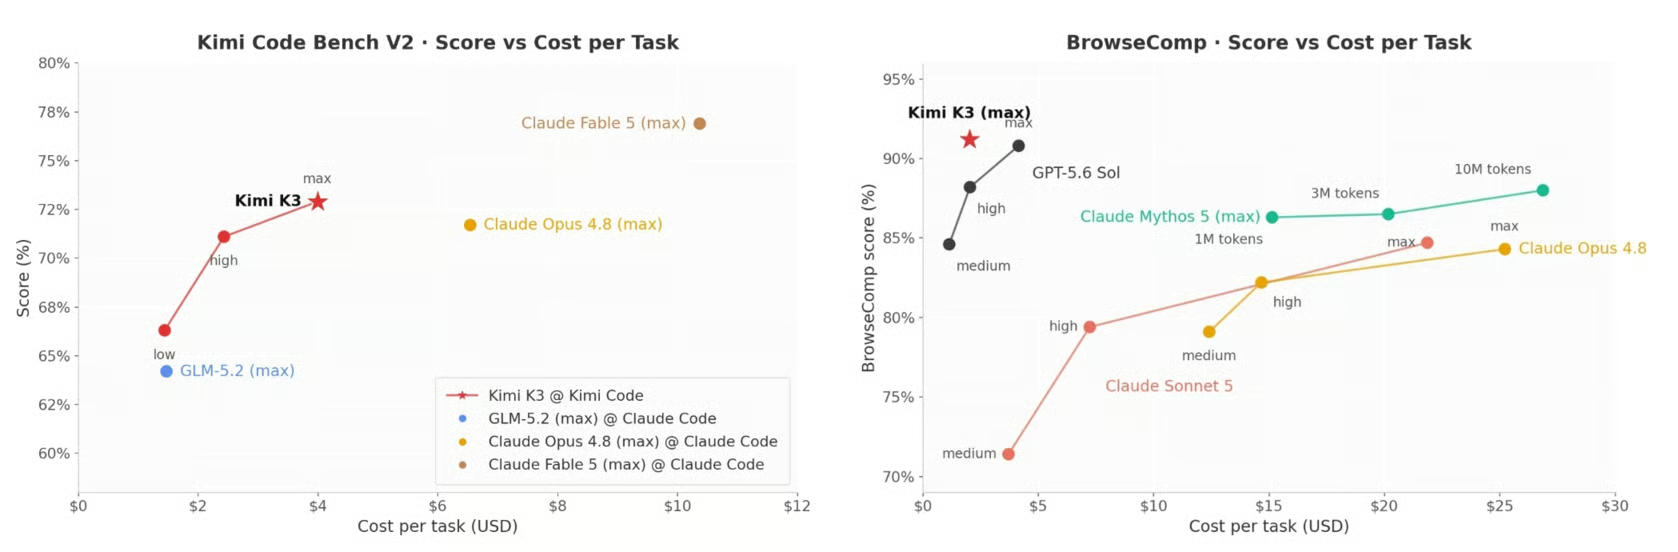
Pada grafik Kimi Code Bench V2 milik Moonshot, K3 meraih skor serupa dengan Opus 4.8 pada kira-kira setengah biaya per tugas, dan jauh lebih murah dibanding Fable 5 untuk beberapa poin tambahan. Grafik BrowseComp bercerita serupa: K3 meraih skor lebih tinggi daripada GPT-5.6 Sol dan Claude Fable 5 sambil berbiaya sebagian kecil per tugas.
Grafik jumlah parameter model menarik untuk dilihat. Ini adalah visual paling jelas dari klaim "model open-weight terbesar" yang disebutkan sebelumnya, memperlihatkan Moonshot melompat dari 1T parameter Kimi K2 melewati DeepSeek, Xiaomi, dan lainnya ke 2,8T dalam satu rilis.
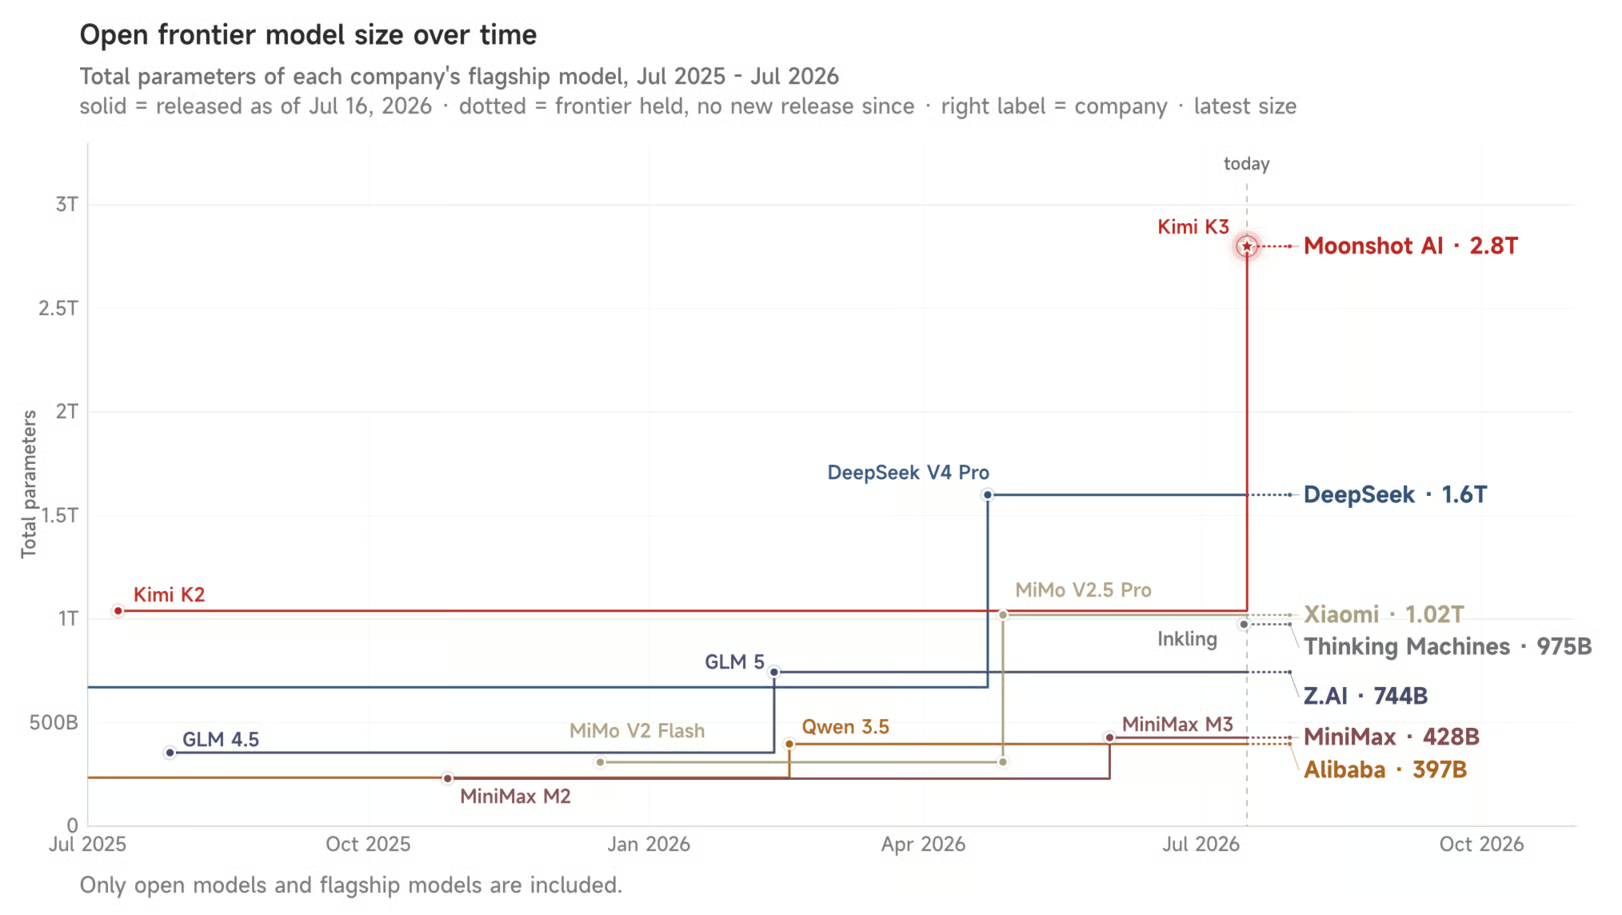
Berikut perbandingan Kimi K3 dengan lab Tiongkok lain yang saat ini merilis model. Secara garis besar, bidang open-weight Tiongkok tampak terbelah dua: lab seperti DeepSeek dan Z.AI masih bersaing di harga murah, sementara Moonshot mulai mematok harga lebih tinggi.
DeepSeek V4 hadir lebih kecil dari K3 dan harganya jauh di bawahnya.
K3 mengambil taruhan berbeda: ukurannya lebih besar, dan Moonshot membanderolnya sesuai alih-alih mencoba menang di harga.
Perbandingan ini menarik karena Alibaba mendukung baik Moonshot maupun tentu saja lini Qwen miliknya.
Namun keduanya berbeda: flagship Qwen, Qwen 3.7 Max, sama sekali bukan open-weight. Model ini tertutup, proprietari, dan hanya dapat digunakan melalui produk Alibaba atau host API pihak ketiga. Alibaba terus merilis model Qwen open-weight yang lebih kecil, tetapi model kelas teratasnya dipindahkan ke balik pintu tertutup.
GLM-5.2 lebih dekat dengan pendekatan open-source Tiongkok lama: model yang benar-benar kuat, berlisensi MIT, dan harganya jauh di bawah tarif frontier Barat. Model ini lebih kecil daripada K3 dan jauh lebih murah, serta mendapatkan reputasi memiliki kinerja coding mendekati frontier dengan sebagian kecil biaya.
Berikut perbandingan angkanya, menggunakan Intelligence Index dari Artificial Analysis (skor komposit dari sembilan tolok ukur, dijalankan dengan cara yang sama di seluruh model) sebagai patokan:
| Model | Parameter | Tanggal Rilis | Indeks Kecerdasan | Terminal-Bench 2.1 | Harga ($/Jt in / out) | Open-weight? |
|---|---|---|---|---|---|---|
| DeepSeek V4 Pro | 1,6T (49B aktif) | 1 Apr 2026 | 44 | Tidak tercantum secara independen | $0,44 / $0,87 | Ya |
| Qwen 3.7 Max (Alibaba) | Tidak diungkap | 20 Mei 2026 | 56,6 | Tidak langsung sebanding | $2,50 / $7,50 | Tidak — hanya API |
| GLM-5.2 (Z.AI) | 744B (40B aktif) | 13 Jun 2026 | 51 | 78 | $1,40 / $4,40 | Ya |
| Kimi K3 | 2,8T (16 dari 896 expert aktif) | 16 Jul 2026 | 57 | 88,3 | $3,00 / $15,00 | Ya |
Beberapa hal yang perlu dicatat: Qwen 3.7 Max disertakan sebagai referensi, tetapi seperti yang saya katakan, model ini sebenarnya bukan open-weight, sehingga bukan benar-benar setara dalam perbandingan ini, namun rasanya tepat untuk tetap memasukkannya sebagai referensi. Selain itu, verifikasi independen dari pihak ketiga masih menyusul di semua sisi, jadi belum ada yang final.
Selanjutnya, mari kita lihat bagaimana Kimi K3 dibandingkan dengan model tertutup dan proprietari dari Anthropic dan OpenAI.
Opus 4.8 telah menjadi flagship Anthropic selama berbulan-bulan, dan menurut angka Moonshot, K3 sedikit unggul pada beberapa tolok ukur individual, khususnya pemrograman. K3 meraih 88,3 pada Terminal-Bench 2.1 berbanding 84,6 untuk Opus 4.8.
Namun perbedaan besarnya adalah ini: Opus 4.8 bersifat tertutup. K3 adalah open-weight, jadi setelah bobot benar-benar dirilis, siapa pun dapat melakukan self-hosting, fine-tuning, atau menjalankannya tanpa bergantung pada server Moonshot.
Seperti terlihat pada grafik di bawah, K3 unggul satu poin dari Opus 4.8 pada Intelligence Index, tetapi jaraknya melebar di tempat lain: K3 berbiaya sekitar separuh per tugas dan merespons token pertama kira-kira 20x lebih cepat.
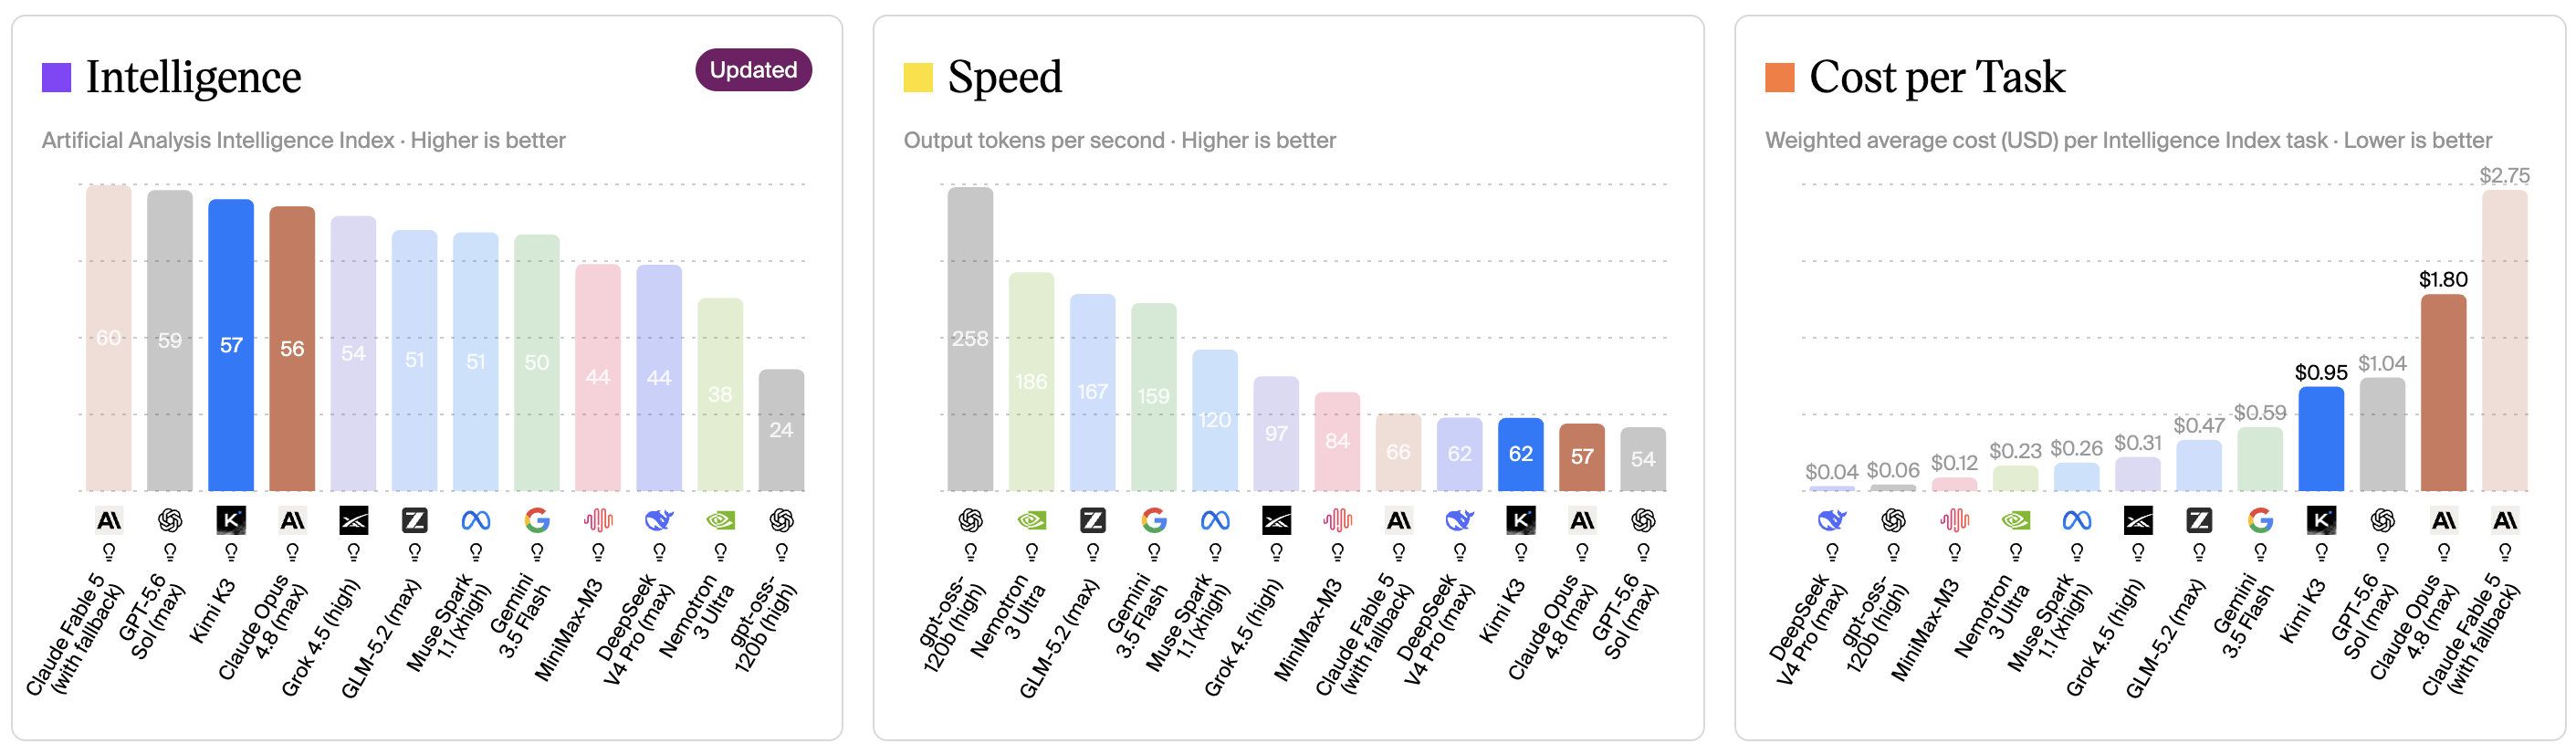
Fable 5 adalah model terbaru dan paling kapabel dari Anthropic, dan inilah yang tidak terkejar oleh K3. Fable 5 memimpin jelas pada kecerdasan keseluruhan, dan biayanya jauh lebih tinggi untuk dijalankan. Fable 5 dihargai $10/$50 per juta token dibanding $3/$15 pada K3. Namun, pitch K3 di sini bukanlah "setara Fable 5." Melainkan "mendekati, dengan sebagian kecil biaya."
Seperti terlihat pada grafik di bawah, Fable 5 memimpin nyaman pada Intelligence Index, dan bahkan sedikit lebih cepat dari K3 dalam kecepatan output mentah. K3 unggul dari sisi biaya. Biayanya sekitar sepertiga harga per tugas Fable 5.
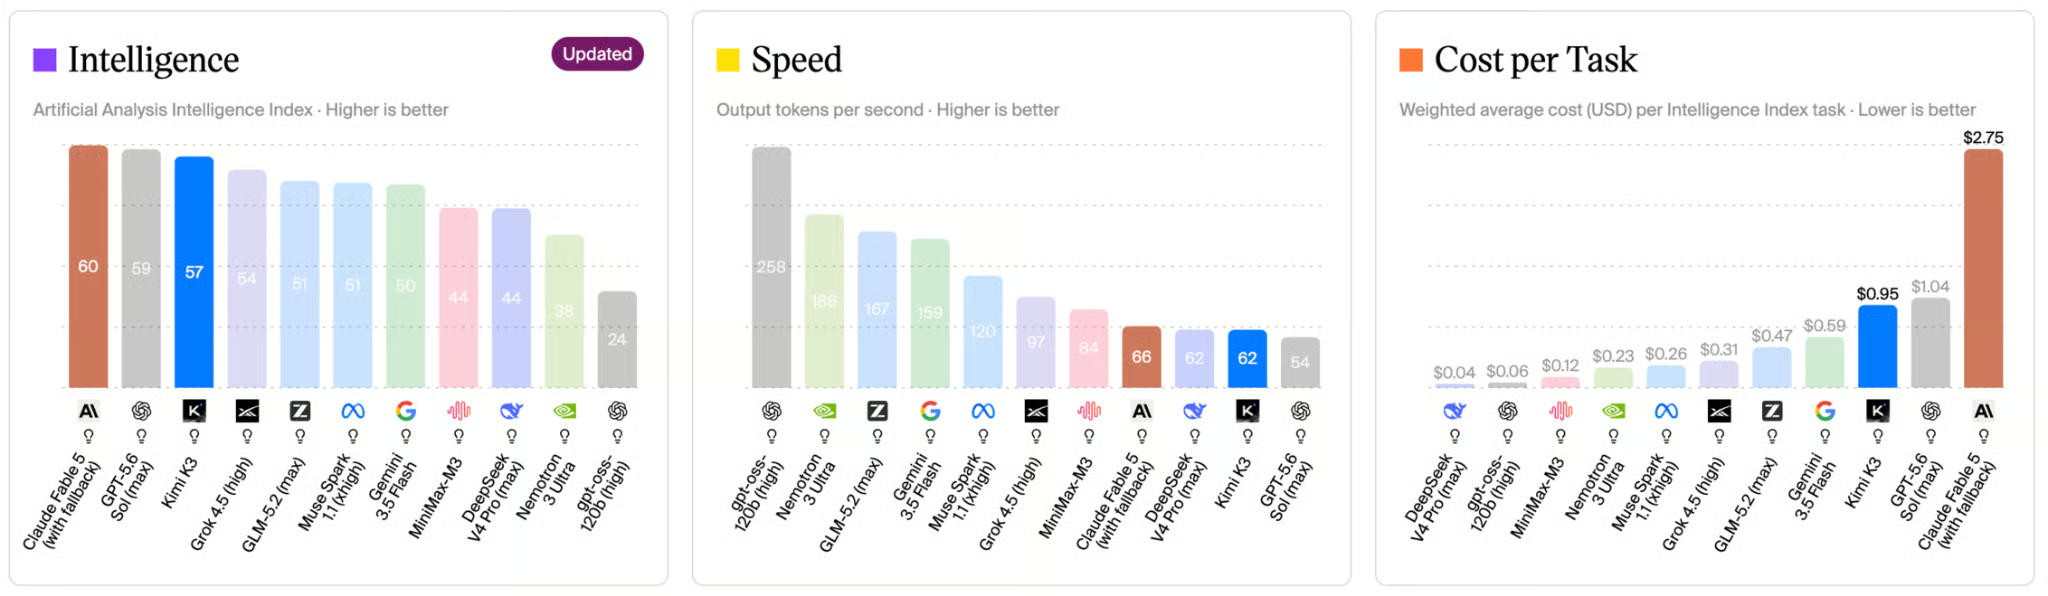
GPT-5.5 berada tepat di bawah K3 pada tolok ukur Moonshot, dan harganya berada di kisaran serupa dengan flagship AS lainnya dan jauh di atas tarif K3.
Seperti terlihat pada grafik di bawah, K3 sedikit mengungguli GPT-5.5 pada Intelligence Index dan berbiaya sedikit lebih rendah per tugas. GPT-5.5 sebenarnya menghasilkan token sedikit lebih cepat setelah berjalan, jadi keduanya saling tukar tergantung mana dari tiga hal itu yang paling penting bagi Anda.
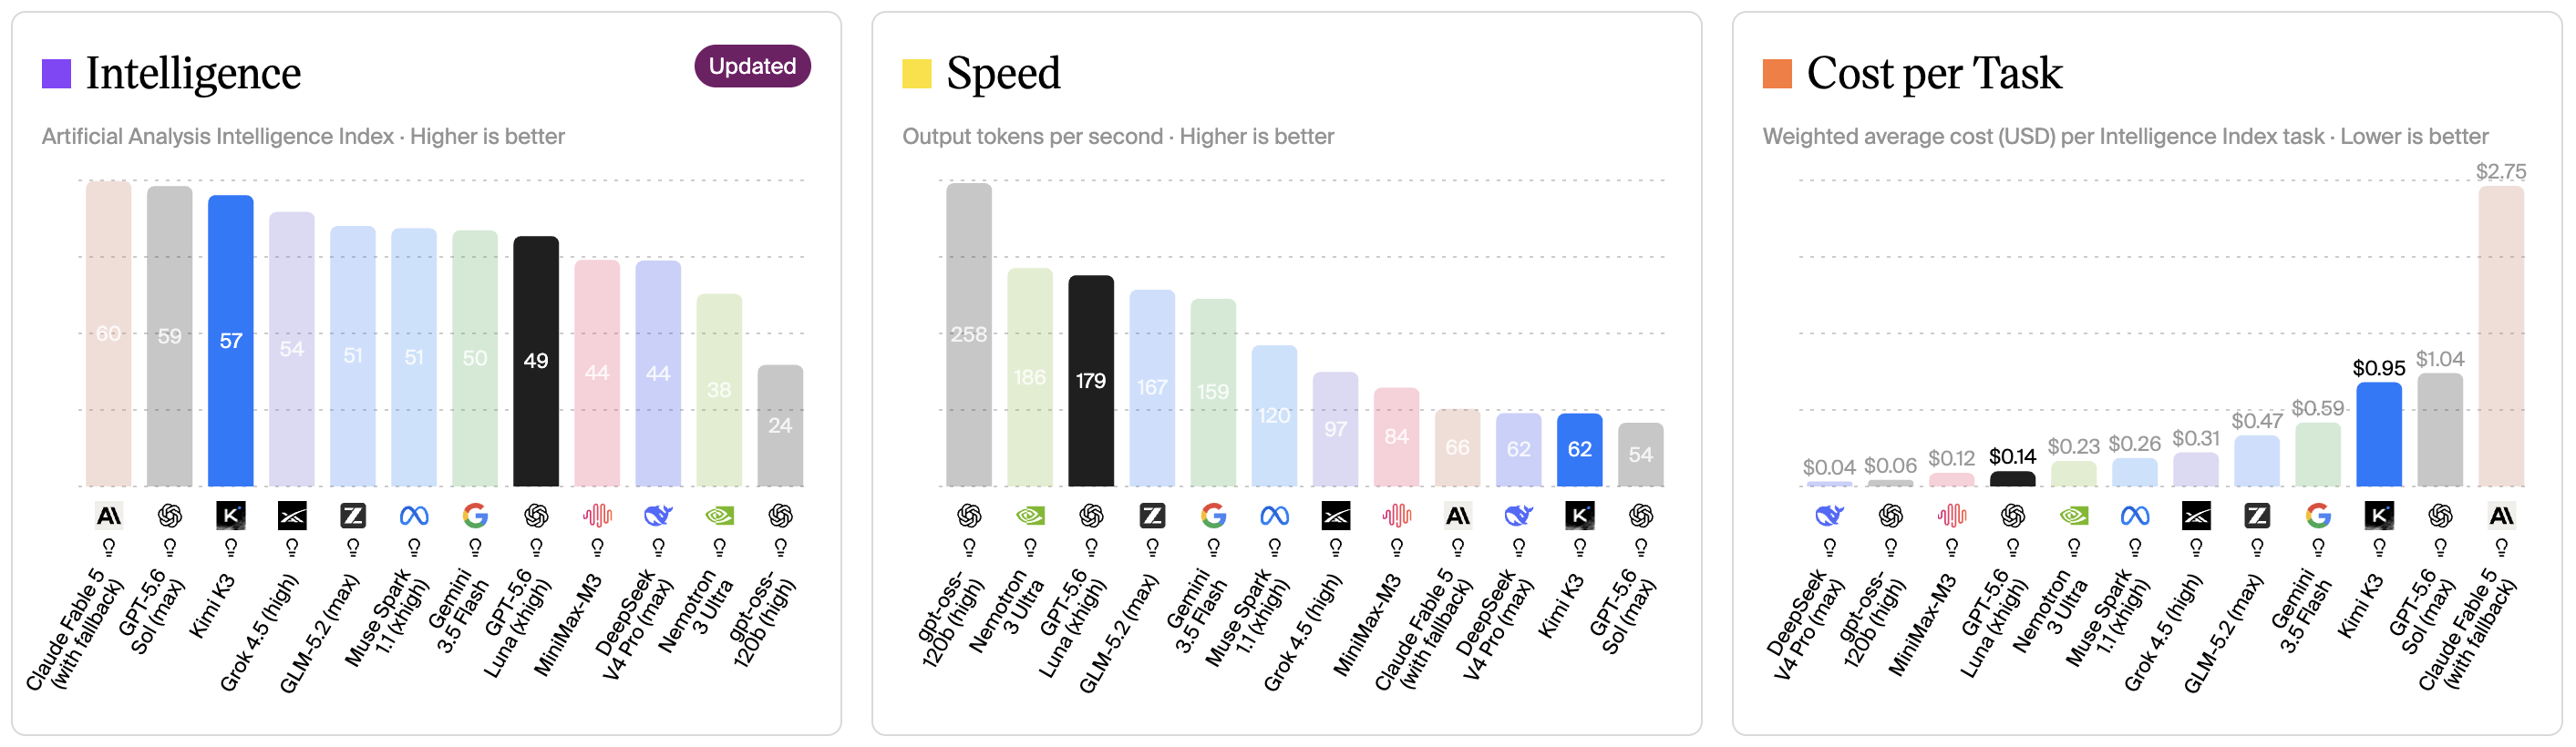
GPT-5.6 Sol adalah model terbaru dan termahal dari OpenAI dalam perbandingan ini, dan pada Terminal-Bench 2.1, model ini pada dasarnya seri dengan K3. Sol meraih 88,8 dibanding 88,3 milik K3.
Perbedaan besarnya sama seperti pada Opus 4.8: Sol adalah closed-weight, jadi Anda hanya dapat menggunakannya melalui produk OpenAI (ChatGPT, Codex, API), sementara K3 adalah open-weight. Setelah bobot dirilis, siapa pun dapat melakukan self-hosting atau fine-tuning.
Seperti terlihat pada grafik di bawah, Sol sedikit mengungguli K3 pada Intelligence Index, tetapi K3 lebih baik pada kecepatan dan biaya.
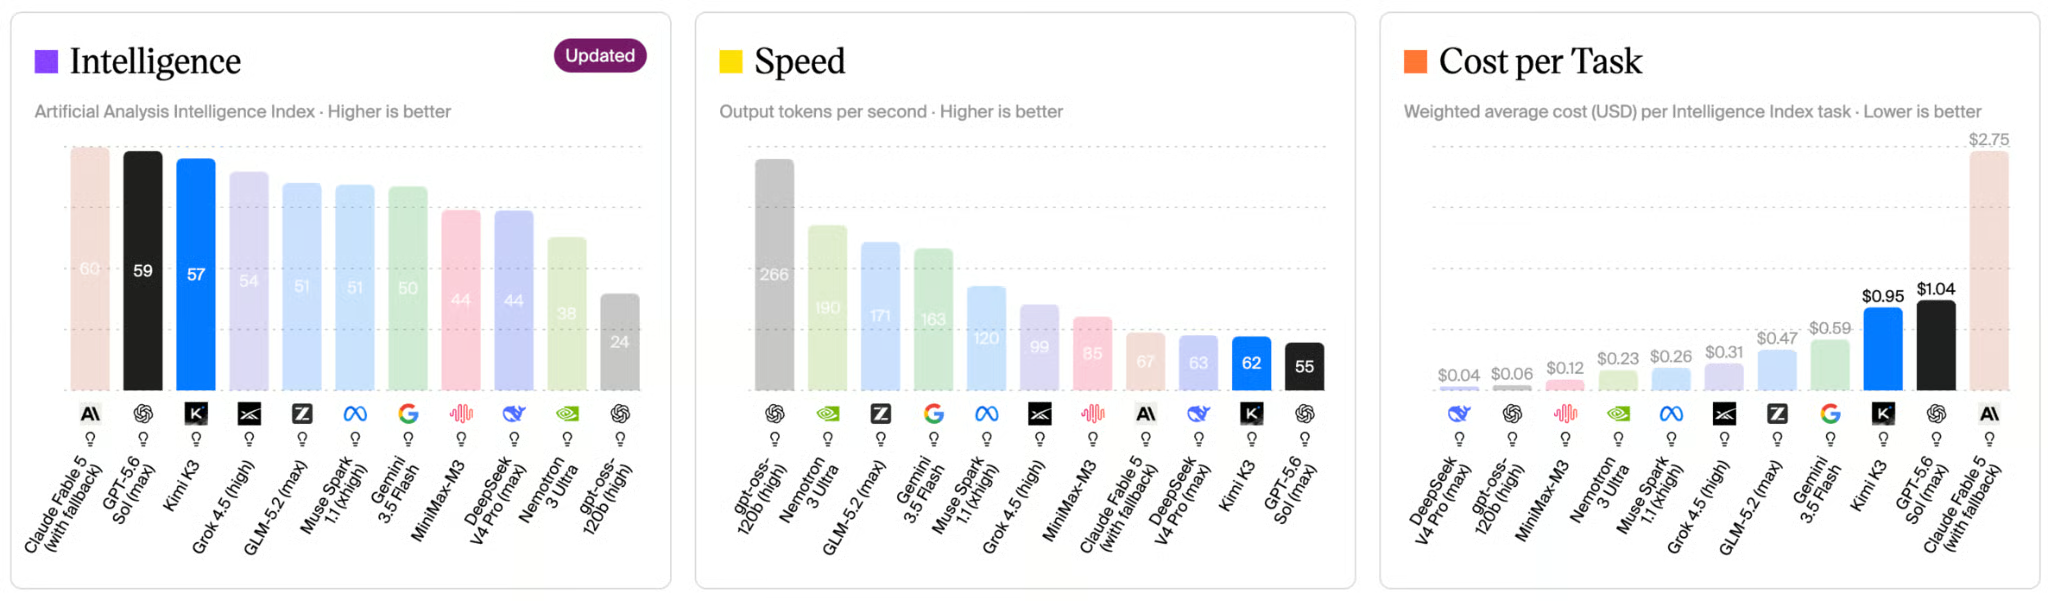
Kimi K3 sudah tayang sekarang, meski belum sepenuhnya. Modelnya diluncurkan kemarin dan sudah dapat digunakan hari ini melalui kimi.com, aplikasi seluler Kimi, Kimi Work, Kimi Code, dan Kimi API dengan ID model kimi-k3. Model ini juga mulai muncul di router pihak ketiga seperti OpenRouter dan OrcaRouter.
Yang belum tersedia adalah bobot open-weight itu sendiri. Moonshot mengatakan bobot tersebut akan dirilis paling lambat 27 Juli 2026, sementara perusahaan melanjutkan kerja dengan mitra inferensi dan pengelola open-source untuk menyelaraskan detail teknis. Hingga saat itu, Anda dapat menggunakan K3 melalui layanan terkelola Moonshot, tetapi belum dapat mengunduh dan melakukan self-hosting.
Kami menyarankan Anda mendaftar buletin AI mingguan kami, The Median, sebagai cara yang baik untuk tetap mengikuti pembaruan rilis model seperti ini.
Untuk harga, K3 menggunakan penagihan flat pay-as-you-go alih-alih bertingkat menurut panjang konteks, meskipun jendelanya 1 juta token. Tarif resmi Moonshot adalah $0,30 per juta token untuk input cache-hit, $3,00 per juta token untuk input cache-miss, dan $15,00 per juta token untuk output — dengan tingkat cache hit di atas 90% dilaporkan untuk beban kerja coding tipikal, yang menurunkan biaya input efektif dalam praktiknya.
Moonshot bersikap terus terang di blog teknisnya sendiri tentang keterbatasan:
Kimi K3 adalah model open-weight terbesar yang dirilis hingga saat ini. Model ini memiliki arsitektur attention baru yang ditujukan langsung pada beban kerja konteks panjang dan agentic. Pada tolok ukur yang kini bersifat publik, K3 bukan pemenang mutlak secara keseluruhan — Fable 5 dan GPT-5.6 Sol keduanya sedikit unggul — namun sangat kompetitif di seluruh tugas pemrograman, agentic, dan multimodal dengan sebagian kecil biaya.
Itulah benang merah seluruh artikel ini: K3 tidak mencoba menang di setiap kategori. Model ini berusaha membuat trade-off harga-ke-kapabilitas sulit diabaikan, seperti yang dilakukan DeepSeek dengan R1 dan GLM-5.2 baru-baru ini — bedanya kali ini, Moonshot mematok tarif frontier untuk melakukannya, bukan tarif diskon.
Belajar AI bersama DataCamp
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt