Cursus
LLMOps-concepten
1 uur
19.9K
Moonshot AI heeft Kimi K3 aangekondigd, het nieuwste vlaggenschip in de Kimi-modellijn en het grootste open-weight model dat tot nu toe is uitgebracht (2,8 biljoen parameters). De volledige gewichten zijn nog niet beschikbaar. Moonshot zegt dat ze over tien dagen worden vrijgegeven.
Het aantal parameters is echter niet de kern van het verhaal. Moonshot is een startup uit Beijing, gesteund door Alibaba (dat ook de Qwen-modellen maakt, zoals je je misschien herinnert, met Qwen 3.7 als de nieuwste), en het vecht om relevant te blijven nu DeepSeek en andere Chinese labs het veld vullen.
Qua schaal is K3 grofweg 75% groter dan DeepSeek's V4. Op Moonshots eigen benchmarks verslaat het Claude Opus 4.8 en GPT-5.5, maar blijft het achter bij Claude Fable 5 en GPT-5.6 Sol.
De prijs is echter het echte signaal. K3 rekent frontier-tarieven. Dat is het probleem voor Amerikaanse labs: als een Chinees model dezelfde prijs kan vragen en ongeveer hetzelfde presteert, ondermijnt dat het idee dat een premiumprijs is wat Amerikaanse modellen onderscheidt.
We noemden al iets over prijs en geschiedenis. Maar wat weten we over Kimi K3, hoe het is opgebouwd en hoe goed het werkt?
Kimi K3 is vooral goed gepositioneerd voor wat Moonshot "frontier intelligence-scenario's" noemt, waarmee het doelt op langetermijn-ontwikkeling, kenniswerk en redeneren.
Daarvoor ondersteunt het een contextvenster van 1 miljoen tokens en native visueel begrip. Dat tweede betekent dat het afbeeldingen en video direct als input kan nemen.
Waar het meest over wordt gepraat, is zichtbaar aan de buitenkant: het contextvenster van 1 miljoen tokens en native visueel begrip, die ik al noemde.
Om dit te bereiken, heeft Moonshot onder de motorkap veranderingen doorgevoerd op drie vlakken:
Het model is opgebouwd rond twee nieuwe componenten: Kimi Delta Attention (KDA), een hybride lineaire aandachtmechanisme, en iets dat Attention Residuals (AttnRes) heet. Beide zijn bedoeld om informatie betrouwbaarder te laten voortplanten door lange sequenties en diepe netwerken.
Daarbovenop heeft Moonshot de sparsity van zijn Mixture-of-Experts-opzet verder doorgetrokken met een "Stable LatentMoE"-framework, waarbij per forward pass een klein deel van de experts wordt geactiveerd. Gecombineerd met training- en datawijzigingen claimt Moonshot dat dit K3 ongeveer 2,5x de schaalefficiëntie van zijn voorganger, K2, geeft.
Moonshot positioneert K3 als sterk in engineeringwerk met lange adem: meerstapstaken volhouden met minimale supervisie, navigeren door grote codebases en terminaltools aansturen.
Het benadrukt ook een specifieke niche — het combineren van coderen met visueel redeneren, zoals het gebruik van screenshots en visuele feedback om te itereren op gamedevelopment, frontend-werk of CAD-taken. Er zijn veel Kimi K3-voorbeelden rond gamedevelopment, zoals een Paper Mario-geïnspireerde game, een vliegtuigbezorggame en iets dat op Halo lijkt.
Moonshot zegt dat zijn interne evaluaties (opgebouwd uit echte agent-samenwerkingsworkflows in plaats van openbare benchmarks) consistente winst laten zien voor Kimi K3's "max"-variant bij productiestijl kenniswerktaken.
Wat dit betekent voor iedereen die het model daadwerkelijk gebruikt: langere documenten, codebases of video kunnen als één enkele input naar binnen in plaats van te worden opgeknipt en weer aan elkaar gezet, en in hetzelfde verzoek kun je tekst, afbeeldingen en video mengen zonder extra koppelingen.
Als de efficiëntiewinst standhoudt, zou dat ook meer capaciteit per dollar compute moeten betekenen dan K2.
De API-documentatie geeft een duidelijker beeld van wat er veranderd is voor mensen die daadwerkelijk met het model bouwen:
Altijd-aan-denkmodus: K3 draait standaard in thinking-modus, geconfigureerd via een top-levelparameter reasoning_effort in plaats van de oudere vlag thinking uit de K2-lijn. Voor nu wordt alleen het inspanningsniveau max ondersteund.
Streaming met gescheiden redenering: Streaming-antwoorden geven reasoning_content en het definitieve-antwoordveld content vrij als afzonderlijke deltas, zodat je het denkproces van het model kunt tonen of verbergen.
Visuele input, geen openbare URL's: Afbeeldingen moeten als base64 of via een geüploade bestandsreferentie worden verzonden; het model accepteert geen platte afbeeldings-URL's, en video wordt afgehandeld via een aparte bestandsupload.
Gestructureerde output: JSON Schema-output wordt ondersteund met een strict-modus, maar dit beperkt alleen het uiteindelijke veld content, niet de redeneringstrace.
Partial mode: Je kunt het antwoord van de assistent starten met een vaste prefix en het model daarvandaan laten doorgaan. Dit is handig als je een bepaalde opening wilt afdwingen.
Dynamisch laden van tools: Tooldefinities kunnen midden in het gesprek worden geïnjecteerd via een system-bericht, en zijn vanaf dat moment in het gesprek beschikbaar.
Automatische contextcaching: Caching is automatisch en vereist geen extra parameters.
Een paar andere limieten om te markeren voor iedereen die de API integreert: max_completion_tokens is standaard 131.072 en maximaal 1.048.576, en samplingparameters zoals temperature en top_p zijn vastgezet in plaats van configureerbaar.
Kimi is ook uitstekend voor browserautomatiseringstaken. Lees meer in onze Kimi-browserextensietutorial.
Moonshots lanceringsmateriaal bevat nu echte benchmarkcijfers, maar we moeten in gedachten houden dat verschillende modellen via verschillende agent-harnassen zijn gerund. K3 is getest met Moonshots eigen KimiCode; de Claude-modellen draaiden via Claude Code of Terminus 2; de GPT-modellen via Codex. Dit is dus geen zuivere vergelijking. Het model van elk lab wordt getest binnen zijn eigen tooling in best-case-scenario's.
Hier is de grote lijn in drie categorieën.
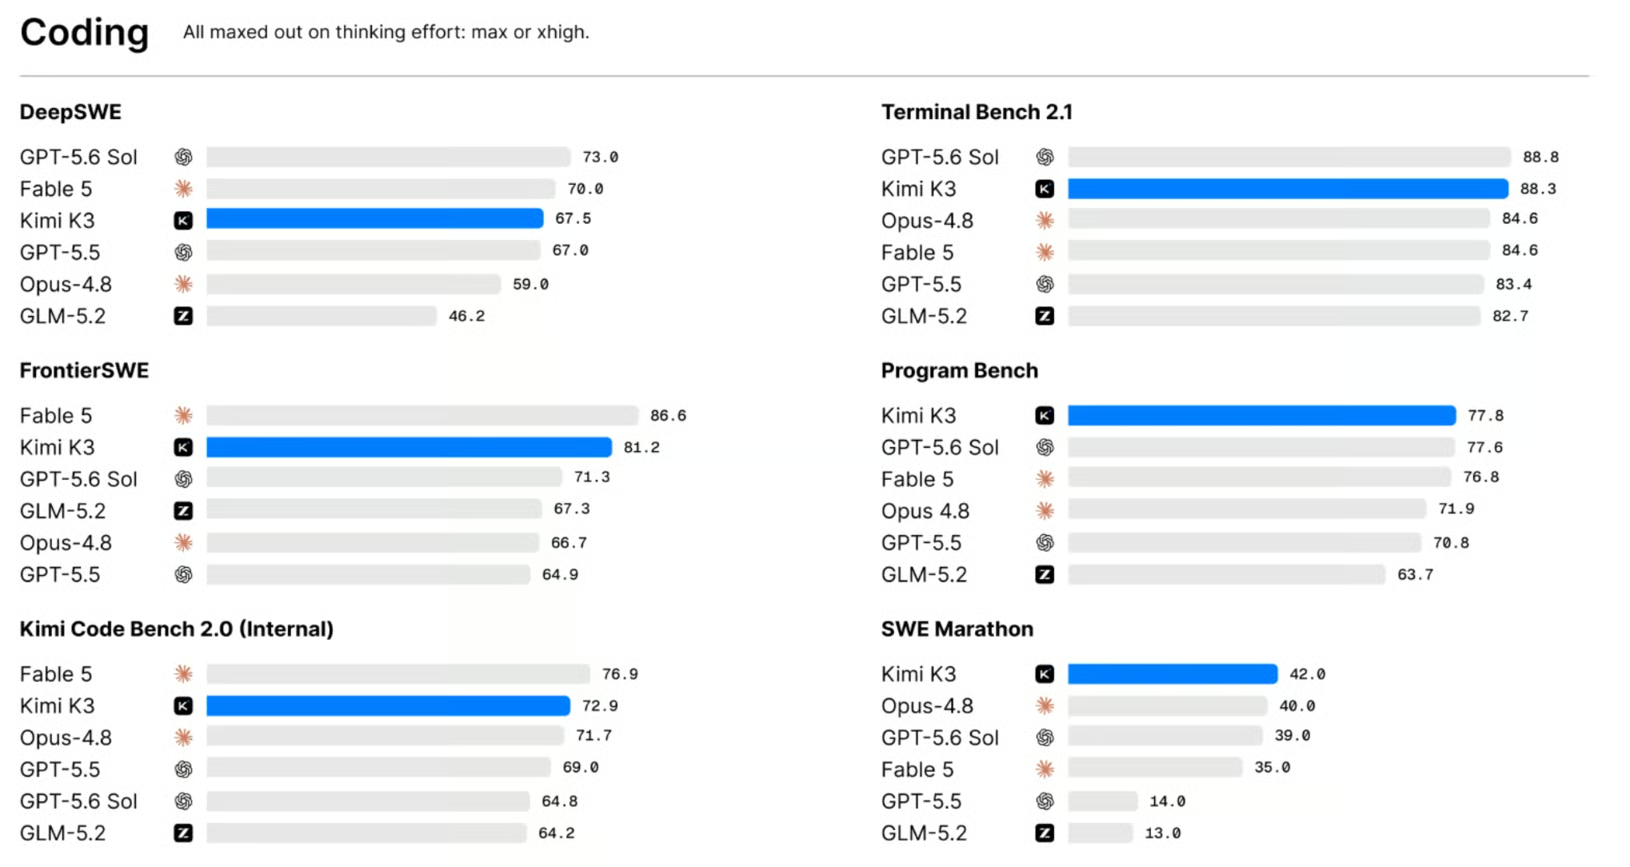
Zoals je in de onderstaande grafiek kunt zien, veegt K3 de codeerbenchmarks niet, maar het is bijna overal competitief. Het leidt ruim op Program Bench en SWE Marathon, komt binnen een halve punt van GPT-5.6 Sol op Terminal-Bench 2.1 en verslaat Opus 4.8 op de meeste individuele tests. Waar het duidelijk verliest, is DeepSWE en FrontierSWE, waar Fable 5 en GPT-5.6 Sol uitlopen.
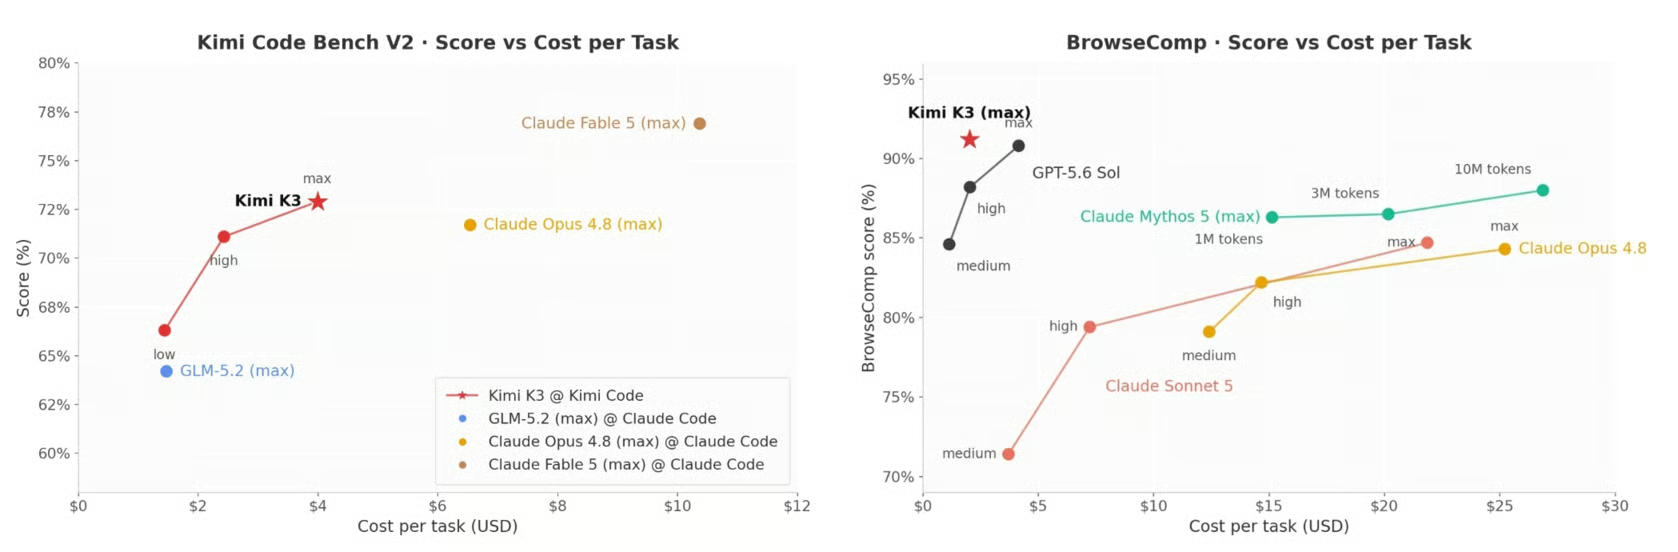
Op Moonshots eigen Kimi Code Bench V2-grafiek landt K3 op een vergelijkbare score als Opus 4.8 tegen ongeveer de helft van de kosten per taak, en lang niet wat Fable 5 kost voor een paar extra punten. De BrowseComp-grafiek vertelt een vergelijkbaar verhaal: K3 scoort hoger dan GPT-5.6 Sol en Claude Fable 5 terwijl het per taak een fractie kost.
De modelparameter-grafiek is een interessante blik. Het is de duidelijkste visualisatie van de claim "grootste open-weight model" van eerder in dit stuk, waarin te zien is dat Moonshot in één release van Kimi K2's 1T parameters rechtstreeks voorbij DeepSeek, Xiaomi en de rest naar 2,8T springt.
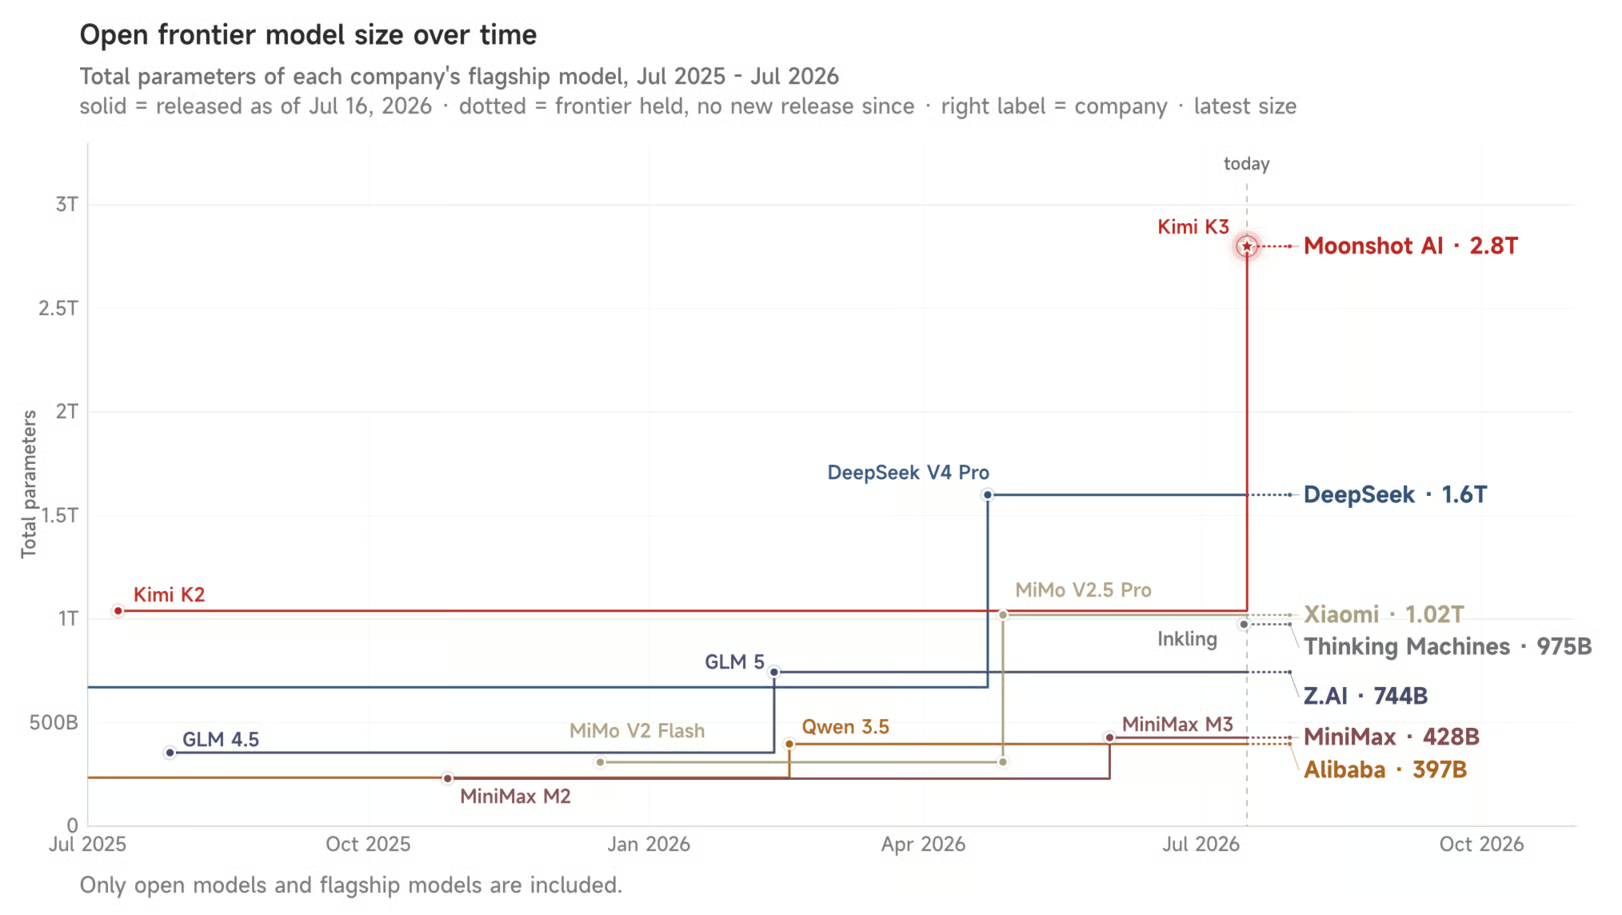
Zo verhoudt Kimi K3 zich tot de andere Chinese labs die nu modellen leveren. In grote lijnen lijkt het Chinese open-weight veld zich in tweeën te splitsen: labs zoals DeepSeek en Z.AI concurreren nog steeds op prijs, en Moonshot begint hogere tarieven te vragen.
DeepSeek V4 is kleiner dan K3 en aanzienlijk lager geprijsd.
K3 maakt een andere keuze: het is groter, en Moonshot rekent daar ook naar in plaats van te proberen op prijs te winnen.
Deze vergelijking is interessant omdat Alibaba zowel Moonshot ondersteunt als natuurlijk zijn eigen Qwen-lijn.
Toch zijn ze anders: Qwens vlaggenschip, Qwen 3.7 Max, is helemaal geen open-weight. Het is gesloten, proprietair en alleen te gebruiken via Alibaba's eigen producten of externe API-hosts. Alibaba blijft kleinere open-weight Qwen-modellen uitbrengen, maar het topmodel is achter gesloten deuren verdwenen.
GLM-5.2 ligt dichter bij het oude Chinese open-sourcehandboek: een echt sterk model, MIT-gelicentieerd en ruim onder Westerse frontier-tarieven geprijsd. Het is kleiner dan K3 en veel goedkoper, en het heeft een reputatie opgebouwd voor bijna-frontier codeerprestaties tegen een fractie van de kosten.
Zo verhouden de cijfers zich, met Artificial Analysis' Intelligence Index (een samengestelde score gebaseerd op negen benchmarks, op dezelfde manier uitgevoerd over modellen) als ijkpunt:
| Model | Parameters | Release Date | Intelligence Index | Terminal-Bench 2.1 | Price ($/M in / out) | Open-weight? |
|---|---|---|---|---|---|---|
| DeepSeek V4 Pro | 1,6T (49B actief) | Apr 24, 2026 | 44 | Niet onafhankelijk vermeld | $0,44 / $0,87 | Ja |
| Qwen 3.7 Max (Alibaba) | Niet bekendgemaakt | May 20, 2026 | 56,6 | Niet direct vergelijkbaar | $2,50 / $7,50 | Nee — alleen API |
| GLM-5.2 (Z.AI) | 744B (40B actief) | Jun 13, 2026 | 51 | 78 | $1,40 / $4,40 | Ja |
| Kimi K3 | 2,8T (16 van 896 experts actief) | Jul 16, 2026 | 57 | 88,3 | $3,00 / $15,00 | Ja |
Een paar dingen om te markeren: Qwen 3.7 Max is ter referentie opgenomen, maar het is, zoals gezegd, eigenlijk geen open-weight en dus geen echte gelijke in deze vergelijking, maar het voelde goed om het als referentie in de tabel op te nemen. Ook is onafhankelijke, third-party verificatie overal nog bezig in te lopen, dus niets is definitief.
Vervolgens de vraag: hoe verhoudt Kimi K3 zich tot de gesloten, proprietaire modellen van Anthropic en OpenAI?
Opus 4.8 is al maanden het vlaggenschip van Anthropic, en op Moonshots eigen cijfers gaat K3 er op verschillende individuele benchmarks, vooral bij coderen, nipt overheen. K3 scoort 88,3 op Terminal-Bench 2.1 tegenover 84,6 voor Opus 4.8.
Het grotere verschil is dit: Opus 4.8 is gesloten. K3 is open-weight, dus zodra de gewichten daadwerkelijk beschikbaar zijn, kan iedereen het zelf hosten, fine-tunen of draaien zonder afhankelijk te zijn van Moonshots servers.
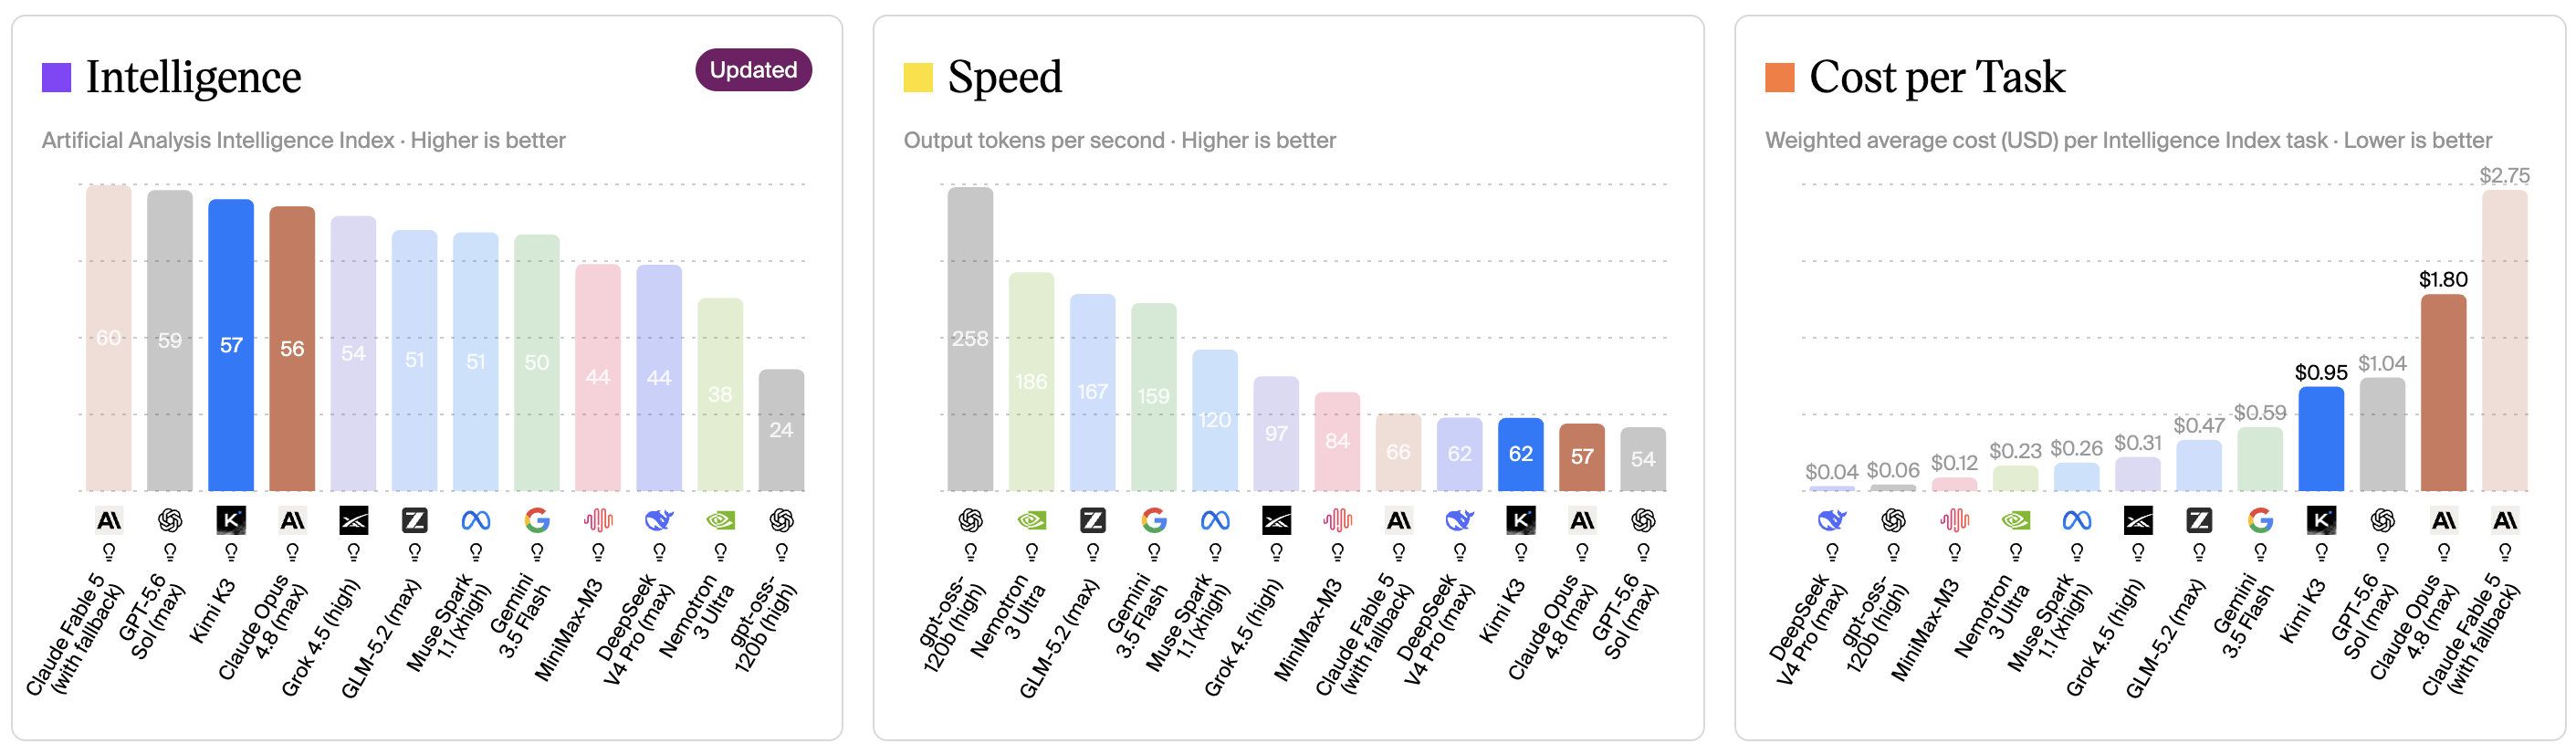
Zoals je in de onderstaande grafieken ziet, gaat K3 Opus 4.8 op de Intelligence Index met één punt voorbij, maar het gat wordt elders groter: K3 kost ongeveer de helft per taak en geeft het eerste token ongeveer 20x sneller vrij.
Fable 5 is Anthropics nieuwste en capabelste model, en dat is het model dat K3 niet inhaalt. Het leidt duidelijk op algemene intelligentie, en het kost aanzienlijk meer om te draaien. Fable 5 is geprijsd op $10/$50 per miljoen tokens versus $3/$15 voor K3. Maar K3's pitch hier is niet "net zo goed als Fable 5." Het is "een groot deel van de weg, voor een fractie van de prijs."
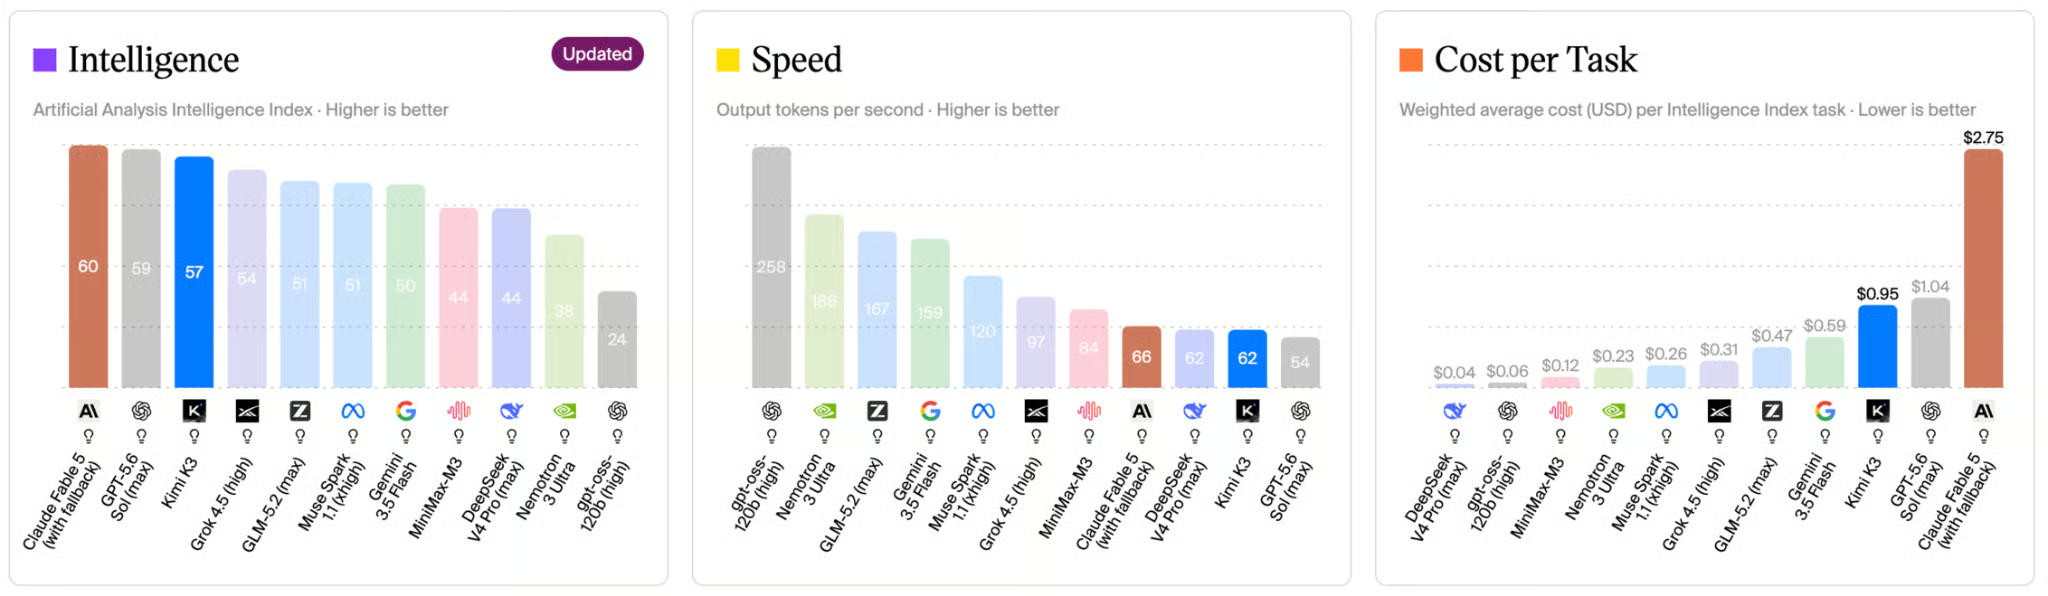
Zoals je in de onderstaande grafieken ziet, ligt Fable 5 comfortabel voor op de Intelligence Index, en het is zelfs een tikje sneller dan K3 op ruwe outputsnelheid. Waar K3 voorligt, is de kost. Het draait tegen ongeveer een derde van de prijs per taak van Fable 5.
GPT-5.5 zit net onder K3 op Moonshots eigen benchmarks, en is geprijsd in een vergelijkbare range als de andere Amerikaanse vlaggenschepen en ruim boven K3's tarief.
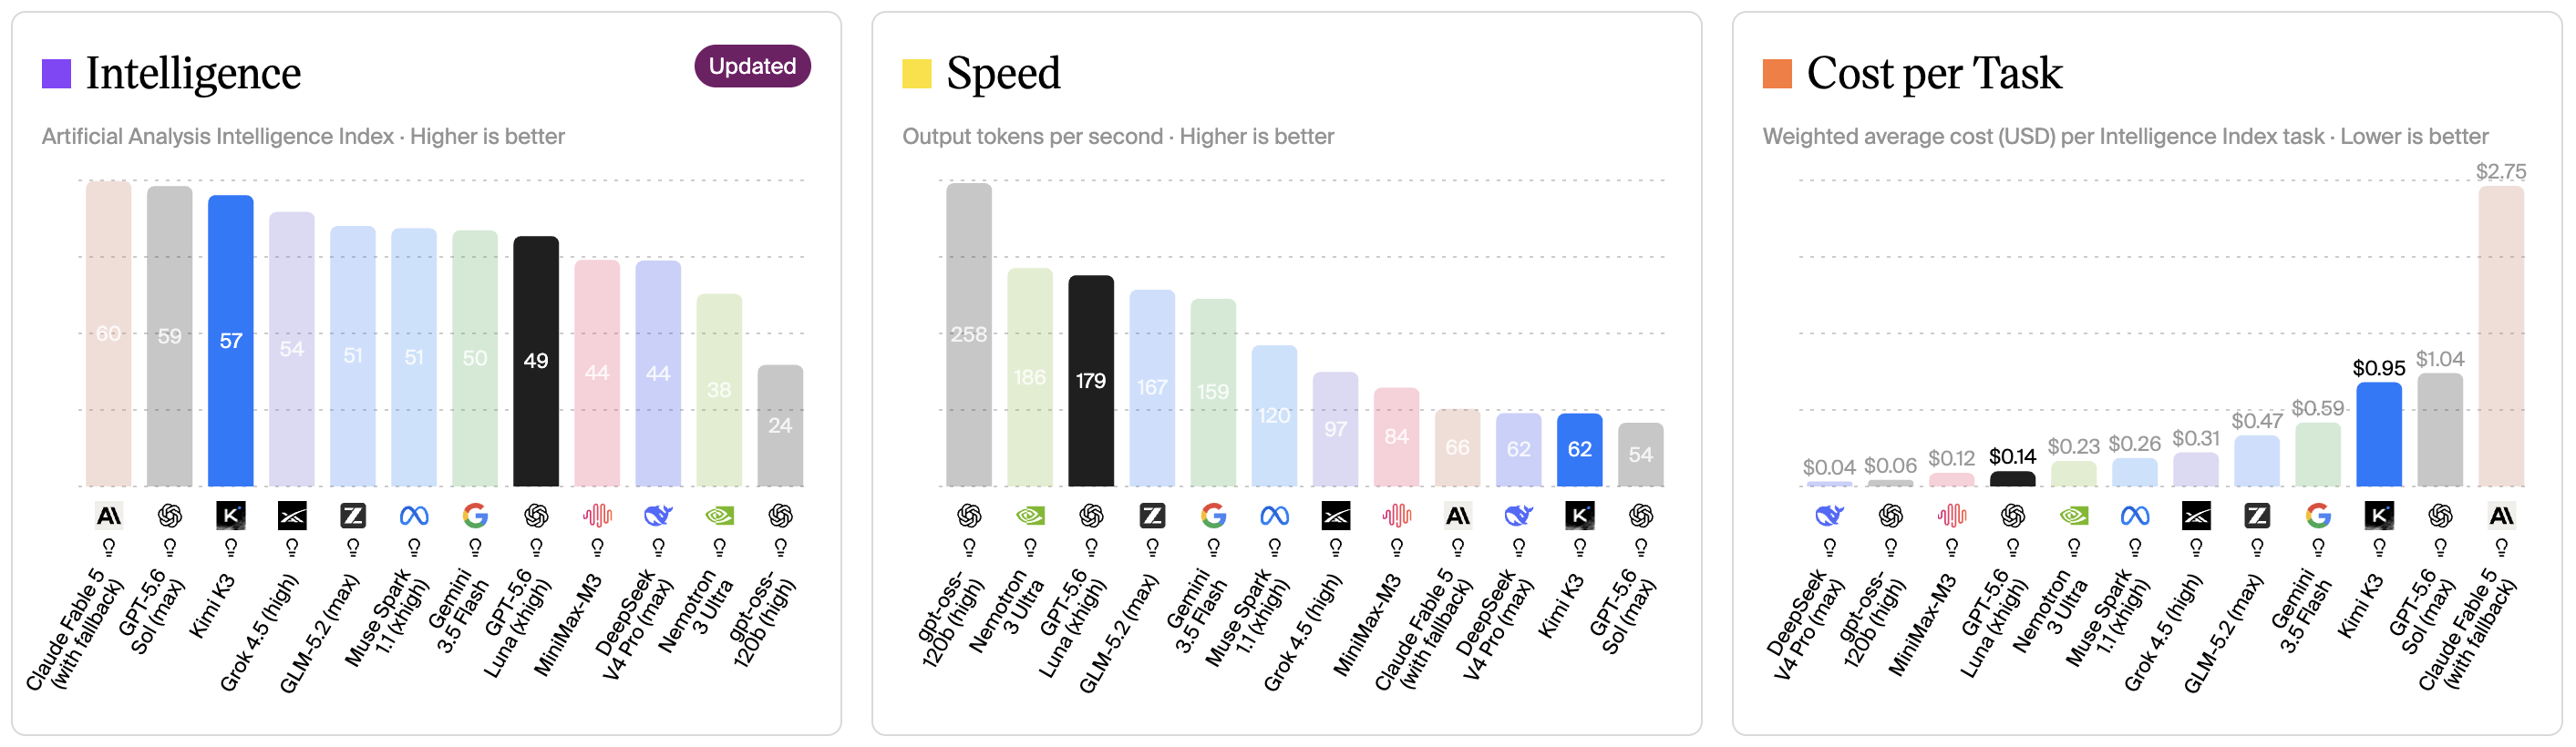
Zoals je in de onderstaande grafieken ziet, gaat K3 GPT-5.5 op de Intelligence Index nipt voorbij en kost het iets minder per taak. GPT-5.5 genereert eenmaal draaiend de tokens wel iets sneller, dus de twee ruilen afhankelijk van wat voor jou het meest telt van die drie dingen.
GPT-5.6 Sol is OpenAI's nieuwste en duurste model in deze vergelijking, en op Terminal-Bench 2.1 staat het praktisch gelijk met K3. Sol scoort 88,8 tegenover 88,3 voor K3.
Het grotere verschil is hetzelfde als bij Opus 4.8: Sol is closed-weight, dus je kunt het alleen gebruiken via OpenAI's eigen producten (ChatGPT, Codex, de API), terwijl K3 open-weight is. Zodra de gewichten worden vrijgegeven, kan iedereen het zelf hosten of fine-tunen.
Zoals je in de onderstaande grafieken ziet, gaat Sol K3 voorbij op de Intelligence Index, maar K3 komt als winnaar uit de bus op zowel snelheid als kosten.
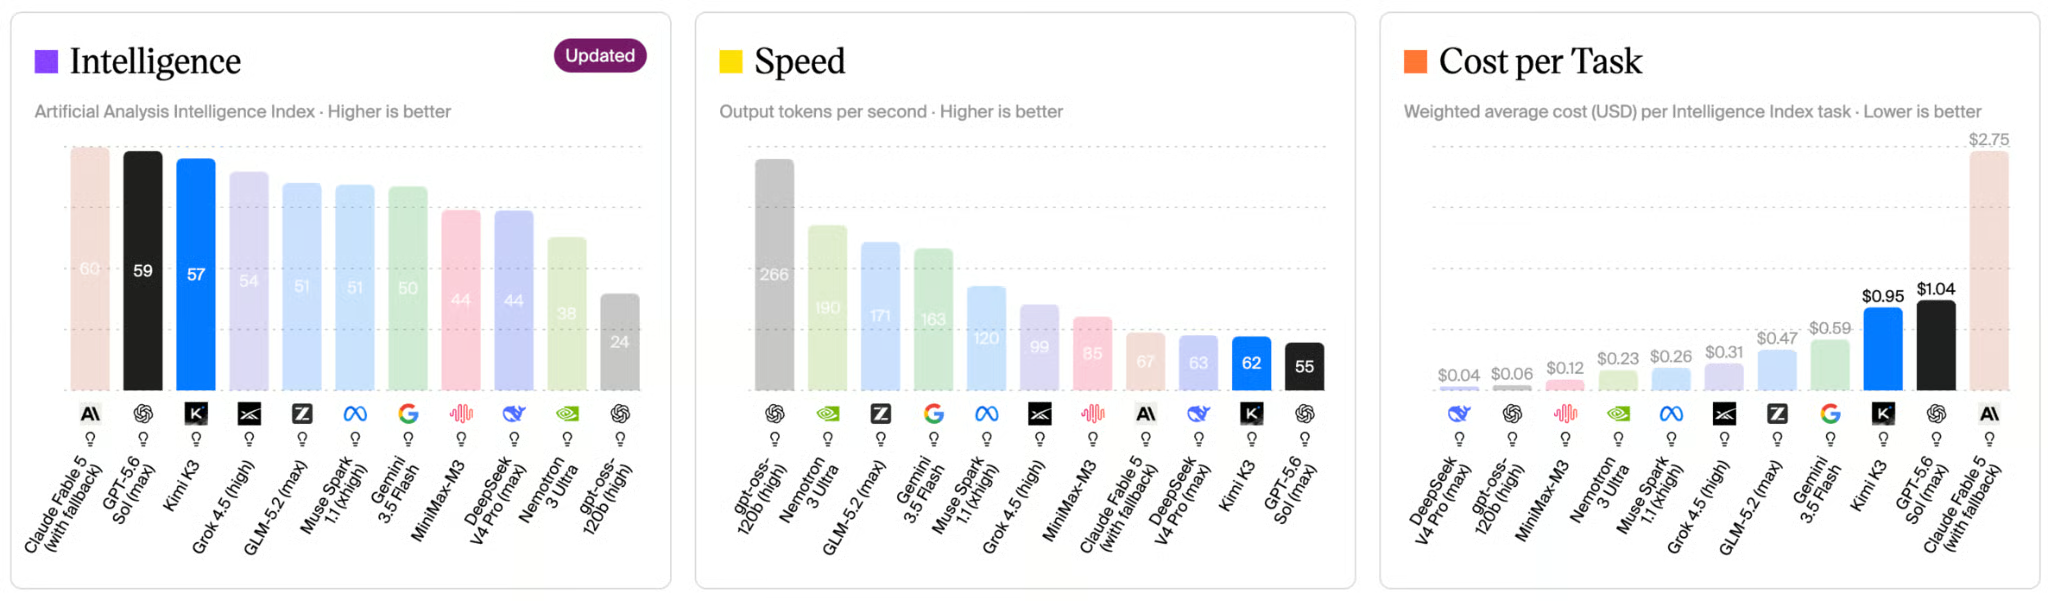
Kimi K3 is nu live, maar nog niet volledig. Het model zelf werd gisteren gelanceerd en is vandaag al te gebruiken via kimi.com, de Kimi-mobiele apps, Kimi Work, Kimi Code en de Kimi API onder het model-ID kimi-k3. Het duikt ook op bij routers van derden zoals OpenRouter en OrcaRouter.
Wat nog niet beschikbaar is, zijn de open gewichten zelf. Moonshot zegt dat die uiterlijk 27 juli 2026 worden vrijgegeven, terwijl het bedrijf samenwerkt met inference-partners en open-sourcemaintainers om technische details op elkaar af te stemmen. Tot die tijd kun je K3 gebruiken via Moonshots gehoste services, maar je kunt het niet downloaden en zelf hosten.
We raden aan je in te schrijven voor onze wekelijkse AI-nieuwsbrief, The Median, als een goede manier om op de hoogte te blijven van modelreleases zoals deze.
Qua prijs hanteert K3 pay-as-you-go zonder te schalen per contextlengte, ondanks het 1M-token venster. Moonshots officiële tarieven zijn $0,30 per miljoen tokens voor cache-hit input, $3,00 per miljoen tokens voor cache-miss input en $15,00 per miljoen tokens voor output — met een cache-hitpercentage boven 90% voor typische codeerworkloads, wat de effectieve inputkosten in de praktijk verlaagt.
Moonshot is openhartig over beperkingen in zijn eigen technische blog:
Kimi K3 is het grootste open-weight model dat tot nu toe is uitgebracht. Het heeft een nieuwe aandachtarchitectuur die zich rechtstreeks richt op long-context en agent-achtige workloads. Op de nu openbare benchmarks is het niet de absolute winnaar overall — Fable 5 en GPT-5.6 Sol gaan er beide nipt overheen — maar het is extreem competitief op codeer-, agent- en multimodale taken tegen een fractie van de kosten.
Dat is de rode draad van dit hele artikel: K3 probeert niet elke categorie te winnen. Het probeert de prijs-capaciteitsafweging moeilijk te negeren te maken, net zoals DeepSeek met R1 deed en GLM-5.2 onlangs — behalve dat Moonshot dit keer frontier-tarieven rekent in plaats van kortingstarieven.
Leer AI met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min