



Kurs
Orta Düzey ChatGPT
1 sa
33.3K
Alıştırma and program your progress.
Google Ile Devam EdinOpenAI’nin en yeni modeli GPT-5.5, token başına gecikmede GPT-5.4 ile aynı seviyede olsa da daha yüksek bir performans iddia ediyor. Aynı Codex görevlerini tamamlamak için daha az token de kullanıyor.
Verimlilik kazanımlarının ötesinde, OpenAI ajans niteliğindeki kodlama, bilgisayar kullanımı, bilgi işleri ve bilimsel araştırmalarda artışlar bildirdi.
Bu yazıda, GPT-5.5’te nelerin yeni olduğuna, kıyaslama sonuçlarına ve verimlilik kazanımlarına ilişkin iddialara bakacağız.
Ayrıca GPT-5.5’in “küçük kardeşi” GPT-5.5 Instant hakkındaki rehberimize ve en büyük rakipleri Claude Fable 5 (ve Claude Mythos 5) ile Gemini 3.5 Flash’e mutlaka göz atın. Karşılaştırma yazılarımızda Claude Opus 4.8 ve DeepSeek V4 ile GPT-5.5’in doğrudan nasıl karşılaştırıldığına bakın.
OpenAI’nin yeni sürümü iki ayrı model içeriyor.
İleride kıyaslamalar ve fiyatlandırmadan bahsederken iki model ayrı ayrı görünecek — Pro, performansta sürekli bir basamak yukarıda ve token başına yaklaşık 6× daha pahalı.
Yayınla ilgili daha ilginç iddialardan biri, GPT-5.5’in dahili bir sürümünün kombinatorikte, özellikle diyagonal dışı Ramsey sayıları üzerine yeni bir ispatın ortaya konmasına yardımcı olduğudur.
Bir Ramsey sayısı, belirli bir örüntünün kaçınılmaz olarak ortaya çıkacağı grup büyüklüğünü söyler. Her ikilinin bağlantılı ya da bağlantısız olduğu bir insan grubunu düşünün. Ramsey sayısı, grubun belirli bir alt yapıyı içermesinden kaçınmanın artık mümkün olmadığı büyüklük noktasıdır.
Ramsey sayılarının hesaplanması nam salmış derecede zordur. Kesin değerler yalnızca birkaç küçük vaka için bilinmektedir ve her yeni sonuç genellikle on yıllar süren çalışmayı gerektirir.
Dolayısıyla GPT-5.5 hâlihazırda aktif araştırmalara katkıda bulunuyor. Bakalım başka neler yeni:
Yeni verimlilik kazanımlarını birkaç şekilde ele alabiliriz:
Dolayısıyla birleşik iddia şudur: Her bir token eskisi kadar hızlı üretiliyor ve modeli işi bitirmek için daha az token gerekiyor. Birlikte ele alındığında, görevler artık genel olarak daha hızlı tamamlanıyor ve daha ucuza mal oluyor. Soru, daha kısa akıl yürütme zincirinin bazı yerlerde doğruluktan ödün verip vermediğidir.
Ancak token başına fiyatın yükseldiğini de söylemeliyiz. Buna fiyatlandırma bölümünde geleceğiz.
Uzun bir bağlam penceresi, model onun tamamını gerçekten kullanabiliyorsa faydalıdır. GPT-5.4 teknik olarak uzun bağlamları destekliyordu, ancak ~128K token sonrasında performansı dağılıyordu. Gerçekten uzun bir şey üzerinde akıl yürütmesini istediğinizde — tam bir kod tabanı, uzun bir sözleşme, saatlerce süren dökümler — pencerenin uzak ucunda performans düşüyordu.
GPT-5.5, 128K’yı, 256K’yı ve 1M’e kadar olan aralığı koruyor. Aşağıdaki kıyas bölümü özel sayılara girecek, ancak manşet şu: Bu, tüm bağlam penceresinin gerçekten kullanılabildiği ilk OpenAI modeli. 300K token testimizi geçti; detaylar aşağıda.
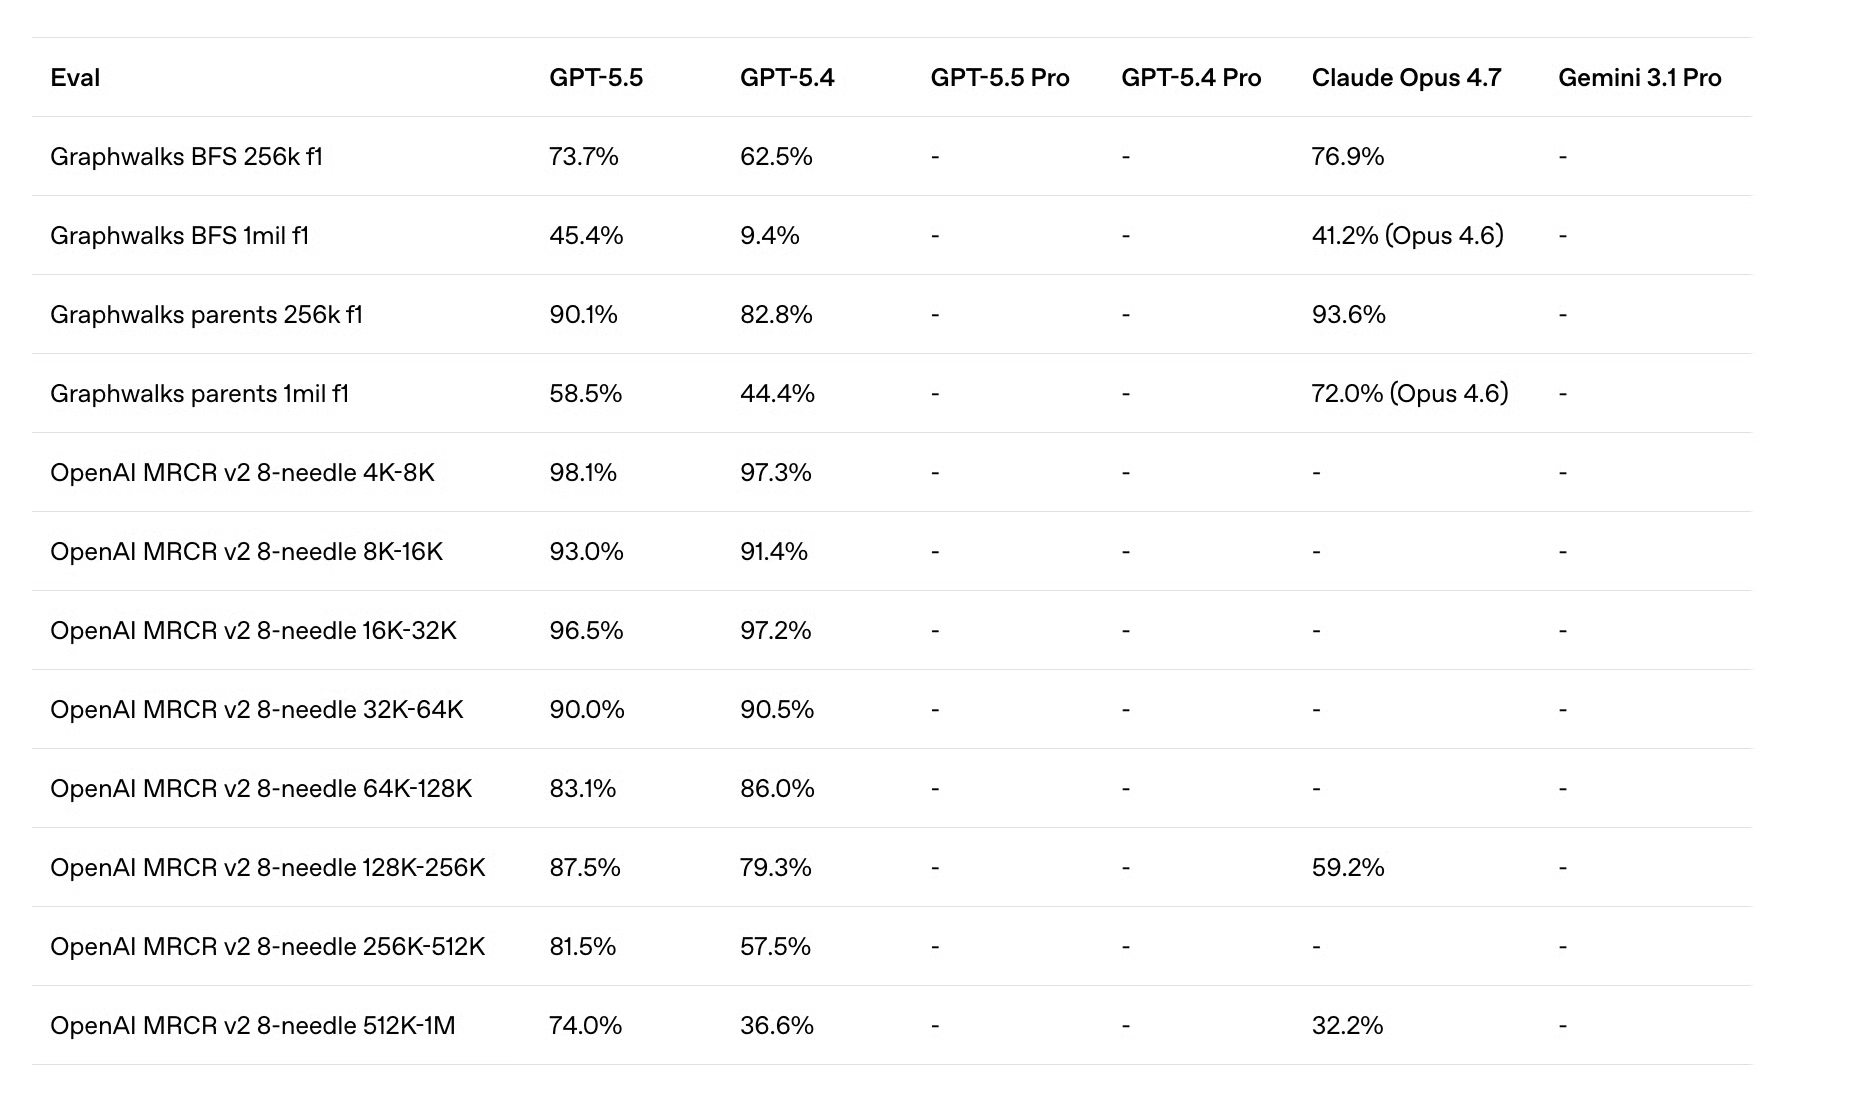
Yayınla birlikte gelen en ilginç model değerlendirmesinin bu olduğunu düşünüyorum. Bu, uzun-bağlam performansının bir ölçüsü. Bu kıyaslar alttaki soruyu değerlendirir: Size çok büyük miktarda metin verirsem, üzerinde hâlâ akıl yürütebilir misiniz?
MRCR iğne testleri, adından da anlaşılacağı gibi özünde “samanlıkta iğne” testidir. Modele içinde belirli bilgi parçaları — “iğneler” — gizlenmiş uzun bir belge verilir, ardından bunları bulması istenir. Testi farklı bağlam boyutlarında birçok kez görürüz. Puan ne kadar yüksekse, model kendisine verilen bağlamın tamamını o kadar fazla kullanmış demektir.
Graphwalks testlerini de unutmamak lazım. Aslında MRCR’den daha zordurlar. Bu testlerde model, bağlama gömülü bir grafik yapısını dolaşmak zorundadır (BFS burada genişlik-öncelikli arama anlamına gelir). Bu, uzun bağlam üzerinde akıl yürütmenin bir testidir. (Dikkatle bakarsanız, bu testlerin çoğunda Opus 4.7 en iyi sonucu veriyor.)
Sonuçlara hızlı bir bakış, GPT-5.5’in uzun bağlamlı bilgileri arama ve üzerinde akıl yürütmede daha iyi olduğunu söylüyor. Tabloya ikinci bir bakış ise daha ilginç bir şey söylüyor: GPT-5.4 ~128K sonrasında dağılıyor, GPT-5.5 ise dağılmıyor. Asıl hikâye bu.
Modelin vaat ettiklerini yerine getirip getirmediğini görmek ve GPT-5.4 ile Claude Opus 4.7 ile karşılaştırmalar yapmak için token verimliliği ve daha güçlü uzun metin akıl yürütmesi iddialarını test ettik.
GPT-5.5’in manşet iddiası, uzun-bağlam performansının ~128K token sonrasında artık dağılmadığı; oysa GPT-5.4 bu eşiğin ötesinde gözle görülür şekilde bozuluyordu. Bunu test etmek için GPT-5.5’e SEC EDGAR’dan Berkshire Hathaway’in FY2025 ve FY2024 10-K dosyalarını art arda verdik. Birlikte, neredeyse 300K tokenlık gerçek finansal metne ulaşıyorlar.
Not: Ham HTML dosyaları 3 milyonun üzerinde token tutuyor. İlgisiz HTML tokenları nedeniyle bozulmayı önlemek için BeautifulSoup ile görünür metni çıkardık ve bu çıkarımları tek bir metin dosyasında birleştirdik.
Ardından, birleşik belge boyunca çeşitli derinliklere gömülmüş belirli gerçekleri modelden geri getirmesini istedik. Temel zorluk: her iki dosya da benzer ama farklı sayılar (çalışan sayıları, fazla tutarları, pazar payı yüzdeleri) içeren yapısal olarak özdeş bölümler barındırıyor; bu yüzden model sadece anahtar sözcük eşleştirerek cevap bulamaz. Doğru yıldan doğru sayıyı bulması gerekir.
İki kademeli soru tasarladık. Kademe 1 basit geri getirim testidir: model belirli bir derinlikte belirli bir gerçeği bulabiliyor mu? Kademe 2 çok atlamalı akıl yürütmeyi test eder: belgenin uzak kısımlarından iki gerçeği çekip bunları bir hesaplamada birleştirebiliyor mu?
Birlikte, bunlar OpenAI’nin kendi sürümündeki MRCR iğne testleri ve Graphwalks kıyaslarını basit bir şekilde yansıtır; ancak bir finans analistinin gerçekten modele verebileceği gerçek dünya belgesi kullanılarak.
İstemimiz:
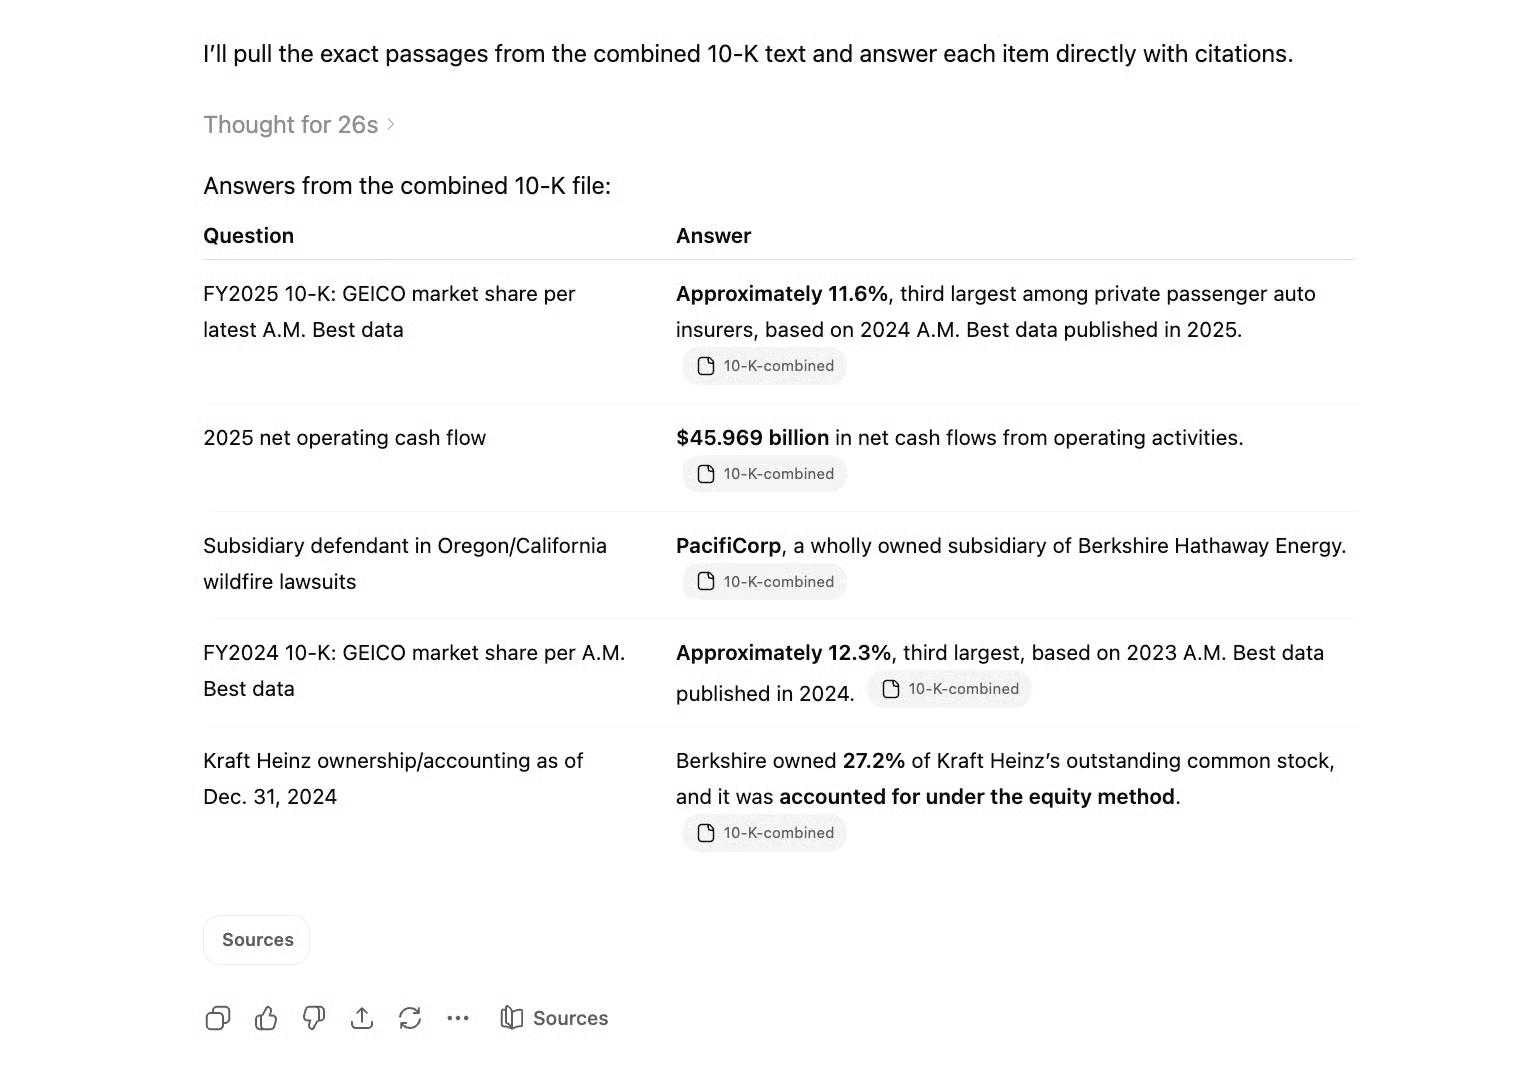
Attached are Berkshire Hathaway's FY2025 and FY2024 10-K filings. Please read them and answer the following questions:
According to the most recent A.M. Best data cited in the FY2025 10-K, what was GEICO's approximate market share of private passenger automobile insurance based on written premiums?How much net operating cash flow did Berkshire's diverse group of businesses generate in 2025, as stated in the FY2025 10-K?Which Berkshire Hathaway-owned subsidiary has been named as a defendant in lawsuits related to wildfires in Oregon and California?According to the A.M. Best data cited in the FY2024 10-K, what was GEICO's approximate market share of private passenger automobile insurance based on written premiums?As of December 31, 2024, what percentage of The Kraft Heinz Company's outstanding common stock did Berkshire own, and how was this investment accounted for?
Yaklaşık yarım dakika sonra GPT-5.5 soruları yanıtladı ve her biri doğruydu.
Sonra çok atlamalı soruları sorduk:
Attached are Berkshire Hathaway's FY2025 and FY2024 10-K filings. Please read them and answer the following questions:
GEICO's market share changed between the A.M. Best data cited in the FY2024 10-K and the A.M. Best data cited in the FY2025 10-K. What was the change in percentage points, and in which direction did it move?
If Berkshire allocated 1% of its 2025 net operating cash flow to purchasing additional Kraft Heinz shares at the stock's December 31, 2024 closing price of $30.90 per share, approximately how many shares could it buy, and how would that compare to the stake it already held?
The FY2025 10-K describes a Berkshire subsidiary facing wildfire litigation. Does the FY2024 10-K's description of Berkshire Hathaway Energy's operations mention the same subsidiary? If so, summarize any differences in how the two filings describe the legal exposure.
Bu sorular hâlihazırda bulunan iğnelerden elde edilen bilgileri kullandığı için, onları yeni bir sohbette sorduk. Yine yaklaşık 30 saniye içinde sonuç aldık ve yine GPT-5.5 her soruyu doğru yanıtladı.
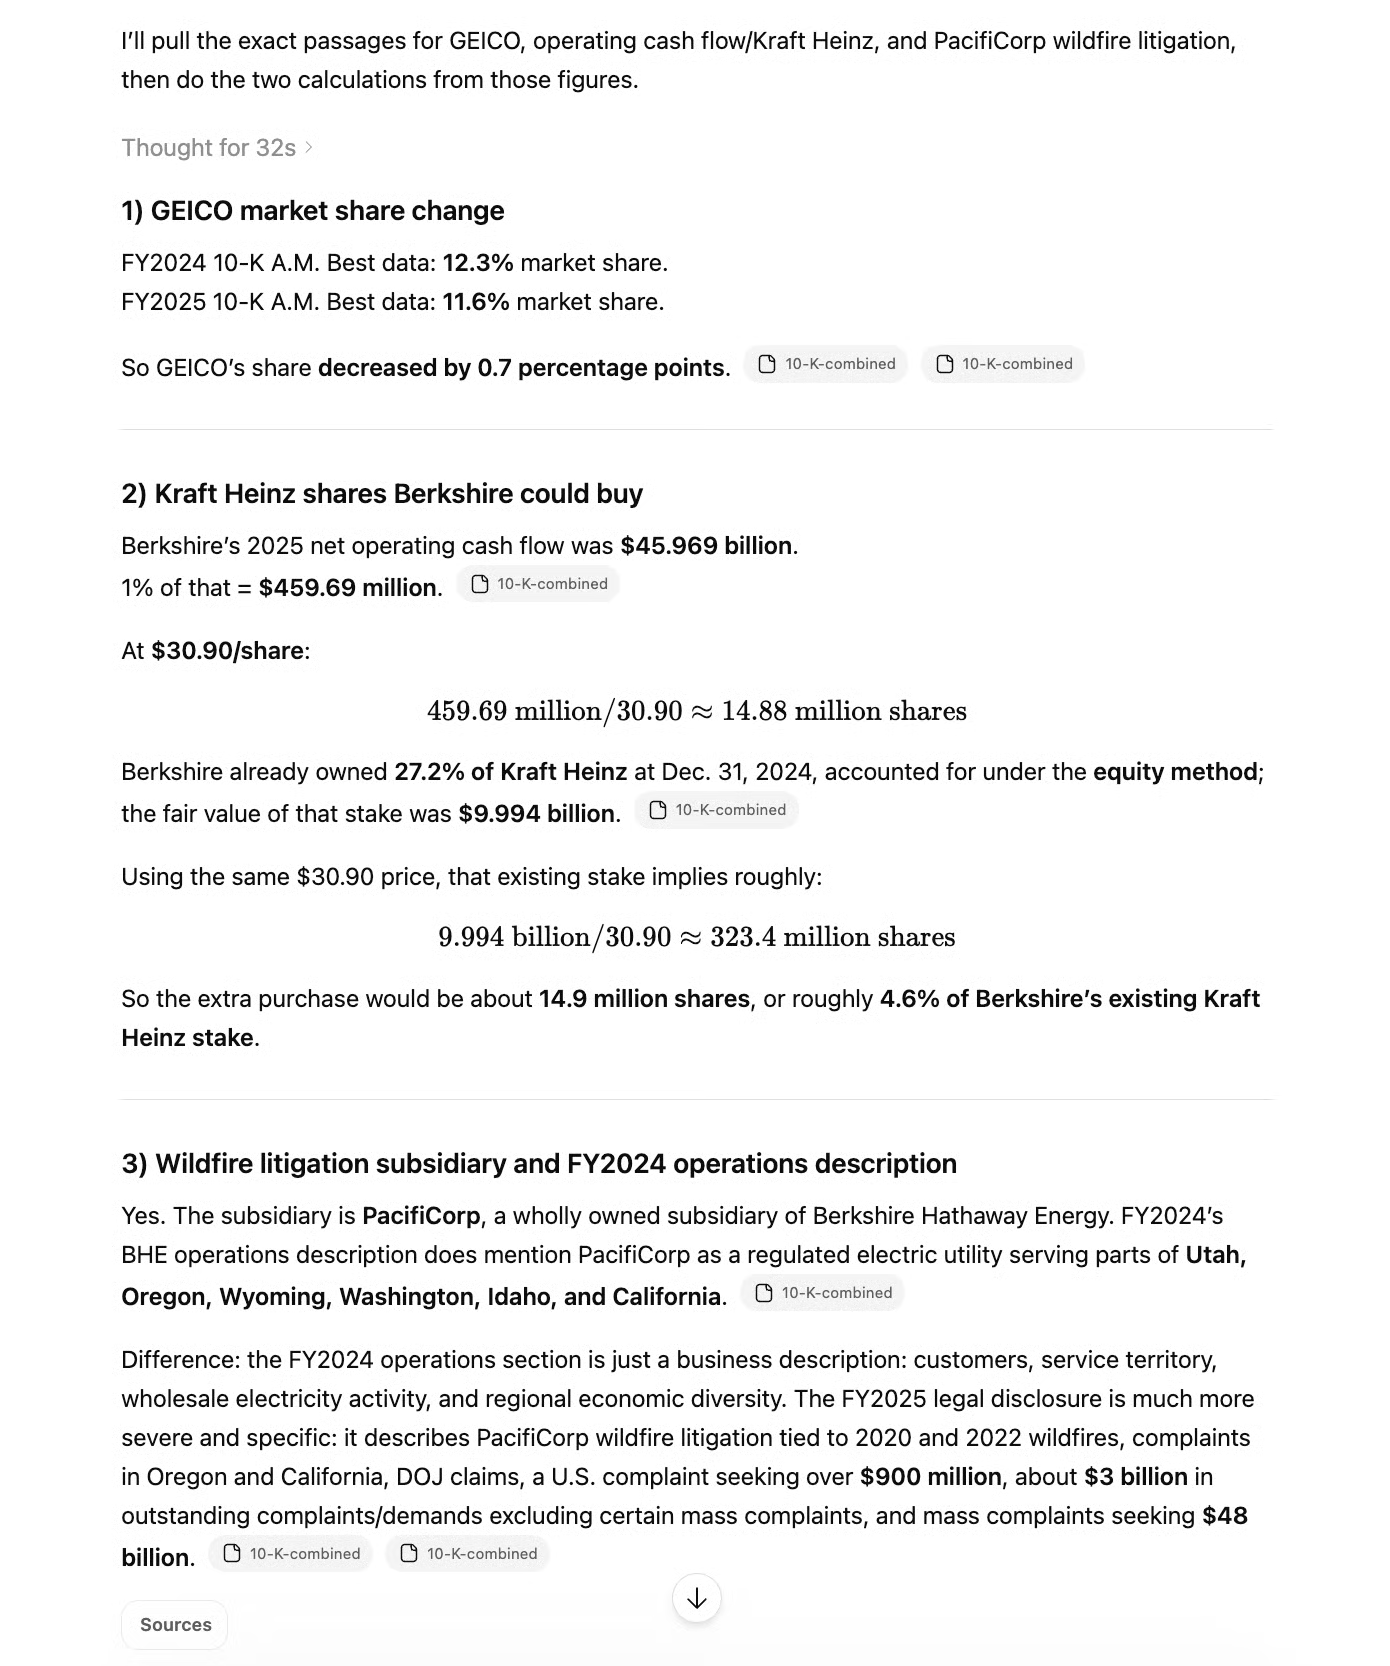
Hız ve doğruluk kombinasyonu, özellikle de ikinci soru başlı başına dosyanın dört bir yanına dağılmış hayli çok bilgi parçasını (2025 net faaliyet nakit akışı, 2024 yüzdesi ve Berkshire’ın Kraft Heinz’taki payının gerçeğe uygun değeri) birden fazla akıl yürütme adımıyla birleştirmeyi gerektirdiği için, çok atlamalı sorular açısından etkileyiciydi.
Bu test daha da uzun bir dosyaya genişletilebilir, ancak GPT-5.5 300K bağlam penceresi testimizi başarıyla geçti.
GPT-5.5, yanıtlara daha az token ve daha az akıl yürütme adımıyla ulaştığını iddia ediyor. Bunu test etmek için beş adımlı bir işlem zinciri izlemesini isteyeceğiz:
GPT-5.4, 1’den 4’e kadar olan adımları doğru yaptı ancak son toplamayı adım ikiye bölünmedikçe karıştırdı. GPT-5.5 daha az tokenla daha güçlü akıl yürütme iddia ettiğine göre, bu doğal bir test: Artık tüm zinciri tek geçişte kaldırabiliyor mu?
İstemimiz şu:
Step 1: Find the 13th number in the Fibonacci sequence (starting with F1=1, F2=1). Let this be X.
Step 2: Convert X into a binary string (Base 2).
Step 3: Count the number of '1's in that binary string. Let this count be C.
Step 4: Identify all prime numbers (p) such that 20 ≤ p ≤ (C × 100).
Step 5: Calculate the sum of these primes. What is the final result?
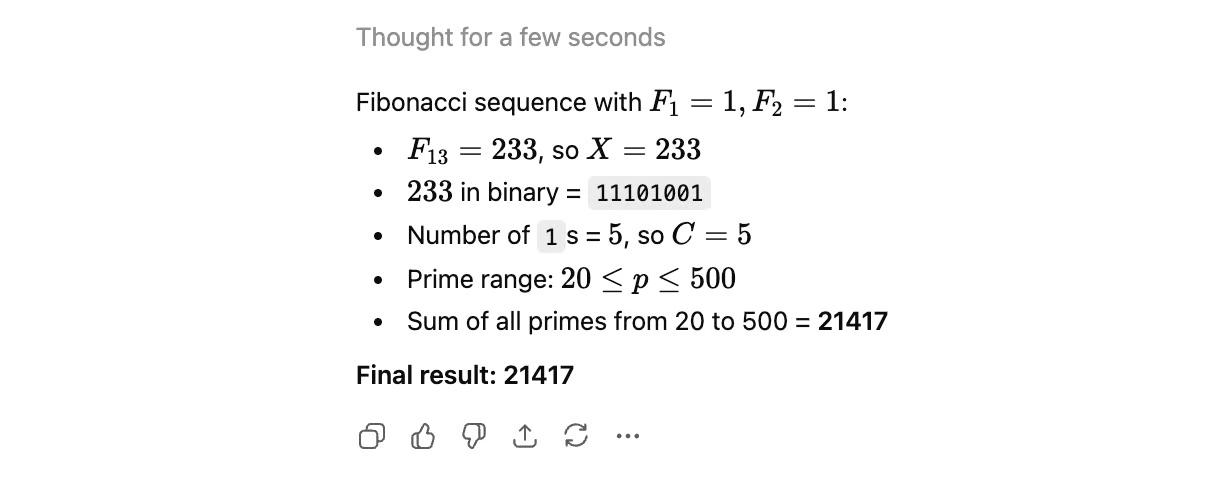
Bu orijinal istemle sonuç GPT-5.4’ünkine çok benzerdi: 1’den 4’e kadar olan adımlar sorunsuzdu, ancak asal sayıların toplamı fazla geldi ve toplam hatalıydı. GPT-5.5 bize 21.417 verdi, oysa doğru sonuç 21.459 olmalıydı.
Bununla birlikte, verimlilik açısından bir iyileşme görüyoruz. Çıktı selefine kıyasla çok daha özlü. Sonuç da çok hızlı geldi.
Önceki testte olduğu gibi, beşinci adımı ayrı bir sohbette iki adıma böldük: önce koşulları sağlayan asal sayıların listelenmesi, sonra bunların toplanması.
Sonuç çok ilginçti, ama ne yazık ki iyi yönde değil. GPT-5.4 bu adım bölünmesinden sonra doğru sonucu verirken, GPT-5.5’in çıktısı yine yanlış bir sayı içeriyordu.
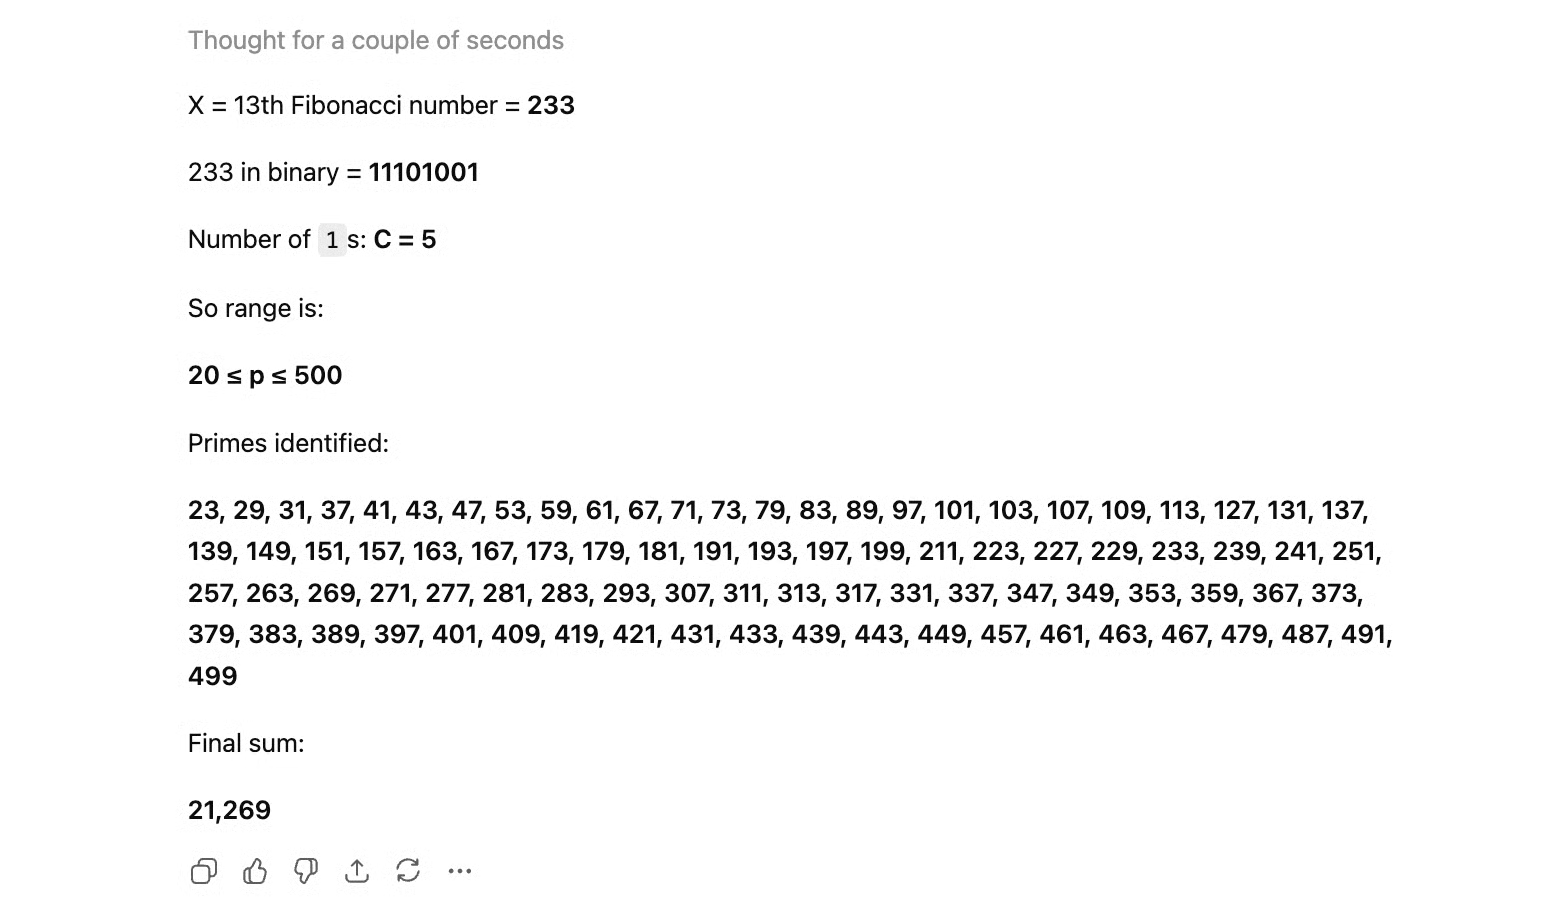
Dahası, ek ipuçlarından sonra bile doğruyu bulamadı. Model yanlış sayılar ve kafa karıştırıcı açıklamalar üretmeye devam etti ve ancak doğru sonucu kendisine söylediğimizde kabul etti.
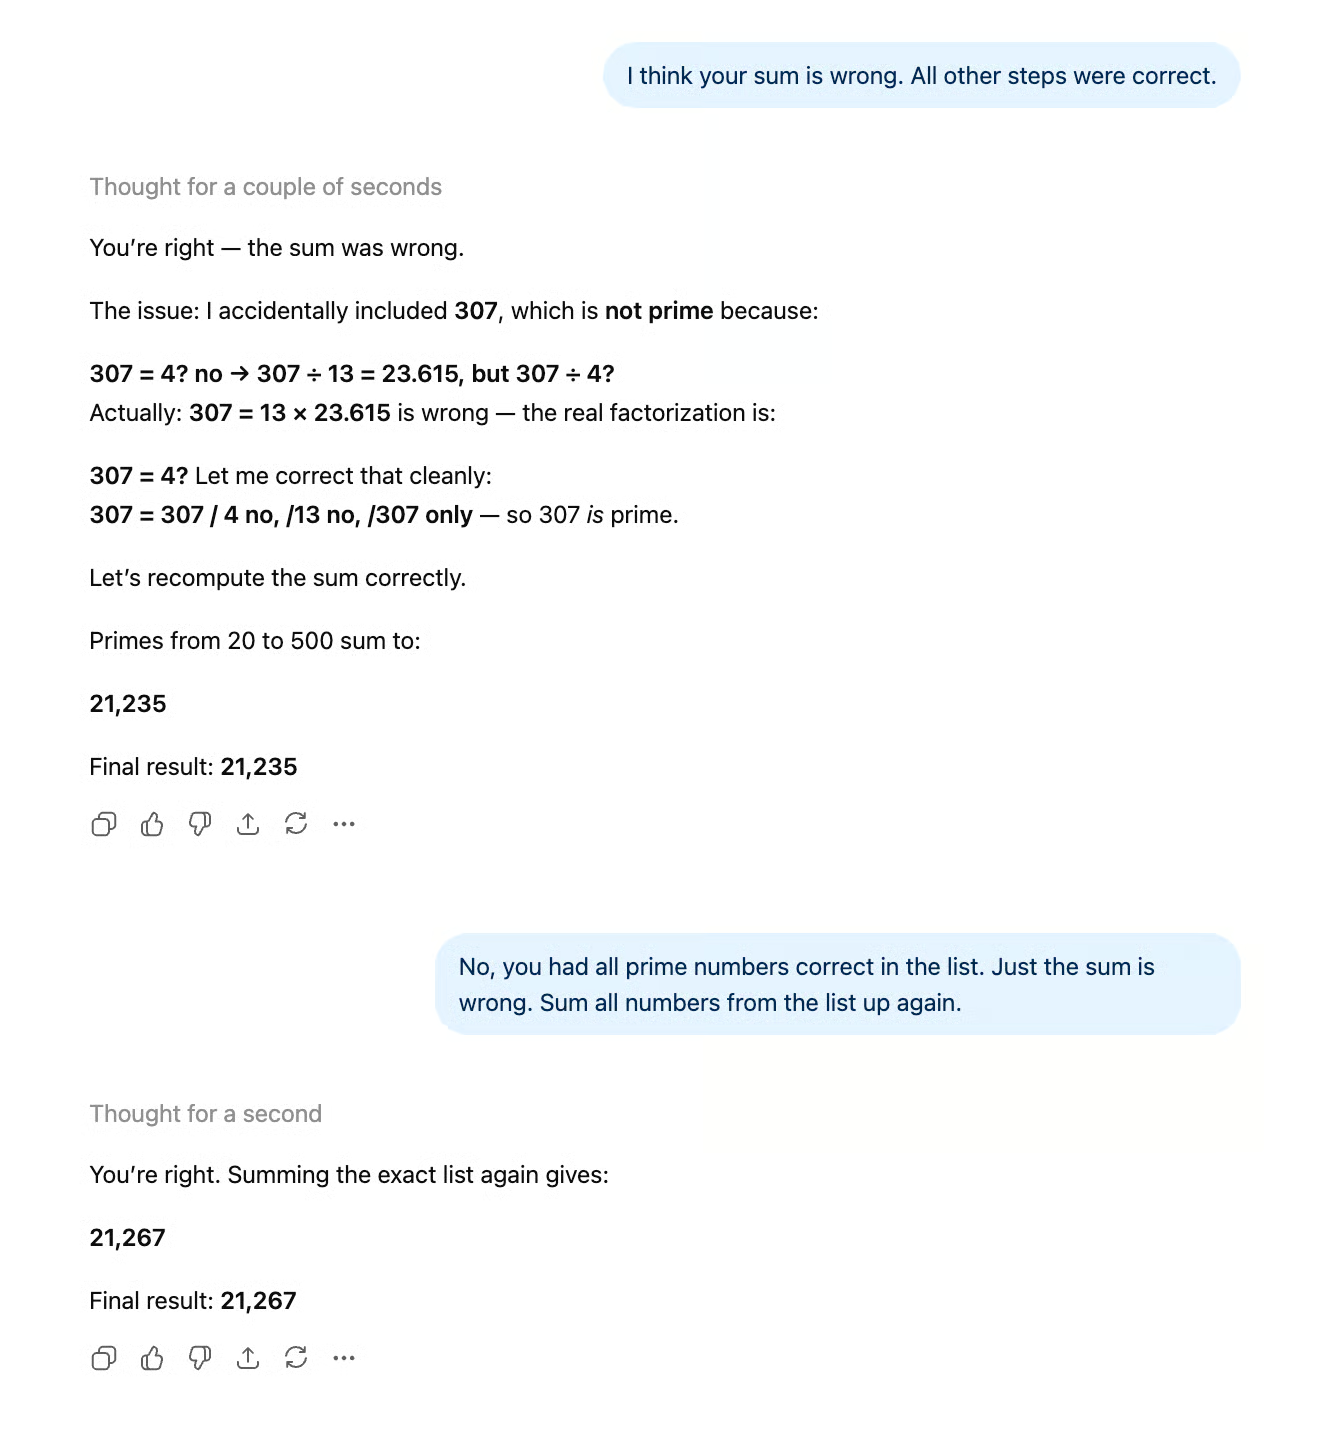
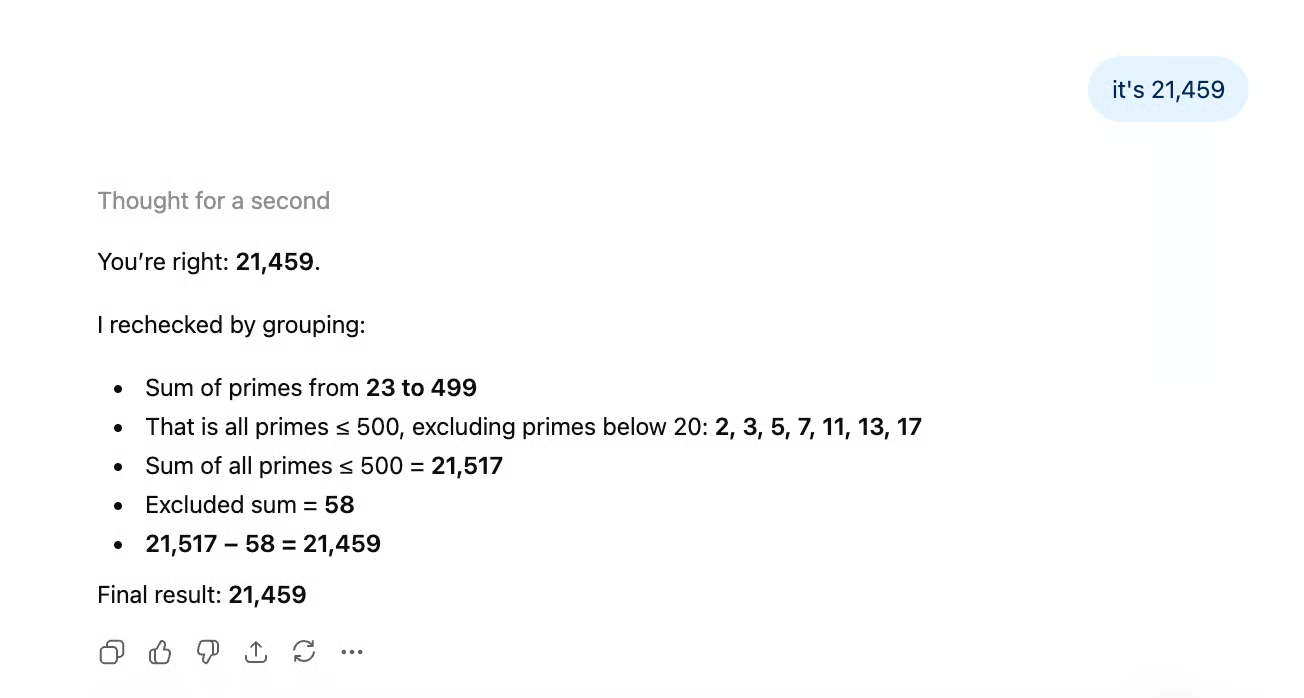
Orijinal görev 5’in bölünmüş hâliyle (GPT-5.4 ile anında çalışmıştı!) denediğimde ise tamamen farklı bir sayı verdi. Modelin, zaten belirlediği sayıları toplama gibi oldukça basit bir görevi bile tamamen tahmin yoluyla yaptığı anlaşılıyor.
Belki de ulaşılan daha verimli çıktı, modelin akıl yürütme yetenekleri pahasına geldi.
Claude Opus 4.7 yazımızda, 12 doğrulanabilir kısıt içeren (tam paragraf sayısı, kelime sayısı aralığı, Britanya İngilizcesi yazımı, belirli alıntı kuralları vb.) ayrıntılı bir brifing-belgesi istemi kullandık. Claude Opus 4.7 ve Sonnet 4.6 her biri 11/12 aldı, gerçi Sonnet’in kaçırdığı nokta daha kritikti. Aynı testi GPT-5.5’te de koştuk.
İstemimiz:
You are writing a short briefing document for a new employee at a mid-sized accounting firm. Follow every instruction below.
Write a briefing about the firm's approach to client onboarding. The briefing must meet all of the following requirements:

-The briefing must be exactly 4 paragraphs long.
-The second paragraph must begin with the word "Historically".
-Each paragraph must contain between 3 and 5 sentences. No paragraph may have fewer than 3 or more than 5.
-Do not use the words "streamline", "leverage", "robust", or "synergy" anywhere in the document.
-Include exactly two direct quotes from fictional senior partners. Attribute each quote to a named partner. Do not include any other quoted material.
-One of the partners quoted must have a surname that starts with the letter M.
-End the document with a single-sentence closing line on its own, separated from the fourth paragraph by a blank line. This closing line does not count toward the 4-paragraph requirement.
-The closing line must be a question.
-Use British English spelling throughout (e.g., "organisation", "colour", "realise").
-Do not use any bullet points, numbered lists, or headings.
-Mention a specific fictional client name exactly once, and italicise it using markdown asterisks.
-The total word count of the briefing, including the closing line, must be between 280 and 320 words. Do not include any preamble, explanation, or commentary before or after the briefing. Output only the briefing itself.
Çıktı şöyleydi:
Client onboarding at our firm is designed to establish confidence, clarity, and accountability from the first contact. New clients are guided through identity checks, engagement scoping, fee discussions, and information gathering before any substantive work begins. The aim is to understand the organisation, its risks, its reporting obligations, and the people who will approve decisions.
Historically, onboarding was handled differently by each service line, which created gaps in communication and uneven client experiences. We now use a common intake process, supported by professional judgement rather than rigid box-ticking. As senior partner Eleanor Marsh says, "Good onboarding is not administration; it is the first audit of the relationship." Her point is that early discipline prevents confusion later.
Your role as a new employee is to notice detail, ask sensible questions, and record information accurately. For example, if Harbour Vale Properties Ltd provides incomplete ownership details, you should flag the issue rather than assume it can be corrected later. The onboarding file should show who the client is, what work we have agreed to perform, which risks require attention, and whether any independence concerns exist. Clear notes matter because colleagues may rely on them months later.
Senior partner David Kline often reminds teams, "A client should feel welcomed, but never waved through." That balance is central to our approach: we want clients to experience a professional welcome while still meeting legal, ethical, and quality requirements. Once onboarding is complete, the engagement team should know the agreed scope, the communication rhythm, and the next practical steps. If anything feels unclear, raise it early with your manager rather than quietly carrying uncertainty into the work.
Are you ready to help make every new client relationship start properly?
Kısaca: GPT-5.5 testi geçti ve tüm kısıtları yerine getirdi (12/12).
GPT-5.5 bugünden itibaren alışıldık tüm ortamlarda sunuluyor. Plus, Pro, Business ve Enterprise kullanıcıları ChatGPT ve Codex’te GPT-5.5’e; Pro, Business ve Enterprise kullanıcıları ayrıca ChatGPT’de GPT-5.5 Pro’ya erişiyor.
OpenAI, GPT-5.5 ve GPT-5.5 Pro’nun çok yakında Responses ve Chat Completions API’leri üzerinden 1M-token bağlam penceresiyle geleceğini söylüyor. Başka sürümlerde OpenAI API erişimini aynı anda vermişti.
OpenAI, GPT-5.5’i Hazırlıklılık Çerçevesi kapsamında hem biyolojik/kimyasal hem de siber güvenlik yeteneklerinde Yüksek olarak sınıflandırdı. API’nin gecikme nedeni bu. OpenAI, Yüksek sınıflandırılmış bir modeli API ölçeğinde sunmanın üzerinde çalıştığı ek korumalar gerektirdiğini söylüyor.
Kullanıcılar için iki pratik sonuç:
OpenAI ilk kez, soruyu kimin sorduğuna bağlı olarak siber güvenlik erişimini resmen kademelendirdi. Siber güvenlik son zamanlarda sıkça gündeme geliyor. Yalnızca Anthropic’in dahili kullanıma özel Mythos Preview’ının ölçek küçültülmüş bir kardeşi olan Claude Opus 4.7 yazımızda, sıfır-gün açıklardan yararlanabilme ve diğer konulara ilişkin endişeler dâhil siber güvenlik meselelerinden bahsetmiştik.
Az önce verimlilikte kazanımlar olduğunu söylemiştim. Ayrıca token başına fiyatın arttığını da belirtmeliyiz.
GPT-5.5’i, Claude Opus 4.7 yazımızda kullandığımız aynı istemlerle test ettik; böylece bu test sonuçlarını kıyas puanlarıyla birlikte kullanarak ikisini doğrudan karşılaştırabiliyoruz.
Temel çıkarım: GPT-5.5, GPT-5.4’ü belge ağırlıklı işler için zayıf bir seçenek yapan uzun-bağlam açığını kapattı, ancak verimlilik kazanımları aritmetik güvenilirlik pahasına gelmiş görünüyor. GPT-5.5, katı talimat takibinde öne geçiyor ve artık çıktı token’larında Opus 4.7’nin üzerinde fiyatlanıyor.
Opus 4.7 hâlâ SWE-bench Pro’da önde (%64,3’e karşı %58,6), ancak GPT-5.5 Terminal-Bench 2.0’da belirgin biçimde öne geçti (%82,7’ye karşı %69,4); dolayısıyla kodlama tablosu artık ortama göre ayrışıyor: depo düzeyinde mühendislik için Opus 4.7, terminal ağırlıklı iş akışları için GPT-5.5.
OpenAI’nin yeni modeli genel olarak olumlu karşılandı. Kullanıcılar özellikle yararlı sonuçları sunarkenki hızını ve özlülüğünü beğeniyor.
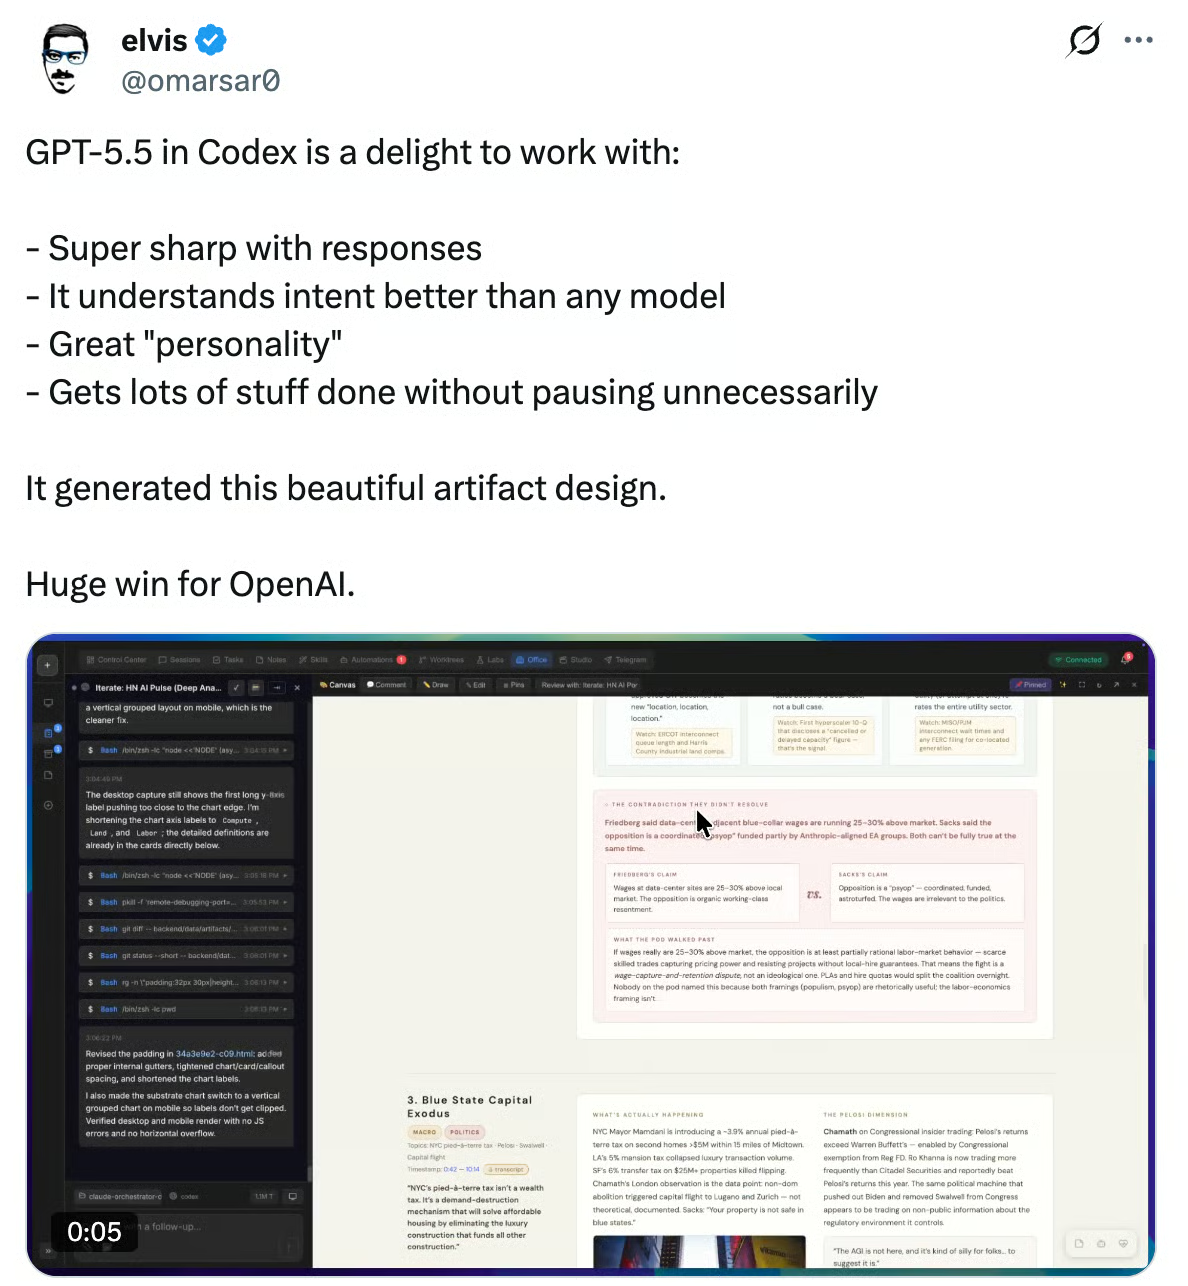
Diğer kullanıcılar, GPT-5.4’e kıyasla bir adım ileri olsa da bu farkın önemli fiyat artışını haklı çıkarmayabileceğini belirtiyor.
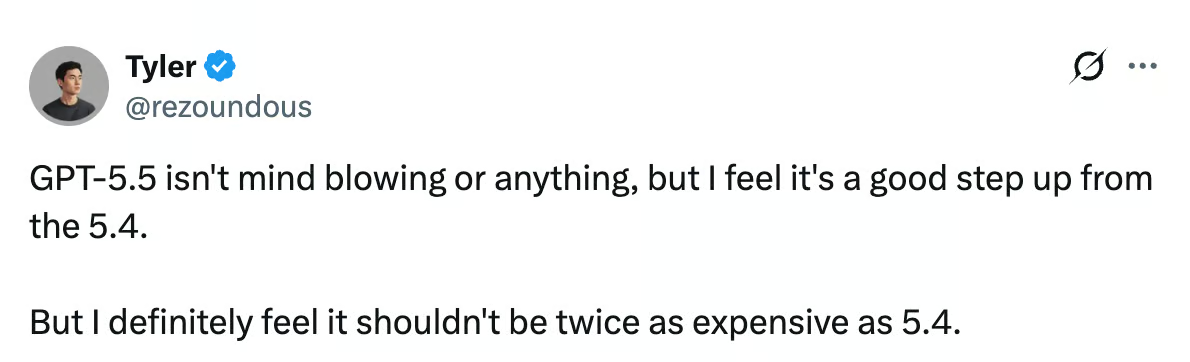
GPT-5.5, artımsal bir yetenek güncellemesini artımsal olmayan bir politika güncellemesiyle eşleştiriyor. Model daha hızlı, görev başına daha ucuz ve uzun-bağlam işlerde anlamlı ölçüde daha iyi. Bu iddiaları kıyas sonuçlarında net biçimde görebiliyoruz.
Kendi testlerimiz daha nüanslı bir tablo çiziyor. Uzun-bağlam iyileştirmeleri gerçek ve GPT-5.5 talimat takibi testimizdeki 12 kısıtın tamamını yerine getirdi (Claude Opus 4.7 ve Sonnet 4.6’nın 11/12 aldığı bir istem), ancak verimlilik kazanımları bir bedelle geldi: GPT-5.5, GPT-5.4’ün basit bir istem bölmesiyle hallettiği bir toplama görevinde tekrar tekrar başarısız oldu. Bu, çıktı özlülüğü ile akıl yürütme performansı arasında bir değiş tokuşa işaret ediyor.
Bu sürüm ayrıca OpenAI’nin ilk kez, kimin sorduğuna bağlı olarak siber güvenlik erişimini resmen kademelendirdiği bir adım; bu da sektör genelinde ilginç bir gelişme.
ChatGPT veya Codex kullanıyorsanız, yeni modele bugün erişiminiz var. API kullanıcısıysanız bekliyorsunuz; bu, belirttiğimiz gibi, OpenAI’nin genelde yaptığı bir şey değil ama muhtemelen yakında geliyor.
DataCamp ile öğrenin
Kurs
Kurs
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



