
Khóa học
Các khái niệm về LLMOps
1 giờ
19.9K
Moonshot AI vừa công bố Kimi K3, mẫu đầu bảng mới nhất trong dòng Kimi và là mô hình open-weight lớn nhất được phát hành cho đến nay (2,8 nghìn tỷ tham số). Toàn bộ trọng số chưa được phát hành. Moonshot cho biết sẽ phát hành trong mười ngày nữa.
Tuy nhiên, số lượng tham số không phải là câu chuyện chính. Moonshot là một startup có trụ sở tại Bắc Kinh được Alibaba hậu thuẫn (đơn vị cũng phát triển các mô hình Qwen, nếu bạn còn nhớ, với Qwen 3.7 là bản mới nhất), và họ đang cạnh tranh để khẳng định vị thế khi DeepSeek và các phòng thí nghiệm Trung Quốc khác dần chiếm lĩnh sân chơi.
Về quy mô, K3 lớn hơn khoảng 75% so với DeepSeek V4. Trên các điểm chuẩn do Moonshot tự thực hiện, nó vượt Claude Opus 4.8 và GPT-5.5, nhưng vẫn xếp sau Claude Fable 5 và GPT-5.6 Sol.
Dấu hiệu quan trọng hơn nằm ở mức giá. K3 tính phí ở mức frontier. Đây là vấn đề đối với các phòng thí nghiệm Mỹ: nếu một mô hình từ Trung Quốc có thể tính cùng mức giá và đạt hiệu năng gần tương đương, điều đó làm suy yếu lập luận rằng giá cao cấp là yếu tố khác biệt của mô hình Mỹ.
Chúng tôi đã đề cập đôi chút về giá và lịch sử. Nhưng chúng ta biết gì về Kimi K3, cách nó được xây dựng và hiệu quả ra sao?
Kimi K3 đặc biệt phù hợp với những gì Moonshot gọi là "kịch bản trí tuệ frontier", tức là lập trình tầm xa, công việc tri thức và suy luận.
Để làm được điều đó, nó hỗ trợ cửa sổ ngữ cảnh 1 triệu token và khả năng hiểu thị giác gốc. Điều thứ hai có nghĩa là nó có thể nhận trực tiếp hình ảnh và video làm đầu vào.
Điều được bàn luận nhiều nhất là phần bề nổi: cửa sổ ngữ cảnh 1 triệu token và khả năng hiểu thị giác gốc, như tôi đã đề cập.
Để đạt được điều đó, Moonshot đã thay đổi backend ở ba mảng:
Mô hình được xây dựng xoay quanh hai thành phần mới: Kimi Delta Attention (KDA), một cơ chế attention tuyến tính lai, và một thứ gọi là Attention Residuals (AttnRes). Cả hai đều nhằm giúp thông tin lan truyền đáng tin cậy hơn qua các chuỗi dài và mạng sâu.
Bên cạnh đó, Moonshot đẩy mạnh độ thưa của thiết lập Mixture-of-Experts với khung "LatentMoE ổn định", kích hoạt một phần nhỏ chuyên gia trong mỗi lượt truyền xuôi. Kết hợp với thay đổi về huấn luyện và dữ liệu, Moonshot cho biết điều này mang lại cho K3 hiệu suất mở rộng cao hơn khoảng 2,5 lần so với tiền nhiệm K2.
Moonshot định vị K3 mạnh ở các công việc kỹ thuật tầm xa: duy trì tác vụ nhiều bước với giám sát tối thiểu, điều hướng các codebase lớn và phối hợp các công cụ terminal.
Họ cũng nhấn mạnh một ngách cụ thể — kết hợp lập trình với suy luận thị giác, như sử dụng ảnh chụp màn hình và phản hồi trực quan để lặp trong phát triển game, công việc frontend hoặc các tác vụ CAD. Có nhiều ví dụ phát triển game bằng Kimi K3, như game lấy cảm hứng từ Paper Mario, một game giao hàng bằng máy bay, và thứ gì đó trông giống Halo.
Moonshot cho biết các đánh giá nội bộ (xây dựng từ quy trình cộng tác agent thực tế thay vì điểm chuẩn công khai) cho thấy biến thể "max" của Kimi K3 đạt mức cải thiện ổn định trên các tác vụ công việc tri thức kiểu sản xuất.
Điều này có nghĩa gì cho người dùng thực tế: tài liệu dài hơn, codebase hoặc video có thể được đưa vào như một đầu vào duy nhất thay vì phải chia nhỏ và ghép lại, và cùng một yêu cầu có thể trộn văn bản, hình ảnh và video mà không cần thêm bước tích hợp.
Nếu các lợi ích về hiệu suất đúng như công bố, bạn sẽ nhận được nhiều năng lực hơn trên mỗi đô la tính toán so với K2.
Tài liệu API phác họa rõ hơn những thay đổi dành cho người trực tiếp xây dựng với mô hình:
Tư duy luôn bật: K3 chạy ở chế độ thinking theo mặc định, được cấu hình qua tham số cấp cao reasoning_effort thay vì cờ thinking cũ của dòng K2. Hiện tại chỉ hỗ trợ mức max.
Streaming với phần suy luận tách rời: Phản hồi dạng stream hiển thị reasoning_content và phần trả lời cuối cùng content dưới dạng các delta riêng, để bạn có thể hiển thị hoặc ẩn phần "suy nghĩ" của mô hình.
Đầu vào thị giác, không chấp nhận URL công khai: Hình ảnh phải được gửi dưới dạng base64 hoặc thông qua tham chiếu tệp đã tải lên; mô hình không chấp nhận URL hình ảnh thuần, và video được xử lý qua một lần tải tệp riêng.
Đầu ra có cấu trúc: Hỗ trợ JSON Schema với chế độ strict, nhưng chỉ ràng buộc trường content cuối cùng, không áp dụng cho vết suy luận.
Chế độ Partial: Bạn có thể gieo trước phần trả lời của trợ lý bằng một tiền tố cố định và để mô hình tiếp tục từ đó. Hữu ích nếu bạn muốn bắt buộc một phần mở đầu cụ thể.
Nạp công cụ động: Định nghĩa công cụ có thể được chèn giữa cuộc hội thoại qua một thông điệp system, và có hiệu lực từ thời điểm đó trở đi.
Tự động lưu đệm ngữ cảnh: Việc lưu đệm là tự động và không cần tham số bổ sung.
Một vài giới hạn khác cần lưu ý khi tích hợp API: max_completion_tokens mặc định là 131.072 và tối đa 1.048.576, và các tham số sampling như temperature và top_p là cố định thay vì cấu hình được.
Kimi cũng rất phù hợp với các tác vụ tự động hóa trình duyệt. Đọc thêm trong hướng dẫn tiện ích mở rộng trình duyệt Kimi của chúng tôi.
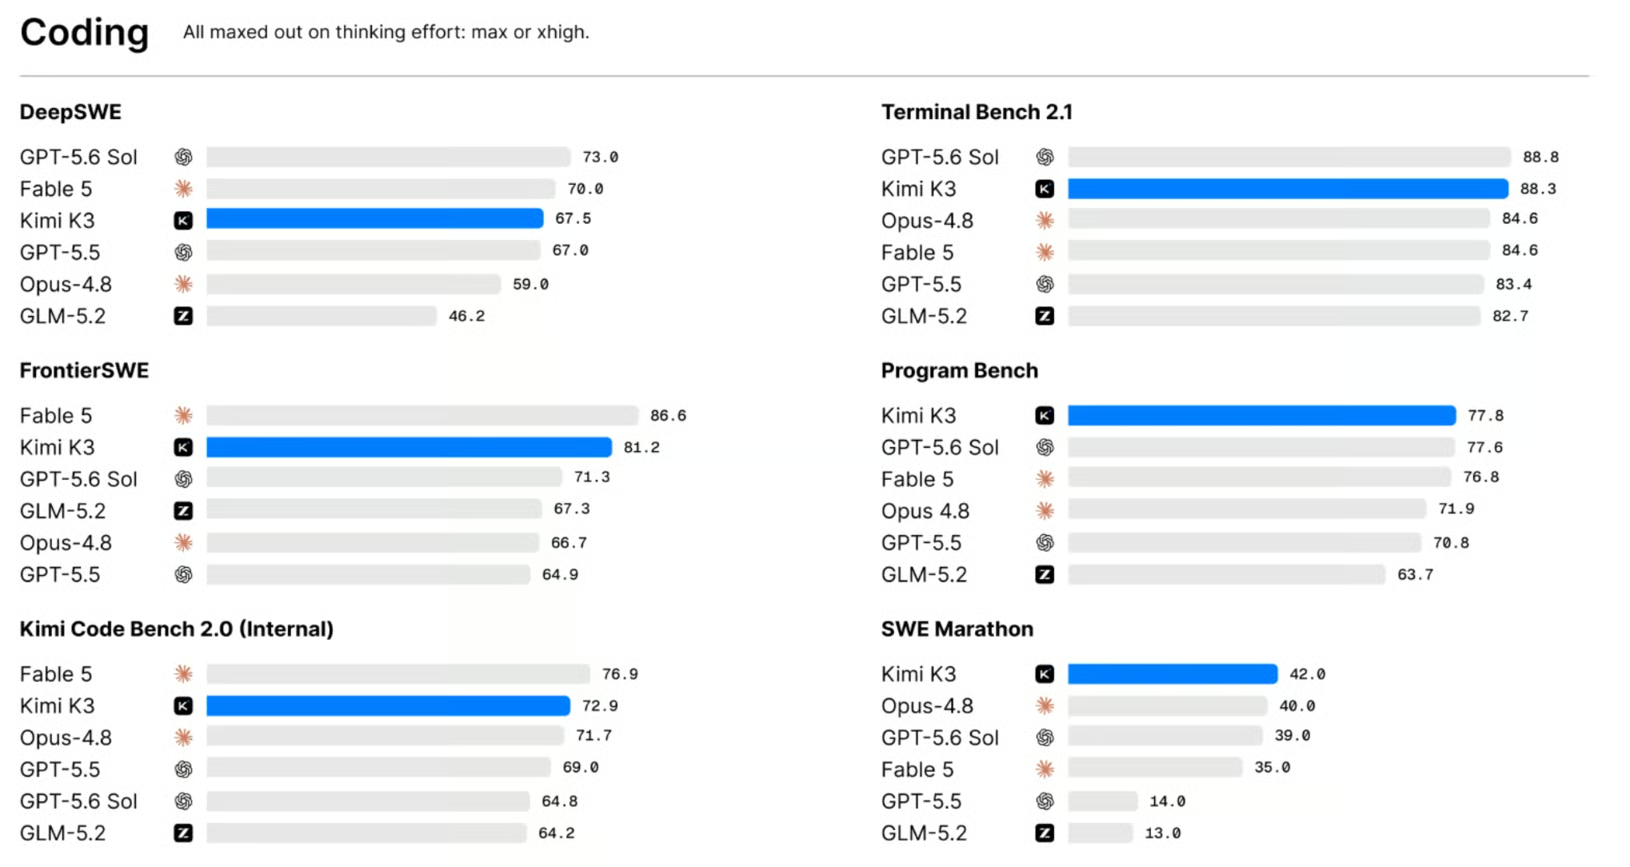
Tài liệu ra mắt của Moonshot hiện có bao gồm các số liệu điểm chuẩn thực, nhưng cần lưu ý các mô hình khác nhau được chạy trong các khung agent khác nhau. K3 được kiểm thử với KimiCode của Moonshot; các mẫu Claude chạy qua Claude Code hoặc Terminus 2; các mẫu GPT chạy qua Codex. Vì vậy, đây không phải là so sánh hoàn toàn sạch. Mỗi mô hình của từng phòng thí nghiệm được kiểm thử trong bộ công cụ thuận lợi nhất của chính họ.
Dưới đây là bức tranh tổng quát trong ba hạng mục.
Như biểu đồ dưới đây cho thấy, K3 không quét sạch các điểm chuẩn lập trình, nhưng cạnh tranh rất mạnh ở hầu hết nơi. Nó dẫn đầu ở Program Bench và SWE Marathon, chỉ kém GPT-5.6 Sol nửa điểm trên Terminal-Bench 2.1, và vượt Opus 4.8 ở đa số bài kiểm thử đơn lẻ. Nơi nó thua rõ ràng là DeepSWE và FrontierSWE, nơi Fable 5 và GPT-5.6 Sol vượt lên.
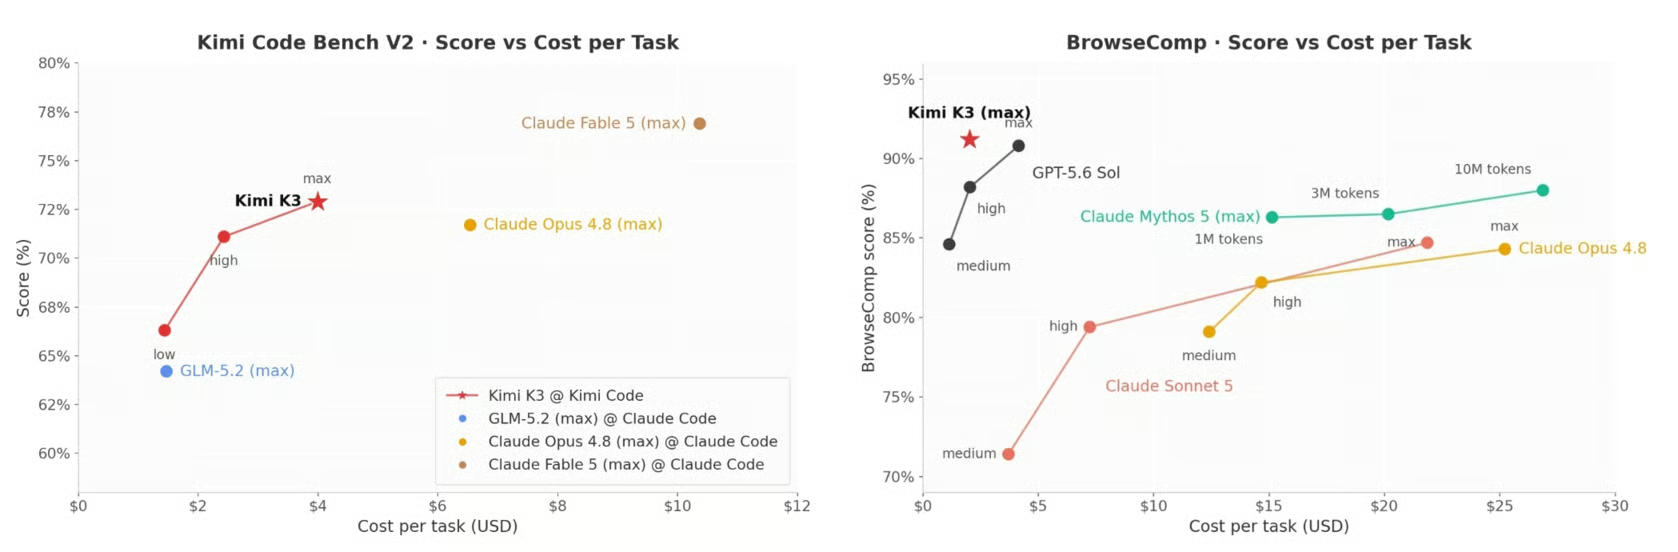
Trên biểu đồ Kimi Code Bench V2 của chính Moonshot, K3 đạt điểm tương tự Opus 4.8 với chi phí mỗi tác vụ vào khoảng một nửa, và còn xa mới chạm mức giá của Fable 5 chỉ để đổi lấy vài điểm cộng. Biểu đồ BrowseComp kể câu chuyện tương tự: K3 đạt điểm cao hơn GPT-5.6 Sol và Claude Fable 5 trong khi chi phí mỗi tác vụ chỉ bằng một phần nhỏ.
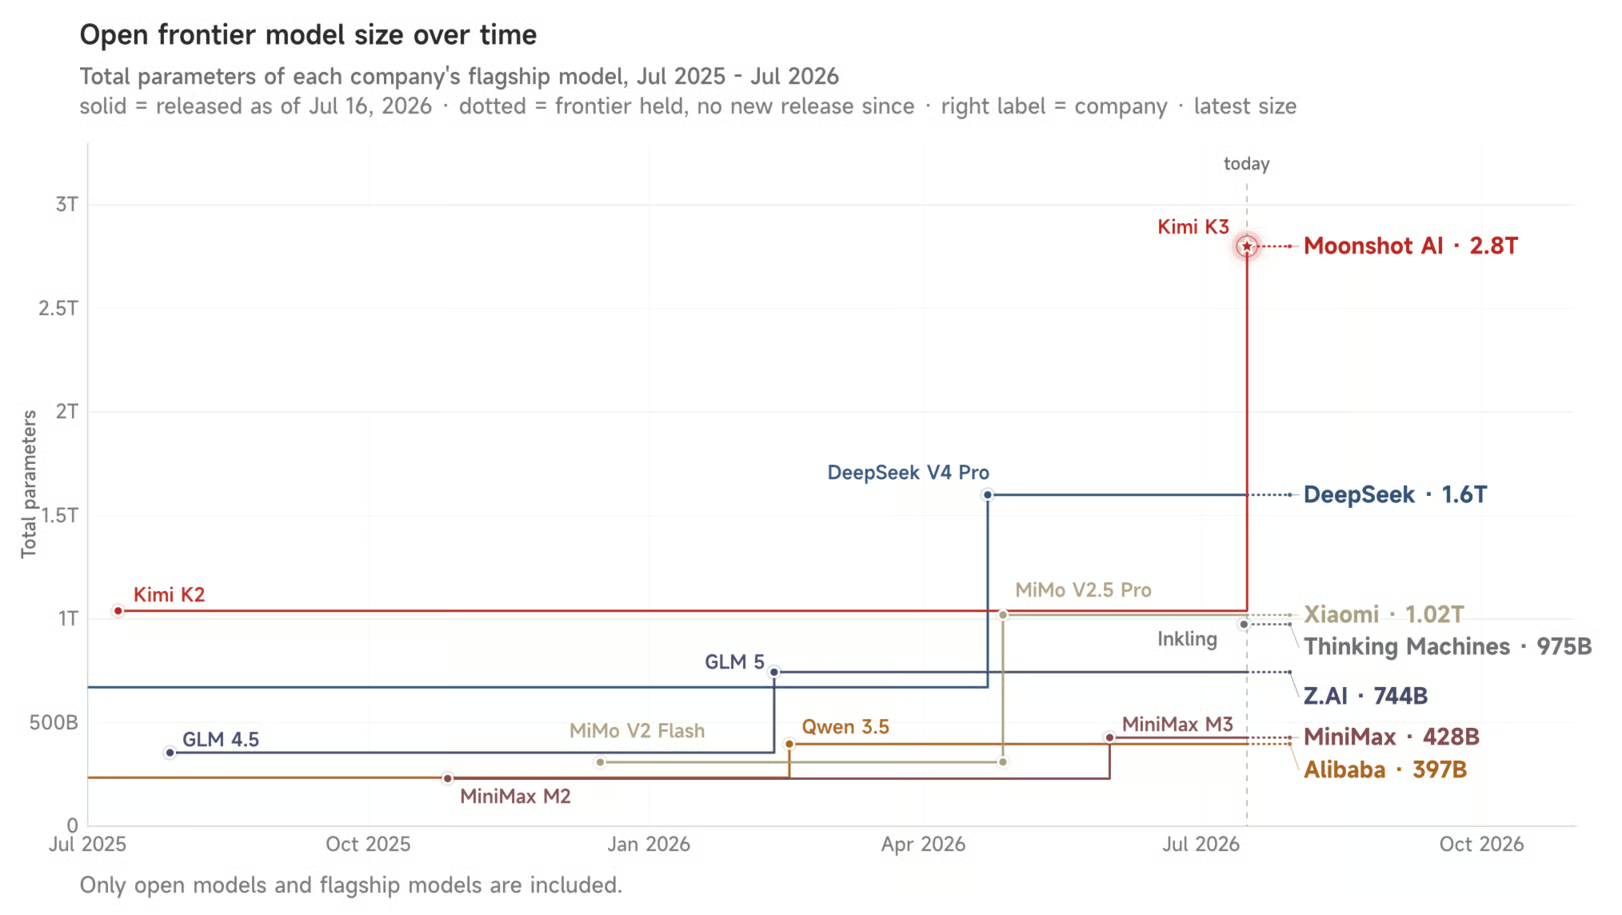
Biểu đồ tham số mô hình là một góc nhìn thú vị. Đây là minh họa rõ ràng nhất cho tuyên bố "mô hình open-weight lớn nhất" ở đầu bài, cho thấy Moonshot nhảy từ 1T tham số của Kimi K2 vượt thẳng DeepSeek, Xiaomi và các bên khác lên 2,8T chỉ trong một bản phát hành.
Dưới đây là cách Kimi K3 đối đầu với các phòng thí nghiệm Trung Quốc khác đang phát hành mô hình hiện nay. Nhìn chung, sân chơi open-weight Trung Quốc dường như đang tách thành hai hướng: các phòng thí nghiệm như DeepSeek và Z.AI vẫn cạnh tranh ở mức giá rẻ, còn Moonshot bắt đầu tính giá cao hơn.
DeepSeek V4 nhỏ hơn K3 và có giá thấp hơn nhiều.
K3 theo đuổi một canh bạc khác: lớn hơn, và Moonshot định giá tương xứng thay vì cố thắng bằng mức giá thấp.
So sánh này thú vị vì Alibaba hậu thuẫn cả Moonshot và dĩ nhiên là dòng Qwen của chính họ.
Tuy nhiên, chúng khác nhau: mẫu đầu bảng của Qwen, Qwen 3.7 Max, hoàn toàn không phải open-weight. Nó đóng, độc quyền và chỉ có thể dùng qua các sản phẩm của Alibaba hoặc các nhà cung cấp API bên thứ ba. Alibaba vẫn phát hành các mô hình Qwen open-weight nhỏ hơn, nhưng mẫu cao cấp nhất đã chuyển sang đóng.
GLM-5.2 gần với "cẩm nang" mã nguồn mở Trung Quốc kiểu cũ: một mô hình thực sự mạnh, cấp phép MIT và có giá thấp hơn nhiều so với mức frontier của phương Tây. Nó nhỏ hơn K3 và rẻ hơn nhiều, và đã có tiếng về hiệu năng lập trình gần mức frontier với chi phí chỉ bằng một phần nhỏ.
Dưới đây là so sánh con số, sử dụng Intelligence Index của Artificial Analysis (điểm tổng hợp từ chín điểm chuẩn, chạy nhất quán giữa các mô hình) làm thước đo:
| Mô hình | Tham số | Ngày phát hành | Intelligence Index | Terminal-Bench 2.1 | Giá ($/M vào / ra) | Open-weight? |
|---|---|---|---|---|---|---|
| DeepSeek V4 Pro | 1,6T (49B hoạt động) | 01 Thg 4, 2026 | 44 | Không được liệt kê độc lập | $0,44 / $0,87 | Có |
| Qwen 3.7 Max (Alibaba) | Không công bố | 20 Thg 5, 2026 | 56,6 | Không so sánh trực tiếp | $2,50 / $7,50 | Không — chỉ API |
| GLM-5.2 (Z.AI) | 744B (40B hoạt động) | 13 Thg 6, 2026 | 51 | 78 | $1,40 / $4,40 | Có |
| Kimi K3 | 2,8T (16/896 chuyên gia hoạt động) | 16 Thg 7, 2026 | 57 | 88,3 | $3,00 / $15,00 | Có |
Có vài điểm cần lưu ý: Qwen 3.7 Max được đưa vào để tham khảo, nhưng như đã nói, nó không phải open-weight, vì vậy không hẳn là đối thủ tương xứng trong so sánh này, nhưng đưa vào bảng để tham chiếu là hợp lý. Ngoài ra, việc kiểm chứng độc lập từ bên thứ ba vẫn đang dần bắt kịp, nên chưa có gì là cuối cùng.
Tiếp theo, hãy xem Kimi K3 so với các mô hình đóng, độc quyền từ Anthropic và OpenAI như thế nào.
Opus 4.8 là mẫu đầu bảng của Anthropic trong nhiều tháng, và theo số liệu của chính Moonshot, K3 nhỉnh hơn ở một số điểm chuẩn đơn lẻ, nhất là lập trình. K3 đạt 88,3 trên Terminal-Bench 2.1 so với 84,6 của Opus 4.8.
Điểm khác biệt lớn hơn là: Opus 4.8 là mô hình đóng. K3 là open-weight, nên khi trọng số được phát hành, bất kỳ ai cũng có thể tự lưu trữ, fine-tune hoặc chạy mà không phụ thuộc vào máy chủ của Moonshot.
Như bạn thấy trong các biểu đồ dưới, K3 nhỉnh hơn Opus 4.8 một điểm trên Intelligence Index, nhưng khoảng cách nới rộng ở các khía cạnh khác: K3 có chi phí mỗi tác vụ khoảng một nửa và phản hồi token đầu tiên nhanh hơn khoảng 20 lần.
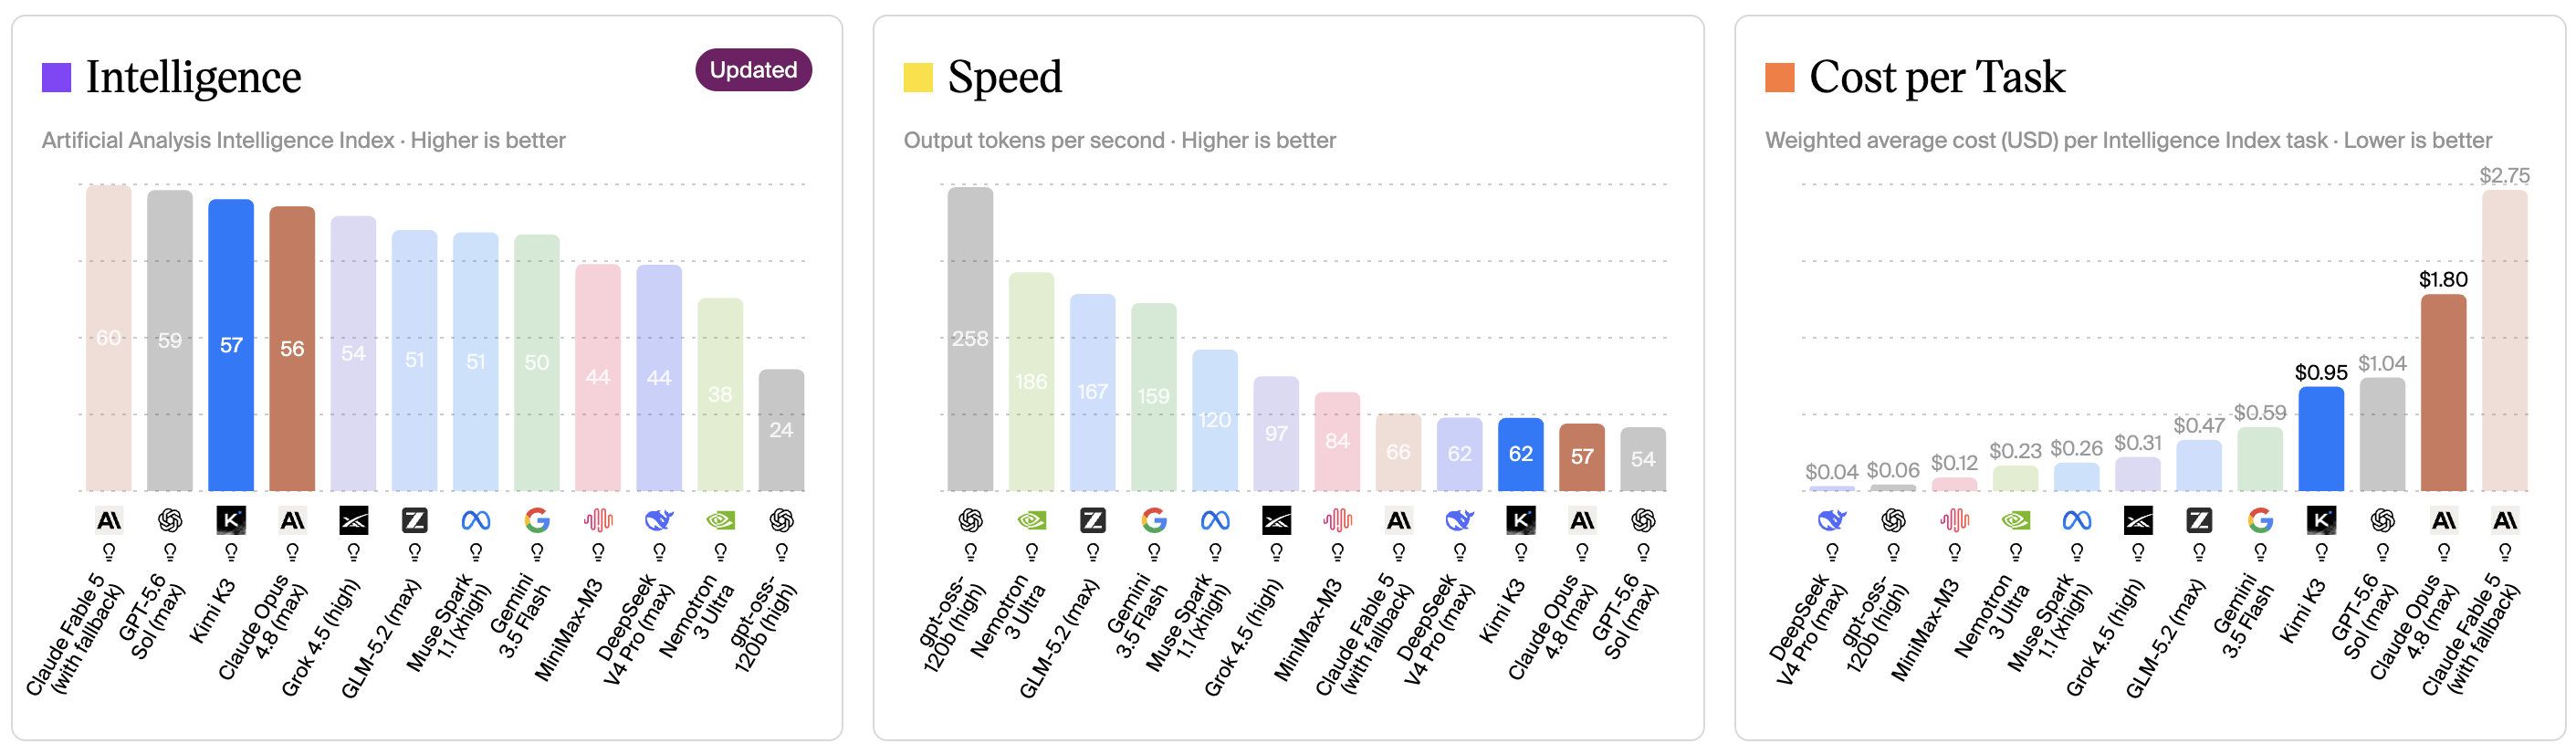
Fable 5 là mô hình mới nhất và mạnh nhất của Anthropic, và đây là đối thủ mà K3 chưa bắt kịp. Fable 5 dẫn trước rõ ràng về tổng thể trí tuệ, và chi phí vận hành cao hơn đáng kể. Fable 5 có giá $10/$50 mỗi triệu token so với $3/$15 của K3. Nhưng thông điệp của K3 không phải "tốt ngang Fable 5" mà là "đạt phần lớn chặng đường, với chi phí chỉ bằng một phần".
Như các biểu đồ dưới cho thấy, Fable 5 dẫn thoải mái trên Intelligence Index, và thậm chí còn hơi nhanh hơn K3 về tốc độ sinh đầu ra thô. Nơi K3 vượt là chi phí. Nó vận hành với mức giá khoảng một phần ba so với Fable 5 cho mỗi tác vụ.
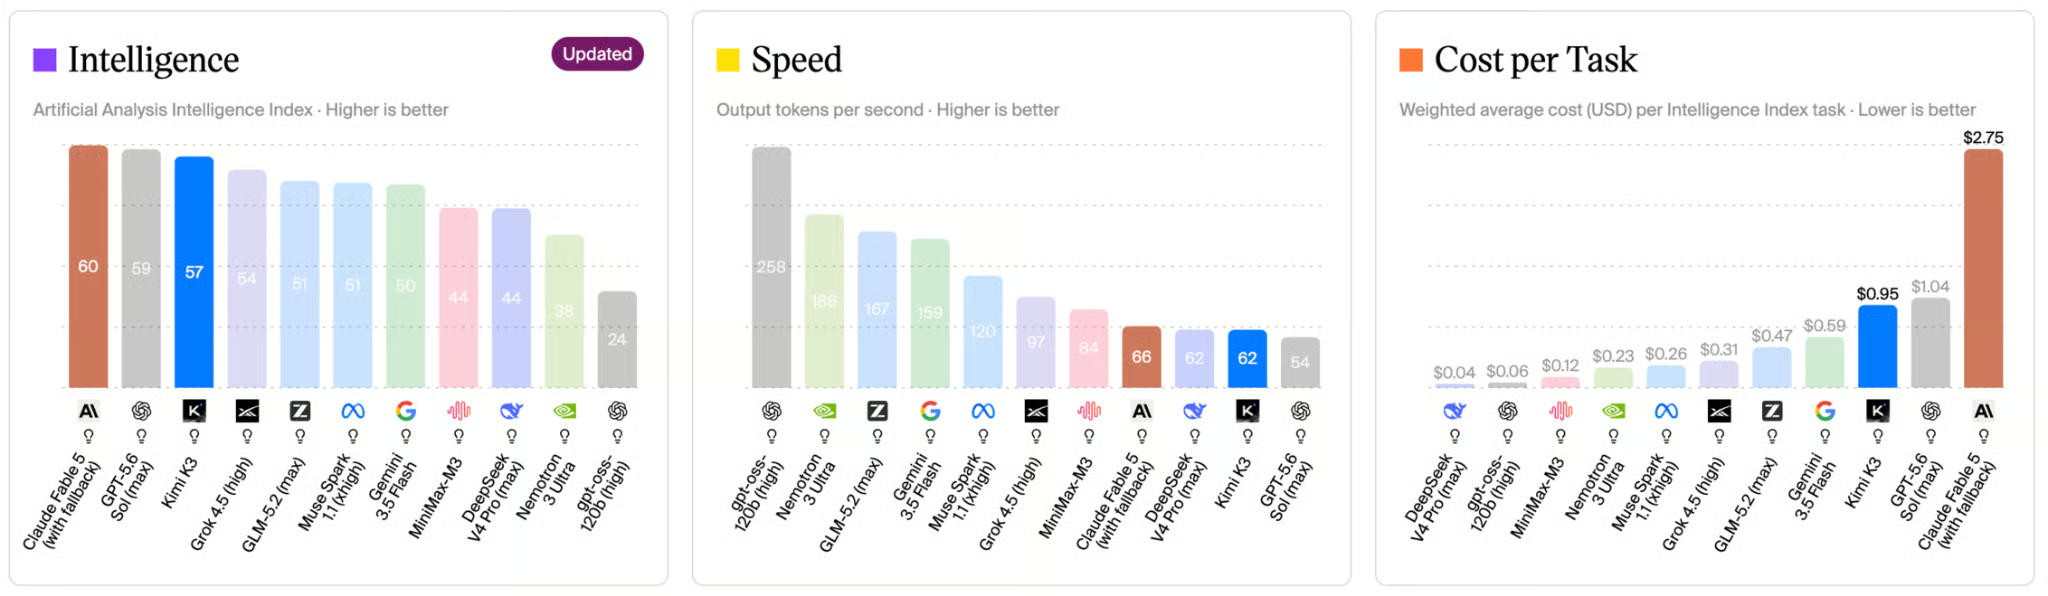
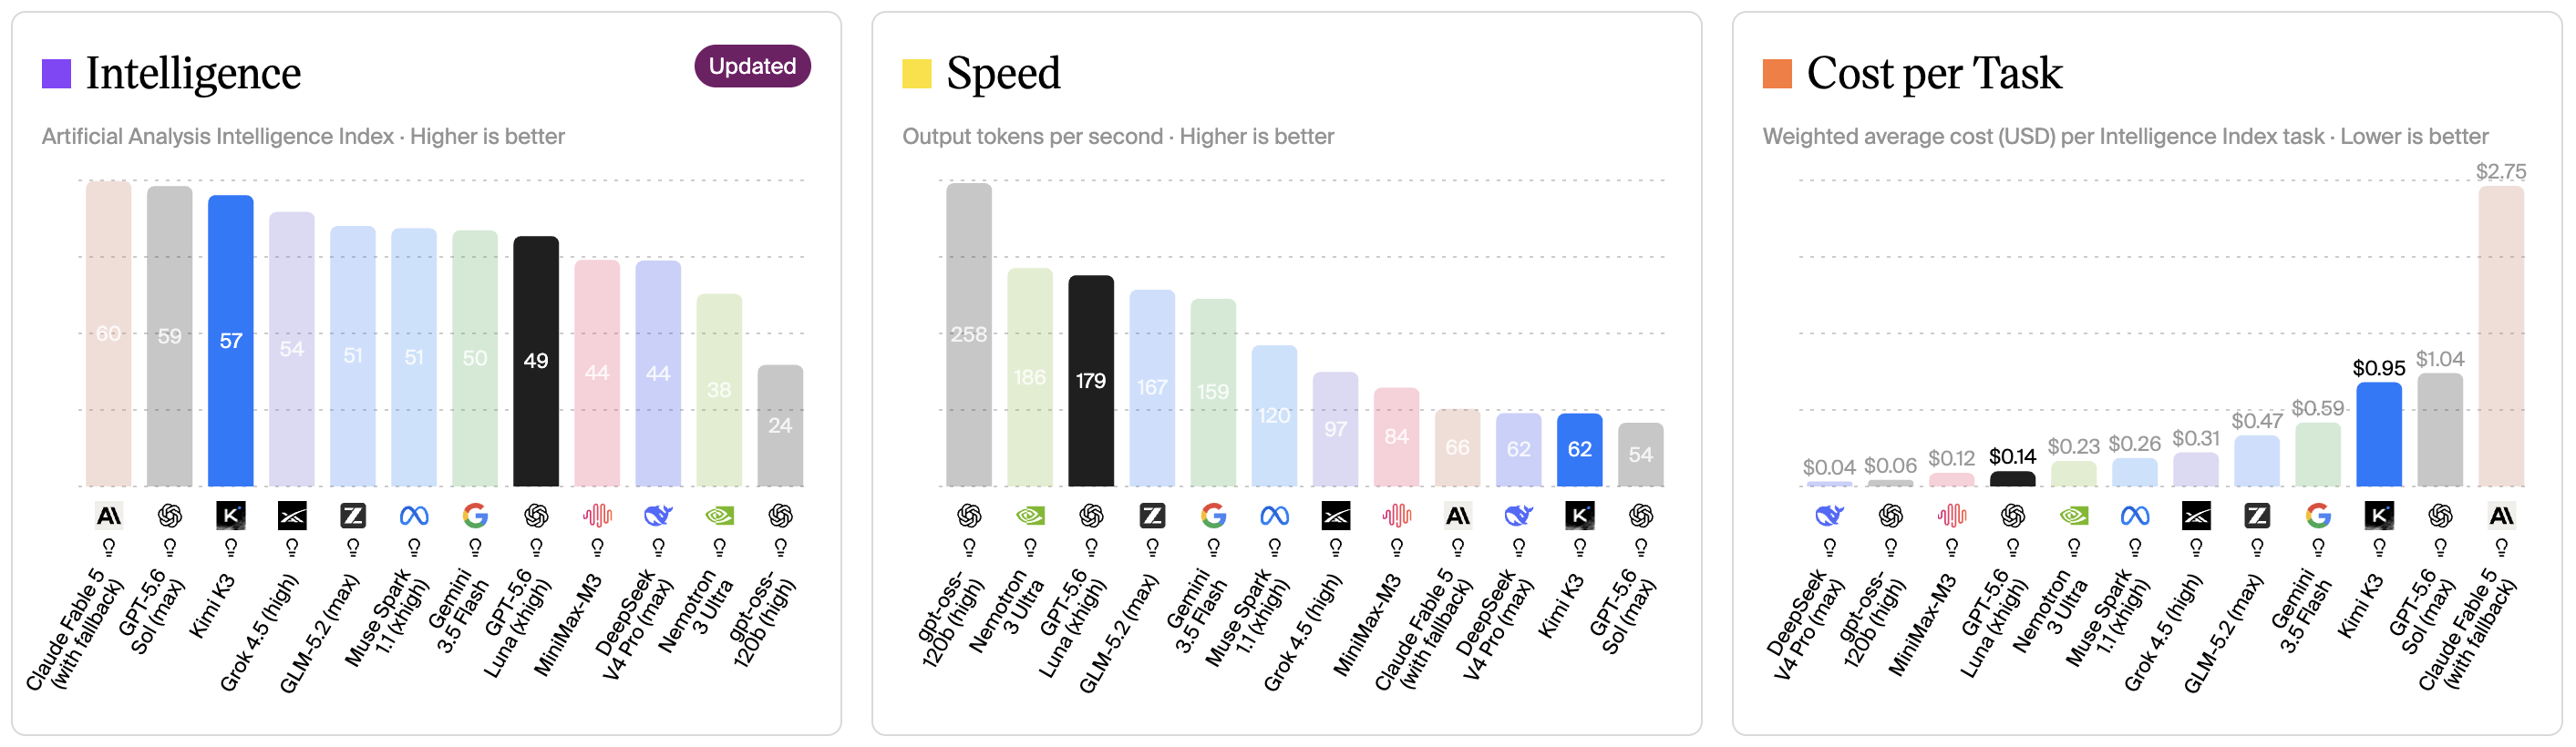
GPT-5.5 xếp ngay dưới K3 theo các điểm chuẩn của Moonshot, và có giá tương tự các mẫu đầu bảng của Mỹ, cao hơn đáng kể so với K3.
Như các biểu đồ dưới cho thấy, K3 nhỉnh hơn GPT-5.5 trên Intelligence Index và rẻ hơn đôi chút mỗi tác vụ. GPT-5.5 thực tế tạo token nhanh hơn một chút khi đã chạy, nên hai bên sẽ hơn kém tùy vào yếu tố bạn coi trọng.
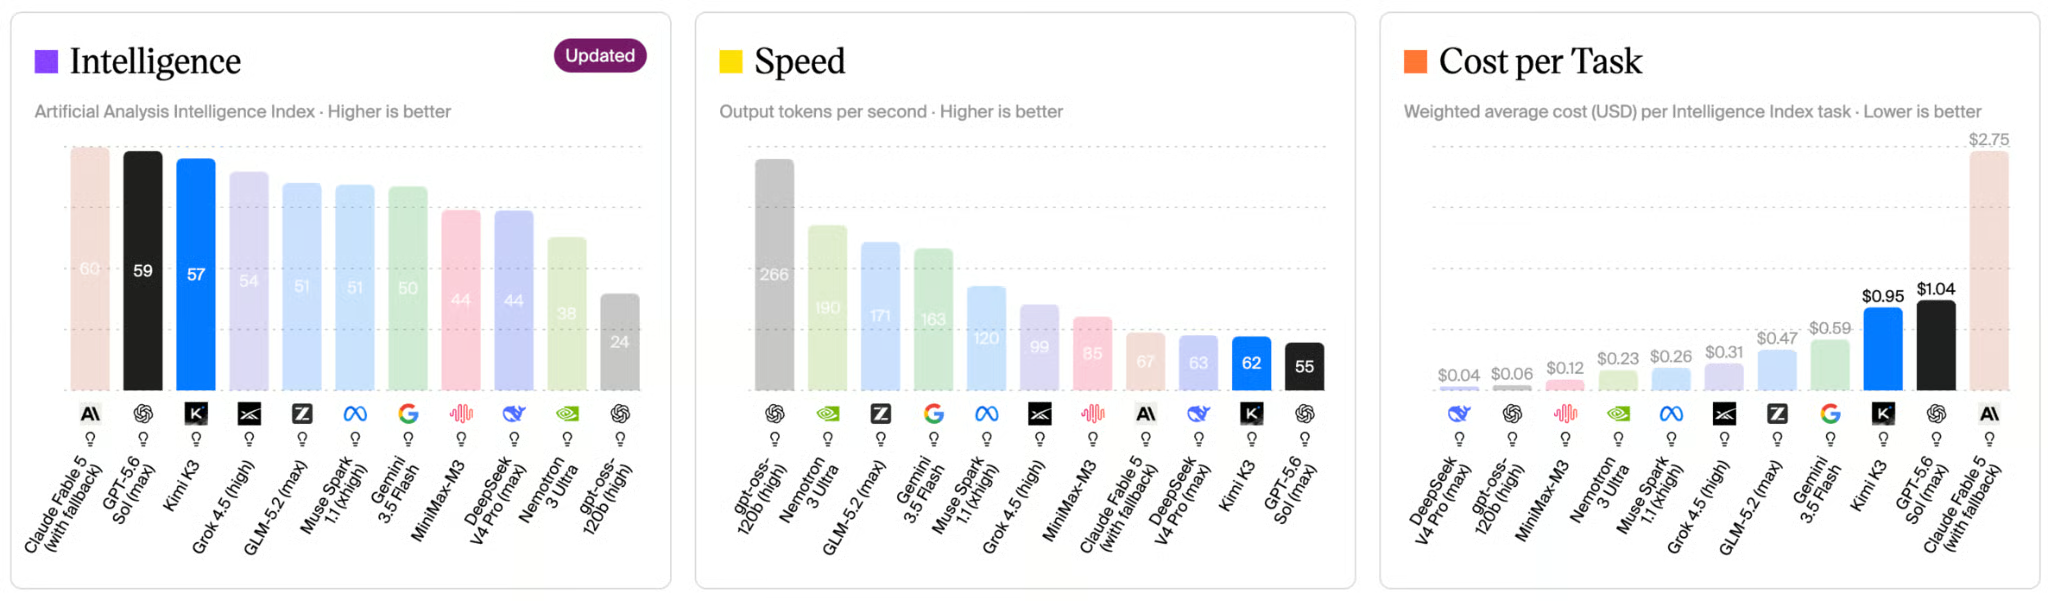
GPT-5.6 Sol là mô hình mới nhất và đắt nhất của OpenAI trong so sánh này, và trên Terminal-Bench 2.1, nó gần như hòa với K3. Sol đạt 88,8 so với 88,3 của K3.
Khác biệt lớn hơn tương tự Opus 4.8: Sol là mô hình đóng, nên bạn chỉ có thể dùng qua các sản phẩm của OpenAI (ChatGPT, Codex, API), trong khi K3 là open-weight. Khi trọng số được phát hành, ai cũng có thể tự lưu trữ hoặc fine-tune.
Như các biểu đồ dưới cho thấy, Sol nhỉnh hơn K3 trên Intelligence Index, nhưng K3 lại vượt về tốc độ và chi phí.
Kimi K3 đã có mặt, nhưng chưa đầy đủ. Bản thân mô hình được ra mắt hôm qua và đã có thể dùng ngay hôm nay qua kimi.com, ứng dụng di động Kimi, Kimi Work, Kimi Code và Kimi API với mã mô hình kimi-k3. Nó cũng đã xuất hiện trên các bộ định tuyến bên thứ ba như OpenRouter và OrcaRouter.
Phần chưa có là chính các trọng số mở. Moonshot nói sẽ phát hành trước ngày 27 tháng 7, 2026, trong khi công ty tiếp tục làm việc với các đối tác suy luận và cộng đồng mã nguồn mở để thống nhất chi tiết kỹ thuật. Cho đến lúc đó, bạn có thể dùng K3 qua các dịch vụ lưu trữ của Moonshot, nhưng chưa thể tải về để tự lưu trữ.
Chúng tôi khuyến nghị đăng ký bản tin AI hàng tuần The Median để cập nhật các đợt phát hành mô hình như thế này.
Về giá, K3 sử dụng hình thức trả theo mức dùng (pay-as-you-go) cố định thay vì phân tầng theo độ dài ngữ cảnh, dù có cửa sổ 1M token. Mức giá chính thức của Moonshot là $0,30 cho mỗi triệu token đầu vào trúng cache, $3,00 cho mỗi triệu token đầu vào trượt cache, và $15,00 cho mỗi triệu token đầu ra — với tỷ lệ trúng cache trên 90% được báo cáo cho các khối lượng công việc lập trình điển hình, giúp giảm chi phí đầu vào thực tế.
Moonshot thẳng thắn trong blog kỹ thuật riêng về các hạn chế:
Kimi K3 là mô hình open-weight lớn nhất được phát hành đến nay. Nó có kiến trúc attention mới nhắm thẳng vào các tác vụ ngữ cảnh dài và tác tử (agentic). Trên các điểm chuẩn đã công bố, nó không phải quán quân tuyệt đối — Fable 5 và GPT-5.6 Sol đều nhỉnh hơn — nhưng cực kỳ cạnh tranh trên các tác vụ lập trình, agentic và đa phương thức với chi phí chỉ bằng một phần.
Đó là mạch xuyên suốt của bài viết: K3 không cố thắng mọi hạng mục. Nó muốn khiến bài toán đánh đổi giá thành so với năng lực trở nên khó bỏ qua, giống như DeepSeek với R1 và GLM-5.2 gần đây — chỉ khác là lần này Moonshot tính giá ở mức frontier thay vì giá chiết khấu.
Học AI với DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
