
कोर्स
LLMOps Concepts
1 घंटा
19.9K
Moonshot AI ने Kimi K3 की घोषणा की है—इसकी Kimi मॉडल लाइन का नवीनतम फ्लैगशिप और अब तक जारी सबसे बड़ा ओपन-वेट मॉडल (2.8 ट्रिलियन पैरामीटर)। पूर्ण वेट्स अभी उपलब्ध नहीं हैं। Moonshot का कहना है कि वे दस दिनों में जारी किए जाएंगे।
हालांकि असली कहानी सिर्फ पैरामीटर गिनती नहीं है। Moonshot बीजिंग स्थित एक स्टार्टअप है, जिसे Alibaba का समर्थन प्राप्त है (जो Qwen मॉडल भी बनाती है—यदि आपको याद हो, नवीनतम Qwen 3.7 है), और DeepSeek तथा अन्य चीनी लैब्स के बीच प्रासंगिकता के लिए प्रतिस्पर्धा कर रहा है।
पैमाने की बात करें तो, K3 लगभग DeepSeek के V4 से लगभग 75% बड़ा है। Moonshot के अपने बेंचमार्क्स पर, यह Claude Opus 4.8 और GPT-5.5 को मात देता है, जबकि Claude Fable 5 और GPT-5.6 Sol से पीछे रहता है।
लेकिन असली संकेत मूल्य निर्धारण है। K3 फ्रंटियर दरें वसूलता है। यही US लैब्स के लिए चुनौती है: यदि कोई चीनी मॉडल वही कीमत ले सकता है और लगभग समान स्तर का प्रदर्शन कर सकता है, तो यह उस धारणा को कमजोर करता है कि प्रीमियम कीमत ही US मॉडलों की अलग पहचान है।
हमने मूल्य निर्धारण और इतिहास के बारे में थोड़ा बताया। लेकिन Kimi K3 के बारे में, यह कैसे बना है, और यह कितना अच्छा काम करता है—हम क्या जानते हैं?
Kimi K3 खासकर उन परिस्थितियों के लिए उपयुक्त है जिन्हें Moonshot "फ्रंटियर इंटेलिजेंस परिदृश्य" कहता है—अर्थात दीर्घ-क्षेत्रफल कोडिंग, ज्ञान-आधारित कार्य, और तर्क क्षमता।
इसी उद्देश्य से, इसमें 10 लाख टोकन का कॉन्टेक्स्ट विंडो और नैटिव विज़ुअल अंडरस्टैंडिंग का समर्थन है। दूसरे शब्दों में, यह सीधे इमेज और वीडियो को इनपुट के रूप में ले सकता है।
सबसे ज्यादा चर्चा सतह पर दिखने वाली चीजों की है: 10 लाख टोकन का कॉन्टेक्स्ट विंडो और नैटिव विज़ुअल अंडरस्टैंडिंग, जिसका मैंने जिक्र किया।
इसे हासिल करने के लिए, Moonshot ने बैकएंड पर तीन क्षेत्रों में बदलाव किए:
मॉडल दो नए अवयवों के इर्द-गिर्द बना है: Kimi Delta Attention (KDA), जो एक हाइब्रिड लीनियर-अटेंशन मैकेनिज्म है, और Attention Residuals (AttnRes) नाम की तकनीक। दोनों का लक्ष्य लंबी श्रृंखलाओं और गहरे नेटवर्क्स में जानकारी के अधिक विश्वसनीय प्रसार में मदद करना है।
इसके अलावा, Moonshot ने अपने Mixture-of-Experts सेटअप की विरलता को "Stable LatentMoE" फ्रेमवर्क के साथ और आगे बढ़ाया है, जिसमें हर फॉरवर्ड पास पर बहुत कम विशेषज्ञ सक्रिय होते हैं। प्रशिक्षण और डेटा बदलावों के साथ मिलकर, Moonshot का दावा है कि इससे K3 को अपने पूर्ववर्ती K2 की तुलना में लगभग 2.5 गुना स्केलिंग दक्षता मिलती है।
Moonshot K3 को दीर्घ-अवधि की इंजीनियरिंग के लिए मजबूत बता रहा है: न्यूनतम निगरानी में बहु-चरणीय कार्यों को जारी रखना, बड़े कोडबेस में नेविगेट करना, और टर्मिनल टूल्स को समन्वित करना।
यह एक खास क्षेत्र को भी उजागर करता है—कोडिंग को विज़ुअल रीज़निंग के साथ जोड़ना, जैसे गेम डेवलपमेंट, फ्रंटएंड कार्य, या CAD कार्यों पर स्क्रीनशॉट्स और विज़ुअल फीडबैक का उपयोग करके इटरेशन करना। Kimi K3 के गेम-डेवलपमेंट के कई उदाहरण हैं, जैसे Paper Mario-प्रेरित गेम, एक प्लेन डिलीवरी गेम, और कुछ जो Halo जैसा दिखता है।
Moonshot का कहना है कि इसकी आंतरिक मूल्यांकनों (जो सार्वजनिक बेंचमार्क्स के बजाय वास्तविक एजेंट-कोलैबोरेशन वर्कफ्लोज़ पर आधारित हैं) में उत्पादन-शैली के ज्ञान कार्यों पर Kimi K3 के "मैक्स" वैरिएंट के लिए लगातार बढ़त दिखती है।
इसका मतलब किसी वास्तविक उपयोगकर्ता के लिए यह है: लंबे दस्तावेज़, कोडबेस, या वीडियो को हिस्सों में तोड़कर जोड़ने के बजाय एक ही इनपुट के रूप में दिया जा सकता है, और उसी अनुरोध में बिना अतिरिक्त जुगत के टेक्स्ट, इमेज और वीडियो मिलाए जा सकते हैं।
यदि दक्षता में ये बढ़तें कायम रहती हैं, तो इसका अर्थ K2 की तुलना में प्रति डॉलर कंप्यूट पर अधिक क्षमता भी होना चाहिए।
API डाक्यूमेंटेशन मॉडल के साथ वास्तव में निर्माण करने वाले लोगों के लिए हुए बदलावों की एक स्पष्ट तस्वीर देता है:
हमेशा‑ऑन थिंकिंग: K3 डिफ़ॉल्ट रूप से थिंकिंग मोड में चलता है, जिसे शीर्ष-स्तरीय reasoning_effort पैरामीटर से कॉन्फ़िगर किया जाता है—K2 लाइन के पुराने thinking फ्लैग की जगह। फिलहाल, केवल max प्रयास स्तर समर्थित है।
अलग किए गए तर्क के साथ स्ट्रीमिंग: स्ट्रीमिंग प्रतिक्रियाएँ reasoning_content और अंतिम‑उत्तर content को अलग‑अलग डेल्टा के रूप में उजागर करती हैं, ताकि आप मॉडल की सोच को दिखा या छिपा सकें।
विज़न इनपुट, कोई पब्लिक URL नहीं: इमेजेस को base64 के रूप में या अपलोडेड फ़ाइल रेफरेंस के जरिए भेजना होगा; मॉडल सादे इमेज URL स्वीकार नहीं करता, और वीडियो अलग फ़ाइल‑अपलोड के माध्यम से संभाले जाते हैं।
स्ट्रक्चर्ड आउटपुट: JSON Schema आउटपुट strict मोड के साथ समर्थित है, लेकिन यह केवल अंतिम content फ़ील्ड को बाध्य करता है, तर्क की ट्रेस को नहीं।
पार्शियल मोड: आप असिस्टेंट के जवाब को किसी तय प्रीफ़िक्स से बीजित कर सकते हैं और मॉडल को वहीं से आगे बढ़ा सकते हैं। यदि आप किसी विशेष शुरुआत को लागू करना चाहते हैं, तो यह उपयोगी है।
डायनेमिक टूल लोडिंग: टूल परिभाषाएँ बातचीत के बीच में system संदेश के जरिए इंजेक्ट की जा सकती हैं, और उसी बिंदु से आगे प्रभावी होती हैं।
स्वचालित कॉन्टेक्स्ट कैशिंग: कैशिंग स्वचालित है और किसी अतिरिक्त पैरामीटर की आवश्यकता नहीं होती।
API एकीकरण करने वालों के लिए कुछ और सीमाएँ ध्यान देने लायक हैं: max_completion_tokens डिफ़ॉल्ट रूप से 131,072 है और अधिकतम 1,048,576 तक जा सकता है, और temperature और top_p जैसे सैंपलिंग पैरामीटर फिक्स्ड हैं, कॉन्फ़िगर करने योग्य नहीं।
Kimi ब्राउज़र ऑटोमेशन कार्यों में भी शानदार है। हमारी Kimi ब्राउज़र एक्सटेंशन ट्यूटोरियल में और पढ़ें।
Moonshot की लॉन्च सामग्री अब वास्तविक बेंचमार्क संख्याएँ शामिल करती है, लेकिन यह ध्यान रखना होगा कि अलग‑अलग मॉडलों को अलग‑अलग एजेंट हार्नेस में चलाया गया। K3 को Moonshot के अपने KimiCode से टेस्ट किया गया; Claude मॉडलों को Claude Code या Terminus 2 से; और GPT मॉडलों को Codex से। इसलिए यह एक क्लीन तुलना नहीं है। हर लैब के मॉडल को उसके अपने बेस्ट‑केस टूलिंग में परखा गया है।
तीन श्रेणियों में इसका समग्र स्वरूप इस प्रकार है।
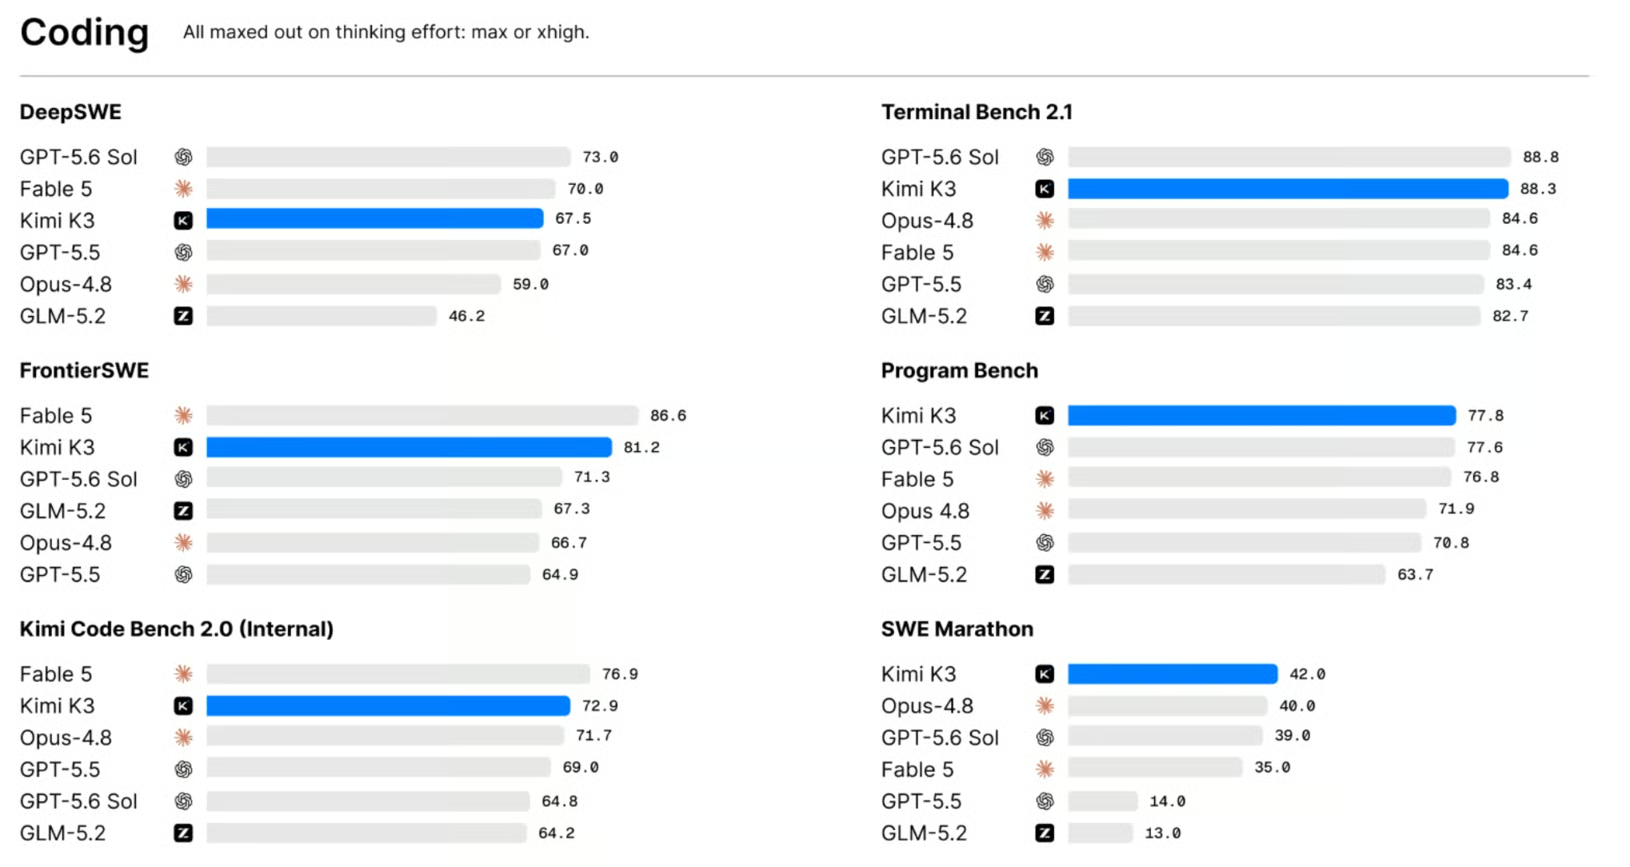
जैसा कि नीचे के चार्ट में दिखता है, K3 कोडिंग बेंचमार्क्स में झाड़ू नहीं लगाता, पर लगभग हर जगह प्रतिस्पर्धी है। यह Program Bench और SWE Marathon पर सीधे आगे है, Terminal-Bench 2.1 पर GPT-5.6 Sol से आधे अंक के भीतर आता है, और अधिकांश व्यक्तिगत परीक्षणों पर Opus 4.8 को पछाड़ता है। जहाँ यह साफ हारता है, वे DeepSWE और FrontierSWE हैं, जहाँ Fable 5 और GPT-5.6 Sol आगे निकलते हैं।
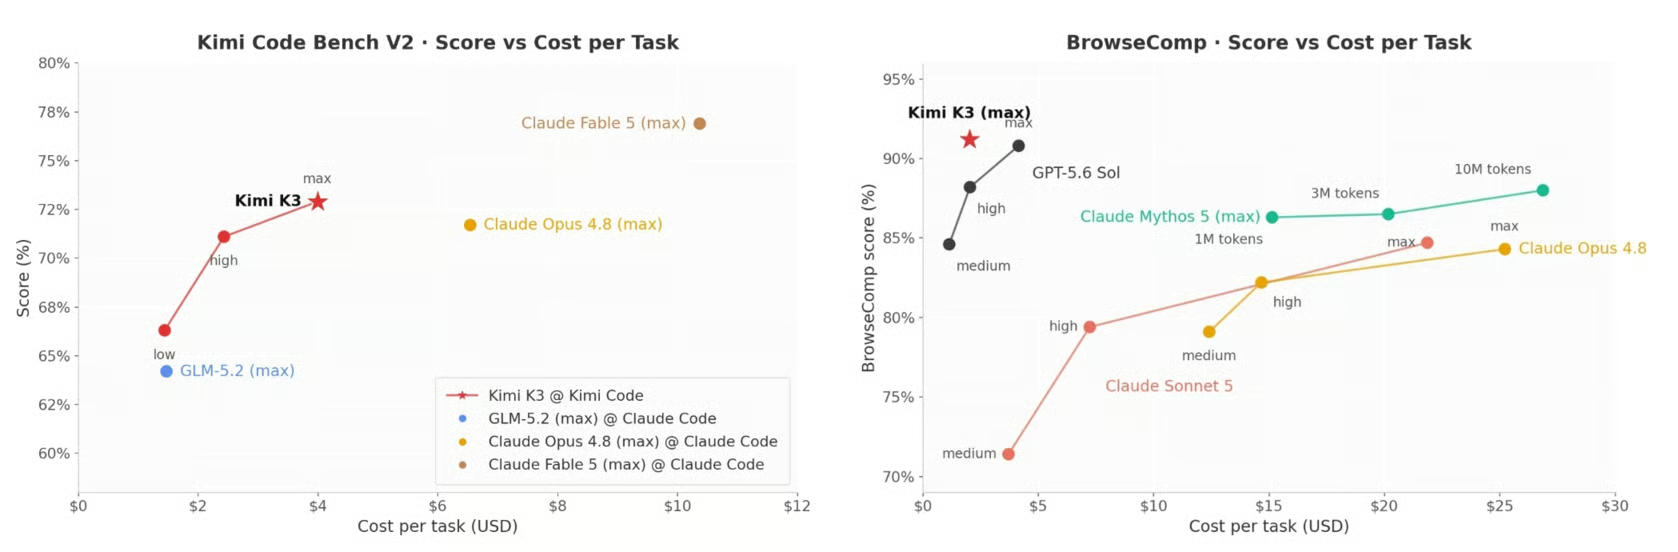
Moonshot के अपने Kimi Code Bench V2 चार्ट पर, K3 लगभग Opus 4.8 के समान स्कोर हासिल करता है, प्रति कार्य लागत लगभग आधी रखते हुए, और कुछ अतिरिक्त अंकों के लिए Fable 5 जितना महँगा तो बिल्कुल नहीं। BrowseComp चार्ट भी यही कहानी बताता है: K3 GPT-5.6 Sol और Claude Fable 5 से ऊँचा स्कोर करता है, जबकि प्रति कार्य लागत का एक अंश ही लगता है।
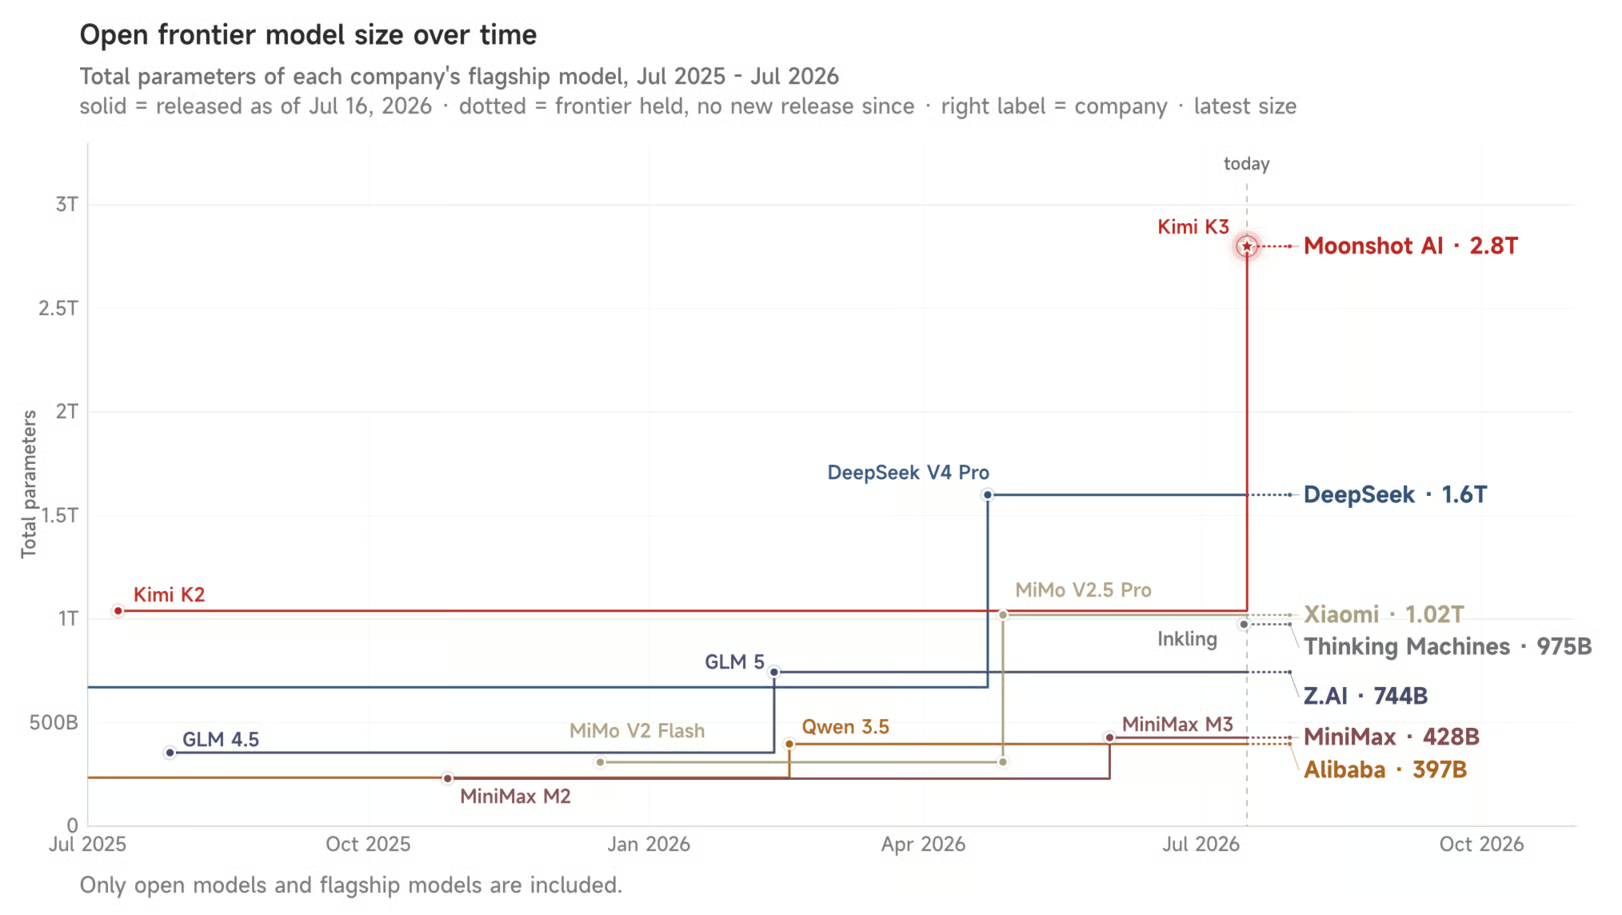
मॉडल पैरामीटर चार्ट एक दिलचस्प नज़रिया देता है। यह इस लेख की शुरुआत में किए गए "सबसे बड़ा ओपन-वेट मॉडल" दावे का सबसे स्पष्ट दृश्य है—यह दिखाता है कि Moonshot Kimi K2 के 1T पैरामीटर से सीधे DeepSeek, Xiaomi और बाकी सबको पार करते हुए एक ही रिलीज़ में 2.8T पर पहुँच गया।
यहाँ देखें कि अभी मॉडल जारी कर रही अन्य चीनी लैब्स के मुकाबले Kimi K3 कैसा है। उच्च स्तर पर, ऐसा लगता है कि चीनी ओपन-वेट परिदृश्य दो हिस्सों में बँट रहा है: DeepSeek और Z.AI जैसी लैब्स अभी भी सस्ते होने पर प्रतिस्पर्धा कर रही हैं, और Moonshot ऊँची कीमतें लेने लगा है।
DeepSeek V4 आकार में K3 से छोटा है और इसकी कीमत भी काफी कम है।
K3 एक अलग दांव लगा रहा है: यह बड़ा है, और Moonshot कीमत भी उसी के अनुरूप वसूल रहा है—भाव पर जीतने की कोशिश नहीं।
यह तुलना दिलचस्प है क्योंकि Alibaba Moonshot और, स्वाभाविक ही, अपनी Qwen लाइन—दोनों का समर्थन करता है।
फिर भी वे अलग हैं: Qwen का फ्लैगशिप, Qwen 3.7 Max, बिल्कुल भी ओपन-वेट नहीं है। यह क्लोज़्ड, स्वामित्व वाला है, और केवल Alibaba के अपने उत्पादों या तृतीय‑पक्ष API होस्ट्स के माध्यम से उपयोग किया जा सकता है। Alibaba छोटे ओपन-वेट Qwen मॉडल जारी करता रहा है, पर उसका टॉप‑टियर मॉडल अब बंद दरवाज़ों के पीछे चला गया है।
GLM-5.2 पुरानी चीनी ओपन‑सोर्स रूपरेखा के अधिक निकट है: सचमुच मजबूत मॉडल, MIT-लाइसेंस्ड, और पश्चिमी फ्रंटियर दरों से काफी नीचे मूल्य पर। यह K3 से छोटा और बहुत सस्ता है, और अपनी लागत के एक अंश पर लगभग‑फ्रंटियर कोडिंग प्रदर्शन की प्रतिष्ठा बना चुका है।
यहाँ देखें कि संख्याएँ कैसे तुलनात्मक रूप से रखी जाती हैं—मापक के रूप में Artificial Analysis के Intelligence Index (नौ बेंचमार्क्स से बना समग्र स्कोर, मॉडलों में समान तरीके से चलाया गया) का उपयोग करते हुए:
| मॉडल | पैरामीटर्स | रिलीज़ तिथि | इंटेलिजेंस इंडेक्स | Terminal-Bench 2.1 | कीमत ($/M इन / आउट) | ओपन‑वेट? |
|---|---|---|---|---|---|---|
| DeepSeek V4 Pro | 1.6T (49B सक्रिय) | Apr 24, 2026 | 44 | स्वतंत्र रूप से सूचीबद्ध नहीं | $0.44 / $0.87 | हाँ |
| Qwen 3.7 Max (Alibaba) | प्रकटीकरण नहीं | May 20, 2026 | 56.6 | सीधे तौर पर तुलनीय नहीं | $2.50 / $7.50 | नहीं — केवल API |
| GLM-5.2 (Z.AI) | 744B (40B सक्रिय) | Jun 13, 2026 | 51 | 78 | $1.40 / $4.40 | हाँ |
| Kimi K3 | 2.8T (896 में से 16 एक्सपर्ट सक्रिय) | Jul 16, 2026 | 57 | 88.3 | $3.00 / $15.00 | हाँ |
कुछ बातें नोट करने लायक हैं: Qwen 3.7 Max संदर्भ के लिए शामिल है, लेकिन जैसा कि मैंने कहा, यह वास्तव में ओपन‑वेट नहीं है, इसलिए यह इस तुलना में सच्चा समकक्ष नहीं है—फिर भी तालिका में इसे रेफरेंस के रूप में शामिल करना उचित लगा। साथ ही, स्वतंत्र, तृतीय‑पक्ष सत्यापन अभी सभी जगह पकड़ बना रहा है, इसलिए कुछ भी अंतिम नहीं है।
अब देखें कि Anthropic और OpenAI के क्लोज़्ड, स्वामित्व वाले मॉडलों के मुकाबले Kimi K3 कैसा ठहरता है।
Opus 4.8 महीनों से Anthropic का फ्लैगशिप रहा है, और Moonshot के अपने आँकड़ों पर, K3 कई व्यक्तिगत बेंचमार्क्स—खासकर कोडिंग—पर इसे पीछे छोड़ देता है। Terminal-Bench 2.1 पर K3 का स्कोर 88.3 है, जबकि Opus 4.8 का 84.6।
लेकिन बड़ा अंतर यह है: Opus 4.8 क्लोज़्ड है। K3 ओपन‑वेट है, इसलिए वेट्स आते ही कोई भी इसे सेल्फ‑होस्ट, फाइन‑ट्यून, या Moonshot के सर्वर पर निर्भर हुए बिना चला सकता है।
जैसा कि नीचे के ग्राफ़्स में दिखता है, इंटेलिजेंस इंडेक्स पर K3, Opus 4.8 से एक अंक आगे है, लेकिन बाकी जगह अंतर बढ़ जाता है: K3 प्रति कार्य लागत में लगभग आधा पड़ता है और पहले टोकन तक पहुँचने में करीब 20 गुना तेज़ है।
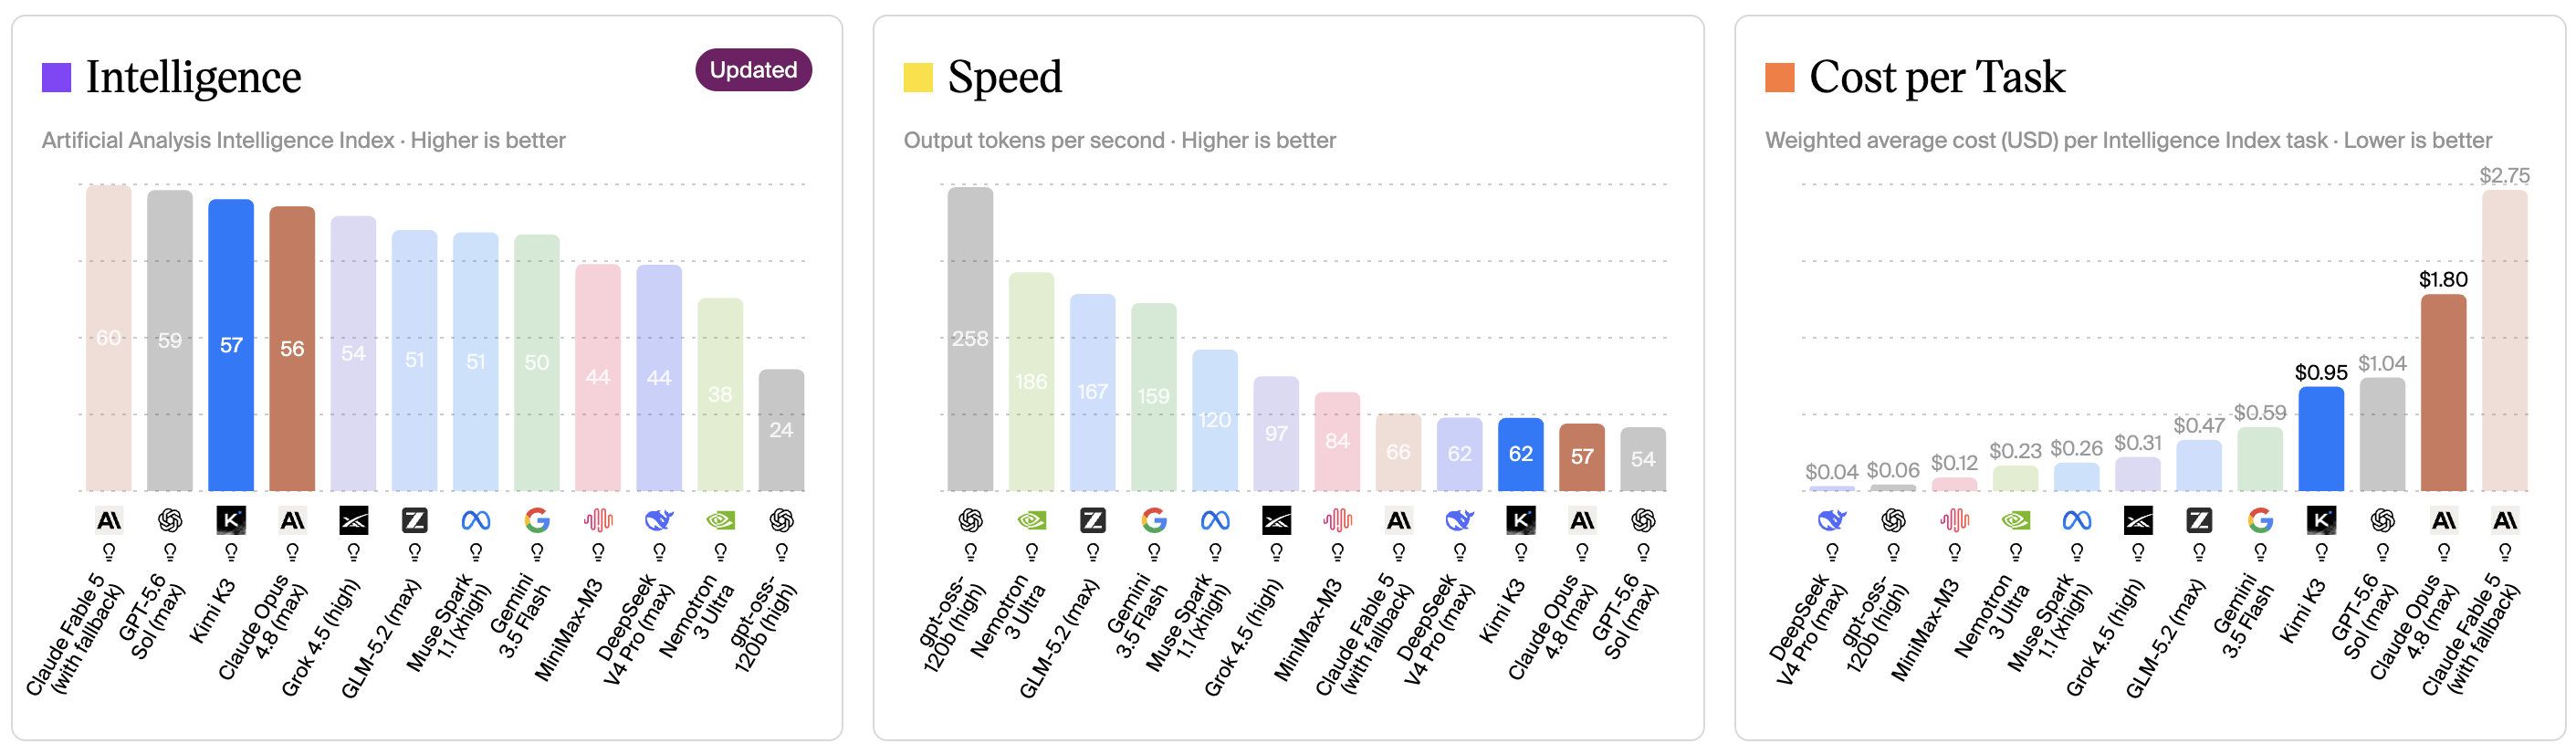
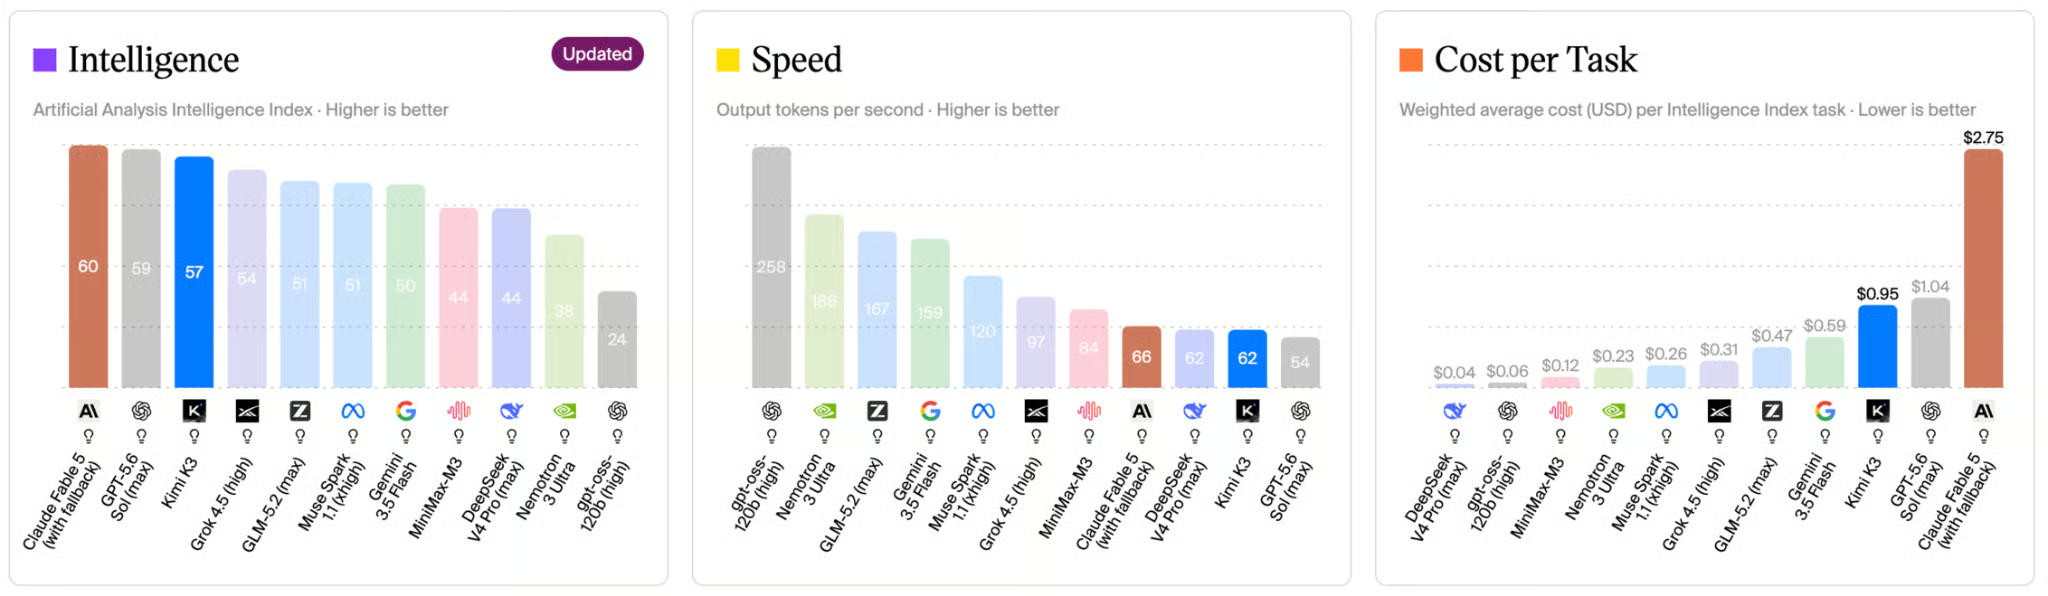
Fable 5 Anthropic का नवीनतम और सबसे सक्षम मॉडल है, और यही वह है जिसे K3 नहीं पकड़ता। यह समग्र इंटेलिजेंस में स्पष्ट रूप से आगे है, और इसे चलाने की लागत भी काफी अधिक है। Fable 5 की कीमत $10/$50 प्रति मिलियन टोकन है, जबकि K3 की $3/$15। लेकिन यहाँ K3 की पेशकश "Fable 5 जितना अच्छा" नहीं है, बल्कि "कीमत के एक अंश पर लगभग उतनी ही क्षमता" है।
जैसा कि नीचे के ग्राफ़्स में दिखता है, इंटेलिजेंस इंडेक्स पर Fable 5 आराम से आगे है, और कच्ची आउटपुट स्पीड पर यह K3 से थोड़ा तेज़ भी है। जहाँ K3 आगे निकलता है, वह लागत है—यह प्रति कार्य लगभग Fable 5 की कीमत का एक तिहाई पड़ता है।
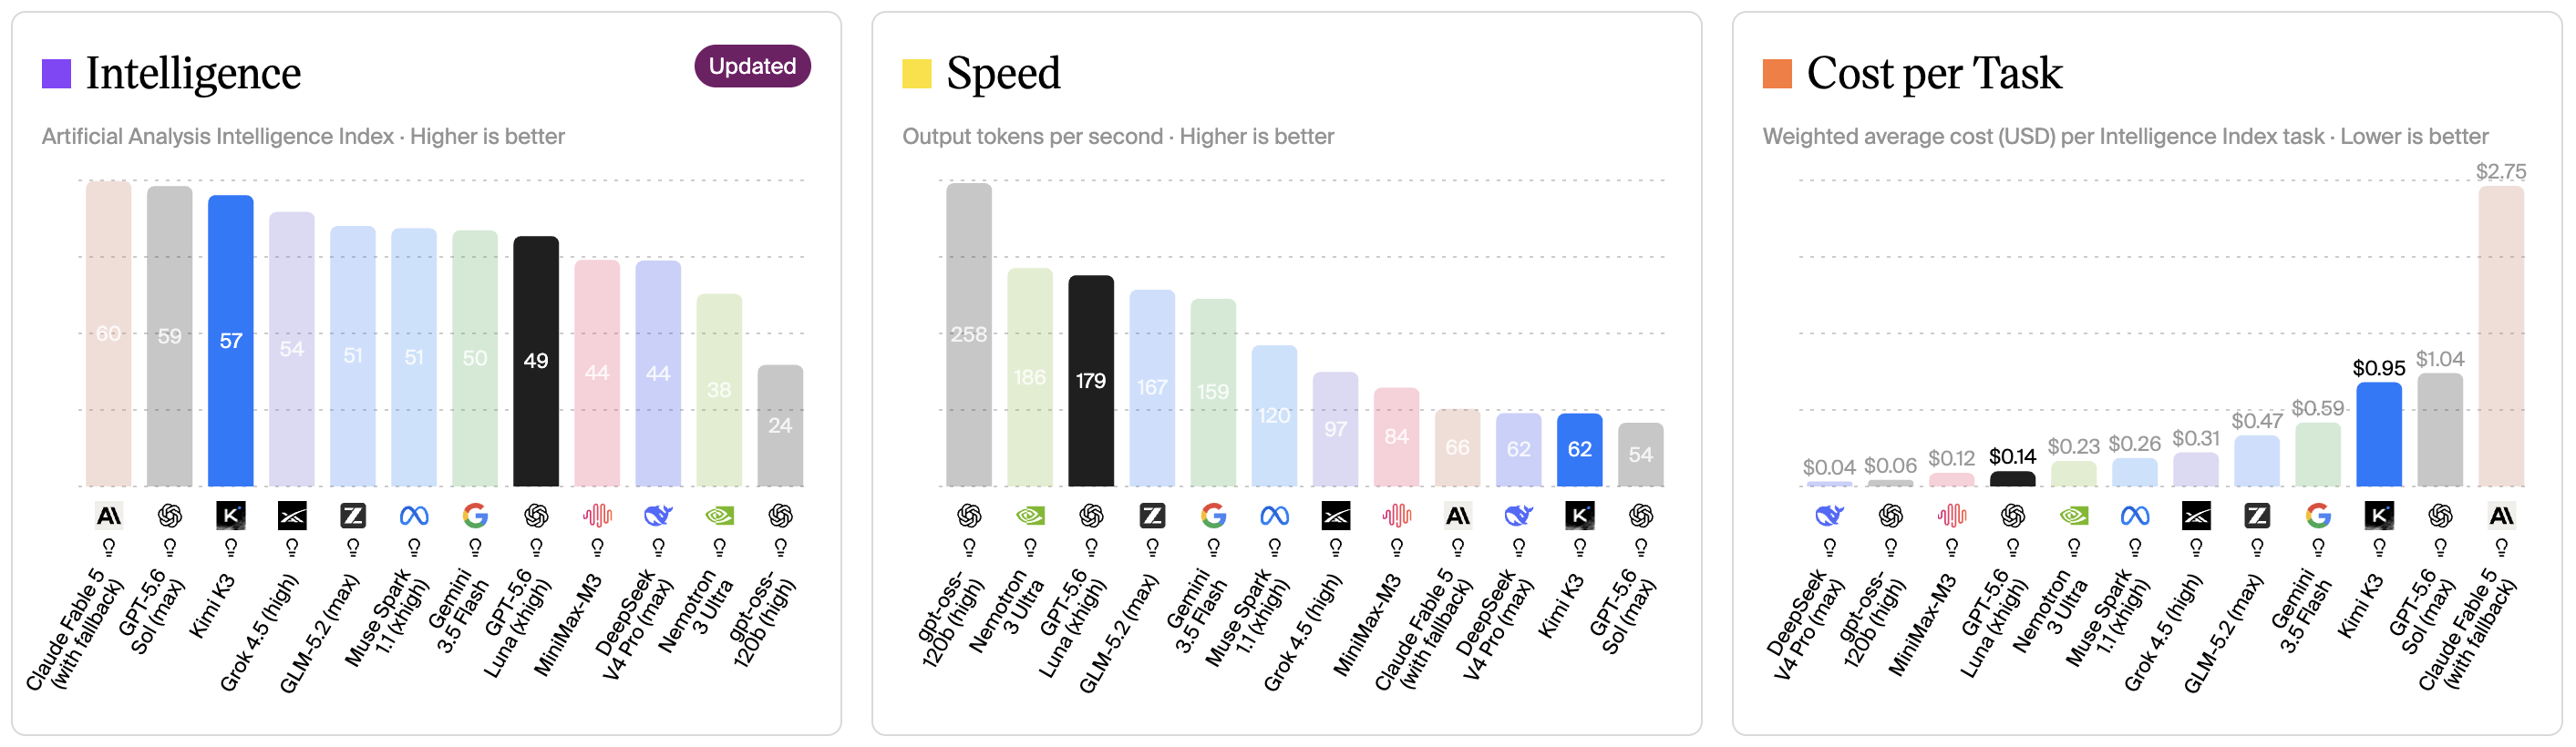
Moonshot के अपने बेंचमार्क्स पर GPT-5.5, K3 से थोड़ा नीचे बैठता है, और इसकी कीमत अन्य US फ्लैगशिप्स की रेंज में है—K3 से काफी ऊपर।
जैसा कि नीचे के ग्राफ़्स में दिखता है, इंटेलिजेंस इंडेक्स पर K3, GPT-5.5 से थोड़ा आगे निकलता है और प्रति कार्य लागत भी कुछ कम रहती है। एक बार चलने के बाद, GPT-5.5 वास्तविक टोकन जेनरेशन में थोड़ा तेज़ है, इसलिए इन तीनों में से किस बात को आप अधिक महत्व देते हैं—उस पर निर्भर करते हुए दोनों की अदला‑बदली हो सकती है।
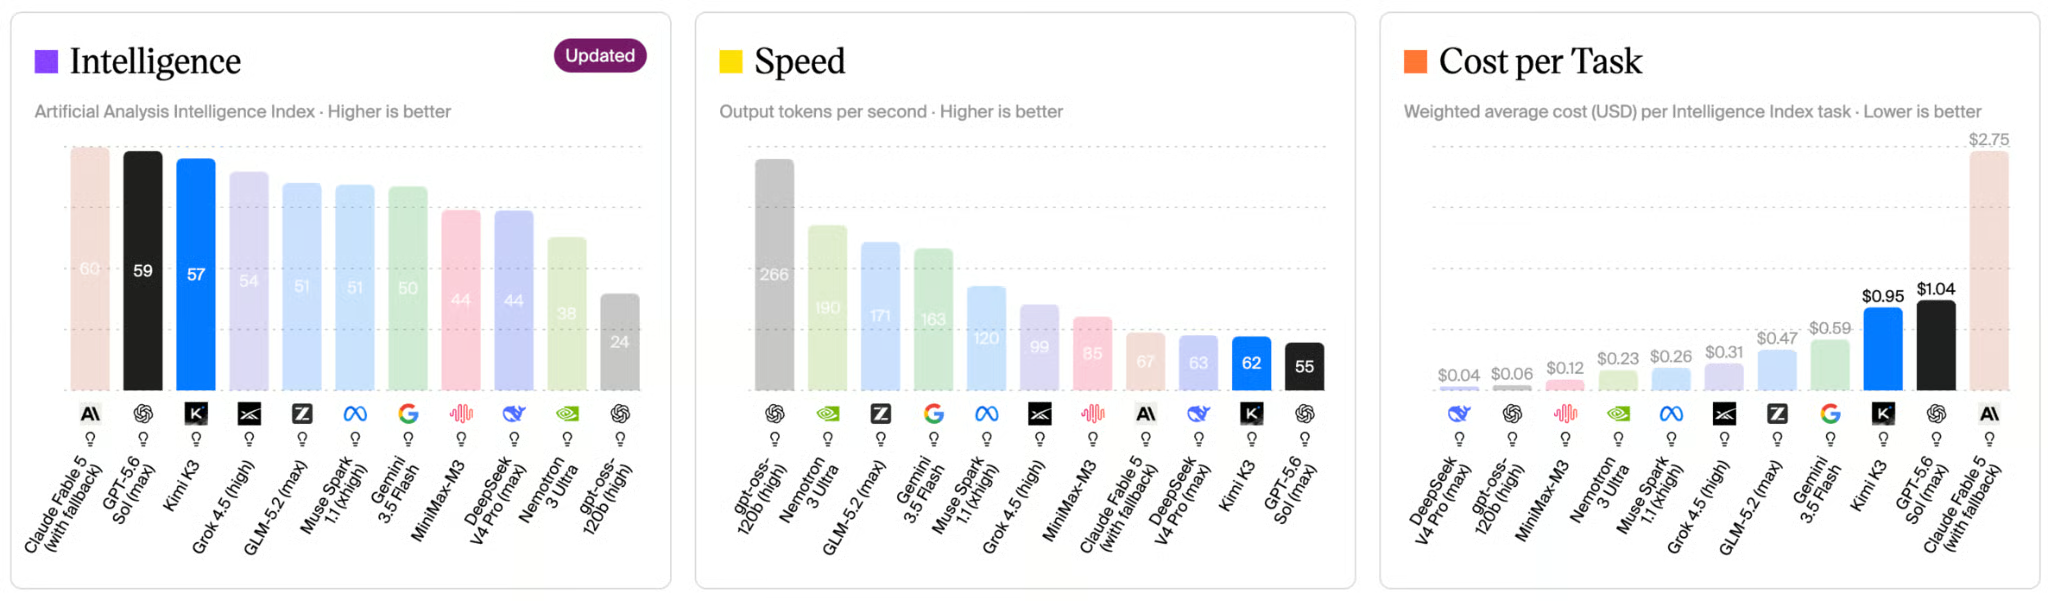
GPT-5.6 Sol इस तुलना में OpenAI का नवीनतम और सबसे महँगा मॉडल है, और Terminal-Bench 2.1 पर यह मूलतः K3 के साथ बराबरी पर है। Sol 88.8 स्कोर करता है, जबकि K3 88.3।
बड़ा अंतर वही है जो Opus 4.8 के साथ था: Sol क्लोज़्ड‑वेट है, इसलिए आप इसे केवल OpenAI के अपने उत्पादों (ChatGPT, Codex, API) के माध्यम से उपयोग कर सकते हैं, जबकि K3 ओपन‑वेट है। वेट्स आते ही कोई भी इसे सेल्फ‑होस्ट या फाइन‑ट्यून कर सकेगा।
जैसा कि नीचे के ग्राफ़्स में दिखता है, इंटेलिजेंस इंडेक्स पर Sol, K3 से थोड़ा आगे निकलता है, लेकिन गति और लागत दोनों में K3 आगे रहता है।
Kimi K3 अभी लाइव है—बस पूरी तरह नहीं। मॉडल स्वयं कल लॉन्च हुआ और आज kimi.com, Kimi मोबाइल ऐप्स, Kimi Work, Kimi Code, और Kimi API पर मॉडल ID kimi-k3 के तहत उपयोग योग्य है। यह OpenRouter और OrcaRouter जैसे तृतीय‑पक्ष राउटर्स पर भी दिखना शुरू हो गया है।
जो अभी बाहर नहीं है, वे स्वयं ओपन वेट्स हैं। Moonshot का कहना है कि उन्हें 27 जुलाई, 2026 तक जारी किया जाएगा, जबकि कंपनी इंफ़ेरेंस पार्टनर्स और ओपन‑सोर्स मेंटेनर्स के साथ तकनीकी विवरणों को संरेखित करने पर काम जारी रखेगी। तब तक आप Moonshot की होस्टेड सेवाओं के माध्यम से K3 का उपयोग कर सकते हैं, लेकिन इसे डाउनलोड कर सेल्फ‑होस्ट नहीं कर सकते।
हम सुझाव देते हैं कि आप हमारे साप्ताहिक AI न्यूज़लेटर The Median के लिए साइन अप करें—ऐसी मॉडल रिलीज़ पर अपडेट रहने का यह एक अच्छा तरीका है।
मूल्य निर्धारण की बात करें तो, 1M‑टोकन विंडो के बावजूद K3 टियरिंग के बजाय फ्लैट पे‑ऐज़‑यू‑गो बिलिंग का उपयोग करता है। Moonshot की आधिकारिक दरें हैं: कैश‑हिट इनपुट के लिए $0.30 प्रति मिलियन टोकन, कैश‑मिस इनपुट के लिए $3.00 प्रति मिलियन टोकन, और आउटपुट के लिए $15.00 प्रति मिलियन टोकन—सामान्य कोडिंग वर्कलोड्स के लिए 90% से अधिक कैश‑हिट दर रिपोर्ट की गई है, जो व्यवहार में प्रभावी इनपुट लागत को कम करती है।
अपनी टेक्निकल ब्लॉग में Moonshot सीमाओं के बारे में स्पष्ट है:
Kimi K3 अब तक जारी सबसे बड़ा ओपन‑वेट मॉडल है। इसमें एक नई अटेंशन आर्किटेक्चर है जो सीधे लंबे कॉन्टेक्स्ट और एजेंटिक वर्कलोड्स को साधती है। जो बेंचमार्क अब सार्वजनिक हैं, उन पर यह समग्र रूप से पूर्ण विजेता नहीं है—Fable 5 और GPT-5.6 Sol दोनों इसे थोड़ा पछाड़ते हैं—लेकिन कोडिंग, एजेंटिक और मल्टीमोडल कार्यों में यह लागत के एक अंश पर बेहद प्रतिस्पर्धी है।
यही इस पूरे लेख की धुरी है: K3 हर श्रेणी जीतने की कोशिश नहीं कर रहा। यह कीमत‑टू‑क्षमता के संतुलन को नज़रअंदाज़ करना मुश्किल बना रहा है—ठीक वैसे ही जैसे DeepSeek ने R1 के साथ और हाल में GLM-5.2 ने किया—बस इस बार Moonshot यह सब डिस्काउंट दरों पर नहीं, बल्कि फ्रंटियर दरों पर कर रहा है।
DataCamp के साथ AI सीखें
कोर्स
कोर्स
कोर्स