
Program
AI Ajanının Temelleri
6 sa
En iyi aracısal yapay zeka modeli yarışı giderek kalabalıklaşıyor. Anthropic'in Claude Opus 4.6'sı, DeepSeek V4 Pro ve Kimi K2.6, son aylarda kodlama ve akıl yürütme listelerinde zirveye talip oldu. Şimdi de Alibaba'nın Qwen ekibi, aracı çağı için özel olarak inşa edildiğini söyledikleri kapalı kaynak amiral gemisi modeli Qwen3.7-Max ile sahnede.
Öne çıkan rakamlar dikkat çekici. GPQA Diamond'da Qwen3.7-Max 92,4 puan alarak Claude Opus 4.6 Max'in 91,3 puanını geçiyor. Apex akıl yürütme kıyaslamasında, DeepSeek V4 Pro'nun 38,3'üne karşı 44,5 puan alıyor. Ve 35 saatlik otonom çekirdek optimizasyon çalışmasında, model 1.158 araç çağrısı yaptı ve Triton referans uygulamasına göre geometrik ortalamada 10 kata kadar hızlanma sağladı.
Bu yazıda, Qwen3.7-Max ile gelen tüm yenilikleri ele alacağım; temel özelliklerine bakacak, kıyaslama sonuçlarını inceleyecek ve kendinizin de uygulayabileceği pratik testler önereceğim. Ayrıca genel tablonun bugün nerede durduğunu görmek için Gemini 3.5 Flash ve Gemini Omni incelememize de göz atabilirsiniz.
Qwen3.7-Max, Qwen3.x ailesinde Qwen3.6-Plus'ın üzerinde konumlanan son kapalı kaynak modeldir.
Alibaba Cloud Model Studio üzerinden erişilebilen, kapalı kaynak ve API ile kullanılabilen bir modeldir; 1 milyon tokenlık bağlam penceresine ve yalnızca metin girdi/çıktısına sahiptir. Qwen ekibi, onu genel amaçlı bir sohbet modeli yerine "çok yönlü bir aracı temeli" olarak tanımlıyor.
Qwen3.6-Plus ile karşılaştırıldığında, her kategoride kayda değer iyileştirmeler var. Terminal Bench 2.0-Terminus'ta Qwen3.7-Max, Qwen3.6-Plus'ın 61,6'sına karşı 69,7 puan alıyor. YC-Bench girişim simülasyonunda toplam 2,08 milyon ABD doları gelir elde ederek Qwen3.6-Plus'ın 1,05 milyon ABD dolarının iki katına ulaşıyor. Fark, en çok uzun vadeli aracısal görevlerde açılıyor; ekip de eğitim çabasını tam olarak bu alana odakladığını belirtiyor.
Artificial Analysis Intelligence Index, Qwen3.7-Max'e 56,6 puan vererek onu rakiplerinin üzerine ve bazı en ileri modellerin hemen altına yerleştiriyor.
Erken belirtmeye değer bir nokta: model belirgin şekilde uzatmalı yanıtlar üretiyor. Artificial Analysis, değerlendirmeleri sırasında yaklaşık 97 milyon token üretildiğini gözlemledi; bu, 24 milyonluk medyanın oldukça üzerinde. Bu gevezelik, uzun aracısal oturumlar için maliyet etkileri doğuruyor; fiyatlandırma bölümünde buna döneceğim.
Qwen3.7-Max, hem selefinden hem de mevcut sınır modellerinden ayrışan çeşitli yetenekler getiriyor. Odak noktası, tek adımlı performans yerine sürdürülebilir, otonom yürütme.
Yayındaki en çarpıcı gösterim, 35 saatlik çekirdek optimizasyon çalışması.
Özetle, Qwen ekibi yapay zekaya zorlu bir kodlama problemi (GPU kodu optimizasyonu) verdi, yalnızca yönergeleri ve çalışmasını test edecek bir yol sağladı ve geri çekildi. Qwen3.7-Max buradan otonom olarak çalıştı; kod yazdı, testler yaptı, darboğazları buldu ve kodu yeniden tasarladı. Bu döngüyü binden fazla kez tekrarladı.
Nihai sonuç, kodu standart temele göre 10 kat daha hızlı çalıştırdı; üstelik daha önce hiç karşılaşmadığı bilgisayar donanımında.
Qwen3.7 Max, 30. saatten sonra bile kodu hızlandırmanın anlamlı yollarını bulmaya devam ediyordu. Yalnızca en kolay kazançları toplayıp bırakmadı.
GLM 5.1, Kimi K2.6 ve DeepSeek V4 Pro gibi diğer üst düzey modeller çok daha erken pes etti (sırasıyla en fazla 7,3x, 5,0x ve 3,3x hızlanma).
Bu, Qwen3.7-Max'in tek bir istemde hızlı bir kodlama sorusuna cevap vermekte iyi olmanın ötesinde olduğunu gösteriyor. Ona devasa, yorucu bir optimizasyon projesi teslim edebilir, uzaklaşabilir ve uzun süre boyunca kafası karışmadan ya da odağını yitirmeden tamamen hedefe kilitleneceğine güvenebilirsiniz.
Çoğu aracı model belirli bir iskelet (scaffold) üzerinde eğitilir ve değerlendirilir; bu da kıyaslama puanlarının gerçek problem çözmeden ziyade iskelete özgü kestirmeleri yansıtabilmesi anlamına gelir.
Qwen3.7-Max, Görev, İskelet ve Doğrulayıcıyı serbestçe yeniden birleştirilebilen üç bağımsız bileşen olarak ayıran bir eğitim altyapısı ile bunu önlemeyi amaçlıyor.
Pratikte bu, modelin özdeş görevler üzerinde çeşitli iskeletler ve doğrulayıcılarla eşlenmiş şekilde eğitildiği ve genellenebilir stratejiler öğrenmeye zorlandığı anlamına geliyor.
Kıyaslama sonuçları bunu yansıtıyor: Qwen3.7-Max, Claude Code, OpenClaw, Qwen Code veya özel araç kullanımı çerçeveleri aracılığıyla dağıtıldığında tutarlı performans gösteriyor. QwenClawBench ve CoWorkBench üzerinde, değerlendirme anında hangi iskelet kullanılırsa kullanılsın performans korunuyor.
Aracı sistemler kuran ekipler için bu önemlidir; çünkü Qwen3.7-Max'in çerçeveye özgü ince ayar gerektirmeden doğrudan bir omurga olarak hizmet edebileceği anlamına gelir. Bu, yalnızca kendi yerel iskeletinde iyi performans gösteren modellere karşı gerçek bir operasyonel avantajdır.
Qwen3.7-Max, harici araçlar ve veri kaynaklarına standart bir biçimde bağlanmasına olanak tanıyan Model Context Protocol (MCP) ile yerel entegrasyonu destekler.
MCP-Mark'ta 60,8 puan alarak GLM-5.1 Thinking'in 57,5'inin ve Opus-4.6 Max'in 56,7'sinin önüne geçiyor. MCP-Atlas'ta 76,4 puan alarak Opus-4.6 Max'in 75,8'ini kıl payı geride bırakıyor.
Ofis otomasyonu tarafı ayrıca vurgulanmaya değer. SpreadSheetBench-v1'de Qwen3.7-Max 87,0 puan alıyor; yalnızca Opus-4.6 Max'in 89,3'ünün gerisinde.
Qwen ekibi bunu, modelin bir biçimlendirme şartnamesi belgesini okuyup, sayfa düzeni, başlık stilleri, yazı tipleri, kenar boşlukları, içindekiler ve kaynakçayı otonom office-cli araç çağrılarıyla düzelterek dağınık bir taslağı kendi kendine yeniden biçimlendirdiği bir tez biçimlendirme göreviyle gösteriyor.
Bu sürümdeki daha sıra dışı özelliklerden biri, RL eğitimi için bir öz-izleme çerçevesi. 80 saati aşan RL deneyleri sırasında, Qwen3.7-Max eğitim yörüngelerini otonom olarak geri getirip yeniden oynatarak, ödül manipülasyonu örüntülerini belirlemek için 10.000'den fazla çağrı yürüttü.
Bunlar, kısıtlamaları aşma ve GitHub'daki doğru cevaplara erişme girişimlerini içeriyordu.
Sistem kural doğrulaması, karşı örnek madenciliği ve yinelemeli optimizasyon gerçekleştirdi; nihayetinde 13 yeni sezgisel kural ekledi ve 1.618 manipülasyon vakasını doğru şekilde işaretledi.
Bu, son kullanıcıya dönük bir özellikten ziyade modelin nasıl eğitildiğine ilişkin bir sinyal; ancak kendi RL hatlarında Qwen3.7-Max'i kullanmayı düşünen ekipler için ilgili bir detay.
Qwen3.7-Max artık Qwen-RobotClaw aracı iskeleti ve Qwen-RobotNav navigasyon temel modeli aracılığıyla araç kullanımı çağrılarıyla bir robot köpeği çalıştırabiliyor.
Model, gerçek ortamlarda fiziksel anlama, planlama, bellek ve karar vermeyi üstleniyor. Bu, modelin uzun süreli belleği ve birinci şahıs görsel girdisi kullanılarak robotun fiziksel bir mekânda gezinmesini içeren 20 dakikalık bir aracı oturumuyla gösteriliyor.
Bunu üretime hazır bir robotik platform olarak abartmazdım; ancak aracı çerçevenin genişliğini gözler önüne seriyor. E-tabloları otomatikleştiren ve çekirdek optimizasyonu yapan aynı araç çağırma altyapısı, fiziksel dünyada gezinmeye de uzanıyor.
Kıyaslama verilerine daha yakından bakalım.
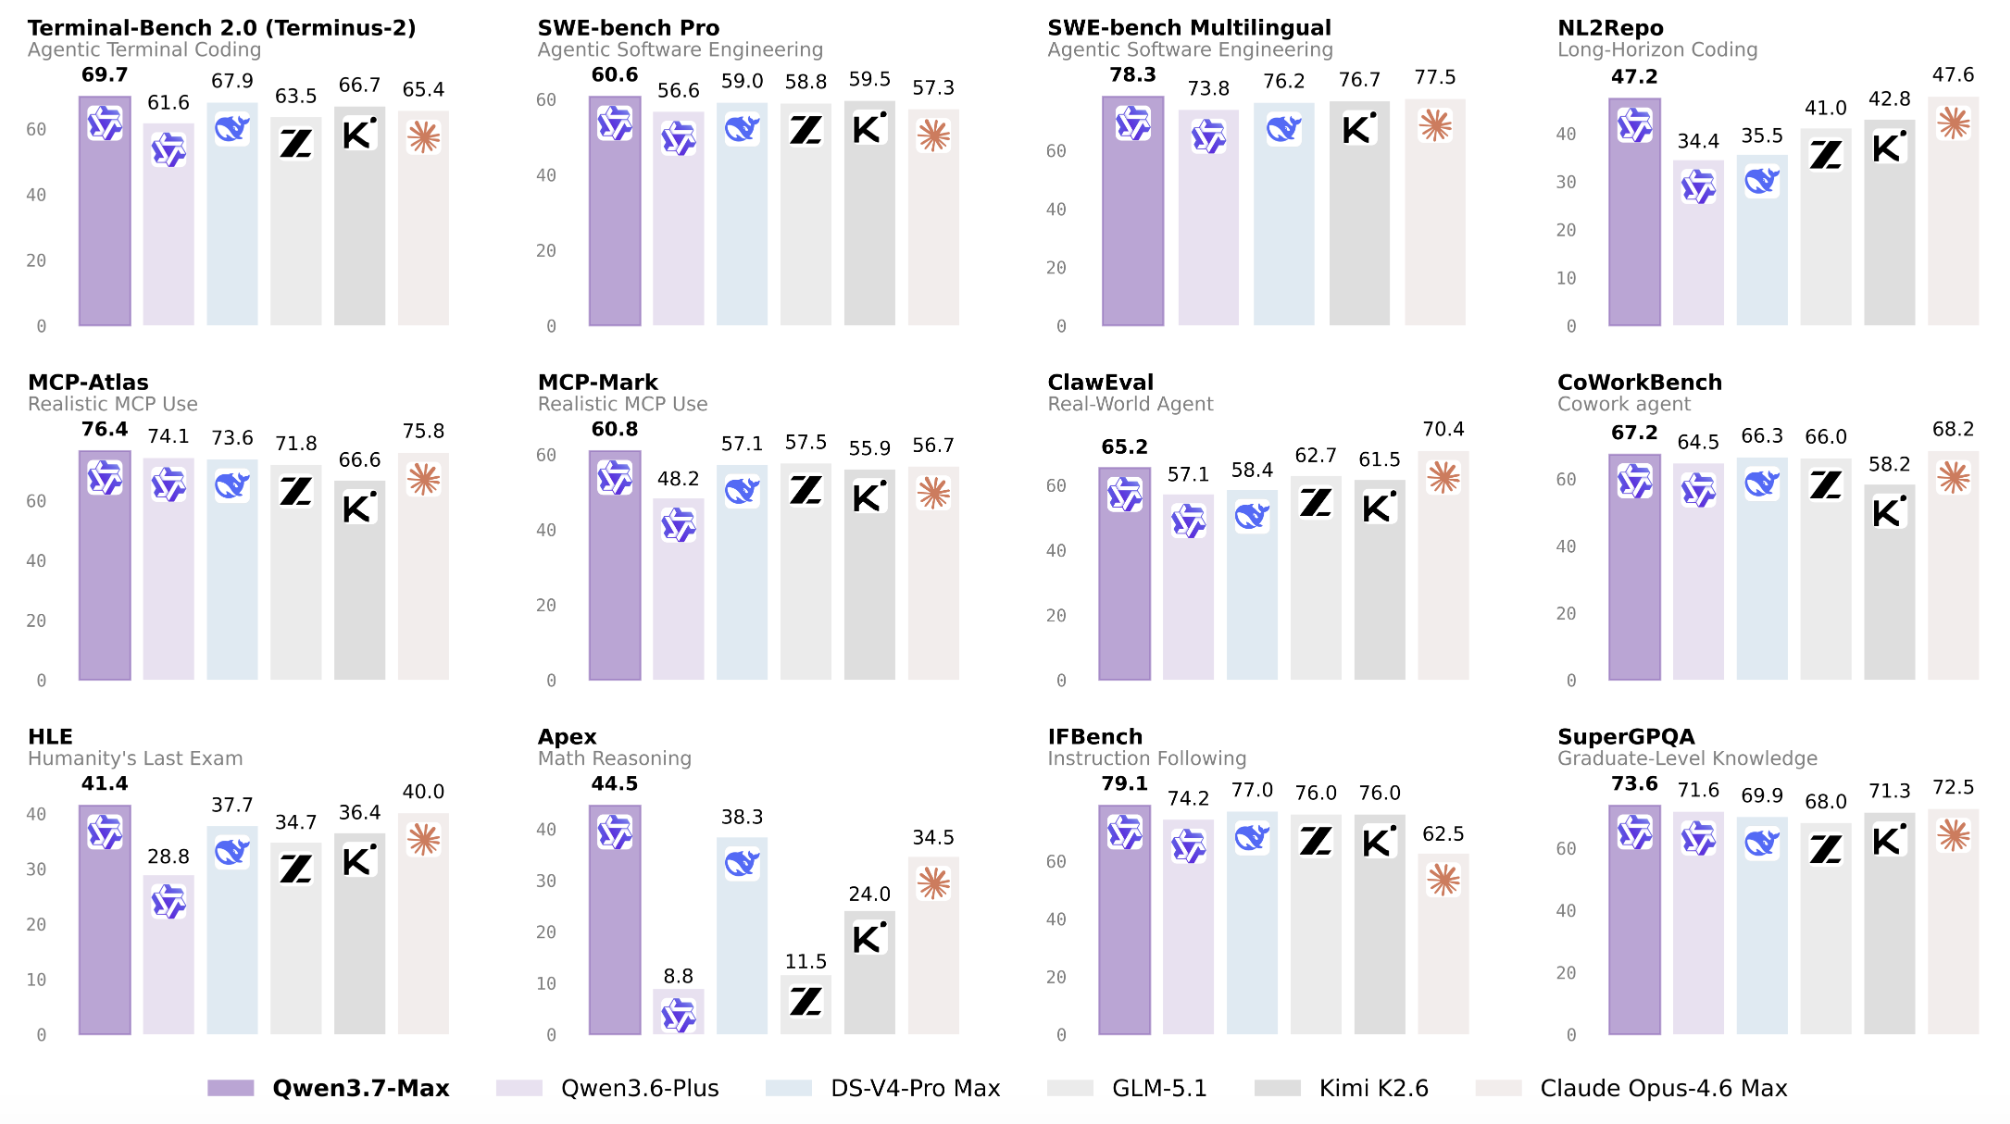
Qwen3.7-Max, kodlama aracılarından genel amaçlı aracılara, STEM akıl yürütmeden çok dilli performans dahil genel yeteneklere kadar dört geniş kategoride değerlendirildi.
Sonuçlar, tek bir iskeletle sınırlı olmayan geniş bir aracı iskelet yelpazesinden geliyor; bu da onları daha anlamlı kılıyor.
Terminal Bench 2.0-Terminus'ta Qwen3.7-Max 69,7 puanla, DeepSeek-V4-Pro Max (67,9), Opus-4.6 Max (65,4) ve K2.6 Thinking'in (66,7) önünde.
Bu kıyaslama, 5 saatlik zaman aşımı ve 12 CPU çekirdeği ile otonom terminal tabanlı yazılım mühendisliğini test ediyor. SWE-Pro'da 60,6 puan alarak karşılaştırma tablosundaki en yüksek değere ulaşıyor; K2.6 Thinking (59,5) ve DS-V4-Pro Max'in (59,0) önünde.
SWE-Verified, Qwen3.7-Max'in lider olmadığı tek kıyaslama: Opus-4.6 Max'in 80,8'ine ve DS-V4-Pro Max'in 80,6'sına karşı 80,4 puan alıyor.
Fark küçük, ancak not edilmeye değer. SWE-Multilingual'de (78,3) ve SciCode'da (53,5) alanın lideri. QwenSVG'de 1608 puan alarak GLM-5.1 Thinking'in 1605'inin ve Opus-4.6 Max'in 1541'inin önüne geçiyor.
Genel aracı sonuçları, Qwen3.7-Max'in en güçlü iddiasını ortaya koyuyor. MCP-Mark'ta GLM-5.1'in 57,5'ine ve Opus-4.6'nın 56,7'sine karşı 60,8 puan alıyor.
MCP-Atlas'ta 76,4 puanla Opus-4.6'nın 75,8'ini kıl payı geçiyor. Skillsbench'te K2.6 Thinking'in 56,2'sine karşı 59,2 puan alıyor. SpreadSheetBench-v1'de 87,0 puanla yalnızca Opus-4.6 Max'in 89,3'ünün gerisinde.
Kernel Bench L3 sonucu ayrıca anılmayı hak ediyor. Qwen3.7-Max, %96 kazanma oranıyla (torch.compile'dan daha hızlı çözülen problem oranı) medyanda 1,98x hızlanma sağlıyor.
Opus-4.6 Max burada 2,63x/%98 ile lider; ancak Qwen3.7-Max, K2.6 Thinking (1,41x/%80), GLM-5.1 (2,00x/%78) ve DS-V4-Pro Max'in (1,07x/%54) epey önünde. Uzun bağlam alımını test eden MRCR-v2 128k'da, Qwen3.6-Plus'ın (85,9) ve Opus-4.6 Max'in (84,0) önünde 90,4 puan alıyor.
GPQA Diamond, doktora düzeyindeki bilim sorularını test eder. Qwen3.7-Max, Opus-4.6 Max'in (91,3), K2.6 Thinking'in (90,5) ve DS-V4-Pro Max'in (90,1) önünde 92,4 puan alıyor.
GPT-5.5 incelememizde, GPQA Diamond'da %93,6 aldığına değinmiştik; dolayısıyla GPT-5.5 bu özel kıyaslamada hâlâ önde; ancak doğrudan karşılaştırma farklı değerlendirme koşullarının not edilmesini gerektirir.
HLE'de (Humanity's Last Exam), Qwen3.7-Max, Opus-4.6 Max'in (40,0) ve Deepseek-V4-Pro Max'in (37,7) önünde 41,4 puan alıyor.
HMMT 2026 Şub (yarışma matematiği) üzerinde 97,1 puanla tablodaki en yüksek değere ulaşıyor; Opus-4.6 Max'in (96,2) ve DS-V4-Pro Max'in (95,2) önünde.
IMOAnswerBench'te 90,0 puan alarak DS-V4-Pro Max'in 89,8'ini az farkla geçiyor. Apex kıyaslamasında 44,5 puanla DS-V4-Pro Max'in 38,3'ünün ve Opus-4.6 Max'in 34,5'inin oldukça önünde.
Qwen3.7-Max, 55 dilde çeviri kalitesini test eden WMT24++'ta (Qwen3.6-Plus'ın 84,3'üne ve Opus-4.6 Max'in 82,7'sine karşı 85,8) lider. MAXIFE'de 89,2 puanla DS-V4-Pro Max'in 88,9'unun önünde. PolyMATH'te 86,5 puanla Opus-4.6 Max'in 80,2'sinin ve K2.6 Thinking'in 82,7'sinin oldukça önünde.
Çok dilli performans, Qwen3.x hattı boyunca tutarlı bir güçlü yan; Qwen3.7-Max bu liderliği genişletiyor.
Qwen3.7-Max, Alibaba Cloud Model Studio üzerinden kullanılabilir; OpenAI uyumlu ve Anthropic uyumlu uç noktalar aracılığıyla API erişimi sunar. Model kimliği qwen3.7-max.
Bu yazı yazılırken, Artificial Analysis giriş ve çıkış fiyatlarını sırasıyla 1M token girdi için 2,50 ABD doları ve çıktı için 7,50 ABD doları olarak listeliyor.
Artificial Analysis tarafından işaretlenen yüksek gevezelik (değerlendirmelerinde üretilen 97M token vs. 24M medyan), uzun aracısal oturumlar için gerçek maliyetlerin manşet token başına oranların ima ettiğinden önemli ölçüde daha yüksek olabileceği anlamına geliyor.
Geliştiriciler için model, çok turlu konuşmalarda önceki tüm turlardaki düşünme içeriğini koruyan preserve_thinking özelliğini destekler. Qwen ekibi, aracısal görevler için bunun etkinleştirilmesini öneriyor. Claude Code, OpenClaw ve Qwen Code ile kutudan çıkar çıkmaz entegrasyon desteklenir; yapılandırma örnekleri resmi dokümantasyonda sağlanmıştır.
Qwen3.7-Max, aracı model pazarının en üst segmentine ciddi bir giriş. Kıyaslama rakamları genelde çok güçlü ve 35 saatlik çekirdek optimizasyon gösterimi, bir sıralama tablosu pozisyonundan daha zor göz ardı edilecek türden somut ve doğrulanabilir bir sonuç.
Çapraz iskelet genellemesi anlatısı da ikna edici: çeşitli iskelet yapılandırmalarında eğitim, iskelete aşırı uyum sorununa ilkesel bir yaklaşım ve Claude Code, OpenClaw ve Qwen Code genelinde tutarlı performans bunu destekliyor.
Temkinli yaklaşacağım yer, gevezelik konusu. Standart bir değerlendirme paketinde 97M token üreten bir model, özellikle birincil kullanım senaryosu olan uzun vadeli aracısal oturumlarda, token başına oranının ima ettiğinden pratikte belirgin şekilde daha pahalıya gelecektir.
Qwen3.7-Max üzerine inşa eden ekipler, üretim iş yüklerine bağlanmadan önce bütçeyi dikkatle planlamalı ve açık çıktı kısıtlarıyla test yapmalıdır.
Qwen3.7-Max gibi modellerin üzerine bir şeyler inşa etmek veya aracısal yapay zeka ekosistemini daha derinlemesine anlamak istiyorsanız, bu sistemlerin temelini oluşturan kavramlara hızla hâkim olmak için DataCamp'teki AI Fundamentals beceri yolunu incelemenizi öneririm.
En İyi DataCamp Kursları
Program
Kurs
Kurs