
Last chance! 50% off DataCamp Premium
Sale ends in
Güncelleme: 2 Eylül 2026: Alibaba, kodlama ve ajan performansına odaklanan Qwen3.8-Max'in yükseltilmiş bir anlık görüntüsü olan Qwen3.8-Max-0902'yi yayımladı. Aşağıdaki bölüm yeni kıyaslamaları yansıtacak şekilde eklendi.
2 Eylül 2026’da Alibaba, Qwen3.8-Max’e sonradan eğitim güncellemesi olarak Qwen3.8-Max-0902’yi yayımladı. Mimari değişmedi: 2,4 trilyon parametre, 1M token bağlam ve aynı fiyatlandırma ($2/1M girdi, $6/1M çıktı). Odak noktası tamamen kodlama ve uzun ufuklu ajan çalışmaları.
Dikkate değer sonuç Code Arena WebDev: Qwen3.8-Max-0902, toplamda 1.691 puanla birinci sırada, Claude Opus 5 Max’in (1.687) 3, Kimi K3 Max’in (1.674) 17 ve önceki Qwen3.8-Max’in (1.669) 22 puan üzerinde. Ayrıca harmanlanmış milyon token başına $5 maliyet düzeyinde Pareto sınırında da en üst konumu koruyor.
Tüm 8 kodlama kıyaslaması iyileşti. En büyük artışlar TerminalBench 3.0’da (11,3’ten 29,0’a) ve ProgramBench Almost Solved’da (10,5’ten 28,0’a) görüldü; ikisi de iki kattan fazla arttı. Aşağıdaki tablo, kodlama, ajan ve çok modlu kategoriler genelindeki tam tabloyu gösteriyor.
| Kıyaslama | Qwen3.8-Max-0902 | Qwen3.8-Max | Claude Opus 5 |
|---|---|---|---|
| Kodlama | |||
| TerminalBench 3.0 | 29.0 | 11.3 | 42.7 |
| DeepSWE 1.1 | 69.3 | 56.6 | 73.6 |
| NL2Repo-Bench | 64.9 | 55.9 | 72.3 |
| ProgramBench (Almost Solved) | 28.0 | 10.5 | 41.5 |
| SWE-Marathon | 44.8 | 39.1 | 50.0 |
| MLS-Bench-Lite | 50.1 | 41.0 | 49.8 |
| SWE-Atlas QnA | 66.3 | 60.3 | 63.2 |
| QwenSWEBench V2 | 70.0 | 55.1 | 68.0 |
| Ajan | |||
| CoWorkBench | 76.1 | 74.8 | 79.6 |
| JobBench | 64.0 | 53.4 | 67.8 |
| Toolathlon Verified | 73.3 | 72.5 | 77.6 |
| WorkArena (Elo) | 1468 | 1348 | 1437 |
| Çok Modlu | |||
| MMMU-Pro | 82.7 | 82.3 | 82.6 |
| ERQA | 78.3 | 77.8 | 67.3 |
Kalın yazılanlar, Qwen3.8-Max-0902’nin o kıyaslamada Claude Opus 5’i geçtiğini gösterir. Tüm sonuçlar Alibaba’nın yayımladığı karşılaştırma tablosundan alınmıştır.
Claude Opus 5’e karşı 0902 güncellemesi üç kodlama kıyaslamasında (MLS-Bench-Lite, SWE-Atlas QnA, QwenSWEBench V2) önde ve WorkArena ile her iki yayımlanmış çok modlu değerlendirmede kazanıyor. Claude hâlâ TerminalBench 3.0, DeepSWE 1.1 ve ajan koordinasyon kıyaslamalarında önde. Fiyatlandırma değişmedi; dolayısıyla zaten Qwen3.8-Max kullanıyorsanız, bu anlamlı bir kodlama artışıyla gelen ücretsiz bir yükseltme. Qwen ayrıca 18 Eylül’de Qwen3.8-Omni-Flash’i de yayımladı.
Orijinal Makale
Alibaba’nın Qwen ekibi, Qwen3.8-Max’i 3 Ağustos 2026’da yayımladı ve model doğrudan sınır piyasasının en çekişmeli alanına iniyor: otonom yazılım mühendisliği ve uzun ufuklu kurumsal işler. Qwen ilk kez bir Max sınıfı modeli açık ağırlıkla sunmayı planlıyor; ağırlıkların gelecek hafta daha küçük Qwen3.8-27B ile birlikte yayımlanması bekleniyor.
Qwen3.8-Max, 95B etkin parametreli, 2,4 trilyon parametreli uzman karışımı (MoE) bir model; 1M token bağlam penceresi ve yerel metin, görsel ve video girdi desteğiyle geliyor. Manşet iddia: OSWorld-Verified’da 86,1 puanla GPT-5.6 Sol Max’in 83,2’sinin, Claude Fable 5’in 85,0’ının ve Gemini 3.1 Pro’nun 76,2’sinin önünde. Ayrıca 93,0 ile bildirilen en yüksek PaperBench skorunu elde ediyor ve milyon başına girdi/çıktı token’larında $2/$6 fiyatlanıyor.
Bu yazıda Qwen3.8-Max’teki tüm yenilikleri ele alacak, kodlama ve ajansal özelliklerine bakacak, kıyaslamaları inceleyecek ve sizin çalıştırabileceğiniz uygulamalı testler kuracağım. İlgili içerikler için Grok 4.5, GPT-5.6 Terra vs Claude Sonnet 5 rehberlerimize ve Claude API’ye kapsamlı rehberimize bakabilirsiniz. Ayrıca yeni Qwen3.8-Flash hakkında da okuyabilirsiniz.
Qwen3.8-Max, Qwen ailesinin en yetenekli modeli; toplam 2,4 trilyon parametreli ve ileri geçiş başına yaklaşık 95B etkin parametreli seyrek bir MoE mimarisi.
Qwen 3.5’in mimari temeli üzerine inşa edildi ve özellikle dört kulvara odaklanıyor:
Qwen3.7-Max’e kıyasla en büyük yapısal değişim ölçek ve açık ağırlık taahhüdü. Qwen daha önce hiçbir Max sınıfı modelin ağırlıklarını yayımlamamıştı; şirket, hem Qwen3.8-Max’in hem de Qwen3.8-27B’nin gelecek hafta Hugging Face ve ModelScope’a yükleneceğini söylüyor.
Alibaba henüz lisansı açıklamadı; dolayısıyla bunun Apache 2.0 gibi izinli bir lisans mı yoksa daha kısıtlayıcı özel bir lisans mı olacağı belirsiz.
Kıyaslama cephesindeki en önemli haber, ajan temelli bilgisayar kullanımı.
Gerçek bir masaüstü ortamında bir ajanın ne kadar iyi çalıştığını ölçen OSWorld-Verified’da, Qwen3.8-Max, Qwen’in karşılaştırdığı tüm tescilli modellerin önünde.
Öz barındırılabilir olacak bir model için bu, genellikle sınırın bir nesil gerisinde kalan alışıldık açık ağırlık sürümlerinden gerçekten farklı bir öneri.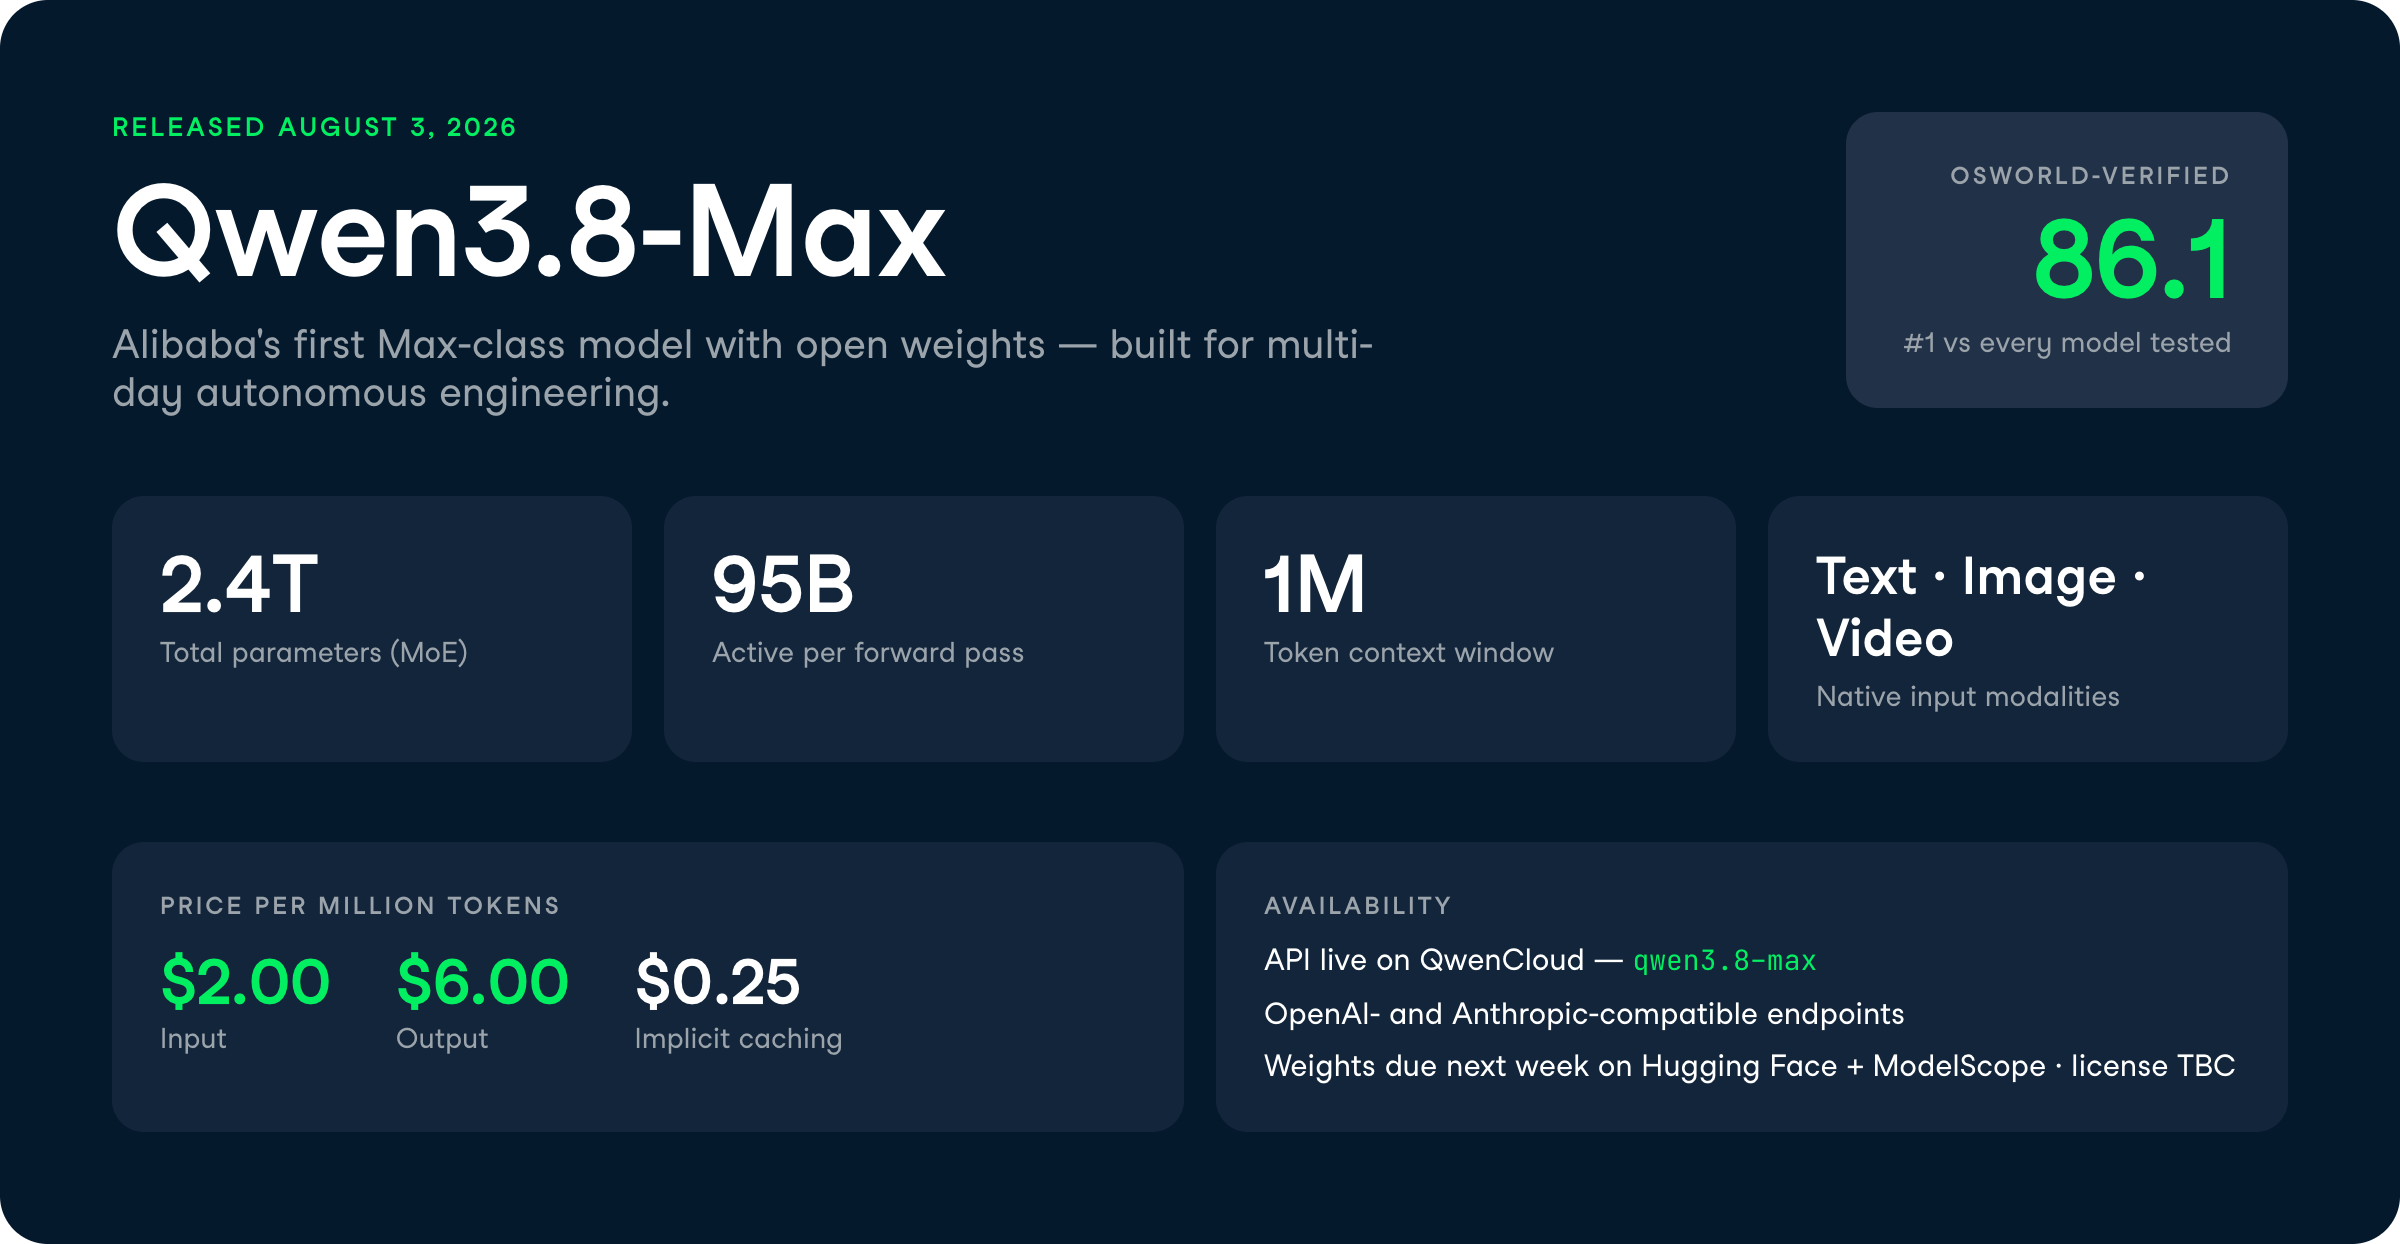
Qwen3.8-Max’in temel teması, uzun ufuklarda özerklik.
Qwen her yeteneği aynı fikir etrafında çerçeveliyor: model sabit bir plan izlemez; günler süren kesintisiz çalışma boyunca geri bildirim döngüleriyle kendi kendini düzeltir.
İşte bana en çok öne çıkan özellikler.
Qwen3.8-Max, insan müdahalesi olmadan günler süren kesintisiz çalışmayla boş bir klasörden bitmiş bir teslimata kadar bir kodlama projesini götürebilir.
Şirketin amiral gemisi demonstrasyonu yaklaşık 16 gün tam otonom çalıştı; 265 commit, 127 PR ve 151 issue biriktiren kendi kendini evrimleştiren bir CLI çerçevesi geliştirdi.
Mekanizma bir geri bildirim döngüsü: gereksinimler GitHub issue’ları olarak giriyor, ajanlar bunları üstlenip yürütüyor, ardından birleştirmeden önce derleme, birim testleri, uçtan uca testler ve CI kontrollerini tetikliyor.
Uygulayıcılar için bu, tek seferlik kod sorularını yanıtlamaktan ziyade gözetimsiz mühendislik hatlarını çalıştırmak üzere tasarlanmış bir modele işaret ediyor.
Buradaki bariz uyarı şu: bunlar tedarikçi tarafından yürütülen gösterimler.
Kontrollü bir ortamda 16 günlük otonom bir çalışma, bunu üretim monoreponuza yöneltip uzaklaşmakla aynı şey değildir.
Qwen3.8-Max bir araştırma makalesini okuyabilir, deneylerini sıfırdan kodda çoğaltabilir ve ardından orijinal yöntemi geçmeye çalışabilir.
Qwen’in örneğinde model yaklaşık 5 gün (~125 saat) çalıştı, yaklaşık 7.600 satır kod yazdı, 1.100’den fazla eylem gerçekleştirdi ve başlangıç kodu sağlanmadan 33 tur GPU eğitimi yaptı.
Önce makalenin altı ana bulgusunu çoğalttı, ardından 4 tur ve 18 fikir boyunca hipotez, kod, GPU çalışması ve analizden oluşan kendi kendini geliştiren bir döngü yürüttü.
Geliştirdiği son yöntem, AIME24’te, yarışma düzeyi bir matematik kıyaslamasında, makalenin kendi yaklaşımını 2,71 puan geçti.
Bu, normalde bir araştırma ekibinin, deneyler başlamadan önce, bir haftalık kurulumunu tüketen türden bir iş akışı.
Dinamik İş Akışları, Qwen3.8-Max’in bir görevi programlı olarak planlamasına ve çok sayıda alt ajanı paralel olarak görevlendirmesine olanak tanır.
Bir nicel araştırma gösteriminde model, 6 kısa faktör tanımını her biri için 50 araştırma yönüne ayırdı, yaklaşık 330 alt ajanı görevlendirdi ve iş akışını çalışma sırasında uyarlayarak yaklaşık 6.000 backtest tamamladı.
Bunu sabit bir betikten farklı kılan, modelin kanıta dayanarak hareket etmesidir.
Aşırı uyum sinyalleri gördüğünde, yinelenen faktörleri tur tur budadı; üç modelli toplulaştırmanın, küçük kesitlerde sabit yönlü sentezden daha az sağlam göründüğü durumda ise çerçeveyi kendi kendine değiştirdi.
Seçilen faktörler 0,64 ile 1,48 arasında ek Sharpe oranlarına ulaştı; bu da his değil, somut ve doğrulanabilir bir sonuç.
Qwen3.8-Max, yürütme boyunca görsellikten yararlanır; yalnızca girdileri okumaz.
Bir görev sırasında kendi ara çıktısını inceler, hizalanmamış bir arayüz veya yanlış yöne bakan bir nesne gibi sorunları tespit eder ve bunları düzeltmek için planı gözden geçirir.
Girdi tarafında, metin, grafik ve yerleşim dahil 200 sayfayı aşan PDF’leri işler ve insanlar, olaylar ve zaman damgalarından oluşan bir video hafızası grafiği oluşturarak 100 saati aşan videoları işleyebilir.
Qwen ayrıca, mevcut ajan çerçevelerine görüntü ve video işleme, çok modlu bellek ve görsel araç kullanımı ekleyen bir çerçeve uzantı kütüphanesi olan Qwen-MM-Plugins’i yayımladı.
Belge ağırlıklı veya video ağırlıklı ajanlar geliştiren herkes için, bellek grafiği izlemeye değer parça.
Qwen3.8-Max, maliyeti derinliğe karşı değiştirebilmeniz için bir reasoning_effort parametresi sunar. Üç seviye, modelin cevaplamadan önce ne kadar düşüneceğini ayarlamanıza imkân tanır:
xhigh (varsayılan): kapsamlı analiz gerektiren karmaşık görevler içinmedium: doğruluk ve hız arasında dengelow: hız ve maliyet için optimize edilmiş verimli akıl yürütmeDikkate değer: r/LocalLLaMA’da bir yorumcu, Qwen modellerinin gereğinden fazla düşündüğünü, DeepSeek V4 Flash’ın ise daha düşük kaliteli çıktı ürettiğinde bile akıl yürütmeye daha az zaman harcadığını belirtti. İş yükünüz gecikmeye duyarlıysa, varsayılanın doğru tercih olduğunu varsaymadan önce low seviyesine düşürün.
Qwen’in kıyas paketi, modele konumlandırmasıyla uyumlu olarak statik sınavlardan ziyade uzun ufuklu yürütmeye ağırlık veriyor.
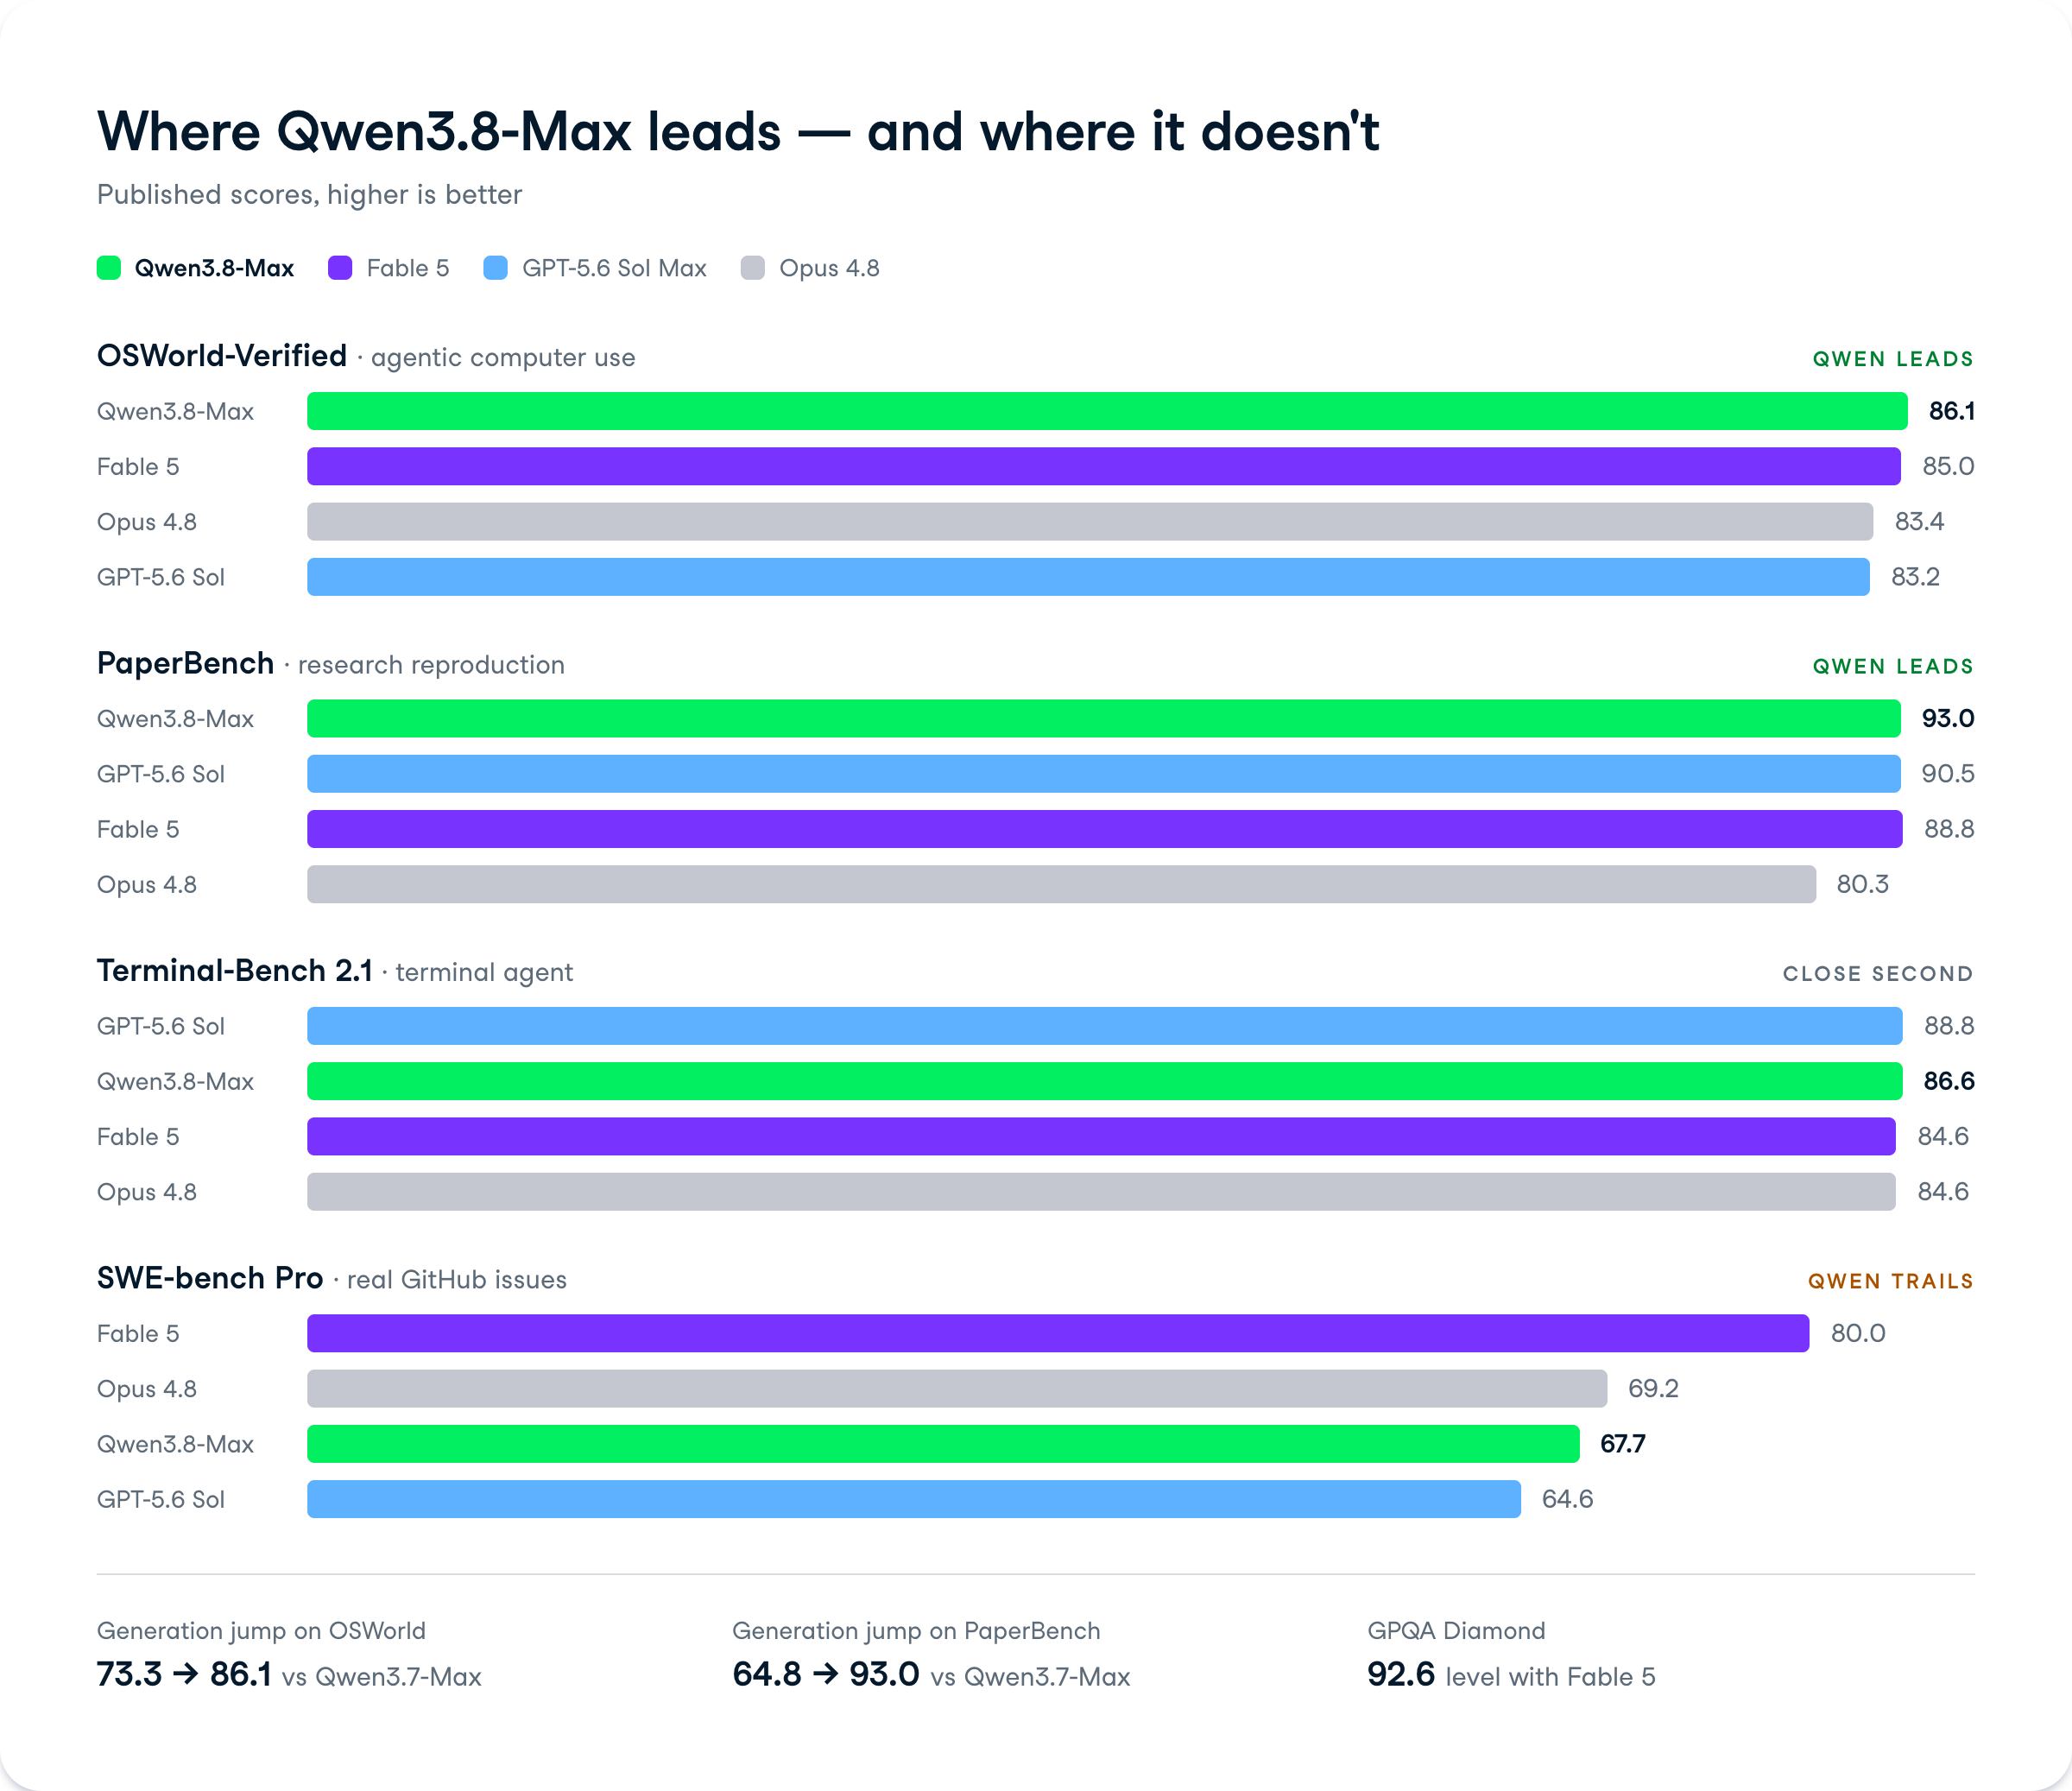
Yayımlanan tablolar genelinde Qwen3.8-Max, ajan temelli bilgisayar kullanımı, araştırma çoğaltımı ve kodlama alanlarında önde ya da oldukça rekabetçi; bazı yazılım mühendisliği değerlendirmelerinde ise GPT-5.6 Sol Max ve Fable 5’in gerisinde kalıyor.
Her kategoride baskın olmak yerine, en geniş dengeli profillerden birini sunuyor.
| Kıyas (Kategori) | Qwen 3.8 Max | Qwen 3.7 Max | Opus 4.8 | Fable 5 | Gemini 3.1-Pro | GPT5.6 Sol (max) |
|---|---|---|---|---|---|---|
| SWE-Pro (Yazılım Mühendisliği) | 67.7 | 60.6 | 69.2 | 80.0 | - | 64.6 |
| TerminalBench-2.1 (Terminal Ajanı) | 86.6 | 74.5 | 84.6 | 84.6 | - | 88.8 |
| PaperBench (Araştırma Çoğaltımı) | 93.0 | 64.8 | 80.3 | 88.8 | - | 90.5 |
| FrontierSWE (Yazılım Mühendisliği) | 73.5 | 40.7 | 70.0 | 88.8 | - | - |
| QwenReactBench (React Ön Uç) | 1724 | 1538 | 1694 | 1770 | - | 1564 |
| CoWorkBench (Profesyonel İş Birliği Görevleri) | 74.8 | 64.6 | 72.3 | 75.9 | - | 71.5 |
| JobBench (Ajanlar İnsan İş Akışlarını Güçlendirir) | 53.4 | 31.3 | 48.4 | 57.4 | - | 45.4 |
| Agents' Last Exam (Uzun Ufuklu Değerli Görevler) | 52.4 | 31.1 | 45.1 | - | - | 53.6 |
| BabyVision (Görsel Akıl Yürütme)* | 82.0 / 91.3 | 64.7 / 70.4 | 28.4 / 81.2 | 42.5 / 90.5 | 55.9 / 68.3 | 65.5 / 88.9 |
| CharXiv (RQ) (Grafik Akıl Yürütme)* | 88.4 / 93.5 | 85.8 / 85.9 | 78.5 / 89.9 | 87.9 / 93.5 | 84.4 / 89.9 | 85.1 / 89.1 |
| ERQA (Cisimlenmiş Akıl Yürütme) | 77.8 | 69.8 | 57.2 | 70.0 | 68.0 | 70.0 |
| PerceptionBench (Görsel Algı) | 63.5 | 51.1 | 47.2 | 57.2 | 56.2 | 59.7 |
| LVBench (Uzun Video Anlama) | 81.8 | 76.2 | 67.3 | 75.1 | - | 78.8 |
| Vision2Web (Görsel Web Geliştirme) | 69.0 | 42.1 | 62.4 | 70.5 | - | 62.1 |
| MobileWorld (Ajanik Mobil Kullanım) | 77.8 | 51.2 | 67.5 | 85.5 | 58.1 | 76.9 |
| OSWorld-Verified (Ajanik Bilgisayar Kullanımı) | 86.1 | 73.3 | 83.4 | 85.0 | 76.2 | 83.2 |
Önemli Notlar:
* Çift Skorlar: Çift metrik ayrıntısı veren kıyaslamalar (BabyVision ve CharXiv) için değerler, ilgili çubuklarda görüntülenen iç ve üst sayılara göre python olmadan / python ile biçiminde verilmiştir.
* Eksik Veri (-): Tire işareti, belirli modelin test edilmediği ya da skorun grafiklerden çıkarıldığı kıyaslamaları gösterir.
Qwen3.8-Max, OSWorld-Verified’da 86,1 puan alıyor; Fable 5’in (85,0), GPT-5.6 Sol Max’in (83,2) ve Gemini 3.1 Pro’nun (76,2) önünde.
Bu kıyaslama, bir bilgisayar kullanım ajanının gerçek bir masaüstü ortamını ne kadar güvenilir şekilde işlettiğini, arayüzlerde tıklayıp çok adımlı görevleri tamamlamasını ölçer.
Gerçek uygulamaları API çağırmak yerine gerçekten süren ajanlar geliştiren herkes için en kritik sayı bu. Qwen3.7-Max burada sadece 73,3 almıştı; dolayısıyla aile içinde sıçrama kayda değer.
PaperBench’te Qwen3.8-Max 93,0 puanla bildirilen en yüksek skoru alıyor; GPT-5.6 Sol’un 90,5’inin ve Fable 5’in 88,8’inin önünde.
PaperBench, bir modelin bir araştırma makalesinin deneylerini kodda yeniden üretme yeteneğini ölçer; bu da doğrudan 5 günlük araştırma çoğaltımı gösterimine karşılık gelir.
Qwen3.7-Max’in 64,8’ine göre büyük bir fark. İşiniz makaleleri çalışan hatlara dönüştürmeyi içeriyorsa, bu güçlü bir sinyal.
Qwen3.8-Max, Terminal-Bench 2.1’de 86,6 puan alıyor; GPT-5.6 Sol’un 88,8’inin ve hem Opus 4.8 hem Fable 5’in 84,6’sının arasında.
Bu kıyaslama, bir ajanı, süre sınırlı mühendislik görevlerini tamamlamak üzere terminalde çalışırken test eder.
Qwen3.7-Max’in 74,5’ine göre gerçek bir iyileşme ve açık ağırlıklı bir modeli, komut satırı ajansal işlerde en üst tescilli skorlara yaklaşma mesafesine getiriyor.
Burada Qwen3.8-Max geride kalıyor. SWE-bench Pro’da 67,7 puan alıyor; Fable 5’in 80,0’ının ve Opus 4.8’in 69,2’sinin gerisinde, ancak GPT-5.6 Sol’un 64,6’sının önünde.
SWE-bench Pro, profesyonel kod tabanlarında gerçek GitHub issue’larını çözmeyi ölçer.
Bu dürüst bir zayıf nokta. Grok 4.5’i incelerken de Fable 5, 80,4 ile SWE-Bench Pro’yu önde götürüyordu; dolayısıyla Anthropic’in modeli bu özel değerlendirmede hâlâ aşılması gereken isim.
Lisansüstü düzeyde bilimsel akıl yürütme kıyaslaması olan GPQA Diamond’da Qwen3.8-Max 92,6 puan alıyor; Fable 5 (92,6) ile aynı seviyede ve GPT-5.6 Sol’un 94,1’inin hemen gerisinde. Ayrıca IFBench’te (talimat izleme) 82,8, HealthBench’te 60,2 ve PRBench-Finance’ta 58,3 ile önde.
Desen genel olarak geçerli: ajansal ve uygulamalı işlerde güçlü, akıl yürütmede rekabetçi ve zaman zaman en zor akıl yürütme sınavı Humanity’s Last Exam’de geride; burada 43,6 alırken Fable 5 53,3 alıyor.
Qwen3.8-Max, QwenCloud üzerinden qwen3.8-max API model kimliğiyle şu anda kullanılabilir. API, OpenAI ile uyumlu sohbet tamamlama ve yanıt uç noktalarını ve ayrıca Anthropic uyumlu bir arayüzü destekler; böylece minimum yapılandırma değişikliğiyle Claude Code veya Codex’i ona yönlendirebilirsiniz.
Fiyatlandırma orta katmanda ve kıyaslandığı üst düzey ABD tescilli modellerinin altında:
Toplam $8, Claude Opus 5’in $30’unun üçte birinden az ve GPT-5.6 Sol Standard’ın $35’inin dörtte birinden düşük. Hem Qwen3.8-Max’in hem de Qwen3.8-27B’nin açık ağırlıkları gelecek hafta Hugging Face ve ModelScope’ta yayımlanacak; ancak lisans şartları henüz kamuya açık değil.
Qwen3.8-Max, açık ağırlıkların nerede rekabet edebileceğine dair Alibaba’nın bir beyanı. Fable 5 ve GPT-5.6 Sol Max’e karşı OSWorld-Verified ve PaperBench’te zirveye çıkmak ve bunu $2/$6 fiyatlı öz barındırılabilir bir modelle yapmak, tüm tescilli katmanı ajan başına maliyet açısından baskılayan türden bir hamle.
Uyarılar gerçek. 16 günlük otonom kodlama çalışması ve 5 günlük araştırma çoğaltımı tedarikçi vitrinleri; bağımsız yeniden üretimler değil ve gelecek haftaki ağırlıkların lisansı hâlâ bilinmiyor. r/LocalLLaMA’da daha ilginç tartışma, tek bir tüketici GPU’suna zekâ sığdırmayı, yalnızca birkaç kurulumun çalıştırabileceği 2,4T’lik bir devasa modele tercih eden birkaç yorumcuyla daha küçük Qwen3.8-27B etrafındaydı.
Benim görüşüm: Gerçek arayüzleri işleten veya araştırma hatlarını çoğaltan ajanlar geliştiriyorsanız, özellikle ağırlıklar yayımlandığında ve öz barındırabildiğinizde, Qwen3.8-Max ciddi şekilde test etmeye değer. İşiniz zorlu GitHub issue’larında saf profesyonel yazılım mühendisliğiyse, Fable 5 hâlâ SWE-bench Pro’da önde; bu nedenle karar vermeden önce ikisini de çalıştırın.
Bu tür modellerle API’ları üzerinden çalışmaya alışmak istiyorsanız, temelleri oluşturmak için AI Fundamentals beceri yolumuzu öneririm.
Öne Çıkan DataCamp Kursları
Kurs
Kurs
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme




