50 % de descuento en DataCamp Premium. Más de 700 cursos a mitad de precio. Empieza a aprender hoy.
Actualización: 2 de septiembre de 2026: Alibaba ha lanzado Qwen3.8-Max-0902, un snapshot mejorado de Qwen3.8-Max centrado en programación y rendimiento de agentes. Se ha añadido la siguiente sección para reflejar los nuevos benchmarks.
El 2 de septiembre de 2026, Alibaba publicó Qwen3.8-Max-0902, una mejora de post-entrenamiento de Qwen3.8-Max. La arquitectura no cambia: 2,4 billones de parámetros, contexto de 1M de tokens y el mismo precio ($2/1M de entrada, $6/1M de salida). El foco está claramente en programación y trabajo de agentes de largo recorrido.
El resultado más destacado es Code Arena WebDev, donde Qwen3.8-Max-0902 se sitúa primero con 1.691 puntos, 3 por encima de Claude Opus 5 Max (1.687), 17 por encima de Kimi K3 Max (1.674) y 22 por encima del anterior Qwen3.8-Max (1.669). También lidera la frontera de Pareto a un precio combinado de $5 por millón de tokens.
Los 8 benchmarks de programación mejoran. Los mayores saltos están en TerminalBench 3.0 (de 11,3 a 29,0) y ProgramBench Almost Solved (de 10,5 a 28,0), ambos más que duplicando. La siguiente tabla muestra la foto completa en categorías de programación, agentes y multimodal.
| Benchmark | Qwen3.8-Max-0902 | Qwen3.8-Max | Claude Opus 5 |
|---|---|---|---|
| Programación | |||
| TerminalBench 3.0 | 29.0 | 11.3 | 42.7 |
| DeepSWE 1.1 | 69.3 | 56.6 | 73.6 |
| NL2Repo-Bench | 64.9 | 55.9 | 72.3 |
| ProgramBench (Almost Solved) | 28.0 | 10.5 | 41.5 |
| SWE-Marathon | 44.8 | 39.1 | 50.0 |
| MLS-Bench-Lite | 50.1 | 41.0 | 49.8 |
| SWE-Atlas QnA | 66.3 | 60.3 | 63.2 |
| QwenSWEBench V2 | 70.0 | 55.1 | 68.0 |
| Agentes | |||
| CoWorkBench | 76.1 | 74.8 | 79.6 |
| JobBench | 64.0 | 53.4 | 67.8 |
| Toolathlon Verified | 73.3 | 72.5 | 77.6 |
| WorkArena (Elo) | 1468 | 1348 | 1437 |
| Multimodal | |||
| MMMU-Pro | 82.7 | 82.3 | 82.6 |
| ERQA | 78.3 | 77.8 | 67.3 |
En negrita se indica dónde Qwen3.8-Max-0902 supera a Claude Opus 5 en ese benchmark. Todos los resultados provienen de la tabla comparativa publicada por Alibaba.
Frente a Claude Opus 5, la actualización 0902 lidera en tres benchmarks de programación (MLS-Bench-Lite, SWE-Atlas QnA, QwenSWEBench V2) y gana en WorkArena y en las dos evaluaciones multimodales publicadas. Claude sigue por delante en TerminalBench 3.0, DeepSWE 1.1 y las pruebas de coordinación de agentes. El precio no cambia, así que si ya usabas Qwen3.8-Max, es una mejora gratuita con un impulso notable en programación. Qwen también lanzó Qwen3.8-Omni-Flash el 18 de septiembre.
Artículo original
El equipo de Qwen de Alibaba lanzó Qwen3.8-Max el 3 de agosto de 2026, y aterriza de lleno en la zona más competida de la frontera: ingeniería de software autónoma y trabajo empresarial de largo recorrido. Es la primera vez que Qwen planea publicar en abierto un modelo de clase Max, con los pesos previstos para la semana que viene junto a un Qwen3.8-27B más pequeño.
Qwen3.8-Max es un modelo mixture-of-experts (MoE) de 2,4 billones de parámetros con 95B activos por pasada, ventana de contexto de 1M de tokens y entrada nativa de texto, imagen y vídeo. El titular es que logra 86,1 en OSWorld-Verified, por delante de GPT-5.6 Sol Max con 83,2, Claude Fable 5 con 85,0 y Gemini 3.1 Pro con 76,2. También registra la puntuación más alta reportada en PaperBench con 93,0 y se tarifa a $2/$6 por millón de tokens de entrada/salida.
En este artículo, cubro todo lo nuevo de Qwen3.8-Max, reviso sus funciones para programación y agentes, exploro los benchmarks y preparo pruebas prácticas para que las ejecutes. Para contenido relacionado, consulta nuestras guías de Grok 4.5, GPT-5.6 Terra vs Claude Sonnet 5 y nuestra guía completa de la API de Claude. También puedes leer sobre el nuevo Qwen3.8-Flash.
Qwen3.8-Max es el modelo más capaz de la familia Qwen, una arquitectura MoE dispersa con 2,4 billones de parámetros totales y alrededor de 95B activos por pasada.
Se construye sobre la base arquitectónica de Qwen 3.5 y apunta específicamente a cuatro itinerarios de aprendizaje:
El mayor cambio estructural respecto a Qwen3.7-Max es la escala y el compromiso de publicar los pesos. Qwen nunca ha liberado pesos de un modelo de clase Max y afirma que tanto Qwen3.8-Max como Qwen3.8-27B llegarán a Hugging Face y ModelScope la semana que viene.
Alibaba aún no ha revelado la licencia, así que no está claro si saldrá bajo algo permisivo como Apache 2.0 o una licencia personalizada más restrictiva.
La gran noticia en benchmarks que más importa es el uso agentivo del ordenador.
En OSWorld-Verified, que mide cómo de bien un agente maneja un entorno de escritorio real, Qwen3.8-Max supera a todos los modelos propietarios contra los que Qwen lo probó.
Para un modelo que será autoalojable, es una propuesta realmente distinta a la típica publicación de pesos abiertos que va una generación por detrás de la frontera.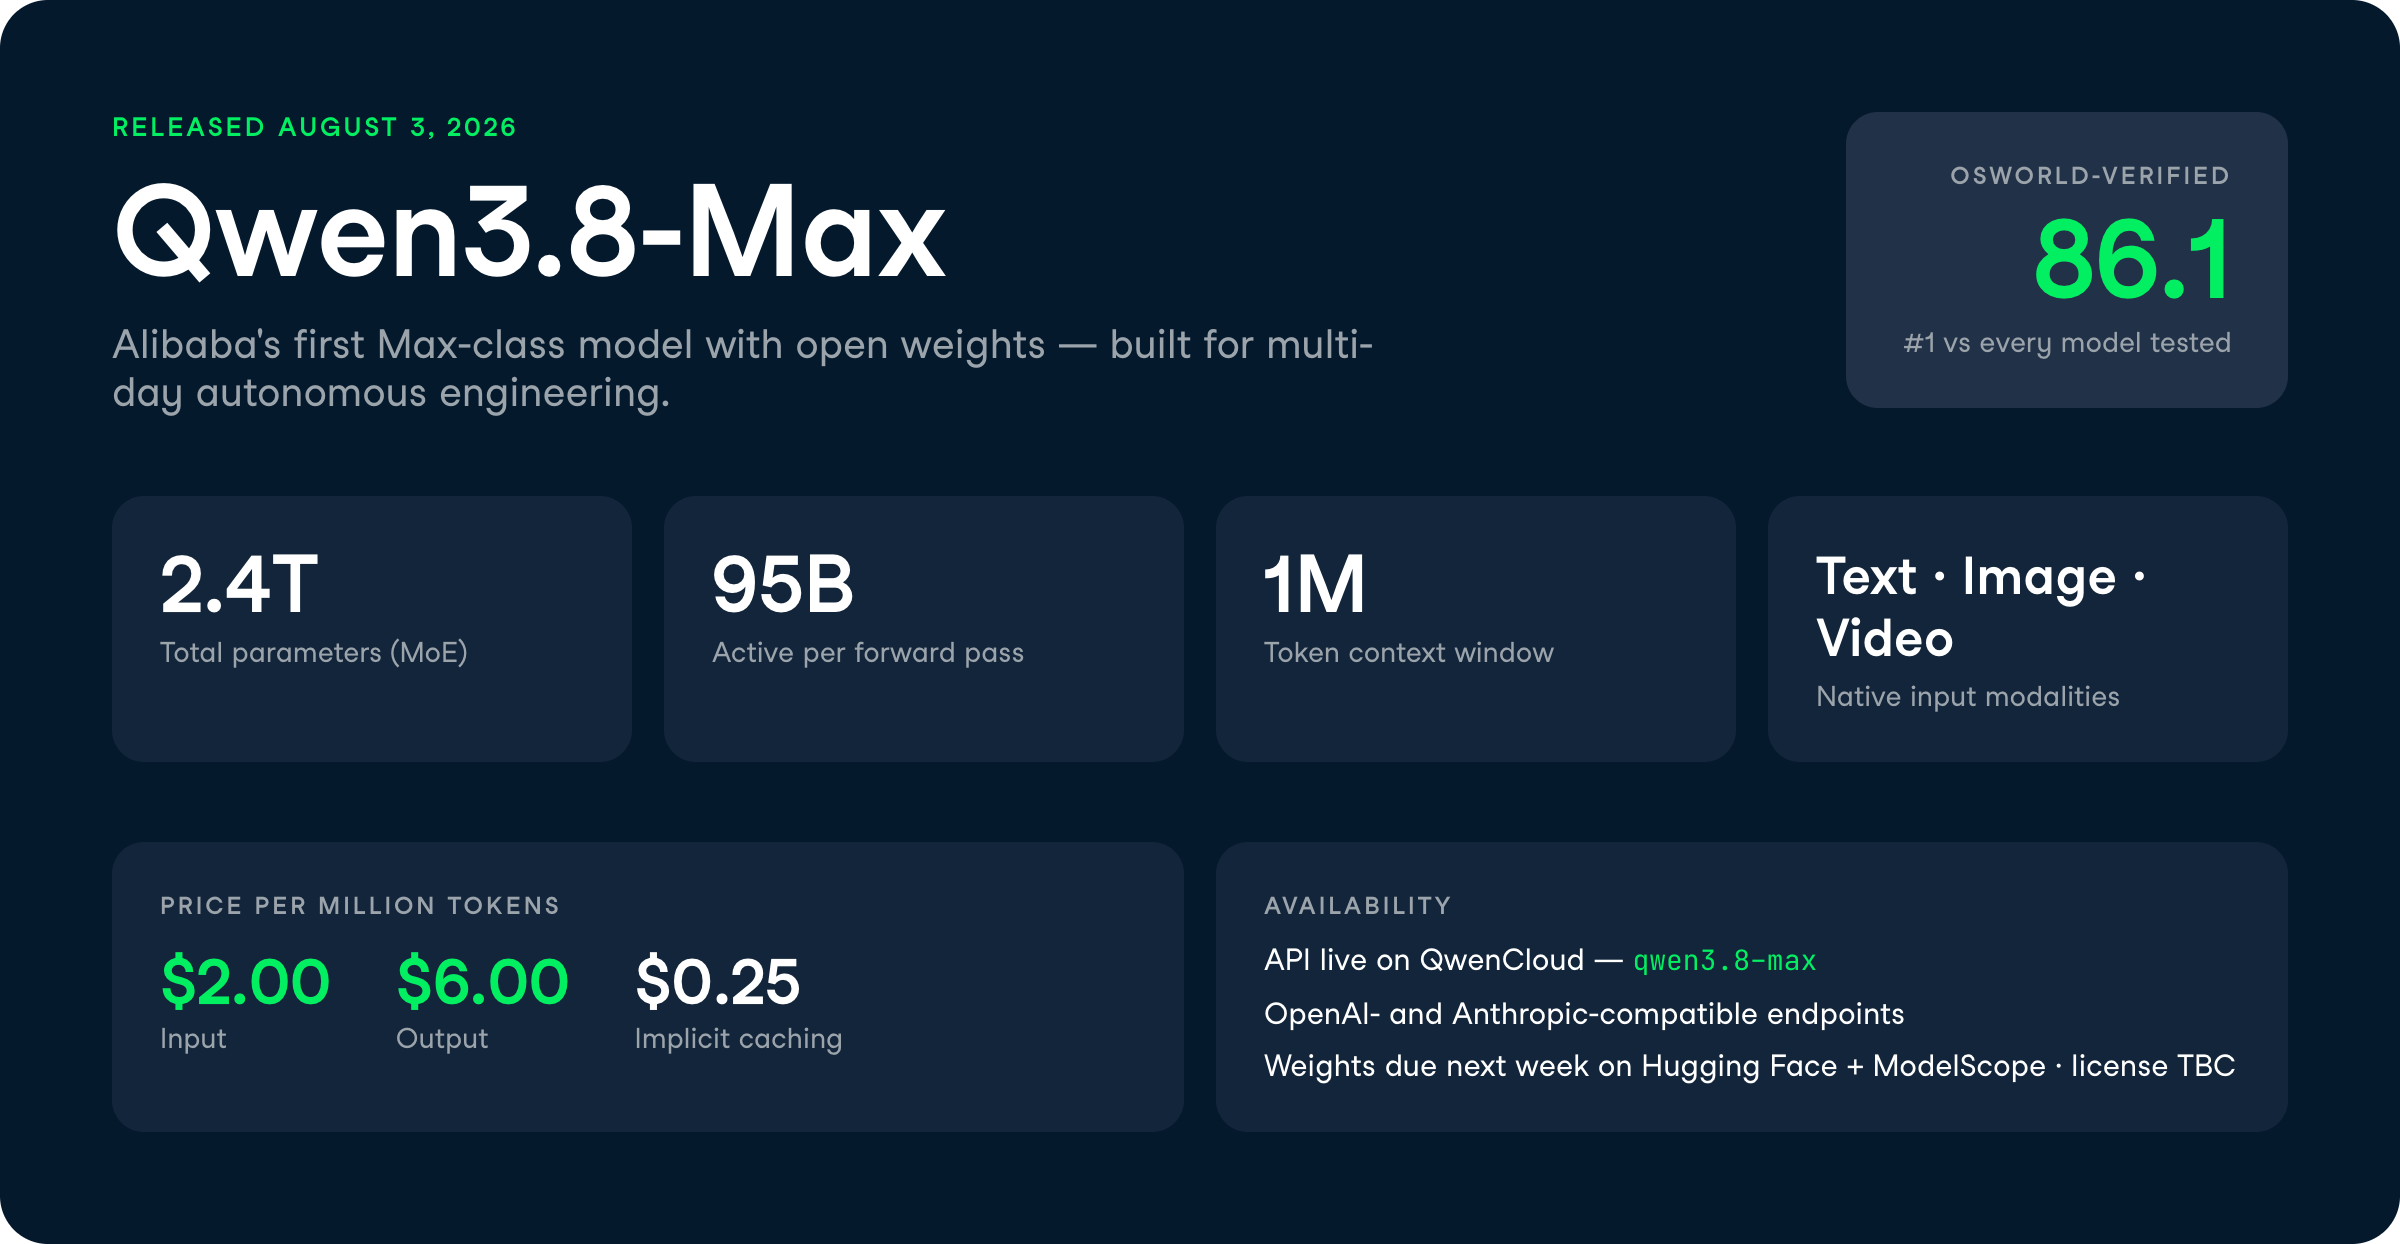
El hilo conductor en Qwen3.8-Max es la autonomía a largo plazo.
Qwen enmarca cada capacidad en la misma idea: el modelo no sigue un plan fijo; se autocorrige mediante bucles de feedback durante días de trabajo continuo.
Estas son las funciones que más me llaman la atención.
Qwen3.8-Max puede llevar un proyecto de código desde una carpeta vacía hasta un entregable final durante días de trabajo continuo sin intervención humana.
La demostración estrella de la compañía duró unos 16 días de operación totalmente autónoma, construyendo un arnés CLI autoevolutivo que acumuló 265 commits, 127 PR y 151 issues.
El mecanismo es un bucle de feedback: los requisitos entran como issues de GitHub, los agentes los reclaman y ejecutan, y luego lanzan build, tests unitarios, tests end-to-end y comprobaciones de CI antes de hacer merge.
Para los profesionales, esto apunta a un modelo diseñado para ejecutar pipelines de ingeniería desatendidos en lugar de responder preguntas de código aisladas.
La salvedad obvia es que son demostraciones del proveedor.
Una ejecución autónoma de 16 días en un entorno controlado no es lo mismo que apuntarlo a tu monorepo de producción y olvidarte.
Qwen3.8-Max puede leer un artículo científico, reproducir sus experimentos en código desde cero e intentar mejorar el método original.
En el ejemplo de Qwen, el modelo trabajó unos 5 días (~125 horas), escribió unas 7.600 líneas de código, realizó más de 1.100 acciones y ejecutó 33 rondas de entrenamiento en GPU sin código base inicial.
Primero reprodujo los seis hallazgos principales del artículo y luego ejecutó un bucle de auto-mejora de hipótesis, código, ejecución en GPU y análisis a lo largo de 4 rondas y 18 ideas.
El método final que ideó superó el enfoque del propio artículo en 2,71 puntos en AIME24, un benchmark de matemáticas a nivel de competición.
Este es el tipo de flujo de trabajo que normalmente consume una semana de un equipo de investigación solo en la preparación antes de empezar a experimentar.
Dynamic Workflows permite a Qwen3.8-Max planificar una tarea de forma programática y despachar grandes cantidades de subagentes en paralelo.
En una demostración de investigación cuantitativa, el modelo descompuso 6 descripciones cortas de factores en 50 líneas de investigación cada una, lanzó unos 330 subagentes y completó alrededor de 6.000 backtests, adaptando el flujo sobre la marcha.
Lo que lo diferencia de un script fijo es que el modelo actuó en base a evidencias.
Cuando detectó señales de sobreajuste, fue podando factores redundantes ronda a ronda; cuando el ensamblado de tres modelos parecía menos robusto que la síntesis de dirección fija en secciones pequeñas, cambió de marco por sí mismo.
Los factores seleccionados alcanzaron ratios de Sharpe en exceso de 0,64 a 1,48, un resultado concreto y comprobable, no solo una impresión.
Qwen3.8-Max utiliza visión durante toda la ejecución, no solo para leer entradas.
Mientras realiza una tarea, inspecciona su salida intermedia, detecta problemas como una interfaz desalineada u objetos orientados al revés y revisa el plan para corregirlos.
En la entrada, maneja PDFs de más de 200 páginas con texto, gráficos y maquetación, y puede procesar vídeos de más de 100 horas construyendo un grafo de memoria de vídeo de personas, eventos y marcas de tiempo.
Qwen también lanzó Qwen-MM-Plugins, una librería de extensiones para el arnés que añade procesamiento de imagen y vídeo, memoria multimodal y uso de herramientas visuales a frameworks de agentes existentes.
Para quienes construyen agentes centrados en documentos o vídeo, el grafo de memoria es la pieza a vigilar.
Qwen3.8-Max expone un parámetro reasoning_effort para que puedas equilibrar coste y profundidad. Tres niveles te permiten ajustar cuánto piensa el modelo antes de responder:
xhigh (por defecto): para tareas complejas que requieren análisis a fondomedium: equilibrio entre precisión y velocidadlow: razonamiento eficiente optimizado para velocidad y costeA tener en cuenta: un usuario de r/LocalLLaMA señaló que los modelos de Qwen tienden a sobrepensar, y que DeepSeek V4 Flash dedica menos tiempo a razonar aunque entregue una calidad inferior. Si tu carga es sensible a la latencia, baja a low antes de asumir que el valor por defecto es el adecuado.
La batería de benchmarks de Qwen se inclina claramente hacia la ejecución a largo plazo más que a exámenes estáticos, lo que encaja con su posicionamiento.
En las tablas publicadas, Qwen3.8-Max lidera o se mantiene muy competitivo en uso agentivo del ordenador, reproducción de investigación y programación, aunque queda por detrás de GPT-5.6 Sol Max y Fable 5 en algunas evaluaciones de ingeniería de software.
Ofrece uno de los perfiles más equilibrados y amplios, en lugar de dominar cada categoría.
| Benchmark (categoría) | Qwen 3.8 Max | Qwen 3.7 Max | Opus 4.8 | Fable 5 | Gemini 3.1-Pro | GPT5.6 Sol (max) |
|---|---|---|---|---|---|---|
| SWE-Pro (ingeniería de software) | 67.7 | 60.6 | 69.2 | 80.0 | - | 64.6 |
| TerminalBench-2.1 (agente en terminal) | 86.6 | 74.5 | 84.6 | 84.6 | - | 88.8 |
| PaperBench (reproducción de investigación) | 93.0 | 64.8 | 80.3 | 88.8 | - | 90.5 |
| FrontierSWE (ingeniería de software) | 73.5 | 40.7 | 70.0 | 88.8 | - | - |
| QwenReactBench (frontend React) | 1724 | 1538 | 1694 | 1770 | - | 1564 |
| CoWorkBench (tareas profesionales en equipo) | 74.8 | 64.6 | 72.3 | 75.9 | - | 71.5 |
| JobBench (agentes que potencian flujos humanos) | 53.4 | 31.3 | 48.4 | 57.4 | - | 45.4 |
| Agents' Last Exam (tareas valiosas de largo recorrido) | 52.4 | 31.1 | 45.1 | - | - | 53.6 |
| BabyVision (razonamiento visual)* | 82.0 / 91.3 | 64.7 / 70.4 | 28.4 / 81.2 | 42.5 / 90.5 | 55.9 / 68.3 | 65.5 / 88.9 |
| CharXiv (RQ) (razonamiento con gráficos)* | 88.4 / 93.5 | 85.8 / 85.9 | 78.5 / 89.9 | 87.9 / 93.5 | 84.4 / 89.9 | 85.1 / 89.1 |
| ERQA (razonamiento encarnado) | 77.8 | 69.8 | 57.2 | 70.0 | 68.0 | 70.0 |
| PerceptionBench (percepción visual) | 63.5 | 51.1 | 47.2 | 57.2 | 56.2 | 59.7 |
| LVBench (comprensión de vídeo largo) | 81.8 | 76.2 | 67.3 | 75.1 | - | 78.8 |
| Vision2Web (desarrollo web visual) | 69.0 | 42.1 | 62.4 | 70.5 | - | 62.1 |
| MobileWorld (uso agentivo en móvil) | 77.8 | 51.2 | 67.5 | 85.5 | 58.1 | 76.9 |
| OSWorld-Verified (uso agentivo del ordenador) | 86.1 | 73.3 | 83.4 | 85.0 | 76.2 | 83.2 |
Notas importantes:
* Puntuaciones dobles: En benchmarks con métricas dobles (BabyVision y CharXiv), los valores se muestran como sin python / con python según los números interiores y superiores en esas barras específicas.
* Datos ausentes (-): Los guiones indican benchmarks donde ese modelo no fue probado o la puntuación se excluyó de los gráficos.
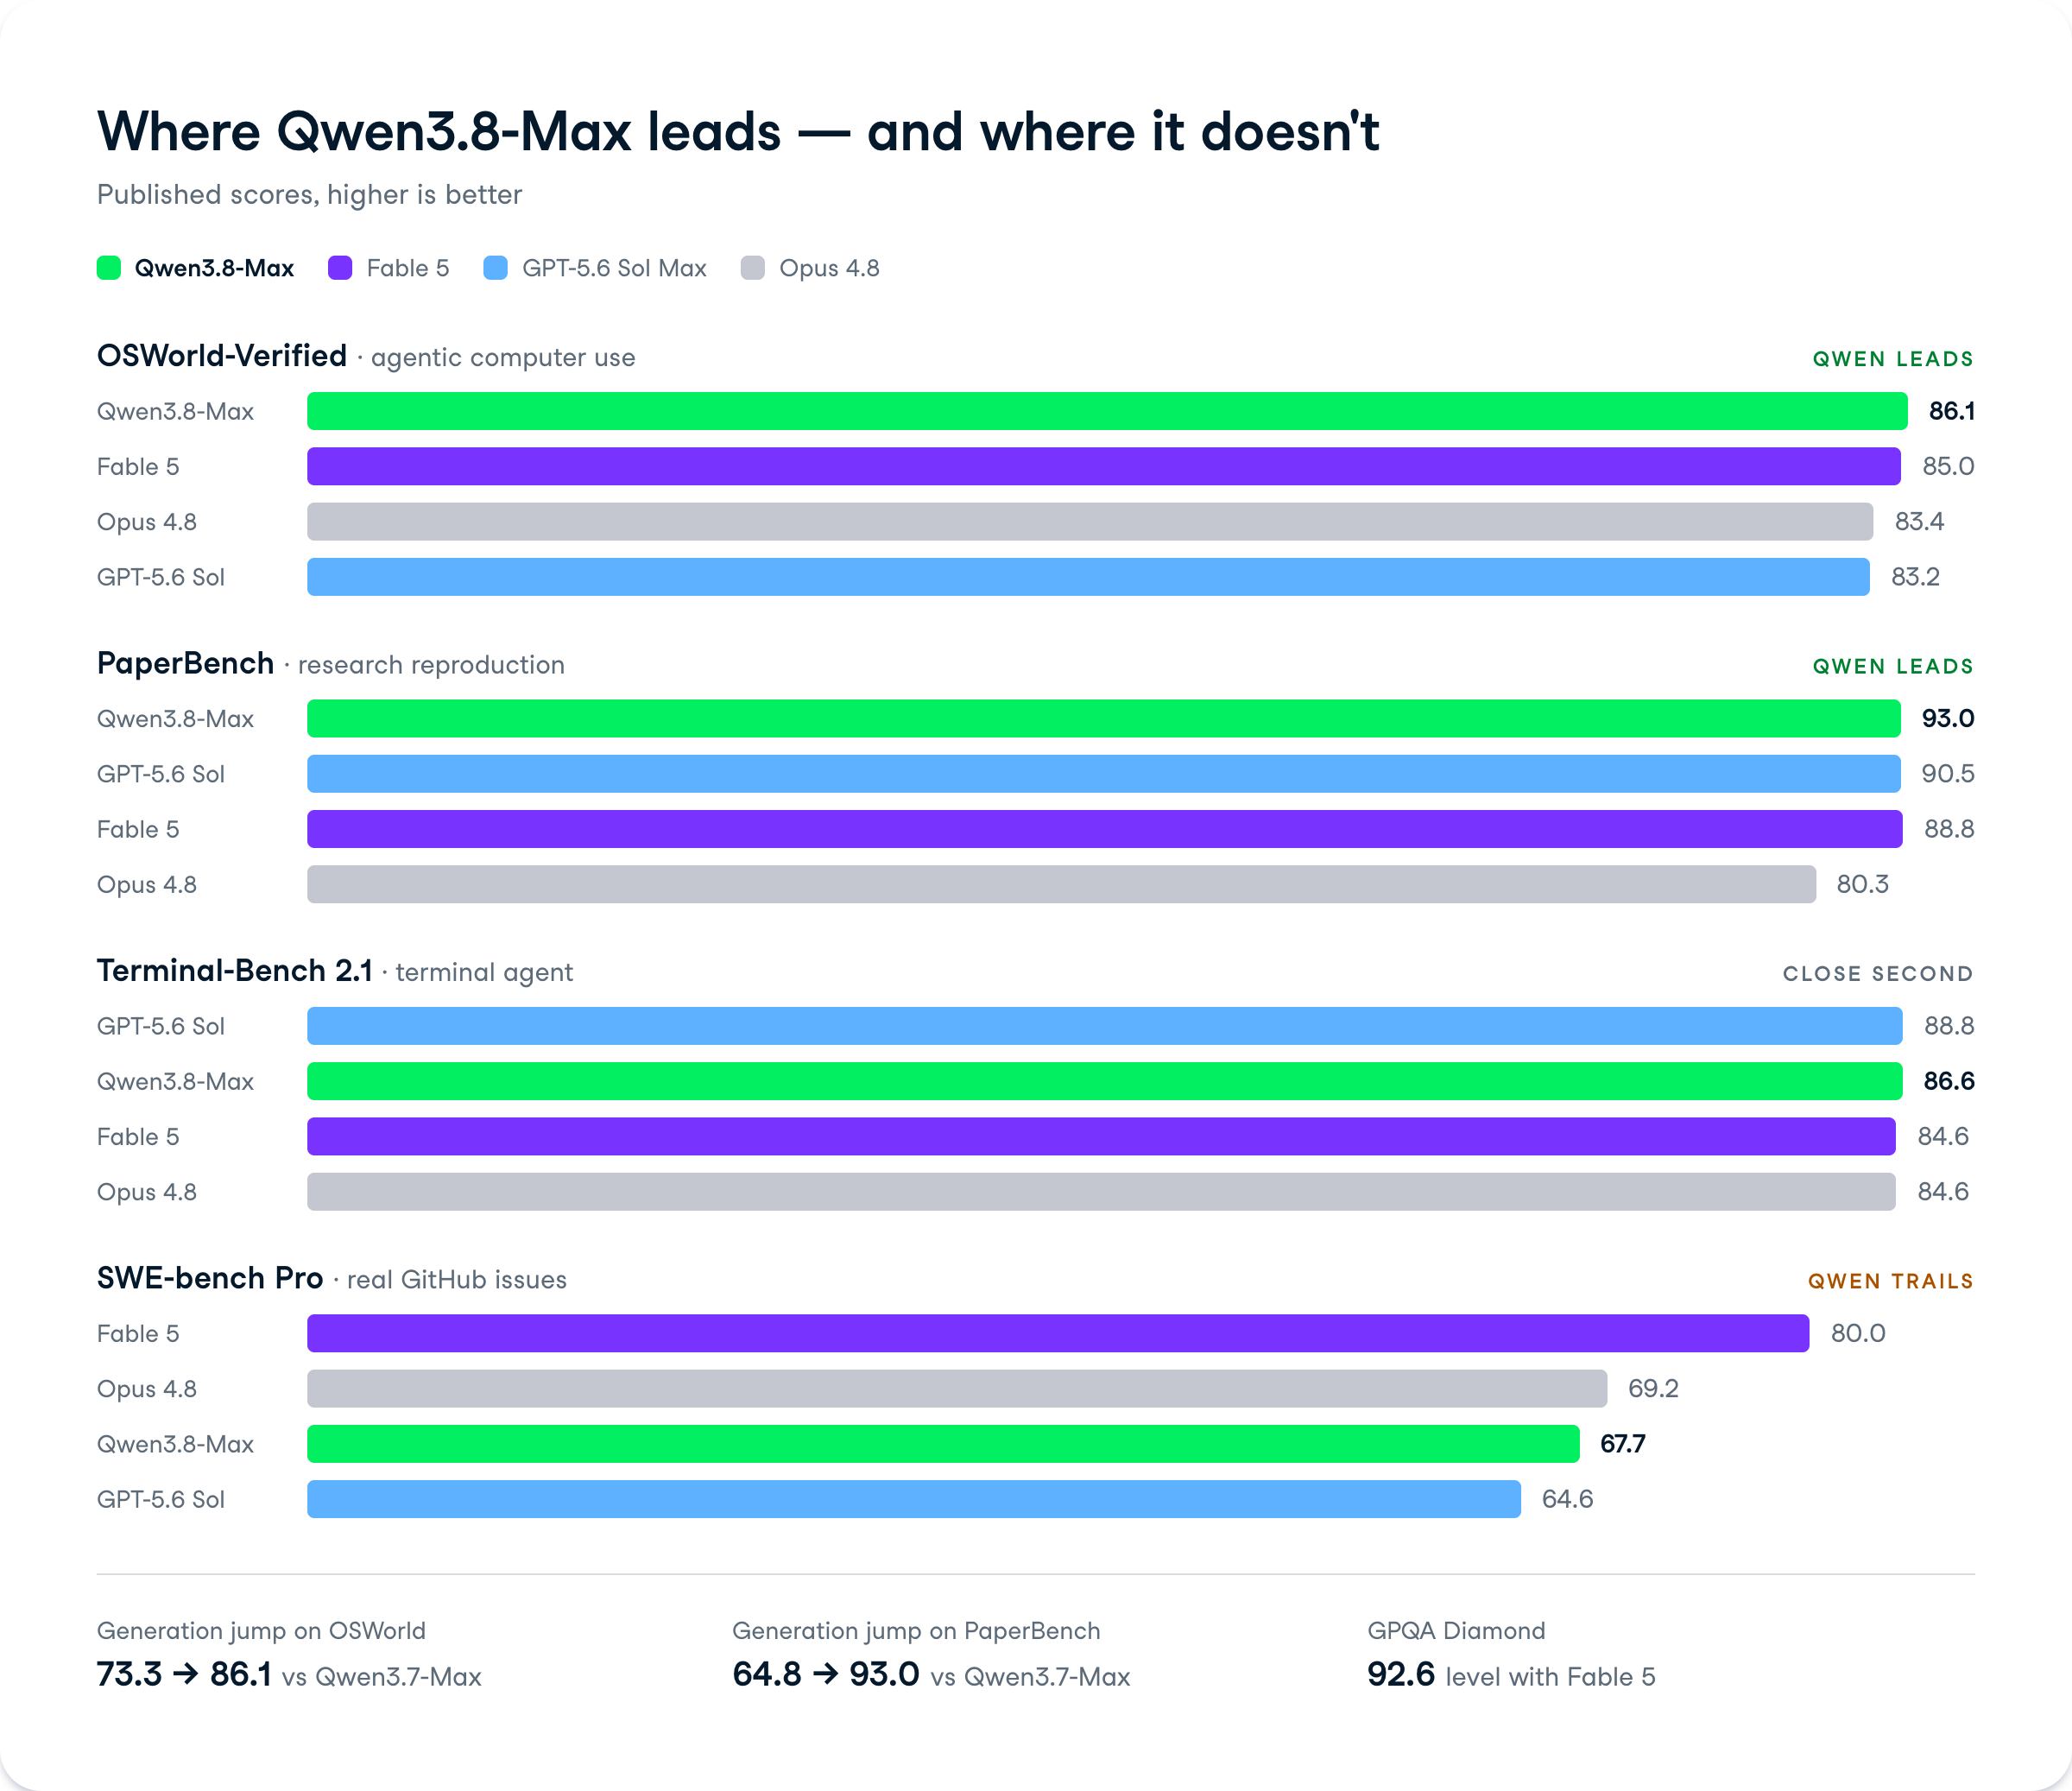
Qwen3.8-Max obtiene 86,1 en OSWorld-Verified, por delante de Fable 5 (85,0), GPT-5.6 Sol Max (83,2) y Gemini 3.1 Pro (76,2).
Este benchmark mide la fiabilidad con la que un agente de uso del ordenador maneja un escritorio real, haciendo clic por las interfaces y completando tareas de varios pasos.
Para quien construye agentes que manejan aplicaciones reales en lugar de llamar APIs, este es el número que más importa. Qwen3.7-Max solo marcó 73,3 aquí, así que el salto es importante dentro de la familia.
En PaperBench, Qwen3.8-Max registra 93,0, la puntuación más alta reportada, por delante de GPT-5.6 Sol con 90,5 y Fable 5 con 88,8.
PaperBench mide la capacidad de un modelo para reproducir en código los experimentos de un artículo, lo que encaja con la demostración de 5 días de reproducción de investigación.
Es una brecha grande frente a Qwen3.7-Max con 64,8. Si tu trabajo consiste en convertir papers en pipelines funcionales, es una señal potente.
Qwen3.8-Max marca 86,6 en Terminal-Bench 2.1, entre GPT-5.6 Sol con 88,8 y los 84,6 de Opus 4.8 y Fable 5.
Este benchmark evalúa a un agente trabajando en terminal para completar tareas de ingeniería bajo límite de tiempo.
Es una mejora real sobre los 74,5 de Qwen3.7-Max, y sitúa a un modelo de pesos abiertos muy cerca de las mejores puntuaciones propietarias en trabajo agentivo por línea de comandos.
Aquí Qwen3.8-Max queda por detrás. Consigue 67,7 en SWE-bench Pro, por debajo de Fable 5 con 80,0 y Opus 4.8 con 69,2, aunque por delante de GPT-5.6 Sol con 64,6.
SWE-bench Pro mide la resolución de issues reales de GitHub en bases de código profesionales.
Este es el punto débil honesto. Cuando analizamos Grok 4.5, Fable 5 también lideraba SWE-Bench Pro con 80,4, así que el modelo de Anthropic sigue siendo el rival a batir en esta prueba concreta.
En GPQA Diamond, un benchmark de razonamiento científico a nivel de posgrado, Qwen3.8-Max puntúa 92,6, a la par con Fable 5 (92,6) y justo por detrás de GPT-5.6 Sol con 94,1. También lidera en IFBench (seguimiento de instrucciones) con 82,8, HealthBench con 60,2 y PRBench-Finance con 58,3.
El patrón se mantiene: fuerte en trabajo agentivo y aplicado, competitivo en razonamiento y, a veces, por detrás en el examen de razonamiento más duro, Humanity's Last Exam, donde obtiene 43,6 frente a 53,3 de Fable 5.
Qwen3.8-Max ya está disponible en QwenCloud mediante el ID de modelo de API qwen3.8-max. La API es compatible con los endpoints de chat completions y responses de OpenAI, además de una interfaz compatible con Anthropic, así que puedes apuntar Claude Code o Codex con cambios mínimos de configuración.
El precio se sitúa en la gama media y mejora a los principales modelos propietarios estadounidenses con los que se compara:
Ese total combinado de $8 es menos de un tercio de los $30 de Claude Opus 5 y menos de una cuarta parte de los $35 de GPT-5.6 Sol Standard. Igual a Grok 4.5, que también cuesta $2/$6, como señalamos en nuestra cobertura de Grok 4.5. Los pesos abiertos de Qwen3.8-Max y Qwen3.8-27B llegarán a Hugging Face y ModelScope la semana que viene, aunque los términos de la licencia aún no son públicos.
Qwen3.8-Max es la forma de Alibaba de marcar dónde pueden competir los pesos abiertos. Liderar OSWorld-Verified y PaperBench frente a Fable 5 y GPT-5.6 Sol Max, con un modelo autoalojable a $2/$6, es el tipo de movimiento que presiona a toda la gama propietaria en coste por tarea agentiva.
Las salvedades son reales. La ejecución autónoma de 16 días y la reproducción de investigación de 5 días son demostraciones del proveedor, no reproducciones independientes, y la licencia de los pesos de la semana que viene sigue sin conocerse. En r/LocalLLaMA, el debate más interesante era sobre el Qwen3.8-27B más pequeño, con varios comentarios más entusiasmados por comprimir inteligencia en una sola GPU de consumo que por un coloso de 2,4T que solo unos pocos montajes pueden ejecutar.
Mi opinión: si estás creando agentes que operan interfaces reales o reproducen pipelines de investigación, Qwen3.8-Max merece pruebas serias, especialmente cuando publiquen los pesos y puedas autoalojarlo. Si tu trabajo es ingeniería de software profesional pura sobre issues complejas de GitHub, Fable 5 sigue liderando SWE-bench Pro, así que prueba ambos antes de decidir.
Si quieres familiarizarte con modelos así a través de sus APIs, te recomiendo nuestro itinerario de aprendizaje AI Fundamentals para construir primero los fundamentos.
Los mejores cursos de DataCamp
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Programa} other {Programas}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
9 min
{count, plural, one {blog} other {blogs}}
Ryan Ong
8 min
{count, plural, one {Tutorial} other {Tutoriales}}
Moez Ali
11 min
{count, plural, one {Tutorial} other {Tutoriales}}
Dimitri Didmanidze
9 min
{count, plural, one {Tutorial} other {Tutoriales}}
Abid Ali Awan
12 min
{count, plural, one {Tutorial} other {Tutoriales}}
Dimitri Didmanidze
8 min