
Last chance! 50% off DataCamp Premium
Sale ends in
Cập nhật: 2 tháng 9, 2026: Alibaba đã phát hành Qwen3.8-Max-0902, một bản snapshot nâng cấp của Qwen3.8-Max tập trung vào hiệu năng lập trình và agent. Phần dưới đây đã được bổ sung để phản ánh các điểm benchmark mới.
Ngày 2 tháng 9, 2026, Alibaba phát hành Qwen3.8-Max-0902, một bản nâng cấp hậu huấn luyện cho Qwen3.8-Max. Kiến trúc không đổi: 2,4 nghìn tỷ tham số, ngữ cảnh 1 triệu token, và mức giá giữ nguyên ($2/1 triệu token đầu vào, $6/1 triệu token đầu ra). Trọng tâm là lập trình và công việc agent dài hạn.
Kết quả nổi bật là Code Arena WebDev, nơi Qwen3.8-Max-0902 đứng hạng nhất chung cuộc với 1.691 điểm, cao hơn Claude Opus 5 Max 3 điểm (1.687), cao hơn Kimi K3 Max 17 điểm (1.674), và cao hơn Qwen3.8-Max trước đó 22 điểm (1.669). Mô hình cũng giữ vị trí dẫn đầu trên biên Pareto ở mức chi phí pha trộn $5 mỗi triệu token.
Cả 8 benchmark lập trình đều tăng. Mức tăng lớn nhất ở TerminalBench 3.0 (từ 11,3 lên 29,0) và ProgramBench Almost Solved (từ 10,5 lên 28,0), đều hơn gấp đôi. Bảng dưới đây cho thấy bức tranh đầy đủ trên các hạng mục lập trình, agent và đa phương thức.
| Benchmark | Qwen3.8-Max-0902 | Qwen3.8-Max | Claude Opus 5 |
|---|---|---|---|
| Lập trình | |||
| TerminalBench 3.0 | 29.0 | 11.3 | 42.7 |
| DeepSWE 1.1 | 69.3 | 56.6 | 73.6 |
| NL2Repo-Bench | 64.9 | 55.9 | 72.3 |
| ProgramBench (Almost Solved) | 28.0 | 10.5 | 41.5 |
| SWE-Marathon | 44.8 | 39.1 | 50.0 |
| MLS-Bench-Lite | 50.1 | 41.0 | 49.8 |
| SWE-Atlas QnA | 66.3 | 60.3 | 63.2 |
| QwenSWEBench V2 | 70.0 | 55.1 | 68.0 |
| Agent | |||
| CoWorkBench | 76.1 | 74.8 | 79.6 |
| JobBench | 64.0 | 53.4 | 67.8 |
| Toolathlon Verified | 73.3 | 72.5 | 77.6 |
| WorkArena (Elo) | 1468 | 1348 | 1437 |
| Đa phương thức | |||
| MMMU-Pro | 82.7 | 82.3 | 82.6 |
| ERQA | 78.3 | 77.8 | 67.3 |
In đậm cho biết Qwen3.8-Max-0902 dẫn trước Claude Opus 5 trên benchmark đó. Tất cả kết quả từ bảng so sánh công bố bởi Alibaba.
So với Claude Opus 5, bản 0902 dẫn trên ba benchmark lập trình (MLS-Bench-Lite, SWE-Atlas QnA, QwenSWEBench V2) và thắng trên WorkArena cùng cả hai bài đánh giá đa phương thức được công bố. Claude vẫn dẫn ở TerminalBench 3.0, DeepSWE 1.1 và các benchmark phối hợp agent. Giá không đổi, nên nếu bạn đã dùng Qwen3.8-Max, đây là nâng cấp miễn phí với cải thiện đáng kể về lập trình. Qwen cũng đã phát hành Qwen3.8-Omni-Flash vào ngày 18 tháng 9.
Bài viết gốc
Nhóm Qwen của Alibaba phát hành Qwen3.8-Max ngày 3 tháng 8, 2026, nhắm thẳng vào phân khúc cạnh tranh nhất của thị trường tiên phong: kỹ thuật phần mềm tự động và công việc doanh nghiệp dài hạn. Đây là lần đầu Qwen dự định mở mã một mô hình hạng Max, với trọng số dự kiến ra mắt vào tuần tới cùng với Qwen3.8-27B nhỏ hơn.
Qwen3.8-Max là mô hình mixture-of-experts (MoE) thưa với 2,4 nghìn tỷ tham số, 95B tham số hoạt động, cửa sổ ngữ cảnh 1 triệu token và đầu vào gốc cho văn bản, hình ảnh, video. Tuyên bố nổi bật là đạt 86,1 trên OSWorld-Verified, vượt GPT-5.6 Sol Max ở mức 83,2, Claude Fable 5 ở 85,0 và Gemini 3.1 Pro ở 76,2. Mô hình cũng đạt điểm PaperBench cao nhất được báo cáo là 93,0 và có giá $2/$6 mỗi triệu token vào/ra.
Trong bài viết này, tôi sẽ điểm qua mọi thứ mới với Qwen3.8-Max, xem các tính năng lập trình và agent, khám phá các benchmark, và thiết lập thử nghiệm thực tế để bạn chạy. Liên quan, xem các hướng dẫn của chúng tôi về Grok 4.5, GPT-5.6 Terra vs Claude Sonnet 5, và hướng dẫn đầy đủ về Claude API. Bạn cũng có thể đọc về Qwen3.8-Flash mới.
Qwen3.8-Max là mô hình mạnh nhất trong họ Qwen, kiến trúc MoE thưa với tổng 2,4 nghìn tỷ tham số và khoảng 95B tham số hoạt động mỗi lần truyền xuôi.
Mô hình được xây dựng trên nền tảng kiến trúc của Qwen 3.5 và nhắm đến bốn hướng cụ thể:
Thay đổi cấu trúc lớn nhất so với Qwen3.7-Max là quy mô và cam kết mở trọng số. Qwen chưa từng phát hành trọng số cho mô hình hạng Max trước đây, và công ty cho biết cả Qwen3.8-Max và Qwen3.8-27B sẽ lên Hugging Face và ModelScope vào tuần tới.
Alibaba chưa công bố giấy phép, nên chưa rõ liệu sẽ theo kiểu mở thoáng như Apache 2.0 hay một giấy phép tuỳ chỉnh hạn chế hơn.
Tin lớn ở mặt benchmark quan trọng nhất là việc dùng máy tính theo kiểu agent.
Trên OSWorld-Verified, thước đo khả năng agent vận hành một môi trường desktop thực, Qwen3.8-Max dẫn trước mọi mô hình độc quyền mà Qwen đem ra so sánh.
Với một mô hình có thể tự lưu trữ, đây thực sự là một đề xuất khác biệt so với các bản mở trọng số thường tụt hậu một thế hệ so với tuyến đầu.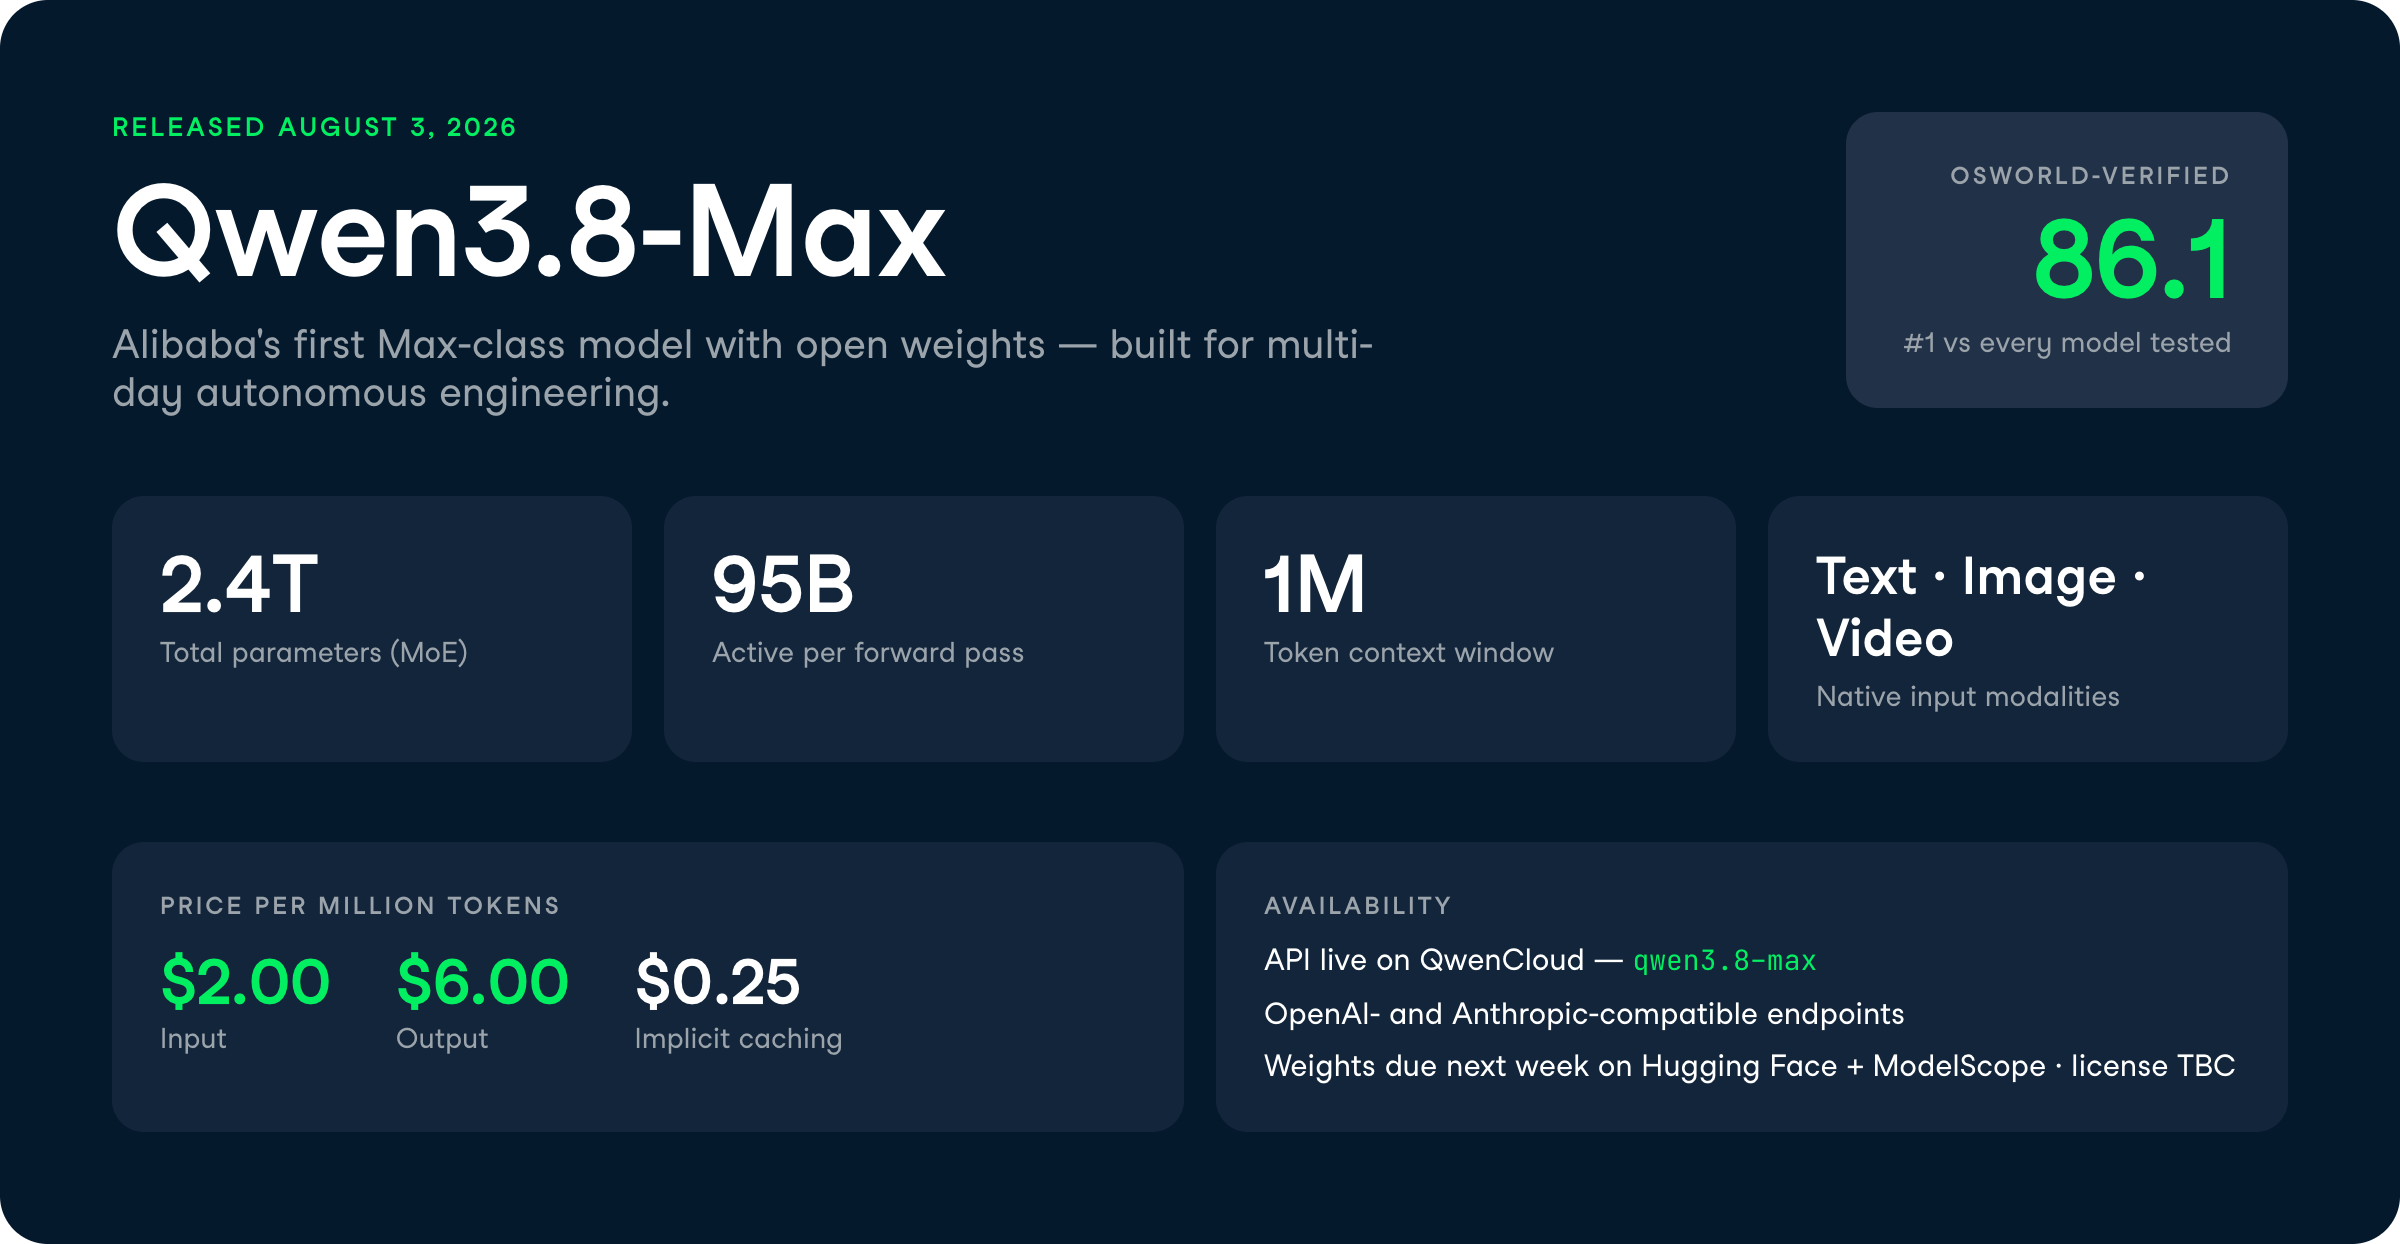
Chủ đề xuyên suốt Qwen3.8-Max là tính tự chủ trong khoảng thời gian dài.
Qwen đóng khung mọi năng lực quanh cùng một ý tưởng: mô hình không theo kế hoạch cố định; nó tự hiệu chỉnh qua các vòng phản hồi trong nhiều ngày làm việc liên tục.
Dưới đây là các tính năng nổi bật nhất với tôi.
Qwen3.8-Max có thể đưa một dự án lập trình từ thư mục trống đến sản phẩm hoàn thiện qua nhiều ngày làm việc liên tục mà không cần con người can thiệp.
Bài trình diễn tiêu biểu của công ty chạy khoảng 16 ngày vận hành hoàn toàn tự động, xây dựng một bộ khung CLI tự phát triển với 265 commit, 127 PR và 151 issue.
Cơ chế là một vòng phản hồi: yêu cầu vào dưới dạng issue GitHub, agent nhận và thực thi, sau đó kích hoạt build, unit test, kiểm thử end-to-end và kiểm tra CI trước khi merge.
Với người làm thực tế, điều này hướng tới một mô hình được thiết kế để vận hành pipeline kỹ thuật không cần giám sát thay vì trả lời các câu hỏi mã lẻ tẻ.
Lưu ý hiển nhiên: đây là các màn trình diễn do nhà cung cấp thực hiện.
Một lần chạy tự động 16 ngày trong môi trường kiểm soát không đồng nghĩa bạn trỏ mô hình vào monorepo production của mình rồi rời đi.
Qwen3.8-Max có thể đọc một bài báo nghiên cứu, tái lập thí nghiệm của nó bằng mã từ đầu, rồi thử vượt qua phương pháp gốc.
Trong ví dụ của Qwen, mô hình làm việc khoảng 5 ngày (~125 giờ), viết chừng 7.600 dòng mã, thực hiện hơn 1.100 hành động, và chạy 33 vòng huấn luyện GPU mà không có mã khởi đầu.
Trước hết, mô hình tái lập sáu phát hiện chính của bài báo, sau đó chạy vòng tự cải thiện gồm giả thuyết, mã, chạy GPU và phân tích qua 4 vòng với 18 ý tưởng.
Phương pháp cuối cùng mà mô hình nghĩ ra vượt cách tiếp cận của bài báo 2,71 điểm trên AIME24, một benchmark toán học ở cấp độ thi đấu.
Đây là loại quy trình thường ngốn cả tuần thiết lập của một nhóm nghiên cứu trước khi thí nghiệm bắt đầu.
Dynamic Workflows cho phép Qwen3.8-Max lập kế hoạch tác vụ theo chương trình và phân phối số lượng lớn sub-agent chạy song song.
Trong một màn trình diễn nghiên cứu định lượng, mô hình phân rã 6 mô tả yếu tố ngắn thành mỗi yếu tố 50 hướng nghiên cứu, phân phối khoảng 330 sub-agent, và hoàn thành khoảng 6.000 backtest, thích ứng quy trình giữa chừng.
Điểm khác biệt so với script cố định là mô hình hành động dựa trên bằng chứng.
Khi phát hiện tín hiệu overfit, mô hình cắt tỉa yếu tố dư thừa theo vòng; khi ensemble ba mô hình kém vững hơn tổng hợp hướng cố định trên các phân đoạn nhỏ, mô hình tự chuyển khung làm việc.
Các yếu tố được chọn đạt hệ số Sharpe vượt trội từ 0,64 đến 1,48, tức là kết quả cụ thể, có thể kiểm chứng thay vì cảm tính.
Qwen3.8-Max dùng thị giác xuyên suốt quá trình thực thi, không chỉ để đọc đầu vào.
Trong khi làm nhiệm vụ, mô hình kiểm tra đầu ra trung gian của chính mình, phát hiện vấn đề như giao diện lệch hàng hoặc vật thể quay sai hướng, rồi chỉnh sửa kế hoạch để khắc phục.
Ở phía đầu vào, mô hình xử lý PDF hơn 200 trang bao gồm văn bản, biểu đồ và bố cục, và có thể xử lý video dài hơn 100 giờ bằng cách xây dựng đồ thị bộ nhớ video gồm người, sự kiện và mốc thời gian.
Qwen cũng phát hành Qwen-MM-Plugins, một thư viện mở rộng harness bổ sung xử lý ảnh và video, bộ nhớ đa phương thức và sử dụng công cụ thị giác cho các framework agent hiện có.
Với ai xây dựng agent xử lý tài liệu hoặc video nặng, đồ thị bộ nhớ là phần đáng chú ý.
Qwen3.8-Max cung cấp tham số reasoning_effort để bạn cân bằng chi phí và độ sâu. Ba mức cho phép tinh chỉnh lượng suy nghĩ trước khi trả lời:
xhigh (mặc định): cho tác vụ phức tạp cần phân tích kỹmedium: cân bằng độ chính xác và tốc độlow: suy luận hiệu quả tối ưu cho tốc độ và chi phíCần lưu ý: một người dùng r/LocalLLaMA nhận xét các mô hình Qwen thường “nghĩ quá nhiều”, trong khi DeepSeek V4 Flash dành ít thời gian suy luận hơn dù đầu ra đôi khi kém chất lượng hơn. Nếu công việc nhạy về độ trễ, hãy chuyển xuống low trước khi mặc định dùng mức tiêu chuẩn.
Bộ benchmark của Qwen thiên nhiều về thực thi dài hạn thay vì các bài thi tĩnh, phù hợp với định vị của mô hình.
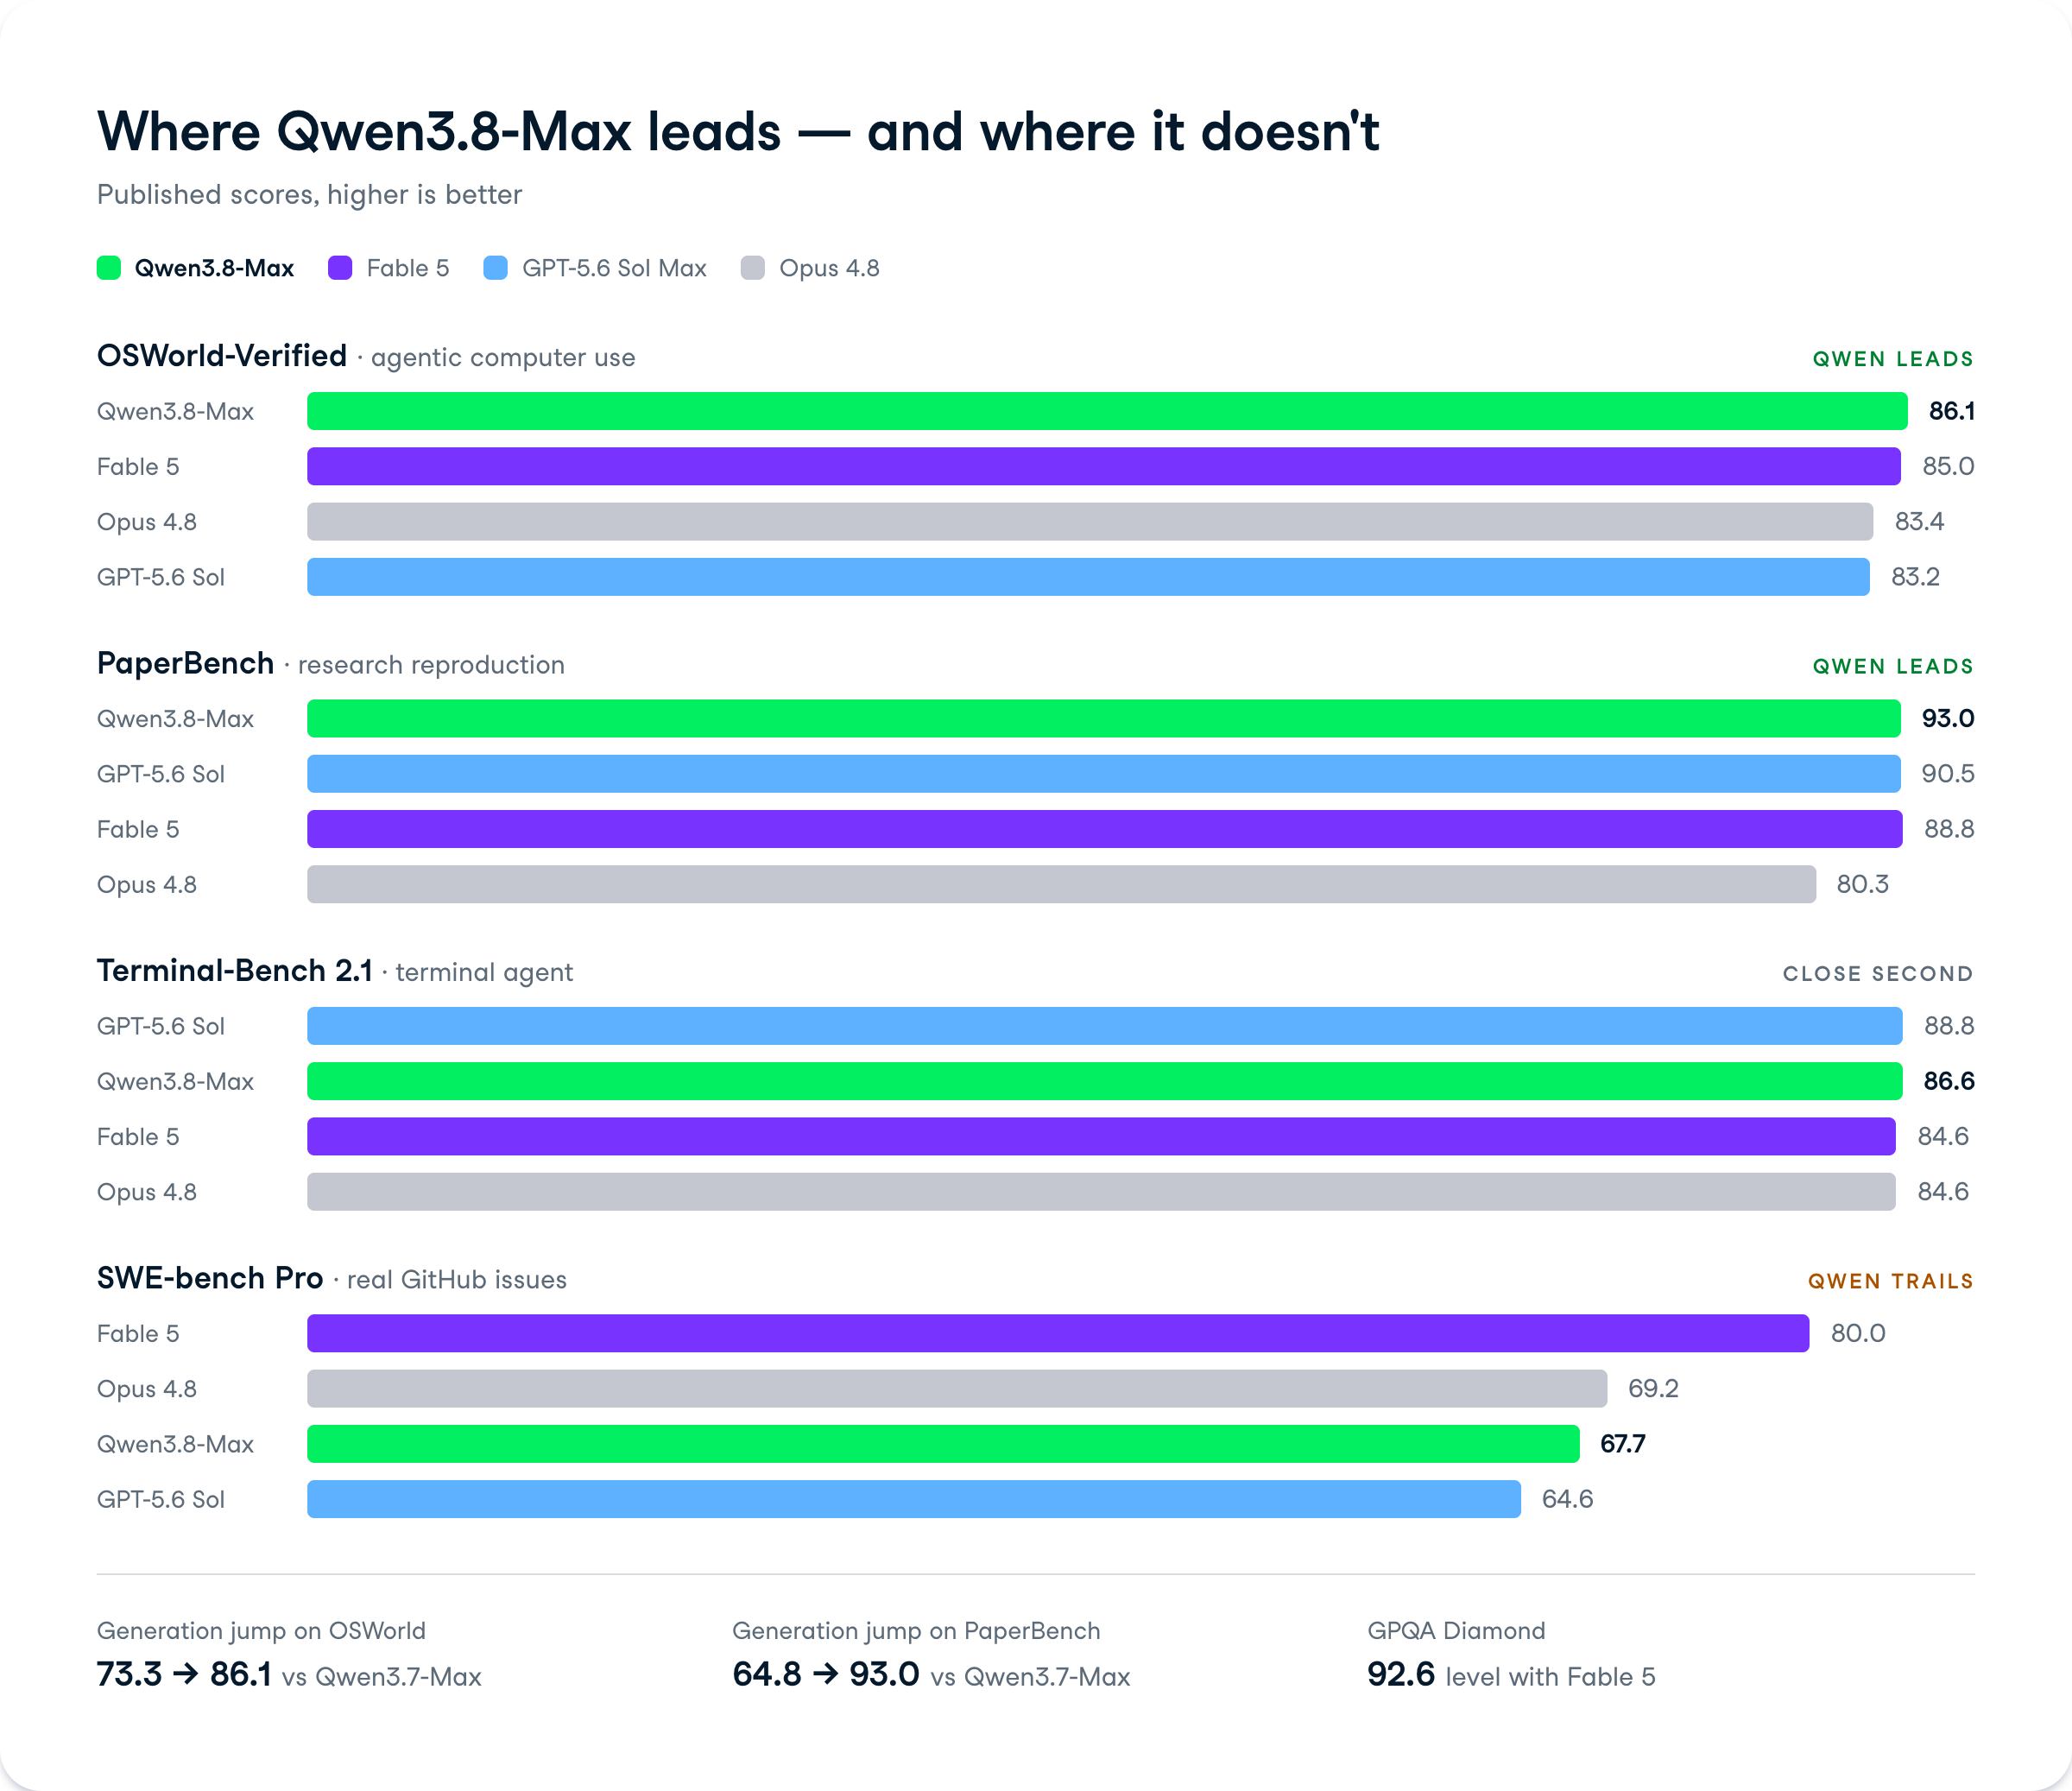
Trong các bảng công bố, Qwen3.8-Max dẫn đầu hoặc rất cạnh tranh ở sử dụng máy tính theo kiểu agent, tái lập nghiên cứu và lập trình, trong khi theo sau GPT-5.6 Sol Max và Fable 5 ở một vài đánh giá kỹ thuật phần mềm.
Mô hình mang lại một hồ sơ cân bằng rộng thay vì thống trị mọi hạng mục.
| Benchmark (Danh mục) | Qwen 3.8 Max | Qwen 3.7 Max | Opus 4.8 | Fable 5 | Gemini 3.1-Pro | GPT5.6 Sol (max) |
|---|---|---|---|---|---|---|
| SWE-Pro (Kỹ thuật phần mềm) | 67.7 | 60.6 | 69.2 | 80.0 | - | 64.6 |
| TerminalBench-2.1 (Agent Terminal) | 86.6 | 74.5 | 84.6 | 84.6 | - | 88.8 |
| PaperBench (Tái lập nghiên cứu) | 93.0 | 64.8 | 80.3 | 88.8 | - | 90.5 |
| FrontierSWE (Kỹ thuật phần mềm) | 73.5 | 40.7 | 70.0 | 88.8 | - | - |
| QwenReactBench (Frontend React) | 1724 | 1538 | 1694 | 1770 | - | 1564 |
| CoWorkBench (Nhiệm vụ đồng nghiệp chuyên nghiệp) | 74.8 | 64.6 | 72.3 | 75.9 | - | 71.5 |
| JobBench (Agent hỗ trợ quy trình công việc) | 53.4 | 31.3 | 48.4 | 57.4 | - | 45.4 |
| Agents' Last Exam (Nhiệm vụ dài hạn giá trị) | 52.4 | 31.1 | 45.1 | - | - | 53.6 |
| BabyVision (Suy luận thị giác)* | 82.0 / 91.3 | 64.7 / 70.4 | 28.4 / 81.2 | 42.5 / 90.5 | 55.9 / 68.3 | 65.5 / 88.9 |
| CharXiv (RQ) (Suy luận biểu đồ)* | 88.4 / 93.5 | 85.8 / 85.9 | 78.5 / 89.9 | 87.9 / 93.5 | 84.4 / 89.9 | 85.1 / 89.1 |
| ERQA (Suy luận nhập thể) | 77.8 | 69.8 | 57.2 | 70.0 | 68.0 | 70.0 |
| PerceptionBench (Nhận thức thị giác) | 63.5 | 51.1 | 47.2 | 57.2 | 56.2 | 59.7 |
| LVBench (Hiểu video dài) | 81.8 | 76.2 | 67.3 | 75.1 | - | 78.8 |
| Vision2Web (Phát triển web bằng thị giác) | 69.0 | 42.1 | 62.4 | 70.5 | - | 62.1 |
| MobileWorld (Sử dụng di động kiểu agent) | 77.8 | 51.2 | 67.5 | 85.5 | 58.1 | 76.9 |
| OSWorld-Verified (Sử dụng máy tính kiểu agent) | 86.1 | 73.3 | 83.4 | 85.0 | 76.2 | 83.2 |
Lưu ý quan trọng:
* Điểm kép: Với các benchmark có hai chỉ số (BabyVision và CharXiv), giá trị được định dạng là w/o python / w/ python dựa trên con số bên trong và trên đỉnh hiển thị trên các cột đó.
* Thiếu dữ liệu (-): Dấu gạch ngang cho biết benchmark mà mô hình cụ thể chưa được thử nghiệm hoặc điểm bị loại khỏi biểu đồ.
Qwen3.8-Max đạt 86,1 trên OSWorld-Verified, vượt Fable 5 (85,0), GPT-5.6 Sol Max (83,2) và Gemini 3.1 Pro (76,2).
Benchmark này đo mức độ tin cậy khi một agent sử dụng máy tính vận hành môi trường desktop thực, nhấp qua giao diện và hoàn thành các tác vụ nhiều bước.
Với những ai xây dựng agent điều khiển ứng dụng thực thay vì gọi API, đây là con số quan trọng nhất. Qwen3.7-Max chỉ đạt 73,3 ở đây, nên mức tăng là đáng kể trong cùng họ.
Trên PaperBench, Qwen3.8-Max đạt 93,0, điểm cao nhất được báo cáo, vượt GPT-5.6 Sol ở 90,5 và Fable 5 ở 88,8.
PaperBench đo khả năng của mô hình trong việc tái lập thí nghiệm của một bài báo nghiên cứu bằng mã, trực tiếp phản ánh màn trình diễn tái lập nghiên cứu 5 ngày.
Đây là khoảng cách lớn so với Qwen3.7-Max ở mức 64,8. Nếu công việc của bạn là chuyển bài báo thành pipeline vận hành, đây là tín hiệu mạnh.
Qwen3.8-Max đạt 86,6 trên Terminal-Bench 2.1, nằm giữa GPT-5.6 Sol ở 88,8 và 84,6 của cả Opus 4.8 và Fable 5.
Benchmark này kiểm tra một agent làm việc trong terminal để hoàn thành tác vụ kỹ thuật trong giới hạn thời gian.
Đây là cải thiện thực sự so với 74,5 của Qwen3.7-Max, và đặt một mô hình mở trọng số tiến sát các điểm số độc quyền hàng đầu ở công việc agent trên dòng lệnh.
Ở đây Qwen3.8-Max thua kém. Mô hình đạt 67,7 trên SWE-bench Pro, sau Fable 5 ở 80,0 và Opus 4.8 ở 69,2, dù cao hơn GPT-5.6 Sol ở 64,6.
SWE-bench Pro đo khả năng giải quyết issue GitHub thực trong các codebase chuyên nghiệp.
Đây là điểm yếu thẳng thắn. Khi chúng tôi đánh giá Grok 4.5, Fable 5 cũng dẫn SWE-Bench Pro ở 80,4, nên mô hình của Anthropic vẫn là đối thủ cần vượt ở bài đánh giá này.
Trên GPQA Diamond, một benchmark suy luận khoa học bậc sau đại học, Qwen3.8-Max đạt 92,6, ngang Fable 5 (92,6) và chỉ sau GPT-5.6 Sol ở 94,1. Mô hình cũng dẫn ở IFBench (tuân thủ hướng dẫn) với 82,8, HealthBench 60,2 và PRBench-Finance 58,3.
Mẫu hình lặp lại: mạnh ở công việc agent và ứng dụng, cạnh tranh về suy luận, và đôi khi thua ở bài thi suy luận khó nhất, Humanity's Last Exam, nơi mô hình đạt 43,6 so với 53,3 của Fable 5.
Qwen3.8-Max hiện có trên QwenCloud qua API với model ID qwen3.8-max. API hỗ trợ các endpoint chat completions và responses tương thích OpenAI cũng như giao diện tương thích Anthropic, vì vậy bạn có thể trỏ Claude Code hoặc Codex vào với rất ít thay đổi cấu hình.
Giá ở tầm trung và thấp hơn các mô hình độc quyền hàng đầu tại Mỹ mà nó so sánh:
Tổng $8 này thấp hơn một phần ba so với $30 của Claude Opus 5 và thấp hơn một phần tư so với $35 của GPT-5.6 Sol Standard. Mức này khớp với Grok 4.5, cũng định giá $2/$6, như chúng tôi đã nêu trong bài về Grok 4.5. Trọng số mở của cả Qwen3.8-Max và Qwen3.8-27B sẽ lên Hugging Face và ModelScope vào tuần tới, dù điều khoản giấy phép chưa công khai.
Qwen3.8-Max là tuyên bố của Alibaba về nơi mà mô hình mở trọng số có thể cạnh tranh. Dẫn đầu OSWorld-Verified và PaperBench trước Fable 5 và GPT-5.6 Sol Max, với một mô hình có thể tự lưu trữ giá $2/$6, là động thái gây sức ép lên toàn bộ tầng mô hình độc quyền về chi phí cho mỗi tác vụ agent.
Những lưu ý là có thật. Lần chạy lập trình tự động 16 ngày và tái lập nghiên cứu 5 ngày là màn trình diễn của nhà cung cấp, không phải tái lập độc lập, và giấy phép cho trọng số tuần tới vẫn chưa rõ. Trên r/LocalLLaMA, cuộc tranh luận thú vị hơn xoay quanh Qwen3.8-27B nhỏ hơn, với một số bình luận hào hứng về việc “nén” trí tuệ vào một GPU tiêu dùng đơn hơn là một khổng lồ 2,4T chỉ vài hệ thống có thể chạy.
Quan điểm của tôi: nếu bạn xây dựng agent vận hành giao diện thực hoặc tái lập pipeline nghiên cứu, Qwen3.8-Max đáng để thử nghiệm nghiêm túc, nhất là khi trọng số được phát hành và bạn có thể tự lưu trữ. Nếu công việc của bạn là kỹ thuật phần mềm chuyên nghiệp thuần túy trên các issue GitHub khó nhằn, Fable 5 vẫn dẫn SWE-bench Pro, nên hãy chạy cả hai trước khi quyết định.
Nếu bạn muốn làm quen làm việc với các mô hình như thế này qua API của chúng, tôi khuyên bạn bắt đầu với lộ trình kỹ năng AI Fundamentals để xây nền tảng trước.
Khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Lộ trình
