Curso
Codificação com IA para Desenvolvedores
1 h 30 min
10.7K
Atualização: 2 de setembro de 2026: a Alibaba lançou o Qwen3.8-Max-0902, um snapshot aprimorado do Qwen3.8-Max com foco em performance de codificação e agentes. A seção abaixo foi adicionada para refletir os novos benchmarks.
Em 2 de setembro de 2026, a Alibaba lançou o Qwen3.8-Max-0902, uma atualização pós-treinamento do Qwen3.8-Max. A arquitetura permanece a mesma: 2,4 trilhões de parâmetros, contexto de 1M de tokens e o mesmo preço (US$2/1M de entrada, US$6/1M de saída). O foco está claramente em código e trabalho de agentes com horizontes longos.
O destaque é o Code Arena WebDev, no qual o Qwen3.8-Max-0902 ficou em primeiro lugar geral com 1.691 pontos, 3 pontos acima do Claude Opus 5 Max (1.687), 17 acima do Kimi K3 Max (1.674) e 22 acima do Qwen3.8-Max anterior (1.669). Ele também ocupa a posição de topo na fronteira de Pareto com um custo combinado de US$5 por milhão de tokens.
Todos os 8 benchmarks de codificação melhoraram. Os maiores ganhos foram no TerminalBench 3.0 (de 11,3 para 29,0) e no ProgramBench Almost Solved (de 10,5 para 28,0), ambos mais que dobrando. A tabela abaixo mostra o panorama completo em categorias de código, agentes e multimodalidade.
| Benchmark | Qwen3.8-Max-0902 | Qwen3.8-Max | Claude Opus 5 |
|---|---|---|---|
| Código | |||
| TerminalBench 3.0 | 29,0 | 11,3 | 42,7 |
| DeepSWE 1.1 | 69,3 | 56,6 | 73,6 |
| NL2Repo-Bench | 64,9 | 55,9 | 72,3 |
| ProgramBench (Almost Solved) | 28,0 | 10,5 | 41,5 |
| SWE-Marathon | 44,8 | 39,1 | 50,0 |
| MLS-Bench-Lite | 50,1 | 41,0 | 49,8 |
| SWE-Atlas QnA | 66,3 | 60,3 | 63,2 |
| QwenSWEBench V2 | 70,0 | 55,1 | 68,0 |
| Agentes | |||
| CoWorkBench | 76,1 | 74,8 | 79,6 |
| JobBench | 64,0 | 53,4 | 67,8 |
| Toolathlon Verified | 73,3 | 72,5 | 77,6 |
| WorkArena (Elo) | 1468 | 1348 | 1437 |
| Multimodal | |||
| MMMU-Pro | 82,7 | 82,3 | 82,6 |
| ERQA | 78,3 | 77,8 | 67,3 |
Negrito indica que o Qwen3.8-Max-0902 supera o Claude Opus 5 naquele benchmark. Todos os resultados vêm da tabela de comparação publicada pela Alibaba.
Em relação ao Claude Opus 5, a atualização 0902 lidera em três benchmarks de código (MLS-Bench-Lite, SWE-Atlas QnA, QwenSWEBench V2) e vence no WorkArena e nos dois testes multimodais publicados. O preço não mudou, então, se você já usava o Qwen3.8-Max, este é um upgrade gratuito com ganho relevante em código. A Qwen também lançou o Qwen3.8-Omni-Flash em 18 de setembro.
Artigo original
A equipe Qwen da Alibaba lançou o Qwen3.8-Max em 3 de agosto de 2026, posicionando-o no segmento mais disputado da fronteira: engenharia de software autônoma e trabalho corporativo de longo prazo. É a primeira vez que a Qwen planeja abrir o código de um modelo da classe Max, com os pesos previstos para a próxima semana, junto com um Qwen3.8-27B menor.
O Qwen3.8-Max é um modelo mixture-of-experts (MoE) esparso com 2,4 trilhões de parâmetros e 95B ativos por passo de inferência, janela de contexto de 1M de tokens e entrada nativa de texto, imagem e vídeo. O grande destaque é a pontuação 86,1 no OSWorld-Verified, à frente do GPT-5.6 Sol Max (83,2), do Claude Fable 5 (85,0) e do Gemini 3.1 Pro (76,2). Ele também registra a maior pontuação reportada no PaperBench, com 93,0, e tem preço de US$2/US$6 por milhão de tokens de entrada/saída.
Neste artigo, vou cobrir tudo que há de novo no Qwen3.8-Max, analisando os recursos de código e agentes, explorando os benchmarks e preparando testes práticos para você rodar. Para leituras relacionadas, confira nossos guias sobre Grok 4.5, GPT-5.6 Terra vs Claude Sonnet 5 e nosso guia completo da API do Claude. Você também pode ler sobre o novo Qwen3.8-Flash.
O Qwen3.8-Max é o modelo mais capaz da família Qwen, com arquitetura MoE esparsa, 2,4 trilhões de parâmetros totais e cerca de 95B ativos por forward pass.
Ele se baseia na fundação arquitetural do Qwen 3.5 e mira especificamente quatro trilhas:
A maior mudança estrutural em relação ao Qwen3.7-Max é a escala e o compromisso com pesos abertos. A Qwen nunca liberou pesos de um modelo classe Max antes, e a empresa diz que tanto o Qwen3.8-Max quanto o Qwen3.8-27B chegarão ao Hugging Face e ao ModelScope na próxima semana.
A Alibaba ainda não divulgou a licença, então não está claro se será algo permissivo como Apache 2.0 ou uma licença personalizada mais restritiva.
A grande novidade nos benchmarks que mais importam é o uso agentivo do computador.
No OSWorld-Verified, que mede o quão bem um agente opera um ambiente de desktop real, o Qwen3.8-Max lidera todos os modelos proprietários contra os quais a Qwen o testou.
Para um modelo que poderá ser auto-hospedado, isso é uma proposta realmente diferente do habitual lançamento de pesos abertos que fica uma geração atrás da fronteira.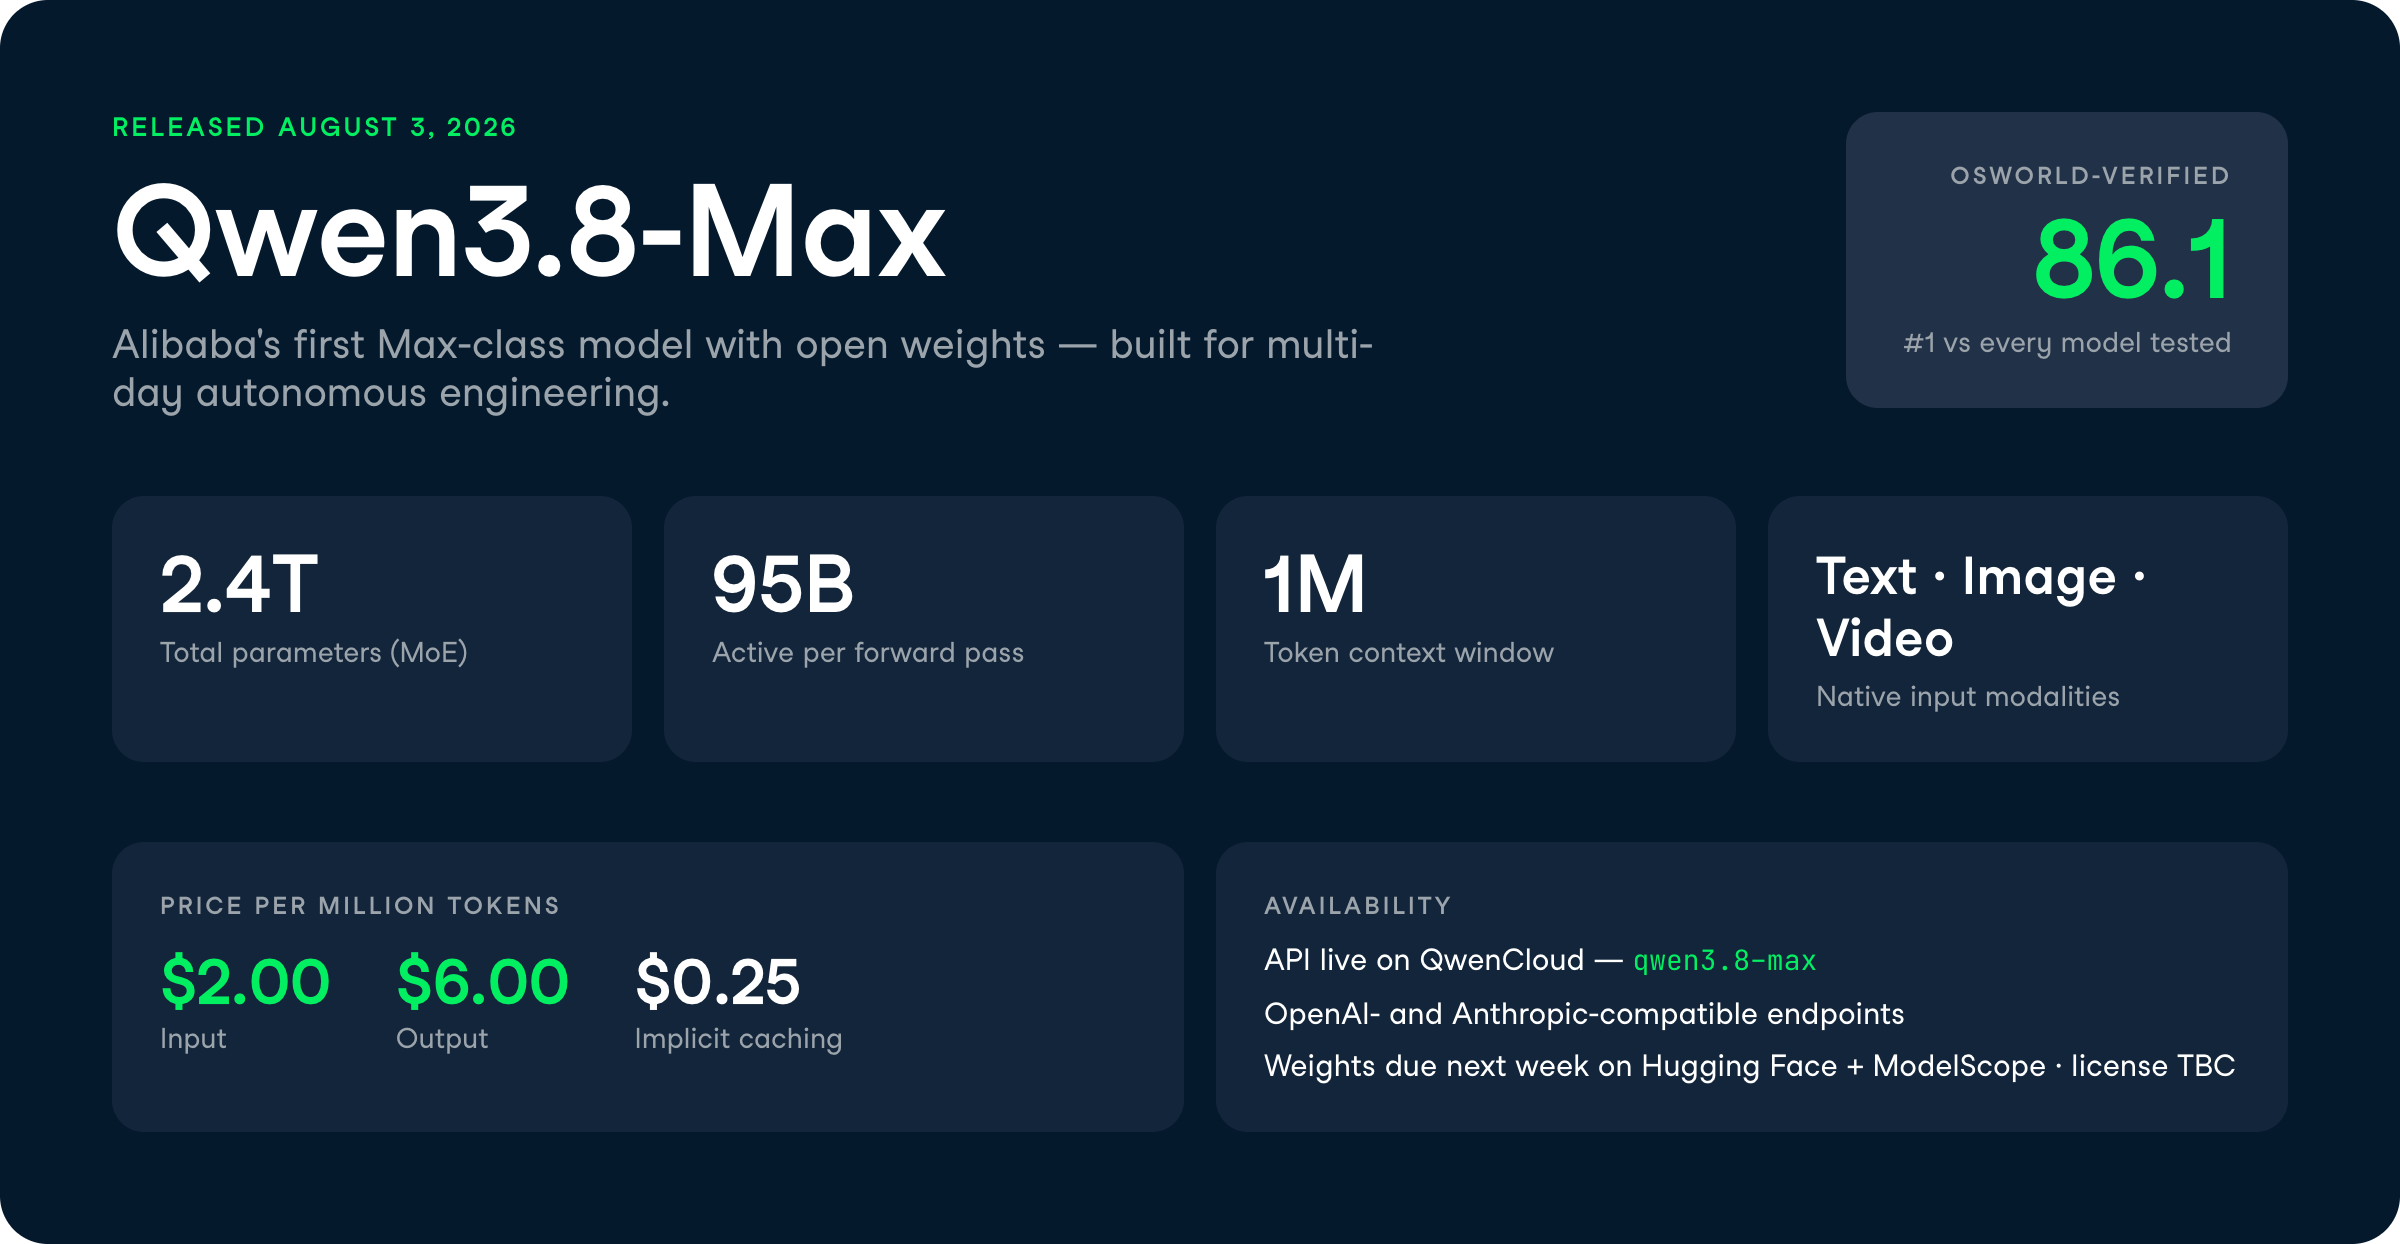
O fio condutor do Qwen3.8-Max é autonomia em horizontes longos.
A Qwen enquadra cada capacidade na mesma ideia: o modelo não segue um plano fixo; ele se autocorrige por meio de ciclos de feedback ao longo de dias de trabalho contínuo.
Aqui vão os recursos que mais chamaram minha atenção.
O Qwen3.8-Max consegue levar um projeto de código de uma pasta vazia a um entregável final ao longo de dias de trabalho contínuo, sem humano no loop.
A demonstração principal da empresa rodou por cerca de 16 dias em operação totalmente autônoma, construindo um harness de CLI autoevolutivo que acumulou 265 commits, 127 PRs e 151 issues.
O mecanismo é um ciclo de feedback: os requisitos entram como issues no GitHub, agentes os assumem e executam, depois disparam build, testes unitários, testes de ponta a ponta e checks de CI antes de fazer o merge.
Para profissionais, isso aponta para um modelo pensado para conduzir pipelines de engenharia sem supervisão, em vez de responder a perguntas pontuais de código.
O alerta óbvio: são demonstrações conduzidas pelo fornecedor.
Uma execução autônoma de 16 dias em ambiente controlado não é o mesmo que apontar isso para seu monorepo de produção e ir embora.
O Qwen3.8-Max consegue ler um artigo científico, reproduzir seus experimentos do zero em código e depois tentar superar o método original.
No exemplo da Qwen, o modelo trabalhou por cerca de 5 dias (~125 horas), escreveu aproximadamente 7.600 linhas de código, tomou mais de 1.100 ações e rodou 33 ciclos de treino em GPU sem código inicial fornecido.
Primeiro reproduziu os seis achados principais do artigo e, em seguida, executou um ciclo de autoaperfeiçoamento de hipótese, código, execução em GPU e análise ao longo de 4 rodadas e 18 ideias.
O método final que ele criou superou a abordagem do próprio artigo em 2,71 pontos no AIME24, um benchmark de matemática em nível de competição.
Esse é o tipo de fluxo de trabalho que normalmente consome uma semana de preparação de um time de pesquisa antes mesmo de os experimentos começarem.
Dynamic Workflows permite que o Qwen3.8-Max planeje uma tarefa programaticamente e despache grandes quantidades de subagentes em paralelo.
Em uma demonstração de pesquisa quantitativa, o modelo decompôs 6 descrições curtas de fatores em 50 linhas de pesquisa cada, despachou cerca de 330 subagentes e completou aproximadamente 6.000 backtests, adaptando o fluxo no meio da execução.
O que o diferencia de um script fixo é que o modelo agiu com base em evidências.
Quando identificou sinais de overfitting, foi podando fatores redundantes rodada a rodada; quando ensembles de três modelos pareceram menos robustos do que síntese de direção fixa em amostras pequenas, ele mesmo trocou de framework.
Os fatores selecionados atingiram rácios de Sharpe excedente de 0,64 a 1,48, um resultado concreto e verificável, não apenas impressão.
O Qwen3.8-Max usa visão ao longo de toda a execução, não apenas para ler entradas.
Durante uma tarefa, ele inspeciona sua própria saída intermediária, identifica problemas como uma interface desalinhada ou um objeto virado para o lado errado e revisa o plano para corrigir.
Do lado da entrada, lida com PDFs de mais de 200 páginas entre texto, gráficos e layout, e consegue processar vídeos com mais de 100 horas construindo um grafo de memória de vídeo com pessoas, eventos e timestamps.
A Qwen também lançou o Qwen-MM-Plugins, uma biblioteca de extensões para harness que adiciona processamento de imagem e vídeo, memória multimodal e uso de ferramentas visuais a frameworks de agentes existentes.
Para quem constrói agentes voltados a documentos ou vídeos, o grafo de memória é a peça a observar.
O Qwen3.8-Max expõe o parâmetro reasoning_effort para você equilibrar custo e profundidade. Três níveis permitem ajustar o quanto o modelo pensa antes de responder:
xhigh (padrão): para tarefas complexas que exigem análise minuciosamedium: equilíbrio entre precisão e velocidadelow: raciocínio eficiente otimizado para velocidade e custoVale o aviso: um comentarista no r/LocalLLaMA observou que modelos Qwen tendem a pensar demais e que o DeepSeek V4 Flash gasta menos tempo raciocinando, mesmo quando entrega saída de qualidade inferior. Se seu workload é sensível à latência, teste o low antes de assumir que o padrão é a melhor opção.
A suíte de benchmarks da Qwen pende fortemente para execução de longo prazo em vez de provas estáticas, o que combina com o posicionamento do modelo.
Nas tabelas publicadas, o Qwen3.8-Max lidera ou se mantém altamente competitivo em uso agentivo do computador, reprodução de pesquisa e codificação, enquanto fica atrás do GPT-5.6 Sol Max e do Fable 5 em alguns testes de engenharia de software.
Ele oferece um dos perfis mais amplos e equilibrados, em vez de dominar todas as categorias.
| Benchmark (categoria) | Qwen 3.8 Max | Qwen 3.7 Max | Opus 4.8 | Fable 5 | Gemini 3.1-Pro | GPT5.6 Sol (max) |
|---|---|---|---|---|---|---|
| SWE-Pro (engenharia de software) | 67,7 | 60,6 | 69,2 | 80,0 | - | 64,6 |
| TerminalBench-2.1 (agente no terminal) | 86,6 | 74,5 | 84,6 | 84,6 | - | 88,8 |
| PaperBench (reprodução de pesquisa) | 93,0 | 64,8 | 80,3 | 88,8 | - | 90,5 |
| FrontierSWE (engenharia de software) | 73,5 | 40,7 | 70,0 | 88,8 | - | - |
| QwenReactBench (frontend React) | 1724 | 1538 | 1694 | 1770 | - | 1564 |
| CoWorkBench (tarefas profissionais em co-work) | 74,8 | 64,6 | 72,3 | 75,9 | - | 71,5 |
| JobBench (agentes potencializam fluxos humanos) | 53,4 | 31,3 | 48,4 | 57,4 | - | 45,4 |
| Agents' Last Exam (tarefas valiosas de longo horizonte) | 52,4 | 31,1 | 45,1 | - | - | 53,6 |
| BabyVision (raciocínio visual)* | 82,0 / 91,3 | 64,7 / 70,4 | 28,4 / 81,2 | 42,5 / 90,5 | 55,9 / 68,3 | 65,5 / 88,9 |
| CharXiv (RQ) (raciocínio com gráficos)* | 88,4 / 93,5 | 85,8 / 85,9 | 78,5 / 89,9 | 87,9 / 93,5 | 84,4 / 89,9 | 85,1 / 89,1 |
| ERQA (raciocínio incorporado) | 77,8 | 69,8 | 57,2 | 70,0 | 68,0 | 70,0 |
| PerceptionBench (percepção visual) | 63,5 | 51,1 | 47,2 | 57,2 | 56,2 | 59,7 |
| LVBench (compreensão de vídeos longos) | 81,8 | 76,2 | 67,3 | 75,1 | - | 78,8 |
| Vision2Web (desenvolvimento web visual) | 69,0 | 42,1 | 62,4 | 70,5 | - | 62,1 |
| MobileWorld (uso agentivo em celular) | 77,8 | 51,2 | 67,5 | 85,5 | 58,1 | 76,9 |
| OSWorld-Verified (uso agentivo do computador) | 86,1 | 73,3 | 83,4 | 85,0 | 76,2 | 83,2 |
Observações importantes:
* Notas duplas: para benchmarks com métricas duplas (BabyVision e CharXiv), os valores são formatados como sem python / com python, seguindo os números internos e superiores mostrados naquelas barras específicas.
* Dados ausentes (-): hífens indicam benchmarks nos quais o modelo específico não foi testado ou a pontuação foi excluída dos gráficos.
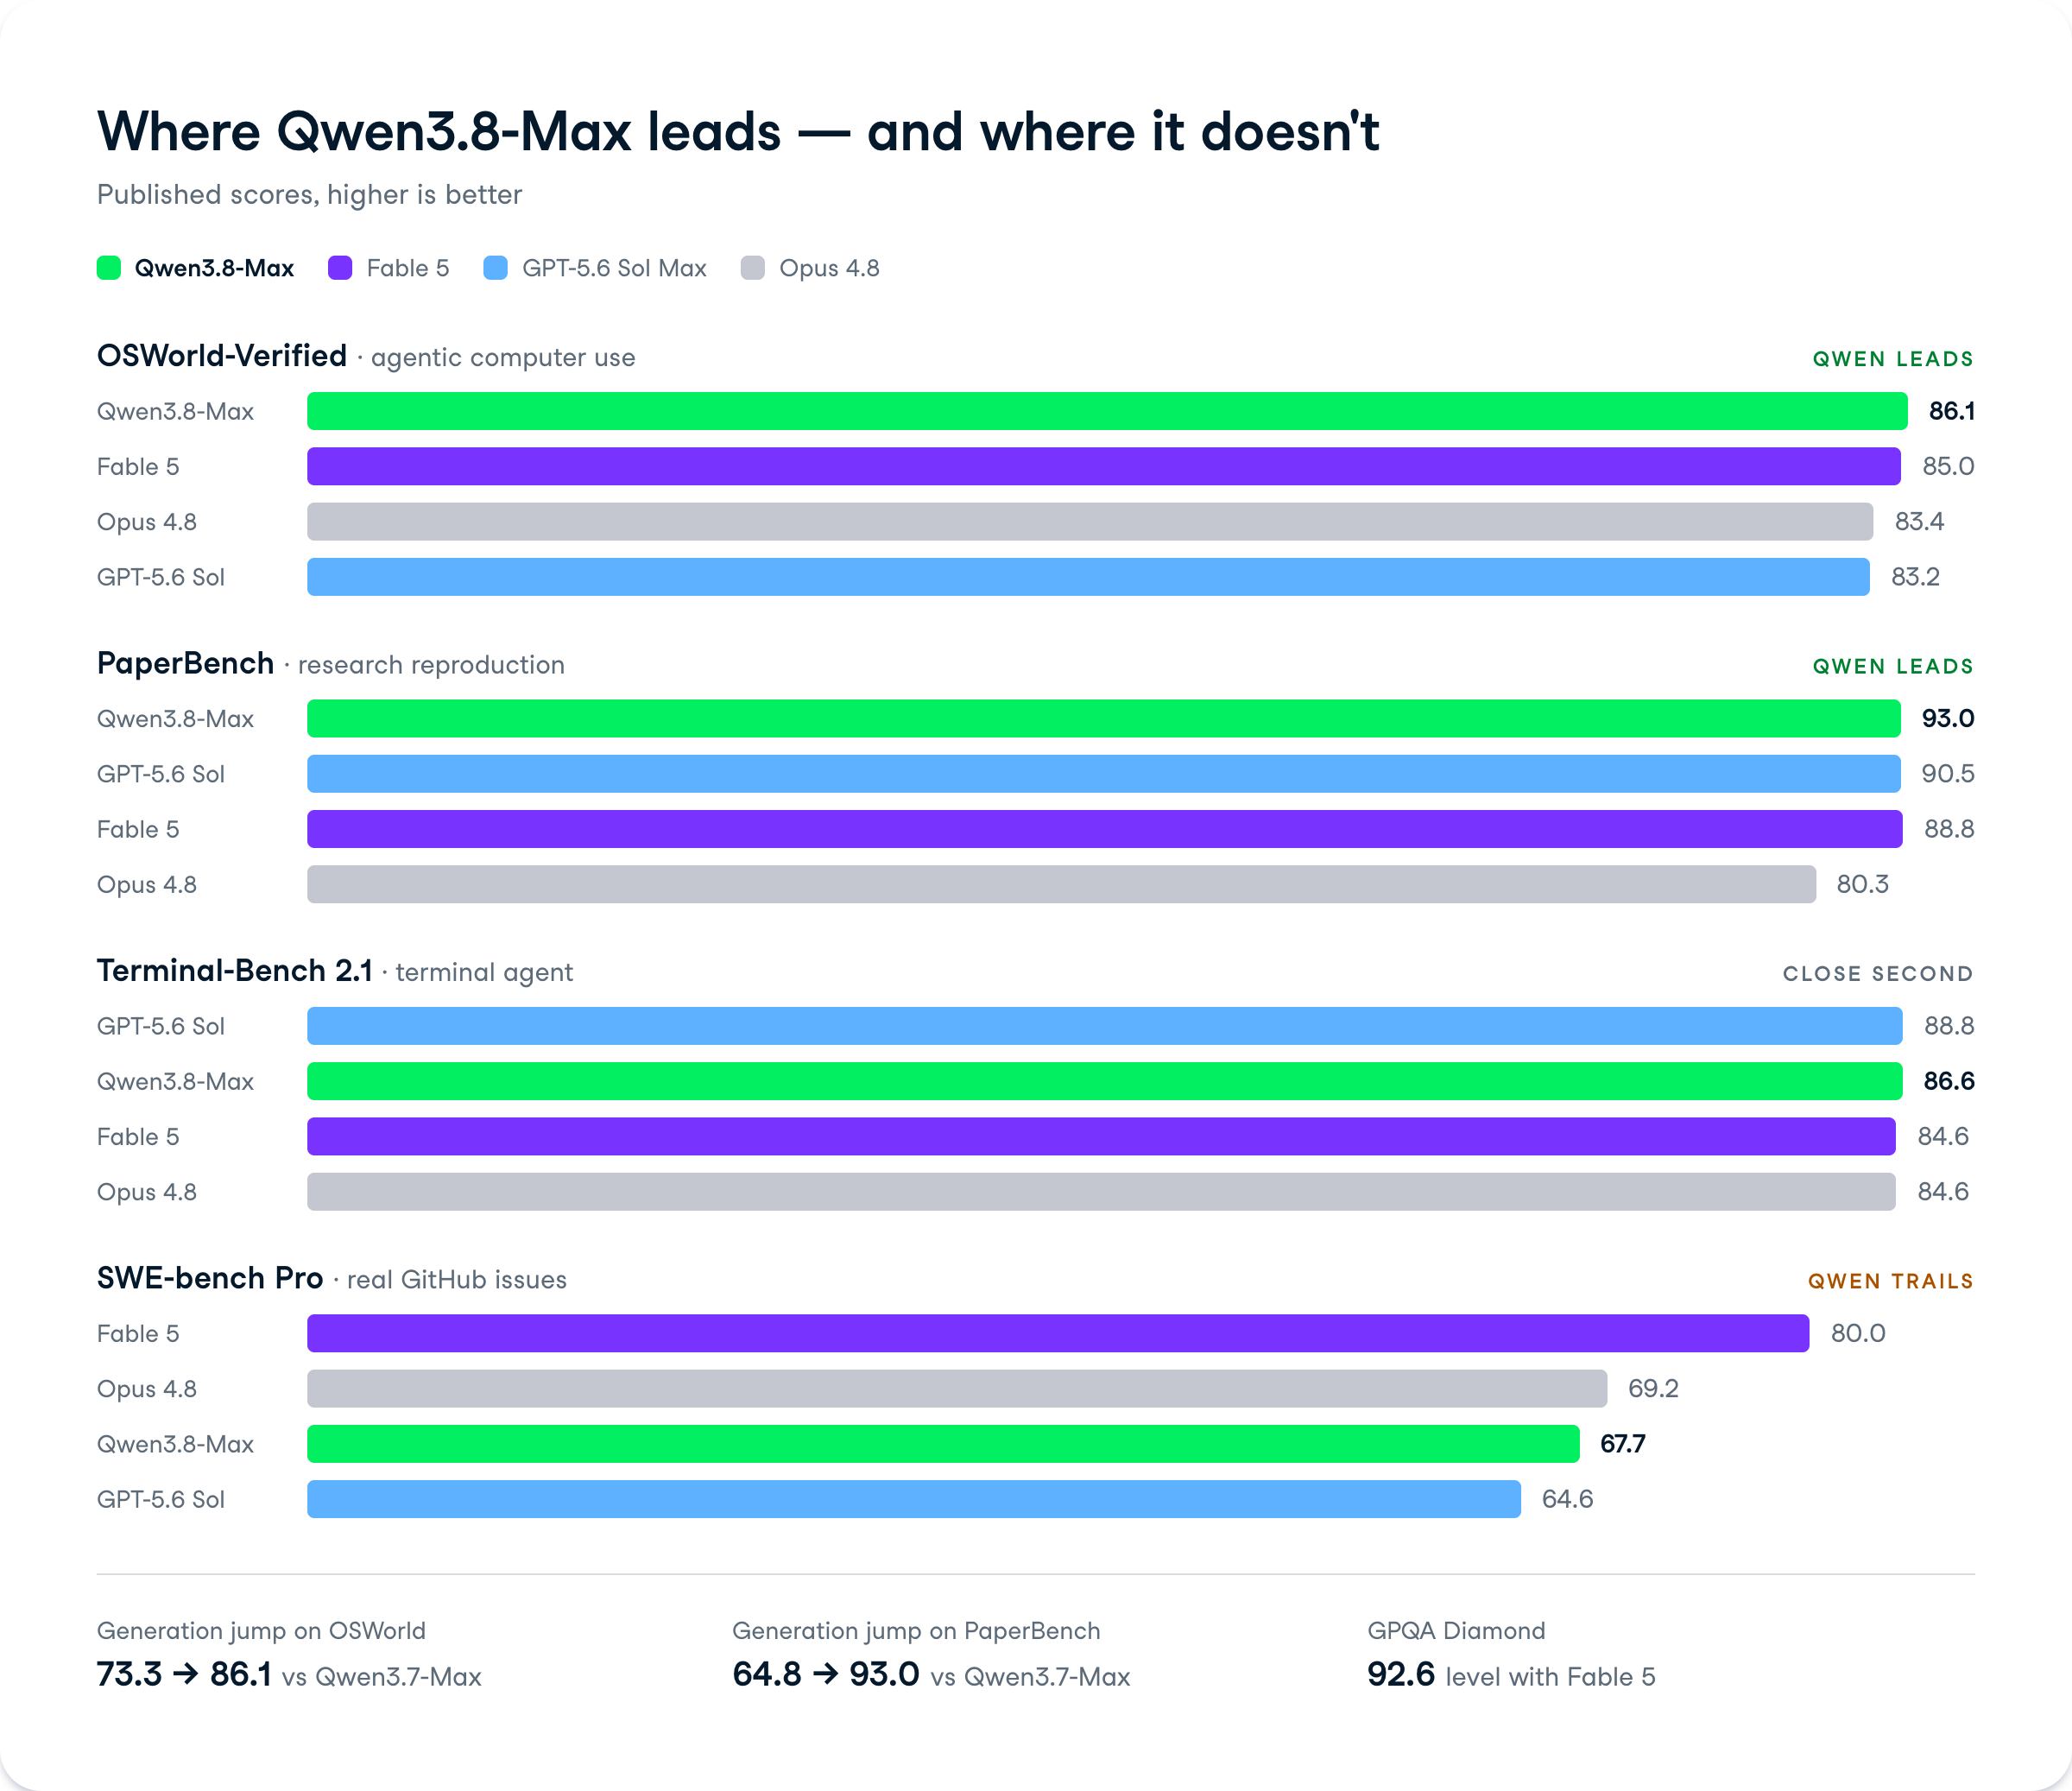
O Qwen3.8-Max marca 86,1 no OSWorld-Verified, à frente do Fable 5 (85,0), do GPT-5.6 Sol Max (83,2) e do Gemini 3.1 Pro (76,2).
Esse benchmark mede o quão confiavelmente um agente de uso do computador opera um desktop real, clicando em interfaces e concluindo tarefas com múltiplas etapas.
Para quem constrói agentes que operam aplicativos reais, e não apenas chamam APIs, este é o número que mais importa. O Qwen3.7-Max marcou apenas 73,3 aqui, então o salto é significativo dentro da família.
No PaperBench, o Qwen3.8-Max registra 93,0, a maior pontuação reportada, à frente do GPT-5.6 Sol (90,5) e do Fable 5 (88,8).
O PaperBench mede a capacidade de um modelo de reproduzir em código os experimentos de um artigo científico, o que se conecta diretamente à demonstração de 5 dias de reprodução de pesquisa.
É uma diferença grande em relação aos 64,8 do Qwen3.7-Max. Se seu trabalho envolve transformar artigos em pipelines funcionando, é um forte sinal.
O Qwen3.8-Max marca 86,6 no Terminal-Bench 2.1, entre o GPT-5.6 Sol (88,8) e os 84,6 publicados por Opus 4.8 e Fable 5.
Esse benchmark testa um agente trabalhando no terminal para concluir tarefas de engenharia sob limite de tempo.
É uma melhora real sobre os 74,5 do Qwen3.7-Max e coloca um modelo de pesos abertos perto dos topos proprietários em trabalho agentivo de linha de comando.
Aqui o Qwen3.8-Max fica atrás. Ele marca 67,7 no SWE-bench Pro, abaixo do Fable 5 (80,0) e do Opus 4.8 (69,2), embora à frente do GPT-5.6 Sol (64,6).
O SWE-bench Pro mede a resolução de issues reais do GitHub em bases de código profissionais.
Este é o ponto fraco honesto. Quando analisamos o Grok 4.5, o Fable 5 também liderou o SWE-bench Pro com 80,4, então o modelo da Anthropic continua sendo o a ser batido nesse teste específico.
No GPQA Diamond, um benchmark de raciocínio científico em nível de pós-graduação, o Qwen3.8-Max marca 92,6, empatado com o Fable 5 (92,6) e logo atrás do GPT-5.6 Sol (94,1). Ele também lidera no IFBench (seguimento de instruções) com 82,8, no HealthBench com 60,2 e no PRBench-Finance com 58,3.
O padrão se mantém: forte em trabalho agentivo e aplicado, competitivo em raciocínio e, às vezes, atrás no exame de raciocínio mais difícil, o Humanity's Last Exam, onde marca 43,6 contra 53,3 do Fable 5.
O Qwen3.8-Max já está disponível no QwenCloud pelo ID de modelo da API qwen3.8-max. A API é compatível com os endpoints de chat completions e responses no padrão OpenAI, além de interface compatível com a Anthropic, então você pode apontar o Claude Code ou o Codex para ele com mudanças mínimas de configuração.
O preço fica no nível intermediário e fica abaixo dos modelos proprietários líderes dos EUA com os quais ele se compara:
Esse total combinado de US$8 é menos de um terço dos US$30 do Claude Opus 5 e menos de um quarto dos US$35 do GPT-5.6 Sol Standard. O preço iguala o do Grok 4.5, também em US$2/US$6, como destacamos na nossa cobertura do Grok 4.5. Os pesos abertos do Qwen3.8-Max e do Qwen3.8-27B devem chegar ao Hugging Face e ao ModelScope na próxima semana, embora os termos de licença ainda não sejam públicos.
O Qwen3.8-Max é a Alibaba mostrando onde pesos abertos podem competir. Liderar o OSWorld-Verified e o PaperBench frente ao Fable 5 e ao GPT-5.6 Sol Max, com um modelo auto-hospedável a US$2/US$6, é o tipo de movimento que pressiona toda a camada proprietária no custo por tarefa agentiva.
Os poréns são reais. A execução autônoma de 16 dias em código e a reprodução de pesquisa de 5 dias são demonstrações do fornecedor, não reproduções independentes, e a licença dos pesos da próxima semana ainda é desconhecida. No r/LocalLLaMA, o debate mais interessante foi sobre o menor Qwen3.8-27B, com vários comentários mais animados com a ideia de concentrar inteligência em uma única GPU de consumo do que com um gigante de 2,4T que só poucos setups conseguem rodar.
Minha visão: se você está construindo agentes que operam interfaces reais ou reproduzem pipelines de pesquisa, o Qwen3.8-Max merece testes sérios, especialmente quando os pesos chegarem e você puder auto-hospedar. Se o seu trabalho é engenharia de software profissional pura em issues cabeludas do GitHub, o Fable 5 ainda lidera o SWE-bench Pro, então rode ambos antes de decidir.
Se você quer ficar à vontade trabalhando com modelos assim via API, recomendo nossa trilha de habilidades AI Fundamentals para construir os fundamentos primeiro.
Principais cursos da DataCamp
Curso
Curso
Programa
blog
Richie Cotton
7 min
blog
Abid Ali Awan
9 min
blog
Ryan Ong
8 min
Tutorial
Moez Ali
11 min
Tutorial
Josep Ferrer
11 min
Tutorial
Abid Ali Awan
13 min