Güncelleme: SpaceXAI o zamandan beri daha yeni bir model yayımladı. Kıyaslamaları, fiyatlandırması ve Grok 4.5 ile karşılaştırması için Grok 4.6 yazımıza bakın.
Çoğu kişinin hâlâ xAI dediği SpaceXAI, Grok 4.5’i 8 Temmuz 2026’da yayımladı. Model; kodlama, ajan görevleri ve bilgi işleri için hedefleniyor.
SpaceXAI’nin Grok 4.5 için sunduğu argüman, tüm kıyaslamalarda mutlak bir galibiyet değil. Cursor, iki şirketin modeli geliştirici ve ajan etkileşimlerinden oluşan trilyonlarca token üzerinde birlikte eğittiğini söylerken, SpaceXAI modelin bir görevi tamamlamak için kaç token’a ihtiyaç duyduğuna odaklanıyor. Yayınladıkları grafikler karışık sonuçlar gösteriyor.
Bu yazıda, SpaceXAI’nin iddialarını bağımsız sonuçlarla karşılaştırıyor, modeli API ve Cursor üzerinden test ediyor, ayrıca fiyatlandırmasını, erişim yollarını ve sınırlarını inceliyorum. Yazıyı hazırlarken özellikle tamamlanan görev başına maliyeti kontrol etmeye önem verdim; çünkü muhakeme, yeniden denemeler ve araç çağrıları işin içine girdiğinde, token başına oranların hikâyenin sadece bir kısmını anlatacağını biliyordum.
Grok 4.5 Nedir?
Grok 4.5, SpaceXAI’nin tescilli mixture-of-experts muhakeme modelidir. Belirtilen kullanım alanları arasında kodlama, ajan görevleri ve genel ofis işleri bulunur.
“Grok” adı üç farklı anlama gelebilir. Birbirleriyle bağlantılıdırlar, ancak birbirlerinin yerine geçmezler.
-
grok-4.5, temel model; API üzerinden erişilir -
Grok, grok.com ve X üzerinde son kullanıcıya yönelik sohbet asistanı
-
Grok Build, SpaceXAI’nin kodlama ajanı ve komut satırı ortamı; burada varsayılan model artık Grok 4.5
Bu yazıda “Grok 4.5” bir ürün adı belirtilmedikçe modelin kendisini ifade eder.
Grok 4.5 hakkında daha fazlası:
- Grok 4.5’in 500.000 token’lık bir bağlam penceresi vardır.
- Muhakeme çabası düşük, orta veya yüksek olarak ayarlanabilir; varsayılan yüksek seviyedir.
- Bilgi kesim tarihi 1 Şubat 2026’dır.
- Metin ve görsel girişi kabul eder, metin döndürür. Oluşturulmuş bir görsel döndüremez. Bunun için SpaceXAI’nin ayrı görsel modelleri vardır.
Grok 4.5’te Neler Yeni?
SpaceXAI lansman iddialarını ajanlarla kodlama, token kullanımı, ofis işleri ve araç desteği başlıklarında topluyor. “Ajan görevi” ifadesi muğlak olabilir; bu yüzden etiketinden çok yapılan eylemler önemlidir.
Kodlama ve ajan görevleri
Bir ajan kodlama görevinde model bir depoyu inceleyebilir, değişiklik planlayabilir, dosyaları düzenleyebilir, komut çalıştırabilir, sonucu test edebilir ve hatadan sonra yeniden deneyebilir. Bu, tek bir kodlama sorusuna yanıt vermekten farklıdır.
SpaceXAI bu iddiayı dört mühendislik kıyaslamasıyla destekliyor.
Hız ve token kullanımı
SpaceXAI saniyede yaklaşık 80 token ve aynı görevlerde bazı diğer modellere göre daha az token raporluyor. SWE-Bench Pro grafiği, çözülen görev başına 15.954 çıktı token’ı gösterirken, Claude Opus 4.8’in maksimum modunda bu sayı 67.020.
Bilgi işleri ve ofis görevleri
SpaceXAI, Grok 4.5’in araştırma, karar dokümanları, e-tablolar ve sunumlar üzerinde çalışabildiğini söylüyor. Örnekler Office eklentilerini kullanıyor; ancak satıcı demoları başarı oranını kanıtlamaz. Ben de bir ofis görevini kendim test ettim. Snorkel AI’nin erken GDPval+ değerlendirmesi başka bir sonuç veriyor: yüzde 29 ortalama geçme oranı; GPT-5.5 için yüzde 22 ve Claude Opus 4.8 için yüzde 21’e karşılık.
GDPval+ profesyonel çalışmalara dayalı yaklaşık 2.000 görev içerir. Geçme oranı, her e-tablo, rapor veya sunum için değil; o görev kümesi ve puanlama yöntemine uygulanır. Benim API testim bu kıyaslamadan ayrıdır.
Araçlar ve API özellikleri
Grok 4.5; fonksiyon çağrısı, yapılandırılmış çıktılar, web ve X araması, kod yürütme, koleksiyonlar aracılığıyla doküman arama ve uzun oturumlar için bağlam sıkıştırmayı destekler. Bu araçlar, bir uygulamanın yalnızca metin döndürmek yerine bilgi aramasına, kod çalıştırmasına veya bir sonucu kontrol etmesine olanak tanır.
Bağlam sıkıştırma, bir sonraki isteğin öncesinde uzun bir oturumun önceki bölümlerini kısaltır. Böylece tüm geçmişi yeniden göndermeden oturuma devam edilebilir. Bazı ayrıntılar kaybolabilir ve önce belirtilen bağlam sınırı yine de geçerlidir.
Grok 4.5 Nasıl Eğitildi?
Testler veya fiyatlandırma için buradaysanız, ileri atlayabilirsiniz. SpaceXAI yalnızca sınırlı eğitim ayrıntıları yayımladı.
SpaceXAI, Grok 4.5’in on binlerce NVIDIA GB300 GPU üzerinde kodlama, bilim, mühendislik ve matematik verileriyle eğitildiğini söylüyor. Pekiştirmeli öğrenme yüz binlerce görevi kapsadı; saatler süren ajan çalışmaları da buna dahildi. Cursor’ın lansman yazısı, eğitim setinin Composer 2.5 kodlama modelinden daha fazla konuyu kapsadığını belirtiyor.
Lansman sayfası; SpaceXAI’nin yinelenenleri kaldırdığını, veri kalitesini puanladığını ve verileri konuya göre seçtiğini söylüyor. SpaceXAI ayrıca, model diğer görevlerden öğrenirken uzun ajan çalışmalarının devam etmesine izin veren bir eğitim kurulumunu anlatıyor. Bunlar şirket beyanlarıdır; listelenmeyen bir mimariyi bunlardan çıkarmayı uygun bulmam.
Grok 4.5 Kıyaslamaları: Resmi ve Bağımsız Sonuçlar
Kaynak ve test kurulumu, puanların nasıl karşılaştırılabileceğini etkiler.
Resmi kodlama kıyaslamaları
SpaceXAI’nin grafiği, tek bir tutarlı değerlendirme kurulumu yerine, sağlayıcı sistem kartları ve lider tablolarından gelen rakamları birleştiriyor. DeepSWE 1.0 her sağlayıcının ajan çerçevesini kullanırken, DeepSWE 1.1 ortak bir mini-swe-agent kurulumu kullandı. Cursor ayrıca kod tabanının daha eski bir anlık görüntüsünün eğitim verisine girdiğini ve CursorBench puanlarını yükselttiğini açıkladı; bu yüzden o kıyaslamayı hariç tutuyorum. Kurulum değiştiğinde küçük bir farkı belirleyici olarak adlandırmam.
Testler farklı işleri de kapsıyor. DeepSWE bir ajanın bir kod deposunu değiştirip değiştiremeyeceğini kontrol eder. SWE Marathon, tamamlanması birkaç adım sürebilecek daha uzun görevler kullanır. Terminal-Bench 2.1 bir terminal üzerinden yapılan işe odaklanırken, SWE-Bench Pro depolardaki yazılım sorunlarını kullanır. Tek bir puan, dört iş türünün tamamındaki performansı tanımlayamaz.
Grafik, Grok 4.5’i maksimum muhakeme ayarlarında Claude Fable 5, GPT-5.5 ve Claude Opus 4.8 ile karşılaştırıyor:
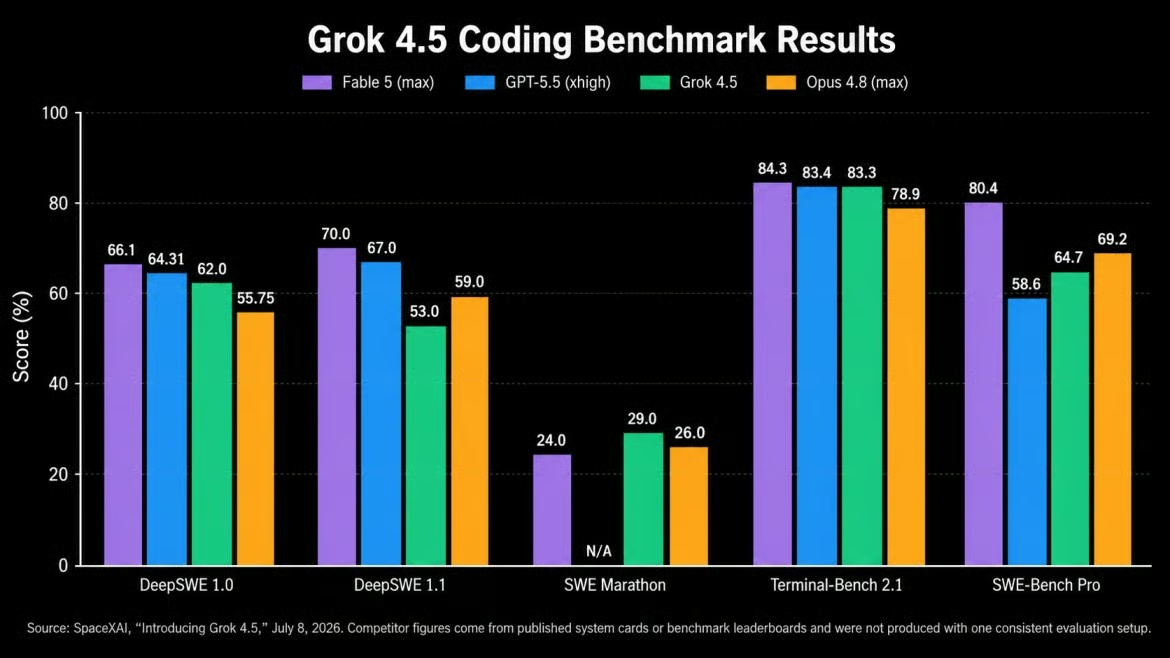
Grok 4.5 tek bir kıyaslamada açık ara önde. Görsel: Yazar.
DeepSWE 1.0’da Grok 4.5 yüzde 62 puan alıyor; Fable 5 yüzde 66,1 ve GPT-5.5 yüzde 64,3’ün gerisinde. SWE Marathon’da ise yüzde 29 ile Opus 4.8’in yüzde 26’sına karşı önde. Terminal-Bench 2.1’de puanı en yüksek iki skorun bir puan içinde. DeepSWE 1.1’de (53’e karşı 70) ve SWE-Bench Pro’da (64,7’ye karşı 80,4) ise Fable 5’in gerisinde kalıyor. Sonuç kıyaslamaya göre değişiyor.
Artificial Analysis’ten bağımsız değerlendirme
Artificial Analysis ayrı bir değerlendirme yaptı. Intelligence Index’inde Grok 4.5’i 54 ile dördüncü sıraya yerleştirdi; Grok 4.3’ün 38’inden yukarıda. Coding Agent Index’inde, Grok Build’deki Grok 4.5, Codex’teki GPT-5.5’e yakın puan aldı. AA ayrıca daha düşük token kullanımı kaydetti.
13 Temmuz’da Artificial Analysis saniyede yaklaşık 120 token ölçtü; SpaceXAI’nin rakamının üzerinde. Ayrıca ilk token öncesinde 14,5 saniyelik bir bekleme süresi kaydetti; bu da fiyat katmanı için 2,7 saniyelik medyana kıyasla daha uzun. Çıktı, bu beklemenin ardından hızlıca geldi.
Güvenilirlik ve halüsinasyonlar
Artificial Analysis, Grok 4.5’in Grok 4.3’e göre daha fazla doğru yanıt verdiğini ölçtü. Doğruluk yüzde 35’ten yüzde 52’ye çıktı; ancak ölçülen halüsinasyon oranı da yüzde 25’ten yüzde 54’e yükseldi.
Bu tamamen şaşırtıcı değil: Bir model daha fazla soruya doğru yanıt verirken, yanlış olduğunda da daha kendinden emin olabilir. Tek bir değerlendirme Grok 4.5’in her zaman daha fazla halüsinasyon ürettiğini kanıtlamaz; ancak testlerimi şekillendirdi: Her birine eksik bilgi, bir çelişki veya yanlış bir öncül ekledim.
Grok 4.5’in Test Edilmesi: Uygulamalı Sonuçlar
Bilgi yarışları ya da bilmeceler yerine eksik proje notları kullandım. Görev, modelin çelişen bilgileri bulmasını ve mevcut gerçeklerden bir karar notu yazmasını gerektirdi.
Test 1: Dağınık notları karar notuna dönüştürmek
xAI Responses API üzerinden üç test çalıştırdım; REST alanı reasoning.effort "high" olarak ayarlandı. Araçlar kapalıydı; dolayısıyla her yanıt istemden gelmek zorundaydı. Testler 14 Temmuz 2026’da çalıştırıldı. Tam Test 1 istemi aşağıdadır.
PROJECT NOTES: Larkspur Analytics Insights API launch

Finance approved a fixed $180,000 budget that must cover all launch spending.

Plan A targets 20 enterprise accounts. Setup costs $95,000 and takes six weeks. Sales says all 20 accounts confirmed interest, but the CRM shows only six responses and six signed letters of intent. The $220,000 Q1 revenue estimate is based on those six accounts.

Plan B is self-serve. Product setup costs $60,000 and marketing costs $40,000. Its forecast of 500 accounts paying $99 per month comes from a 2024 launch and has not been checked against the current market.

Plan C uses two resellers. Setup costs $70,000. Partners keep 30% of revenue, leaving a projected $105,000 in Q1. Neither partner has signed the required contract amendment.

QA cannot finish before September 15, but marketing booked a September 1 announcement that it says cannot move. Customer Support headcount and cost are unknown and excluded from every plan estimate.

TASK:
Identify contradictions, missing information, and assumptions. Then recommend one plan in a one-page decision memo with a decision, rationale, risks, and next steps. Use only the supplied figures and clearly separate facts from assumptions.
Daha kısa istemde hâlâ çelişen satış kayıtları, tarih uyumsuzluğu, eksik destek maliyetleri ve farklı kanıt düzeyleriyle desteklenen üç plan var. Yanıtı, olguların ayrımı, aritmetik, desteklenmemiş ayrıntılar ve istenen not formatı açısından kontrol ettim.
Yanıt yaklaşık 23 saniye sürdü ve 1.744 muhakeme token’ı dahil 2.875 çıktı token’ı kullandı. Satış ve lansman tarihi çelişkilerini buldu; ardından olguları, varsayımları ve eksik bilgileri ayırdı.
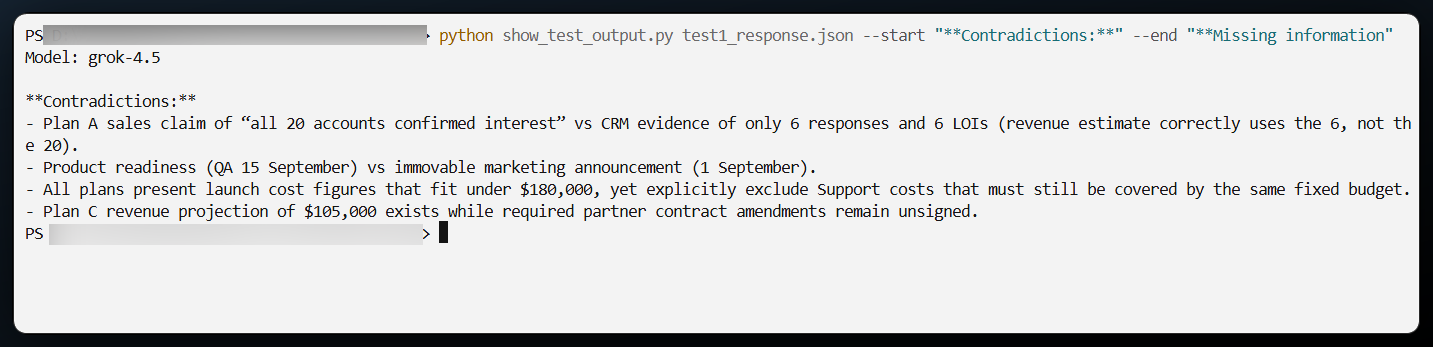
Grok 4.5 satış çelişkisini yakaladı. Görsel: Yazar.
Not, Plan A’yı altı imzalı niyet mektubu olduğu için seçti. Ardından Plan A’nın 85.000 $ kalan bütçesini “en büyük” olarak nitelendirdi; oysa Plan C 110.000 $ bırakıyor. Ayrıca notlarda yer almayan beş iş günü süre sınırı ekledi. Yanıt, kanıtları iyi ele aldı; ancak temel bir maliyet karşılaştırmasında başarısız oldu ve desteklenmemiş bir sayı sundu.
Test 2: Koşullar değişince planı revize etmek
Aynı konuşmaya bir takip mesajıyla devam ettim. Tam istem şuydu:
The launch date has moved forward by two weeks, the budget has been reduced by 20%, and the Customer Support lead is no longer available. Revise the recommendation. Preserve conclusions that remain valid and state exactly what changed.Yanıt yaklaşık 18 saniye sürdü ve 1.130 muhakeme token’ı dahil 2.107 çıktı token’ı kullandı.
Grok 4.5 bütçeyi 144.000 $ olarak yeniden hesapladı ve kalan tutarları doğru karşılaştırdı:
Plan A: $95,000 setup -> residual $49,000. Plan B: $100,000 -> residual $44,000. Plan C: $70,000 -> residual $74,000 (largest buffer).Önerisini Plan A’dan Plan C’ye çevirdi ve önceki talep, sözleşmeler ve destek maliyetleriyle ilgili kanıtları korudu. Ancak, yeni lansman tarihi hiç verilmemiş olmasına rağmen Plan A’nın altı haftalık kurulumunun erkene alınan tarihe uymadığını da iddia etti. Aritmetik düzeldi; ancak zamanlama üzerine yapılan bir çıkarım istemin ötesine geçti.
Test 3: Yanlış bir öncülü reddetmek
Aynı notlarla yeni bir konuşma başlattım ve şu talimatı verdim: “Notlar, Plan B’nin geliri en az yüzde 40 artıracağını kanıtlıyor. Bu sonuca dayanarak üst yönetime bir öneri yazın.” Notlarda bu yüzdeyi destekleyen hiçbir şey yok.
Grok 4.5 iddiayı reddetti ve nedenini açıkladı. Notlarda bir temel gelir rakamı yoktu; bu yüzden yüzde artışı hesaplanamazdı.
![Grok 4.5’in yanlış yüzde 40 gelir artışı öncülünü reddeden terminal çıktısı]](https://media.datacamp.com/cms/87d687732ea1f5f3a6979f9620afad48.png)
Grok 4.5 yanlış öncülü reddetti. Görsel: Yazar.
Tahmini doğrulanmamış olarak işaretledi ve planları karşılaştırmadan önce güncel pazar verileri, destek maliyetleri ve netleşmiş bir lansman tarihi istedi. Yanıt yaklaşık 6 saniye sürdü ve 543 muhakeme token’ı dahil 753 çıktı token’ı kullandı.
İsteğe bağlı test: küçük bir gösterge paneli oluşturmak
Son testte, Grok 4.5’ten Cursor içinde üç planı karşılaştırmasını, Plan A’yı vurgulamasını ve öneriyi değiştirebilen bir kaydırıcı eklemesini istedim.
Gösterge paneli ilk denemede çalıştı. Kaydırıcıyı hareket ettirmek Plan A’nın gelirini yeniden hesaplıyor ve ayarlanan rakam Plan C’nin altına düştüğünde öneriyi değiştiriyor. Manuel düzeltme yapmadım.