Dernière chance ! -50 % sur DataCamp Premium
L'offre se termine dans
Mise à jour : 2 septembre 2026 : Alibaba a publié Qwen3.8-Max-0902, un snapshot amélioré de Qwen3.8-Max axé sur le code et la performance des agents. La section ci-dessous a été ajoutée pour refléter les nouveaux benchmarks.
Le 2 septembre 2026, Alibaba a publié Qwen3.8-Max-0902, une mise à niveau post-formation de Qwen3.8-Max. L'architecture reste inchangée : 2,4 billions de paramètres, contexte de 1 million de tokens et même tarification (2 $ / 1 M en entrée, 6 $ / 1 M en sortie). La priorité est clairement le code et le travail d'agent sur des horizons longs.
Le résultat marquant est Code Arena WebDev, où Qwen3.8-Max-0902 se classe premier au global avec 1 691 points, soit 3 de plus que Claude Opus 5 Max (1 687), 17 de plus que Kimi K3 Max (1 674), et 22 de plus que l'ancien Qwen3.8-Max (1 669). Il occupe également la première place sur la frontière de Pareto pour un mélange à 5 $ par million de tokens.
Les 8 benchmarks de code progressent. Les gains les plus importants concernent TerminalBench 3.0 (de 11,3 à 29,0) et ProgramBench Almost Solved (de 10,5 à 28,0), tous deux plus que doublés. Le tableau ci-dessous présente la vue d'ensemble couvrant le code, les agents et le multimodal.
| Benchmark | Qwen3.8-Max-0902 | Qwen3.8-Max | Claude Opus 5 |
|---|---|---|---|
| Code | |||
| TerminalBench 3.0 | 29.0 | 11.3 | 42.7 |
| DeepSWE 1.1 | 69.3 | 56.6 | 73.6 |
| NL2Repo-Bench | 64.9 | 55.9 | 72.3 |
| ProgramBench (Almost Solved) | 28.0 | 10.5 | 41.5 |
| SWE-Marathon | 44.8 | 39.1 | 50.0 |
| MLS-Bench-Lite | 50.1 | 41.0 | 49.8 |
| SWE-Atlas QnA | 66.3 | 60.3 | 63.2 |
| QwenSWEBench V2 | 70.0 | 55.1 | 68.0 |
| Agent | |||
| CoWorkBench | 76.1 | 74.8 | 79.6 |
| JobBench | 64.0 | 53.4 | 67.8 |
| Toolathlon Verified | 73.3 | 72.5 | 77.6 |
| WorkArena (Elo) | 1468 | 1348 | 1437 |
| Multimodal | |||
| MMMU-Pro | 82.7 | 82.3 | 82.6 |
| ERQA | 78.3 | 77.8 | 67.3 |
En gras : Qwen3.8-Max-0902 devance Claude Opus 5 sur ce benchmark. Tous les résultats proviennent du tableau comparatif publié par Alibaba.
Face à Claude Opus 5, la mise à jour 0902 prend la tête sur trois benchmarks de code (MLS-Bench-Lite, SWE-Atlas QnA, QwenSWEBench V2) et gagne sur WorkArena et les deux évaluations multimodales publiées. Claude garde l'avantage sur TerminalBench 3.0, DeepSWE 1.1 et les benchmarks de coordination d'agents. La tarification est inchangée : si vous utilisiez déjà Qwen3.8-Max, c'est une mise à niveau gratuite avec un vrai gain sur le code. Qwen a également publié Qwen3.8-Omni-Flash le 18 septembre.
Article original
L'équipe Qwen d'Alibaba a lancé Qwen3.8-Max le 3 août 2026, en visant le segment le plus disputé du marché de pointe : l'ingénierie logicielle autonome et le travail en entreprise sur long horizon. C'est la première fois que Qwen prévoit d'ouvrir les poids d'un modèle de classe Max, avec une publication la semaine prochaine en parallèle d'un plus petit Qwen3.8-27B.
Qwen3.8-Max est un modèle MoE (mixture-of-experts) sparse de 2,4 billions de paramètres, avec 95 Md actifs par passe avant, une fenêtre de contexte d'1 million de tokens, et des entrées natives texte, image et vidéo. Le chiffre à retenir : 86,1 sur OSWorld-Verified, devant GPT-5.6 Sol Max à 83,2, Claude Fable 5 à 85,0 et Gemini 3.1 Pro à 76,2. Il affiche également le score PaperBench le plus élevé rapporté à 93,0 et est tarifé 2 $ / 6 $ par million de tokens entrée/sortie.
Dans cet article, nous passons en revue les nouveautés de Qwen3.8-Max : ses fonctions pour le code et les agents, les benchmarks, et la mise en place de tests pratiques à exécuter. Pour aller plus loin, consultez nos guides sur Grok 4.5, GPT-5.6 Terra vs Claude Sonnet 5 et notre guide complet de l'API Claude. Vous pouvez aussi lire notre article sur le nouveau Qwen3.8-Flash.
Qwen3.8-Max est le modèle le plus performant de la famille Qwen, une architecture MoE sparse avec 2,4 billions de paramètres au total et environ 95 Md actifs par passe.
Il repose sur les fondations architecturales de Qwen 3.5 et cible quatre parcours en particulier :
Le principal changement structurel par rapport à Qwen3.7-Max concerne l'échelle et l'engagement à ouvrir les poids. Qwen n'a encore jamais publié les poids d'un modèle de classe Max, et l'entreprise indique que Qwen3.8-Max et Qwen3.8-27B arriveront sur Hugging Face et ModelScope la semaine prochaine.
Alibaba n'a pas encore précisé la licence, il n'est donc pas clair si ce sera quelque chose de permissif comme Apache 2.0 ou une licence sur mesure plus restrictive.
La grande nouvelle côté benchmarks, celle qui compte le plus, concerne l'usage agentique de l'ordinateur.
Sur OSWorld-Verified, qui mesure la capacité d'un agent à utiliser un véritable environnement desktop, Qwen3.8-Max devance tous les modèles propriétaires contre lesquels Qwen l'a testé.
Pour un modèle qui sera auto-hébergeable, c'est une proposition réellement différente des sorties open weights habituelles qui accusent généralement une génération de retard.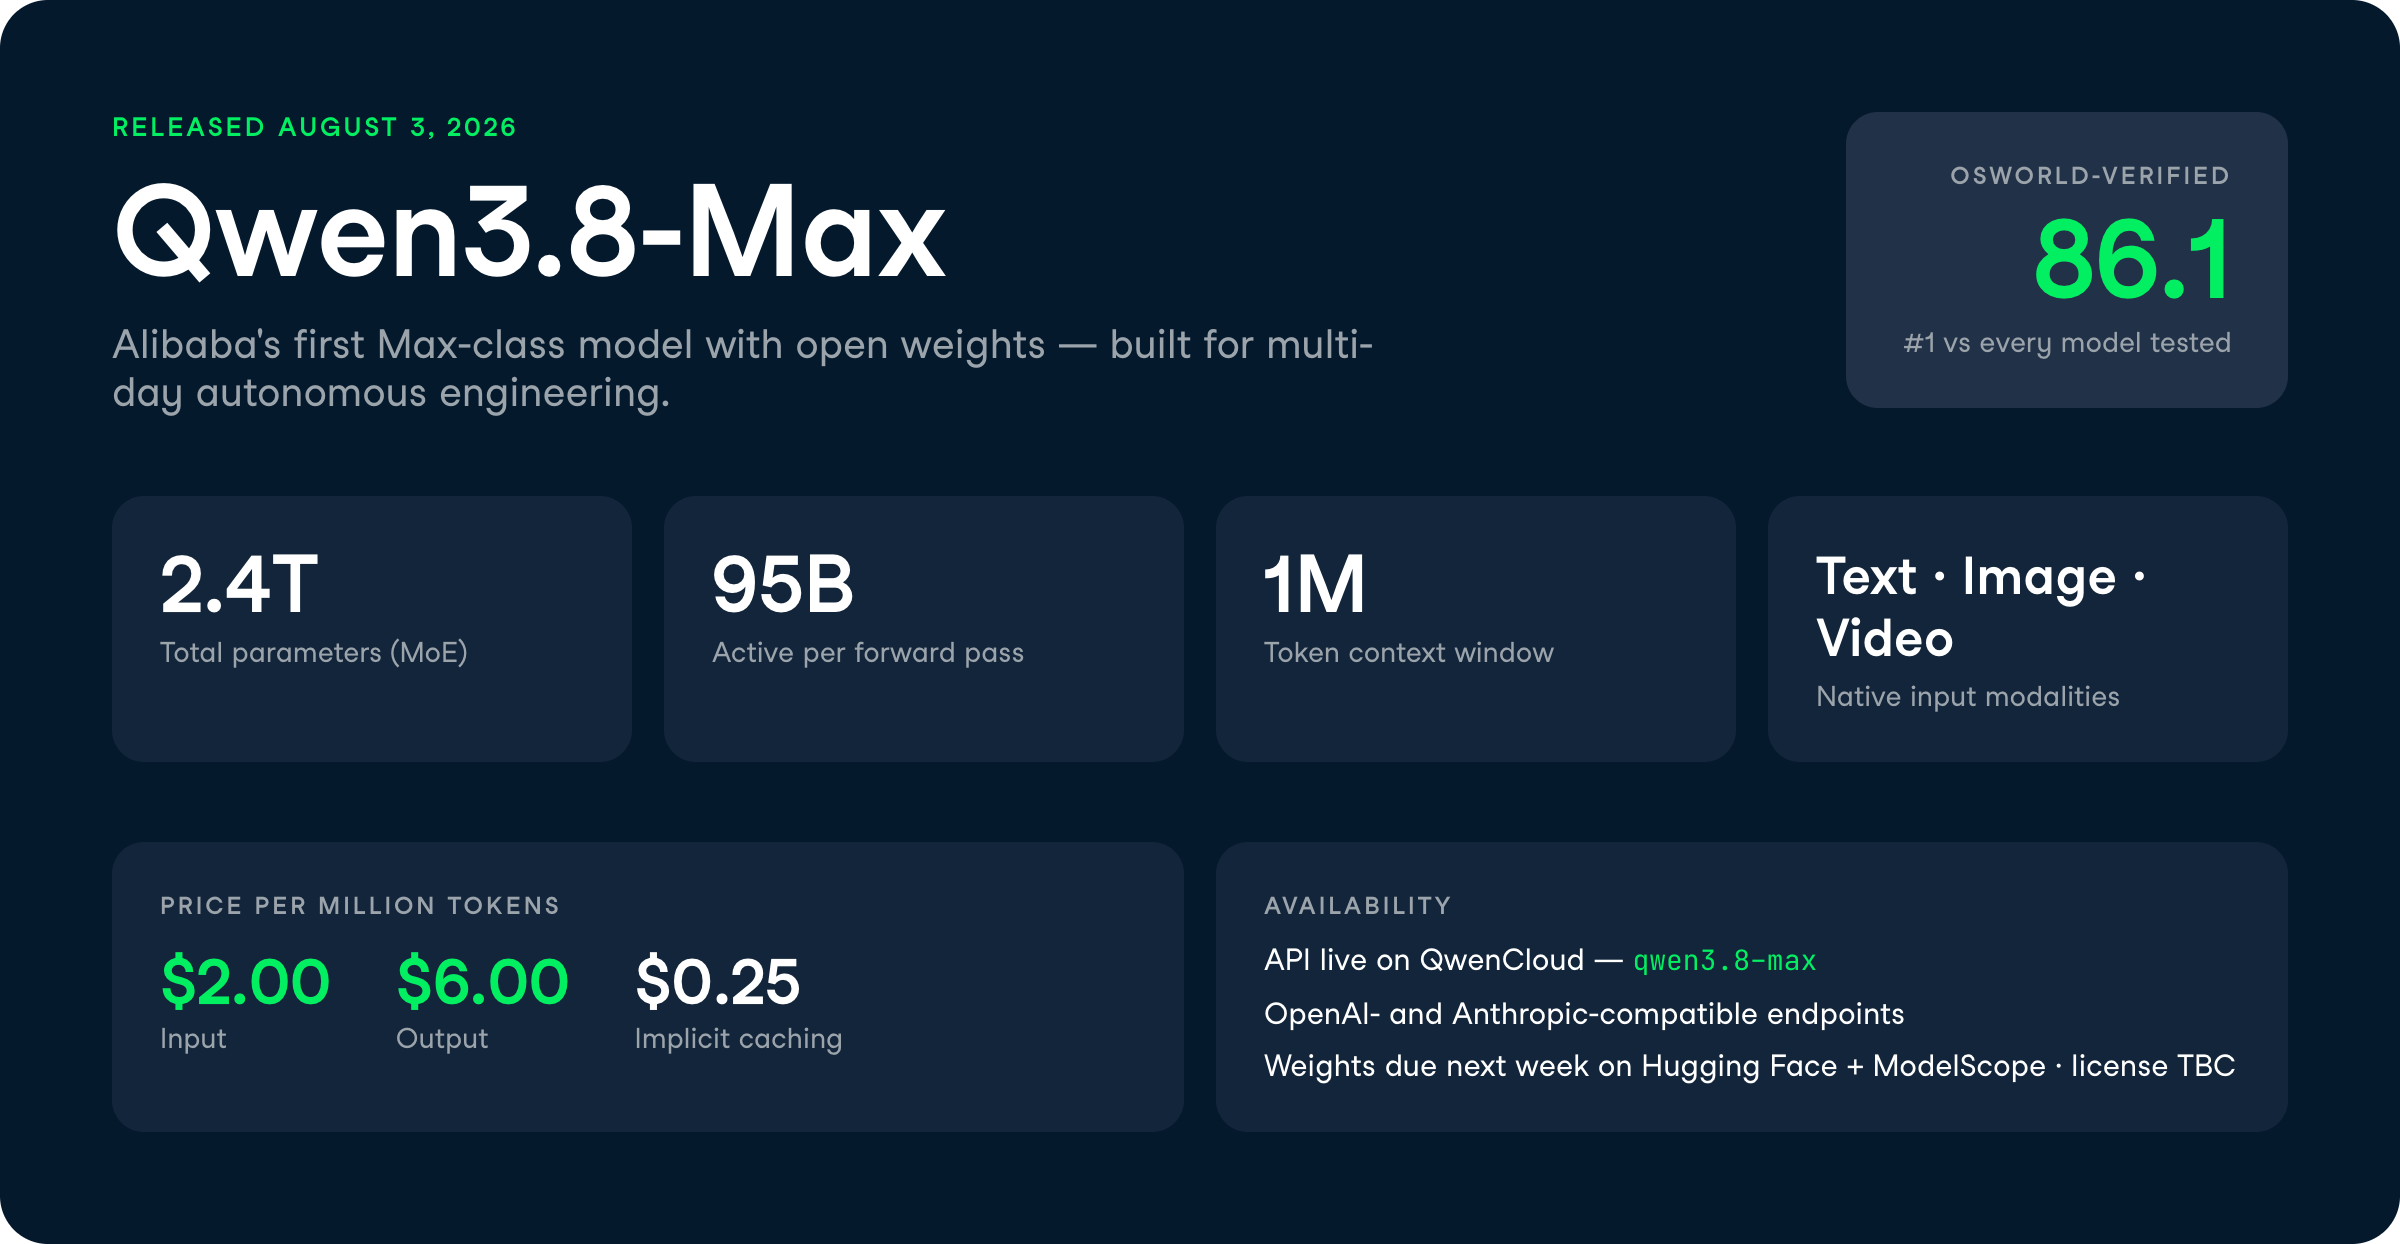
Le fil conducteur de Qwen3.8-Max, c'est l'autonomie sur des horizons longs.
Qwen présente chaque capacité autour de la même idée : le modèle ne suit pas un plan figé ; il s'auto-corrige via des boucles de rétroaction sur des journées de travail continu.
Voici les fonctionnalités qui ressortent le plus.
Qwen3.8-Max peut mener un projet de code d'un dossier vide à un livrable final sur plusieurs jours de travail continu, sans humain dans la boucle.
La démonstration phare de l'entreprise a duré environ 16 jours en opération pleinement autonome, en construisant un harnais CLI auto-évolutif qui a cumulé 265 commits, 127 PR et 151 issues.
Le mécanisme repose sur une boucle de feedback : les besoins arrivent comme issues GitHub, des agents les revendiquent et les exécutent, puis déclenchent build, tests unitaires, tests de bout en bout et contrôles CI avant fusion.
Pour les praticiens, cela montre un modèle conçu pour exécuter des pipelines d'ingénierie sans surveillance plutôt que répondre à des questions de code one-shot.
L'évidence à garder en tête : ce sont des showcases menés par l'éditeur.
Une exécution autonome de 16 jours en environnement contrôlé n'est pas la même chose que de pointer votre monorepo de production et de s'en aller.
Qwen3.8-Max peut lire un article de recherche, reproduire ses expériences en code depuis zéro, puis tenter de dépasser la méthode originale.
Dans l'exemple de Qwen, le modèle a travaillé environ 5 jours (~125 heures), écrit près de 7 600 lignes de code, réalisé plus de 1¡000 actions et mené 33 cycles d'entraînement GPU sans code de départ.
Il a d'abord reproduit les six résultats principaux de l'article, puis a exécuté une boucle d'auto-amélioration hypothèse-code-exécution GPU-analyse sur 4 tours et 18 idées.
La méthode finale qu'il a conçue a surpassé l'approche de l'article de 2,71 points sur AIME24, un benchmark de maths de niveau compétition.
C'est le type de flux de travail qui mobilise habituellement une équipe de recherche pendant une semaine rien que pour la mise en place, avant même de lancer les expériences.
Dynamic Workflows permet à Qwen3.8-Max de planifier une tâche de manière programmatique et de déployer un grand nombre de sous-agents en parallèle.
Dans une démonstration de recherche quantitative, le modèle a décomposé 6 descriptions courtes de facteurs en 50 pistes de recherche chacune, déployé environ 330 sous-agents et effectué près de 6 000 backtests, en adaptant le flux en cours de route.
La différence avec un script figé, c'est que le modèle a agi sur la base d'évidences.
Lorsqu'il a détecté des signaux de surapprentissage, il a élagué les facteurs redondants à chaque itération ; quand l'ensemblage à trois modèles paraissait moins robuste qu'une synthèse à direction fixe sur de petits échantillons, il a changé de cadre de lui-même.
Les facteurs retenus ont atteint des Sharpe excédentaires de 0,64 à 1,48, un résultat concret et vérifiable plutôt qu'une impression.
Qwen3.8-Max utilise la vision tout au long de l'exécution, pas uniquement pour lire les entrées.
Pendant une tâche, il inspecte ses sorties intermédiaires, détecte des problèmes comme une interface décalée ou un objet orienté à l'envers, et révise son plan pour les corriger.
Côté entrées, il gère des PDF de plus de 200 pages (texte, graphiques, mise en page) et peut traiter des vidéos de plus de 100 heures en construisant un graphe mémoire vidéo des personnes, événements et horodatages.
Qwen a aussi livré Qwen-MM-Plugins, une bibliothèque d'extensions pour harnais qui ajoute traitement d'images et de vidéos, mémoire multimodale et usage d'outils visuels aux frameworks d'agents existants.
Pour quiconque conçoit des agents centrés documents ou vidéos, le graphe mémoire est la brique à surveiller.
Qwen3.8-Max expose un paramètre reasoning_effort pour arbitrer coût et profondeur. Trois niveaux permettent de régler l'effort de réflexion avant réponse :
xhigh (par défaut) : pour les tâches complexes nécessitant une analyse pousséemedium : équilibre précision et vitesselow : raisonnement efficace optimisé pour la vitesse et le coûtPoint d'attention : un commentaire sur r/LocalLLaMA note que les modèles Qwen ont tendance à trop réfléchir, là où DeepSeek V4 Flash passe moins de temps à raisonner, quitte à produire une qualité moindre. Si votre charge est sensible à la latence, descendez sur low avant de supposer que le défaut est le bon choix.
La batterie de tests de Qwen privilégie l'exécution sur long horizon plutôt que les examens statiques, ce qui correspond au positionnement du modèle.
Sur les tableaux publiés, Qwen3.8-Max mène ou reste très compétitif sur l'usage agentique de l'ordinateur, la reproduction de recherche et le code, tout en étant derrière GPT-5.6 Sol Max et Fable 5 sur quelques évals d'ingénierie logicielle.
Il propose l'un des profils les plus équilibrés, sans dominer toutes les catégories.
| Benchmark (catégorie) | Qwen 3.8 Max | Qwen 3.7 Max | Opus 4.8 | Fable 5 | Gemini 3.1-Pro | GPT5.6 Sol (max) |
|---|---|---|---|---|---|---|
| SWE-Pro (ingénierie logicielle) | 67.7 | 60.6 | 69.2 | 80.0 | - | 64.6 |
| TerminalBench-2.1 (agent terminal) | 86.6 | 74.5 | 84.6 | 84.6 | - | 88.8 |
| PaperBench (reproduction de recherche) | 93.0 | 64.8 | 80.3 | 88.8 | - | 90.5 |
| FrontierSWE (ingénierie logicielle) | 73.5 | 40.7 | 70.0 | 88.8 | - | - |
| QwenReactBench (frontend React) | 1724 | 1538 | 1694 | 1770 | - | 1564 |
| CoWorkBench (tâches de coworking pro) | 74.8 | 64.6 | 72.3 | 75.9 | - | 71.5 |
| JobBench (agents au service des workflows humains) | 53.4 | 31.3 | 48.4 | 57.4 | - | 45.4 |
| Agents' Last Exam (tâches longues à forte valeur) | 52.4 | 31.1 | 45.1 | - | - | 53.6 |
| BabyVision (raisonnement visuel)* | 82.0 / 91.3 | 64.7 / 70.4 | 28.4 / 81.2 | 42.5 / 90.5 | 55.9 / 68.3 | 65.5 / 88.9 |
| CharXiv (RQ) (raisonnement sur graphiques)* | 88.4 / 93.5 | 85.8 / 85.9 | 78.5 / 89.9 | 87.9 / 93.5 | 84.4 / 89.9 | 85.1 / 89.1 |
| ERQA (raisonnement incarné) | 77.8 | 69.8 | 57.2 | 70.0 | 68.0 | 70.0 |
| PerceptionBench (perception visuelle) | 63.5 | 51.1 | 47.2 | 57.2 | 56.2 | 59.7 |
| LVBench (compréhension de vidéos longues) | 81.8 | 76.2 | 67.3 | 75.1 | - | 78.8 |
| Vision2Web (dév web visuel) | 69.0 | 42.1 | 62.4 | 70.5 | - | 62.1 |
| MobileWorld (usage agentique sur mobile) | 77.8 | 51.2 | 67.5 | 85.5 | 58.1 | 76.9 |
| OSWorld-Verified (usage agentique de l'ordinateur) | 86.1 | 73.3 | 83.4 | 85.0 | 76.2 | 83.2 |
Notes importantes :
* Scores doubles : pour les benchmarks à double métrique (BabyVision et CharXiv), les valeurs sont au format sans python / avec python selon les chiffres internes et supérieurs affichés sur ces barres.
* Données manquantes (-) : les tirets indiquent que le modèle n'a pas été testé ou que le score a été exclu des graphiques.
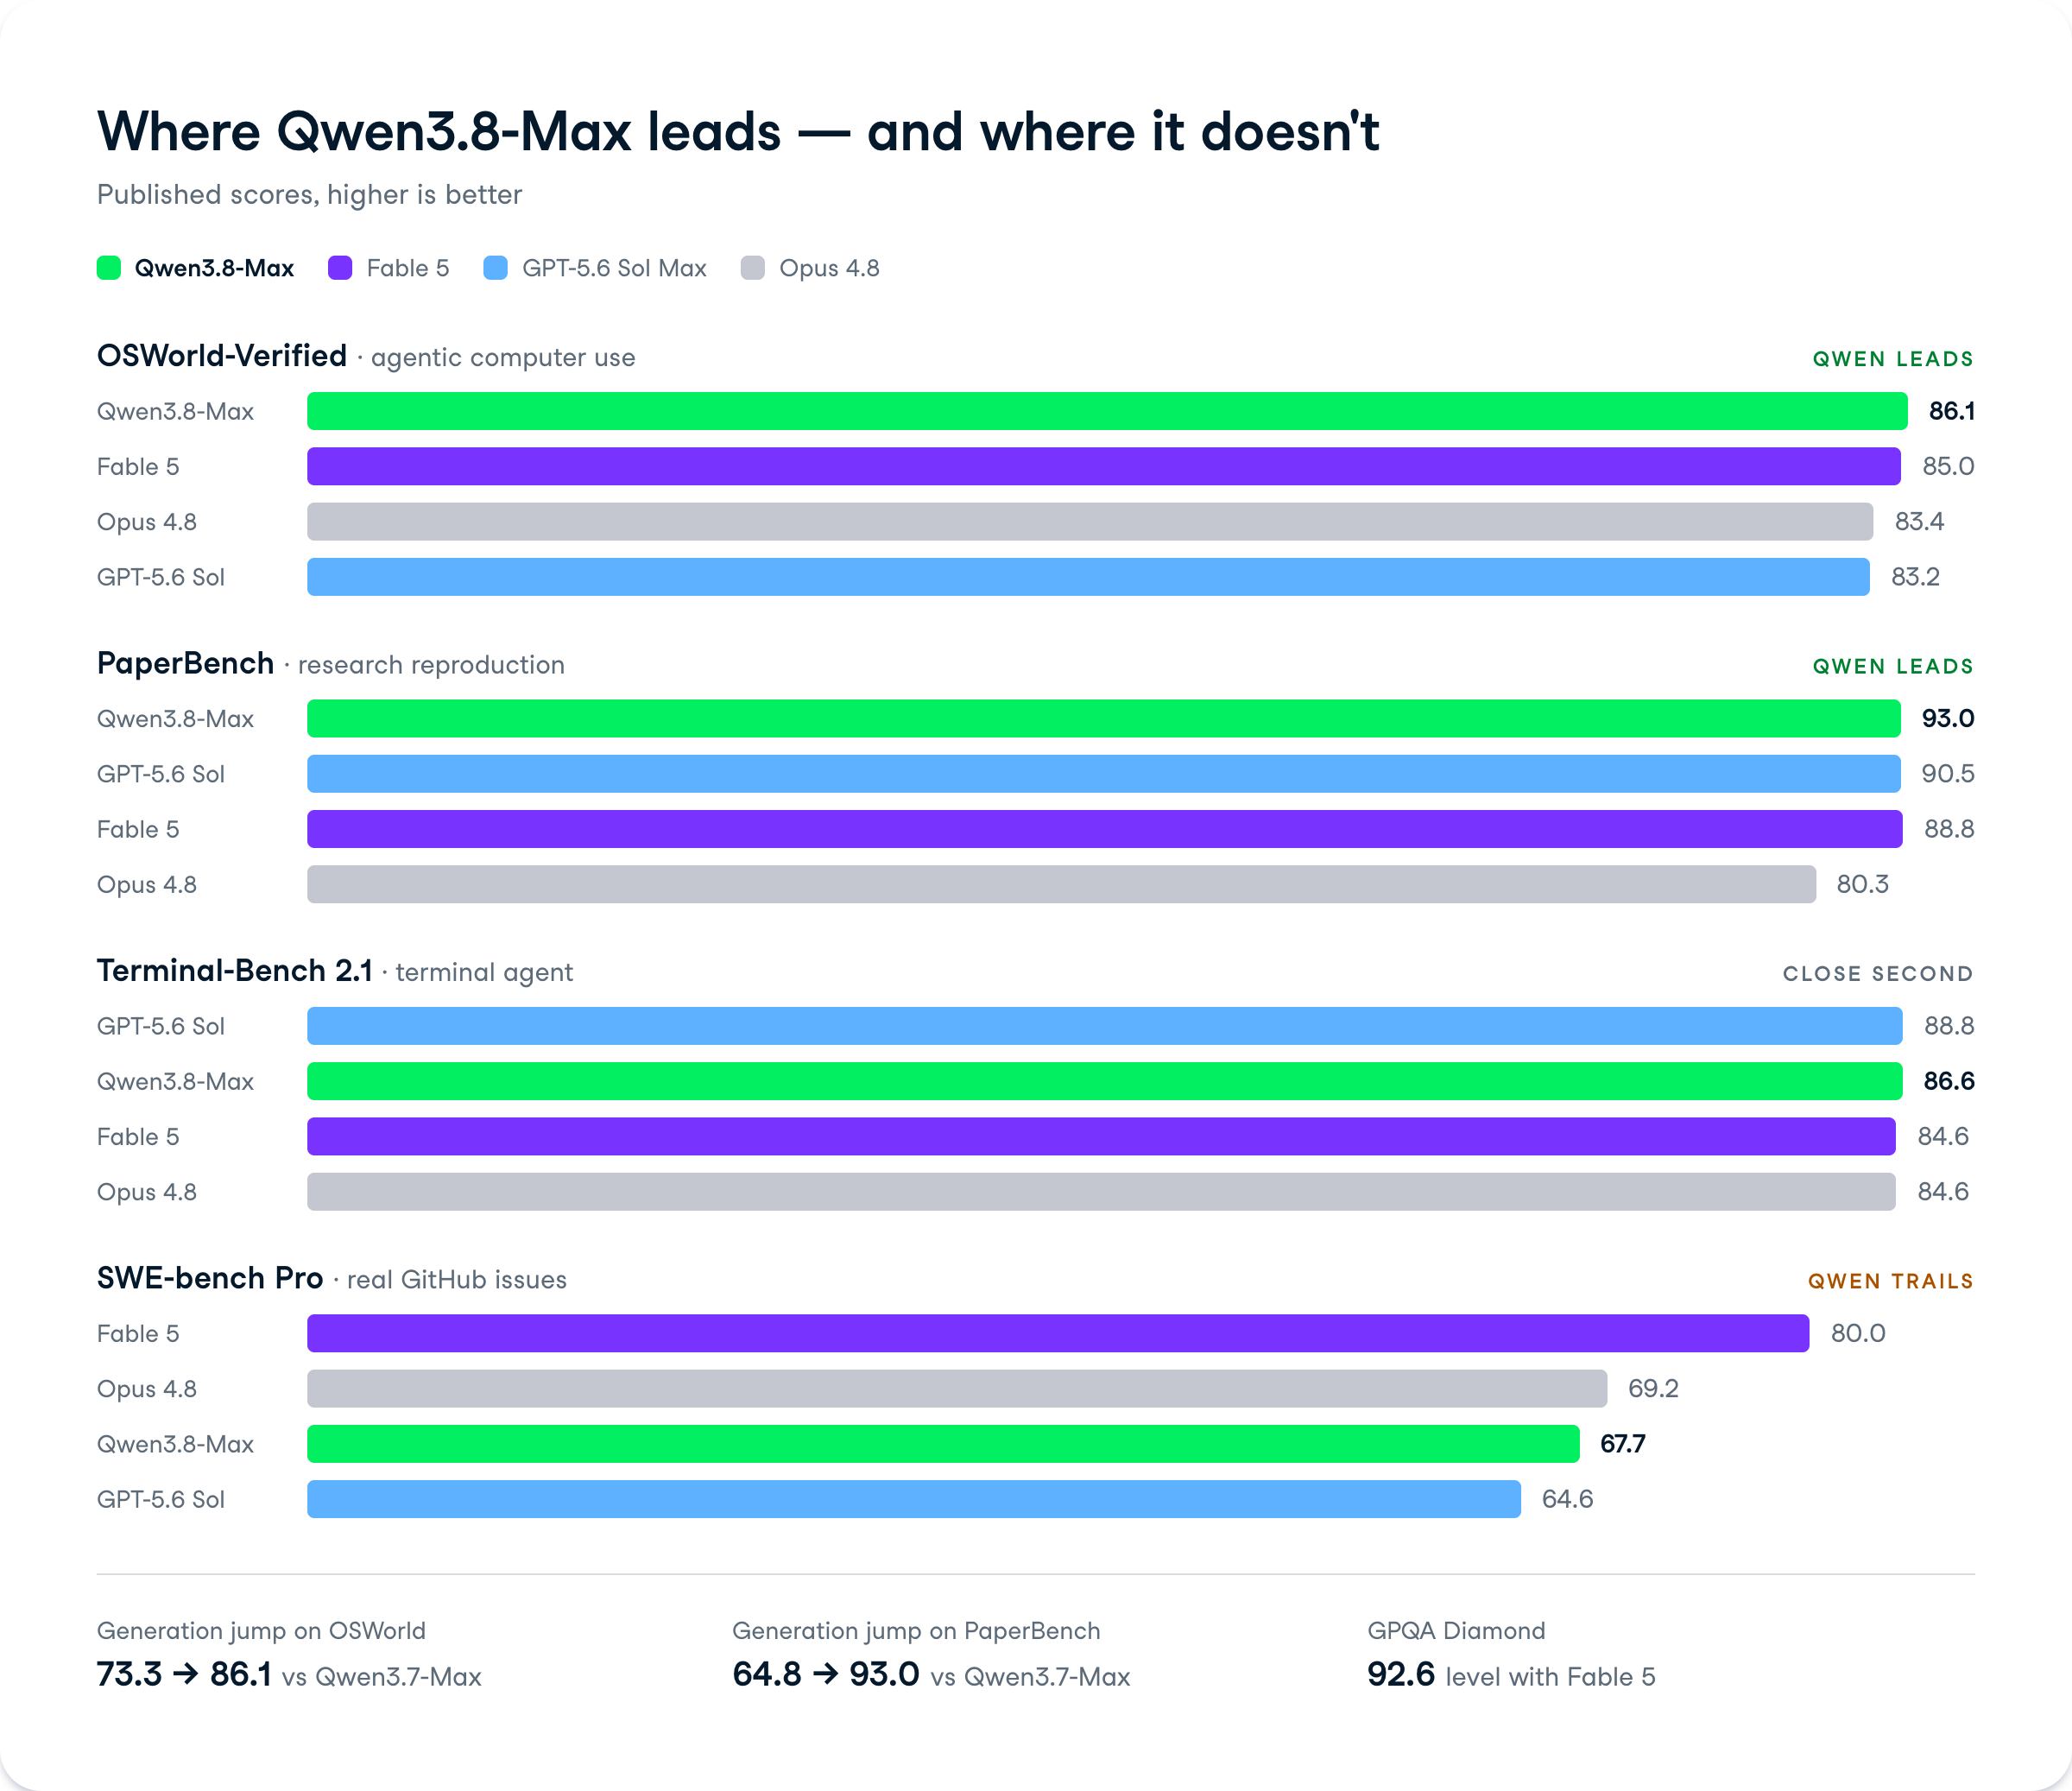
Qwen3.8-Max obtient 86,1 sur OSWorld-Verified, devant Fable 5 (85,0), GPT-5.6 Sol Max (83,2) et Gemini 3.1 Pro (76,2).
Ce benchmark mesure la fiabilité avec laquelle un agent d'usage informatique opère un environnement desktop réel, en cliquant dans les interfaces et en réussissant des tâches multi-étapes.
Pour quiconque conçoit des agents qui pilotent des applications réelles plutôt que d'appeler des APIs, c'est la métrique qui compte le plus. Qwen3.7-Max n'était qu'à 73,3 ici, la progression au sein de la famille est notable.
Sur PaperBench, Qwen3.8-Max affiche 93,0, le score le plus élevé rapporté, devant GPT-5.6 Sol à 90,5 et Fable 5 à 88,8.
PaperBench mesure la capacité d'un modèle à reproduire en code les expériences d'un article, ce qui correspond directement à la démo de reproduction sur 5 jours.
L'écart avec Qwen3.7-Max (64,8) est important. Si votre travail consiste à transformer des articles en pipelines opérationnels, c'est un signal fort.
Qwen3.8-Max obtient 86,6 sur Terminal-Bench 2.1, entre GPT-5.6 Sol à 88,8 et les 84,6 d'Opus 4.8 et Fable 5.
Ce benchmark évalue un agent qui travaille dans un terminal pour accomplir des tâches d'ingénierie sous contrainte de temps.
C'est un vrai bond par rapport aux 74,5 de Qwen3.7-Max, et cela place un modèle open weights à portée des meilleurs scores propriétaires sur le travail agentique en ligne de commande.
Ici, Qwen3.8-Max est derrière. Il obtient 67,7 sur SWE-bench Pro, derrière Fable 5 à 80,0 et Opus 4.8 à 69,2, mais devant GPT-5.6 Sol à 64,6.
SWE-bench Pro mesure la résolution d'issues GitHub réelles dans des bases de code professionnelles.
C'est un point faible assumé. Lors de notre analyse de Grok 4.5, Fable 5 menait aussi SWE-Bench Pro à 80,4 ; le modèle d'Anthropic reste donc la référence sur cette éval spécifique.
Sur GPQA Diamond, un benchmark de raisonnement scientifique de niveau master, Qwen3.8-Max atteint 92,6, au niveau de Fable 5 (92,6) et juste derrière GPT-5.6 Sol à 94,1. Il mène aussi sur IFBench (suivi d'instructions) à 82,8, HealthBench à 60,2 et PRBench-Finance à 58,3.
La tendance se confirme : très fort sur l'agentique et l'appliqué, compétitif en raisonnement, parfois derrière sur l'examen de raisonnement le plus difficile, Humanity's Last Exam, où il score 43,6 contre 53,3 pour Fable 5.
Qwen3.8-Max est disponible dès maintenant via QwenCloud avec l'ID de modèle API qwen3.8-max. L'API prend en charge les endpoints OpenAI-compatibles pour chat completions et responses ainsi qu'une interface compatible Anthropic, ce qui permet d'y pointer Claude Code ou Codex avec des ajustements minimes.
La tarification se situe dans le milieu de gamme et sous-cote les principaux modèles propriétaires américains de référence :
Ce total combiné de 8 $ représente moins d'un tiers des 30 $ de Claude Opus 5 et moins d'un quart des 35 $ de GPT-5.6 Sol Standard. Cela égale Grok 4.5, également tarifé 2 $/6 $, comme nous l'avions noté dans notre couverture de Grok 4.5. Les poids ouverts de Qwen3.8-Max et Qwen3.8-27B doivent être publiés sur Hugging Face et ModelScope la semaine prochaine, même si les conditions de licence ne sont pas encore publiques.
Qwen3.8-Max est le message d'Alibaba sur l'endroit où les poids ouverts peuvent rivaliser. Dépasser Fable 5 et GPT-5.6 Sol Max sur OSWorld-Verified et PaperBench, avec un modèle auto-hébergeable à 2 $/6 $, met la pression sur tout le segment propriétaire en coût par tâche agentique.
Les réserves sont réelles. L'exécution de code autonome sur 16 jours et la reproduction de recherche sur 5 jours sont des vitrines éditeur, pas des reproductions indépendantes, et la licence des poids attendus la semaine prochaine reste inconnue. Sur r/LocalLLaMA, le débat le plus vif concerne le plus petit Qwen3.8-27B, plusieurs commentateurs étant plus enthousiastes à l'idée de concentrer l'intelligence sur un seul GPU grand public que par un mastodonte de 2,4 T que seuls quelques setups peuvent faire tourner.
Notre avis : si vous construisez des agents qui opèrent de vraies interfaces ou reproduisent des pipelines de recherche, Qwen3.8-Max mérite des tests sérieux, surtout une fois les poids publiés pour l'auto-hébergement. Si votre travail est de l'ingénierie logicielle pure sur des issues GitHub coriaces, Fable 5 domine encore SWE-bench Pro : testez les deux avant de vous engager.
Pour vous familiariser avec ces modèles via leurs APIs, nous recommandons notre parcours de compétences AI Fundamentals pour poser d'abord les fondamentaux.
Les meilleurs cours DataCamp
Cours
Cours
Cursus
blog
Kurtis Pykes
9 min
blog
Kurtis Pykes
15 min
blog
Zoumana Keita
15 min
blog
Lynn Heidmann
Tutoriel
Laiba Siddiqui
14 min
Tutoriel