Letzte Chance! 50 % auf alles
Der Sale endet in
Update: 2. September 2026: Alibaba hat Qwen3.8-Max-0902 veröffentlicht, einen erweiterten Snapshot von Qwen3.8-Max mit Fokus auf Coding und die Performance von Agenten. Der folgende Abschnitt wurde ergänzt, um die neuen Benchmarks abzubilden.
Am 2. September 2026 hat Alibaba Qwen3.8-Max-0902 als Post-Training-Upgrade zu Qwen3.8-Max veröffentlicht. Die Architektur bleibt unverändert: 2,4 Billionen Parameter, 1M Token Kontext und die gleichen Preise ($2/1M Input, $6/1M Output). Der Schwerpunkt liegt klar auf Coding und Agentenarbeit über lange Zeithorizonte.
Das auffälligste Ergebnis ist Code Arena WebDev, wo Qwen3.8-Max-0902 mit 1.691 Punkten insgesamt auf Platz eins liegt — 3 Punkte vor Claude Opus 5 Max (1.687), 17 vor Kimi K3 Max (1.674) und 22 vor dem bisherigen Qwen3.8-Max (1.669). Zudem steht es zum gemischten Preis von $5 pro Million Tokens an der Spitze der Pareto-Front.
Alle 8 Coding-Benchmarks haben sich verbessert. Die größten Sprünge gab es bei TerminalBench 3.0 (11,3 auf 29,0) und ProgramBench Almost Solved (10,5 auf 28,0) — beide mehr als verdoppelt. Die Tabelle unten zeigt das Gesamtbild über die Kategorien Coding, Agenten und Multimodal.
| Benchmark | Qwen3.8-Max-0902 | Qwen3.8-Max | Claude Opus 5 |
|---|---|---|---|
| Coding | |||
| TerminalBench 3.0 | 29.0 | 11.3 | 42.7 |
| DeepSWE 1.1 | 69.3 | 56.6 | 73.6 |
| NL2Repo-Bench | 64.9 | 55.9 | 72.3 |
| ProgramBench (Almost Solved) | 28.0 | 10.5 | 41.5 |
| SWE-Marathon | 44.8 | 39.1 | 50.0 |
| MLS-Bench-Lite | 50.1 | 41.0 | 49.8 |
| SWE-Atlas QnA | 66.3 | 60.3 | 63.2 |
| QwenSWEBench V2 | 70.0 | 55.1 | 68.0 |
| Agent | |||
| CoWorkBench | 76.1 | 74.8 | 79.6 |
| JobBench | 64.0 | 53.4 | 67.8 |
| Toolathlon Verified | 73.3 | 72.5 | 77.6 |
| WorkArena (Elo) | 1468 | 1348 | 1437 |
| Multimodal | |||
| MMMU-Pro | 82.7 | 82.3 | 82.6 |
| ERQA | 78.3 | 77.8 | 67.3 |
Fett markiert: Qwen3.8-Max-0902 liegt auf diesem Benchmark vor Claude Opus 5. Alle Ergebnisse stammen aus Alibabas veröffentlichter Vergleichstabelle.
Im Vergleich zu Claude Opus 5 führt das 0902-Update auf drei Coding-Benchmarks (MLS-Bench-Lite, SWE-Atlas QnA, QwenSWEBench V2) und gewinnt auf WorkArena sowie bei beiden veröffentlichten multimodalen Evals. Claude liegt weiterhin vorn bei TerminalBench 3.0, DeepSWE 1.1 und den Agenten-Koordinationsbenchmarks. Die Preise bleiben unverändert — wenn du Qwen3.8-Max bereits nutzt, ist das ein kostenloses Upgrade mit spürbarem Coding-Schub. Qwen hat außerdem am 18. September Qwen3.8-Omni-Flash veröffentlicht.
Ursprünglicher Artikel
Alibabas Qwen-Team hat Qwen3.8-Max am 3. August 2026 veröffentlicht — genau im umkämpftesten Teil des Frontier-Markts: autonome Softwareentwicklung und Enterprise-Arbeit über lange Zeithorizonte. Erstmals plant Qwen, ein Max-Klassen-Modell als Open Weights bereitzustellen; die Gewichte sollen nächste Woche zusammen mit einem kleineren Qwen3.8-27B erscheinen.
Qwen3.8-Max ist ein Mixture-of-Experts-(MoE)-Modell mit 2,4 Billionen Parametern und 95B aktiven Parametern, 1M-Token-Kontextfenster sowie nativer Text-, Bild- und Videoeingabe. Der zentrale Claim: 86,1 Punkte auf OSWorld-Verified — vor GPT-5.6 Sol Max (83,2), Claude Fable 5 (85,0) und Gemini 3.1 Pro (76,2). Außerdem meldet es den höchsten PaperBench-Wert von 93,0 und kostet $2/$6 pro Million Input-/Output-Tokens.
In diesem Artikel zeige ich dir alles Neue an Qwen3.8-Max: die Coding- und Agentenfunktionen, die Benchmarks und wie du eigene Tests aufsetzt. Verwandte Beiträge: unsere Guides zu Grok 4.5, GPT-5.6 Terra vs Claude Sonnet 5 und unser kompletter Guide zur Claude API. Lies auch über den neuen Qwen3.8-Flash.
Qwen3.8-Max ist das leistungsfähigste Modell der Qwen-Familie, eine spärliche MoE-Architektur mit insgesamt 2,4 Billionen Parametern und rund 95B aktiven Parametern pro Forward Pass.
Es basiert auf der Architektur von Qwen 3.5 und zielt speziell auf vier Lernpfade:
Die größte strukturelle Änderung gegenüber Qwen3.7-Max ist der Maßstab und das Open-Weight-Versprechen. Qwen hat noch nie Gewichte für ein Max-Klassen-Modell veröffentlicht, und das Unternehmen sagt, sowohl Qwen3.8-Max als auch Qwen3.8-27B werden nächste Woche auf Hugging Face und ModelScope erscheinen.
Alibaba hat die Lizenz noch nicht offengelegt, daher ist unklar, ob etwas Freizügiges wie Apache 2.0 kommt oder eine restriktivere Custom-Lizenz.
Die wichtigste Benchmark-News betrifft agentische Computernutzung.
Auf OSWorld-Verified, das misst, wie gut ein Agent eine echte Desktop-Umgebung bedient, führt Qwen3.8-Max alle proprietären Modelle, gegen die Qwen getestet hat.
Für ein Modell, das sich selbst hosten lässt, ist das ein echtes Ausrufezeichen im Vergleich zu typischen Open-Weight-Releases, die der Spitze oft eine Generation hinterherlaufen.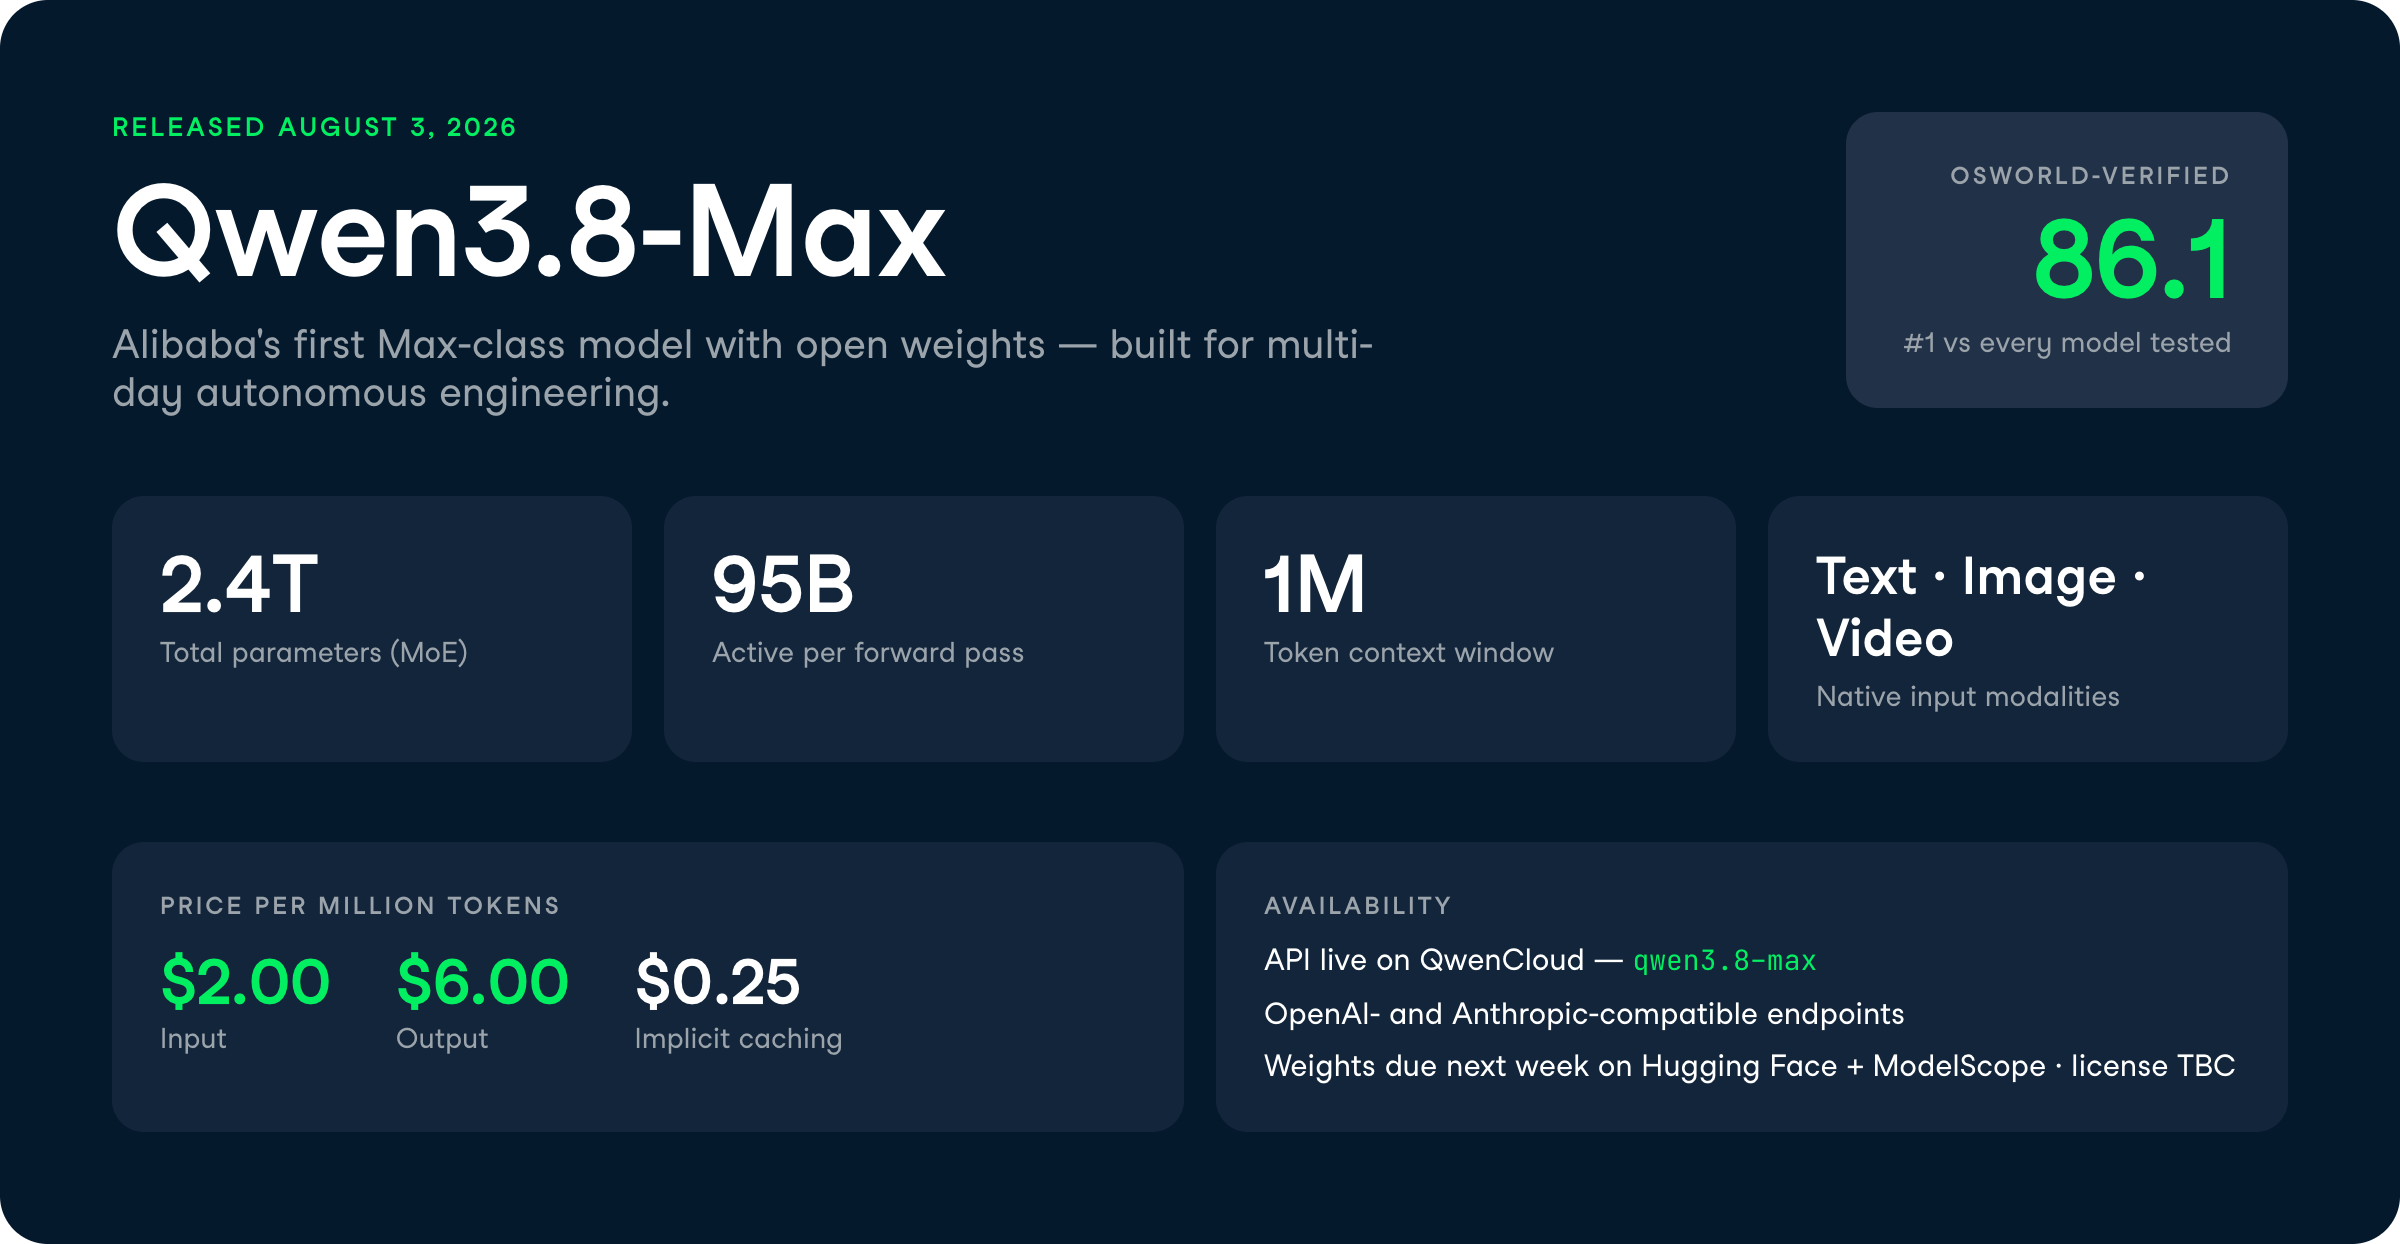
Das Leitmotiv von Qwen3.8-Max ist Autonomie über lange Zeithorizonte.
Qwen rahmt jede Fähigkeit über dieselbe Idee: Das Modell folgt keinem starren Plan, sondern korrigiert sich über Feedback-Loops selbst — über Tage kontinuierlicher Arbeit.
Das sind die Features, die für mich herausstechen.
Qwen3.8-Max kann ein Coding-Projekt von einem leeren Ordner zu einem fertigen Ergebnis über Tage kontinuierlicher Arbeit bringen — ohne Menschen in der Schleife.
Die Vorzeigedemo des Unternehmens lief rund 16 Tage voll autonom und baute ein sich selbst weiterentwickelndes CLI-Harness mit 265 Commits, 127 PRs und 151 Issues.
Der Mechanismus ist ein Feedback-Loop: Anforderungen kommen als GitHub-Issues rein, Agenten übernehmen und setzen um, dann folgen Build, Unit-Tests, End-to-End-Tests und CI-Checks vor dem Merge.
Für Praktiker deutet das auf ein Modell, das unbeaufsichtigte Engineering-Pipelines fährt — statt Einzelfragen zum Code zu beantworten.
Die offensichtliche Einschränkung: Das sind Anbieter-Demos.
Ein 16-tägiger autonomer Lauf in einer kontrollierten Umgebung ist nicht dasselbe, wie das auf dein Produktions-Monorepo loszulassen und wegzugehen.
Qwen3.8-Max kann ein Paper lesen, seine Experimente von Grund auf in Code reproduzieren und anschließend versuchen, die Originalmethode zu schlagen.
Im Qwen-Beispiel arbeitete das Modell etwa 5 Tage (~125 Stunden), schrieb rund 7.600 Zeilen Code, führte über 1.100 Aktionen aus und startete 33 Runden GPU-Training — ohne Starter-Code.
Es reproduzierte zuerst die sechs Hauptbefunde des Papers, dann lief ein Self-Improvement-Loop aus Hypothese, Code, GPU-Run und Analyse über 4 Runden und 18 Ideen.
Die finale Methode, die es entwickelte, schlug den Ansatz des Papers um 2,71 Punkte auf AIME24, einem Wettbewerbs-Benchmark für Mathematik.
Solche Workflows binden normalerweise eine Forschungsgruppe eine Woche lang, bevor überhaupt Experimente starten.
Dynamic Workflows lassen Qwen3.8-Max Aufgaben programmatisch planen und große Zahlen an Sub-Agenten parallel steuern.
In einer Quant-Research-Demo zerlegte das Modell 6 kurze Faktor-Beschreibungen in jeweils 50 Forschungsrichtungen, startete rund 330 Sub-Agenten und absolvierte etwa 6.000 Backtests — mit Anpassungen des Workflows während des Laufs.
Der Unterschied zu einem starren Skript: Das Modell handelte evidenzbasiert.
Erkannte es Overfitting-Signale, kappte es redundante Faktoren Runde für Runde; als Three-Model-Ensembling weniger robust wirkte als Fixed-Direction-Synthese auf kleinen Querschnitten, wechselte es eigenständig den Rahmen.
Die ausgewählten Faktoren erzielten zusätzliche Sharpe Ratios von 0,64 bis 1,48 — ein konkretes, prüfbares Ergebnis statt nur ein Gefühl.
Qwen3.8-Max nutzt Vision während der gesamten Ausführung, nicht nur zum Einlesen.
Während einer Aufgabe inspiziert es eigene Zwischenergebnisse, erkennt Probleme wie eine verrutschte Oberfläche oder ein falsch ausgerichtetes Objekt und passt den Plan zur Korrektur an.
Auf der Input-Seite verarbeitet es PDFs mit über 200 Seiten — inklusive Text, Charts und Layout — und kann Videos mit über 100 Stunden Länge analysieren, indem es einen Video-Memory-Graphen aus Personen, Ereignissen und Zeitstempeln aufbaut.
Qwen hat außerdem Qwen-MM-Plugins ausgeliefert, eine Erweiterungsbibliothek für Harnesses, die Bild- und Videobearbeitung, multimodales Gedächtnis und visuelle Tool-Nutzung zu bestehenden Agentenframeworks hinzufügt.
Für alle, die dokumentlastige oder videolastige Agenten bauen, ist der Memory-Graph das spannende Teil.
Qwen3.8-Max stellt einen Parameter reasoning_effort bereit, um Kosten gegen Tiefe zu tauschen. Drei Stufen steuern, wie viel das Modell vor der Antwort „nachdenkt“:
xhigh (Standard): für komplexe Aufgaben mit gründlicher Analysemedium: Balance aus Genauigkeit und Geschwindigkeitlow: effizientes Reasoning, optimiert für Tempo und KostenWichtig: Ein r/LocalLLaMA-Kommentator merkte an, dass Qwen-Modelle zum Überlegen neigen und dass DeepSeek V4 Flash weniger Zeit fürs Reasoning braucht, auch wenn die Ausgabequalität teils niedriger ist. Wenn Latenz kritisch ist, stell auf low, bevor du den Standard übernimmst.
Qwens Benchmark-Suite fokussiert stark auf Ausführung über lange Zeithorizonte statt auf statische Prüfungen — passend zur Positionierung des Modells.
Über die veröffentlichten Tabellen hinweg führt oder bleibt Qwen3.8-Max sehr konkurrenzfähig bei agentischer Computernutzung, Forschungsreproduktion und Coding, während es bei einigen Software-Engineering-Evals hinter GPT-5.6 Sol Max und Fable 5 zurückliegt.
Es bietet eines der breitesten, ausgewogenen Profile, ohne jede Kategorie zu dominieren.
| Benchmark (Kategorie) | Qwen 3.8 Max | Qwen 3.7 Max | Opus 4.8 | Fable 5 | Gemini 3.1-Pro | GPT5.6 Sol (max) |
|---|---|---|---|---|---|---|
| SWE-Pro (Software Engineering) | 67.7 | 60.6 | 69.2 | 80.0 | - | 64.6 |
| TerminalBench-2.1 (Terminal-Agent) | 86.6 | 74.5 | 84.6 | 84.6 | - | 88.8 |
| PaperBench (Forschungsreproduktion) | 93.0 | 64.8 | 80.3 | 88.8 | - | 90.5 |
| FrontierSWE (Software Engineering) | 73.5 | 40.7 | 70.0 | 88.8 | - | - |
| QwenReactBench (React-Frontend) | 1724 | 1538 | 1694 | 1770 | - | 1564 |
| CoWorkBench (Professionelle Teamaufgaben) | 74.8 | 64.6 | 72.3 | 75.9 | - | 71.5 |
| JobBench (Agenten unterstützen Workflows) | 53.4 | 31.3 | 48.4 | 57.4 | - | 45.4 |
| Agents' Last Exam (Langfristig wertvolle Aufgaben) | 52.4 | 31.1 | 45.1 | - | - | 53.6 |
| BabyVision (Visuelles Reasoning)* | 82.0 / 91.3 | 64.7 / 70.4 | 28.4 / 81.2 | 42.5 / 90.5 | 55.9 / 68.3 | 65.5 / 88.9 |
| CharXiv (RQ) (Diagramm-Reasoning)* | 88.4 / 93.5 | 85.8 / 85.9 | 78.5 / 89.9 | 87.9 / 93.5 | 84.4 / 89.9 | 85.1 / 89.1 |
| ERQA (Embodied Reasoning) | 77.8 | 69.8 | 57.2 | 70.0 | 68.0 | 70.0 |
| PerceptionBench (Visuelle Wahrnehmung) | 63.5 | 51.1 | 47.2 | 57.2 | 56.2 | 59.7 |
| LVBench (Verständnis langer Videos) | 81.8 | 76.2 | 67.3 | 75.1 | - | 78.8 |
| Vision2Web (Visuelle Webentwicklung) | 69.0 | 42.1 | 62.4 | 70.5 | - | 62.1 |
| MobileWorld (Agentische Mobile-Nutzung) | 77.8 | 51.2 | 67.5 | 85.5 | 58.1 | 76.9 |
| OSWorld-Verified (Agentische Computernutzung) | 86.1 | 73.3 | 83.4 | 85.0 | 76.2 | 83.2 |
Wichtige Hinweise:
* Doppelte Werte: Für Benchmarks mit zwei Metriken (BabyVision und CharXiv) sind die Werte als w/o python / w/ python formatiert — basierend auf den inneren bzw. oberen Zahlen der jeweiligen Balken.
* Fehlende Daten (-): Gedankenstriche kennzeichnen Benchmarks, bei denen das Modell nicht getestet wurde oder der Wert nicht in den Charts enthalten ist.
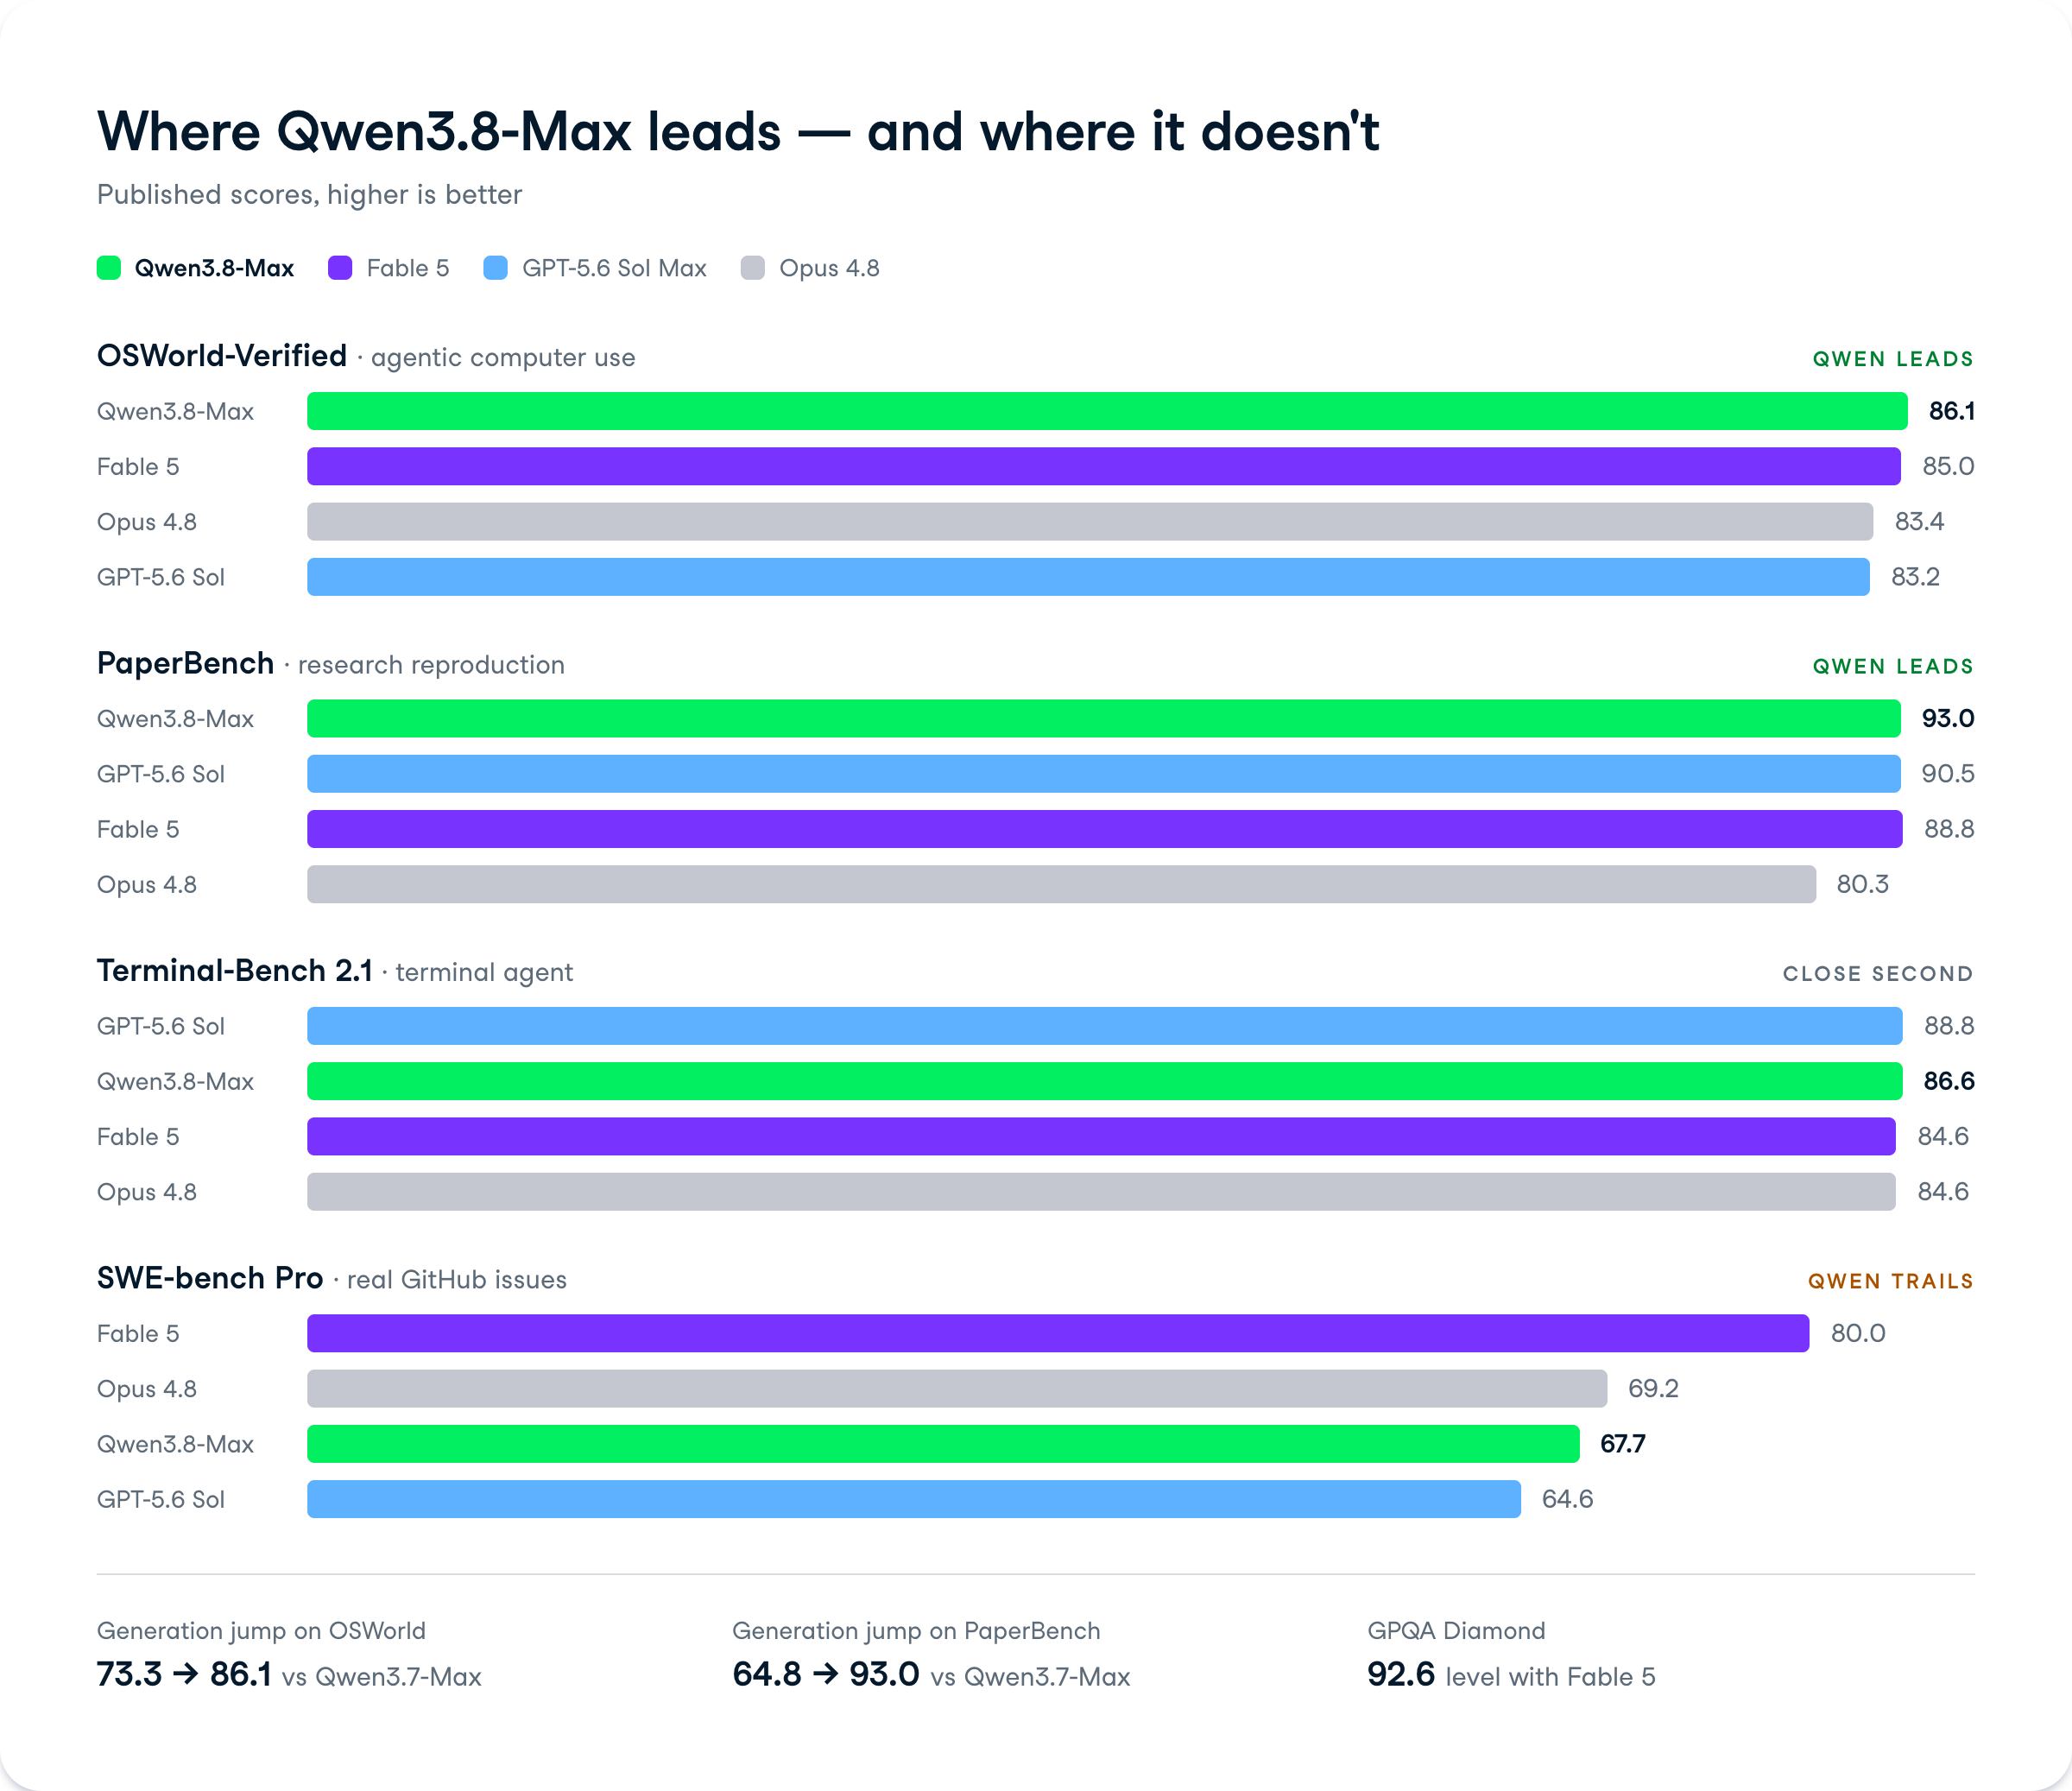
Qwen3.8-Max erzielt 86,1 auf OSWorld-Verified, vor Fable 5 (85,0), GPT-5.6 Sol Max (83,2) und Gemini 3.1 Pro (76,2).
Dieser Benchmark misst, wie zuverlässig ein Computer-Use-Agent eine echte Desktop-Umgebung bedient, durch Interfaces klickt und mehrstufige Aufgaben abschließt.
Für alle, die Agenten bauen, die echte Anwendungen steuern statt nur APIs aufzurufen, ist das die wichtigste Zahl. Qwen3.7-Max kam hier nur auf 73,3 — der Sprung innerhalb der Familie ist deutlich.
Auf PaperBench erreicht Qwen3.8-Max 93,0, den höchsten gemeldeten Wert — vor GPT-5.6 Sol mit 90,5 und Fable 5 mit 88,8.
PaperBench misst die Fähigkeit eines Modells, die Experimente eines Papers in Code zu reproduzieren — direkt vergleichbar mit der 5-tägigen Showcase zur Forschungsreproduktion.
Das ist ein großer Abstand zu Qwen3.7-Max (64,8). Wenn du Papers in produktive Pipelines übersetzt, ist das ein starkes Signal.
Qwen3.8-Max erzielt 86,6 auf Terminal-Bench 2.1 — zwischen GPT-5.6 Sol (88,8) und den 84,6 von Opus 4.8 und Fable 5.
Dieser Benchmark testet einen Agenten im Terminal, der Engineering-Aufgaben unter Zeitdruck löst.
Das ist ein echter Fortschritt gegenüber den 74,5 von Qwen3.7-Max und bringt ein Open-Weight-Modell in Schlagdistanz zu den Top-Werten proprietärer Modelle bei Command-Line-Agentenarbeit.
Hier liegt Qwen3.8-Max zurück. Es erzielt 67,7 auf SWE-bench Pro — hinter Fable 5 (80,0) und Opus 4.8 (69,2), aber vor GPT-5.6 Sol (64,6).
SWE-bench Pro misst das Lösen realer GitHub-Issues in professionellen Codebasen.
Das ist die ehrliche Schwachstelle. Als wir Grok 4.5 reviewt haben, führte Fable 5 auch bei SWE-Bench Pro mit 80,4. Anthrophics Modell bleibt hier die Messlatte.
Auf GPQA Diamond, einem Benchmark für wissenschaftliches Reasoning auf Master-Niveau, erzielt Qwen3.8-Max 92,6 — gleichauf mit Fable 5 (92,6) und knapp hinter GPT-5.6 Sol (94,1). Es liegt außerdem vorn bei IFBench (Instruction Following) mit 82,8, HealthBench mit 60,2 und PRBench-Finance mit 58,3.
Das Muster hält: stark bei agentischer und angewandter Arbeit, wettbewerbsfähig im Reasoning und gelegentlich hinten bei der härtesten Reasoning-Prüfung, Humanity's Last Exam, wo es 43,6 gegenüber 53,3 von Fable 5 erzielt.
Qwen3.8-Max ist jetzt über QwenCloud mit der API-Model-ID qwen3.8-max verfügbar. Die API unterstützt OpenAI-kompatible Chat Completions und Responses Endpoints sowie eine Anthropic-kompatible Schnittstelle — du kannst Claude Code oder Codex mit minimalen Konfigurationsänderungen darauf zeigen.
Die Preise liegen im Mittelfeld und unterbieten die Top-US-Modelle, mit denen es verglichen wird:
Die kombinierten $8 liegen bei weniger als einem Drittel von Claude Opus 5 ($30) und unter einem Viertel von GPT-5.6 Sol Standard ($35). Es entspricht Grok 4.5, das ebenfalls $2/$6 kostet — wie in unserem Grok-4.5-Beitrag erwähnt. Die Open Weights für Qwen3.8-Max und Qwen3.8-27B sollen nächste Woche auf Hugging Face und ModelScope erscheinen, die Lizenzbedingungen sind jedoch noch nicht öffentlich.
Qwen3.8-Max ist Alibabas Statement, wo Open Weights mithalten können. OSWorld-Verified und PaperBench vor Fable 5 und GPT-5.6 Sol Max zu toppen — und das mit einem selbst hostbaren Modell für $2/$6 — erhöht den Druck auf die gesamte proprietäre Spitze beim Preis pro agentischer Aufgabe.
Die Einschränkungen sind real. Der 16-tägige autonome Coding-Lauf und die 5-tägige Forschungsreproduktion sind Anbietershowcases, keine unabhängigen Replizierungen, und die Lizenz für die nächste Woche erwarteten Gewichte ist noch unbekannt. Auf r/LocalLLaMA drehte sich die spannendere Debatte um das kleinere Qwen3.8-27B — einige fanden es reizvoller, Intelligenz auf eine einzelne Consumer-GPU zu bringen, als einen 2,4T-Brocken, den nur wenige Setups fahren können.
Mein Fazit: Wenn du Agenten baust, die echte Interfaces bedienen oder Forschungspipelines reproduzieren, lohnt sich Qwen3.8-Max für ernsthafte Tests — besonders, sobald die Gewichte da sind und du selbst hosten kannst. Wenn deine Arbeit reine professionelle Softwareentwicklung mit kniffligen GitHub-Issues ist, liegt Fable 5 bei SWE-bench Pro vorn — also teste beide, bevor du dich festlegst.
Wenn du dich im Umgang mit solchen Modellen per API sicher fühlen willst, empfehle ich unseren AI Fundamentals Skill Track, um zuerst die Grundlagen aufzubauen.
Top-DataCamp-Kurse
Kurs
Kurs
Lernpfad
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Zoumana Keita
15 Min.
Blog
Tutorial
Allan Ouko
11 Min.
Tutorial
Josef Waples
3 Min.
Tutorial
Josef Waples
8 Min.