Kurs
Geliştiriciler için Yapay Zeka Destekli Kodlama
1 sa 30 dk
10.7K
GLM-5.3 Flash lansmanıyla aynı gün, Alibaba'nın Qwen ekibi, yakında çıkacak Qwen4 ailesinin arkasındaki mimariye erken bir ön bakış işlevi de gören, çok modlu bir uzman karışımı (MoE) modeli olan Qwen3.8-Flash-Next'in ağırlıklarını açtı.
Bu, Qwen3-Next'in Qwen3.5 için yaptığını yansıtıyor: Toplu model serisinden önce mimari değişiklikleri yayımlayarak topluluğun önce bunları incelemesini sağlamak.
Buradaki büyük haber maliyet. Son derece verimli yeni bir mimari sayesinde Qwen3.8-Flash-Next'i eğitmek, selefi Qwen3.7-Plus'a kıyasla yaklaşık dokuzda birine mal oldu. Ancak bu noktaya gelmek için güçten ödün vermiyor; hatta SWE-bench gibi önemli kodlama testlerinde Claude Opus 4.6 Max'i geride bırakıyor.
Bu yazıda, Qwen3.8-Flash-Next ile gelen tüm yenilikleri, mimarisini ve özelliklerini inceleyecek ve kıyaslamaları ele alacağım. Modeli yerelde nasıl indirip çalıştıracağınıza dair derinlemesine bir anlatım için Qwen3.8-Flash-Next eğitimimize göz atın. Diğer bazı Çin modelleri hakkında bağlam istiyorsanız, Qwen3.8-Max rehberimizi ve DeepSeek-V4-Flash-0731'i yerelde çalıştırma eğitimimizi inceleyin. Ayrıca yeni Qwen3.8-Omni-Flash sürümüne de bakmanızı öneririm.
Qwen3.8-Flash-Next, Alibaba'nın Qwen ekibinden gelen, 26 Ağustos 2026'da yayımlanan, üst düzey amiral gemisinden ziyade maliyet-etkin bir iş atı olarak konumlanan çok modlu bir MoE modelidir.
Zeka olarak Max sınıfı modellerin altında konumlanır, ancak fiyat konusunda neredeyse her şeyi alt eder; bu da "Flash" serisinin tüm amacıdır.
Model, yerel olarak 262.144 tokenlık bir bağlam penceresini destekler ve YaRN ([Yet another RoPE extensioN] yöntemi, bir modelin bağlam penceresini uzatan, böylece modelin orijinal performansını korurken çok büyük metin girdilerini işlemesine olanak tanıyan bir konumsal kodlama tekniği) ile 1.000.000 tokena genişletilebilir.
Tek bir API üzerinden metin, görüntü ve videoyu işler; bu da yorumcuların Ağustos 2026 özetlerinde onu "gecelik topluluk gözdesi" olarak nitelendirmesinin nedenlerinden biridir.
Bu sürümü uygulayıcılar için önemli kılan şey, dolar başına kıyas puanıdır.
Qwen3.8-Flash-Next, yayımlanan her kıyaslamada kendi 27B kardeşini geride bırakır ve token başına yalnızca 6B parametreyi etkinleştirirken çoğu pratik kodlama ve ajan değerlendirmesinde Claude Opus 4.6 Max'i aşar. Bu, Qwen4 mimarisine bir ön bakıştır; dolayısıyla burada yapılan tasarım tercihleri, Alibaba'nın sonraki adımda nereye yöneldiğini gösterir.
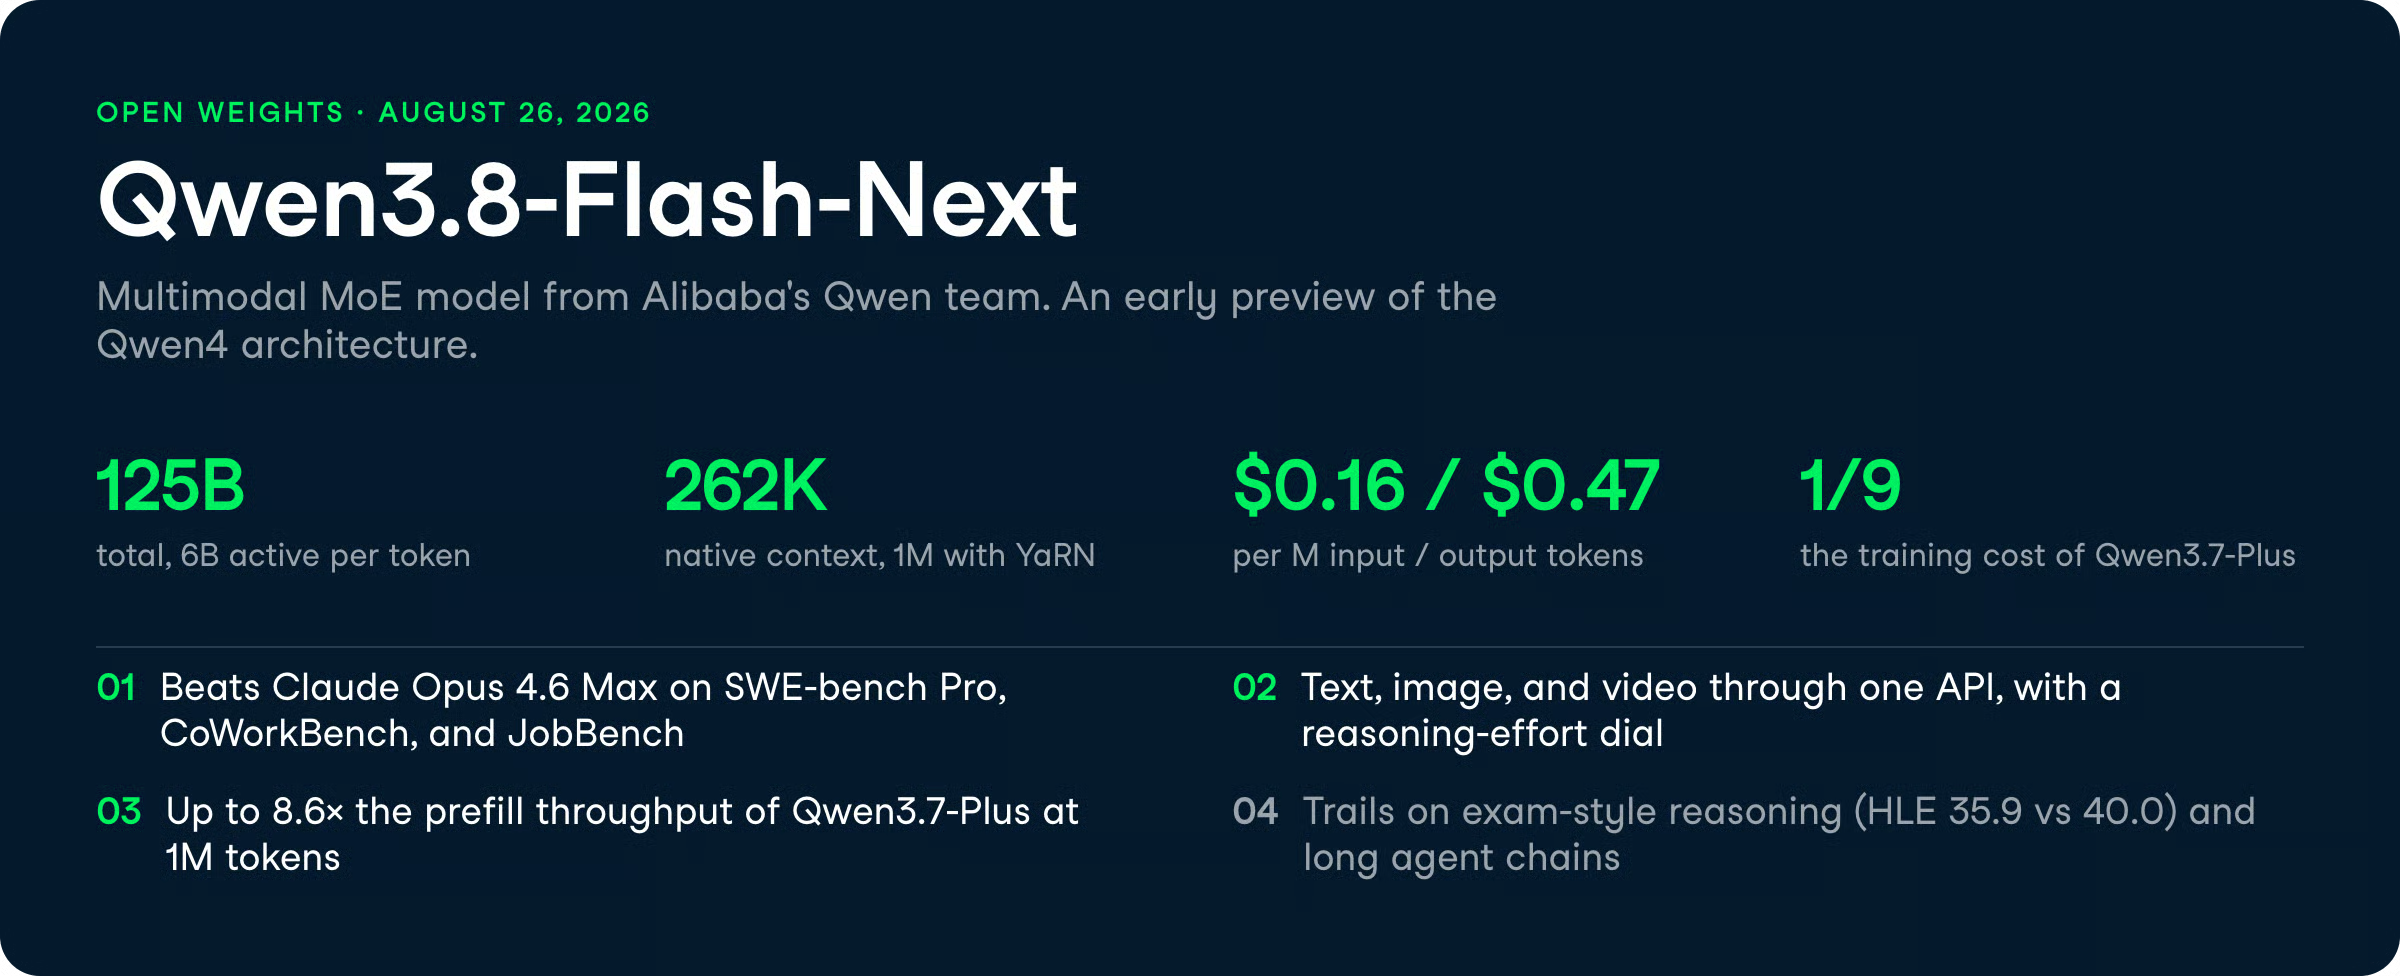
Qwen3.8-Flash-Next, modeli dört eksende yükseltir: dikkat, artık bağlantılar, gömme ve optimizasyon.
Aşağıda, her değişikliğin ne olduğundan ziyade bir kullanıcı olarak size gerçekte ne kazandırdığını özetliyorum.
En büyük pratik kazanç, uzun girdilerde hızdır.
Qwen3.8-Flash-Next, hibrit bir dikkat tasarımı kullanır; bağlam geçmişinin çoğunu sıkıştırarak yer tasarrufu yapar ve gerektiğinde yalnızca en alakalı ayrıntıları geri çağırmak için hedefli bir "Seyrek Dikkat" aracı kullanır.
1 milyon token'da hızlanmalar çok büyük: istem işleme (prefill) 7.6 kata kadar, üretim (decode) 4.9 kata kadar daha hızlı. Önbelleğe alınmış öneklerin bulunduğu tipik bir sunum kurulumunda, genel verim Qwen3.7-Plus'a kıyasla 8.6 kat artar.
Yüksek hacimli alma veya depo ölçeğinde kodlama ajanları çalıştıran herkes için bu verim farkı asıl özelliktir.
Ödemeyi hesaplama için yaparsınız ve bu tasarım, eskiden kötü şöhretli derecede pahalı olan uzun dizilerde faturayı ciddi biçimde düşürür.
Qwen, esasen bedavaya 51 milyar parametre eklemek için N-gram Gömme adı verilen zekice bir numara kullanır. Model, sadece tek bir tokena bakmak yerine, mevcut tokena ek olarak yakın komşularına da bakar; bu da modele devasa bir "yerel desen hafızası" kazandırır.
Modelin neyi önceden arayacağını bilmesi sayesinde bu ekstra 51B parametre, GPU'da değil standart sistem belleğinde (RAM) bulunur. Arka planda otomatik olarak çekilirler; bu da GPU belleğini kalıcı olarak işgal etmedikleri veya token başına hesaplamayı yavaşlatmadıkları anlamına gelir.
Tipik VRAM bedelini ödemeden çok daha büyük bir modelin zekasına sahip olursunuz.
Qwen3.8-Flash-Next, tek bir arayüz üzerinden metin, görüntü ve videoyu işler ve görsel yetenekleri maliyet diliminin çok üzerinde performans sergiler.
Mobil kullanım testlerinde (AndroidWorld'de 84.5'e karşı 62.0) ve gerçek dünya görsel anlama testlerinde (RealWorldQA'da 88.5'e karşı 73.9) Claude Opus 4.6 Max'i rahatlıkla geride bırakır.
Görsel matematikte de çok güçlüdür; MathVision'da 95.7'ye kadar puan alır (Opus'un 65.5'inin epey ilerisinde).
İş akışınız ekran görüntüleri, grafikler veya uygulama arayüzlerini ayrıştırmayı içeriyorsa, Qwen bu fiyat noktasında Claude'a karşı gerçek bir avantaj sunar.
API, üç ayarlı (yüksek, orta ve düşük) bir reasoning effort düğmesi sunar; bu sayede derin düşünmeyi daha düşük gecikme ve daha ucuz isteklerle takas edebilirsiniz.
Model ayrıca gerçek dünya iş yüklerinde üretimi hızlandırmak için birkaç adımı önceden tahmin eden çoklu token tahmin modülüyle gelir.
Pratik sonuç kontrol edebilmektir.
Aynı model kimliğini kullanarak, yüksek hacimli ve maliyet hassas trafiğe yönelik akıl yürütmeyi kısmak; karmaşık ajan görevleri için artırmak elinizdedir.
Yayımlanan sayılar genelinde, Qwen3.8-Flash-Next çoğu kodlama ve ajan kıyaslamasında önde gelirken, birkaç sınav tarzı akıl yürütme değerlendirmesinde geride kalır.
Kendi 27B kardeşini her alanda geçer; en büyük farklar ajan işlerinde görülür.
Aşağıdaki tüm karşılaştırmalar, aksi belirtilmedikçe Qwen'in kendi yayımladığı tablodan alınmıştır.
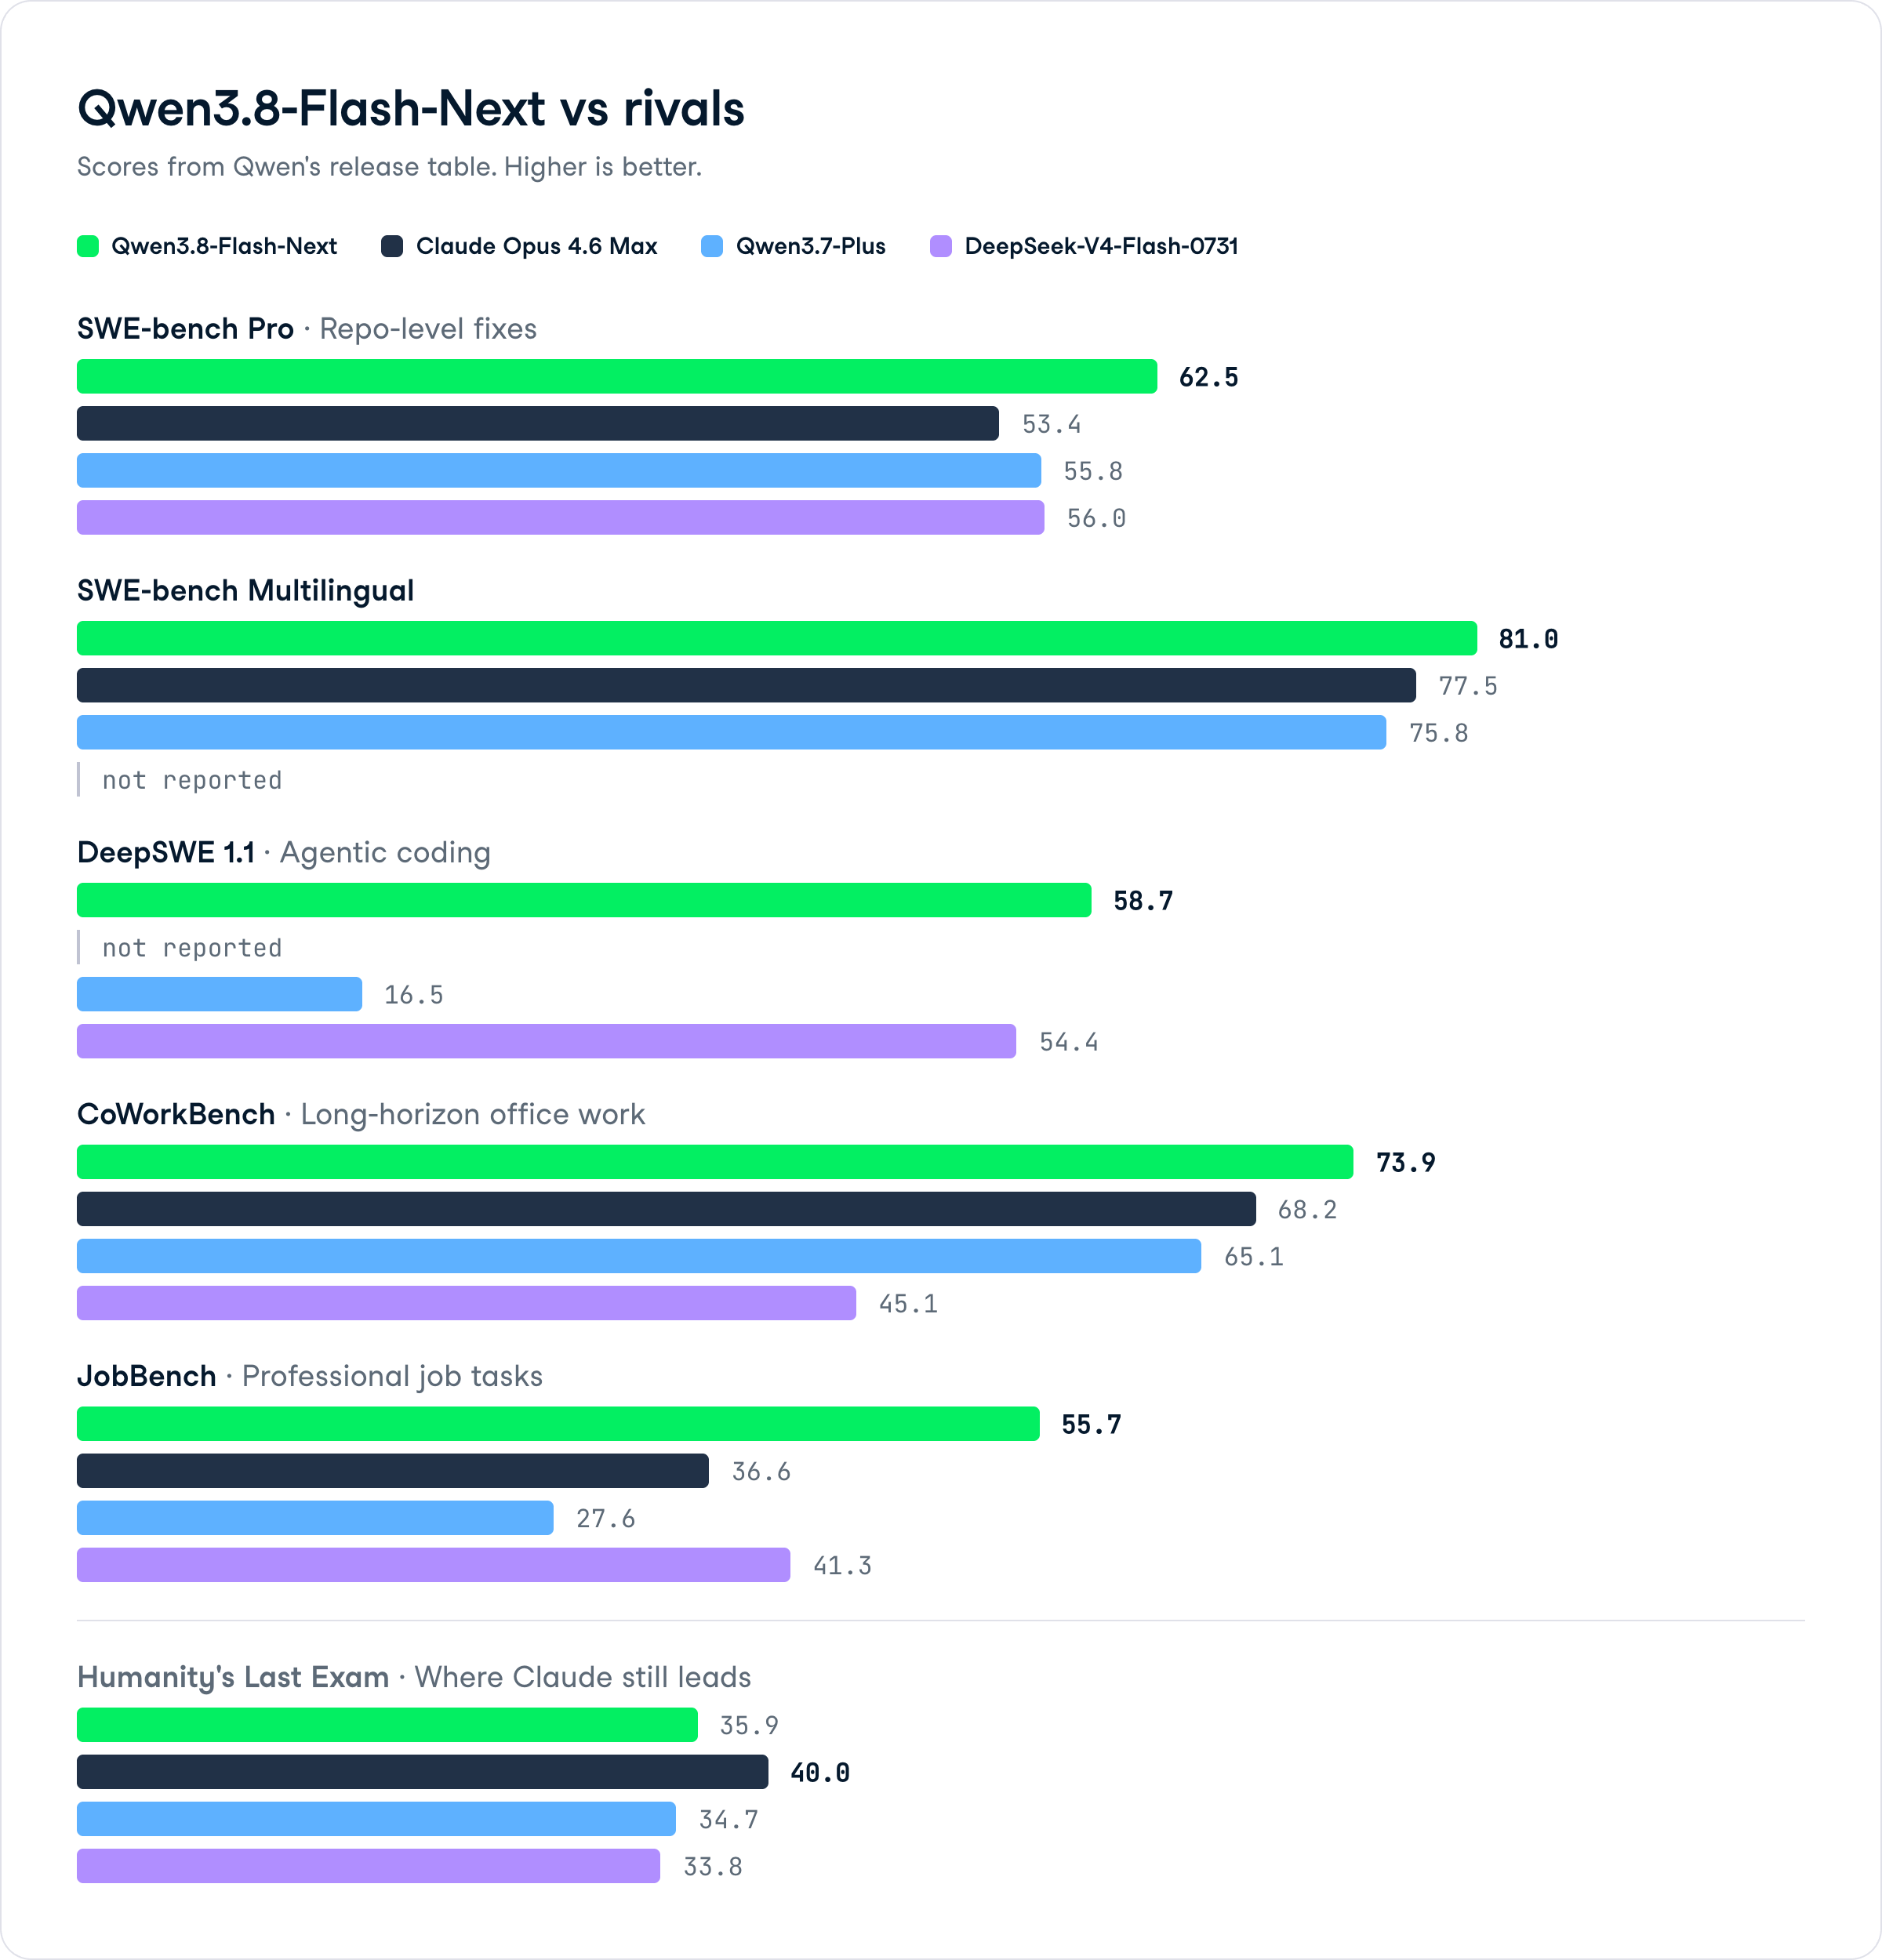
SWE-bench Pro, gerçek depo düzeyi yazılım düzeltmelerini ölçer ve Qwen3.8-Flash-Next 62.5 puan alır; bu, Claude Opus 4.6 Max'in 53.4'ünün ve Qwen3.7-Plus'ın 55.8'inin önündedir.
Diller arası düzeltmeleri test eden SWE-bench Multilingual'de, Opus 4.6 Max'in 77.5'ine karşı 81.0'a ulaşır.
Bu sayılar, sürümün ağırlığını taşıyor.
6B aktif bir modelin depo düzeyi mühendislikte Max sınıfı bir Claude'u geçebilmesi, bu kadar ilgi görmesinin başlıca nedenidir.
DeepSWE 1.1, Claude Code ve mini-SWE-agent gibi yapılar üzerinden ajan temelli kodlamayı değerlendirir; Qwen3.8-Flash-Next burada 27B kardeşinin 42.2'sine ve Qwen3.7-Plus'ın 16.5'ine karşı 58.7 puan alır.
DeepSeek-V4-Flash-0731 bu alanda 54.4'tedir.
Eğitimimizde DeepSeek-V4-Flash-0731'i bir kodlama ajanı olarak çalıştırdığımızda, tek bir istemden yaklaşık 20 dakikada tam bir hisse senedi analiz sitesi oluşturdu ve sohbeti saniyede yaklaşık 33 token hızında üretti.
İki model arasındaki DeepSWE farkı, Qwen3.8-Flash-Next'in benzer ajan temelli kodlama döngülerinde iyi dayanacağını gösteriyor.
Ajan tarafında, model çeşitli değerlendirmelerde güçlü sayılar sunuyor:
JobBench farkı öne çıkıyor.
Profesyonel iş akışı görevlerinde, Qwen3.8-Flash-Next, Max sınıfı bir Claude'un neredeyse 20 puan üzerine çıkıyor; bu da kurumsal otomasyon için denemeye değer kılan türden bir sonuç.
Genel akıl yürütmede, Qwen3.8-Flash-Next GPQA Diamond'da (bilimsel akıl yürütme) 91.7'ye ulaşır; bu, Claude Opus 4.6 Max'in 91.3'ünün biraz önündedir ve LiveCodeBench v6'da (rekabetçi kodlama) Opus 4.6 Max'in 88.8'ine karşı 91.9 alır.
Yine de her yerde kazanmaz.
Multidisipliner akıl yürütmeyi test eden Humanity's Last Exam'de (HLE) 35.9 alırken, Claude Opus 4.6 Max 40.0 alır. Agents' Last Exam Pass@1'de ise DeepSeek-V4-Flash-0731, 24.3'e karşı 25.2 ile az farkla öndedir.
Bağımsız takipçilerde de desen aynı: Qwen3.8-Flash-Next, pratik kodlama ve ajan işlerinde öndeyken, Claude bazı sınav tarzı akıl yürütme kıyaslarında üstünlüğünü korur.
Qwen3.8-Flash-Next-Base, Qwen3.8-27B ve çok daha büyük Qwen3.7-Plus'ın temel modellerine karşı 14 ön eğitim kıyaslamasının 8'ini kazanır.
MMLU-Pro (73.23), SuperGPQA (51.36), BBH (90.87), GSM8K (93.29), EvalPlus (78.76), SWEBench-Pretrain (50.99), MGSM (89.33) ve MMMLU'da (84.86) öndedir.
Dikkat çekici olan, bunu Qwen3.7-Plus'ın 17B aktif ve toplam 397B parametresine karşı 6B etkinleştirilmiş parametreyle yapması ve MMLU, MMLU-Redux, GPQA, MATH ve MultiPL-E'de ondan bir puan içinde kalmasıdır.
51B N-gram gömme parametreleri deterministik olarak adreslenir ve asla token başına matmul bütçesine girmez; dolayısıyla bu, parametre sayısı hilesi değil gerçek verimliliktir.
Model, manşet değerlendirmelerde Claude Opus 4.6 Max'e, selefi Qwen3.7-Plus'a ve DeepSeek-V4-Flash-0731'e karşı şu şekilde konumlanıyor.
| Kıyaslama | Qwen3.8-Flash-Next | Claude Opus 4.6 Max | Qwen3.7-Plus | DeepSeek-V4-Flash-0731 |
|---|---|---|---|---|
| SWE-bench Pro | 62.5 | 53.4 | 55.8 | 56.0 |
| SWE-bench Multilingual | 81.0 | 77.5 | 75.8 | -- |
| DeepSWE 1.1 | 58.7 | -- | 16.5 | 54.4 |
| CoWorkBench | 73.9 | 68.2 | 65.1 | 45.1 |
| JobBench | 55.7 | 36.6 | 27.6 | 41.3 |
| GPQA Diamond | 91.7 | 91.3 | 90.3 | 90.8 |
| LiveCodeBench v6 | 91.9 | 88.8 | 89.6 | 90.6 |
| HLE | 35.9 | 40.0 | 34.7 | 33.8 |
Qwen3.8-Flash-Next ağırlıkları, Hugging Face ve ModelScope üzerinde açık ağırlıklı bir model olarak şimdi mevcut.
Üretim sürümü, varsayılan olarak 1M bağlam ve yerleşik araçlarla, QwenCloud'da qwen3.8-flash model kimliği altında Qwen3.8-Flash olarak sunulur.
Fiyatlandırma, bu modelin en iddialı rekabet ettiği alandır:
Karşılaştırma için, Qwen3.8-Max kapsamımız bu modeli milyon başına girişte $2.00 ve çıkışta $6.00 olarak listeler; dolayısıyla Flash-Next, girişte kendi Max kardeşini 10 kattan fazla farkla alt eder.
QwenCloud, OpenAI uyumlu Chat Completions ve Responses API'lerini ve ayrıca Anthropic uyumlu bir arayüzü destekler; bu sayede Claude Code, Codex ve Qwen Code'a minimum konfigürasyon değişikliğiyle entegre olur.
Duyuru sırasında API'nin yakında geleceği belirtilmişti; bu nedenle canlı durum için QwenCloud'u kontrol edin.
Aynı gün çıkan diğer bütçe modeli GLM-5.3-Flash, yan yana koymaya en çok değen doğrudan rakiptir.
| Qwen3.8-Flash-Next | GLM-5.3-Flash | |
|---|---|---|
| Mimari | Toplam 125B / 6B aktif | Toplam 320B / 18B aktif |
| Yerel bağlam | 262K (YaRN ile 1M) | 1M token |
| DeepSWE v1.1 | 58.7 | 63.4 |
| SWE-bench Pro | 62.5 | Yayımlanmadı |
| Girdi fiyatı | $0.16/1M | ~$0.075/1M (promosyon) |
| Çok modlu | Evet | Evet |
GLM-5.3-Flash, DeepSWE v1.1'de öndedir (63.4'e karşı 58.7) ve Qwen'in rakam yayımlamadığı bir kıyas olan Terminal-Bench 2.1'de 84.3 puan alır.
Ayrıca promosyon döneminde daha düşük bir girdi fiyatına ve YaRN gerektirmeden yerel olarak 1M tokenlık bağlam penceresine sahiptir.
Qwen3.8-Flash-Next, GLM'nin eşdeğer sayı yayımlamadığı SWE-bench Pro'da (62.5), CoWorkBench'te (73.9) ve JobBench'te (55.7) öndedir. Qwen ayrıca token başına çok daha az parametre etkinleştirir (6B'e karşı 18B); bu da onu öz barındırmada belirgin biçimde daha ucuz ve ölçekli sunumda daha hızlı kılar.
Özetle, GLM doğrudan paylaşılan kıyaslarda daha güçlü yayımlanmış sayılara sahip. Qwen ise ofis ve profesyonel iş akışı değerlendirmelerinde önde ve kendi altyapınızı çalıştırıyorsanız daha iyi bir seçimdir. GLM-5.3-Flash'in ayrıntılı dökümü için tam rehberimize bakın.
Qwen3.8-Flash-Next, Alibaba'nın mücadele alanı olarak maliyet-etkinliği net biçimde sahiplendiğini gösteriyor.
6B aktif parametreyle, milyon başına giriş token'ında $0.16 maliyetle, SWE-bench Pro, CoWorkBench ve JobBench'te Claude Opus 4.6 Max'i geçmek; yüksek hacimli kodlama veya ajan iş yüklerini yürüten herkes için ciddi bir tekliftir.
Bunu, iki çekinceyle birlikte, araç odaklı ve kod ağırlıklı hatlar için güçlü bir varsayılan olarak görürdüm.
Topluluk raporları, çok uzun ajan zincirlerinde ara sıra kararsızlık ve araçlar standart dışı JSON döndürdüğünde kırılganlık işaret ediyor; ayrıca model, Claude serisine kıyasla güvenlikte daha az muhafazakârdır; bu nedenle sınırda içeriklerde dikkatli istemleme gerekir.
HLE ve Agents' Last Exam sonuçları da en zorlu sınav tarzı akıl yürütmede başvurulacak model olmadığını gösteriyor.
Qwen4 mimarisine erken bir ön bakış olarak, GDN + QSA hibriti ve N-gram Gömme tasarımları izlemeye değerdir; çünkü tam Qwen4 ailesi bunların üzerine inşa edilecektir.
Alibaba bu dolar başına kıyas oranını amiral gemisi kademesinde koruyabilirse, sınır fiyatlandırması konuşması değişir.
Bu tür modeller etrafında ajan ve kodlama iş akışları kurmak istiyorsanız, temel kavramlara hızla hâkim olmak için AI Agent Fundamentals beceri yolumuzla başlamanızı öneririm.
Öne Çıkan DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.