Program
Makine Öğrenimi Temelleri Python'da
16 sa
Alıştırma and program your progress.
Google Ile Devam EdinSürekli büyüyen veri bilimi alanı veriye dayanır, ancak büyük ve etiketli veri kümeleri elde etmek, model geliştirme sürecinde önemli bir darboğaz olabilir. İşte bu noktada few-shot learning devreye girer; yalnızca birkaç örnekle değerli içgörüler çıkarmamıza olanak tanıyan devrim niteliğinde bir yaklaşım sunar.
Geniş miktarda veri gerektiren geleneksel denetimli öğrenme yöntemlerinin aksine, few-shot learning, modellere hızla öğrenme ve uyum sağlama yetisi kazandırır; bu da verinin az, toplanmasının pahalı veya doğası gereği hassas olduğu alanlarda son derece önemlidir.
Bu makale, few-shot learning'i kapsamlı bir şekilde ele alarak önemini, nasıl çalıştığını ve farklı sektörlerdeki çeşitli uygulamalarını inceler.
Few-shot learning (FSL), modellerin çok az sayıda eğitim örneğine dayanarak kalıpları tanımayı ve tahminlerde bulunmayı öğrendiği bir makine öğrenimi alt alanıdır. Bu, etkili eğitim için genellikle çok miktarda etiketli veri gerektiren geleneksel denetimli öğrenmenin karşıtıdır.
FSL, ezberlemekten ziyade genelleştirmeye vurgu yapar. En erken çalışmalardan biri, kapsamlı ince ayar ihtiyacını sorgulayan “Language Models are Few Shot Learners” (Tom B. Brown ve diğ.) başlıklı makaledir.
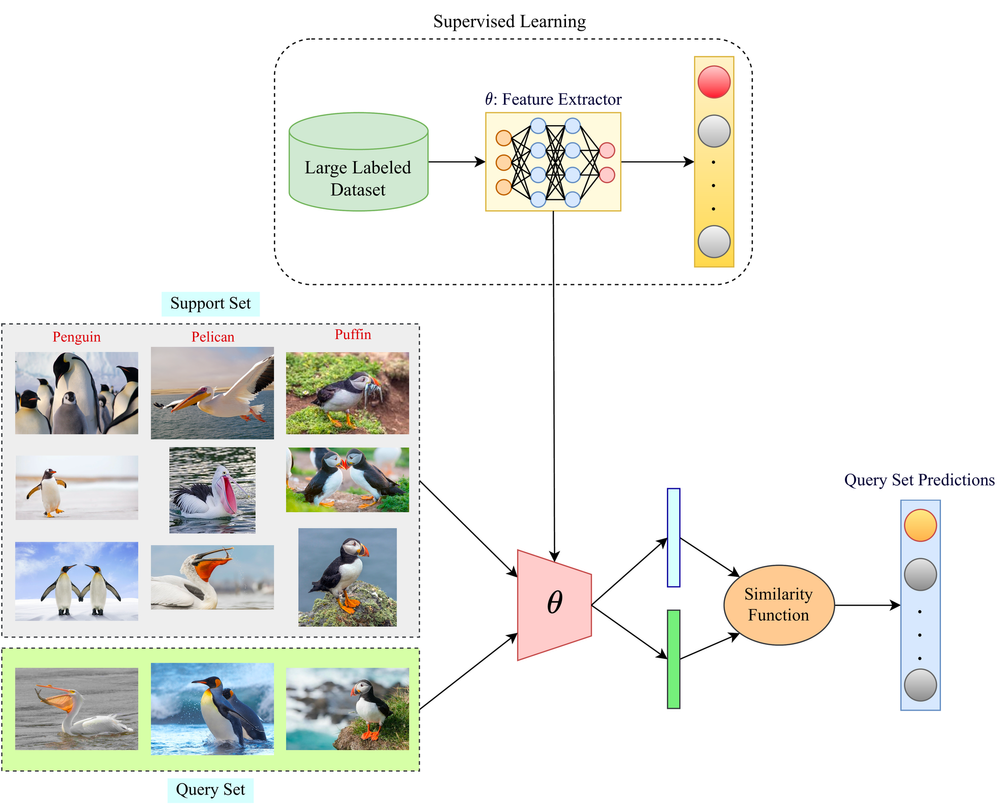
Denetimli öğrenme ile few-shot learning yaklaşımları arasındaki farkı gösteren bir diyagram. Denetimli öğrenme bölümünde, bir özellik çıkarıcı modeli eğitmek için büyük bir etiketli veri kümesinin kullanımı gösterilirken; few-shot learning bölümünde, tahmin yapmak için küçük bir destek örnekleri kümesi ile benzerlik fonksiyonunun sorgu kümesine uygulanması gösterilmiştir. Kaynak: Paperspace
Farklı hayvanları tanımayı öğrenen bir çocuğu düşünün. Köpek, kedi ve kuşlardan yalnızca birkaç örnekle, gelecekte bu canlıları hızla ayırt edebilir; hatta daha önce görmediği ırk veya türlerle karşılaşsa bile.
Sınırlı veriden genelleme yapabilme, insan zekâsının ayırt edici bir niteliğidir ve few-shot learning'in hedeflediği şey tam olarak budur.
Kilit nokta, bir kategoriyi tanımlayan temel yapı ve özellikleri ayırt edebilme yetisidir.
İnsanlar, sınırlı deneyimlerden öz bilgiyi çıkarıp bunu yeni durumlara uygulama becerisine sahiptir. Few-shot learning modelleri, geçmiş deneyimlerden verinin temel yapısına dair genel bir anlayış öğrenerek bunu taklit etmeye çalışır.
Bu bilgi, tıpkı bir çocuğun mevcut köpek bilgisine dayanarak yeni bir köpek ırkını tanıması gibi, en az ek bilgiyle yeni görevlere hızla uyum sağlamak için kullanılır.
FSL, geliştiricinin veri toplamadan ziyade model geliştirmeye odaklanmasına yardımcı olur. Sınırlı veriden öğrenebilme şu avantajları sunar:
Few-shot learning, sağlanan örnek sayısına dayalı çeşitli teknikleri kapsayan daha geniş bir n-shot learning şemsiyesi altına girer:
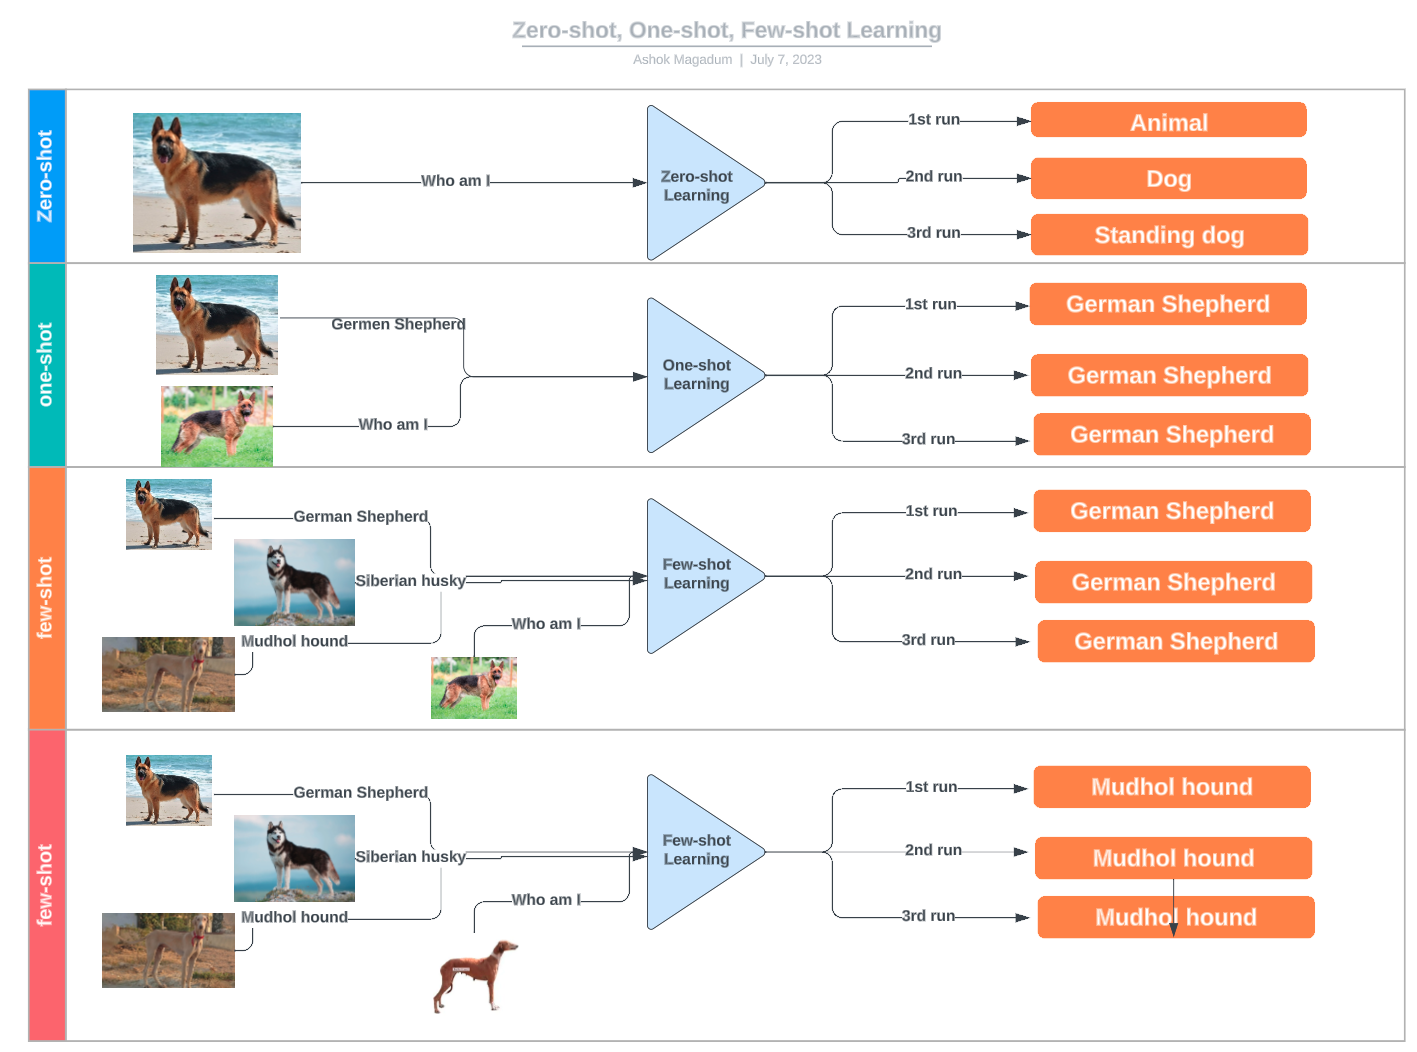
Zero-shot, one-shot ve few-shot learning arasındaki farkları, köpek ırkı sınıflandırma örnekleri üzerinden gösteren bir diyagram. Kaynak: LinkedIn
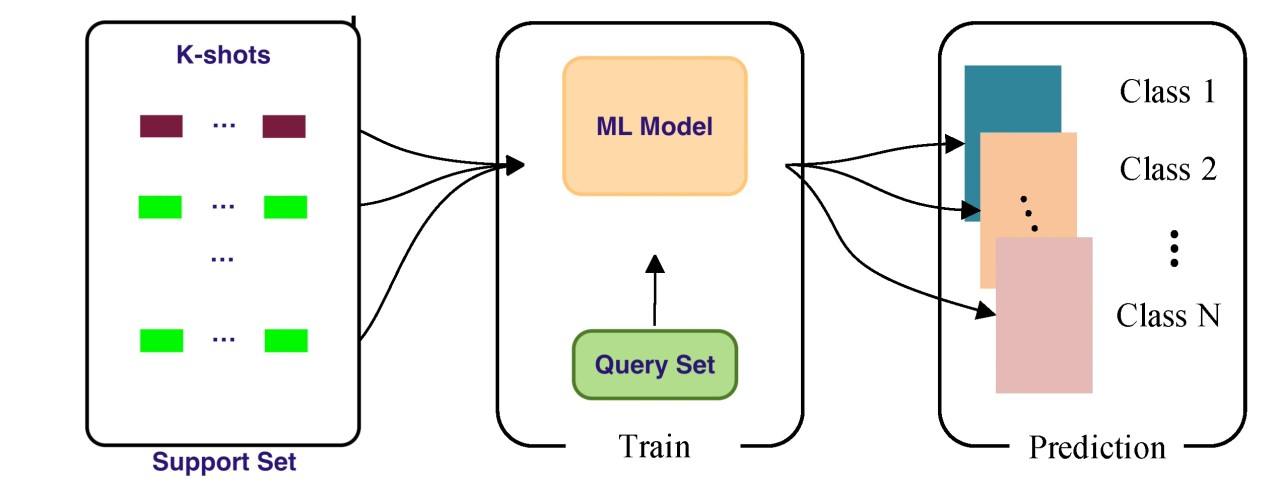
Few-shot learning sürecini gösteren bir diyagram. Birden çok sınıf için k-shot örnekler içeren bir destek kümesi, sorgu kümesi üzerinde eğitilen bir makine öğrenimi modeli ve modelin farklı sınıflardaki yeni veri örnekleri için tahminlerde bulunması gösterilmektedir. Kaynak: LinkedIn
Geniş eğitim veri kümelerine dayanan geleneksel denetimli öğrenmeden farklı olarak, few-shot learning modelleri önceden edinilmiş bilgi ve öğrenme deneyimlerinden yararlanarak çok az ek veriyle yeni görevlere hızla uyum sağlar. Bir kavramı tanımlayan temel yapı ve belirgin özellikleri ayırt ederek, yalnızca birkaç örnekle yeni örnekler üzerinde doğru tahminler yapacak şekilde etkili biçimde genelleme yapabilirler.
Bu bilgi daha sonra, sorgu ve destek kümelerindeki sınıfları en az ek bilgiyle eşleyebilen bir benzerlik fonksiyonu aracılığıyla yeni görevlere hızla uyarlanmak için uygulanır.
Bağlam açısından, burada sorgu kümesi, modelin genelleme yaptığı ve performansı değerlendirmek için kullandığı eski ve yeni kategorilere ait örnekleri ifade eder. Buna karşılık, destek kümesi, her bir yeni veri kategorisinden modelin parametrelerini güncellemek için kullanılan az sayıdaki etiketli örnekten oluşur:
MAML, yalnızca birkaç gradyan adımıyla belirli görevlere ince ayar yapılabilen genel bir model başlangıcı öğrenir. Bu, modellere dikkat çekici bir verimle yeni görevlere uyum sağlama yetisi kazandıran, çok yönlü ve güçlü bir meta-öğrenme yaklaşımıdır.
Gücü, yeni bir görevde yalnızca birkaç gradyan inişi adımıyla hızlı öğrenmeyi kolaylaştıran bir model başlangıcını öğrenme becerisinde yatar.
Bu özellik, modeli "ince ayar yapması kolay" hâle getirir ve az veriyle yeni görevlerin inceliklerini hızla kavramasını sağlar.
MAML, göreve yönelik değişimlere son derece duyarlı bir başlangıç parametreler kümesi θ öğrenme ilkesine dayanır. Bu duyarlılık, parametrelerdeki küçük ayarlamaların, o kaybın gradyanı doğrultusunda güncellendiğinde, görev dağılımı p(T)'den çekilen herhangi bir görevin kayıp fonksiyonunu önemli ölçüde iyileştirmesini sağlar.
MAML algoritmasının adımları şöyledir:
Metrik öğrenme, veri noktaları arasındaki benzerliği ölçen bir mesafe fonksiyonunun öğrenilmesine odaklanır. x ve x' veri noktaları arasındaki benzerliği ölçen d(x, x') olarak gösterilen bir mesafe fonksiyonunun öğrenilmesine odaklanır. Bu sayede modeller, yeni veri noktalarını az sayıda bilinen örnekle karşılaştırarak sınıflandırabilir.
Transfer öğrenme, kaynak bir görevden kazanılan bilgiyi ilişkili bir hedef görev üzerindeki performansı iyileştirmek için kullanır.
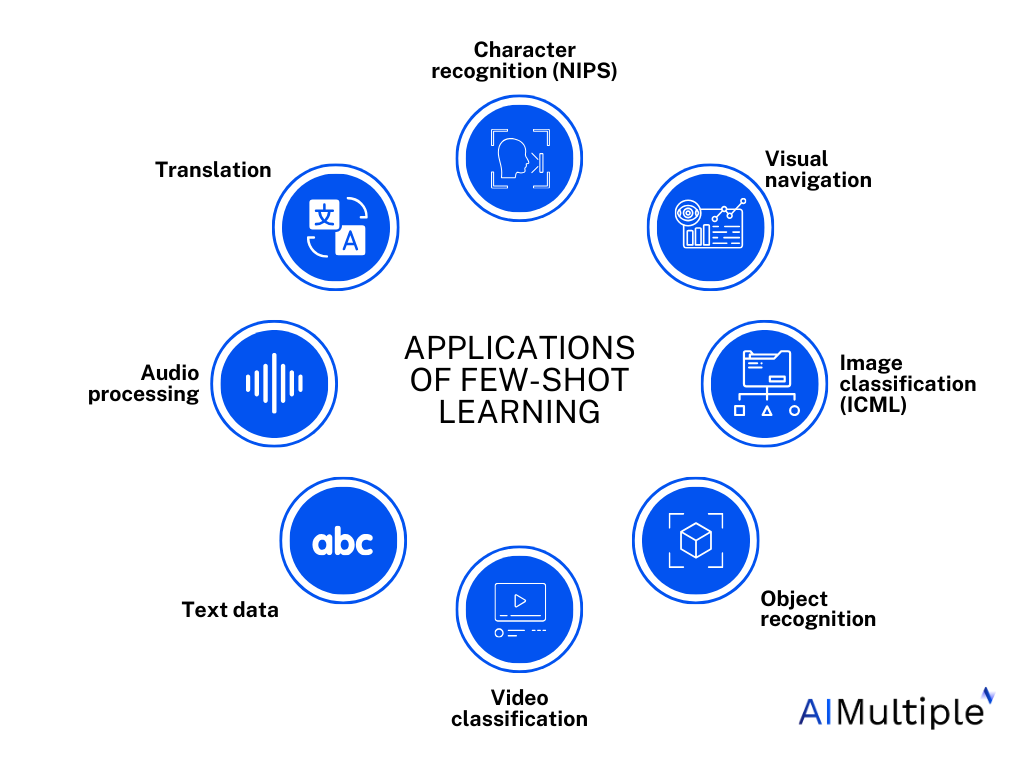
FSL'in çeşitli alanlardaki uygulamalarının özeti. Kaynak: AI Multiple Research
Few-shot learning'in uygulama alanları son derece geniştir; bilgisayarla görme, doğal dil işleme, robotik ve sağlık gibi farklı alanlara uzanır. Örneğin bilgisayarla görme alanında, few-shot learning, yalnızca birkaç eğitim örneğiyle nadir nesneleri tanımayı veya tıbbi görüntülerdeki belirsiz kalıpları belirlemeyi mümkün kılabilir.
Doğal dil işlemede ise few-shot learning, bir bireyin kendine özgü yazı stilini veya lehçesini taklit edebilen kişiselleştirilmiş dil modellerinin önünü açarak içerik üretimi ve iletişimi dönüştürebilir. Ayrıca, düşük kaynaklı dillerin korunması ve çevrilmesi için büyük potansiyel taşır; bu da daha fazla kültürel anlayış ve kapsayıcılık sağlar.
Belki de en dönüştürücü uygulamalardan biri ilaç keşfi ve sağlık alanındadır. Klinik deneylerden veya nadir hastalık vakalarından elde edilen sınırlı verilerle modelleri eğiterek, few-shot learning hayat kurtaran tedavilerin geliştirilmesini hızlandırabilir ve daha doğru teşhisi mümkün kılarak hasta sonuçlarını iyileştirebilir.
Muazzam potansiyeline rağmen, few-shot learning bazı zorluklardan azade değildir. Başlıca engellerden biri, modellerin sınırlı eğitim verisine aşırı uyum sağlayıp yeni örneklere etkili şekilde genelleme yapamaması olan aşırı öğrenme riskidir. Ayrıca, doğru performans için uygun benzerlik ölçütünün veya mesafe fonksiyonunun seçilmesi kritik öneme sahiptir ve görev belirsizliği ya da gürültülü veriler model etkinliğini daha da engelleyebilir.
Ancak bu zorluklar, alanda araştırma ve yenilik patlamasını tetiklemiştir. Meta-öğrenme, metrik öğrenme ve transfer öğrenme gibi yaklaşımlar, few-shot learning yeteneklerini geliştirmek için umut verici stratejiler olarak ortaya çıkmıştır. Model-Agnostik Meta-Öğrenme (MAML) ve Prototipik Ağlar gibi teknikler, az veriyle yeni görevlere hızla uyum sağlamada dikkate değer başarılar sergilemiştir.
Alan gelişmeye devam ettikçe, sınırlı verilerle mümkün olanın sınırlarını zorlayan daha da sofistike ve dayanıklı few-shot learning yöntemlerinin ortaya çıkmasını bekleyebiliriz. Nihayetinde few-shot learning'in gerçek gücü, veriye erişimin kısıtlı olduğu alan ve uygulamalara yapay zekâyı demokratikleştirerek ulaştırmasında; veri-verimli, uyarlanabilir ve kapsayıcı bir yapay zekâ çağının kapılarını aralamasında yatar.
Few-shot learning, sınırlı veriden içgörü çıkarmamızı sağlayarak makine öğrenimi alanında önemli bir ilerlemeyi temsil eder. Farklı yaklaşımları ve uygulamaları anlayan yeni veri profesyonelleri, bu güçlü aracı çeşitli alanlardaki gerçek dünya problemlerini ele almak için kullanabilir.
Araştırmalar sürdükçe, veri biliminin sınırlarını daha da zorlayacak, daha yenilikçi ve verimli few-shot learning tekniklerinin ortaya çıkmasını bekleyebiliriz.
Diğer makine öğrenimi kavramlarında ustalaşmak istiyorsanız, Python ile Makine Öğrenimi Bilimcisi kariyer yolumuzu inceleyin.
DataCamp ile Öğrenmeye Devam Edin
Program
Kurs
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



