Cursus
Principes fondamentaux de l'apprentissage automatique en Python
16 h
Le champ en pleine expansion de la data science repose sur les données, mais l’obtention de grands jeux de données étiquetés peut devenir un véritable goulot d’étranglement dans le développement de modèles. C’est là que le few-shot learning entre en jeu, avec une approche révolutionnaire qui permet d’extraire des informations utiles à partir de quelques exemples seulement.
Contrairement aux méthodes supervisées classiques qui exigent d’importants volumes de données, le few-shot learning permet aux modèles d’apprendre et de s’adapter rapidement. Il est donc particulièrement pertinent dans les domaines où les données sont rares, coûteuses à collecter ou sensibles par nature.
Cet article propose une exploration complète du few-shot learning : importance, principes de fonctionnement et applications variées dans de nombreux secteurs.
Le few-shot learning (FSL) est un sous-domaine de l'apprentissage automatique où les modèles apprennent à reconnaître des motifs et à faire des prédictions à partir d’un très petit nombre d’exemples d’entraînement. Il s’oppose ainsi à l’apprentissage supervisé traditionnel, qui requiert souvent de grandes quantités de données étiquetées pour être efficace.
Le FSL met l’accent sur la généralisation plutôt que sur la mémorisation. L’un des travaux fondateurs est l’article « Language Models are Few Shot Learners » de Tom B. Brown et al., qui remet en question la nécessité d’un affinage intensif.
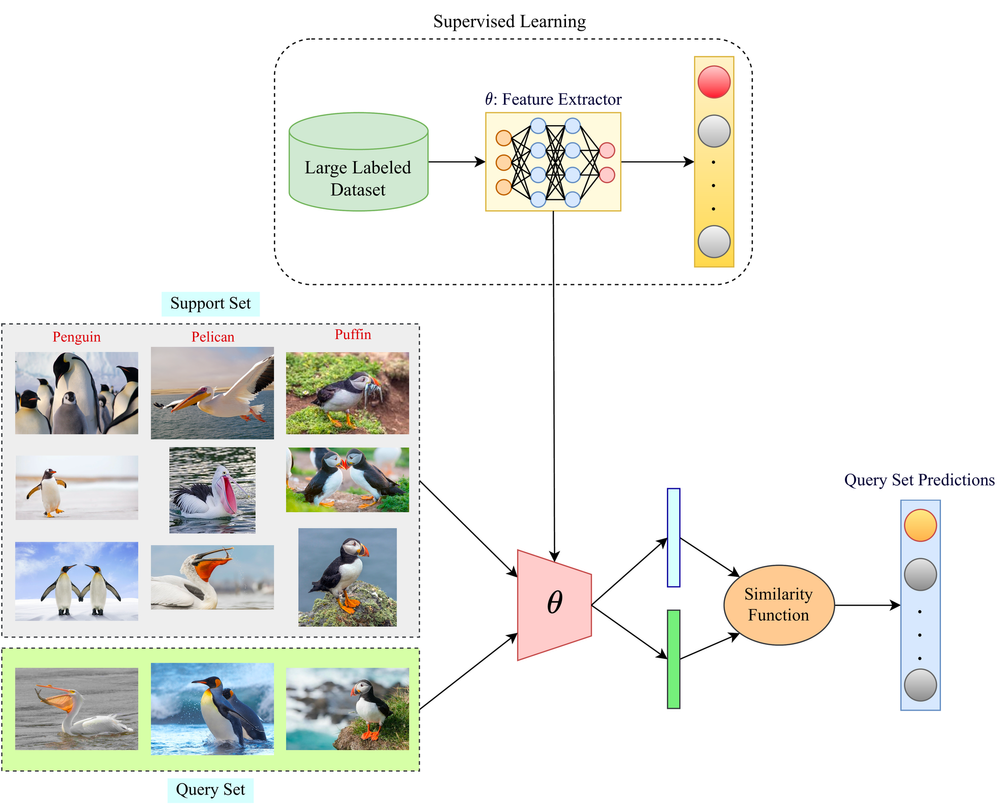
Schéma illustrant la différence entre apprentissage supervisé et few-shot learning. La partie apprentissage supervisé montre un grand jeu de données étiquetées pour entraîner un extracteur de caractéristiques, tandis que la partie few-shot learning montre l’usage d’un petit ensemble de support et d’une fonction de similarité pour prédire sur un ensemble de requête. Source : Paperspace
Pensez à un enfant qui apprend à reconnaître des animaux. Avec quelques exemples de chiens, chats et oiseaux, il peut rapidement identifier et distinguer ces espèces par la suite, même s’il rencontre des races ou espèces qu’il n’a jamais vues.
Cette capacité à généraliser à partir de peu d’informations est une marque de l’intelligence humaine ; c’est précisément ce que vise le few-shot learning.
La clé réside dans l’aptitude à discerner la structure sous-jacente et les traits saillants qui définissent une catégorie.
Les humains savent extraire l’essentiel à partir d’expériences limitées et réutiliser ce savoir dans de nouveaux contextes. Les modèles de few-shot learning tentent de reproduire ce mécanisme en apprenant une compréhension générale de la structure des données à partir d’expériences préalables.
Ces connaissances sont ensuite mobilisées pour s’adapter rapidement à de nouvelles tâches avec un minimum d’informations complémentaires, comme l’enfant qui reconnaît une nouvelle race de chien à partir de ce qu’il sait déjà.
Le FSL permet aux développeurs de se concentrer sur la conception de modèles plutôt que sur l’acquisition de données. Apprendre à partir de peu de données offre plusieurs avantages :
Le few-shot learning s’inscrit dans la famille plus large du n-shot learning, qui regroupe différentes techniques selon le nombre d’exemples fournis :
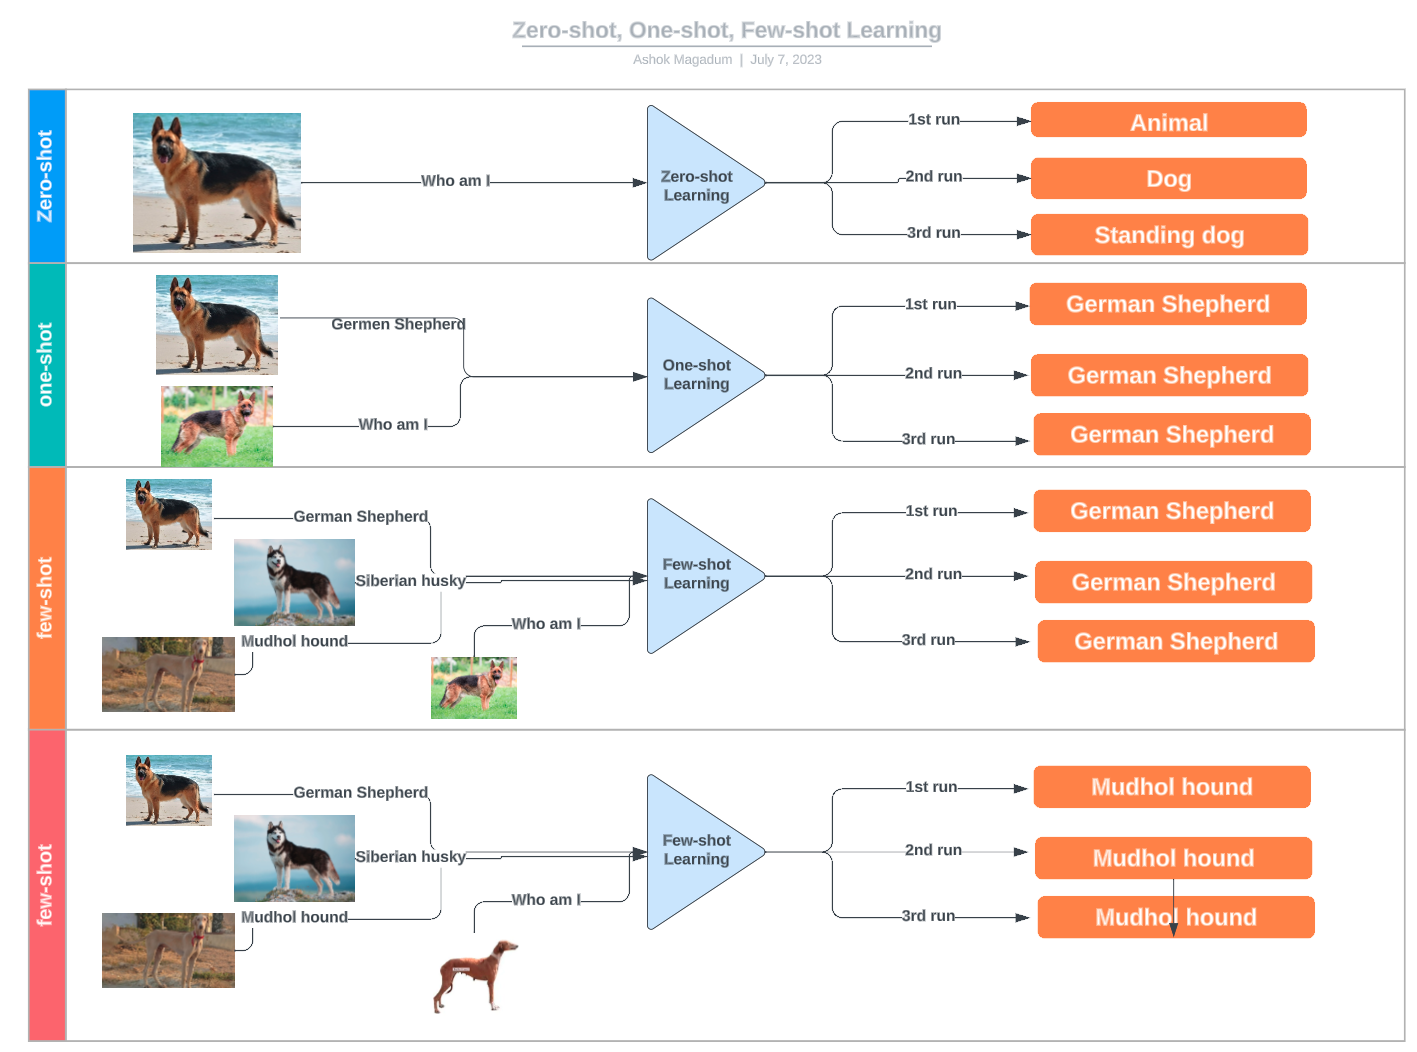
Schéma illustrant les différences entre zero-shot, one-shot et few-shot learning via des exemples de classification de races de chiens. Source : LinkedIn
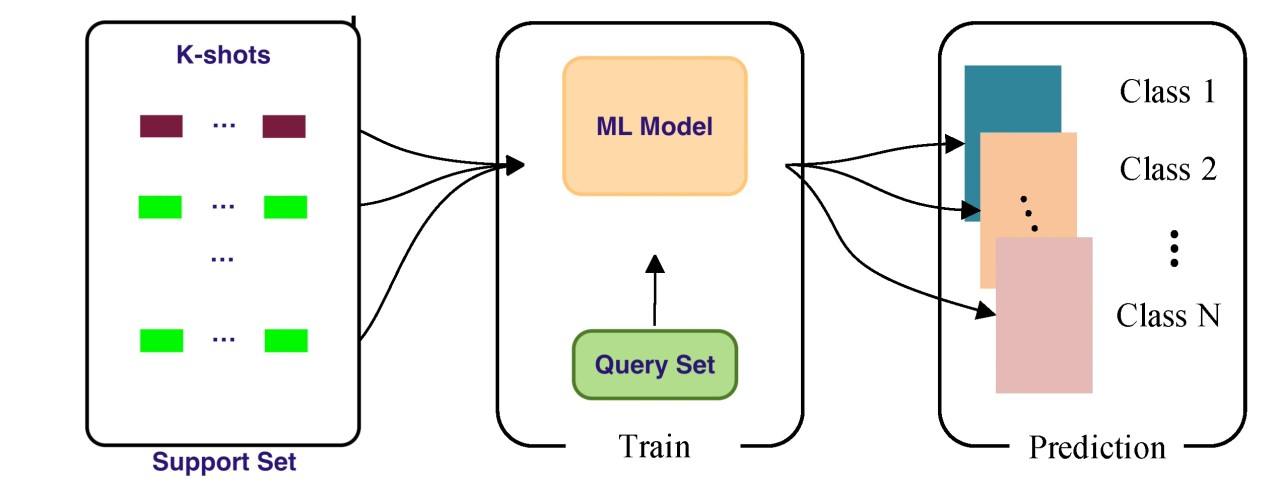
Schéma illustrant le processus de few-shot learning. On y voit un ensemble de support contenant k exemples par classe, un modèle d’apprentissage automatique entraîné sur un ensemble de requête, puis le modèle qui réalise des prédictions pour de nouvelles données. Source : LinkedIn
Contrairement à l’apprentissage supervisé traditionnel, qui s’appuie sur de grands jeux de données d’entraînement, les modèles de few-shot learning exploitent des connaissances et expériences préalables pour s’adapter rapidement à de nouvelles tâches avec un minimum de données supplémentaires. En décelant la structure sous-jacente et les caractéristiques saillantes d’un concept, ces modèles généralisent efficacement et produisent des prédictions justes sur des cas inédits avec quelques exemples seulement.
Ces connaissances sont ensuite appliquées pour s’adapter rapidement à de nouvelles tâches via une fonction de similarité capable d’apparier les classes des ensembles de requête et de support avec très peu d’informations additionnelles.
Pour situer, l’ensemble de requête désigne ici les échantillons issus à la fois d’anciennes et de nouvelles catégories, sur lesquels le modèle généralise et évalue ses performances. À l’inverse, l’ensemble de support regroupe les quelques échantillons étiquetés de chaque nouvelle catégorie, utilisés pour mettre à jour les paramètres du modèle :
MAML apprend une initialisation générale du modèle qui peut être affinée pour des tâches spécifiques en quelques pas de gradient seulement. C’est une approche de méta-apprentissage puissante et polyvalente, qui permet aux modèles de s’adapter à de nouvelles tâches avec une efficacité remarquable.
Sa force réside dans la capacité à apprendre une initialisation qui facilite un apprentissage rapide via quelques itérations de descente de gradient sur une nouvelle tâche.
Ce caractère rend le modèle « facile à affiner », lui permettant de saisir rapidement les spécificités de tâches nouvelles avec très peu de données.
MAML repose sur le principe de l’apprentissage d’un jeu de paramètres initiaux θ très sensibles aux changements de tâche. Cette sensibilité garantit que de légères modifications des paramètres peuvent améliorer sensiblement la fonction de coût de toute tâche tirée de la distribution p(T) lorsqu’on met à jour dans la direction de son gradient.
Voici les étapes de l’algorithme MAML :
Le metric learning consiste à apprendre une fonction de distance qui mesure la similarité entre points de données. On apprend ainsi une fonction d(x, x') qui évalue la proximité entre x et x'. Cela permet de classifier de nouveaux points en les comparant à quelques exemples connus.
Le transfer learning réutilise des connaissances acquises sur une tâche source pour améliorer les performances sur une tâche cible apparentée.
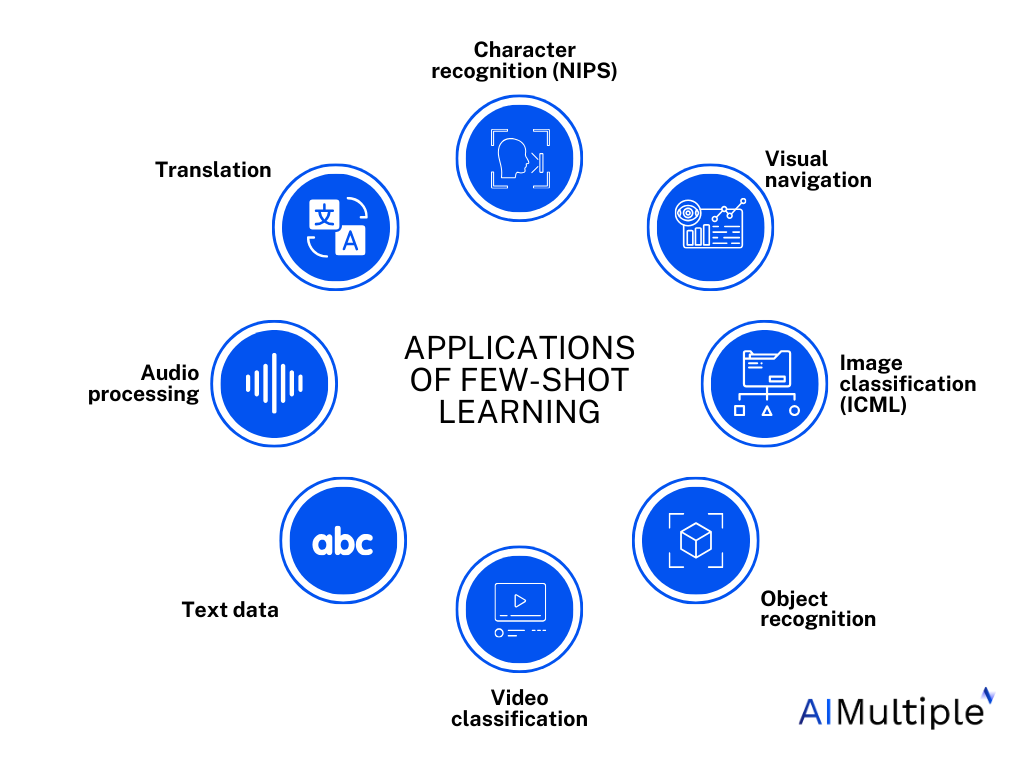
Récapitulatif des applications du FSL dans plusieurs domaines. Source : AI Multiple Research
Les applications du few-shot learning sont vastes et touchent des champs aussi variés que la vision par ordinateur, le traitement du langage naturel, la robotique et la santé. En vision, par exemple, le few-shot learning permet de reconnaître des objets rares ou d’identifier des motifs peu fréquents en imagerie médicale avec une poignée d’exemples.
En traitement du langage naturel, le few-shot learning ouvre la voie à des modèles personnalisés capables d’imiter le style ou le dialecte d’une personne, transformant la création de contenu et la communication. Il offre également un fort potentiel pour la préservation et la traduction de langues peu dotées, favorisant l’inclusion et la compréhension interculturelle.
Peut-être l’un des usages les plus transformants concerne la découverte de médicaments et la santé. En entraînant des modèles sur des données limitées issues d’essais cliniques ou de cas de maladies rares, le few-shot learning pourrait accélérer le développement de traitements vitaux et améliorer la précision des diagnostics, au bénéfice des patients.
Malgré son immense potentiel, le few-shot learning présente des défis. Le principal risque est le surapprentissage : des modèles trop spécialisés sur peu de données généralisent mal à de nouveaux cas. En outre, le choix d’une mesure de similarité ou d’une fonction de distance adaptée est crucial, et l’ambiguïté des tâches ou le bruit dans les données peuvent nuire aux performances.
Ces défis stimulent toutefois la recherche et l’innovation. Des approches comme le méta-apprentissage, le metric learning et le transfer learning s’imposent comme des stratégies prometteuses pour renforcer les capacités du few-shot learning. Des techniques telles que Model-Agnostic Meta-Learning (MAML) et les réseaux prototypiques montrent une grande efficacité pour s’adapter rapidement à de nouvelles tâches avec peu de données.
Au fur et à mesure que le domaine évolue, on peut s’attendre à des méthodes de few-shot learning encore plus sophistiquées et robustes, repoussant les limites de ce qu’il est possible de faire avec des données rares. En fin de compte, la vraie force du few-shot learning est de rendre l’IA plus accessible, y compris dans des domaines longtemps freinés par le manque de données, et d’ouvrir une nouvelle ère d’IA adaptable, sobre en données et inclusive.
Le few-shot learning marque une avancée importante en apprentissage automatique, en permettant d’extraire des insights à partir de peu de données. En comprenant ses approches et applications, les jeunes praticiens des données peuvent exploiter cet outil puissant pour résoudre des problèmes concrets dans des domaines variés.
Avec la poursuite des recherches, on peut s’attendre à des techniques de few-shot learning encore plus innovantes et efficaces, qui pousseront davantage les frontières de la data science.
Si vous souhaitez maîtriser d’autres concepts de machine learning, découvrez notre parcours de carrière Machine Learning Scientist with Python.
Continuez à apprendre avec DataCamp
Cursus
Cours
Cursus
blog
Kurtis Pykes
15 min
blog
Tutoriel
Tutoriel
Josef Waples
8 min
Tutoriel
Matt Crabtree
5 min
Tutoriel
Samuel Shaibu
9 min