Lernpfad
Grundlagen des maschinellen Lernens in Python
16 Std.
Die Datenwissenschaft lebt von Daten, doch große, gelabelte Datensätze zu beschaffen, ist oft der Engpass in der Modellentwicklung. Hier kommt Few-Shot Learning ins Spiel: ein Ansatz, mit dem sich aus nur wenigen Beispielen aussagekräftige Erkenntnisse gewinnen lassen.
Im Gegensatz zu klassischen überwachten Lernverfahren, die enorme Datenmengen verlangen, macht Few-Shot Learning Modelle schnell lern- und anpassungsfähig. Das ist besonders relevant in Bereichen, in denen Daten rar, teuer zu erheben oder sensibel sind.
Dieser Artikel beleuchtet Few-Shot Learning umfassend: seine Bedeutung, die grundlegenden Mechanismen und vielfältige Anwendungen in unterschiedlichen Branchen.
Few-Shot Learning (FSL) ist ein Teilgebiet des Machine Learnings, in dem Modelle anhand sehr weniger Trainingsbeispiele Muster erkennen und Vorhersagen treffen. Das steht im Kontrast zu klassischem Supervised Learning, das in der Regel große Mengen gelabelter Daten für ein wirksames Training benötigt.
FSL setzt auf Generalisierung statt Auswendiglernen. Eine der früh einflussreichen Arbeiten war das Paper „Language Models are Few Shot Learners“ von Tom B. Brown et al., das die Notwendigkeit umfangreichen Fine-Tunings infrage stellt.
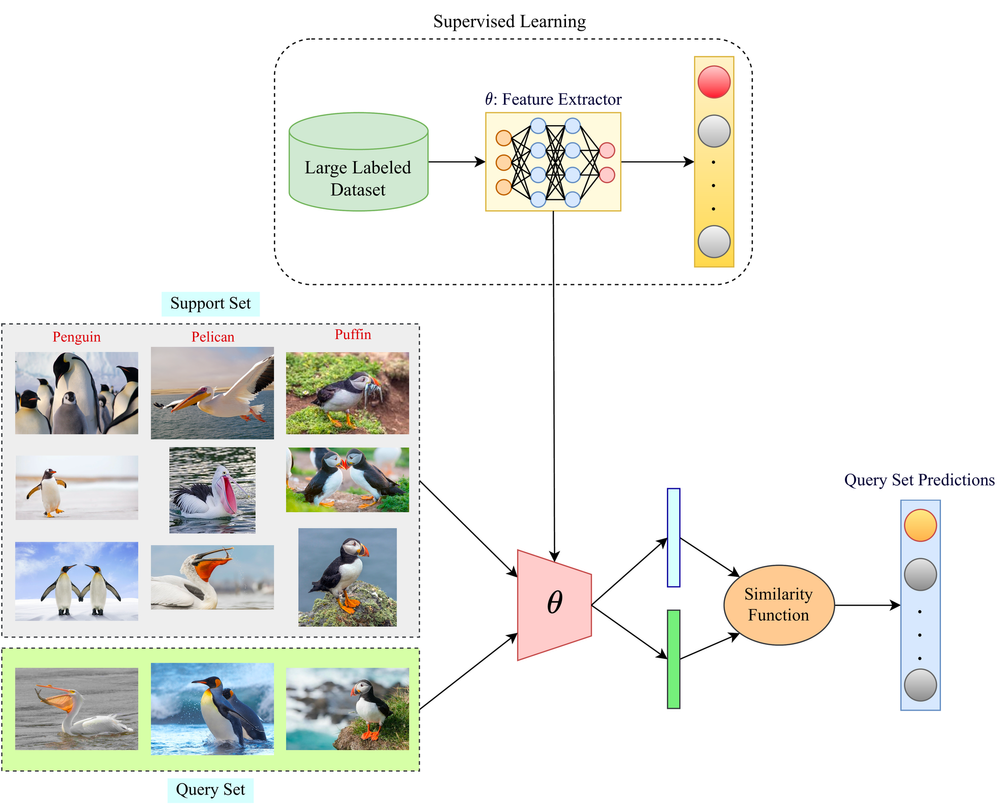
Ein Diagramm, das den Unterschied zwischen überwachtem Lernen und Few-Shot Learning zeigt. Links trainiert ein großer gelabelter Datensatz ein Feature-Extractor-Modell, rechts nutzt Few-Shot Learning ein kleines Support-Set und eine Ähnlichkeitsfunktion, um Vorhersagen für ein Query-Set zu treffen. Quelle: Paperspace
Stell dir vor, ein Kind lernt, verschiedene Tiere zu unterscheiden. Mit nur wenigen Beispielen von Hunden, Katzen und Vögeln kann es diese später schnell wiedererkennen – selbst wenn es Rassen oder Arten sieht, die es zuvor nicht kannte.
Diese Fähigkeit, aus wenigen Daten zu verallgemeinern, ist ein Markenzeichen menschlicher Intelligenz – und genau das will Few-Shot Learning nachbilden.
Entscheidend ist, die zugrunde liegende Struktur und die prägenden Merkmale einer Kategorie zu erkennen.
Menschen können aus begrenzten Erfahrungen das Wesentliche herausziehen und dieses Wissen auf neue Situationen übertragen. Few-Shot-Modelle versuchen dies nachzuahmen, indem sie aus früheren Erfahrungen ein allgemeines Verständnis der zugrunde liegenden Datenstruktur lernen.
Dieses Wissen wird genutzt, um sich mit minimalen Zusatzinformationen schnell an neue Aufgaben anzupassen – so wie das Kind eine neue Hunderasse erkennt, weil es bereits Hunde kennt.
FSL erlaubt es Entwicklerinnen und Entwicklern, sich stärker auf die Modellentwicklung statt auf die Datenbeschaffung zu konzentrieren. Aus wenig Daten zu lernen, bringt mehrere Vorteile:
Few-Shot Learning gehört zur größeren Familie des n-shot Learnings und umfasst verschiedene Techniken je nach Anzahl der Beispiele:
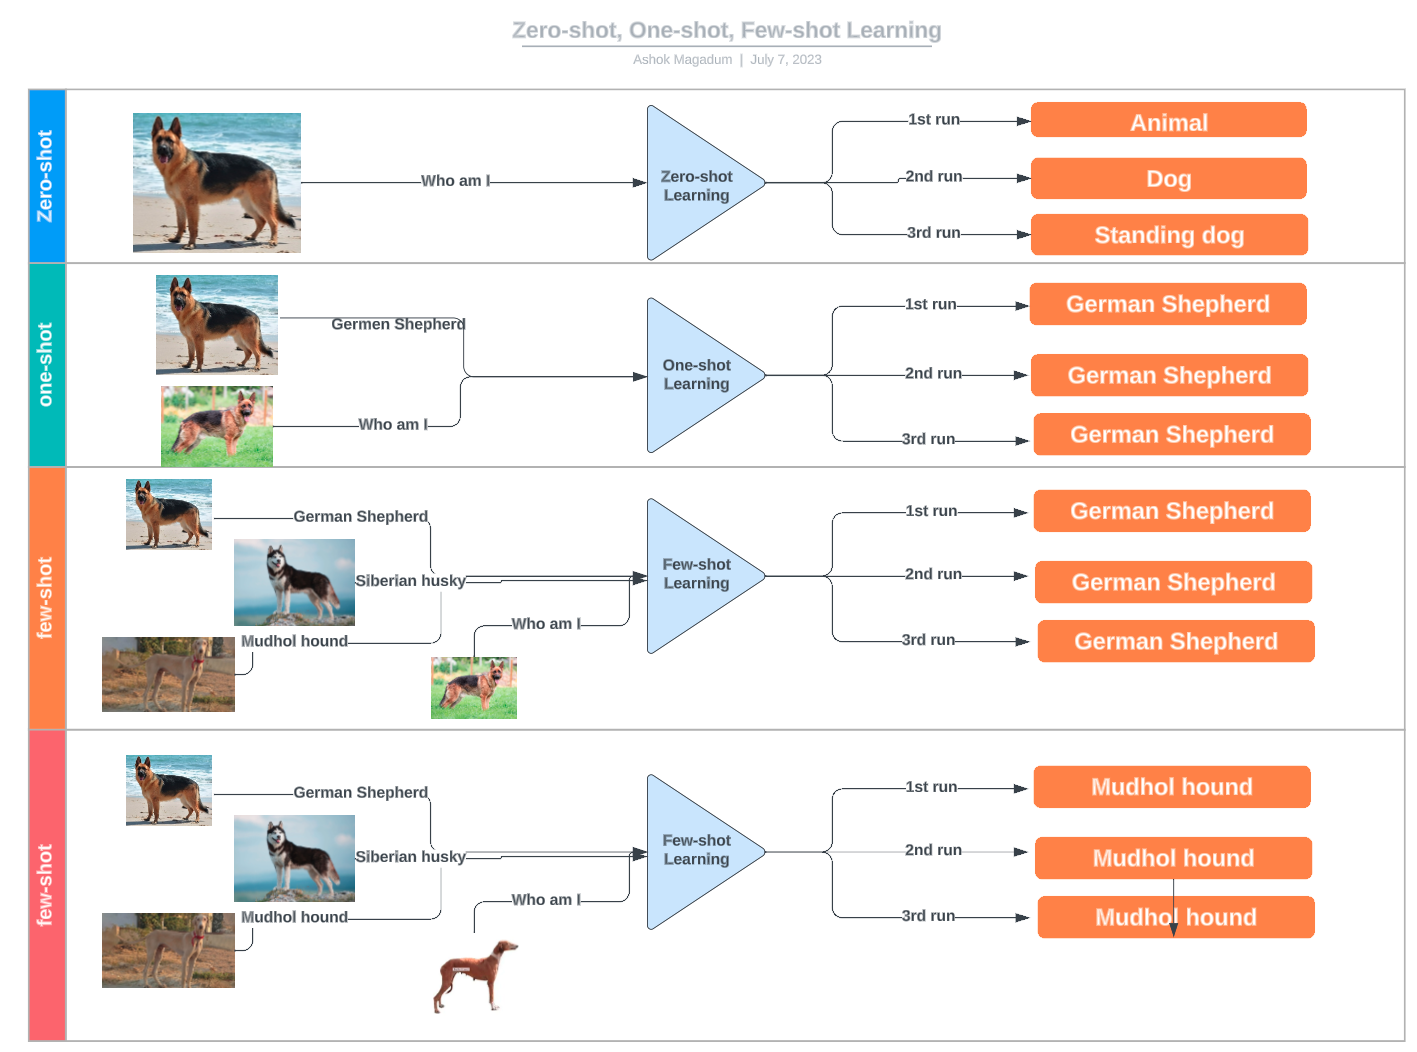
Ein Diagramm, das die Unterschiede zwischen Zero-, One- und Few-Shot Learning anhand der Klassifikation von Hunderassen zeigt. Quelle: LinkedIn
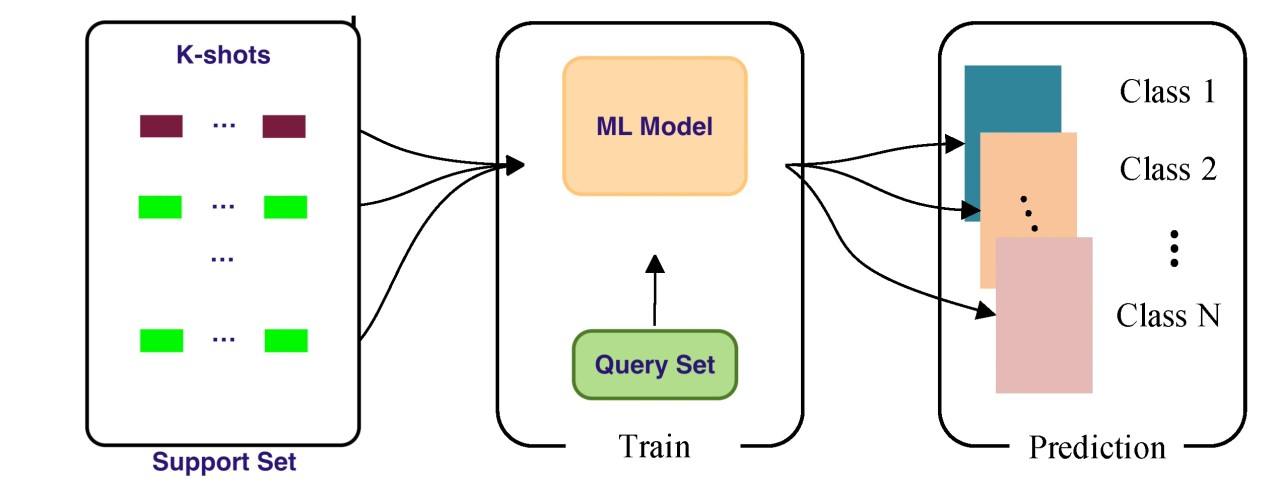
Ein Diagramm, das den Few-Shot-Learning-Prozess zeigt: ein Support-Set mit k-shot Beispielen für mehrere Klassen, ein Machine-Learning-Modell, das auf einem Query-Set trainiert wird, und das anschließend Vorhersagen für neue Dateninstanzen trifft. Quelle: LinkedIn
Anders als klassisches Supervised Learning, das auf umfangreiche Trainingsdatensätze baut, nutzen Few-Shot-Modelle Vorwissen und Vorerfahrungen, um sich mit minimalen Zusatzdaten rasch an neue Aufgaben anzupassen. Indem sie die zugrunde liegende Struktur und die wesentlichen Merkmale eines Konzepts erkennen, können sie effektiv generalisieren und mit nur wenigen Beispielen präzise Vorhersagen für neue Instanzen treffen.
Dieses Wissen wird dann über eine Ähnlichkeitsfunktion angewendet, um die Klassen in Query- und Support-Set mit minimalen Zusatzinformationen aufeinander abzubilden und so schnell auf neue Aufgaben zu adaptieren.
Zur Einordnung: Das Query-Set umfasst hier Stichproben aus alten und neuen Kategorien, auf denen das Modell generalisiert und seine Leistung bewertet. Das Support-Set hingegen besteht aus wenigen gelabelten Beispielen jeder neuen Datenkategorie, mit denen die Modellparameter aktualisiert werden:
MAML lernt eine allgemeine Modellinitialisierung, die sich mit nur wenigen Gradienten-Schritten für spezifische Aufgaben feinabstimmen lässt. Es ist ein vielseitiger, leistungsstarker Meta-Learning-Ansatz, der eine bemerkenswert effiziente Anpassung an neue Aufgaben ermöglicht.
Seine Stärke liegt darin, eine Initialisierung zu lernen, die schnelles Lernen über wenige Gradient-Descent-Schritte auf einer neuen Aufgabe begünstigt.
Damit wird das Modell praktisch „leicht zu fine-tunen“ und kann die Besonderheiten neuer Aufgaben mit minimalen Daten schnell erfassen.
MAML basiert auf dem Prinzip, einen Satz initialer Parameter θ zu lernen, die stark auf Aufgabenänderungen reagieren. Diese Sensitivität sorgt dafür, dass bereits kleine Anpassungen die Loss-Funktion beliebiger Aufgaben aus der Aufgabeverteilung p(T) deutlich verbessern, wenn in Richtung des Gradienten aktualisiert wird.
So funktioniert MAML im Überblick:
Metric Learning zielt darauf ab, eine Distanzfunktion zu lernen, die die Ähnlichkeit zwischen Datenpunkten misst. Gesucht ist eine Funktion d(x, x'), die die Ähnlichkeit der Punkte x und x' bewertet. So können Modelle neue Datenpunkte klassifizieren, indem sie sie mit wenigen bekannten Beispielen vergleichen.
Transfer Learning nutzt Wissen aus einer Quellaufgabe, um die Leistung auf einer verwandten Zielaufgabe zu verbessern.
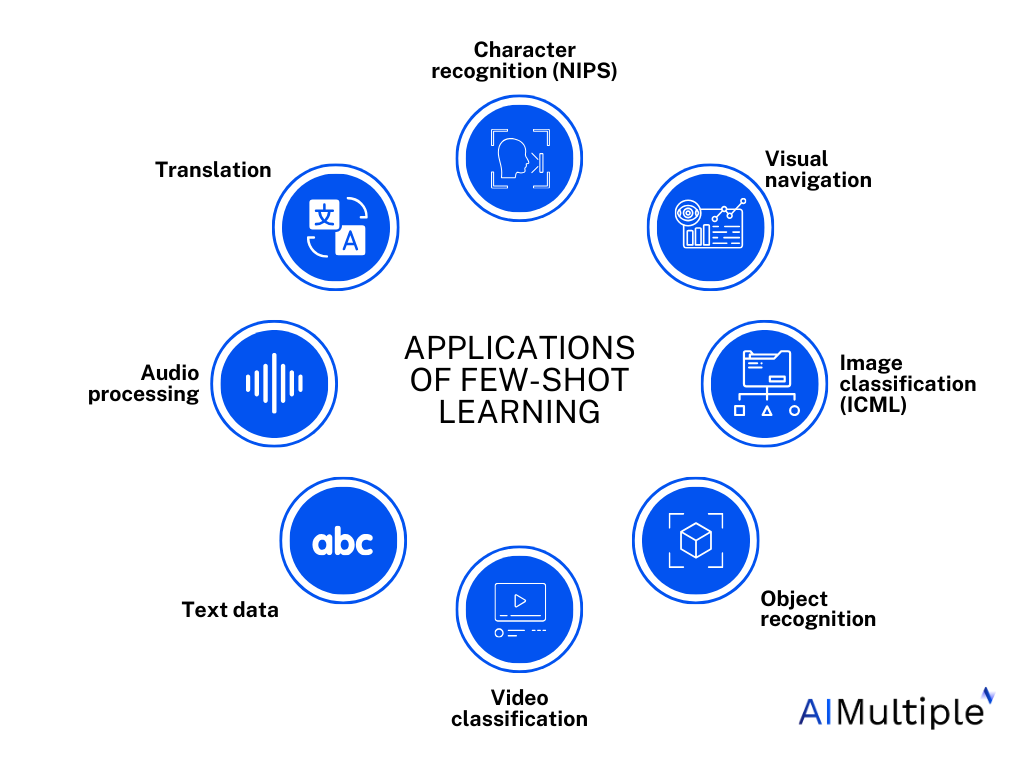
Ein Überblick über Anwendungen von FSL in verschiedenen Domänen. Quelle: AI Multiple Research
Die Einsatzmöglichkeiten von Few-Shot Learning sind breit gefächert – von Computer Vision über natürliche Sprachverarbeitung bis hin zu Robotik und Gesundheitswesen. In der Bildverarbeitung können Systeme etwa seltene Objekte erkennen oder in medizinischen Bildern ungewöhnliche Muster identifizieren – mit nur wenigen Trainingsbeispielen.
In der Sprachverarbeitung ebnet Few-Shot Learning den Weg zu personalisierten Sprachmodellen, die individuellen Schreibstil oder Dialekt nachahmen – ein möglicher Gamechanger für Content-Erstellung und Kommunikation. Zudem birgt es großes Potenzial, ressourcenschwache Sprachen zu bewahren und zu übersetzen und so kulturelles Verständnis und Inklusion zu fördern.
Besonders transformative Anwendungen liegen in der Arzneimittelentwicklung und im Gesundheitswesen. Wenn Modelle auf begrenzten Daten aus klinischen Studien oder seltenen Krankheitsfällen trainiert werden, kann Few-Shot Learning die Entwicklung lebensrettender Therapien beschleunigen und genauere Diagnosen ermöglichen – mit spürbar besseren Patientenergebnissen.
Trotz des großen Potenzials ist Few-Shot Learning nicht frei von Hürden. Eine der größten Herausforderungen ist Overfitting: Modelle spezialisieren sich zu stark auf die wenigen Trainingsdaten und generalisieren dann schlecht. Außerdem ist die Wahl einer passenden Ähnlichkeits- oder Distanzfunktion entscheidend für die Genauigkeit, und Aufgabenunklarheit oder Rauschen in den Daten können die Modellleistung weiter beeinträchtigen.
Diese Herausforderungen befeuern jedoch die Forschung. Ansätze wie Meta-Learning, Metric Learning und Transfer Learning haben sich als vielversprechend erwiesen, um FSL zu stärken. Techniken wie Model-Agnostic Meta-Learning (MAML) und Prototypical Networks zeigen beeindruckende Erfolge bei der schnellen Anpassung an neue Aufgaben mit minimalen Daten.
Mit dem weiteren Fortschritt des Feldes dürfen wir noch ausgefeiltere und robustere Few-Shot-Methoden erwarten, die die Grenzen des Machbaren mit wenig Daten verschieben. Die wahre Stärke von Few-Shot Learning liegt darin, KI zu demokratisieren – und Anwendungen zu erschließen, die bislang an Datenknappheit gescheitert sind. So entsteht eine daten-effiziente, anpassungsfähige und inklusive Künstliche Intelligenz.
Few-Shot Learning ist ein wichtiger Schritt im Machine Learning und ermöglicht es, aus wenigen Daten Erkenntnisse zu gewinnen. Wer die verschiedenen Ansätze und Anwendungen versteht, kann dieses mächtige Werkzeug nutzen, um reale Probleme in vielen Domänen zu lösen.
Mit weiterer Forschung werden noch innovativere und effizientere Few-Shot-Techniken entstehen – und die Grenzen der Datenwissenschaft weiter verschieben.
Wenn du weitere Machine-Learning-Konzepte meistern willst, schau dir unseren Machine Learning Scientist with Python Lernpfad an.
Mit DataCamp weiterlernen
Lernpfad
Kurs
Lernpfad