Lĩnh vực khoa học dữ liệu không ngừng phát triển dựa trên dữ liệu, nhưng việc thu thập các bộ dữ liệu lớn, đã gán nhãn có thể trở thành điểm nghẽn đáng kể trong quá trình phát triển mô hình. Đây là lúc few-shot learning xuất hiện, mang đến một cách tiếp cận mang tính đột phá cho phép chúng ta rút ra hiểu biết giá trị chỉ từ một vài ví dụ.
Trái ngược với các phương pháp học có giám sát truyền thống đòi hỏi lượng dữ liệu khổng lồ, few-shot learning giúp mô hình học và thích ứng nhanh chóng, nhờ đó đặc biệt phù hợp trong những lĩnh vực dữ liệu khan hiếm, tốn kém để thu thập hoặc có tính nhạy cảm.
Bài viết này cung cấp cái nhìn toàn diện về few-shot learning, đi sâu vào tầm quan trọng, cơ chế và các ứng dụng đa dạng của nó trong nhiều ngành.
Few-Shot Learning là gì?
Few-shot learning (FSL) là một nhánh của học máy, trong đó mô hình học cách nhận diện mẫu và đưa ra dự đoán dựa trên số lượng ví dụ huấn luyện rất nhỏ. Điều này trái ngược với học có giám sát truyền thống, vốn thường yêu cầu lượng dữ liệu đã gán nhãn rất lớn để huấn luyện hiệu quả.
FSL nhấn mạnh khả năng khái quát hóa thay vì ghi nhớ. Một trong những công trình sớm nhất là bài báo “Language Models are Few Shot Learners” của Tom B. Brown và cộng sự, đặt dấu hỏi về nhu cầu tinh chỉnh rộng rãi.
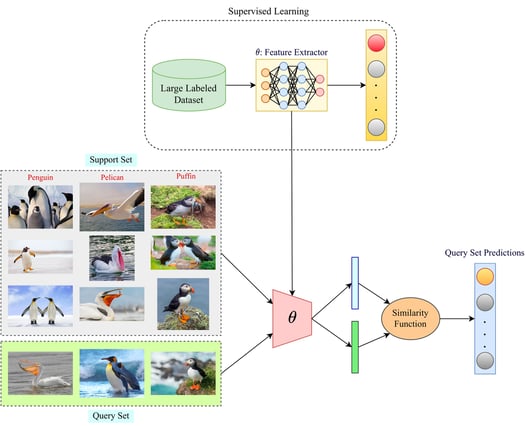
Sơ đồ minh họa sự khác biệt giữa học có giám sát và few-shot learning. Phần học có giám sát cho thấy một bộ dữ liệu lớn đã gán nhãn được dùng để huấn luyện mô hình trích xuất đặc trưng, trong khi phần few-shot learning minh họa việc dùng một tập hỗ trợ nhỏ các ví dụ và một hàm đo tương đồng để dự đoán trên tập truy vấn. Nguồn: Paperspace
Hãy nghĩ về việc một đứa trẻ học nhận biết các loài động vật. Chỉ với vài ví dụ về chó, mèo và chim, trẻ có thể nhanh chóng nhận ra và phân biệt những loài này sau này, ngay cả khi gặp các giống hay loài chưa từng thấy trước đó.
Khả năng khái quát hóa từ dữ liệu hạn chế là dấu ấn của trí tuệ con người, và đó chính là điều few-shot learning hướng tới.
Yếu tố then chốt nằm ở khả năng nhận ra cấu trúc nền tảng và các đặc trưng xác định một phạm trù.
Con người có khả năng bẩm sinh trong việc trích xuất thông tin cốt lõi từ trải nghiệm hạn chế và áp dụng kiến thức đó vào tình huống mới. Các mô hình few-shot learning cố gắng mô phỏng điều này bằng cách học một hiểu biết tổng quát về cấu trúc nền tảng của dữ liệu từ các trải nghiệm trước.
Sau đó, kiến thức này được tận dụng để thích ứng nhanh với các nhiệm vụ mới với rất ít thông tin bổ sung, giống như đứa trẻ nhận ra một giống chó mới dựa trên hiểu biết sẵn có về chó.
Vì sao Few-Shot Learning quan trọng?
FSL giúp nhà phát triển tập trung vào phát triển mô hình hơn là thu thập dữ liệu. Khả năng học từ dữ liệu hạn chế mang lại một số lợi ích:
- Giảm công sức thu thập dữ liệu. FSL giảm nhu cầu về các bộ dữ liệu khổng lồ, tiết kiệm thời gian và nguồn lực cho việc thu thập và gán nhãn.
- Tiết kiệm năng lực tính toán vì mô hình không phải huấn luyện lại từ đầu mà chỉ mở rộng sang một nhóm dữ liệu mới
- Giải quyết vấn đề khan hiếm dữ liệu. Ở những lĩnh vực dữ liệu vốn khan hiếm hoặc đắt đỏ để thu thập (ví dụ: bệnh hiếm, loài nguy cấp), FSL cho phép phát triển mô hình và trích xuất tri thức.
- Nâng cao khả năng thích ứng. Các mô hình FSL có thể nhanh chóng thích ứng với nhiệm vụ và tình huống mới, khiến chúng trở nên đa dụng và vững vàng trong môi trường động.
N-Shot Learning và các biến thể
Few-shot learning nằm trong phạm vi rộng hơn của n-shot learning, bao gồm nhiều kỹ thuật dựa trên số lượng ví dụ được cung cấp:
- Zero-shot learning: Không có ví dụ nào; mô hình chỉ dựa vào kiến thức sẵn có hoặc mô tả.
- One-shot learning: Chỉ có một ví dụ cho mỗi lớp.
- Two-shot learning: Hai ví dụ cho mỗi lớp được dùng để huấn luyện.
- Few-shot learning: Có một số ít ví dụ (thường từ 3 đến 10) cho mỗi lớp.
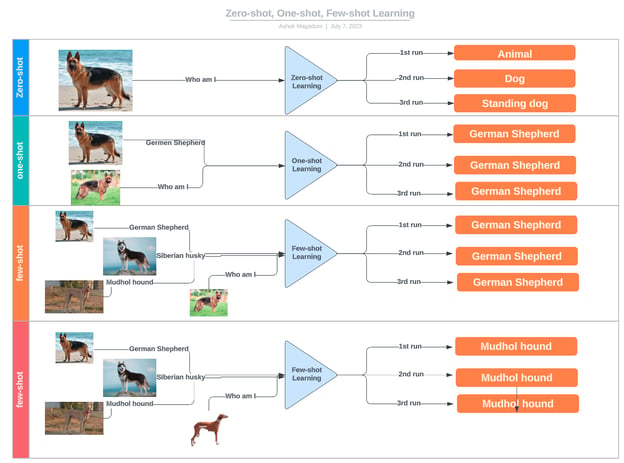
Sơ đồ minh họa khác biệt giữa zero-shot, one-shot và few-shot learning qua ví dụ phân loại các giống chó. Nguồn: LinkedIn
Few-Shot Learning hoạt động như thế nào?
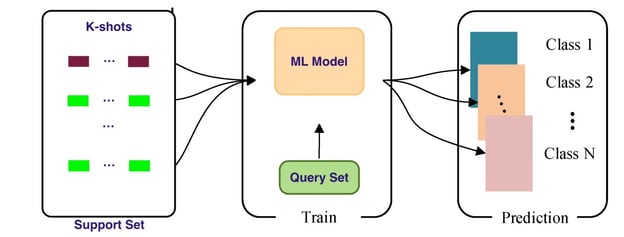
Sơ đồ minh họa quy trình few-shot learning. Gồm một tập hỗ trợ chứa các ví dụ k-shot cho nhiều lớp, một mô hình học máy được huấn luyện trên tập truy vấn, và mô hình sau đó đưa ra dự đoán cho các điểm dữ liệu mới thuộc nhiều lớp khác nhau. Nguồn: LinkedIn
Không giống học có giám sát truyền thống, vốn dựa vào các bộ dữ liệu huấn luyện lớn, few-shot learning tận dụng kiến thức và kinh nghiệm học trước đó để nhanh chóng thích ứng với nhiệm vụ mới chỉ với rất ít dữ liệu bổ sung. Bằng cách nhận ra cấu trúc nền tảng và các đặc trưng nổi bật định nghĩa một khái niệm, các mô hình này có thể khái quát hóa hiệu quả, đưa ra dự đoán chính xác cho các trường hợp mới chỉ từ vài ví dụ.
Kiến thức này sau đó được áp dụng để nhanh chóng thích ứng với nhiệm vụ mới thông qua một hàm đo tương đồng có thể ánh xạ các lớp trong tập truy vấn và tập hỗ trợ với lượng thông tin bổ sung tối thiểu.
Trong ngữ cảnh này, tập truy vấn đề cập đến các mẫu từ cả danh mục cũ và mới, trên đó mô hình khái quát và dùng để đánh giá hiệu năng. Ngược lại, tập hỗ trợ gồm một vài mẫu đã gán nhãn từ mỗi danh mục dữ liệu mới, được dùng để cập nhật tham số của mô hình:
- Tập hỗ trợ (S): Một tập nhỏ các ví dụ đã gán nhãn, S={(x1,y1),…,(xk,yk)}S = \{(x₁, y₁), \ldots, (xₖ, yₖ)\}S={(x1,y1),…,(xk,yk)}, trong đó mỗi ví dụ gồm một điểm dữ liệu xixᵢxi và nhãn tương ứng yiyᵢyi.
- Tập truy vấn (Q): Một tập các điểm dữ liệu chưa gán nhãn, Q={x1′,…,xm′}Q = \{x'₁, \ldots, x'ₘ\}Q={x1′,…,xm′}, mà mô hình cần dự đoán nhãn.
Các phương pháp tiếp cận Few-Shot Learning
MAML học một khởi tạo mô hình tổng quát có thể tinh chỉnh cho các nhiệm vụ cụ thể chỉ với vài bước gradient. Đây là một cách tiếp cận meta-learning linh hoạt và mạnh mẽ, cho phép mô hình thích ứng với nhiệm vụ mới một cách hiệu quả đáng kể.
Điểm mạnh của MAML nằm ở khả năng học một trạng thái khởi tạo mô hình tạo điều kiện cho việc học nhanh chỉ qua vài bước hạ dốc gradient trên nhiệm vụ mới.
Đặc tính này khiến mô hình trở nên “dễ tinh chỉnh”, cho phép nhanh chóng nắm bắt các sắc thái của nhiệm vụ mới với lượng dữ liệu tối thiểu.
MAML vận hành theo nguyên lý học một tập tham số khởi tạo θ có độ nhạy cao với thay đổi của nhiệm vụ. Độ nhạy này đảm bảo rằng những điều chỉnh nhỏ lên tham số có thể cải thiện đáng kể hàm mất mát của bất kỳ nhiệm vụ nào được rút trích từ phân phối nhiệm vụ p(T) khi cập nhật theo hướng gradient của hàm mất mát đó.
Sau đây là tóm lược thuật toán MAML:
- Khởi tạo: Mô hình bắt đầu với một tập tham số ban đầu θ.
- Thích ứng theo nhiệm vụ: Với mỗi nhiệm vụ Tᵢ được lấy mẫu từ p(T), mô hình được huấn luyện trên tập hỗ trợ Sᵢ chứa K ví dụ bằng hạ dốc gradient. Kết quả là tham số riêng cho nhiệm vụ θ'ᵢ: trong đó α biểu diễn tốc độ học cho vòng lặp bên trong (cập nhật theo nhiệm vụ).
- Đánh giá: Hiệu năng của mô hình được đánh giá trên tập truy vấn Qᵢ bằng các tham số đã thích ứng θ'ᵢ.
- Cập nhật meta: Các gradient từ tập truy vấn sau đó được dùng để cập nhật tham số khởi tạo θ. Mục tiêu là tối ưu θ sao cho chỉ cần một số ít bước gradient trên một nhiệm vụ mới cũng đạt hiệu năng tối ưu: trong đó β biểu diễn tốc độ học cho vòng lặp bên ngoài (meta).
Metric learning
Metric learning tập trung vào việc học một hàm khoảng cách đo lường độ tương đồng giữa các điểm dữ liệu. Nó chú trọng học một hàm khoảng cách, ký hiệu d(x, x'), nhằm đo mức độ giống nhau giữa các điểm dữ liệu x và x'. Nhờ vậy, mô hình có thể phân loại các điểm dữ liệu mới bằng cách so sánh chúng với một vài ví dụ đã biết.
- Mạng Siamese: Sử dụng một cặp mạng giống hệt nhau để học độ tương đồng giữa đầu vào.
- Matching networks: Tận dụng cơ chế attention để so sánh ảnh truy vấn với tập hỗ trợ gồm các ví dụ đã gán nhãn.
- Prototypical networks: Học biểu diễn nguyên mẫu cho mỗi lớp và phân loại điểm mới dựa trên khoảng cách tới các nguyên mẫu này.
Transfer learning
Transfer learning tận dụng kiến thức thu được từ một nhiệm vụ nguồn để cải thiện hiệu năng trên một nhiệm vụ đích có liên quan.
- Mô hình tiền huấn luyện: Sử dụng các mô hình đã được huấn luyện trước trên bộ dữ liệu lớn và tinh chỉnh chúng cho nhiệm vụ few-shot.
Ứng dụng của Few-Shot Learning
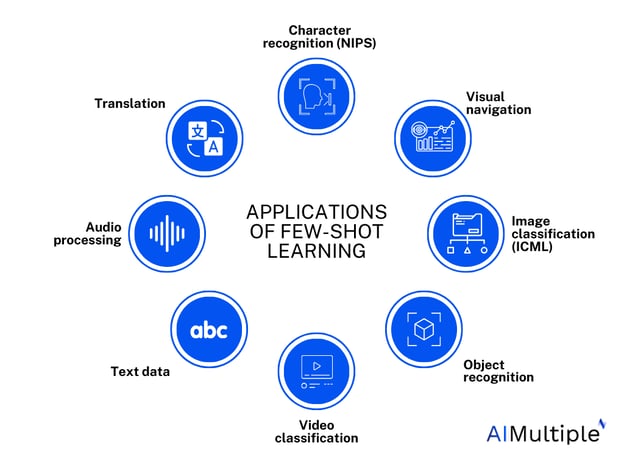
Tổng quan các ứng dụng của FSL trong nhiều lĩnh vực. Nguồn: AI Multiple Research
Ứng dụng của few-shot learning rất rộng và sâu, trải dài từ thị giác máy tính, xử lý ngôn ngữ tự nhiên, robot cho đến chăm sóc sức khỏe. Chẳng hạn, trong thị giác máy tính, few-shot learning có thể giúp hệ thống nhận diện đối tượng hiếm gặp hoặc phát hiện các mẫu tinh vi trong ảnh y khoa chỉ với một vài ví dụ huấn luyện.
Trong xử lý ngôn ngữ tự nhiên, few-shot learning có thể mở đường cho các mô hình ngôn ngữ cá nhân hóa, mô phỏng phong cách viết hoặc phương ngữ riêng của từng người, tạo ra bước ngoặt trong sáng tạo nội dung và giao tiếp. Ngoài ra, nó còn có tiềm năng lớn trong việc bảo tồn và dịch các ngôn ngữ ít tài nguyên, thúc đẩy hiểu biết văn hóa và tính bao trùm.
Có lẽ một trong những ứng dụng mang tính chuyển đổi nhất nằm ở khám phá thuốc và y tế. Bằng cách huấn luyện mô hình trên dữ liệu hạn chế từ thử nghiệm lâm sàng hoặc ca bệnh hiếm, few-shot learning có thể đẩy nhanh phát triển các phương pháp điều trị cứu sống và cho phép chẩn đoán chính xác hơn, cuối cùng cải thiện kết quả cho bệnh nhân.
Thách thức và hướng phát triển
Dù có tiềm năng to lớn, few-shot learning không phải không có thách thức. Một rào cản chính là nguy cơ quá khớp, khi mô hình trở nên quá chuyên biệt với dữ liệu huấn luyện hạn chế và không khái quát tốt cho trường hợp mới. Bên cạnh đó, việc lựa chọn thước đo tương đồng hay hàm khoảng cách phù hợp là tối quan trọng để đạt hiệu năng chính xác, và sự mơ hồ của nhiệm vụ hoặc dữ liệu nhiễu có thể tiếp tục cản trở hiệu quả của mô hình.
Tuy nhiên, chính những thách thức này đã thúc đẩy làn sóng nghiên cứu và đổi mới trong lĩnh vực. Các hướng tiếp cận như meta-learning, metric learning và transfer learning đã nổi lên như những chiến lược hứa hẹn nhằm nâng cao năng lực few-shot learning. Các kỹ thuật như Model-Agnostic Meta-Learning (MAML) và Prototypical Networks đã chứng minh thành công đáng kể trong việc thích ứng nhanh với nhiệm vụ mới chỉ với ít dữ liệu.
Khi lĩnh vực tiếp tục phát triển, chúng ta có thể kỳ vọng xuất hiện các phương pháp few-shot learning tinh vi và vững chắc hơn nữa, mở rộng ranh giới của những gì có thể làm được với dữ liệu hạn chế. Cuối cùng, sức mạnh thực sự của few-shot learning nằm ở khả năng dân chủ hóa AI, giúp AI tiếp cận được với các lĩnh vực và ứng dụng từng bị cản trở bởi sự khan hiếm dữ liệu, mở ra kỷ nguyên mới của trí tuệ nhân tạo tiết kiệm dữ liệu, linh hoạt và bao trùm.
Kết luận
Few-shot learning đại diện cho một bước tiến đáng kể trong học máy, cho phép chúng ta rút ra hiểu biết từ dữ liệu hạn chế. Bằng cách hiểu các phương pháp và ứng dụng khác nhau, những người thực hành dữ liệu ở cấp junior có thể tận dụng công cụ mạnh mẽ này để giải quyết bài toán thực tế trong nhiều lĩnh vực.
Khi nghiên cứu tiếp tục, chúng ta có thể kỳ vọng xuất hiện thêm nhiều kỹ thuật few-shot learning sáng tạo và hiệu quả, tiếp tục mở rộng biên giới của khoa học dữ liệu.
Nếu bạn muốn nắm vững thêm các khái niệm học máy khác, hãy xem lộ trình nghề nghiệp Machine Learning Scientist with Python của chúng tôi.


Lĩnh vực khoa học dữ liệu không ngừng phát triển dựa trên dữ liệu, nhưng việc thu thập các bộ dữ liệu lớn, đã gán nhãn có thể trở thành điểm nghẽn đáng kể trong quá trình phát triển mô hình. Đây là lúc few-shot learning xuất hiện, mang đến một cách tiếp cận mang tính đột phá cho phép chúng ta rút ra hiểu biết giá trị chỉ từ một vài ví dụ.
Trái ngược với các phương pháp học có giám sát truyền thống đòi hỏi lượng dữ liệu khổng lồ, few-shot learning giúp mô hình học và thích ứng nhanh chóng, nhờ đó đặc biệt phù hợp trong những lĩnh vực dữ liệu khan hiếm, tốn kém để thu thập hoặc có tính nhạy cảm.
Bài viết này cung cấp cái nhìn toàn diện về few-shot learning, đi sâu vào tầm quan trọng, cơ chế và các ứng dụng đa dạng của nó trong nhiều ngành.
Few-Shot Learning là gì?
Few-shot learning (FSL) là một nhánh của học máy, trong đó mô hình học cách nhận diện mẫu và đưa ra dự đoán dựa trên số lượng ví dụ huấn luyện rất nhỏ. Điều này trái ngược với học có giám sát truyền thống, vốn thường yêu cầu lượng dữ liệu đã gán nhãn rất lớn để huấn luyện hiệu quả.
FSL nhấn mạnh khả năng khái quát hóa thay vì ghi nhớ. Một trong những công trình sớm nhất là bài báo “Language Models are Few Shot Learners” của Tom B. Brown và cộng sự, đặt dấu hỏi về nhu cầu tinh chỉnh rộng rãi.
Sơ đồ minh họa sự khác biệt giữa học có giám sát và few-shot learning. Phần học có giám sát cho thấy một bộ dữ liệu lớn đã gán nhãn được dùng để huấn luyện mô hình trích xuất đặc trưng, trong khi phần few-shot learning minh họa việc dùng một tập hỗ trợ nhỏ các ví dụ và một hàm đo tương đồng để dự đoán trên tập truy vấn. Nguồn: Paperspace
Hãy nghĩ về việc một đứa trẻ học nhận biết các loài động vật. Chỉ với vài ví dụ về chó, mèo và chim, trẻ có thể nhanh chóng nhận ra và phân biệt những loài này sau này, ngay cả khi gặp các giống hay loài chưa từng thấy trước đó.
Khả năng khái quát hóa từ dữ liệu hạn chế là dấu ấn của trí tuệ con người, và đó chính là điều few-shot learning hướng tới.
Yếu tố then chốt nằm ở khả năng nhận ra cấu trúc nền tảng và các đặc trưng xác định một phạm trù.
Con người có khả năng bẩm sinh trong việc trích xuất thông tin cốt lõi từ trải nghiệm hạn chế và áp dụng kiến thức đó vào tình huống mới. Các mô hình few-shot learning cố gắng mô phỏng điều này bằng cách học một hiểu biết tổng quát về cấu trúc nền tảng của dữ liệu từ các trải nghiệm trước.
Sau đó, kiến thức này được tận dụng để thích ứng nhanh với các nhiệm vụ mới với rất ít thông tin bổ sung, giống như đứa trẻ nhận ra một giống chó mới dựa trên hiểu biết sẵn có về chó.
Vì sao Few-Shot Learning quan trọng?
FSL giúp nhà phát triển tập trung vào phát triển mô hình hơn là thu thập dữ liệu. Khả năng học từ dữ liệu hạn chế mang lại một số lợi ích:
N-Shot Learning và các biến thể
Few-shot learning nằm trong phạm vi rộng hơn của n-shot learning, bao gồm nhiều kỹ thuật dựa trên số lượng ví dụ được cung cấp:
Sơ đồ minh họa khác biệt giữa zero-shot, one-shot và few-shot learning qua ví dụ phân loại các giống chó. Nguồn: LinkedIn
Few-Shot Learning hoạt động như thế nào?
Sơ đồ minh họa quy trình few-shot learning. Gồm một tập hỗ trợ chứa các ví dụ k-shot cho nhiều lớp, một mô hình học máy được huấn luyện trên tập truy vấn, và mô hình sau đó đưa ra dự đoán cho các điểm dữ liệu mới thuộc nhiều lớp khác nhau. Nguồn: LinkedIn
Không giống học có giám sát truyền thống, vốn dựa vào các bộ dữ liệu huấn luyện lớn, few-shot learning tận dụng kiến thức và kinh nghiệm học trước đó để nhanh chóng thích ứng với nhiệm vụ mới chỉ với rất ít dữ liệu bổ sung. Bằng cách nhận ra cấu trúc nền tảng và các đặc trưng nổi bật định nghĩa một khái niệm, các mô hình này có thể khái quát hóa hiệu quả, đưa ra dự đoán chính xác cho các trường hợp mới chỉ từ vài ví dụ.
Kiến thức này sau đó được áp dụng để nhanh chóng thích ứng với nhiệm vụ mới thông qua một hàm đo tương đồng có thể ánh xạ các lớp trong tập truy vấn và tập hỗ trợ với lượng thông tin bổ sung tối thiểu.
Trong ngữ cảnh này, tập truy vấn đề cập đến các mẫu từ cả danh mục cũ và mới, trên đó mô hình khái quát và dùng để đánh giá hiệu năng. Ngược lại, tập hỗ trợ gồm một vài mẫu đã gán nhãn từ mỗi danh mục dữ liệu mới, được dùng để cập nhật tham số của mô hình:
Các phương pháp tiếp cận Few-Shot Learning
Model-Agnostic Meta-Learning (MAML)
MAML học một khởi tạo mô hình tổng quát có thể tinh chỉnh cho các nhiệm vụ cụ thể chỉ với vài bước gradient. Đây là một cách tiếp cận meta-learning linh hoạt và mạnh mẽ, cho phép mô hình thích ứng với nhiệm vụ mới một cách hiệu quả đáng kể.
Điểm mạnh của MAML nằm ở khả năng học một trạng thái khởi tạo mô hình tạo điều kiện cho việc học nhanh chỉ qua vài bước hạ dốc gradient trên nhiệm vụ mới.
Đặc tính này khiến mô hình trở nên “dễ tinh chỉnh”, cho phép nhanh chóng nắm bắt các sắc thái của nhiệm vụ mới với lượng dữ liệu tối thiểu.
MAML vận hành theo nguyên lý học một tập tham số khởi tạo θ có độ nhạy cao với thay đổi của nhiệm vụ. Độ nhạy này đảm bảo rằng những điều chỉnh nhỏ lên tham số có thể cải thiện đáng kể hàm mất mát của bất kỳ nhiệm vụ nào được rút trích từ phân phối nhiệm vụ p(T) khi cập nhật theo hướng gradient của hàm mất mát đó.
Sau đây là tóm lược thuật toán MAML:
Metric learning
Metric learning tập trung vào việc học một hàm khoảng cách đo lường độ tương đồng giữa các điểm dữ liệu. Nó chú trọng học một hàm khoảng cách, ký hiệu d(x, x'), nhằm đo mức độ giống nhau giữa các điểm dữ liệu x và x'. Nhờ vậy, mô hình có thể phân loại các điểm dữ liệu mới bằng cách so sánh chúng với một vài ví dụ đã biết.
Transfer learning
Transfer learning tận dụng kiến thức thu được từ một nhiệm vụ nguồn để cải thiện hiệu năng trên một nhiệm vụ đích có liên quan.
Ứng dụng của Few-Shot Learning
Tổng quan các ứng dụng của FSL trong nhiều lĩnh vực. Nguồn: AI Multiple Research
Ứng dụng của few-shot learning rất rộng và sâu, trải dài từ thị giác máy tính, xử lý ngôn ngữ tự nhiên, robot cho đến chăm sóc sức khỏe. Chẳng hạn, trong thị giác máy tính, few-shot learning có thể giúp hệ thống nhận diện đối tượng hiếm gặp hoặc phát hiện các mẫu tinh vi trong ảnh y khoa chỉ với một vài ví dụ huấn luyện.
Trong xử lý ngôn ngữ tự nhiên, few-shot learning có thể mở đường cho các mô hình ngôn ngữ cá nhân hóa, mô phỏng phong cách viết hoặc phương ngữ riêng của từng người, tạo ra bước ngoặt trong sáng tạo nội dung và giao tiếp. Ngoài ra, nó còn có tiềm năng lớn trong việc bảo tồn và dịch các ngôn ngữ ít tài nguyên, thúc đẩy hiểu biết văn hóa và tính bao trùm.
Có lẽ một trong những ứng dụng mang tính chuyển đổi nhất nằm ở khám phá thuốc và y tế. Bằng cách huấn luyện mô hình trên dữ liệu hạn chế từ thử nghiệm lâm sàng hoặc ca bệnh hiếm, few-shot learning có thể đẩy nhanh phát triển các phương pháp điều trị cứu sống và cho phép chẩn đoán chính xác hơn, cuối cùng cải thiện kết quả cho bệnh nhân.
Thách thức và hướng phát triển
Dù có tiềm năng to lớn, few-shot learning không phải không có thách thức. Một rào cản chính là nguy cơ quá khớp, khi mô hình trở nên quá chuyên biệt với dữ liệu huấn luyện hạn chế và không khái quát tốt cho trường hợp mới. Bên cạnh đó, việc lựa chọn thước đo tương đồng hay hàm khoảng cách phù hợp là tối quan trọng để đạt hiệu năng chính xác, và sự mơ hồ của nhiệm vụ hoặc dữ liệu nhiễu có thể tiếp tục cản trở hiệu quả của mô hình.
Tuy nhiên, chính những thách thức này đã thúc đẩy làn sóng nghiên cứu và đổi mới trong lĩnh vực. Các hướng tiếp cận như meta-learning, metric learning và transfer learning đã nổi lên như những chiến lược hứa hẹn nhằm nâng cao năng lực few-shot learning. Các kỹ thuật như Model-Agnostic Meta-Learning (MAML) và Prototypical Networks đã chứng minh thành công đáng kể trong việc thích ứng nhanh với nhiệm vụ mới chỉ với ít dữ liệu.
Khi lĩnh vực tiếp tục phát triển, chúng ta có thể kỳ vọng xuất hiện các phương pháp few-shot learning tinh vi và vững chắc hơn nữa, mở rộng ranh giới của những gì có thể làm được với dữ liệu hạn chế. Cuối cùng, sức mạnh thực sự của few-shot learning nằm ở khả năng dân chủ hóa AI, giúp AI tiếp cận được với các lĩnh vực và ứng dụng từng bị cản trở bởi sự khan hiếm dữ liệu, mở ra kỷ nguyên mới của trí tuệ nhân tạo tiết kiệm dữ liệu, linh hoạt và bao trùm.
Kết luận
Few-shot learning đại diện cho một bước tiến đáng kể trong học máy, cho phép chúng ta rút ra hiểu biết từ dữ liệu hạn chế. Bằng cách hiểu các phương pháp và ứng dụng khác nhau, những người thực hành dữ liệu ở cấp junior có thể tận dụng công cụ mạnh mẽ này để giải quyết bài toán thực tế trong nhiều lĩnh vực.
Khi nghiên cứu tiếp tục, chúng ta có thể kỳ vọng xuất hiện thêm nhiều kỹ thuật few-shot learning sáng tạo và hiệu quả, tiếp tục mở rộng biên giới của khoa học dữ liệu.
Nếu bạn muốn nắm vững thêm các khái niệm học máy khác, hãy xem lộ trình nghề nghiệp Machine Learning Scientist with Python của chúng tôi.