Bidang data science yang terus berkembang bergantung pada data, namun memperoleh dataset berlabel dalam jumlah besar bisa menjadi hambatan signifikan dalam proses pengembangan model. Di sinilah few-shot learning berperan, menawarkan pendekatan revolusioner yang memungkinkan kita mengekstrak wawasan berharga hanya dari segelintir contoh.
Berbeda dengan metode pembelajaran terawasi tradisional yang menuntut data dalam jumlah besar, few-shot learning memberdayakan model untuk belajar dan beradaptasi dengan cepat, sehingga sangat relevan di domain yang datanya langka, mahal untuk dikumpulkan, atau bersifat sensitif.
Artikel ini menyajikan eksplorasi komprehensif tentang few-shot learning, mengulas pentingnya, mekanismenya, dan beragam penerapannya di berbagai industri.
Apa itu Few-Shot Learning?
Few-shot learning (FSL) adalah subbidang machine learning di mana model belajar mengenali pola dan membuat prediksi berdasarkan jumlah contoh pelatihan yang sangat sedikit. Ini berlawanan dengan pembelajaran terawasi tradisional, yang sering memerlukan sejumlah besar data berlabel untuk pelatihan yang efektif.
FSL menekankan generalisasi alih-alih menghafal. Salah satu karya awal adalah makalah “Language Models are Few Shot Learners” oleh Tom B. Brown dkk. yang menantang kebutuhan akan fine-tuning ekstensif.
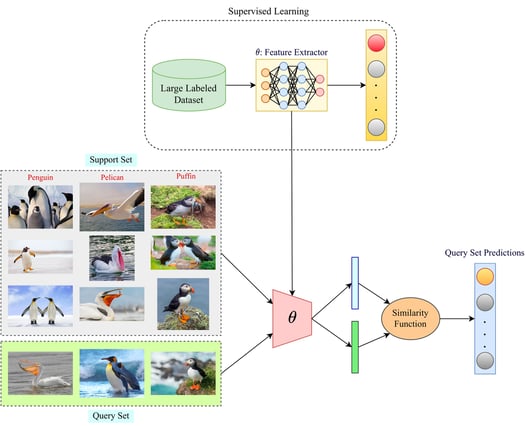
Sebuah diagram yang menggambarkan perbedaan antara pendekatan supervised learning dan few-shot learning. Bagian supervised learning menunjukkan dataset besar berlabel yang digunakan untuk melatih model feature extractor, sedangkan bagian few-shot learning memperlihatkan penggunaan set pendukung kecil berisi contoh dan fungsi kesamaan untuk membuat prediksi pada query set. Sumber: Paperspace
Bayangkan seorang anak belajar mengidentifikasi hewan yang berbeda. Hanya dengan beberapa contoh anjing, kucing, dan burung, mereka dapat dengan cepat mengenali dan membedakan makhluk-makhluk ini di masa depan, bahkan jika mereka menemui ras atau spesies yang belum pernah mereka lihat sebelumnya.
Kemampuan untuk melakukan generalisasi dari data terbatas adalah ciri khas kecerdasan manusia, dan inilah yang ingin dicapai oleh few-shot learning.
Kuncinya terletak pada kemampuan membedakan struktur dan fitur mendasar yang mendefinisikan sebuah kategori.
Manusia memiliki kemampuan bawaan untuk mengekstrak informasi esensial dari pengalaman yang terbatas dan menerapkan pengetahuan itu pada situasi baru. Model few-shot learning berupaya menirunya dengan mempelajari pemahaman umum tentang struktur dasar data dari pengalaman sebelumnya.
Pengetahuan ini kemudian dimanfaatkan untuk beradaptasi cepat dengan tugas baru dengan informasi tambahan yang minimal, seperti halnya anak yang mengenali ras anjing baru berdasarkan pengetahuan mereka tentang anjing.
Mengapa Few-Shot Learning Penting?
FSL membantu pengembang fokus pada pengembangan model alih-alih akuisisi data. Kemampuan belajar dari data terbatas menawarkan beberapa keuntungan:
- Mengurangi upaya pengumpulan data. FSL mengurangi kebutuhan akan dataset masif, menghemat waktu dan sumber daya dalam pengumpulan dan pelabelan data.
- Hemat daya komputasi karena model tidak harus dilatih dari awal, melainkan diperluas ke kategori data baru
- Menangani kelangkaan data. Di domain yang datanya memang langka atau mahal untuk diperoleh (misalnya penyakit langka, spesies terancam punah), FSL memungkinkan pengembangan model dan ekstraksi pengetahuan.
- Adaptabilitas yang lebih baik. Model FSL dapat dengan cepat beradaptasi dengan tugas dan situasi baru, menjadikannya serbaguna dan andal di lingkungan yang dinamis.
N-Shot Learning dan Variasinya
Few-shot learning berada di bawah payung yang lebih luas yaitu n-shot learning, yang mencakup berbagai teknik berdasarkan jumlah contoh yang disediakan:
- Zero-shot learning: Tidak ada contoh yang diberikan; model hanya mengandalkan pengetahuan atau deskripsi sebelumnya.
- One-shot learning: Hanya satu contoh per kelas yang disediakan.
- Two-shot learning: Dua contoh per kelas digunakan untuk pelatihan.
- Few-shot learning: Sejumlah kecil contoh (biasanya antara 3 hingga 10) tersedia untuk setiap kelas.
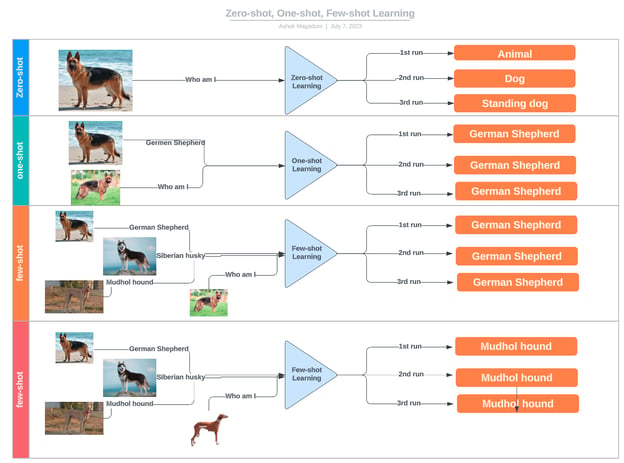
Sebuah diagram yang menggambarkan perbedaan antara zero-shot, one-shot, dan few-shot learning dengan contoh klasifikasi ras anjing. Sumber: LinkedIn
Bagaimana Cara Kerja Few-Shot Learning?
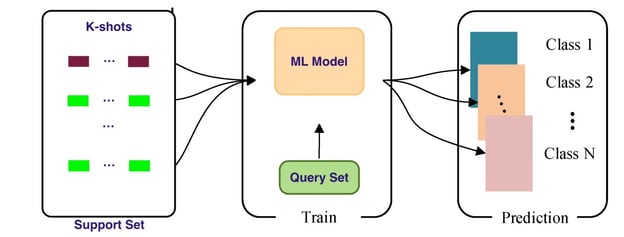
Sebuah diagram yang menggambarkan proses few-shot learning. Diagram menunjukkan support set yang berisi contoh k-shot untuk banyak kelas, sebuah model machine learning yang dilatih pada query set, dan model kemudian membuat prediksi untuk instance data baru di berbagai kelas. Sumber: LinkedIn
Tidak seperti pembelajaran terawasi tradisional yang bergantung pada dataset pelatihan yang ekstensif, model few-shot learning memanfaatkan pengetahuan dan pengalaman belajar sebelumnya untuk cepat beradaptasi dengan tugas baru dengan data tambahan yang minimal. Dengan membedakan struktur dasar dan fitur menonjol yang mendefinisikan suatu konsep, model ini dapat melakukan generalisasi secara efektif, membuat prediksi akurat pada instance baru hanya dengan beberapa contoh.
Pengetahuan ini kemudian diterapkan untuk beradaptasi cepat dengan tugas baru melalui fungsi kesamaan yang dapat memetakan kelas-kelas dalam query set dan support set dengan informasi tambahan yang minimal.
Untuk konteks, query set di sini mengacu pada sampel dari kategori lama dan baru, yang digeneralisasi oleh model dan digunakan untuk mengevaluasi kinerja. Sebaliknya, support set terdiri dari sedikit sampel berlabel dari setiap kategori data baru, yang digunakan untuk memperbarui parameter model:
- Support set (S): Sekumpulan kecil contoh berlabel, S={(x1,y1),…,(xk,yk)}S = \{(x₁, y₁), \ldots, (xₖ, yₖ)\}S={(x1,y1),…,(xk,yk)}, di mana setiap contoh terdiri dari titik data xixᵢxi dan labelnya yiyᵢyi.
- Query set (Q): Sekumpulan titik data tanpa label, Q={x1′,…,xm′}Q = \{x'₁, \ldots, x'ₘ\}Q={x1′,…,xm′}, yang labelnya perlu diprediksi oleh model.
Pendekatan yang Berbeda untuk Few-Shot Learning
MAML mempelajari inisialisasi model umum yang dapat di-fine-tune untuk tugas spesifik hanya dengan beberapa langkah gradien. Ini adalah pendekatan meta-learning yang serbaguna dan kuat, memungkinkan model beradaptasi dengan tugas baru secara sangat efisien.
Kekuatan MAML terletak pada kemampuannya mempelajari inisialisasi model yang memfasilitasi pembelajaran cepat hanya melalui beberapa langkah gradient descent pada tugas baru.
Karakteristik ini secara efektif membuat model "mudah di-fine-tune," memungkinkannya dengan cepat menangkap seluk-beluk tugas baru dengan data minimal.
MAML beroperasi berdasarkan prinsip mempelajari seperangkat parameter awal θ yang sangat sensitif terhadap perubahan tugas. Sensitivitas ini memastikan bahwa penyesuaian kecil pada parameter dapat secara signifikan meningkatkan loss function dari tugas apa pun yang diambil dari distribusi tugas p(T) ketika diperbarui ke arah gradien loss tersebut.
Berikut adalah ringkasan algoritma MAML:
- Inisialisasi: Model dimulai dengan seperangkat parameter awal θ.
- Adaptasi spesifik tugas: Untuk setiap tugas Tᵢ yang diambil dari p(T), model dilatih pada support set Sᵢ yang berisi K contoh menggunakan gradient descent. Ini menghasilkan parameter spesifik tugas θ'ᵢ: dengan α merepresentasikan laju pembelajaran untuk pembaruan loop dalam (spesifik tugas).
- Evaluasi: Kinerja model dievaluasi pada query set Qᵢ menggunakan parameter teradaptasi θ'ᵢ.
- Pembaruan meta: Gradien dari query set kemudian digunakan untuk memperbarui parameter awal θ. Pembaruan ini bertujuan mengoptimalkan θ sehingga sejumlah kecil langkah gradien pada tugas baru akan menghasilkan kinerja optimal: dengan β merepresentasikan laju pembelajaran untuk pembaruan loop luar (meta).
Metric learning
Metric learning berfokus pada pembelajaran fungsi jarak yang mengukur kesamaan antar titik data. Pendekatan ini mempelajari fungsi jarak, dinotasikan sebagai d(x, x'), yang mengukur kesamaan antara titik data x dan x'. Ini memungkinkan model mengklasifikasikan titik data baru dengan membandingkannya terhadap beberapa contoh yang sudah diketahui.
- Siamese networks: Menggunakan sepasang jaringan identik untuk mempelajari kesamaan antar masukan.
- Matching networks: Memanfaatkan mekanisme atensi untuk membandingkan gambar kueri dengan support set berlabel.
- Prototypical networks: Mempelajari representasi prototipe untuk setiap kelas dan mengklasifikasikan titik baru berdasarkan jaraknya ke prototipe tersebut.
Transfer learning
Transfer learning memanfaatkan pengetahuan yang diperoleh dari tugas sumber untuk meningkatkan kinerja pada tugas target yang terkait.
- Model pratampil: Memanfaatkan model yang telah dilatih pada dataset besar dan melakukan fine-tuning pada tugas few-shot.
Penerapan Few-Shot Learning
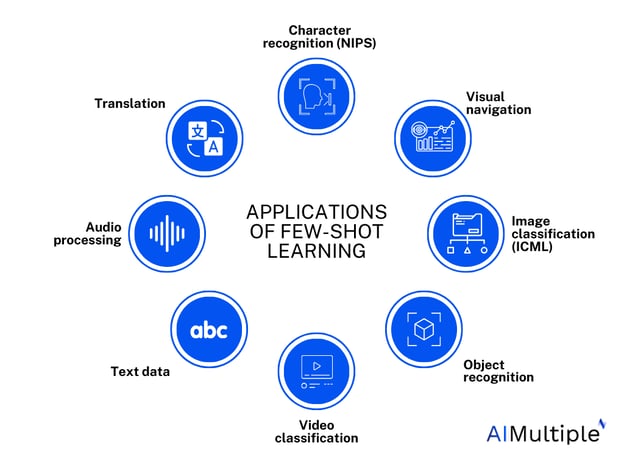
Ringkasan penerapan FSL di berbagai domain. Sumber: AI Multiple Research
Penerapan few-shot learning sangat luas dan berdampak, mencakup bidang yang beragam seperti computer vision, natural language processing, robotika, dan layanan kesehatan. Dalam ranah computer vision, misalnya, few-shot learning dapat memungkinkan sistem mengenali objek langka atau mengidentifikasi pola samar dalam pencitraan medis hanya dengan segelintir contoh pelatihan.
Dalam natural language processing, few-shot learning dapat membuka jalan bagi model bahasa yang dipersonalisasi yang dapat meniru gaya penulisan atau dialek unik seseorang, merevolusi pembuatan konten dan komunikasi. Selain itu, pendekatan ini memiliki potensi besar untuk melestarikan dan menerjemahkan bahasa dengan sumber daya terbatas, mendorong pemahaman budaya dan inklusivitas yang lebih besar.
Mungkin salah satu penerapan yang paling transformatif ada pada penemuan obat dan layanan kesehatan. Dengan melatih model pada data terbatas dari uji klinis atau kasus penyakit langka, few-shot learning dapat mempercepat pengembangan terapi yang menyelamatkan jiwa dan memungkinkan diagnosis yang lebih akurat, pada akhirnya meningkatkan hasil pasien.
Tantangan dan Arah Masa Depan
Terlepas dari potensinya yang besar, few-shot learning tidak lepas dari tantangan. Salah satu hambatan utama adalah risiko overfitting, ketika model menjadi terlalu terspesialisasi pada data pelatihan yang terbatas dan gagal melakukan generalisasi secara efektif pada instance baru. Selain itu, pemilihan ukuran kesamaan atau fungsi jarak yang tepat sangat krusial untuk kinerja yang akurat, dan ambiguitas tugas atau data berisik dapat semakin menghambat efektivitas model.
Namun, tantangan-tantangan ini justru memicu lonjakan riset dan inovasi di bidang tersebut. Pendekatan seperti meta-learning, metric learning, dan transfer learning muncul sebagai strategi menjanjikan untuk meningkatkan kemampuan few-shot learning. Teknik seperti Model-Agnostic Meta-Learning (MAML) dan Prototypical Networks telah menunjukkan keberhasilan luar biasa dalam beradaptasi cepat dengan tugas baru menggunakan data minimal.
Seiring terus berkembangnya bidang ini, kita dapat mengharapkan metode few-shot learning yang makin canggih dan tangguh bermunculan, mendorong batasan kemungkinan dengan data terbatas. Pada akhirnya, kekuatan sejati few-shot learning terletak pada kemampuannya mendemokratisasi AI, menjadikannya dapat diakses oleh domain dan aplikasi yang sebelumnya terhambat oleh kelangkaan data, serta membuka era baru kecerdasan buatan yang hemat data, adaptif, dan inklusif.
Kesimpulan
Few-shot learning merepresentasikan lompatan besar di bidang machine learning, memungkinkan kita mengekstrak wawasan dari data terbatas. Dengan memahami berbagai pendekatan dan penerapannya, praktisi data pemula dapat memanfaatkan alat yang kuat ini untuk menghadapi masalah dunia nyata di beragam domain.
Seiring berlanjutnya riset, kita dapat mengharapkan teknik few-shot learning yang makin inovatif dan efisien bermunculan, semakin mendorong batas-batas data science.
Jika Anda ingin menguasai konsep machine learning lainnya, lihat Machine Learning Scientist with Python career track kami.




Bidang data science yang terus berkembang bergantung pada data, namun memperoleh dataset berlabel dalam jumlah besar bisa menjadi hambatan signifikan dalam proses pengembangan model. Di sinilah few-shot learning berperan, menawarkan pendekatan revolusioner yang memungkinkan kita mengekstrak wawasan berharga hanya dari segelintir contoh.
Berbeda dengan metode pembelajaran terawasi tradisional yang menuntut data dalam jumlah besar, few-shot learning memberdayakan model untuk belajar dan beradaptasi dengan cepat, sehingga sangat relevan di domain yang datanya langka, mahal untuk dikumpulkan, atau bersifat sensitif.
Artikel ini menyajikan eksplorasi komprehensif tentang few-shot learning, mengulas pentingnya, mekanismenya, dan beragam penerapannya di berbagai industri.
Apa itu Few-Shot Learning?
Few-shot learning (FSL) adalah subbidang machine learning di mana model belajar mengenali pola dan membuat prediksi berdasarkan jumlah contoh pelatihan yang sangat sedikit. Ini berlawanan dengan pembelajaran terawasi tradisional, yang sering memerlukan sejumlah besar data berlabel untuk pelatihan yang efektif.
FSL menekankan generalisasi alih-alih menghafal. Salah satu karya awal adalah makalah “Language Models are Few Shot Learners” oleh Tom B. Brown dkk. yang menantang kebutuhan akan fine-tuning ekstensif.
Sebuah diagram yang menggambarkan perbedaan antara pendekatan supervised learning dan few-shot learning. Bagian supervised learning menunjukkan dataset besar berlabel yang digunakan untuk melatih model feature extractor, sedangkan bagian few-shot learning memperlihatkan penggunaan set pendukung kecil berisi contoh dan fungsi kesamaan untuk membuat prediksi pada query set. Sumber: Paperspace
Bayangkan seorang anak belajar mengidentifikasi hewan yang berbeda. Hanya dengan beberapa contoh anjing, kucing, dan burung, mereka dapat dengan cepat mengenali dan membedakan makhluk-makhluk ini di masa depan, bahkan jika mereka menemui ras atau spesies yang belum pernah mereka lihat sebelumnya.
Kemampuan untuk melakukan generalisasi dari data terbatas adalah ciri khas kecerdasan manusia, dan inilah yang ingin dicapai oleh few-shot learning.
Kuncinya terletak pada kemampuan membedakan struktur dan fitur mendasar yang mendefinisikan sebuah kategori.
Manusia memiliki kemampuan bawaan untuk mengekstrak informasi esensial dari pengalaman yang terbatas dan menerapkan pengetahuan itu pada situasi baru. Model few-shot learning berupaya menirunya dengan mempelajari pemahaman umum tentang struktur dasar data dari pengalaman sebelumnya.
Pengetahuan ini kemudian dimanfaatkan untuk beradaptasi cepat dengan tugas baru dengan informasi tambahan yang minimal, seperti halnya anak yang mengenali ras anjing baru berdasarkan pengetahuan mereka tentang anjing.
Mengapa Few-Shot Learning Penting?
FSL membantu pengembang fokus pada pengembangan model alih-alih akuisisi data. Kemampuan belajar dari data terbatas menawarkan beberapa keuntungan:
N-Shot Learning dan Variasinya
Few-shot learning berada di bawah payung yang lebih luas yaitu n-shot learning, yang mencakup berbagai teknik berdasarkan jumlah contoh yang disediakan:
Sebuah diagram yang menggambarkan perbedaan antara zero-shot, one-shot, dan few-shot learning dengan contoh klasifikasi ras anjing. Sumber: LinkedIn
Bagaimana Cara Kerja Few-Shot Learning?
Sebuah diagram yang menggambarkan proses few-shot learning. Diagram menunjukkan support set yang berisi contoh k-shot untuk banyak kelas, sebuah model machine learning yang dilatih pada query set, dan model kemudian membuat prediksi untuk instance data baru di berbagai kelas. Sumber: LinkedIn
Tidak seperti pembelajaran terawasi tradisional yang bergantung pada dataset pelatihan yang ekstensif, model few-shot learning memanfaatkan pengetahuan dan pengalaman belajar sebelumnya untuk cepat beradaptasi dengan tugas baru dengan data tambahan yang minimal. Dengan membedakan struktur dasar dan fitur menonjol yang mendefinisikan suatu konsep, model ini dapat melakukan generalisasi secara efektif, membuat prediksi akurat pada instance baru hanya dengan beberapa contoh.
Pengetahuan ini kemudian diterapkan untuk beradaptasi cepat dengan tugas baru melalui fungsi kesamaan yang dapat memetakan kelas-kelas dalam query set dan support set dengan informasi tambahan yang minimal.
Untuk konteks, query set di sini mengacu pada sampel dari kategori lama dan baru, yang digeneralisasi oleh model dan digunakan untuk mengevaluasi kinerja. Sebaliknya, support set terdiri dari sedikit sampel berlabel dari setiap kategori data baru, yang digunakan untuk memperbarui parameter model:
Pendekatan yang Berbeda untuk Few-Shot Learning
Model-Agnostic Meta-Learning (MAML)
MAML mempelajari inisialisasi model umum yang dapat di-fine-tune untuk tugas spesifik hanya dengan beberapa langkah gradien. Ini adalah pendekatan meta-learning yang serbaguna dan kuat, memungkinkan model beradaptasi dengan tugas baru secara sangat efisien.
Kekuatan MAML terletak pada kemampuannya mempelajari inisialisasi model yang memfasilitasi pembelajaran cepat hanya melalui beberapa langkah gradient descent pada tugas baru.
Karakteristik ini secara efektif membuat model "mudah di-fine-tune," memungkinkannya dengan cepat menangkap seluk-beluk tugas baru dengan data minimal.
MAML beroperasi berdasarkan prinsip mempelajari seperangkat parameter awal θ yang sangat sensitif terhadap perubahan tugas. Sensitivitas ini memastikan bahwa penyesuaian kecil pada parameter dapat secara signifikan meningkatkan loss function dari tugas apa pun yang diambil dari distribusi tugas p(T) ketika diperbarui ke arah gradien loss tersebut.
Berikut adalah ringkasan algoritma MAML:
Metric learning
Metric learning berfokus pada pembelajaran fungsi jarak yang mengukur kesamaan antar titik data. Pendekatan ini mempelajari fungsi jarak, dinotasikan sebagai d(x, x'), yang mengukur kesamaan antara titik data x dan x'. Ini memungkinkan model mengklasifikasikan titik data baru dengan membandingkannya terhadap beberapa contoh yang sudah diketahui.
Transfer learning
Transfer learning memanfaatkan pengetahuan yang diperoleh dari tugas sumber untuk meningkatkan kinerja pada tugas target yang terkait.
Penerapan Few-Shot Learning
Ringkasan penerapan FSL di berbagai domain. Sumber: AI Multiple Research
Penerapan few-shot learning sangat luas dan berdampak, mencakup bidang yang beragam seperti computer vision, natural language processing, robotika, dan layanan kesehatan. Dalam ranah computer vision, misalnya, few-shot learning dapat memungkinkan sistem mengenali objek langka atau mengidentifikasi pola samar dalam pencitraan medis hanya dengan segelintir contoh pelatihan.
Dalam natural language processing, few-shot learning dapat membuka jalan bagi model bahasa yang dipersonalisasi yang dapat meniru gaya penulisan atau dialek unik seseorang, merevolusi pembuatan konten dan komunikasi. Selain itu, pendekatan ini memiliki potensi besar untuk melestarikan dan menerjemahkan bahasa dengan sumber daya terbatas, mendorong pemahaman budaya dan inklusivitas yang lebih besar.
Mungkin salah satu penerapan yang paling transformatif ada pada penemuan obat dan layanan kesehatan. Dengan melatih model pada data terbatas dari uji klinis atau kasus penyakit langka, few-shot learning dapat mempercepat pengembangan terapi yang menyelamatkan jiwa dan memungkinkan diagnosis yang lebih akurat, pada akhirnya meningkatkan hasil pasien.
Tantangan dan Arah Masa Depan
Terlepas dari potensinya yang besar, few-shot learning tidak lepas dari tantangan. Salah satu hambatan utama adalah risiko overfitting, ketika model menjadi terlalu terspesialisasi pada data pelatihan yang terbatas dan gagal melakukan generalisasi secara efektif pada instance baru. Selain itu, pemilihan ukuran kesamaan atau fungsi jarak yang tepat sangat krusial untuk kinerja yang akurat, dan ambiguitas tugas atau data berisik dapat semakin menghambat efektivitas model.
Namun, tantangan-tantangan ini justru memicu lonjakan riset dan inovasi di bidang tersebut. Pendekatan seperti meta-learning, metric learning, dan transfer learning muncul sebagai strategi menjanjikan untuk meningkatkan kemampuan few-shot learning. Teknik seperti Model-Agnostic Meta-Learning (MAML) dan Prototypical Networks telah menunjukkan keberhasilan luar biasa dalam beradaptasi cepat dengan tugas baru menggunakan data minimal.
Seiring terus berkembangnya bidang ini, kita dapat mengharapkan metode few-shot learning yang makin canggih dan tangguh bermunculan, mendorong batasan kemungkinan dengan data terbatas. Pada akhirnya, kekuatan sejati few-shot learning terletak pada kemampuannya mendemokratisasi AI, menjadikannya dapat diakses oleh domain dan aplikasi yang sebelumnya terhambat oleh kelangkaan data, serta membuka era baru kecerdasan buatan yang hemat data, adaptif, dan inklusif.
Kesimpulan
Few-shot learning merepresentasikan lompatan besar di bidang machine learning, memungkinkan kita mengekstrak wawasan dari data terbatas. Dengan memahami berbagai pendekatan dan penerapannya, praktisi data pemula dapat memanfaatkan alat yang kuat ini untuk menghadapi masalah dunia nyata di beragam domain.
Seiring berlanjutnya riset, kita dapat mengharapkan teknik few-shot learning yang makin inovatif dan efisien bermunculan, semakin mendorong batas-batas data science.
Jika Anda ingin menguasai konsep machine learning lainnya, lihat Machine Learning Scientist with Python career track kami.