
Khóa học
Nhập môn Hồi quy bằng R
4 giờ
78.9K
Nếu tôi chỉ được khuyên học chuyên sâu một thứ để trở thành nhà phân tích dữ liệu hoặc nhà khoa học dữ liệu giỏi hơn, đó sẽ là hồi quy. Và một phần then chốt khi học hồi quy là hiểu chính xác heteroscedasticity là gì.
Trong bài viết này, chúng ta sẽ xem xét hiện tượng heteroscedasticity, tìm hiểu vì sao nó quan trọng, cách nhận diện và các bước xử lý. Tôi sẽ trình bày đầy đủ nhưng đi nhanh. Vậy nên, dù bạn là nhà phân tích dày dạn hay mới bắt đầu, tôi hy vọng bạn sẽ tìm thấy điều gì đó thú vị và hữu ích ở đây. Để biết thêm thông tin và bắt đầu con đường trở thành chuyên gia, hãy học khóa Intro to Regression in R hoặc Intro to Regression in Python của chúng tôi. Tôi cũng có một hướng dẫn về hồi quy tuyến tính đơn nếu bạn cần ôn nhanh.
Vậy chính xác heteroscedasticity là gì? Hãy đi qua các định nghĩa kỹ thuật trước khi xem ví dụ. Nếu bạn vấp ở từ này như tôi, bạn có thể nói “phương sai không đồng nhất” để diễn đạt ý.
Heteroscedasticity đề cập đến tình huống trong đó độ biến thiên của biến phụ thuộc là không đồng nhất trên toàn bộ phạm vi giá trị của biến độc lập. Hoặc, theo một định nghĩa gắn chặt với xây dựng mô hình hơn, chúng ta có thể nói heteroscedasticity xảy ra khi độ phân tán của phần dư không hằng số, như đôi khi thấy trong các mô hình như mô hình hồi quy hoặc chuỗi thời gian.
Theo một cách nào đó, tôi thích định nghĩa thứ hai hơn vì nó nhắc chúng ta rằng heteroscedasticity thực ra là một khía cạnh phổ biến (dù cũng là vấn đề thường gặp) của mô hình thống kê. Nhưng để rõ ràng, dù heteroscedasticity thường được bàn trong bối cảnh các mô hình như hồi quy, nó có thể là đặc trưng của đặc tả mô hình hoặc là thuộc tính của chính dữ liệu.
Hãy xem một vài ví dụ bằng R và chọn một lĩnh vực — chẳng hạn tài chính hộ gia đình. Ban đầu, tôi sẽ minh họa hình phễu hoặc quạt kinh điển mà cá nhân tôi nghĩ đến khi nói về phương sai không đồng nhất.
Dạng heteroscedasticity này có thể xuất hiện, ví dụ, trong dữ liệu thu nhập so với chi tiêu: Các hộ thu nhập thấp thường có mức chi tiêu hàng tháng ổn định tập trung vào những nhu cầu thiết yếu như tiền thuê nhà và thực phẩm, dẫn đến độ biến thiên thấp; trong khi đó, các hộ thu nhập cao có thể biến thiên chi tiêu lớn hơn vì chỉ một số hộ có thu nhập cao lựa chọn các khoản chi tiêu tùy ý đắt đỏ như du lịch hay hàng xa xỉ, còn những hộ khác thì tiết kiệm. Vậy nên, trong ví dụ này, khi thu nhập tăng, độ biến thiên của chi tiêu hàng tháng cũng tăng, tạo thành hình quạt.
y_funnel <- x + rnorm(length(x), mean = 0, sd = x * 0.5)y_inverse_funnel <- x + rnorm(length(x), mean = 0, sd = (1 / x) * 20)y_cyclical <- x + rnorm(length(x), mean = 0, sd = 10 * abs(sin(x / 5)))heteroscedasticity_data <- data.frame(x, y_funnel, y_inverse_funnel, y_cyclical)library(ggplot2)ggplot(heteroscedasticity_data, aes(x = x, y = y_funnel)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Funnel Shape", x = "X Values", y = "Y Values" )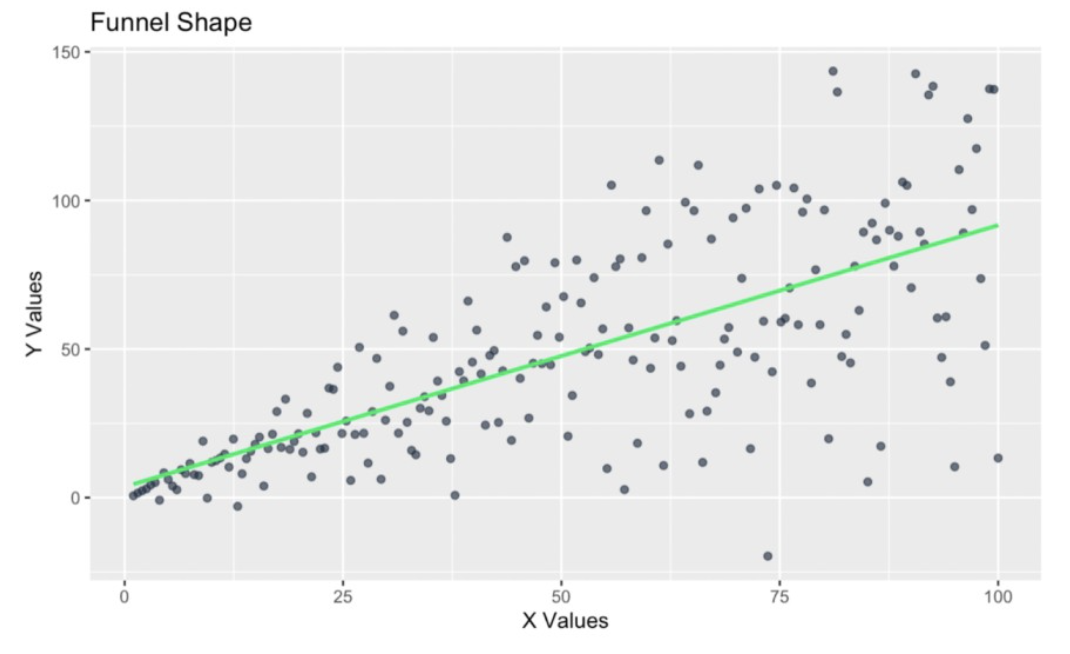
Hình phễu trong phần dư. Ảnh: Tác giả
Hãy thử một ví dụ khác, cũng trong tài chính hộ gia đình. Hãy tưởng tượng chúng ta đang tạo một mô hình hồi quy để biểu diễn độ biến thiên tiết kiệm theo độ tuổi của các thành viên trong hộ.
Chúng ta nghi ngờ dữ liệu này sẽ có heteroscedasticity vì các hộ trẻ tuổi có thể có biến thiên tiết kiệm cao do thu nhập không đều, như làm gig hay thực tập, hoặc chi tiêu phát sinh như khoản vay sinh viên hay lập gia đình. Nhưng khi hộ gia đình lớn tuổi hơn và ổn định tài chính, hành vi tiết kiệm trở nên nhất quán hơn, tạo ra hình phễu ngược khi biến thiên giảm theo tuổi.
ggplot(heteroscedasticity_data, aes(x = x, y = y_inverse_funnel)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Inverse Funnel Shape", x = "X Values", y = "Y Values" )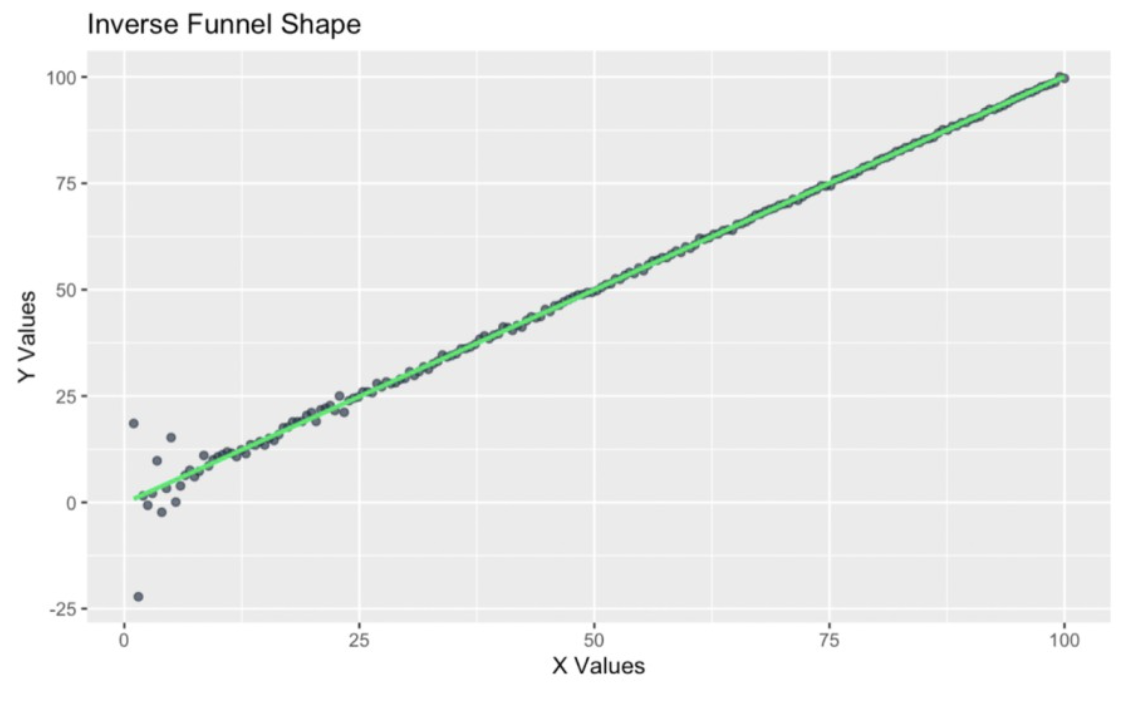
Hình phễu ngược trong phần dư. Ảnh: Tác giả
Xem ví dụ cuối cùng với thu nhập hộ gia đình. Ở đây, chúng ta xem phương sai chu kỳ, cụ thể là biến thiên chi tiêu theo mùa. Bạn có thể nhận ra kiểu mẫu này nếu bạn đã học một trong các khóa dự báo của chúng tôi, như Forecasting in R rất phổ biến.
Chúng ta biết chi tiêu hộ gia đình thường dao động theo chu kỳ trong năm. Ví dụ, phương sai có thể tăng trong mùa lễ vì chúng ta mua quà hoặc đi thăm gia đình, và phương sai giảm ở các tháng ít ngày lễ hơn, có thể là tháng Ba hoặc Chín. Biểu đồ sau cho thấy heteroscedasticity nhưng theo cách phức tạp hơn, khi nó tăng giảm ở các giai đoạn khác nhau.
ggplot(heteroscedasticity_data, aes(x = x, y = y_cyclical)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Cyclical Pattern", x = "X Values", y = "Y Values" )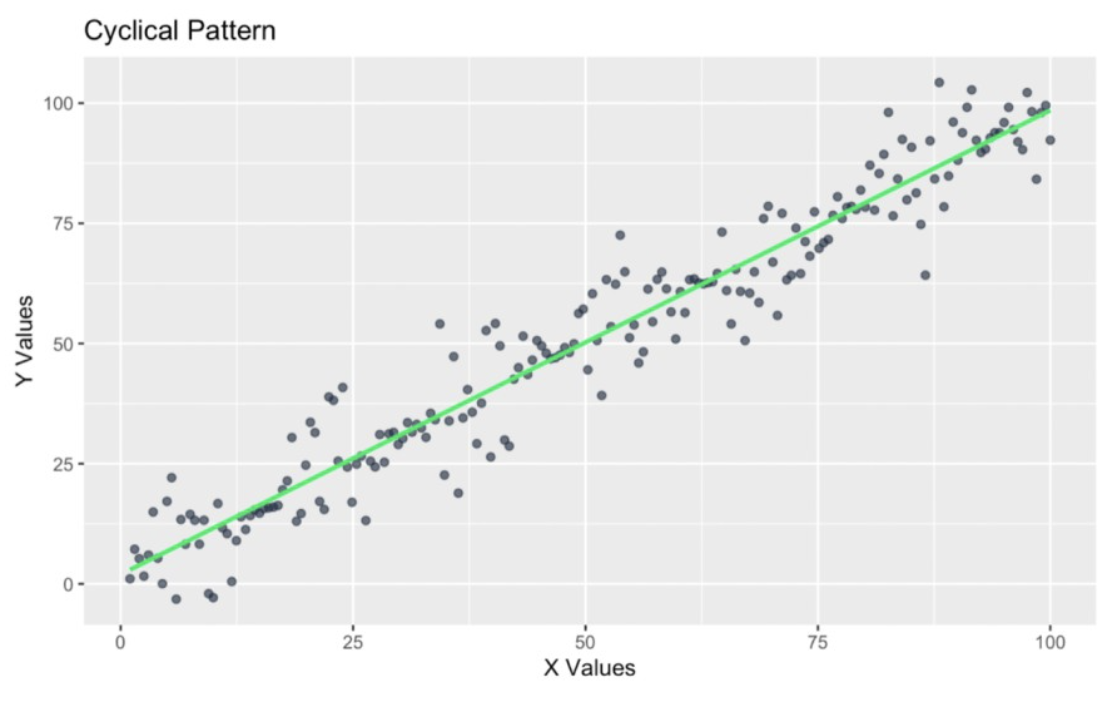
Mẫu chu kỳ trong phần dư. Ảnh: Tác giả
Như bạn thấy, heteroscedasticity có thể xuất hiện dưới nhiều dạng. Giờ hãy xem vì sao điều này quan trọng.
Tôi dám nói rằng, nói chung, bạn khó có thể làm hồi quy đúng nếu không hiểu gì đó về heteroscedasticity, vì nó rất phổ biến và có thể gây méo kết quả lớn.
Có lẽ vì lý do này mà homoscedasticity — đối lập với heteroscedasticity — thực ra là một trong các giả định chính của mô hình hồi quy, cùng với tính tuyến tính, tính độc lập của sai số, tính chuẩn của phần dư, và không có đa cộng tuyến.
Những giả định hồi quy này quan trọng vì chúng giúp đảm bảo dự đoán và suy luận từ mô hình có ý nghĩa. Khi giả định bị vi phạm, độ tin cậy của ước lượng, bao gồm sai số chuẩn và khoảng tin cậy, có thể suy giảm, và các kiểm định giả thuyết của chúng ta kém giá trị hơn.
Heteroscedasticity không xuất hiện từ hư không. Gốc rễ của nó thường nằm ở cách dữ liệu được thu thập hoặc được biến đổi. Hãy xem cả vấn đề biến đổi dữ liệu và thu thập dữ liệu.
Đôi khi, chính các bước chúng ta thực hiện để chuẩn bị dữ liệu lại đưa heteroscedasticity vào. Tôi đang nghĩ đến việc chuẩn hóa sai hoặc các biến đổi phi tuyến có thể tạo ra biến thiên ngoài ý muốn.
Để hình dung, giả sử chúng ta nghiên cứu mối quan hệ giữa diện tích căn hộ và tiền thuê hàng tháng. Thông thường, ta có thể kỳ vọng mối quan hệ tuyến tính giữa diện tích và tiền thuê vì căn hộ lớn hơn thì đắt hơn, và phương sai tiền thuê có thể không nhất thiết tăng theo diện tích vì mối quan hệ (có thể) tỷ lệ. Trông sẽ như sau:
set.seed(1024)size <- runif(1000, 500, 2000) # Random sizes between 500 and 2000 sq ftrent <- 20 * size + rnorm(100, mean = 0, sd = 5000) # Linear relation with added noiseunequal_variance_df <- data.frame(size = size, rent = rent)ggplot(unequal_variance_df, aes(x = size, y = rent)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size vs. Rent", x = "Size (sq ft)", y = "Rent")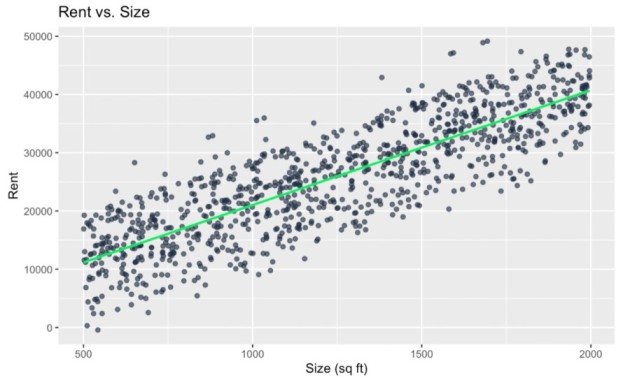
Không có heteroscedasticity. Ảnh: Tác giả
Nếu ta chia tiền thuê cho diện tích để tính “giá thuê trên mỗi foot vuông”, chúng ta tạo ra một chỉ số mới. Nếu sau đó cố dự đoán giá thuê trên mỗi foot vuông theo tiền thuê, ta có thể thấy phép biến đổi này tạo ra hoặc phóng đại heteroscedasticity. Rõ ràng, nói chung, tôi thừa nhận đây không phải ý hay — chia biến độc lập cho biến phụ thuộc — vì ta đang tạo tình huống y đã bị ảnh hưởng bởi x và do đó tạo tương quan giả. Vậy nên tôi nhận ra điều này tạo thách thức về khái niệm và thống kê. Nhưng (hãy kiên nhẫn) tôi dùng ví dụ này để minh họa điểm cần nói:
unequal_variance_df$rent_per_sqft <- unequal_variance_df$rent / unequal_variance_df$siz eggplot(unequal_variance_df, aes(x = size, y = rent_per_sqft)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size vs. Rent per Square Foot", x = "Size (sq ft)", y = "Rent per Sq Ft")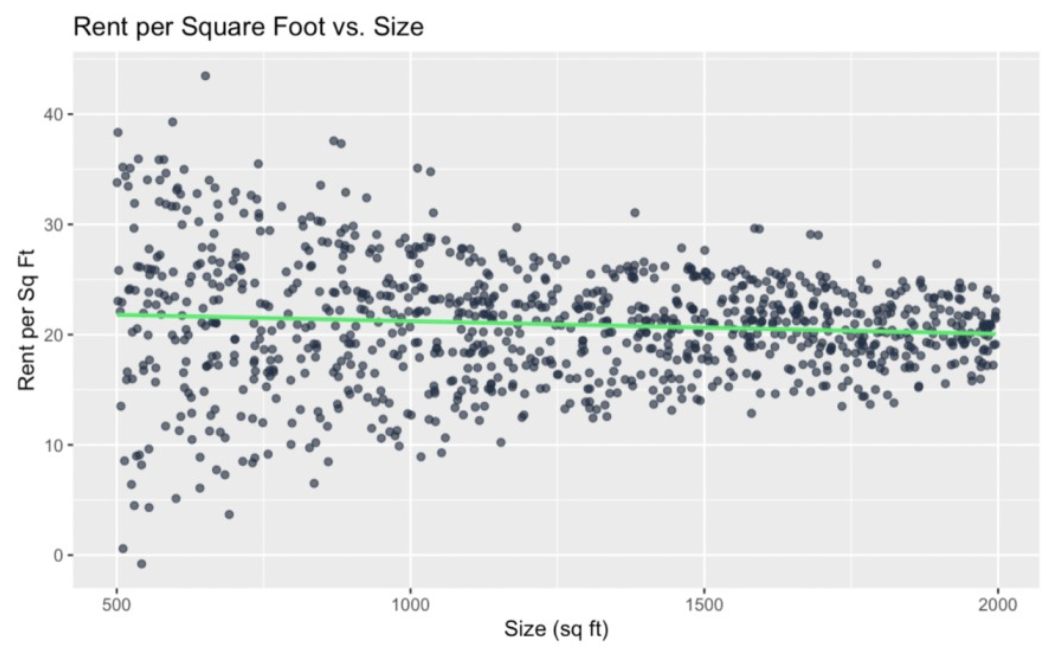
Heteroscedasticity phát sinh do phụ thuộc hàm. Ảnh: Tác giả
Ta thấy biểu đồ có hình phễu trong đó biến thiên của giá thuê trên mỗi foot vuông giảm khi diện tích tăng. Tức là chúng ta đã tạo heteroscedasticity từ con số không. Ví dụ khác, ta có thể bình phương cả hai biến:
unequal_variance_df$size_squared <- unequal_variance_df$size^2ggplot(unequal_variance_df, aes(x = size ^ 2, y = rent ^ 2)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size Squared vs. Rent Squared", x = "Size Squared", y = "Rent Squared")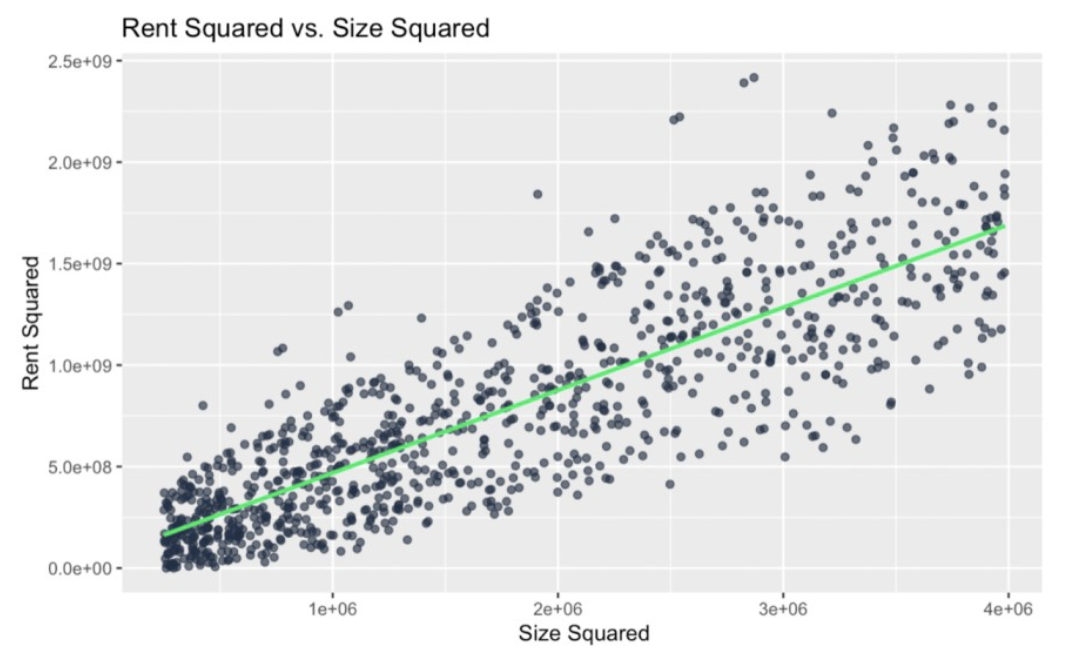
Heteroscedasticity phát sinh do bình phương. Ảnh: Tác giả
Một lần nữa, chúng ta đã tạo heteroscedasticity nơi trước đó không có, vì cứ nhất quyết bình phương cả x và y. Trong vài bối cảnh, điều này không sao, nhưng ở đây tôi đoán rằng bình phương cả hai biến sẽ tạo heteroscedasticity vì phép biến đổi sẽ khuếch đại khác biệt về phương sai khi giá trị biến tăng.
Ví dụ thứ hai này cũng hơi gượng ép vì ta không nên xây mô hình như vậy. Ta sẽ không làm vì nó khó diễn giải mà không có lý do chính đáng. Tuy nhiên, trong quy trình mô hình hóa thực tế, các biến đổi vô tình tạo heteroscedasticity có thể tinh vi hơn. Bạn có thể bỏ lỡ nếu quy trình gồm nhiều bước.
Cụ thể hơn, trong trường hợp này, heteroscedasticity xuất phát từ kỹ thuật đặc trưng với tỷ số. Tỷ số như “giá thuê trên mỗi foot vuông” thực sự phổ biến trong kỹ thuật đặc trưng. Tuy nhiên, các biến này có thể đưa vào heteroscedasticity nếu đặc biệt mẫu số biến thiên mạnh giữa các quan sát. Các biến đổi logarit hoặc hàm mũ cũng thường được dùng để ổn định phương sai hoặc tuyến tính hóa quan hệ. Tuy nhiên, áp dụng không nhất quán có thể phản tác dụng. Giả sử bạn có mô hình log-transform thu nhập nhưng không điều chỉnh các đặc trưng liên quan như chi tiêu. Sự lệch pha kiểu này là nguồn heteroscedasticity phổ biến, nên hãy đảm bảo mọi thứ “ăn khớp” để không tạo động lực giả.
Heteroscedasticity cũng có thể bắt nguồn từ thực hành thu thập dữ liệu không nhất quán. Ví dụ, thay đổi công cụ đo lường giữa chừng một nghiên cứu có thể gây heteroscedasticity. Có các nhóm kích thước khác nhau và do đó kích thước mẫu khác nhau trong một nghiên cứu cũng có thể tạo heteroscedasticity. Duy trì một cách tiếp cận nhất quán là quan trọng.
Phát hiện heteroscedasticity là bước đầu để xử lý, và may mắn là có cả công cụ trực quan lẫn thống kê để hỗ trợ.
Biểu đồ phân tán có thể hé lộ các mẫu giúp phát hiện heteroscedasticity. Tôi thích biểu đồ giá trị dự đoán so với phần dư cho mục đích này. Lưu ý, biểu đồ tần suất phần dư hoặc biểu đồ q-q của phần dư là chưa đủ để phát hiện heteroscedasticity vì hai biểu đồ này chủ yếu dùng để kiểm tra tính chuẩn.
y_funnel <- x + rnorm(length(x), mean = 0, sd = x * 0.5)heteroscedasticity_data <- data.frame(x, y_funnel)unequal_variance_model <- lm(y_funnel ~ x, heteroscedasticity_data)fitted_values_vs_residuals <- ggplot(data = unequal_variance_model, aes(x = .fitted, y = .resid)) + geom_point(color = '#203147') + geom_hline(yintercept = 0, linetype = "dashed", color = '#01ef63', size = 1) + xlab("fitted values") + ylab("residuals") + labs(title = "Heteroscedasticity Data") + labs(subtitle = "Fitted Values vs Residuals")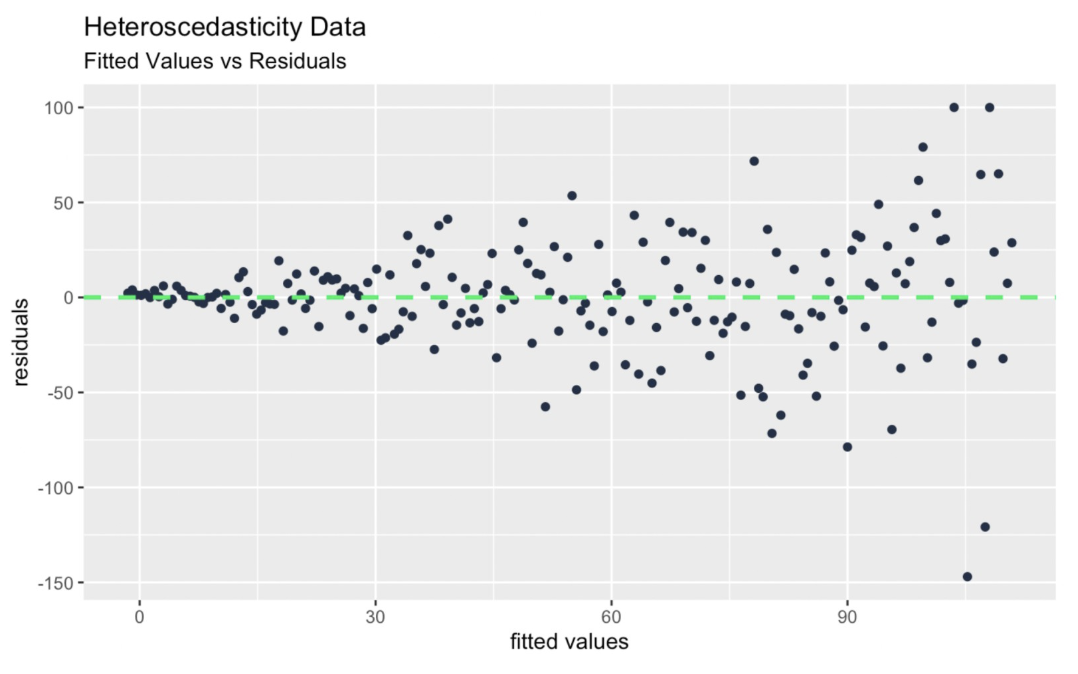 Biểu đồ chẩn đoán giá trị dự đoán vs. phần dư. Ảnh: Tác giả
Các kiểm định thống kê như kiểm định Breusch–Pagan cung cấp cách tiếp cận định lượng hơn. Breusch–Pagan hoạt động bằng cách xem liệu bình phương phần dư từ mô hình có liên quan đến các biến dự báo hay không. Để thực hiện kiểm định, ta ước lượng mô hình và dùng hàm bptest() từ thư viện lmtest. Lưu ý kiểm định này giả định phần dư chuẩn.
library(lmtest)model <- lm(rent ~ size, data = unequal_variance_df)bp_test <- bptest(model)print(bp_test)Sau khi đã nhận diện heteroscedasticity, bước tiếp theo là xử lý nó bằng các kỹ thuật đã được kiểm chứng.
Các biến đổi đơn giản, như lấy logarit, thường có thể giảm hoặc loại bỏ heteroscedasticity. Trước đó, ta lấy một mô hình không có phương sai không đồng nhất, áp dụng biến đổi và tạo ra vấn đề, nhưng tự nhiên quy trình ngược lại mới thường xảy ra: Chúng ta dùng các biến đổi như logarit, căn bậc hai, hoặc nghịch đảo để nén các giá trị lớn đồng thời giãn các giá trị nhỏ. Ví dụ, nếu tiền thuê tăng theo hàm mũ với diện tích, lấy log của tiền thuê sẽ làm phẳng tăng trưởng hàm mũ và khiến quan hệ trở nên tuyến tính với (có thể) phương sai bằng nhau.
Ngoài ra, tôi muốn lưu ý rằng khi tiền xử lý dữ liệu, chúng ta thường nghĩ về việc sửa lệch. Ví dụ, nếu dữ liệu lệch phải, ta có thể dùng biến đổi căn bậc hai để làm dữ liệu Gaussian. Nhưng điều có thể chưa được đánh giá đúng mức là trong dữ liệu lệch, các giá trị lớn cũng có xu hướng có biến thiên cao hơn, điều này cũng vi phạm giả định homoscedasticity.
Khi các biến đổi là chưa đủ, các phương pháp hồi quy vững như bình phương tối thiểu có trọng số (WLS) có thể hữu ích. WLS đặc biệt đáng chú ý ở đây vì nó được thiết kế để xử lý các vấn đề dữ liệu như heteroscedasticity và ngoại lệ. Cụ thể, WLS gán trọng số cho các quan sát dựa trên phương sai của chúng, nhờ đó giảm ảnh hưởng của các điểm dữ liệu có biến thiên cao và mang lại ước lượng ổn định hơn. Lưu ý, với WLS, ta giả định trọng số được biết rõ hoặc ước lượng tốt.
Bỏ qua heteroscedasticity có thể trông vô hại, nhưng nó có thể dẫn đến vấn đề.
Heteroscedasticity có thể làm sai lệch cách mô hình diễn giải mức độ quan trọng của đặc trưng. Ví dụ, trong mô hình chi tiêu, các đặc trưng như thu nhập có thể có vẻ quan trọng hơn nếu chúng gắn với các nhóm có biến thiên cao, chẳng hạn hộ thu nhập cao với chi tiêu tùy ý. Sự sai lệch này có thể khiến chúng ta đề cao quá mức các biến dự báo kém tin cậy trong khi đánh giá thấp các biến nhất quán hơn, làm giảm tính hữu dụng của mô hình.
Heteroscedasticity có thể làm mất hiệu lực việc dùng các kiểm định thống kê phổ biến như t-test hoặc F-test nếu bạn giả định phương sai bằng nhau nhưng giả định này không thỏa. Phương sai không đồng nhất cũng gây vấn đề trong dữ liệu chuỗi thời gian, nơi các mẫu biến thiên tiến hóa theo thời gian, dẫn đến nhầm lẫn khi phân tích xu hướng mùa vụ. Sai số chuẩn vững với heteroscedasticity (HCSE) có thể được dùng để hỗ trợ suy luận thống kê đáng tin cậy hơn.
Trong bài này, chúng ta đã nghiên cứu tình huống phương sai của phần dư không hằng theo các mức của biến độc lập trong một mô hình. Ở đây, tôi muốn nói ngắn gọn về một ý tưởng liên quan, đó là không đồng nhất phương sai ở cấp nhóm, đề cập đến biến thiên giữa các nhóm xác định trước, ít mang tính vấn đề thống kê gắn với giả định mô hình hơn mà thiên về quan sát mô tả dữ liệu.
Tôi sẽ minh họa bằng ví dụ cuối cùng. Ở đây, tôi dùng mô phỏng dữ liệu khảo sát. Tôi xét kịch bản dữ liệu thu nhập được thu thập bằng hai phương pháp: khảo sát và hồ sơ hành chính. Các phương pháp này có thể có mức độ chính xác khác nhau (Khảo sát vốn “nổi tiếng” mà?). Ta có thể thấy mức độ biến thiên trong mỗi nhóm không nhất quán, điều này có thể là vấn đề với thứ như ANOVA.
set.seed(1024)income_admin <- rnorm(500, mean = 50000, sd = 2000) spending_admin <- income_admin * 0.3 + rnorm(500, mean = 0, sd = 1000)income_survey <- rnorm(500, mean = 50000, sd = 8000) # Same mean, higher SDspending_survey <- income_survey * 0.3 + rnorm(500, mean = 0, sd = 5000)income <- c(income_admin, income_survey)spending <- c(spending_admin, spending_survey)method <- rep(c("Administrative Records", "Survey"), each = 500)survey_and_admin_data <- data.frame(income = income, spending = spending, method = method) # Plot the datacustom_colors <- c("Administrative Records" ='#01ef63', "Survey" = '#203147')ggplot(survey_and_admin_data, aes(x = income, y = spending, color = method)) + geom_point(alpha = 0.7) + labs( title = "Variability in Data Collection", x = "Income", y = "Spending")+ scale_color_manual(values = custom_colors)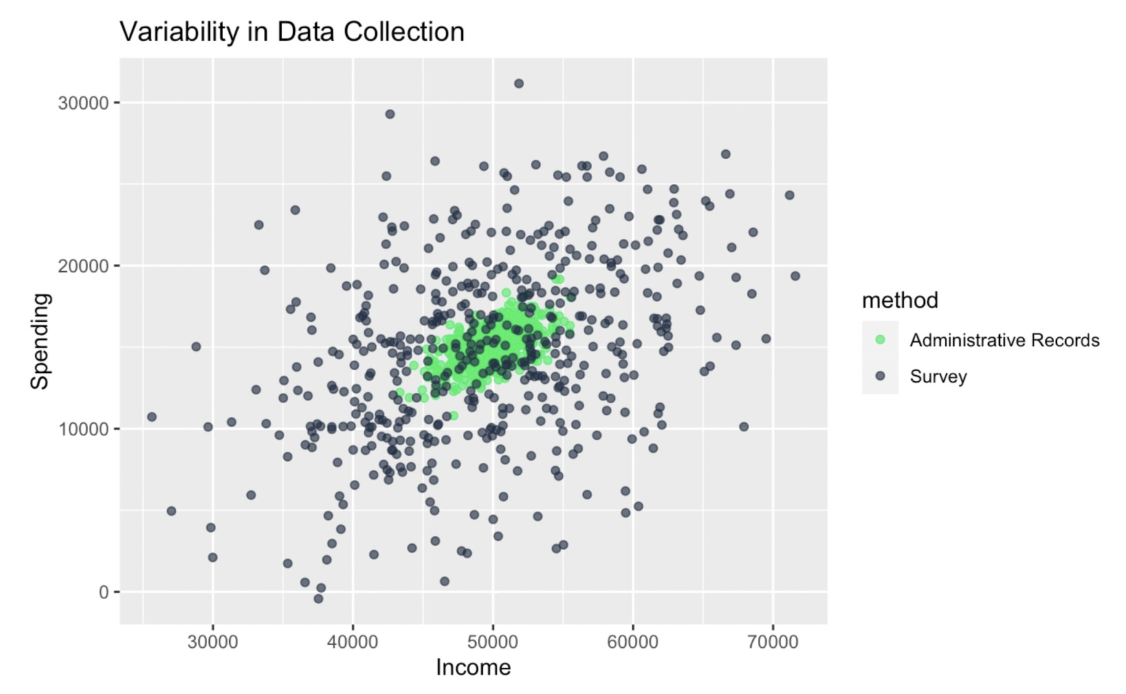
Không đồng nhất phương sai ở cấp nhóm. Ảnh: Tác giả
Xử lý heteroscedasticity không chỉ là cải thiện mô hình hồi quy của bạn. Đó là đảm bảo công việc của bạn đứng vững trước sự thẩm định. Để tiếp tục học và trở thành chuyên gia, hãy tham gia lộ trình Statistical Inference in R và khóa Foundations of Inference in R. Tôi cũng nghĩ lộ trình Statistician in R là lựa chọn tuyệt vời khác cho cả học tập và phát triển sự nghiệp.
Học hồi quy với DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
