Trong lịch sử, nhiều mô hình máy học được thiết kế để học theo từng nhiệm vụ cụ thể, đòi hỏi các bộ dữ liệu lớn cho mỗi nhiệm vụ mới. Với những giới hạn kỹ thuật thời bấy giờ, cách tiếp cận hiệu quả nhất là huấn luyện mô hình máy học bằng một bộ dữ liệu khổng lồ, chuyên biệt cho từng nhiệm vụ. Kết quả là các mô hình tối tân có thể dự đoán cực kỳ chính xác kết quả của vấn đề mà chúng được huấn luyện. Tuy nhiên, các mô hình này vẫn còn cách xa con người với năng lực đáng kinh ngạc là học các nhiệm vụ mới dựa trên trải nghiệm trước đó.
Bổ sung các chiến lược học thích nghi vào mô hình máy học là sứ mệnh trọng tâm của meta learning, một phân ngành của máy học tập trung vào việc cải thiện cách các mô hình học các nhiệm vụ mới một cách hiệu quả. Meta learning chú trọng dạy mô hình thích ứng nhanh với ít tái huấn luyện và ít can thiệp của con người, đồng thời cải thiện hiệu suất theo thời gian.
Trong bài viết này, chúng tôi sẽ giới thiệu về meta learning và cách nó đang cách mạng hóa máy học. Chúng tôi sẽ đề cập đến các khía cạnh kỹ thuật của mô hình meta learning, những cách tiếp cận và ứng dụng phổ biến nhất, cũng như lợi ích và thách thức. Sau đó, tôi khuyến khích bạn thử học lộ trình kỹ năng AI Fundamentals để thực sự tự tin khi nói về các khái niệm khác nhau và liên quan trong AI.
Nghiên cứu về meta learning bắt đầu từ những năm 1980, nhưng lĩnh vực này trở nên nổi bật trong thập niên 2010, cùng sự trỗi dậy của mạng nơ-ron và gần đây là sự phát triển của AI sinh tạo. Meta learning, với tư cách một phân ngành của máy học, tập trung vào việc dạy mô hình cách học các nhiệm vụ mới nhanh chóng và hiệu quả. Nó lấy cảm hứng từ khả năng “học cách học” của con người.
Hãy tưởng tượng bạn muốn học cách giải bài toán thật nhanh. Cách tiếp cận truyền thống là ghi nhớ lời giải cho nhiều dạng bài khác nhau, để khi gặp bài quen thuộc, bạn có thể nhớ đáp án ngay. Tuy nhiên, cách này gặp khó khi bạn đối mặt với một bài hoàn toàn mới.
Thay vào đó, nếu bạn tập trung học các chiến lược giải quyết vấn đề nói chung thay vì ghi nhớ lời giải cụ thể thì sao? Bạn có thể học các kỹ thuật giải bài, nhận diện mẫu hình và phát triển trực giác để tiếp cận thử thách mới. Nhờ vậy, khi gặp một bài mới, bạn có thể nhanh chóng thích ứng và áp dụng phương pháp phù hợp, dù trước đó chưa từng thấy đúng bài đó.
Đó chính là bản chất của meta learning. Máy học truyền thống ghi nhớ các mẫu từ bộ dữ liệu lớn cho một nhiệm vụ duy nhất, trong khi meta learning huấn luyện mô hình nhanh chóng thích ứng với các nhiệm vụ mới bằng cách học cách học một cách hiệu quả.
Bạn có thể hình dung mô hình meta learning như một hệ thống bao gồm một phân hệ học được điều chỉnh linh hoạt bằng cách khai thác kinh nghiệm từ các lần học trước đó hoặc từ các nhiệm vụ khác nhau.
Trái với các mô hình máy học truyền thống chỉ xét một nhiệm vụ với bộ dữ liệu cố định và lớn, các mô hình meta được tiếp xúc với nhiều nhiệm vụ để trích xuất các mẫu có thể khái quát hóa. Thông thường, mỗi vấn đề đi kèm một bộ dữ liệu huấn luyện nhỏ hơn, chuyên biệt cho nhiệm vụ.
Mục tiêu của quá trình meta training là rút trích thông tin tổng quát về quy trình học trên từng nhiệm vụ nhằm cải thiện khả năng của mô hình trong việc giải quyết các nhiệm vụ mới với rất ít tái huấn luyện.
Phát triển các mô hình meta learning thường theo quy trình hai bước, “tái lấy mẫu” quá trình huấn luyện của máy học truyền thống:
- Meta-training. Ở giai đoạn này, mô hình được huấn luyện trên nhiều nhiệm vụ, mỗi nhiệm vụ gồm một mẫu dữ liệu huấn luyện (gộp lại thành meta train dataset) và, trong nhiều trường hợp, siêu dữ liệu của mô hình như tham số mô hình và thước đo hiệu suất. Mục tiêu là khám phá các mẫu chung có thể khái quát hóa để trang bị cho mô hình kiến thức rộng, dùng được cho các nhiệm vụ mới.
- Meta-testing. Trong giai đoạn meta testing, mô hình được đưa đối mặt với các nhiệm vụ hoàn toàn mới chưa từng gặp trong huấn luyện. Mục tiêu là đánh giá hiệu suất bằng cách đo khả năng và tốc độ thích ứng với môi trường và nhiệm vụ mới.
Quy trình meta-training và meta-testing được minh họa trong hình sau.
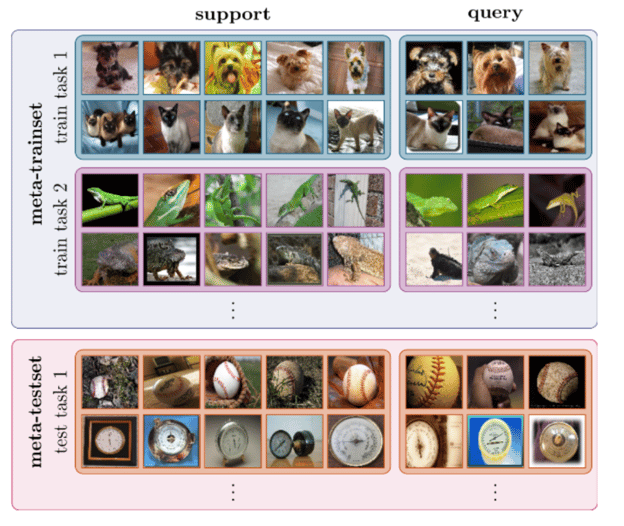
Meta learning cho phân loại ảnh. Nguồn: Dida
Meta learning có thể được dùng để giải quyết mọi dạng máy học, dù là học có giám sát, không giám sát, hay tăng cường.
Có nhiều cách tiếp cận với meta learning. Dưới đây là ba nhóm phổ biến nhất:
Các mô hình meta learning dựa trên mô hình được thiết kế riêng cho việc học nhanh, nghĩa là chúng có thể cập nhật tham số chỉ với vài bước huấn luyện. Việc cập nhật nhanh này có thể đạt được nhờ kiến trúc bên trong hoặc được điều khiển bởi một mô hình meta-learner khác.
Dưới đây là danh sách các chiến lược meta learning dựa trên mô hình thường gặp:
- Memory-Augmented Neural Networks (MANNs). Được các nhà nghiên cứu Google giới thiệu trong một bài báo năm 2016, MANN là các mô hình nơ-ron được trang bị mô-đun bộ nhớ ngoài cho phép chúng nhanh chóng mã hóa và truy xuất thông tin mới và đưa ra dự đoán chính xác chỉ sau vài mẫu. Khi dữ liệu mới được nạp vào, các mạng này dịch chuyển thiên lệch thông qua cập nhật trọng số, đồng thời điều biến đầu ra bằng cách học cách lưu nhanh các biểu diễn vào vùng nhớ.
- Meta Networks. Meta Networks, hay MetaNets, là một dạng mô hình meta learning do Munkhdalai và Yu đề xuất trong bài báo năm 2017. Meta networks gồm hai mô hình: một meta learner và một base learner. Base learner hoạt động như mạng nơ-ron truyền thống: nhận một nhiệm vụ đầu vào và gửi siêu thông tin về không gian nhiệm vụ hiện tại cho meta learner. Thông tin này được meta learner dùng để cập nhật nhanh trọng số của mô hình.
Meta learning dựa trên độ đo tập trung vào việc học một độ đo khoảng cách để tính độ tương đồng hay khác biệt giữa các cặp điểm dữ liệu. Điểm cao trả về khi các đối tượng giống nhau và điểm thấp khi ảnh hoặc đối tượng khác nhau.
Ý tưởng cốt lõi của cách tiếp cận này tương tự các thuật toán láng giềng gần nhất như K-NN hoặc K-means, vốn dùng khoảng cách giữa các điểm dữ liệu để phân loại hoặc phân cụm.
So với các bài toán phân loại truyền thống, nơi cần rất nhiều dữ liệu huấn luyện, các mô hình dựa trên độ đo có thể hoạt động chỉ với vài ví dụ.
Một số mô hình phổ biến tận dụng chiến lược meta learning dựa trên độ đo gồm:
- Mạng nơ-ron Siamese tích chập. Mạng Siamese là một loại mạng nơ-ron được thiết kế cho các tác vụ đo độ tương đồng hoặc học độ đo, như xác minh khuôn mặt. Mô hình gồm hai mạng “sinh đôi” và đầu ra của chúng được huấn luyện chung bằng một hàm để học mối quan hệ giữa các cặp mẫu dữ liệu đầu vào. Hai mạng sinh đôi giống nhau, chia sẻ cùng trọng số và tham số mạng.
- Matching networks. Do các nhà nghiên cứu Google phát triển trong một bài báo năm 2016, Matching networks dùng một độ đo gọi là độ tương đồng cosine giữa hai mẫu để phân loại. Kiến trúc matching network sử dụng mạng nơ-ron tăng cường bộ nhớ gồm bộ nhớ ngoài và cơ chế chú ý để truy cập bộ nhớ.
- Prototypical networks. Trình bày trong một bài báo năm 2017 của Snell và cộng sự, prototypical networks học một không gian nhúng mà trong đó việc phân loại được thực hiện bằng cách tính khoảng cách đến các biểu diễn nguyên mẫu của mỗi lớp. Chúng dựa trên giả định rằng tồn tại một không gian nhúng nơi nhiều điểm tụ quanh một biểu diễn nguyên mẫu duy nhất cho mỗi lớp.
Mạng nơ-ron dùng lan truyền ngược gradient để giảm dần lỗi của mô hình và cải thiện hiệu suất. Hàm tối ưu chịu trách nhiệm tìm cách hiệu quả nhất để tính lại trọng số và độ lệch của mạng. Tuy nhiên, đa số hàm tối ưu phổ biến được thiết kế cho lượng dữ liệu huấn luyện rất lớn, thay vì các bộ dữ liệu nhỏ.
Meta learning dựa trên tối ưu hóa tập trung vào việc thiết kế các hàm tối ưu mới có thể cập nhật tham số mô hình chỉ với một bộ dữ liệu huấn luyện nhỏ, nhờ đó thích ứng nhanh với nhiệm vụ mới.
Trong số các mô hình meta learning dựa trên tối ưu hóa phổ biến có:
- LSTM meta-learner. Cách tiếp cận này, do Ravi và Larochelle trình bày trong năm 2017, sử dụng mạng bộ nhớ ngắn-dài (LSTM) để huấn luyện một meta-learner có thể học chính thuật toán tối ưu được dùng để huấn luyện một bộ phân loại mạng nơ-ron khác, từ đó tăng tốc cập nhật tham số để hội tụ nhanh trong các kịch bản nhiệm vụ mới với dữ liệu huấn luyện hạn chế.
- Model-Agnostic Meta Learning (MAML). Được Finn và cộng sự giới thiệu trong một bài báo năm 2017, MAML tương thích với mọi mô hình được huấn luyện bằng gradient descent và áp dụng cho đa dạng bài toán học khác nhau, gồm phân loại, hồi quy và học tăng cường. MAML dựa trên giả định rằng huấn luyện tham số khởi đầu của mô hình sao cho chỉ cần vài bước cập nhật gradient sẽ dẫn đến việc học nhanh trên nhiệm vụ mới. Mục tiêu là xác định các tham số mô hình nhạy với thay đổi của nhiệm vụ để chỉ những thay đổi nhỏ ở tham số cũng mang lại cải thiện lớn ở hàm mất mát của nhiệm vụ.
- Reptile. Do OpenAI phát triển, Reptile là một thuật toán meta learning dựa trên gradient bậc nhất. Thuật toán lặp lại việc lấy mẫu một nhiệm vụ, thực hiện stochastic gradient descent trên nhiệm vụ đó, và cập nhật tham số khởi đầu theo hướng các tham số cuối cùng học được trên nhiệm vụ. Reptile là ứng dụng của thuật toán Shortest Descent trong bối cảnh meta learning và về mặt toán học tương tự MAML, với hiệu quả tính toán và hiệu năng tương đương.
Trái với các phương pháp học có giám sát truyền thống đòi hỏi lượng dữ liệu khổng lồ, meta learning mang đến một bước chuyển mô hình, giúp các mô hình AI khái quát hóa qua nhiều nhiệm vụ, thích ứng nhanh với tối thiểu dữ liệu và cải thiện hiệu suất theo thời gian.
Hãy cùng phân tích một số ứng dụng hứa hẹn nhất:
Few-shot learning
Few-shot learning là một phân nhánh của máy học, nơi mô hình học nhận diện mẫu và đưa ra dự đoán dựa trên số lượng hạn chế ví dụ huấn luyện. Few-shot learning nhấn mạnh khả năng khái quát hơn là ghi nhớ, thách thức nhu cầu tinh chỉnh sâu rộng. Theo hướng tiếp cận này, chìa khóa nằm ở khả năng nắm bắt cấu trúc và đặc trưng nền tảng định nghĩa một nhóm đối tượng.
Few-shot learning thuộc “ô” rộng hơn là n-shot learning, bao trùm nhiều kỹ thuật dựa trên số lượng ví dụ được cung cấp:
- Zero-shot learning: Không có ví dụ; mô hình chỉ dựa vào kiến thức hoặc mô tả có sẵn.
- One-shot learning: Chỉ có một ví dụ cho mỗi lớp.
- Two-shot learning: Có hai ví dụ cho mỗi lớp để huấn luyện.
- Few-shot learning: Có một số ít ví dụ (thường từ 3 đến 10) cho mỗi lớp.
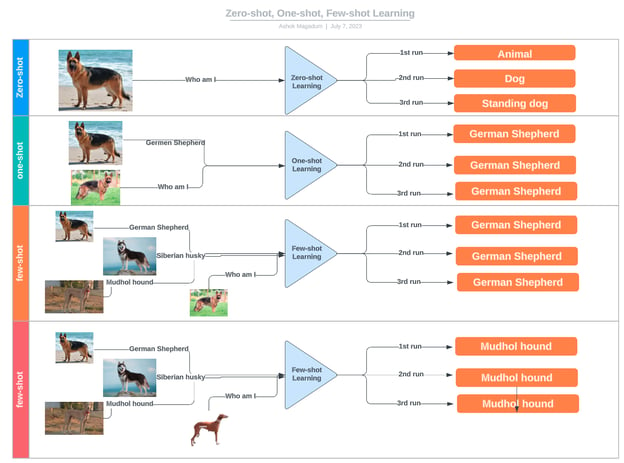
Ví dụ về zero-shot, one-shot và few-shot learning. Nguồn: LinkedIn
Transfer learning
Transfer learning cho phép một mô hình được huấn luyện cho một nhiệm vụ được tái sử dụng cho một nhiệm vụ khác nhưng có liên quan, thường bằng cách fine-tune một mô hình đã được huấn luyện trước. Ngược lại, meta learning tập trung vào việc dạy mô hình cách thích ứng nhanh với các nhiệm vụ mới với tối thiểu tái huấn luyện. Dù meta learning có thể tăng cường transfer learning trong một số trường hợp, chẳng hạn tối ưu siêu tham số hoặc chọn chiến lược fine-tune tốt nhất, nó không phải là thành phần bắt buộc của transfer learning. Nhiều phương pháp transfer learning chỉ dựa vào các kỹ thuật fine-tune thông thường thay vì meta learning.
Hệ thống gợi ý
Hệ thống gợi ý sử dụng phản hồi của người dùng để tìm các mục phù hợp mới cho họ hoặc cho những người khác, dựa trên giả định rằng người dùng có sở thích tương tự trong quá khứ có khả năng tiếp tục có sở thích tương tự trong tương lai.
Mục tiêu của hệ thống gợi ý là cung cấp đề xuất cá nhân hóa dựa trên sở thích và hành vi trước đây. Meta learning có thể hỗ trợ mục tiêu này bằng cách học cách tối ưu thuật toán gợi ý cho từng người dùng.
Hệ thống meta-recommendation gồm hai lớp: một hệ gợi ý nền và một bộ tối ưu cấp meta. Hệ gợi ý nền tạo đề xuất dựa trên hành vi quá khứ của người dùng, trong khi bộ tối ưu cấp meta học cách tối ưu hệ gợi ý nền cho từng người dùng.
Tự động hóa máy học (AutoML)
Tự động hóa máy học, hay AutoML, là quá trình tự động hóa toàn bộ quy trình xây dựng mô hình máy học. Điều này bao gồm các tác vụ như tiền xử lý dữ liệu, kỹ thuật đặc trưng, lựa chọn mô hình và tinh chỉnh siêu tham số.
Các kỹ thuật meta learning có thể hỗ trợ các quy trình này, ví dụ bằng cách tự động hóa việc tối ưu và điều chỉnh siêu tham số, hoặc thậm chí tìm mô hình phù hợp nhất để giải một nhiệm vụ cụ thể.
Có nhiều lý do thuyết phục khiến các nhà nghiên cứu máy học ngày càng chuyển sang chiến lược meta learning để phát triển mô hình.
-
Hiệu quả huấn luyện: Meta learning rút ngắn thời gian huấn luyện bằng cách tránh phải huấn luyện với các bộ dữ liệu khổng lồ và cho phép fine-tune với dữ liệu hạn chế.
-
Giảm chi phí vận hành: Meta learning giảm chi phí bằng cách không cần huấn luyện mô hình từ đầu, trong khi cả việc thu thập dữ liệu và sử dụng tài nguyên tính toán để huấn luyện đều có thể tốn kém.
-
Tăng khả năng thích ứng và tái sử dụng: Meta learning là kỹ thuật then chốt giúp mô hình thích ứng với nhiều bối cảnh và nhiệm vụ, từ đó tăng tiềm năng và tính hữu dụng.
-
Hiệu suất mô hình: Bên cạnh tăng khả năng thích ứng, meta learning cũng có thể cải thiện độ chính xác của các mô hình máy học hiện có.
Tuy nhiên, meta learning không phải là chiến lược “một cho tất cả”. Nó có những hạn chế và rủi ro cần được xử lý cẩn thận. Một số thách thức thường gặp trong meta learning gồm:
-
Không khớp miền: Meta learning có xu hướng hoạt động tốt hơn khi nhiệm vụ nguồn và đích có mức độ liên quan nhất định. Nếu nhiệm vụ mới quá khác biệt, kiến thức khái quát chuyển giao có thể không đủ để thực hiện chính xác, thậm chí làm giảm hiệu suất ở mọi nhiệm vụ.
-
Thiếu dữ liệu: Luôn cần một lượng dữ liệu huấn luyện nhất định. Nếu dữ liệu quá ít hoặc chất lượng kém, mô hình có khả năng bị underfitting.
-
Overfitting: Meta learning cũng không miễn nhiễm với overfitting. Nếu mô hình được fine-tune quá mức trên một nhiệm vụ, nó có thể học các đặc trưng quá đặc thù, không khái quát tốt sang dữ liệu mới.
-
Độ phức tạp và chi phí: Đôi khi, nhiệm vụ đích quá phức tạp khiến quá trình fine-tune trở nên thách thức, tốn kém tính toán và thời gian.
Meta learning là một cách tiếp cận thiết kế then chốt để tăng hiệu quả và tiềm năng của mạng nơ-ron. Có thể nói cuộc cách mạng AI hiện nay khó có thể đạt được nếu thiếu các kỹ thuật transfer learning đa dạng.
Lĩnh vực này đang phát triển nhanh chóng, với một số hướng cần nghiên cứu sâu hơn, bao gồm:
- Hiệu quả theo mẫu. Cần bao nhiêu dữ liệu để một mô hình trở nên hiệu quả trong các nhiệm vụ mới? Đây là câu hỏi trung tâm của meta learning. Dù các chiến lược học với ít mẫu cho thấy mô hình có thể học với dữ liệu hạn chế, vẫn còn nhiều dư địa cải tiến để làm cho mô hình hiệu quả và linh hoạt hơn.
- Đa dạng nhiệm vụ. Các kỹ thuật meta learning thường hoạt động tốt hơn khi các nhiệm vụ có liên quan phần nào. Tuy vậy, cần nghiên cứu thêm để phát triển các mô hình meta learning có thể khái quát trên phạm vi nhiệm vụ rộng mà không bị overfitting.
- Kỹ thuật tiên tiến. Meta learning là chất xúc tác trung tâm thúc đẩy đổi mới trong nhiều công nghệ hứa hẹn và giá trị hiện nay, bao gồm học tăng cường, robot và transformers.
Kết luận
Khi các mô hình máy học ngày càng lớn và phức tạp, việc tìm ra các kỹ thuật mới để khiến chúng hiệu quả và linh hoạt hơn là tối quan trọng để ngành AI thực hiện được kỳ vọng, đảm bảo bài toán chi phí, và thúc đẩy tính bền vững trong lĩnh vực này.
Meta learning có nhiều điều để nói trong khía cạnh này. Lĩnh vực nghiên cứu này đang phát triển nhanh, mang đến một tập hợp kỹ thuật và chiến lược then chốt để nâng cao năng lực của AI. Hãy theo dõi DataCamp để cập nhật tin tức mới nhất về meta learning, AI và nhiều nội dung khác:


Trong lịch sử, nhiều mô hình máy học được thiết kế để học theo từng nhiệm vụ cụ thể, đòi hỏi các bộ dữ liệu lớn cho mỗi nhiệm vụ mới. Với những giới hạn kỹ thuật thời bấy giờ, cách tiếp cận hiệu quả nhất là huấn luyện mô hình máy học bằng một bộ dữ liệu khổng lồ, chuyên biệt cho từng nhiệm vụ. Kết quả là các mô hình tối tân có thể dự đoán cực kỳ chính xác kết quả của vấn đề mà chúng được huấn luyện. Tuy nhiên, các mô hình này vẫn còn cách xa con người với năng lực đáng kinh ngạc là học các nhiệm vụ mới dựa trên trải nghiệm trước đó.
Bổ sung các chiến lược học thích nghi vào mô hình máy học là sứ mệnh trọng tâm của meta learning, một phân ngành của máy học tập trung vào việc cải thiện cách các mô hình học các nhiệm vụ mới một cách hiệu quả. Meta learning chú trọng dạy mô hình thích ứng nhanh với ít tái huấn luyện và ít can thiệp của con người, đồng thời cải thiện hiệu suất theo thời gian.
Trong bài viết này, chúng tôi sẽ giới thiệu về meta learning và cách nó đang cách mạng hóa máy học. Chúng tôi sẽ đề cập đến các khía cạnh kỹ thuật của mô hình meta learning, những cách tiếp cận và ứng dụng phổ biến nhất, cũng như lợi ích và thách thức. Sau đó, tôi khuyến khích bạn thử học lộ trình kỹ năng AI Fundamentals để thực sự tự tin khi nói về các khái niệm khác nhau và liên quan trong AI.
Meta Learning là gì?
Nghiên cứu về meta learning bắt đầu từ những năm 1980, nhưng lĩnh vực này trở nên nổi bật trong thập niên 2010, cùng sự trỗi dậy của mạng nơ-ron và gần đây là sự phát triển của AI sinh tạo. Meta learning, với tư cách một phân ngành của máy học, tập trung vào việc dạy mô hình cách học các nhiệm vụ mới nhanh chóng và hiệu quả. Nó lấy cảm hứng từ khả năng “học cách học” của con người.
Hãy tưởng tượng bạn muốn học cách giải bài toán thật nhanh. Cách tiếp cận truyền thống là ghi nhớ lời giải cho nhiều dạng bài khác nhau, để khi gặp bài quen thuộc, bạn có thể nhớ đáp án ngay. Tuy nhiên, cách này gặp khó khi bạn đối mặt với một bài hoàn toàn mới.
Thay vào đó, nếu bạn tập trung học các chiến lược giải quyết vấn đề nói chung thay vì ghi nhớ lời giải cụ thể thì sao? Bạn có thể học các kỹ thuật giải bài, nhận diện mẫu hình và phát triển trực giác để tiếp cận thử thách mới. Nhờ vậy, khi gặp một bài mới, bạn có thể nhanh chóng thích ứng và áp dụng phương pháp phù hợp, dù trước đó chưa từng thấy đúng bài đó.
Đó chính là bản chất của meta learning. Máy học truyền thống ghi nhớ các mẫu từ bộ dữ liệu lớn cho một nhiệm vụ duy nhất, trong khi meta learning huấn luyện mô hình nhanh chóng thích ứng với các nhiệm vụ mới bằng cách học cách học một cách hiệu quả.
Meta Learning vận hành như thế nào
Bạn có thể hình dung mô hình meta learning như một hệ thống bao gồm một phân hệ học được điều chỉnh linh hoạt bằng cách khai thác kinh nghiệm từ các lần học trước đó hoặc từ các nhiệm vụ khác nhau.
Trái với các mô hình máy học truyền thống chỉ xét một nhiệm vụ với bộ dữ liệu cố định và lớn, các mô hình meta được tiếp xúc với nhiều nhiệm vụ để trích xuất các mẫu có thể khái quát hóa. Thông thường, mỗi vấn đề đi kèm một bộ dữ liệu huấn luyện nhỏ hơn, chuyên biệt cho nhiệm vụ.
Mục tiêu của quá trình meta training là rút trích thông tin tổng quát về quy trình học trên từng nhiệm vụ nhằm cải thiện khả năng của mô hình trong việc giải quyết các nhiệm vụ mới với rất ít tái huấn luyện.
Phát triển các mô hình meta learning thường theo quy trình hai bước, “tái lấy mẫu” quá trình huấn luyện của máy học truyền thống:
Quy trình meta-training và meta-testing được minh họa trong hình sau.
Meta learning cho phân loại ảnh. Nguồn: Dida
Meta learning có thể được dùng để giải quyết mọi dạng máy học, dù là học có giám sát, không giám sát, hay tăng cường.
Các cách tiếp cận phổ biến trong Meta Learning
Có nhiều cách tiếp cận với meta learning. Dưới đây là ba nhóm phổ biến nhất:
Meta learning dựa trên mô hình
Các mô hình meta learning dựa trên mô hình được thiết kế riêng cho việc học nhanh, nghĩa là chúng có thể cập nhật tham số chỉ với vài bước huấn luyện. Việc cập nhật nhanh này có thể đạt được nhờ kiến trúc bên trong hoặc được điều khiển bởi một mô hình meta-learner khác.
Dưới đây là danh sách các chiến lược meta learning dựa trên mô hình thường gặp:
Meta learning dựa trên độ đo
Meta learning dựa trên độ đo tập trung vào việc học một độ đo khoảng cách để tính độ tương đồng hay khác biệt giữa các cặp điểm dữ liệu. Điểm cao trả về khi các đối tượng giống nhau và điểm thấp khi ảnh hoặc đối tượng khác nhau.
Ý tưởng cốt lõi của cách tiếp cận này tương tự các thuật toán láng giềng gần nhất như K-NN hoặc K-means, vốn dùng khoảng cách giữa các điểm dữ liệu để phân loại hoặc phân cụm.
So với các bài toán phân loại truyền thống, nơi cần rất nhiều dữ liệu huấn luyện, các mô hình dựa trên độ đo có thể hoạt động chỉ với vài ví dụ.
Một số mô hình phổ biến tận dụng chiến lược meta learning dựa trên độ đo gồm:
Meta learning dựa trên tối ưu hóa
Mạng nơ-ron dùng lan truyền ngược gradient để giảm dần lỗi của mô hình và cải thiện hiệu suất. Hàm tối ưu chịu trách nhiệm tìm cách hiệu quả nhất để tính lại trọng số và độ lệch của mạng. Tuy nhiên, đa số hàm tối ưu phổ biến được thiết kế cho lượng dữ liệu huấn luyện rất lớn, thay vì các bộ dữ liệu nhỏ.
Meta learning dựa trên tối ưu hóa tập trung vào việc thiết kế các hàm tối ưu mới có thể cập nhật tham số mô hình chỉ với một bộ dữ liệu huấn luyện nhỏ, nhờ đó thích ứng nhanh với nhiệm vụ mới.
Trong số các mô hình meta learning dựa trên tối ưu hóa phổ biến có:
Meta Learning và các kiểu học khác
Trái với các phương pháp học có giám sát truyền thống đòi hỏi lượng dữ liệu khổng lồ, meta learning mang đến một bước chuyển mô hình, giúp các mô hình AI khái quát hóa qua nhiều nhiệm vụ, thích ứng nhanh với tối thiểu dữ liệu và cải thiện hiệu suất theo thời gian.
Hãy cùng phân tích một số ứng dụng hứa hẹn nhất:
Few-shot learning
Few-shot learning là một phân nhánh của máy học, nơi mô hình học nhận diện mẫu và đưa ra dự đoán dựa trên số lượng hạn chế ví dụ huấn luyện. Few-shot learning nhấn mạnh khả năng khái quát hơn là ghi nhớ, thách thức nhu cầu tinh chỉnh sâu rộng. Theo hướng tiếp cận này, chìa khóa nằm ở khả năng nắm bắt cấu trúc và đặc trưng nền tảng định nghĩa một nhóm đối tượng.
Few-shot learning thuộc “ô” rộng hơn là n-shot learning, bao trùm nhiều kỹ thuật dựa trên số lượng ví dụ được cung cấp:
Ví dụ về zero-shot, one-shot và few-shot learning. Nguồn: LinkedIn
Transfer learning
Transfer learning cho phép một mô hình được huấn luyện cho một nhiệm vụ được tái sử dụng cho một nhiệm vụ khác nhưng có liên quan, thường bằng cách fine-tune một mô hình đã được huấn luyện trước. Ngược lại, meta learning tập trung vào việc dạy mô hình cách thích ứng nhanh với các nhiệm vụ mới với tối thiểu tái huấn luyện. Dù meta learning có thể tăng cường transfer learning trong một số trường hợp, chẳng hạn tối ưu siêu tham số hoặc chọn chiến lược fine-tune tốt nhất, nó không phải là thành phần bắt buộc của transfer learning. Nhiều phương pháp transfer learning chỉ dựa vào các kỹ thuật fine-tune thông thường thay vì meta learning.
Hệ thống gợi ý
Hệ thống gợi ý sử dụng phản hồi của người dùng để tìm các mục phù hợp mới cho họ hoặc cho những người khác, dựa trên giả định rằng người dùng có sở thích tương tự trong quá khứ có khả năng tiếp tục có sở thích tương tự trong tương lai.
Mục tiêu của hệ thống gợi ý là cung cấp đề xuất cá nhân hóa dựa trên sở thích và hành vi trước đây. Meta learning có thể hỗ trợ mục tiêu này bằng cách học cách tối ưu thuật toán gợi ý cho từng người dùng.
Hệ thống meta-recommendation gồm hai lớp: một hệ gợi ý nền và một bộ tối ưu cấp meta. Hệ gợi ý nền tạo đề xuất dựa trên hành vi quá khứ của người dùng, trong khi bộ tối ưu cấp meta học cách tối ưu hệ gợi ý nền cho từng người dùng.
Tự động hóa máy học (AutoML)
Tự động hóa máy học, hay AutoML, là quá trình tự động hóa toàn bộ quy trình xây dựng mô hình máy học. Điều này bao gồm các tác vụ như tiền xử lý dữ liệu, kỹ thuật đặc trưng, lựa chọn mô hình và tinh chỉnh siêu tham số.
Các kỹ thuật meta learning có thể hỗ trợ các quy trình này, ví dụ bằng cách tự động hóa việc tối ưu và điều chỉnh siêu tham số, hoặc thậm chí tìm mô hình phù hợp nhất để giải một nhiệm vụ cụ thể.
Lợi ích và thách thức của Meta Learning
Có nhiều lý do thuyết phục khiến các nhà nghiên cứu máy học ngày càng chuyển sang chiến lược meta learning để phát triển mô hình.
Hiệu quả huấn luyện: Meta learning rút ngắn thời gian huấn luyện bằng cách tránh phải huấn luyện với các bộ dữ liệu khổng lồ và cho phép fine-tune với dữ liệu hạn chế.
Giảm chi phí vận hành: Meta learning giảm chi phí bằng cách không cần huấn luyện mô hình từ đầu, trong khi cả việc thu thập dữ liệu và sử dụng tài nguyên tính toán để huấn luyện đều có thể tốn kém.
Tăng khả năng thích ứng và tái sử dụng: Meta learning là kỹ thuật then chốt giúp mô hình thích ứng với nhiều bối cảnh và nhiệm vụ, từ đó tăng tiềm năng và tính hữu dụng.
Hiệu suất mô hình: Bên cạnh tăng khả năng thích ứng, meta learning cũng có thể cải thiện độ chính xác của các mô hình máy học hiện có.
Tuy nhiên, meta learning không phải là chiến lược “một cho tất cả”. Nó có những hạn chế và rủi ro cần được xử lý cẩn thận. Một số thách thức thường gặp trong meta learning gồm:
Không khớp miền: Meta learning có xu hướng hoạt động tốt hơn khi nhiệm vụ nguồn và đích có mức độ liên quan nhất định. Nếu nhiệm vụ mới quá khác biệt, kiến thức khái quát chuyển giao có thể không đủ để thực hiện chính xác, thậm chí làm giảm hiệu suất ở mọi nhiệm vụ.
Thiếu dữ liệu: Luôn cần một lượng dữ liệu huấn luyện nhất định. Nếu dữ liệu quá ít hoặc chất lượng kém, mô hình có khả năng bị underfitting.
Overfitting: Meta learning cũng không miễn nhiễm với overfitting. Nếu mô hình được fine-tune quá mức trên một nhiệm vụ, nó có thể học các đặc trưng quá đặc thù, không khái quát tốt sang dữ liệu mới.
Độ phức tạp và chi phí: Đôi khi, nhiệm vụ đích quá phức tạp khiến quá trình fine-tune trở nên thách thức, tốn kém tính toán và thời gian.
Định hướng tương lai và cơ hội nghiên cứu
Meta learning là một cách tiếp cận thiết kế then chốt để tăng hiệu quả và tiềm năng của mạng nơ-ron. Có thể nói cuộc cách mạng AI hiện nay khó có thể đạt được nếu thiếu các kỹ thuật transfer learning đa dạng.
Lĩnh vực này đang phát triển nhanh chóng, với một số hướng cần nghiên cứu sâu hơn, bao gồm:
Kết luận
Khi các mô hình máy học ngày càng lớn và phức tạp, việc tìm ra các kỹ thuật mới để khiến chúng hiệu quả và linh hoạt hơn là tối quan trọng để ngành AI thực hiện được kỳ vọng, đảm bảo bài toán chi phí, và thúc đẩy tính bền vững trong lĩnh vực này.
Meta learning có nhiều điều để nói trong khía cạnh này. Lĩnh vực nghiên cứu này đang phát triển nhanh, mang đến một tập hợp kỹ thuật và chiến lược then chốt để nâng cao năng lực của AI. Hãy theo dõi DataCamp để cập nhật tin tức mới nhất về meta learning, AI và nhiều nội dung khác:
Few-Shot Learning là gì? Khai mở hiểu biết với dữ liệu hạn chế
Deep Learning là gì? Hướng dẫn cho người mới bắt đầu
Tìm hiểu Superalignment: Điều chỉnh AI theo giá trị của con người
AI Alignment là gì? Đảm bảo AI phục vụ nhân loại
Transfer Learning trong AI là gì? Hướng dẫn nhập môn kèm ví dụ
Các khái niệm về AI sinh tạo