Historisch gezien waren veel machinelearningmodellen ontworpen voor taak-specifiek leren en hadden ze voor elke nieuwe taak grote datasets nodig. Gezien de technische beperkingen destijds was de meest effectieve aanpak om machinelearningmodellen te trainen met een enorme, taak-specifieke dataset. Daardoor waren state-of-the-art modellen extreem goed in het voorspellen van uitkomsten voor het probleem waarvoor ze waren getraind. Toch bleven deze modellen ver verwijderd van mensen en ons verbluffende vermogen om nieuwe taken te leren op basis van eerdere ervaringen.
Adaptieve leerstrategieën toevoegen aan machinelearningmodellen is de centrale missie van meta learning, een subveld van machine learning dat zich richt op het verbeteren van hoe modellen nieuwe taken efficiënt leren. Meta learning focust op het aanleren van snelle aanpassing met beperkte hertraining en minimale menselijke tussenkomst, en op prestatieverbetering in de tijd.
In dit artikel geven we een introductie tot meta learning en hoe het machine learning revolutioneert. We behandelen de technische kant van meta learning-modellen, de meest voorkomende benaderingen en toepassingen, evenals de voordelen en uitdagingen. Daarna raad ik je aan om onze AI Fundamentals-skilltrack te volgen, zodat je echt vaardig wordt in het bespreken van de verschillende en verwante AI-concepten.
Onderzoek naar meta learning gaat terug tot de jaren tachtig, maar het veld kreeg meer gewicht in de jaren 2010 met de opkomst van neurale netwerken en, recenter, door de ontwikkeling van generatieve AI. Meta learning is als subveld van machine learning gericht op het aanleren van hoe modellen nieuwe taken snel en efficiënt leren. Het is geïnspireerd op het menselijk vermogen om, zeg maar, te “leren leren”.
Stel, je wilt leren om snel wiskundeproblemen op te lossen. Een traditionele aanpak is om oplossingen voor veel verschillende problemen te memoriseren, zodat je bij een bekend probleem het antwoord meteen kunt terughalen. Deze aanpak schiet echter tekort zodra je een compleet nieuw probleem tegenkomt.
Wat als je je in plaats daarvan richt op het leren van algemene oplossingsstrategieën in plaats van specifieke oplossingen te onthouden? Je zou probleemoplossende technieken bestuderen, patronen herkennen en een intuïtie ontwikkelen voor het benaderen van nieuwe uitdagingen. Zo kun je, wanneer je met een nieuw probleem wordt geconfronteerd, snel aanpassen en de juiste methode toepassen, ook als je dat specifieke probleem nog niet eerder hebt gezien.
Dit is de kern van meta learning. Traditionele machine learning memoriseert patronen uit grote datasets voor één taak, terwijl meta learning modellen traint om zich snel aan te passen aan nieuwe taken door te leren hoe ze effectief moeten leren.
Je kunt meta learning-modellen zien als een systeem met een leersubsysteem dat dynamisch wordt aangepast door ervaring uit eerdere leerepisodes of uit verschillende taken te benutten.
In tegenstelling tot traditionele machinelearningmodellen die slechts één taak met een vaste, grote dataset behandelen, worden metamodellen blootgesteld aan een reeks taken om generaliseerbare patronen te extraheren. Gewoonlijk is elk probleem gekoppeld aan een kleinere, taak-specifieke trainingsdataset.
Het doel van het meta-trainingsproces is om algemene informatie over het leerproces op afzonderlijke taken te extraheren, om zo het vermogen van het model te verbeteren om nieuwe taken met weinig hertraining aan te pakken.
Het ontwikkelen van meta-learningmodellen volgt een tweestapsproces dat het traditionele trainingsproces van machine learning hersampelt:
- Meta-training. In deze fase wordt het model getraind op meerdere taken, waarbij elke taak bestaat uit een trainingsdatasample (samen vormen ze de meta-trainingsdataset) en in veel gevallen modelmetagegevens, zoals modelparameters en prestatiemaatstaven. Het doel is om gemeenschappelijke, generaliseerbare patronen te ontdekken om het model uit te rusten met brede kennis die kan worden gebruikt bij nieuwe taken.
- Meta-testing. Tijdens meta-testing wordt het model blootgesteld aan nieuwe taken die tijdens de training niet zijn tegengekomen. Het doel is om de prestaties te beoordelen door te meten hoe goed en hoe snel het zich aanpast aan nieuwe omgevingen en taken.
Het meta-trainings- en meta-testproces wordt geïllustreerd in de volgende afbeelding.
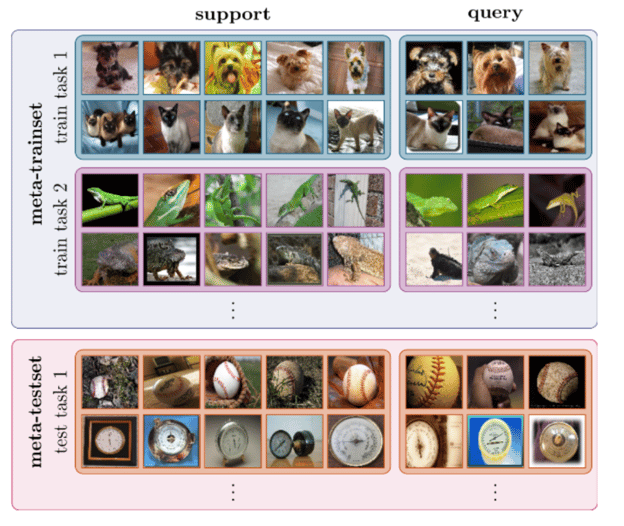
Meta learning voor beeldclassificatie. Bron: Dida
Meta learning kan worden gebruikt om elk type machine learning op te lossen, of het nu gaat om supervised learning, unsupervised learning of reinforcement learning.
Er zijn verschillende benaderingen van meta learning. Hieronder vind je de drie meest voorkomende:
Modelgebaseerde meta-learningmodellen zijn specifiek ontworpen voor snel leren; ze kunnen hun parameters namelijk razendsnel bijwerken met een paar trainingsstappen. Deze snelle update kan worden bereikt door de interne architectuur of worden aangestuurd door een ander meta-learner-model.
Hier is een lijst met de meest voorkomende modelgebaseerde meta learning-strategieën:
- Memory-Augmented Neural Networks (MANNs). Geïntroduceerd door Google-onderzoekers in een paper uit 2016. MANNs zijn neurale modellen met een extern geheugensubsysteem, waardoor ze snel nieuwe informatie kunnen encoderen en ophalen en nauwkeurige voorspellingen kunnen doen na slechts enkele voorbeelden. Terwijl nieuwe data het model binnenkomt, verschuiven deze netwerken hun bias via gewichtsupdates, maar ze moduleren hun output ook door te leren representaties snel in geheugens op te slaan.
- Meta Networks. Meta Networks, of MetaNets, zijn een type meta-learningmodel voorgesteld door Munkhdalai en Yu in een paper uit 2017. Meta networks bestaan uit twee modellen: een meta-learner en een basis-learner. De basis-learner werkt als een traditioneel neuraal netwerk: hij neemt een invoertaak en stuurt metainformatie over de huidige taakruimte naar de meta-learner. Deze informatie wordt door de meta-learner gebruikt om de gewichten van het model snel bij te werken.
Metric-gebaseerd meta learning richt zich op het leren van een afstandsmaat die de (on)gelijkenis tussen paren datapunten berekent. Een hoge score wordt teruggegeven wanneer objecten vergelijkbaar zijn en een lage score wanneer de afbeeldingen of objecten verschillend zijn.
De kern van deze aanpak lijkt op nearest-neighbor-algoritmen zoals K-NN of K-means, die de afstand tussen punten gebruiken voor classificatie of clustering.
Vergeleken met traditionele classificatieproblemen, waarvoor veel trainingsdata nodig is, kunnen metric-gebaseerde modellen volstaan met slechts enkele voorbeelden.
Enkele van de meest gebruikte modellen die metric-gebaseerde meta learning-strategieën benutten, zijn:
- Convolutional Siamese Neural Network. Siamese netwerken zijn een type neuraal netwerk dat is ontworpen voor taken waarbij gelijkenis meten of metric learning centraal staat, zoals gezichtsverificatie. Het model bestaat uit twee “tweeling”-netwerken en hun outputs worden samen bovenop getraind met een functie om de relatie tussen paren invoer-samples te leren. De tweelingnetwerken zijn gelijk, met gedeelde gewichten en netwerkparameters.
- Matching networks. Ontwikkeld door Google-onderzoekers in een paper uit 2016. Matching networks gebruiken een afstandsmaat, cosinusgelijkenis, tussen twee samples om classificaties te maken. De architectuur van matching networks gebruikt geheugen-aangevulde neurale netwerken met extern geheugen en een aandachtmechanisme om dat geheugen te benaderen.
- Prototypical networks. Gepresenteerd in een paper uit 2017 door Snell et al. Prototypical networks leren een metrische ruimte waarin classificatie kan worden uitgevoerd door afstanden te berekenen tot prototyperepresentaties van elke klasse. Ze zijn gebaseerd op de aanname dat er een embedding bestaat waarin meerdere punten rond één prototyperepresentatie per klasse clusteren.
Neurale netwerken gebruiken backpropagation van gradiënten om de fout van het model geleidelijk te verkleinen en de prestaties te verbeteren. De optimalisatiefunctie is verantwoordelijk voor het vinden van de meest effectieve manier om de gewichten en biases van het netwerk te herberekenen. De meest populaire optimalisatiefuncties zijn echter ontworpen voor enorme hoeveelheden trainingsdata, niet voor kleine datasets.
Optimalisatie-gebaseerd meta learning richt zich op het ontwerpen van innovatieve optimalisatiefuncties die de modelparameters kunnen bijwerken met slechts een kleine trainingsdataset, zodat ze zich snel aan nieuwe taken kunnen aanpassen.
Tot de populairste optimalisatie-gebaseerde meta learning-modellen behoren:
- LSTM meta-learner. Deze aanpak, gepresenteerd door Ravi en Larochelle in 2017, gebruikt long short-term memory (LSTM)-netwerken om een meta-learner te trainen die het exacte optimalisatie-algoritme kan leren dat wordt gebruikt om een andere neurale netwerk-classifier te trainen, waardoor parameterupdates worden versneld voor snelle convergentie bij nieuwe taken met beperkte data.
- Model-Agnostic Meta Learning (MAML). Gepresenteerd door Finn et al. in een paper uit 2017. MAML is compatibel met elk model dat met gradient descent wordt getraind en toepasbaar op uiteenlopende leervraagstukken, waaronder classificatie, regressie en reinforcement learning. MAML gaat ervan uit dat het trainen van de beginparameters van het model met slechts enkele gradientupdates resulteert in snel leren op een nieuwe taak. Het doel is om modelparameters te vinden die gevoelig zijn voor taakveranderingen, zodat kleine aanpassingen aan die parameters grote verbeteringen in de verliesfunctie van de taak opleveren.
- Reptile. Ontwikkeld door OpenAI. Reptile is een meta learning-algoritme op basis van eerste-orde gradiënten. Het sampelt herhaaldelijk een taak, voert daar stochastische gradient descent op uit en werkt de initiële parameters bij in de richting van de eindparameters die op die taak zijn geleerd. Reptile is de toepassing van het Shortest Descent-algoritme in de meta-learningcontext en is wiskundig vergelijkbaar met MAML, met vergelijkbare rekenkundige efficiëntie en prestaties.
In tegenstelling tot traditionele supervised learning-methoden die enorme hoeveelheden data vereisen, biedt meta learning een paradigmaverschuiving: AI-modellen kunnen generaliseren over taken heen, zich snel aanpassen met minimale data en hun prestaties in de tijd verbeteren.
Laten we enkele van de meest veelbelovende toepassingen bekijken:
Few-shot learning
Few-shot learning is een subveld van machine learning waarin modellen patronen leren herkennen en voorspellingen doen op basis van een beperkt aantal trainingsvoorbeelden. Few-shot learning legt de nadruk op generalisatie boven memorisatie en stelt de noodzaak van uitgebreide fine-tuning ter discussie. Voor voorstanders ligt de sleutel in het vermogen om de onderliggende structuur en kenmerken te onderscheiden die een categorie definiëren.
Few-shot learning valt onder de bredere paraplu van n-shot learning, met verschillende technieken op basis van het aantal voorbeelden dat wordt gegeven:
- Zero-shot learning: Er worden geen voorbeelden gegeven; het model vertrouwt uitsluitend op eerdere kennis of beschrijvingen.
- One-shot learning: Er is slechts één voorbeeld per klasse beschikbaar.
- Two-shot learning: Twee voorbeelden per klasse worden gebruikt voor training.
- Few-shot learning: Een klein aantal voorbeelden (meestal tussen 3 en 10) is beschikbaar voor elke klasse.
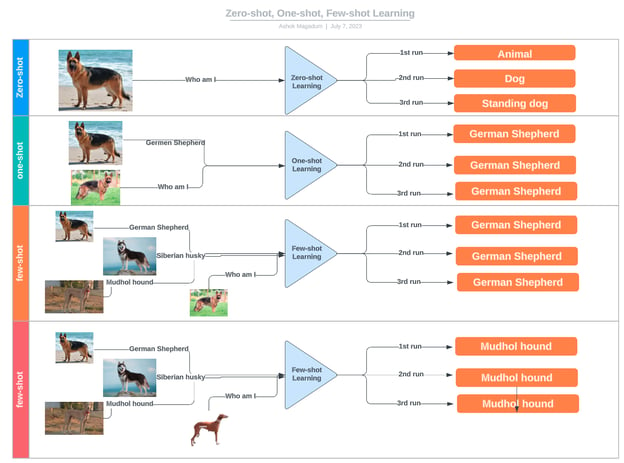
Voorbeelden van zero-shot-, one-shot- en few-shot learning. Bron: LinkedIn
Transfer learning
Transfer learning maakt het mogelijk om een voor één taak getraind model te hergebruiken voor een andere maar verwante taak, vaak door een voorgetraind model te fine-tunen. Meta learning daarentegen richt zich op het leren hoe modellen zich snel kunnen aanpassen aan nieuwe taken met minimale hertraining. Hoewel meta learning transfer learning in sommige gevallen kan versterken, bijvoorbeeld door hyperparameters te optimaliseren of de beste fine-tuningstrategie te kiezen, is het geen noodzakelijk onderdeel van transfer learning. Veel transfer learning-benaderingen steunen uitsluitend op conventionele fine-tuningtechnieken en niet op meta learning.
Aanbevelingssystemen
Aanbevelingssystemen gebruiken feedback van gebruikers om nieuwe relevante items voor hen of voor anderen te vinden, met de aanname dat gebruikers die in het verleden vergelijkbare voorkeuren hadden, in de toekomst waarschijnlijk opnieuw vergelijkbare voorkeuren zullen hebben.
Het doel van een aanbevelingssysteem is om gebruikers gepersonaliseerde aanbevelingen te bieden op basis van hun voorkeuren en eerder gedrag. Meta learning kan hierbij helpen door te leren hoe het aanbevelingsalgoritme voor elke gebruiker te optimaliseren.
Meta-aanbevelingssystemen bestaan uit twee lagen: een basisaanbevelingssysteem en een optimizer op meta-niveau. Het basisaanbevelingssysteem genereert aanbevelingen voor gebruikers op basis van hun eerdere gedrag, terwijl de optimizer op meta-niveau leert hoe het basissysteem voor elke gebruiker kan worden geoptimaliseerd.
Geautomatiseerde machine learning (AutoML)
Geautomatiseerde machine learning, ook wel AutoML genoemd, is het proces waarbij het end-to-end bouwen van machinelearningmodellen wordt geautomatiseerd. Dit omvat taken zoals datapreprocessing, feature engineering, modelselectie en hyperparametertuning.
Meta learning-technieken kunnen deze processen ondersteunen, bijvoorbeeld door hyperparameteroptimalisatie en -aanpassing te automatiseren, of zelfs door het meest geschikte model te vinden om een specifieke taak op te lossen.
Er zijn verschillende overtuigende redenen waarom machinelearningonderzoekers steeds vaker naar meta learning-strategieën grijpen om hun modellen te ontwikkelen.
-
Trainingsefficiëntie: Meta learning verkort de trainingstijd door te voorkomen dat modellen met enorme datasets moeten worden getraind en maakt fine-tuning met beperkte data mogelijk.
-
Lagere operationele kosten: Meta learning verlaagt de kosten doordat modellen niet vanaf nul hoeven te worden getraind; zowel dataverzameling als het gebruik van rekenmiddelen voor training kan duur zijn.
-
Verbeterde aanpasbaarheid en herbruikbaarheid: Meta learning is een sleuteltechniek waarmee modellen zich aan meerdere scenario’s en taken kunnen aanpassen, waardoor hun potentieel en inzetbaarheid toeneemt.
-
Modelprestaties: Naast betere aanpasbaarheid kan meta learning ook de nauwkeurigheid van bestaande machinelearningmodellen verbeteren.
Meta learning is echter geen one-size-fits-all-strategie. Er zijn beperkingen en valkuilen die zorgvuldig moeten worden aangepakt. Enkele van de meest voorkomende uitdagingen bij meta learning zijn:
-
Domeinmismatch: Meta learning werkt waarschijnlijk beter wanneer bron- en doeltaken in zekere mate verwant zijn. Als de nieuwe taak heel anders is, is de overgedragen generaliseerbare kennis mogelijk niet voldoende voor nauwkeurige prestaties, en kan deze zelfs de prestaties op alle taken verlagen.
-
Dataschaarste: Er is altijd een bepaalde hoeveelheid trainingsdata nodig. Als de trainingsdata extreem beperkt is of van slechte kwaliteit, zal het model waarschijnlijk onderfitten.
-
Overfitting: Meta learning is ook niet immuun voor overfitting. Als het model te veel wordt gefine-tuned op een taak, kan het taak-specifieke kenmerken leren die slecht generaliseren naar nieuwe data.
-
Complexiteit en kosten: Soms is de doeltaak zo complex dat het fine-tuningproces uitdagend, rekenintensief en tijdrovend kan zijn.
Meta learning is een cruciale ontwerpaanpak om de efficiëntie en het potentieel van neurale netwerken te vergroten. Het is fair om te zeggen dat de huidige AI-revolutie niet mogelijk was geweest zonder de vele beschikbare transfer learning-technieken.
Het veld ontwikkelt zich snel, met enkele gebieden die verder onderzoek vereisen, waaronder:
- Sample-efficiëntie. Hoeveel data is nodig voordat een model effectief wordt op nieuwe taken? Dit is een centrale vraag in meta learning. Hoewel strategieën zoals short-shot learning laten zien dat een model met beperkte data kan leren, is er nog veel ruimte voor verbetering om modellen efficiënter en veelzijdiger te maken.
- Taakdiversiteit. Meta learning-technieken werken doorgaans beter wanneer de taken tot op zekere hoogte verwant zijn. Verder onderzoek is echter cruciaal om meta learning-modellen te ontwikkelen die kunnen generaliseren over een breed scala aan taken zonder overfitting.
- Geavanceerde technieken. Meta learning is een centrale katalysator voor innovatie in enkele van de meest veelbelovende en waardevolle technologieën van vandaag, waaronder reinforcement learning, robotica en transformers.
Conclusie
Naarmate machinelearningmodellen groter en complexer worden, is het cruciaal om nieuwe technieken te vinden die ze efficiënter en veelzijdiger maken, zodat de AI-sector zijn belofte kan waarmaken, de cijfers uitkomen en duurzaamheid in de sector vooruitgaat.
Meta learning heeft hierin veel te betekenen. Dit onderzoeksveld ontwikkelt zich snel en biedt een reeks technieken en strategieën die cruciaal zijn voor het vergroten van de capaciteiten van AI. Blijf op de hoogte met DataCamp voor het laatste nieuws over meta learning, AI en meer:




Historisch gezien waren veel machinelearningmodellen ontworpen voor taak-specifiek leren en hadden ze voor elke nieuwe taak grote datasets nodig. Gezien de technische beperkingen destijds was de meest effectieve aanpak om machinelearningmodellen te trainen met een enorme, taak-specifieke dataset. Daardoor waren state-of-the-art modellen extreem goed in het voorspellen van uitkomsten voor het probleem waarvoor ze waren getraind. Toch bleven deze modellen ver verwijderd van mensen en ons verbluffende vermogen om nieuwe taken te leren op basis van eerdere ervaringen.
Adaptieve leerstrategieën toevoegen aan machinelearningmodellen is de centrale missie van meta learning, een subveld van machine learning dat zich richt op het verbeteren van hoe modellen nieuwe taken efficiënt leren. Meta learning focust op het aanleren van snelle aanpassing met beperkte hertraining en minimale menselijke tussenkomst, en op prestatieverbetering in de tijd.
In dit artikel geven we een introductie tot meta learning en hoe het machine learning revolutioneert. We behandelen de technische kant van meta learning-modellen, de meest voorkomende benaderingen en toepassingen, evenals de voordelen en uitdagingen. Daarna raad ik je aan om onze AI Fundamentals-skilltrack te volgen, zodat je echt vaardig wordt in het bespreken van de verschillende en verwante AI-concepten.
Wat is meta learning?
Onderzoek naar meta learning gaat terug tot de jaren tachtig, maar het veld kreeg meer gewicht in de jaren 2010 met de opkomst van neurale netwerken en, recenter, door de ontwikkeling van generatieve AI. Meta learning is als subveld van machine learning gericht op het aanleren van hoe modellen nieuwe taken snel en efficiënt leren. Het is geïnspireerd op het menselijk vermogen om, zeg maar, te “leren leren”.
Stel, je wilt leren om snel wiskundeproblemen op te lossen. Een traditionele aanpak is om oplossingen voor veel verschillende problemen te memoriseren, zodat je bij een bekend probleem het antwoord meteen kunt terughalen. Deze aanpak schiet echter tekort zodra je een compleet nieuw probleem tegenkomt.
Wat als je je in plaats daarvan richt op het leren van algemene oplossingsstrategieën in plaats van specifieke oplossingen te onthouden? Je zou probleemoplossende technieken bestuderen, patronen herkennen en een intuïtie ontwikkelen voor het benaderen van nieuwe uitdagingen. Zo kun je, wanneer je met een nieuw probleem wordt geconfronteerd, snel aanpassen en de juiste methode toepassen, ook als je dat specifieke probleem nog niet eerder hebt gezien.
Dit is de kern van meta learning. Traditionele machine learning memoriseert patronen uit grote datasets voor één taak, terwijl meta learning modellen traint om zich snel aan te passen aan nieuwe taken door te leren hoe ze effectief moeten leren.
Hoe meta learning werkt
Je kunt meta learning-modellen zien als een systeem met een leersubsysteem dat dynamisch wordt aangepast door ervaring uit eerdere leerepisodes of uit verschillende taken te benutten.
In tegenstelling tot traditionele machinelearningmodellen die slechts één taak met een vaste, grote dataset behandelen, worden metamodellen blootgesteld aan een reeks taken om generaliseerbare patronen te extraheren. Gewoonlijk is elk probleem gekoppeld aan een kleinere, taak-specifieke trainingsdataset.
Het doel van het meta-trainingsproces is om algemene informatie over het leerproces op afzonderlijke taken te extraheren, om zo het vermogen van het model te verbeteren om nieuwe taken met weinig hertraining aan te pakken.
Het ontwikkelen van meta-learningmodellen volgt een tweestapsproces dat het traditionele trainingsproces van machine learning hersampelt:
Het meta-trainings- en meta-testproces wordt geïllustreerd in de volgende afbeelding.
Meta learning voor beeldclassificatie. Bron: Dida
Meta learning kan worden gebruikt om elk type machine learning op te lossen, of het nu gaat om supervised learning, unsupervised learning of reinforcement learning.
Veelvoorkomende benaderingen van meta learning
Er zijn verschillende benaderingen van meta learning. Hieronder vind je de drie meest voorkomende:
Modelgebaseerd meta learning
Modelgebaseerde meta-learningmodellen zijn specifiek ontworpen voor snel leren; ze kunnen hun parameters namelijk razendsnel bijwerken met een paar trainingsstappen. Deze snelle update kan worden bereikt door de interne architectuur of worden aangestuurd door een ander meta-learner-model.
Hier is een lijst met de meest voorkomende modelgebaseerde meta learning-strategieën:
Metric-gebaseerd meta learning
Metric-gebaseerd meta learning richt zich op het leren van een afstandsmaat die de (on)gelijkenis tussen paren datapunten berekent. Een hoge score wordt teruggegeven wanneer objecten vergelijkbaar zijn en een lage score wanneer de afbeeldingen of objecten verschillend zijn.
De kern van deze aanpak lijkt op nearest-neighbor-algoritmen zoals K-NN of K-means, die de afstand tussen punten gebruiken voor classificatie of clustering.
Vergeleken met traditionele classificatieproblemen, waarvoor veel trainingsdata nodig is, kunnen metric-gebaseerde modellen volstaan met slechts enkele voorbeelden.
Enkele van de meest gebruikte modellen die metric-gebaseerde meta learning-strategieën benutten, zijn:
Optimalisatie-gebaseerd meta learning
Neurale netwerken gebruiken backpropagation van gradiënten om de fout van het model geleidelijk te verkleinen en de prestaties te verbeteren. De optimalisatiefunctie is verantwoordelijk voor het vinden van de meest effectieve manier om de gewichten en biases van het netwerk te herberekenen. De meest populaire optimalisatiefuncties zijn echter ontworpen voor enorme hoeveelheden trainingsdata, niet voor kleine datasets.
Optimalisatie-gebaseerd meta learning richt zich op het ontwerpen van innovatieve optimalisatiefuncties die de modelparameters kunnen bijwerken met slechts een kleine trainingsdataset, zodat ze zich snel aan nieuwe taken kunnen aanpassen.
Tot de populairste optimalisatie-gebaseerde meta learning-modellen behoren:
Meta learning en andere vormen van leren
In tegenstelling tot traditionele supervised learning-methoden die enorme hoeveelheden data vereisen, biedt meta learning een paradigmaverschuiving: AI-modellen kunnen generaliseren over taken heen, zich snel aanpassen met minimale data en hun prestaties in de tijd verbeteren.
Laten we enkele van de meest veelbelovende toepassingen bekijken:
Few-shot learning
Few-shot learning is een subveld van machine learning waarin modellen patronen leren herkennen en voorspellingen doen op basis van een beperkt aantal trainingsvoorbeelden. Few-shot learning legt de nadruk op generalisatie boven memorisatie en stelt de noodzaak van uitgebreide fine-tuning ter discussie. Voor voorstanders ligt de sleutel in het vermogen om de onderliggende structuur en kenmerken te onderscheiden die een categorie definiëren.
Few-shot learning valt onder de bredere paraplu van n-shot learning, met verschillende technieken op basis van het aantal voorbeelden dat wordt gegeven:
Voorbeelden van zero-shot-, one-shot- en few-shot learning. Bron: LinkedIn
Transfer learning
Transfer learning maakt het mogelijk om een voor één taak getraind model te hergebruiken voor een andere maar verwante taak, vaak door een voorgetraind model te fine-tunen. Meta learning daarentegen richt zich op het leren hoe modellen zich snel kunnen aanpassen aan nieuwe taken met minimale hertraining. Hoewel meta learning transfer learning in sommige gevallen kan versterken, bijvoorbeeld door hyperparameters te optimaliseren of de beste fine-tuningstrategie te kiezen, is het geen noodzakelijk onderdeel van transfer learning. Veel transfer learning-benaderingen steunen uitsluitend op conventionele fine-tuningtechnieken en niet op meta learning.
Aanbevelingssystemen
Aanbevelingssystemen gebruiken feedback van gebruikers om nieuwe relevante items voor hen of voor anderen te vinden, met de aanname dat gebruikers die in het verleden vergelijkbare voorkeuren hadden, in de toekomst waarschijnlijk opnieuw vergelijkbare voorkeuren zullen hebben.
Het doel van een aanbevelingssysteem is om gebruikers gepersonaliseerde aanbevelingen te bieden op basis van hun voorkeuren en eerder gedrag. Meta learning kan hierbij helpen door te leren hoe het aanbevelingsalgoritme voor elke gebruiker te optimaliseren.
Meta-aanbevelingssystemen bestaan uit twee lagen: een basisaanbevelingssysteem en een optimizer op meta-niveau. Het basisaanbevelingssysteem genereert aanbevelingen voor gebruikers op basis van hun eerdere gedrag, terwijl de optimizer op meta-niveau leert hoe het basissysteem voor elke gebruiker kan worden geoptimaliseerd.
Geautomatiseerde machine learning (AutoML)
Geautomatiseerde machine learning, ook wel AutoML genoemd, is het proces waarbij het end-to-end bouwen van machinelearningmodellen wordt geautomatiseerd. Dit omvat taken zoals datapreprocessing, feature engineering, modelselectie en hyperparametertuning.
Meta learning-technieken kunnen deze processen ondersteunen, bijvoorbeeld door hyperparameteroptimalisatie en -aanpassing te automatiseren, of zelfs door het meest geschikte model te vinden om een specifieke taak op te lossen.
Voordelen en uitdagingen van meta learning
Er zijn verschillende overtuigende redenen waarom machinelearningonderzoekers steeds vaker naar meta learning-strategieën grijpen om hun modellen te ontwikkelen.
Trainingsefficiëntie: Meta learning verkort de trainingstijd door te voorkomen dat modellen met enorme datasets moeten worden getraind en maakt fine-tuning met beperkte data mogelijk.
Lagere operationele kosten: Meta learning verlaagt de kosten doordat modellen niet vanaf nul hoeven te worden getraind; zowel dataverzameling als het gebruik van rekenmiddelen voor training kan duur zijn.
Verbeterde aanpasbaarheid en herbruikbaarheid: Meta learning is een sleuteltechniek waarmee modellen zich aan meerdere scenario’s en taken kunnen aanpassen, waardoor hun potentieel en inzetbaarheid toeneemt.
Modelprestaties: Naast betere aanpasbaarheid kan meta learning ook de nauwkeurigheid van bestaande machinelearningmodellen verbeteren.
Meta learning is echter geen one-size-fits-all-strategie. Er zijn beperkingen en valkuilen die zorgvuldig moeten worden aangepakt. Enkele van de meest voorkomende uitdagingen bij meta learning zijn:
Domeinmismatch: Meta learning werkt waarschijnlijk beter wanneer bron- en doeltaken in zekere mate verwant zijn. Als de nieuwe taak heel anders is, is de overgedragen generaliseerbare kennis mogelijk niet voldoende voor nauwkeurige prestaties, en kan deze zelfs de prestaties op alle taken verlagen.
Dataschaarste: Er is altijd een bepaalde hoeveelheid trainingsdata nodig. Als de trainingsdata extreem beperkt is of van slechte kwaliteit, zal het model waarschijnlijk onderfitten.
Overfitting: Meta learning is ook niet immuun voor overfitting. Als het model te veel wordt gefine-tuned op een taak, kan het taak-specifieke kenmerken leren die slecht generaliseren naar nieuwe data.
Complexiteit en kosten: Soms is de doeltaak zo complex dat het fine-tuningproces uitdagend, rekenintensief en tijdrovend kan zijn.
Toekomstige richtingen en onderzoekskansen
Meta learning is een cruciale ontwerpaanpak om de efficiëntie en het potentieel van neurale netwerken te vergroten. Het is fair om te zeggen dat de huidige AI-revolutie niet mogelijk was geweest zonder de vele beschikbare transfer learning-technieken.
Het veld ontwikkelt zich snel, met enkele gebieden die verder onderzoek vereisen, waaronder:
Conclusie
Naarmate machinelearningmodellen groter en complexer worden, is het cruciaal om nieuwe technieken te vinden die ze efficiënter en veelzijdiger maken, zodat de AI-sector zijn belofte kan waarmaken, de cijfers uitkomen en duurzaamheid in de sector vooruitgaat.
Meta learning heeft hierin veel te betekenen. Dit onderzoeksveld ontwikkelt zich snel en biedt een reeks technieken en strategieën die cruciaal zijn voor het vergroten van de capaciteiten van AI. Blijf op de hoogte met DataCamp voor het laatste nieuws over meta learning, AI en meer:
Wat is few-shot learning? Inzichten ontsluiten met beperkte data
Wat is deep learning? Een tutorial voor beginners
Superalignment begrijpen: AI afstemmen op menselijke waarden
Wat is AI alignment? Zorgen dat AI werkt voor de mensheid
Wat is transfer learning in AI? Een inleidende gids met voorbeelden
Generative AI Concepts