Storicamente, molti modelli di machine learning sono stati progettati per l’apprendimento specifico di un compito, richiedendo grandi dataset per ogni nuovo task. Date le limitazioni tecniche dell’epoca, l’approccio più efficace era addestrare i modelli con un enorme dataset specifico per il compito. Di conseguenza, i modelli all’avanguardia erano estremamente efficaci nel predire l’esito del problema per cui erano stati addestrati. Tuttavia, questi modelli erano ancora lontani dagli esseri umani e dalla nostra straordinaria capacità di imparare nuovi compiti basandoci sulle esperienze precedenti.
Aggiungere strategie di apprendimento adattivo ai modelli di machine learning è la missione centrale del meta learning, un sottoambito del machine learning che si concentra sul migliorare il modo in cui i modelli apprendono nuovi compiti in modo efficiente. Il meta learning punta a insegnare ai modelli ad adattarsi rapidamente con un retraining limitato e un intervento umano minimo, migliorando le prestazioni nel tempo.
In questo articolo ti offriremo un’introduzione al meta learning e a come sta rivoluzionando il machine learning. Tratteremo gli aspetti tecnici dei modelli di meta learning, gli approcci e le applicazioni più comuni, oltre a benefici e sfide. Dopo, ti invito a provare il nostro skill track AI Fundamentals per acquisire davvero dimestichezza nel parlare dei diversi concetti dell’IA e di quelli correlati.
La ricerca sul meta learning risale agli anni ’80, ma il campo ha acquisito rilevanza negli anni 2010, con l’ascesa delle reti neurali e, più recentemente, con lo sviluppo dell’IA generativa. Il meta learning, come sottoambito del machine learning, si concentra sull’insegnare ai modelli come imparare nuovi compiti in modo rapido ed efficiente. Si ispira alla capacità umana di “imparare a imparare”, per così dire.
Immagina di voler imparare a risolvere velocemente i problemi di matematica. Un approccio tradizionale sarebbe memorizzare le soluzioni di molti problemi diversi, così quando ne vedi uno familiare puoi richiamare subito la risposta. Tuttavia, questo approccio vacilla quando ti imbatti in un problema del tutto nuovo.
Invece, cosa accadrebbe se ti concentrassi sull’apprendere strategie generali per risolvere i problemi, piuttosto che memorizzare soluzioni specifiche? Potresti studiare tecniche di problem solving, individuare schemi ricorrenti e sviluppare un’intuizione per affrontare nuove sfide. In questo modo, di fronte a un problema nuovo, puoi adattarti rapidamente e applicare il metodo giusto, anche se non hai mai visto esattamente quel problema prima.
Questa è l’essenza del meta learning. Il machine learning tradizionale memorizza schemi da grandi dataset per un singolo compito, mentre il meta learning addestra i modelli ad adattarsi rapidamente a nuovi compiti imparando come imparare in modo efficace.
Puoi pensare ai modelli di meta learning come a un sistema che include un sottosistema di apprendimento adattato dinamicamente sfruttando l’esperienza di precedenti episodi di apprendimento o di compiti diversi.
Al contrario dei modelli tradizionali di machine learning, che considerano un singolo compito con un dataset fisso e ampio, i meta modelli sono esposti a una gamma di compiti per estrarre pattern generalizzabili. Normalmente, ogni problema è associato a un dataset di addestramento più piccolo e specifico per il compito.
L’obiettivo del processo di meta training è estrarre informazioni generali sul processo di apprendimento sui singoli compiti, per migliorare la capacità del modello di affrontare task inediti con poco retraining.
Lo sviluppo di modelli di meta learning segue un processo in due fasi che ricalca il processo di addestramento del machine learning tradizionale:
- Meta-training. In questa fase, il modello viene addestrato su più compiti, ciascuno composto da un campione di dati di addestramento (che insieme formano il meta train dataset) e, in molti casi, da metadati del modello, come parametri e misure di performance. L’obiettivo è scoprire pattern comuni e generalizzabili per dotare il modello di conoscenze ampie da riutilizzare in compiti nuovi.
- Meta-testing. Durante il meta testing, il modello è esposto a nuovi compiti mai incontrati in addestramento. L’obiettivo è valutarne le prestazioni misurando quanto bene e quanto velocemente si adatta a nuovi ambienti e task.
Il processo di meta-training e meta-testing è illustrato nell’immagine seguente.
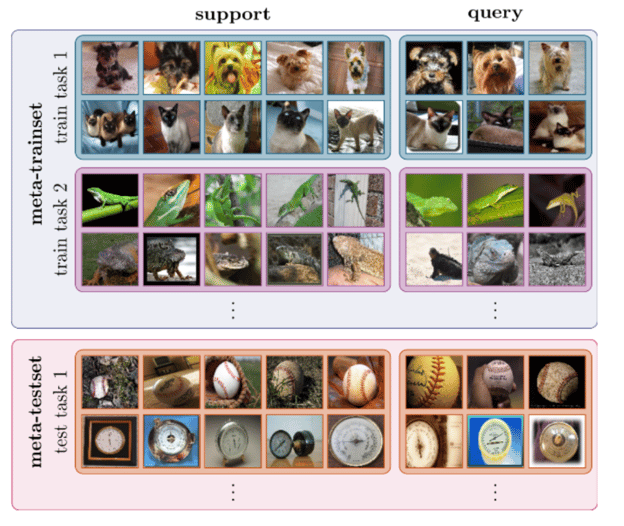
Meta learning per la classificazione delle immagini. Fonte: Dida
Il meta learning può essere usato per risolvere qualsiasi tipo di machine learning, sia supervisionato, non supervisionato o di rinforzo.
Esistono diversi approcci al meta learning. Qui sotto trovi i tre più comuni:
I modelli di meta learning basati sul modello sono progettati specificamente per un apprendimento veloce, cioè possono aggiornare rapidamente i propri parametri con pochi passaggi di addestramento. Questo aggiornamento rapido può essere ottenuto tramite l’architettura interna o controllato da un altro modello meta-learner.
Ecco un elenco delle strategie di meta learning basate sul modello più comuni:
- Memory-Augmented Neural Networks (MANN). Presentate da ricercatori di Google in un articolo del 2016, le MANN sono modelli neurali dotati di un modulo di memoria esterno che consente loro di codificare e recuperare rapidamente nuove informazioni e fare previsioni accurate dopo solo pochi campioni. Quando nuovi dati vengono forniti al modello, queste reti spostano il loro bias attraverso aggiornamenti dei pesi ma modulano anche l’output imparando a memorizzare rapidamente rappresentazioni negli archivi di memoria.
- Meta Networks. Le Meta Networks, o MetaNets, sono un tipo di modello di meta learning proposto da Munkhdalai e Yu in un articolo del 2017. Le meta networks comprendono due modelli: un meta learner e un base learner. Il base learner funziona come una rete neurale tradizionale: prende in input un task e invia informazioni meta sullo spazio del compito corrente al meta learner. Queste informazioni sono usate dal meta learner per aggiornare rapidamente i pesi del modello.
Il meta learning basato su metriche si concentra sull’apprendere una metrica di distanza che calcola la similarità o dissimilarità tra coppie di punti dati. Viene restituito un punteggio alto quando gli oggetti sono simili e un punteggio basso quando le immagini o gli oggetti sono diversi.
L’idea alla base di questo approccio è simile agli algoritmi dei vicini più prossimi, come K-NN o K-means, che usano la distanza tra punti dati per effettuare classificazione o clustering.
Rispetto ai problemi di classificazione tradizionali, dove è necessario molto training data, i modelli basati su metriche possono lavorare con poche istanze.
Alcuni dei modelli più comuni che sfruttano strategie di meta learning basate su metriche sono:
- Convolutional Siamese Neural Network. Le reti siamesi sono un tipo di rete neurale progettata per compiti che coinvolgono la misurazione della similarità o il metric learning, come la verifica facciale. Il modello comprende due reti gemelle e i loro output sono addestrati congiuntamente in cima con una funzione per apprendere la relazione tra coppie di campioni di input. Le reti gemelle sono simili, condividendo gli stessi pesi e parametri.
- Matching Networks. Sviluppate da ricercatori di Google in un articolo del 2016, le Matching Networks usano una distanza metrica chiamata similarità coseno tra due campioni per effettuare classificazioni. L’architettura delle matching network utilizza reti neurali potenziate da memoria, comprendenti una memoria esterna e un meccanismo di attenzione per accedervi.
- Prototypical Networks. Presentate in un articolo del 2017 di Snell et al., le prototypical networks apprendono uno spazio metrico in cui la classificazione può essere eseguita calcolando le distanze dalle rappresentazioni prototipiche di ciascuna classe. Si basano sull’ipotesi che esista un embedding in cui più punti si raggruppano attorno a un’unica rappresentazione prototipica per classe.
Le reti neurali usano la backpropagation dei gradienti per ridurre progressivamente l’errore del modello e migliorarne le prestazioni. La funzione di ottimizzazione è responsabile di trovare il modo più efficace per ricalcolare pesi e bias della rete. Tuttavia, le funzioni di ottimizzazione più popolari sono progettate per gestire grandi quantità di dati di addestramento, piuttosto che dataset piccoli.
Il meta learning basato sull’ottimizzazione si concentra sulla progettazione di funzioni di ottimizzazione innovative che possano aggiornare i parametri del modello con un dataset di addestramento ridotto, così da adattarsi rapidamente a nuovi compiti.
Tra i modelli di meta learning basati sull’ottimizzazione più popolari ci sono:
- LSTM meta-learner. Questo approccio, presentato da Ravi e Larochelle nel 2017, utilizza reti LSTM (long-short term memory) per addestrare un meta-learner che può apprendere l’algoritmo di ottimizzazione esatto usato per addestrare un altro classificatore neurale, accelerando così l’aggiornamento dei parametri per una rapida convergenza in scenari con nuovi task e dati limitati.
- Model-Agnostic Meta Learning (MAML). Presentato da Finn et al. in un articolo del 2017, MAML è compatibile con qualsiasi modello addestrato con discesa del gradiente ed è applicabile a una varietà di problemi di apprendimento, tra cui classificazione, regressione e reinforcement learning. MAML si basa sull’assunto che addestrare i parametri iniziali del modello in poche iterazioni di gradiente porterà a un apprendimento rapido su un nuovo compito. L’obiettivo è determinare parametri del modello sensibili ai cambiamenti di un task, tali che piccole variazioni di quei parametri conducano a grandi miglioramenti nella funzione di loss del task.
- Reptile. Sviluppato da OpenAI, Reptile è un algoritmo di meta learning basato su gradienti di primo ordine. Campiona ripetutamente un compito, esegue la discesa stocastica del gradiente su di esso e aggiorna i parametri iniziali verso i parametri finali appresi su quel task. Reptile è l’applicazione dell’algoritmo Shortest Descent all’impostazione del meta learning ed è matematicamente simile a MAML, con efficienza computazionale e prestazioni analoghe.
In contrasto con i metodi supervisionati tradizionali che richiedono grandi quantità di dati, il meta learning offre un cambio di paradigma, consentendo ai modelli di IA di generalizzare tra i compiti, adattarsi rapidamente con dati minimi e migliorare le prestazioni nel tempo.
Analizziamo alcune delle applicazioni più promettenti:
Few-shot learning
Il few-shot learning è un sottoambito del machine learning in cui i modelli imparano a riconoscere pattern e fare previsioni basandosi su un numero limitato di esempi di addestramento. Il few-shot learning enfatizza la generalizzazione rispetto alla memorizzazione, mettendo in discussione la necessità di un fine-tuning esteso. Per i sostenitori di questo approccio, la chiave sta nella capacità di cogliere la struttura e le caratteristiche sottostanti che definiscono una categoria.
Il few-shot learning rientra nella categoria più ampia del n-shot learning, che comprende varie tecniche in base al numero di esempi forniti:
- Zero-shot learning: non vengono forniti esempi; il modello si basa esclusivamente su conoscenze pregresse o descrizioni.
- One-shot learning: è fornito un solo esempio per classe.
- Two-shot learning: si usano due esempi per classe per l’addestramento.
- Few-shot learning: è disponibile un numero ridotto di esempi (tipicamente tra 3 e 10) per ciascuna classe.
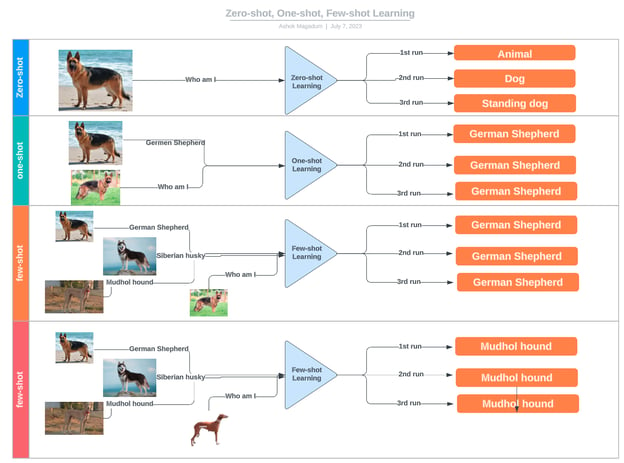
Esempi di zero-shot, one-shot e few-shot learning. Fonte: LinkedIn
Transfer learning
Il transfer learning consente di riutilizzare un modello addestrato per un compito su un altro compito correlato, spesso tramite fine-tuning di un modello pre-addestrato. Il meta learning, invece, si concentra sull’insegnare ai modelli come adattarsi rapidamente a nuovi compiti con un retraining minimo. Sebbene in alcuni casi il meta learning possa potenziare il transfer learning, ad esempio ottimizzando gli iperparametri o selezionando la migliore strategia di fine-tuning, non è un componente necessario del transfer learning. Molti approcci di transfer learning si basano esclusivamente su tecniche di fine-tuning convenzionali piuttosto che sul meta learning.
Sistemi di raccomandazione
I sistemi di raccomandazione utilizzano il feedback degli utenti per trovare nuovi elementi rilevanti per loro o per altri, partendo dal presupposto che utenti con preferenze simili in passato tenderanno ad avere preferenze simili in futuro.
L’obiettivo di un sistema di raccomandazione è fornire agli utenti consigli personalizzati in base alle loro preferenze e al comportamento passato. Il meta learning può aiutare a raggiungere questo obiettivo imparando come ottimizzare l’algoritmo di raccomandazione per ciascun utente.
I sistemi di meta-raccomandazione consistono in due livelli: un sistema di raccomandazione di base e un ottimizzatore a livello meta. Il sistema di base genera raccomandazioni per gli utenti in base al comportamento passato, mentre l’ottimizzatore meta impara come ottimizzare il sistema di base per ciascun utente.
Automated machine learning (AutoML)
L’automated machine learning, noto anche come AutoML, è il processo di automazione end-to-end della costruzione di modelli di machine learning. Include attività come il preprocessing dei dati, l’ingegneria delle caratteristiche, la selezione del modello e il tuning degli iperparametri.
Le tecniche di meta learning possono supportare questi processi, ad esempio automatizzando l’ottimizzazione e l’adattamento degli iperparametri, o persino individuando il modello più adatto a risolvere uno specifico compito.
Ci sono diverse ragioni convincenti per cui i ricercatori di machine learning ricorrono sempre più spesso a strategie di meta learning per sviluppare i propri modelli.
-
Efficienza di addestramento: il meta learning riduce i tempi di training evitando la necessità di addestrare modelli con dataset enormi e permette il fine-tuning con dati limitati.
-
Riduzione dei costi operativi: il meta learning riduce i costi eliminando la necessità di addestrare i modelli da zero, dove sia l’acquisizione dei dati sia l’uso di risorse computazionali per l’addestramento possono essere costosi.
-
Maggiore adattabilità e riusabilità: il meta learning è una tecnica chiave che consente ai modelli di adattarsi a molteplici scenari e compiti, aumentandone potenziale e utilità.
-
Prestazioni del modello: oltre a migliorare l’adattabilità, il meta learning può anche aumentare l’accuratezza dei modelli di machine learning esistenti.
Tuttavia, il meta learning non è una strategia valida per ogni situazione. Ha limitazioni e potenziali insidie che devono essere affrontate con attenzione. Alcune delle sfide più comuni nel meta learning sono:
-
Mismatch di dominio: il meta learning tende a funzionare meglio quando i compiti di origine e di destinazione sono in qualche modo correlati. Se il nuovo compito è molto diverso, le conoscenze generalizzabili trasferite potrebbero non bastare per svolgere accuratamente il nuovo task e possono persino ridurre le prestazioni in tutti i compiti.
-
Scarsità di dati: è sempre richiesto un certo quantitativo di dati di addestramento. Se i dati sono estremamente limitati o di scarsa qualità, il modello rischia l’underfitting.
-
Overfitting: il meta learning non è immune all’overfitting. Se il modello viene ottimizzato troppo su un compito, può apprendere caratteristiche specifiche che non generalizzano bene a nuovi dati.
-
Complessità e costo: talvolta il compito target è così complesso che il processo di fine-tuning può risultare impegnativo, costoso dal punto di vista computazionale e dispendioso in termini di tempo.
Direzioni future e opportunità di ricerca
Il meta learning è un approccio progettuale cruciale per aumentare l’efficienza e il potenziale delle reti neurali. Si può dire che l’attuale rivoluzione dell’IA non sarebbe stata possibile senza le numerose tecniche di transfer learning disponibili.
Il campo si sta evolvendo rapidamente, con alcune aree che richiedono ulteriori ricerche, tra cui:
- Efficienza campionaria. Quanti dati sono necessari perché un modello diventi efficace in nuovi compiti? Questa è una domanda centrale nel meta learning. Sebbene le strategie di short-shot learning mostrino che è possibile per un modello imparare con dati limitati, c’è ancora un ampio margine di miglioramento per rendere i modelli più efficienti e versatili.
- Diversità dei compiti. Le tecniche di meta learning tendono a funzionare meglio quando i compiti in questione sono in qualche modo correlati. Tuttavia, ulteriori ricerche sono fondamentali per far progredire modelli di meta learning che possano generalizzare su un’ampia gamma di compiti senza overfitting.
- Tecniche avanzate. Il meta learning è un catalizzatore centrale d’innovazione in alcune delle tecnologie più promettenti e preziose di oggi, tra cui il reinforcement learning, la robotica e i transformer.
Conclusione
Man mano che i modelli di machine learning diventano più grandi e complessi, trovare tecniche nuove per renderli più efficienti e versatili è cruciale perché l’industria dell’IA mantenga le sue promesse, faccia tornare i conti e promuova la sostenibilità nel settore.
Il meta learning ha molto da dire a questo proposito. Questo campo di ricerca si sta evolvendo rapidamente, offrendo un insieme di tecniche e strategie cruciali per far progredire le capacità dell’IA. Resta sintonizzato con DataCamp per conoscere le ultime novità su meta learning, IA e molto altro:







Storicamente, molti modelli di machine learning sono stati progettati per l’apprendimento specifico di un compito, richiedendo grandi dataset per ogni nuovo task. Date le limitazioni tecniche dell’epoca, l’approccio più efficace era addestrare i modelli con un enorme dataset specifico per il compito. Di conseguenza, i modelli all’avanguardia erano estremamente efficaci nel predire l’esito del problema per cui erano stati addestrati. Tuttavia, questi modelli erano ancora lontani dagli esseri umani e dalla nostra straordinaria capacità di imparare nuovi compiti basandoci sulle esperienze precedenti.
Aggiungere strategie di apprendimento adattivo ai modelli di machine learning è la missione centrale del meta learning, un sottoambito del machine learning che si concentra sul migliorare il modo in cui i modelli apprendono nuovi compiti in modo efficiente. Il meta learning punta a insegnare ai modelli ad adattarsi rapidamente con un retraining limitato e un intervento umano minimo, migliorando le prestazioni nel tempo.
In questo articolo ti offriremo un’introduzione al meta learning e a come sta rivoluzionando il machine learning. Tratteremo gli aspetti tecnici dei modelli di meta learning, gli approcci e le applicazioni più comuni, oltre a benefici e sfide. Dopo, ti invito a provare il nostro skill track AI Fundamentals per acquisire davvero dimestichezza nel parlare dei diversi concetti dell’IA e di quelli correlati.
Che cos’è il meta learning?
La ricerca sul meta learning risale agli anni ’80, ma il campo ha acquisito rilevanza negli anni 2010, con l’ascesa delle reti neurali e, più recentemente, con lo sviluppo dell’IA generativa. Il meta learning, come sottoambito del machine learning, si concentra sull’insegnare ai modelli come imparare nuovi compiti in modo rapido ed efficiente. Si ispira alla capacità umana di “imparare a imparare”, per così dire.
Immagina di voler imparare a risolvere velocemente i problemi di matematica. Un approccio tradizionale sarebbe memorizzare le soluzioni di molti problemi diversi, così quando ne vedi uno familiare puoi richiamare subito la risposta. Tuttavia, questo approccio vacilla quando ti imbatti in un problema del tutto nuovo.
Invece, cosa accadrebbe se ti concentrassi sull’apprendere strategie generali per risolvere i problemi, piuttosto che memorizzare soluzioni specifiche? Potresti studiare tecniche di problem solving, individuare schemi ricorrenti e sviluppare un’intuizione per affrontare nuove sfide. In questo modo, di fronte a un problema nuovo, puoi adattarti rapidamente e applicare il metodo giusto, anche se non hai mai visto esattamente quel problema prima.
Questa è l’essenza del meta learning. Il machine learning tradizionale memorizza schemi da grandi dataset per un singolo compito, mentre il meta learning addestra i modelli ad adattarsi rapidamente a nuovi compiti imparando come imparare in modo efficace.
Come funziona il meta learning
Puoi pensare ai modelli di meta learning come a un sistema che include un sottosistema di apprendimento adattato dinamicamente sfruttando l’esperienza di precedenti episodi di apprendimento o di compiti diversi.
Al contrario dei modelli tradizionali di machine learning, che considerano un singolo compito con un dataset fisso e ampio, i meta modelli sono esposti a una gamma di compiti per estrarre pattern generalizzabili. Normalmente, ogni problema è associato a un dataset di addestramento più piccolo e specifico per il compito.
L’obiettivo del processo di meta training è estrarre informazioni generali sul processo di apprendimento sui singoli compiti, per migliorare la capacità del modello di affrontare task inediti con poco retraining.
Lo sviluppo di modelli di meta learning segue un processo in due fasi che ricalca il processo di addestramento del machine learning tradizionale:
Il processo di meta-training e meta-testing è illustrato nell’immagine seguente.
Meta learning per la classificazione delle immagini. Fonte: Dida
Il meta learning può essere usato per risolvere qualsiasi tipo di machine learning, sia supervisionato, non supervisionato o di rinforzo.
Approcci comuni al meta learning
Esistono diversi approcci al meta learning. Qui sotto trovi i tre più comuni:
Meta learning basato sul modello
I modelli di meta learning basati sul modello sono progettati specificamente per un apprendimento veloce, cioè possono aggiornare rapidamente i propri parametri con pochi passaggi di addestramento. Questo aggiornamento rapido può essere ottenuto tramite l’architettura interna o controllato da un altro modello meta-learner.
Ecco un elenco delle strategie di meta learning basate sul modello più comuni:
Meta learning basato su metriche
Il meta learning basato su metriche si concentra sull’apprendere una metrica di distanza che calcola la similarità o dissimilarità tra coppie di punti dati. Viene restituito un punteggio alto quando gli oggetti sono simili e un punteggio basso quando le immagini o gli oggetti sono diversi.
L’idea alla base di questo approccio è simile agli algoritmi dei vicini più prossimi, come K-NN o K-means, che usano la distanza tra punti dati per effettuare classificazione o clustering.
Rispetto ai problemi di classificazione tradizionali, dove è necessario molto training data, i modelli basati su metriche possono lavorare con poche istanze.
Alcuni dei modelli più comuni che sfruttano strategie di meta learning basate su metriche sono:
Meta learning basato sull’ottimizzazione
Le reti neurali usano la backpropagation dei gradienti per ridurre progressivamente l’errore del modello e migliorarne le prestazioni. La funzione di ottimizzazione è responsabile di trovare il modo più efficace per ricalcolare pesi e bias della rete. Tuttavia, le funzioni di ottimizzazione più popolari sono progettate per gestire grandi quantità di dati di addestramento, piuttosto che dataset piccoli.
Il meta learning basato sull’ottimizzazione si concentra sulla progettazione di funzioni di ottimizzazione innovative che possano aggiornare i parametri del modello con un dataset di addestramento ridotto, così da adattarsi rapidamente a nuovi compiti.
Tra i modelli di meta learning basati sull’ottimizzazione più popolari ci sono:
Meta learning e altri tipi di apprendimento
In contrasto con i metodi supervisionati tradizionali che richiedono grandi quantità di dati, il meta learning offre un cambio di paradigma, consentendo ai modelli di IA di generalizzare tra i compiti, adattarsi rapidamente con dati minimi e migliorare le prestazioni nel tempo.
Analizziamo alcune delle applicazioni più promettenti:
Few-shot learning
Il few-shot learning è un sottoambito del machine learning in cui i modelli imparano a riconoscere pattern e fare previsioni basandosi su un numero limitato di esempi di addestramento. Il few-shot learning enfatizza la generalizzazione rispetto alla memorizzazione, mettendo in discussione la necessità di un fine-tuning esteso. Per i sostenitori di questo approccio, la chiave sta nella capacità di cogliere la struttura e le caratteristiche sottostanti che definiscono una categoria.
Il few-shot learning rientra nella categoria più ampia del n-shot learning, che comprende varie tecniche in base al numero di esempi forniti:
Esempi di zero-shot, one-shot e few-shot learning. Fonte: LinkedIn
Transfer learning
Il transfer learning consente di riutilizzare un modello addestrato per un compito su un altro compito correlato, spesso tramite fine-tuning di un modello pre-addestrato. Il meta learning, invece, si concentra sull’insegnare ai modelli come adattarsi rapidamente a nuovi compiti con un retraining minimo. Sebbene in alcuni casi il meta learning possa potenziare il transfer learning, ad esempio ottimizzando gli iperparametri o selezionando la migliore strategia di fine-tuning, non è un componente necessario del transfer learning. Molti approcci di transfer learning si basano esclusivamente su tecniche di fine-tuning convenzionali piuttosto che sul meta learning.
Sistemi di raccomandazione
I sistemi di raccomandazione utilizzano il feedback degli utenti per trovare nuovi elementi rilevanti per loro o per altri, partendo dal presupposto che utenti con preferenze simili in passato tenderanno ad avere preferenze simili in futuro.
L’obiettivo di un sistema di raccomandazione è fornire agli utenti consigli personalizzati in base alle loro preferenze e al comportamento passato. Il meta learning può aiutare a raggiungere questo obiettivo imparando come ottimizzare l’algoritmo di raccomandazione per ciascun utente.
I sistemi di meta-raccomandazione consistono in due livelli: un sistema di raccomandazione di base e un ottimizzatore a livello meta. Il sistema di base genera raccomandazioni per gli utenti in base al comportamento passato, mentre l’ottimizzatore meta impara come ottimizzare il sistema di base per ciascun utente.
Automated machine learning (AutoML)
L’automated machine learning, noto anche come AutoML, è il processo di automazione end-to-end della costruzione di modelli di machine learning. Include attività come il preprocessing dei dati, l’ingegneria delle caratteristiche, la selezione del modello e il tuning degli iperparametri.
Le tecniche di meta learning possono supportare questi processi, ad esempio automatizzando l’ottimizzazione e l’adattamento degli iperparametri, o persino individuando il modello più adatto a risolvere uno specifico compito.
Vantaggi e sfide del meta learning
Ci sono diverse ragioni convincenti per cui i ricercatori di machine learning ricorrono sempre più spesso a strategie di meta learning per sviluppare i propri modelli.
Efficienza di addestramento: il meta learning riduce i tempi di training evitando la necessità di addestrare modelli con dataset enormi e permette il fine-tuning con dati limitati.
Riduzione dei costi operativi: il meta learning riduce i costi eliminando la necessità di addestrare i modelli da zero, dove sia l’acquisizione dei dati sia l’uso di risorse computazionali per l’addestramento possono essere costosi.
Maggiore adattabilità e riusabilità: il meta learning è una tecnica chiave che consente ai modelli di adattarsi a molteplici scenari e compiti, aumentandone potenziale e utilità.
Prestazioni del modello: oltre a migliorare l’adattabilità, il meta learning può anche aumentare l’accuratezza dei modelli di machine learning esistenti.
Tuttavia, il meta learning non è una strategia valida per ogni situazione. Ha limitazioni e potenziali insidie che devono essere affrontate con attenzione. Alcune delle sfide più comuni nel meta learning sono:
Mismatch di dominio: il meta learning tende a funzionare meglio quando i compiti di origine e di destinazione sono in qualche modo correlati. Se il nuovo compito è molto diverso, le conoscenze generalizzabili trasferite potrebbero non bastare per svolgere accuratamente il nuovo task e possono persino ridurre le prestazioni in tutti i compiti.
Scarsità di dati: è sempre richiesto un certo quantitativo di dati di addestramento. Se i dati sono estremamente limitati o di scarsa qualità, il modello rischia l’underfitting.
Overfitting: il meta learning non è immune all’overfitting. Se il modello viene ottimizzato troppo su un compito, può apprendere caratteristiche specifiche che non generalizzano bene a nuovi dati.
Complessità e costo: talvolta il compito target è così complesso che il processo di fine-tuning può risultare impegnativo, costoso dal punto di vista computazionale e dispendioso in termini di tempo.
Direzioni future e opportunità di ricerca
Il meta learning è un approccio progettuale cruciale per aumentare l’efficienza e il potenziale delle reti neurali. Si può dire che l’attuale rivoluzione dell’IA non sarebbe stata possibile senza le numerose tecniche di transfer learning disponibili.
Il campo si sta evolvendo rapidamente, con alcune aree che richiedono ulteriori ricerche, tra cui:
Conclusione
Man mano che i modelli di machine learning diventano più grandi e complessi, trovare tecniche nuove per renderli più efficienti e versatili è cruciale perché l’industria dell’IA mantenga le sue promesse, faccia tornare i conti e promuova la sostenibilità nel settore.
Il meta learning ha molto da dire a questo proposito. Questo campo di ricerca si sta evolvendo rapidamente, offrendo un insieme di tecniche e strategie cruciali per far progredire le capacità dell’IA. Resta sintonizzato con DataCamp per conoscere le ultime novità su meta learning, IA e molto altro:
Cos’è il few-shot learning? Scopri di più con dati limitati
Cos’è il deep learning? Un tutorial per principianti
Capire il superalignment: allineare l’IA ai valori umani
Cos’è l’allineamento dell’IA? Garantire che l’IA lavori per l’umanità
Cos’è il transfer learning nell’IA? Una guida introduttiva con esempi
Concetti di IA generativa