Khóa học
Nhập môn Ngôn ngữ lập trình R
4 giờ
3.1M
Hồi quy tuyến tính là một trong những kỹ thuật thống kê quan trọng và nền tảng nhất. Thành thạo kỹ thuật này là điều thiết yếu với bất kỳ nhà phân tích dữ liệu hay nhà khoa học dữ liệu nào vì, như bạn sẽ thấy, nó là cơ sở của nhiều phương pháp nâng cao khác.
Hướng dẫn này sẽ dẫn bạn qua quy trình thực hiện hồi quy tuyến tính trong R, một ngôn ngữ lập trình quan trọng. Kết thúc bài này, bạn sẽ hiểu cách triển khai và diễn giải các mô hình hồi quy tuyến tính, từ đó dễ dàng áp dụng kiến thức này vào các tác vụ phân tích dữ liệu.
Nếu bạn chưa quen với ngôn ngữ R, tôi khuyến nghị các hướng dẫn sau để bắt đầu: Phân tích dữ liệu khám phá trong R cho người mới bắt đầu tuyệt đối và Làm chủ cấu trúc dữ liệu trong ngôn ngữ lập trình R.
Hồi quy tuyến tính là một mô hình thống kê phân tích mối quan hệ giữa một biến phản hồi (thường gọi là y) và một hoặc nhiều biến cùng các tương tác của chúng (thường gọi là x hay biến giải thích). Bạn vẫn thiết lập những mối quan hệ kiểu này trong đầu mọi lúc; ví dụ, khi bạn ước tính tuổi của một đứa trẻ dựa trên chiều cao của chúng, bạn đang giả định rằng càng lớn tuổi thì sẽ càng cao.
Hồi quy tuyến tính là một trong những mô hình thống kê cơ bản nhất. Kết quả của nó có thể được hầu như ai cũng diễn giải, và nó đã tồn tại từ đầu thế kỷ 19. Chính điều này khiến hồi quy tuyến tính rất phổ biến. Nó đơn giản và đã bền bỉ hàng trăm năm. Dù không tinh vi như các thuật toán khác như mạng nơ-ron nhân tạo hay rừng ngẫu nhiên, theo một khảo sát của KD Nuggets, hồi quy là thuật toán được các nhà khoa học dữ liệu dùng nhiều nhất vào các năm 2016 và 2017. Thậm chí còn có dự đoán rằng nó vẫn sẽ được dùng vào năm 2118!
Trong hướng dẫn hồi quy tuyến tính này, chúng ta sẽ khám phá cách tạo một hồi quy tuyến tính trong R, xem các bước bạn cần thực hiện với một ví dụ có thể tự tay làm theo.
Để tự chạy dễ dàng toàn bộ mã ví dụ trong hướng dẫn này, bạn có thể tạo một sổ tay DataLab miễn phí với R được cài sẵn và chứa toàn bộ mẫu mã. Để thực hành thêm về hồi quy tuyến tính, hãy xem bài tập thực hành trên DataCamp của chúng tôi.
Không phải vấn đề nào cũng giải được bằng cùng một thuật toán. Hồi quy tuyến tính được biết là phù hợp khi có mối quan hệ tuyến tính giữa biến phản hồi và biến kết quả. Nói cách khác, hồi quy tuyến tính giả định rằng tồn tại một mối quan hệ tuyến tính giữa biến phản hồi và các biến giải thích. Trong trường hợp hai biến, điều này có nghĩa là bạn có thể khớp một đường thẳng giữa hai biến. Quay lại ví dụ trước về tuổi của trẻ em, rõ ràng có mối quan hệ giữa tuổi và chiều cao.
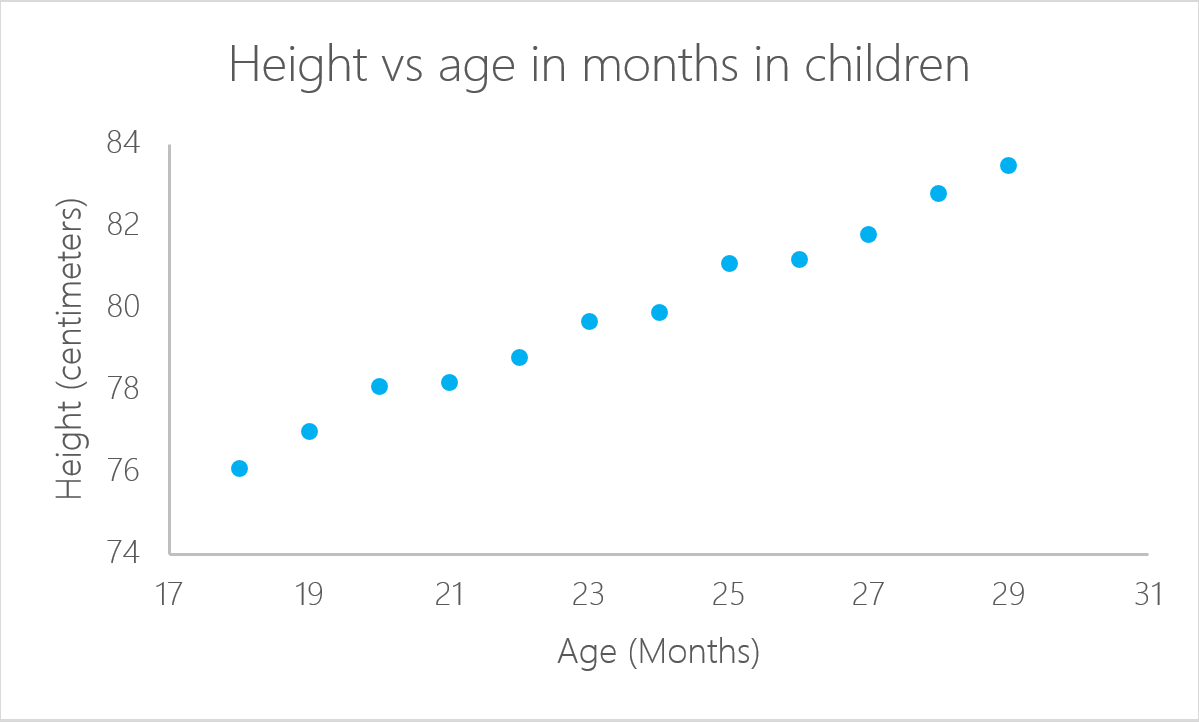
Trong ví dụ cụ thể này, bạn có thể tính chiều cao của một đứa trẻ nếu biết tuổi của bé:
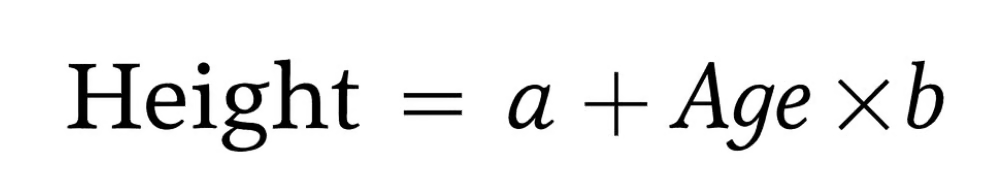
Trong trường hợp này, a và b lần lượt được gọi là hệ số chặn (intercept) và hệ số dốc (slope). Với cùng ví dụ, a, hay hệ số chặn, là giá trị bắt đầu đo. Trẻ sơ sinh 0 tháng tuổi không phải cao 0 cm. Đây là vai trò của hệ số chặn. Hệ số dốc đo mức thay đổi chiều cao theo tuổi tính bằng tháng. Nói chung, mỗi tháng lớn hơn, chiều cao của trẻ sẽ tăng thêm b.
Một hồi quy tuyến tính có thể được tính trong R với lệnh lm(). Ở ví dụ tiếp theo, chúng ta dùng lệnh này để tính chiều cao ước tính dựa trên tuổi của trẻ.
Trước hết, nhập thư viện readxl để đọc tệp Microsoft Excel. Khóa học Giới thiệu nhập dữ liệu trong R của chúng tôi là một nguồn học tuyệt vời nếu bạn chưa quen việc nhập tệp Excel hoặc CSV vào môi trường R như RStudio.
Bạn có thể tải về bộ dữ liệu dùng cho hướng dẫn này trước khi bắt đầu. Tải dữ liệu vào một đối tượng tên ageandheight rồi tạo hồi quy tuyến tính ở dòng thứ ba. Hàm lm() nhận các biến theo định dạng:
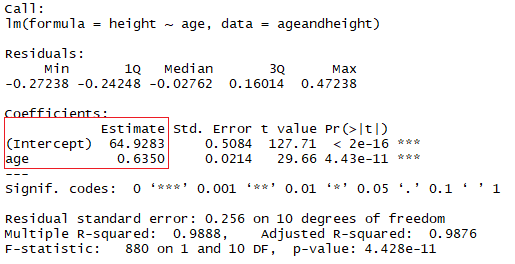
lm([target] ~ [predictor], data = [data source])Trong đoạn mã sau, chúng ta dùng hàm lm() để tạo một đối tượng mô hình tuyến tính, gọi là lmHeight. Sau đó dùng hàm summary() trên lmHeight để xem thông tin chi tiết về hiệu năng và các hệ số của mô hình.
library(readxl)

ageandheight <- read_excel("ageandheight.xls", sheet = "Hoja2") #Upload the data

lmHeight = lm(height~age, data = ageandheight) #Create the linear regression

summary(lmHeight) #Review the resultsTrong ô vuông màu đỏ, bạn có thể thấy giá trị của hệ số chặn (giá trị “a”) và hệ số dốc (giá trị “b”) cho biến tuổi. Các giá trị “a” và “b” này vẽ nên một đường giữa tất cả các điểm dữ liệu. Vậy nên, trong trường hợp này, nếu có một đứa trẻ 20,5 tháng tuổi, a là 64,92 và b là 0,635, mô hình dự đoán (trung bình) rằng chiều cao tính bằng cm sẽ khoảng 64,92 + (0,635 × 20,5) = 77,93 cm.
Khi một hồi quy tính đến hai hay nhiều biến dự đoán để tạo hồi quy tuyến tính, nó được gọi là hồi quy tuyến tính bội. Theo cùng logic với ví dụ đơn giản trước đó, chiều cao của đứa trẻ sẽ được đo bằng:
Chiều cao = a + Tuổi × b1 + (Số anh chị em} × b2
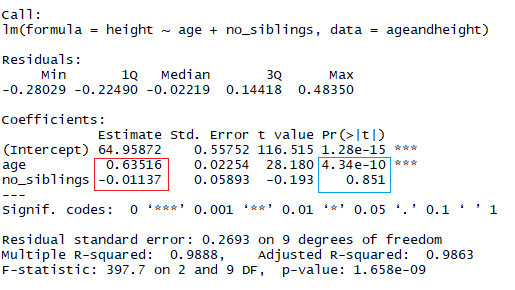
Bây giờ bạn đang xem chiều cao như một hàm của tuổi tính theo tháng và số anh chị em mà đứa trẻ có. Trên hình ảnh phía trên, hình chữ nhật màu đỏ chỉ các hệ số (b1 và b2). Bạn có thể diễn giải các hệ số này như sau:
Khi so sánh những đứa trẻ có cùng số lượng anh chị em, chiều cao dự đoán trung bình tăng 0,63 cm cho mỗi tháng tuổi tăng thêm. Tương tự, khi so sánh những đứa trẻ có cùng tuổi, chiều cao giảm (vì hệ số âm) 0,01 cm cho mỗi lần tăng thêm một người anh chị em.
Trong R, để thêm một hệ số khác, hãy thêm ký hiệu "+" cho mỗi biến bổ sung bạn muốn đưa vào mô hình.
lmHeight2 = lm(height~age + no_siblings, data = ageandheight) #Create a linear regression with two variables
summary(lmHeight2) #Review the results
Như bạn có thể nhận ra, xem xét số anh chị em là một cách khập khiễng để dự đoán chiều cao của trẻ. Một khía cạnh khác cần chú ý trong các mô hình tuyến tính là p-value của các hệ số. Trong ví dụ trước, hình chữ nhật màu xanh lam chỉ p-value cho các hệ số tuổi và số anh chị em. Nói đơn giản, p-value cho biết bạn có thể bác bỏ hay chấp nhận một giả thuyết hay không. Giả thuyết, trong trường hợp này, là biến dự đoán không có ý nghĩa đối với mô hình của bạn.
Một cách tiêu chuẩn để kiểm tra xem các biến dự đoán có không có ý nghĩa hay không là xem p-value có nhỏ hơn 0,05 không.
Một cách tốt để kiểm tra chất lượng độ khớp của mô hình là xem các phần dư, tức chênh lệch giữa giá trị thực tế và giá trị dự đoán. Đường thẳng trên hình phía trên biểu diễn các giá trị dự đoán. Đường dọc màu đỏ từ đường thẳng đến giá trị quan sát được là phần dư.
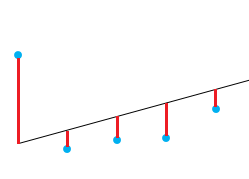
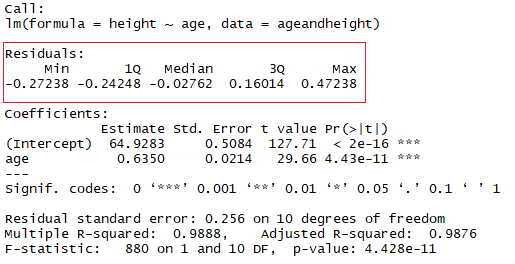
Ý tưởng ở đây là tổng các phần dư xấp xỉ bằng không hoặc càng nhỏ càng tốt. Trong thực tế, hầu hết trường hợp sẽ không theo một đường thẳng hoàn hảo, nên phần dư là điều được kỳ vọng. Trong phần tóm tắt của hàm lm() trong R, bạn có thể xem thống kê mô tả về phần dư của mô hình; theo ví dụ, ô đỏ cho thấy các phần dư xấp xỉ bằng không.
Một thước đo rất thường được dùng để kiểm tra mức độ tốt của mô hình là hệ số xác định hay R². Thước đo này được định nghĩa là tỷ lệ biến thiên tổng thể được giải thích bởi mô hình hồi quy.
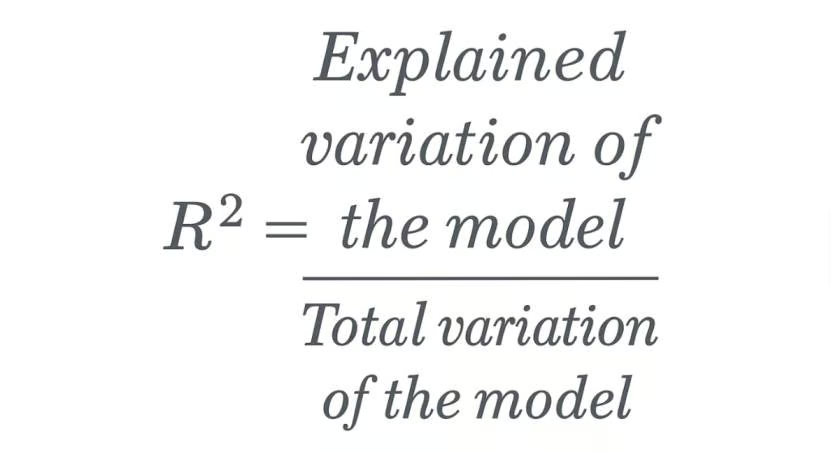
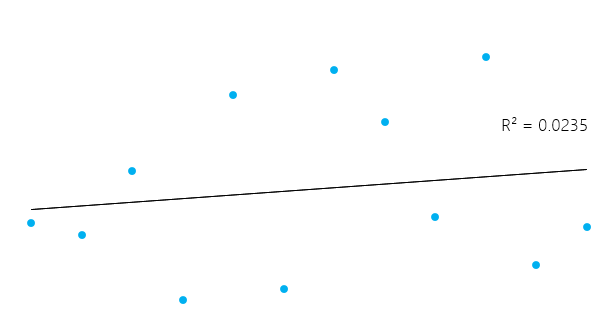
Điều này có thể trông hơi phức tạp, nhưng nhìn chung, với các mô hình khớp dữ liệu tốt, R² gần 1. Các mô hình khớp kém có R² gần 0. Trong các ví dụ dưới đây, ví dụ đầu có R² là 0,02; nghĩa là mô hình chỉ giải thích được 2% biến thiên của dữ liệu. Ví dụ thứ hai có R² là 0,99 và mô hình có thể giải thích 99% biến thiên tổng.**
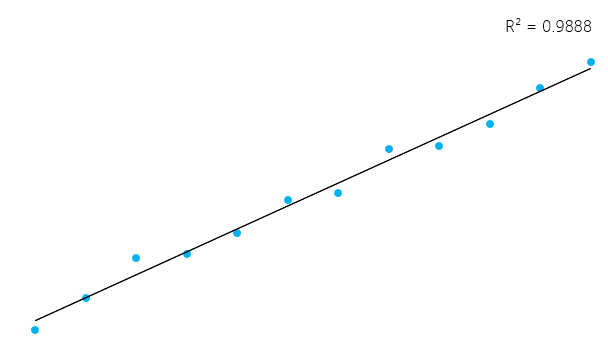
Tuy nhiên, điều quan trọng là nhớ rằng đôi khi R² cao không phải lúc nào cũng tốt (xem các đồ thị phần dư bên dưới) và R² thấp không phải lúc nào cũng xấu. Trong đời thực, các hiện tượng không phải lúc nào cũng nằm gọn trên một đường thẳng. Ví dụ, trong dữ liệu của bạn có thể có những đứa trẻ cao hơn hoặc thấp hơn dù cùng tuổi. Ở một số lĩnh vực, R² bằng 0,5 được coi là tốt.
Với cùng ví dụ như trên, xem phần tóm tắt của mô hình tuyến tính để thấy R² của nó.
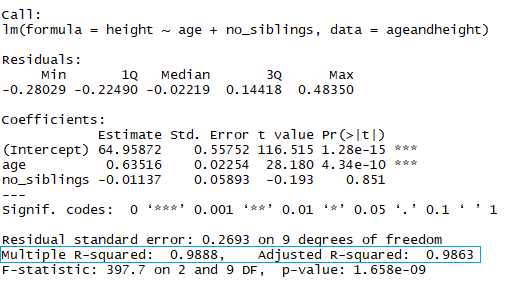
Trong hình chữ nhật màu xanh lam, lưu ý có hai giá trị R² khác nhau, một là multiple và một là adjusted. Multiple chính là R² bạn đã thấy trước đó. Một vấn đề với R² này là nó không thể giảm khi bạn thêm nhiều biến độc lập vào mô hình; nó sẽ tiếp tục tăng khi bạn làm mô hình phức tạp hơn, ngay cả khi các biến đó không đóng góp gì cho dự đoán (như ví dụ số anh chị em). Vì lý do này, adjusted R² có lẽ phù hợp hơn để quan sát nếu bạn thêm nhiều hơn một biến vào mô hình, vì nó chỉ tăng khi làm giảm lỗi dự đoán tổng thể.
Bạn có thể có một R² khá tốt trong mô hình, nhưng đừng vội kết luận. Hãy xem một ví dụ. Bạn sẽ dự đoán áp suất của một vật liệu trong phòng thí nghiệm dựa trên nhiệt độ của nó.
Hãy vẽ dữ liệu (trong một biểu đồ phân tán đơn giản) và thêm đường thẳng bạn xây dựng bằng mô hình tuyến tính. Trong ví dụ này, để R đọc dữ liệu trước bằng lệnh read_excel, tạo một dataframe với dữ liệu, rồi tạo hồi quy tuyến tính với dữ liệu mới. Lệnh plot() nhận một data frame và vẽ các biến trên đó. Trong trường hợp này, nó vẽ áp suất theo nhiệt độ của vật liệu. Sau đó, thêm đường thẳng do hồi quy tuyến tính tạo bằng lệnh abline.
pressure <- read_excel("pressure.xlsx") #Upload the data
lmTemp = lm(Pressure~Temperature, data = pressure) #Create the linear regression
plot(pressure, pch = 16, col = "blue") #Plot the results
abline(lmTemp) #Add a regression line
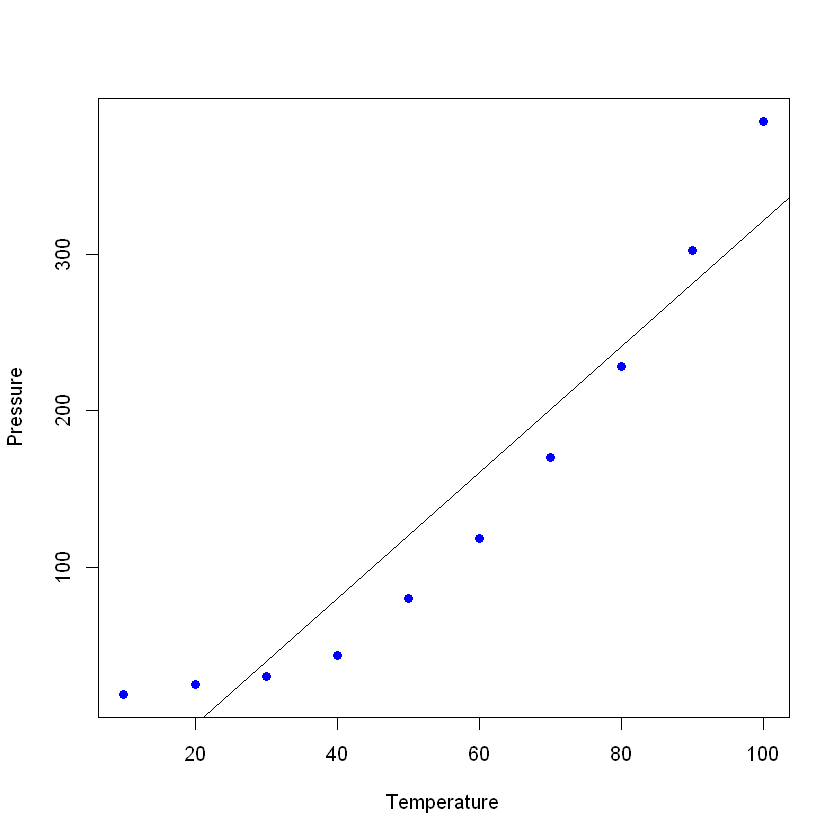
Nếu bạn xem phần tóm tắt của mô hình mới, bạn có thể thấy nó cho kết quả khá tốt (xem R² và adjusted R²)
summary(lmTemp)
Call:
lm(formula = Pressure ~ Temperature, data = pressure)

Residuals:
   Min     1Q Median     3Q    Max
-41.85 -34.72 -10.90  24.69  63.51

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) -81.5000    29.1395  -2.797   0.0233 *
Temperature   4.0309     0.4696   8.583 2.62e-05 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 42.66 on 8 degrees of freedom
Multiple R-squared:  0.902,    Adjusted R-squared:  0.8898
F-statistic: 73.67 on 1 and 8 DF,  p-value: 2.622e-05
Lý tưởng nhất, khi bạn vẽ phần dư, chúng nên trông ngẫu nhiên. Nếu không, có nghĩa là có thể tồn tại một mẫu ẩn mà mô hình tuyến tính không xét đến. Để vẽ phần dư, dùng lệnh plot(lmTemp$residuals).
plot(lmTemp$residuals, pch = 16, col = "red")
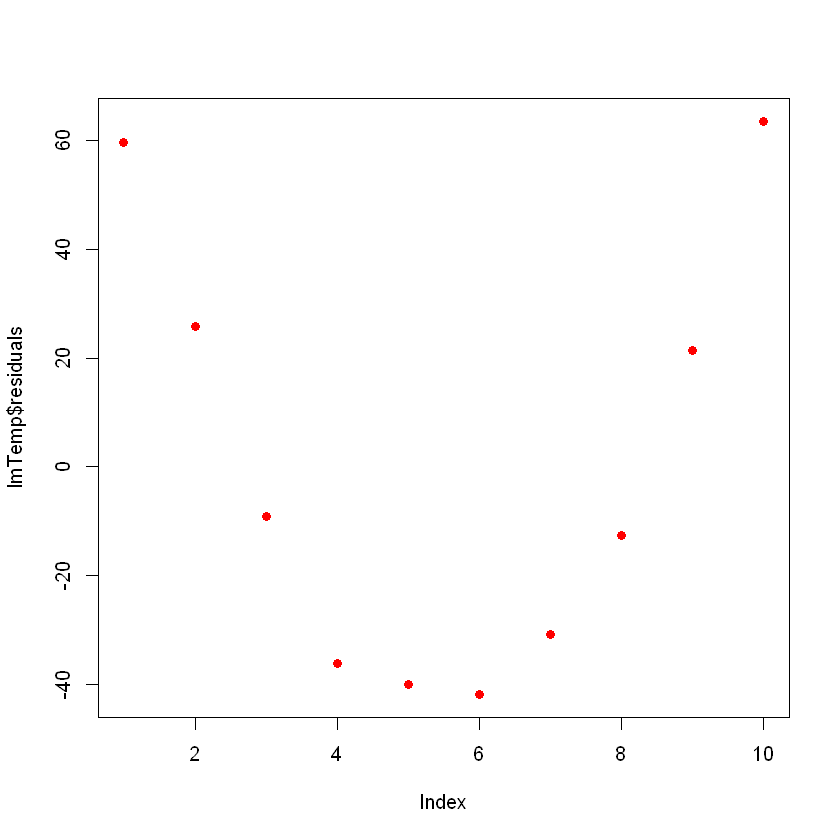
Điều này có thể là một vấn đề. Nếu bạn có thêm dữ liệu, mô hình tuyến tính đơn giản sẽ không khái quát tốt. Ở hình trước, chú ý rằng có một mẫu (như một đường cong trên phần dư). Điều này hoàn toàn không ngẫu nhiên.
Bạn có thể thực hiện phép biến đổi biến. Có nhiều phép biến đổi có thể áp dụng cho dữ liệu của bạn, như thêm hạng tử bậc hai (x2), bậc ba (x3), hoặc phức tạp hơn như ln(X), ln(X+1), sqrt(X), 1/x, Exp(X). Việc lựa chọn phép biến đổi phù hợp sẽ đến từ một chút hiểu biết về các hàm đại số, thực hành, thử và sai.
Hãy thử với một hạng tử bậc hai. Để làm điều này, thêm từ “I” (chữ “I” in hoa) trước phép biến đổi của bạn; ví dụ, đây sẽ là công thức hồi quy tuyến tính thông thường:
lmTemp2 = lm(Pressure~Temperature + I(Temperature^2), data = pressure) #Create a linear regression with a quadratic coefficient
summary(lmTemp2) #Review the results
Call:
lm(formula = Pressure ~ Temperature + I(Temperature^2), data = pressure)

Residuals:
    Min      1Q  Median      3Q     Max
-4.6045 -1.6330  0.5545  1.1795  4.8273

Coefficients:
                  Estimate Std. Error t value Pr(>|t|)
(Intercept)      33.750000   3.615591   9.335 3.36e-05 ***
Temperature      -1.731591   0.151002 -11.467 8.62e-06 ***
I(Temperature^2)  0.052386   0.001338  39.158 1.84e-09 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 3.074 on 7 degrees of freedom
Multiple R-squared:  0.9996,    Adjusted R-squared:  0.9994
F-statistic:  7859 on 2 and 7 DF,  p-value: 1.861e-12
Lưu ý rằng mô hình đã cải thiện đáng kể. Nếu bạn vẽ phần dư của mô hình mới, chúng sẽ trông như sau:
plot(lmTemp2$residuals, pch = 16, col = "red")
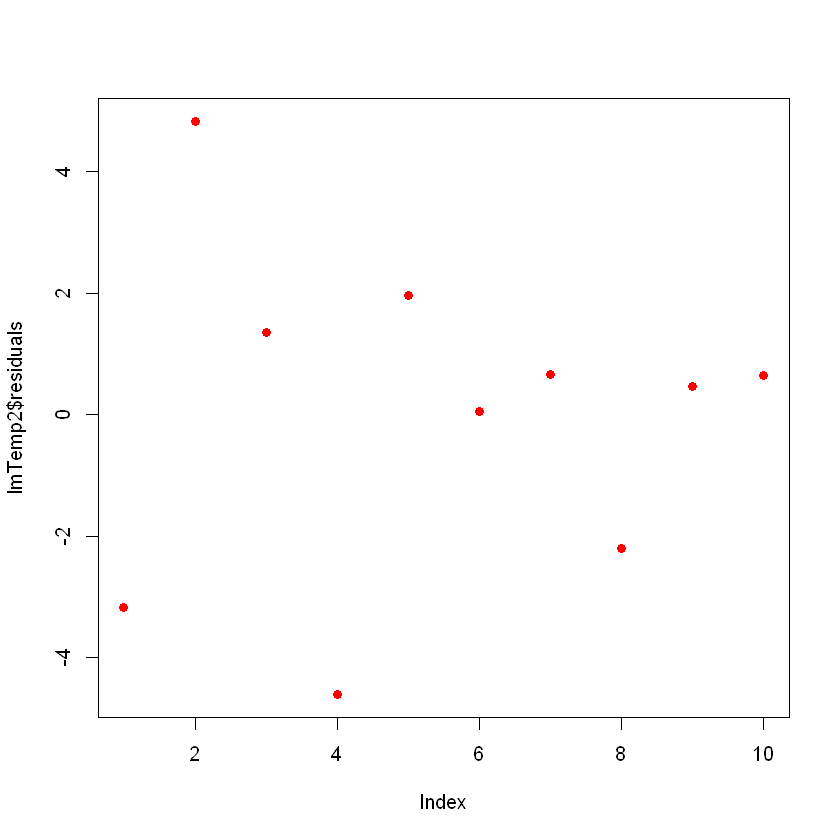
Bây giờ bạn không còn thấy mẫu rõ ràng nào trên phần dư nữa, đó là điều tốt!
Trong dữ liệu của bạn, có thể có các điểm ảnh hưởng mạnh làm lệch mô hình, đôi khi không cần thiết. Hãy nghĩ đến một lỗi nhập liệu: thay vì ghi “2.3” thì lại là “23”. Loại điểm ảnh hưởng mạnh phổ biến nhất là ngoại lệ (outlier), tức các điểm dữ liệu mà phản hồi quan sát được không theo mẫu hình do phần còn lại của dữ liệu thiết lập.
Bạn có thể phát hiện các điểm ảnh hưởng mạnh bằng cách xem đối tượng chứa mô hình tuyến tính, dùng hàm cooks.distance() rồi vẽ các khoảng cách này. Hãy thay đổi một giá trị có chủ đích để xem nó trông như thế nào trên biểu đồ Cook’s Distance. Để thay đổi một giá trị cụ thể, bạn có thể chỉ trực tiếp đến nó với ageandheight[row number, column number] = [new value]. Trong trường hợp này, chiều cao của quan sát thứ hai được đổi thành 7,7:
ageandheight[2, 2] = 7.7
head(ageandheight)
| age | height | no_siblings |
|---|---|---|
| 18 | 76.1 | 0 |
| 19 | 7.7 | 2 |
| 20 | 78.1 | 0 |
| 21 | 78.2 | 3 |
| 22 | 78.8 | 4 |
| 23 | 79.7 | 1 |
Bạn tạo lại mô hình và thấy phần tóm tắt cho thấy độ khớp kém, sau đó vẽ Cook’s Distances. Để làm điều này, sau khi tạo hồi quy tuyến tính, dùng lệnh cooks.distance([linear model], rồi nếu muốn, bạn có thể vẽ các khoảng cách này bằng lệnh plot().
lmHeight3 = lm(height~age, data = ageandheight)#Create the linear regression
summary(lmHeight3)#Review the results
plot(cooks.distance(lmHeight3), pch = 16, col = "blue") #Plot the Cooks Distances.
Call:
lm(formula = height ~ age, data = ageandheight)

Residuals:
    Min      1Q  Median      3Q     Max
-53.704  -2.584   3.609   9.503  17.512

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    7.905     38.319   0.206    0.841
age            2.816      1.613   1.745    0.112

Residual standard error: 19.29 on 10 degrees of freedom
Multiple R-squared:  0.2335,    Adjusted R-squared:  0.1568
F-statistic: 3.046 on 1 and 10 DF,  p-value: 0.1115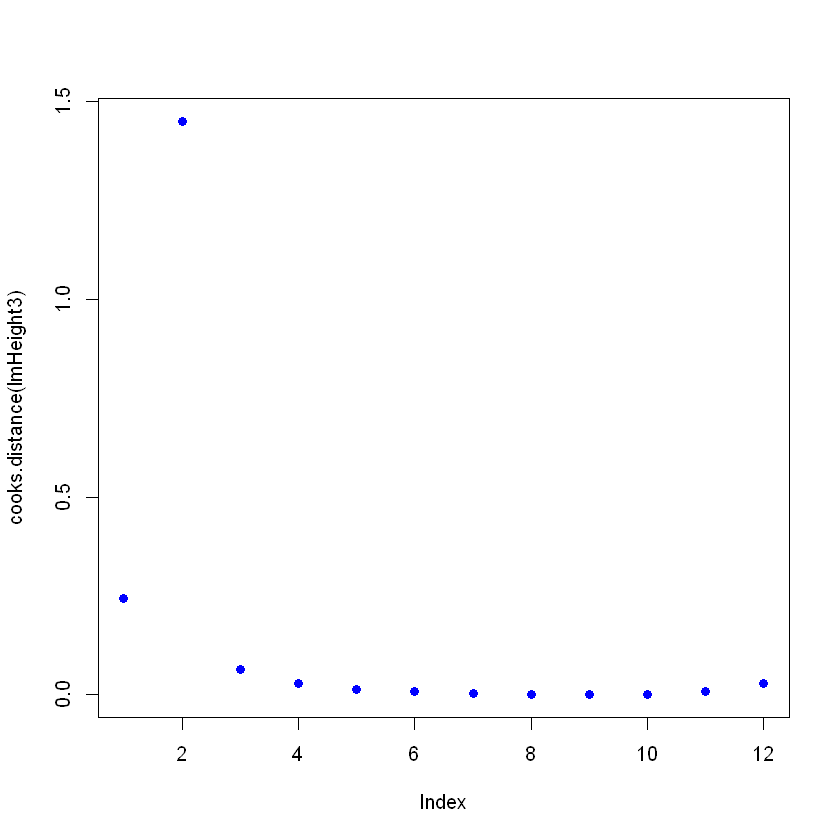
Lưu ý rằng có một điểm không theo mẫu hình và có thể đang ảnh hưởng đến mô hình. Ở đây bạn có thể đưa ra quyết định về điểm này; nhìn chung có ba lý do khiến một điểm có ảnh hưởng mạnh:
Nếu rơi vào trường hợp 1 hoặc 2, bạn có thể xóa điểm đó (hoặc sửa lại). Nếu là 3, không đáng để xóa một điểm hợp lệ; có lẽ bạn có thể thử một mô hình phi tuyến tính thay vì mô hình tuyến tính như hồi quy tuyến tính.
Hãy cẩn thận vì một điểm ảnh hưởng mạnh có thể là điểm hợp lệ; hãy chắc chắn kiểm tra dữ liệu và nguồn của nó trước khi xóa. Trong sách thống kê thường có câu: “Đôi khi chúng ta loại bỏ những dữ liệu hoàn toàn tốt khi lẽ ra phải loại bỏ các mô hình đáng nghi.”
Bạn đã đến cuối bài! Hồi quy tuyến tính là một chủ đề lớn, và nó sẽ còn ở lại. Ở đây, chúng tôi đã giới thiệu một vài mẹo giúp tinh chỉnh và khai thác tối đa một thuật toán vừa mạnh mẽ vừa đơn giản như vậy. Bạn cũng đã học cách hiểu những gì đằng sau mô hình thống kê đơn giản này và cách bạn có thể điều chỉnh nó theo nhu cầu. Bạn cũng có thể khám phá các tùy chọn khác bằng cách gõ ?lm trên console R và xem các tham số khác chưa đề cập ở đây. Hãy xem Hướng dẫn Regularization: Ridge, Lasso và Elastic Net. Nếu bạn quan tâm đi sâu vào các mô hình thống kê, hãy xem khóa học Mô hình thống kê trong R.
Vì hồi quy tuyến tính là nền tảng của nhiều kỹ thuật phân tích nâng cao, đảm bảo đội ngũ của bạn nắm vững kiến thức này và các kỹ năng thiết yếu khác là điều then chốt cho thành công dài hạn.
DataCamp for Business cung cấp giải pháp phù hợp cho các tổ chức muốn nâng tầm kỹ năng của đội ngũ trong khoa học dữ liệu và phân tích. Với lộ trình học tập tùy chỉnh và các khóa học thực hành bao quát nhiều phương pháp thống kê, bao gồm hồi quy và mô hình dự đoán, đội ngũ của bạn có thể tự tin xử lý các thách thức dữ liệu phức tạp.
Yêu cầu bản demo ngay hôm nay và đầu tư cho tương lai tổ chức của bạn bằng cách giúp đội ngũ luôn cập nhật các công cụ và kỹ thuật mới nhất trong phân tích dữ liệu.
Khóa học R
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
