Hãy tưởng tượng bạn bước vào một hiệu sách nơi sách vở vương vãi khắp nơi, chẳng có nhãn nào… Bạn sẽ tốn thời gian tìm kiếm và có khi bỏ lỡ đúng thứ mình cần.
Giờ hãy nghĩ đến một hiệu sách ngăn nắp với các khu vực rõ ràng, tóm tắt nội dung sách và thông tin tác giả. Bạn sẽ nhanh chóng tìm được chính xác cuốn sách mình muốn.
Đó chính là bản chất của catalog dữ liệu.
Nó giống như một thư viện được tổ chức tốt cho toàn bộ dữ liệu của công ty bạn. Catalog sắp xếp, gắn nhãn và cung cấp chi tiết cho mọi tài sản dữ liệu, giúp chúng dễ tìm và dễ hiểu hơn – điều này đặc biệt quan trọng với các doanh nghiệp tạo ra rất nhiều dữ liệu.
Trong bài viết này, tôi sẽ cung cấp hướng dẫn chuyên sâu về catalog dữ liệu. Cụ thể, tôi sẽ đề cập đến:
- Catalog dữ liệu là gì?
- Các tính năng của catalog dữ liệu
- Catalog dữ liệu hoạt động như thế nào
- Các trường hợp sử dụng catalog dữ liệu
- Công cụ catalog dữ liệu phổ biến
- Thực tiễn tốt nhất khi triển khai catalog dữ liệu
Cùng bắt đầu nhé!
Catalog dữ liệu là gì?
Về cơ bản, catalog dữ liệu là một kho kiểm kê tập trung lưu trữ siêu dữ liệu – thông tin về dữ liệu – liên quan đến các tài sản dữ liệu của tổ chức. Những tài sản này bao gồm:
- Tập dữ liệu
- Bảng
- Cơ sở dữ liệu
- Tệp từ nhiều nguồn dữ liệu khác nhau
Mục đích chính của catalog dữ liệu là cung cấp khả năng hiển thị đối với dữ liệu của tổ chức. Vì sao? Khả năng hiển thị cao hơn giúp người dùng dễ tìm, dễ hiểu và sử dụng dữ liệu hiệu quả hơn.
Vì vậy, bằng cách tổ chức siêu dữ liệu, catalog dữ liệu giúp tinh gọn việc khám phá dữ liệu, hỗ trợ các sáng kiến quản trị dữ liệu và nâng cao khả năng cộng tác giữa các nhóm dữ liệu.
Các tính năng của catalog dữ liệu
Catalog dữ liệu thường cung cấp một số tính năng cốt lõi, tất cả đều nhằm cải thiện khả năng sử dụng và quản trị dữ liệu trong tổ chức.
Dưới đây là một vài tính năng phổ biến nhất.
Quản lý siêu dữ liệu
Một trong những chức năng cốt lõi của catalog dữ liệu là quản lý siêu dữ liệu. Siêu dữ liệu cung cấp chi tiết mô tả về các tài sản dữ liệu (ví dụ: nguồn, cấu trúc, bối cảnh nghiệp vụ, v.v.).
Nó trả lời các câu hỏi then chốt như:
- “Dữ liệu đến từ đâu?”
- “Dữ liệu này đại diện cho điều gì?”
- “Có thể sử dụng dữ liệu này như thế nào?”
Điều này giúp người dùng nhanh chóng hiểu được mức độ liên quan và chất lượng của dữ liệu.
Khám phá và tìm kiếm dữ liệu
Catalog dữ liệu đơn giản hóa việc khám phá dữ liệu nhờ cung cấp các chức năng tìm kiếm mạnh mẽ. Tức là người dùng có thể nhanh chóng tìm các tập dữ liệu liên quan dựa trên từ khóa, thẻ, bộ lọc hoặc thuật ngữ nghiệp vụ.
Nếu bạn làm việc tại một tổ chức lớn với hàng nghìn tập dữ liệu, chức năng này thực sự quý giá vì nó giảm đáng kể thời gian thăm dò dữ liệu.
Dòng dữ liệu (data lineage)
Dòng dữ liệu theo dõi luồng di chuyển của dữ liệu qua nhiều hệ thống. Với catalog dữ liệu, người dùng có thể truy vết nguồn gốc của một tập dữ liệu, hiểu cách nó đã phát triển và xác định các vấn đề tiềm ẩn về tính toàn vẹn. Tính năng này rất quan trọng để đảm bảo độ tin cậy của dữ liệu và là thành phần then chốt trong các nỗ lực quản trị và tuân thủ.
Phân loại và gắn thẻ dữ liệu
Các tính năng phân loại và gắn thẻ cho phép tổ chức phân loại dữ liệu theo các thuộc tính khác nhau. Những thẻ này cung cấp bối cảnh cho dữ liệu. Bối cảnh giúp dễ nhóm các tài sản liên quan và tinh gọn việc khám phá dữ liệu.
Tính năng cộng tác
Các catalog dữ liệu hiện đại thay đổi cách các nhóm dữ liệu phối hợp. Thay vì làm việc rời rạc, thành viên nhóm có thể dễ dàng chia sẻ thông tin chi tiết và phản hồi theo thời gian thực. Họ có thể bình luận trực tiếp trên các tập dữ liệu, gắn cờ chi tiết quan trọng và đánh giá chất lượng dữ liệu, biến catalog thành một trung tâm thông tin năng động.
Cách tiếp cận này tăng tính minh bạch – mọi người đều biết dữ liệu nào đáng tin và vì sao. Việc thêm ghi chú và gán điểm chất lượng tạo nền tảng cho một “tài liệu sống” theo dõi hành trình của dữ liệu.
Hỗ trợ quản trị dữ liệu
Catalog dữ liệu thúc đẩy quản trị dữ liệu bằng cách chủ động thực thi các quy tắc giúp dữ liệu an toàn và được quản lý tốt. Bằng cách nào? Nó xác định rõ:
- Ai sở hữu từng tập dữ liệu
- Ai có quyền truy cập
- Nguyên tắc sử dụng là gì
Cấu trúc này giúp tổ chức kiểm soát dữ liệu của mình, đảm bảo sử dụng có trách nhiệm và tuân thủ quy định.
Catalog dữ liệu hoạt động như thế nào?
Cách tốt nhất để hiểu cách catalog dữ liệu hoạt động là hình dung dữ liệu của tổ chức như một sân bay náo nhiệt. Bạn có “máy bay” (dữ liệu) liên tục hạ cánh, cất cánh và nối chuyến.
Tháp kiểm soát không lưu ở sân bay chịu trách nhiệm quản lý lưu lượng không khí an toàn và hiệu quả – sẽ hỗn loạn nếu không có chúng.
Catalog dữ liệu của bạn đóng vai trò như tháp kiểm soát đó. Bằng cách nào? Nó lập bản đồ mọi tuyến, theo dõi hành trình của từng chuyến bay và nói chung là bảo đảm mọi thứ vận hành trơn tru. Nó cũng thu thập chi tiết về nơi xuất phát, điểm đến và các điểm dừng trên đường đi của mỗi “máy bay”.
Nhưng đó chỉ là cái nhìn khái quát…
Trong phần này, chúng ta sẽ tìm hiểu hoạt động nội tại của catalog dữ liệu, giúp bạn hình dung rõ hơn cách nó vận hành.
Thu thập siêu dữ liệu
Catalog dữ liệu giống như các thám tử thu thập manh mối để phá án; họ gom thông tin từ mọi ngóc ngách để giải quyết. Tuy nhiên, trong catalog dữ liệu, các “manh mối” này chính là siêu dữ liệu.
Nói cách khác, catalog dữ liệu thu thập siêu dữ liệu từ nhiều nguồn: cơ sở dữ liệu, data lake, lưu trữ đám mây và các kho dữ liệu khác. Các quy trình tự động hoạt động như công cụ của thám tử, xác định dữ liệu đến từ đâu, cấu trúc ra sao và mục đích của nó.
Giống như thám tử liên tục thu thập manh mối để cập nhật diễn biến vụ án, catalog dữ liệu liên tục tự cập nhật để đảm bảo đội ngũ của bạn luôn có thông tin mới nhất và chính xác nhất nhằm “giải mã” nhu cầu dữ liệu.
Lập chỉ mục và tổ chức dữ liệu
Khi thám tử thu thập manh mối, họ không ném chúng vào một đống – mà sắp xếp cực kỳ cẩn thận. Catalog dữ liệu cũng vậy; nó lập chỉ mục siêu dữ liệu, nghĩa là sắp xếp các thuộc tính chính như loại, nguồn và thẻ.
Điều này giống như tạo hồ sơ vụ án nơi mỗi manh mối đều có chỗ, như trong phim khi các thám tử ghim mọi đầu mối lên tường và nối chúng lại. Việc lập chỉ mục và tổ chức dữ liệu giúp nhóm dễ dàng “nối các điểm”. Cụ thể, nó giúp người dùng điều hướng bức tranh dữ liệu và nhanh chóng tìm đúng thứ họ cần.
Tương tác của người dùng với catalog dữ liệu
Trừ khi James Bond tự xử lý vụ án, thám tử hiếm khi giữ hồ sơ cho riêng mình. Thay vào đó, họ ghi chép và chia sẻ trong các hệ thống tập trung để người khác cùng giải đố.
Một lần nữa, catalog dữ liệu hoạt động tương tự. Nó cung cấp một giao diện trực quan mà bất kỳ ai cũng có thể dùng để tìm kiếm tập dữ liệu, khám phá câu chuyện đằng sau dữ liệu và xem siêu dữ liệu của nó.
Bộ lọc nâng cao, bảng điều khiển gọn gàng và chế độ xem tùy chỉnh giúp trải nghiệm trở nên nhẹ nhàng, trao quyền cho mọi người dùng trở thành “thám tử dữ liệu” — ngay cả khi họ không có chuyên môn kỹ thuật.
Các trường hợp sử dụng catalog dữ liệu
Catalog dữ liệu là công cụ linh hoạt phục vụ nhiều mục đích trong tổ chức. Ví dụ, chúng giúp tổ chức cải thiện chất lượng dữ liệu. Tuy nhiên, chúng cũng có thể giúp tổ chức thực thi chính sách quản trị và hỗ trợ nhà khoa học dữ liệu tìm đúng tập dữ liệu.
Hãy xem một số kịch bản thực tế nơi catalog dữ liệu tạo ra tác động đáng kể.
Khám phá dữ liệu cho nhà khoa học dữ liệu và nhà phân tích
Một nhà khoa học dữ liệu xây dựng mô hình dự đoán rời bỏ của khách hàng có thể dùng catalog dữ liệu để nhanh chóng tìm dữ liệu lịch sử khách hàng, giao dịch bán hàng và chỉ số tương tác để đưa vào hệ thống. Thay vì lục lọi qua nhiều cơ sở dữ liệu, họ dùng bộ lọc tìm kiếm của catalog để xác định các tập dữ liệu liên quan nhất chỉ trong vài phút, tăng tốc phân tích và xây dựng mô hình.
Hỗ trợ các sáng kiến quản trị dữ liệu
Một data steward có thể kiểm tra catalog dữ liệu để theo dõi ai sở hữu từng tập dữ liệu và các quyền truy cập hiện có. Xem xét siêu dữ liệu cho phép họ đảm bảo chỉ người được ủy quyền mới truy cập dữ liệu nhạy cảm, từ đó thực thi tuân thủ các chính sách nội bộ và quy định.
Cải thiện quản lý chất lượng dữ liệu
Giả sử một nhà phân tích dữ liệu phát hiện sự sai lệch trong dữ liệu khách hàng khi xem báo cáo bán hàng... Sử dụng catalog dữ liệu, họ có thể truy vết dòng đời của tập dữ liệu, xác định nơi vấn đề chất lượng dữ liệu phát sinh và nhanh chóng khắc phục để đảm bảo dữ liệu chính xác, tin cậy cho các báo cáo sau này.
Công cụ catalog dữ liệu phổ biến
Chúng ta đã xác định rằng các công cụ catalog dữ liệu hỗ trợ tổ chức quản lý, tổ chức và khám phá tài sản dữ liệu. Chúng đạt được điều này bằng cách xây dựng một kho kiểm kê các tài sản và ghi nhận siêu dữ liệu liên quan.
Vậy bắt đầu với catalog dữ liệu từ đâu? Ở phần này, chúng ta sẽ khám phá một số công cụ catalog dữ liệu phổ biến đang tạo dấu ấn trong ngành.
AWS Glue Data Catalog
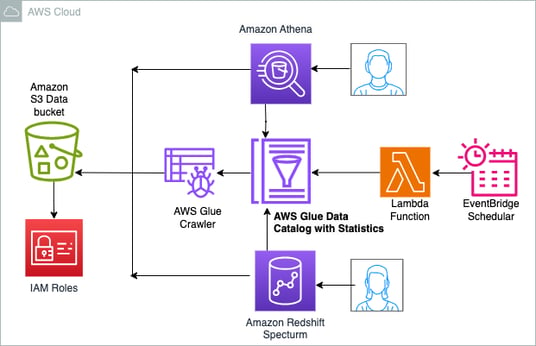
Ví dụ kiến trúc dữ liệu sử dụng Glue Data Catalog. Ảnh nguồn: AWS
AWS Glue Data Catalog là một catalog dữ liệu được quản lý hoàn toàn, không máy chủ, đóng vai trò kho trung tâm cho toàn bộ siêu dữ liệu của bạn. Nó tích hợp với các dịch vụ AWS như Amazon Redshift, Amazon S3 và AWS Athena.
Nó giúp người dùng nhanh chóng tìm và truy cập các tập dữ liệu của họ bằng cách tự động phát hiện và phân loại siêu dữ liệu từ các nguồn dữ liệu. Lưu ý rằng Glue Data Catalog cũng hỗ trợ quản trị và bảo mật dữ liệu.
Alation
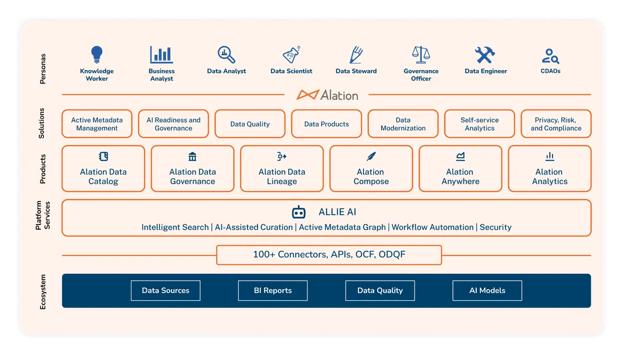
Hệ sinh thái Alation và vị trí của giải pháp catalog dữ liệu. Ảnh nguồn: Alation.
Alation là một catalog dữ liệu sử dụng AI giúp tổ chức cải thiện việc khám phá và quản trị dữ liệu. Nó tận dụng các thuật toán máy học mạnh mẽ để tự động lập chỉ mục, phân loại và biên tập siêu dữ liệu, giúp người dùng dễ dàng tìm các tập dữ liệu phù hợp.
Các tính năng cộng tác của Alation, như khả năng đặt câu hỏi, gắn thẻ dữ liệu và tạo thảo luận, khuyến khích làm việc nhóm giữa các nhóm dữ liệu và người dùng nghiệp vụ. Một tính năng hữu ích khác là theo dõi dòng dữ liệu chi tiết. Điều này giúp tổ chức hiểu bối cảnh dữ liệu và đảm bảo chất lượng cũng như tuân thủ.
Collibra
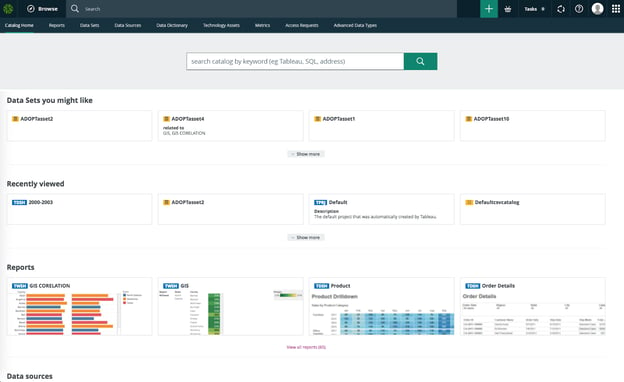
Giao diện người dùng catalog dữ liệu Collibra. Ảnh nguồn: Collibra
Catalog của Collibra có các tính năng tự động khám phá dữ liệu, biên tập siêu dữ liệu và năng lực quản trị dữ liệu. Nó cũng cung cấp công cụ theo dõi dòng dữ liệu và quản lý yêu cầu tuân thủ. Collibra đảm bảo các quy trình quản trị dữ liệu được duy trì trên toàn tổ chức bằng cách thúc đẩy cộng tác giữa chuyên gia dữ liệu và người dùng nghiệp vụ. Nó cũng tích hợp với nhiều nguồn và nền tảng dữ liệu, giúp thích ứng với các hệ sinh thái dữ liệu đa dạng.
Apache Atlas
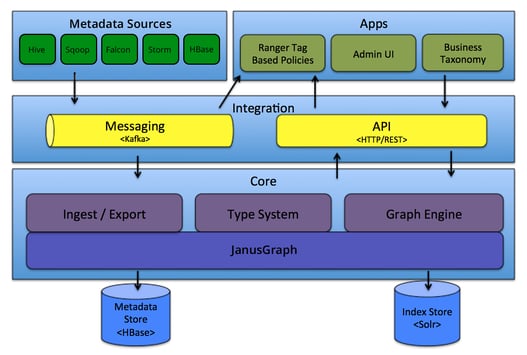
Tổng quan kiến trúc cấp cao của Apache Atlas. Ảnh nguồn: Apache Atlas
Apache Atlas là công cụ mã nguồn mở về quản trị dữ liệu và quản lý siêu dữ liệu, giúp tổ chức quản lý tài sản dữ liệu trên các môi trường phức tạp, đặc biệt là bên trong hệ sinh thái Hadoop. Nó cung cấp cho người dùng một khung thống nhất để quản lý siêu dữ liệu, dòng dữ liệu và quản trị dữ liệu.
Cụ thể, Atlas cho phép tổ chức định nghĩa các kiểu và mối quan hệ tùy chỉnh cho dữ liệu của mình, giúp theo dõi và quản lý luồng dữ liệu tốt hơn. Ngoài ra, bộ API phong phú và khả năng tích hợp của Atlas cho phép tùy biến để đáp ứng nhu cầu đặc thù của các doanh nghiệp lớn, từ đó đảm bảo tuân thủ và thúc đẩy ra quyết định dựa trên dữ liệu.
Thực tiễn tốt nhất khi triển khai catalog dữ liệu
Để tận dụng tối đa lợi ích của catalog dữ liệu, tổ chức cần tuân theo các thực tiễn tốt nhất nhằm đảm bảo việc tiếp nhận và sử dụng hiệu quả. Trong phần này, chúng ta sẽ khám phá các chiến lược then chốt để triển khai và duy trì catalog dữ liệu thành công trong tổ chức của bạn.
Bắt đầu với mục tiêu rõ ràng
Bạn sẽ không lên đường cho một chuyến đi mà không có điểm đến, đúng không? Tất nhiên là không. Vậy thì đừng làm vậy với catalog dữ liệu. Có thể bạn sẽ đến nơi nào đó thú vị, nhưng khó mà là nơi mình muốn. Nếu bạn không có mục tiêu rõ ràng cho catalog dữ liệu, bạn đang điều hướng trong mù mờ - và đó là công thức cho thất bại.
Hãy nhớ: catalog dữ liệu là một công cụ. Nhiệm vụ của công cụ là giúp bạn đáp ứng nhu cầu hiệu quả hơn. Nếu bạn không rõ nhu cầu, bạn sẽ không khai thác tốt công cụ của mình.
Tập trung vào việc người dùng tiếp nhận
Catalog dữ liệu quá đắt để “phủ bụi trong góc” chỉ vì chẳng ai thật sự biết cách dùng. Nhưng điều này xảy ra thường xuyên hơn bạn nghĩ. Nếu người dùng không tiếp nhận công cụ, nó xem như vô dụng.
Để tận dụng tối đa catalog dữ liệu, bạn cần tập trung thuyết phục mọi người cùng tham gia. Đào tạo đội ngũ, cho họ thấy giá trị của catalog và đảm bảo nó được tích hợp vào quy trình công việc hằng ngày.
Thường xuyên cập nhật và bảo trì siêu dữ liệu
Siêu dữ liệu phải luôn được cập nhật để duy trì tính hữu dụng của catalog dữ liệu. Nếu bạn không thường xuyên cập nhật và bảo trì, nó sẽ lỗi thời và kém tin cậy, khiến catalog trở nên kém hiệu quả. Hãy coi đó như việc bảo dưỡng xe. Bạn sẽ không lái một chiếc xe mà không bảo dưỡng định kỳ và thay dầu, đúng không? Siêu dữ liệu cũng vậy.
Thu hút các bên liên quan tham gia
Xây dựng catalog dữ liệu thành công không phải nỗ lực đơn lẻ. Việc gắn kết các bên liên quan từ mọi bộ phận trong tổ chức là điều tối quan trọng để đảm bảo catalog đáp ứng nhu cầu của tất cả. Việc thu hút mọi bên liên quan ngay từ đầu giúp catalog phản ánh đúng nhu cầu cụ thể của từng nhóm trong tổ chức bạn.
Kết luận
Catalog dữ liệu là “vũ khí bí mật” của tổ chức trong hành trình hướng tới sự rõ ràng, hiệu quả và thấu hiểu dữ liệu. Nó giống như GPS ở chỗ dẫn bạn đến đúng thông tin mình cần, đúng lúc cần, loại bỏ mọi phỏng đoán. Nhưng cũng như mọi công cụ mạnh mẽ khác, thành công của nó phụ thuộc vào cách bạn triển khai.
Nếu bạn bắt đầu với mục tiêu rõ ràng, đưa cả đội ngũ cùng tham gia, giữ dữ liệu luôn mới và mời các bên liên quan tham gia ngay từ đầu, catalog dữ liệu sẽ trở thành một kho tàng tri thức.
Hãy nhớ, mục tiêu không chỉ là thu thập dữ liệu; mà là khai mở toàn bộ tiềm năng của nó – và nếu bạn làm theo các thực tiễn tốt trong bài viết này, catalog dữ liệu sẽ giúp bạn đạt được mục tiêu đó.
Để tiếp tục học tập, tôi khuyên bạn tham khảo các tài nguyên sau:


Hãy tưởng tượng bạn bước vào một hiệu sách nơi sách vở vương vãi khắp nơi, chẳng có nhãn nào… Bạn sẽ tốn thời gian tìm kiếm và có khi bỏ lỡ đúng thứ mình cần.
Giờ hãy nghĩ đến một hiệu sách ngăn nắp với các khu vực rõ ràng, tóm tắt nội dung sách và thông tin tác giả. Bạn sẽ nhanh chóng tìm được chính xác cuốn sách mình muốn.
Đó chính là bản chất của catalog dữ liệu.
Nó giống như một thư viện được tổ chức tốt cho toàn bộ dữ liệu của công ty bạn. Catalog sắp xếp, gắn nhãn và cung cấp chi tiết cho mọi tài sản dữ liệu, giúp chúng dễ tìm và dễ hiểu hơn – điều này đặc biệt quan trọng với các doanh nghiệp tạo ra rất nhiều dữ liệu.
Trong bài viết này, tôi sẽ cung cấp hướng dẫn chuyên sâu về catalog dữ liệu. Cụ thể, tôi sẽ đề cập đến:
Cùng bắt đầu nhé!
Catalog dữ liệu là gì?
Về cơ bản, catalog dữ liệu là một kho kiểm kê tập trung lưu trữ siêu dữ liệu – thông tin về dữ liệu – liên quan đến các tài sản dữ liệu của tổ chức. Những tài sản này bao gồm:
Mục đích chính của catalog dữ liệu là cung cấp khả năng hiển thị đối với dữ liệu của tổ chức. Vì sao? Khả năng hiển thị cao hơn giúp người dùng dễ tìm, dễ hiểu và sử dụng dữ liệu hiệu quả hơn.
Vì vậy, bằng cách tổ chức siêu dữ liệu, catalog dữ liệu giúp tinh gọn việc khám phá dữ liệu, hỗ trợ các sáng kiến quản trị dữ liệu và nâng cao khả năng cộng tác giữa các nhóm dữ liệu.
Các tính năng của catalog dữ liệu
Catalog dữ liệu thường cung cấp một số tính năng cốt lõi, tất cả đều nhằm cải thiện khả năng sử dụng và quản trị dữ liệu trong tổ chức.
Dưới đây là một vài tính năng phổ biến nhất.
Quản lý siêu dữ liệu
Một trong những chức năng cốt lõi của catalog dữ liệu là quản lý siêu dữ liệu. Siêu dữ liệu cung cấp chi tiết mô tả về các tài sản dữ liệu (ví dụ: nguồn, cấu trúc, bối cảnh nghiệp vụ, v.v.).
Nó trả lời các câu hỏi then chốt như:
Điều này giúp người dùng nhanh chóng hiểu được mức độ liên quan và chất lượng của dữ liệu.
Khám phá và tìm kiếm dữ liệu
Catalog dữ liệu đơn giản hóa việc khám phá dữ liệu nhờ cung cấp các chức năng tìm kiếm mạnh mẽ. Tức là người dùng có thể nhanh chóng tìm các tập dữ liệu liên quan dựa trên từ khóa, thẻ, bộ lọc hoặc thuật ngữ nghiệp vụ.
Nếu bạn làm việc tại một tổ chức lớn với hàng nghìn tập dữ liệu, chức năng này thực sự quý giá vì nó giảm đáng kể thời gian thăm dò dữ liệu.
Dòng dữ liệu (data lineage)
Dòng dữ liệu theo dõi luồng di chuyển của dữ liệu qua nhiều hệ thống. Với catalog dữ liệu, người dùng có thể truy vết nguồn gốc của một tập dữ liệu, hiểu cách nó đã phát triển và xác định các vấn đề tiềm ẩn về tính toàn vẹn. Tính năng này rất quan trọng để đảm bảo độ tin cậy của dữ liệu và là thành phần then chốt trong các nỗ lực quản trị và tuân thủ.
Phân loại và gắn thẻ dữ liệu
Các tính năng phân loại và gắn thẻ cho phép tổ chức phân loại dữ liệu theo các thuộc tính khác nhau. Những thẻ này cung cấp bối cảnh cho dữ liệu. Bối cảnh giúp dễ nhóm các tài sản liên quan và tinh gọn việc khám phá dữ liệu.
Tính năng cộng tác
Các catalog dữ liệu hiện đại thay đổi cách các nhóm dữ liệu phối hợp. Thay vì làm việc rời rạc, thành viên nhóm có thể dễ dàng chia sẻ thông tin chi tiết và phản hồi theo thời gian thực. Họ có thể bình luận trực tiếp trên các tập dữ liệu, gắn cờ chi tiết quan trọng và đánh giá chất lượng dữ liệu, biến catalog thành một trung tâm thông tin năng động.
Cách tiếp cận này tăng tính minh bạch – mọi người đều biết dữ liệu nào đáng tin và vì sao. Việc thêm ghi chú và gán điểm chất lượng tạo nền tảng cho một “tài liệu sống” theo dõi hành trình của dữ liệu.
Hỗ trợ quản trị dữ liệu
Catalog dữ liệu thúc đẩy quản trị dữ liệu bằng cách chủ động thực thi các quy tắc giúp dữ liệu an toàn và được quản lý tốt. Bằng cách nào? Nó xác định rõ:
Cấu trúc này giúp tổ chức kiểm soát dữ liệu của mình, đảm bảo sử dụng có trách nhiệm và tuân thủ quy định.
Catalog dữ liệu hoạt động như thế nào?
Cách tốt nhất để hiểu cách catalog dữ liệu hoạt động là hình dung dữ liệu của tổ chức như một sân bay náo nhiệt. Bạn có “máy bay” (dữ liệu) liên tục hạ cánh, cất cánh và nối chuyến.
Tháp kiểm soát không lưu ở sân bay chịu trách nhiệm quản lý lưu lượng không khí an toàn và hiệu quả – sẽ hỗn loạn nếu không có chúng.
Catalog dữ liệu của bạn đóng vai trò như tháp kiểm soát đó. Bằng cách nào? Nó lập bản đồ mọi tuyến, theo dõi hành trình của từng chuyến bay và nói chung là bảo đảm mọi thứ vận hành trơn tru. Nó cũng thu thập chi tiết về nơi xuất phát, điểm đến và các điểm dừng trên đường đi của mỗi “máy bay”.
Nhưng đó chỉ là cái nhìn khái quát…
Trong phần này, chúng ta sẽ tìm hiểu hoạt động nội tại của catalog dữ liệu, giúp bạn hình dung rõ hơn cách nó vận hành.
Thu thập siêu dữ liệu
Catalog dữ liệu giống như các thám tử thu thập manh mối để phá án; họ gom thông tin từ mọi ngóc ngách để giải quyết. Tuy nhiên, trong catalog dữ liệu, các “manh mối” này chính là siêu dữ liệu.
Nói cách khác, catalog dữ liệu thu thập siêu dữ liệu từ nhiều nguồn: cơ sở dữ liệu, data lake, lưu trữ đám mây và các kho dữ liệu khác. Các quy trình tự động hoạt động như công cụ của thám tử, xác định dữ liệu đến từ đâu, cấu trúc ra sao và mục đích của nó.
Giống như thám tử liên tục thu thập manh mối để cập nhật diễn biến vụ án, catalog dữ liệu liên tục tự cập nhật để đảm bảo đội ngũ của bạn luôn có thông tin mới nhất và chính xác nhất nhằm “giải mã” nhu cầu dữ liệu.
Lập chỉ mục và tổ chức dữ liệu
Khi thám tử thu thập manh mối, họ không ném chúng vào một đống – mà sắp xếp cực kỳ cẩn thận. Catalog dữ liệu cũng vậy; nó lập chỉ mục siêu dữ liệu, nghĩa là sắp xếp các thuộc tính chính như loại, nguồn và thẻ.
Điều này giống như tạo hồ sơ vụ án nơi mỗi manh mối đều có chỗ, như trong phim khi các thám tử ghim mọi đầu mối lên tường và nối chúng lại. Việc lập chỉ mục và tổ chức dữ liệu giúp nhóm dễ dàng “nối các điểm”. Cụ thể, nó giúp người dùng điều hướng bức tranh dữ liệu và nhanh chóng tìm đúng thứ họ cần.
Tương tác của người dùng với catalog dữ liệu
Trừ khi James Bond tự xử lý vụ án, thám tử hiếm khi giữ hồ sơ cho riêng mình. Thay vào đó, họ ghi chép và chia sẻ trong các hệ thống tập trung để người khác cùng giải đố.
Một lần nữa, catalog dữ liệu hoạt động tương tự. Nó cung cấp một giao diện trực quan mà bất kỳ ai cũng có thể dùng để tìm kiếm tập dữ liệu, khám phá câu chuyện đằng sau dữ liệu và xem siêu dữ liệu của nó.
Bộ lọc nâng cao, bảng điều khiển gọn gàng và chế độ xem tùy chỉnh giúp trải nghiệm trở nên nhẹ nhàng, trao quyền cho mọi người dùng trở thành “thám tử dữ liệu” — ngay cả khi họ không có chuyên môn kỹ thuật.
Các trường hợp sử dụng catalog dữ liệu
Catalog dữ liệu là công cụ linh hoạt phục vụ nhiều mục đích trong tổ chức. Ví dụ, chúng giúp tổ chức cải thiện chất lượng dữ liệu. Tuy nhiên, chúng cũng có thể giúp tổ chức thực thi chính sách quản trị và hỗ trợ nhà khoa học dữ liệu tìm đúng tập dữ liệu.
Hãy xem một số kịch bản thực tế nơi catalog dữ liệu tạo ra tác động đáng kể.
Khám phá dữ liệu cho nhà khoa học dữ liệu và nhà phân tích
Một nhà khoa học dữ liệu xây dựng mô hình dự đoán rời bỏ của khách hàng có thể dùng catalog dữ liệu để nhanh chóng tìm dữ liệu lịch sử khách hàng, giao dịch bán hàng và chỉ số tương tác để đưa vào hệ thống. Thay vì lục lọi qua nhiều cơ sở dữ liệu, họ dùng bộ lọc tìm kiếm của catalog để xác định các tập dữ liệu liên quan nhất chỉ trong vài phút, tăng tốc phân tích và xây dựng mô hình.
Hỗ trợ các sáng kiến quản trị dữ liệu
Một data steward có thể kiểm tra catalog dữ liệu để theo dõi ai sở hữu từng tập dữ liệu và các quyền truy cập hiện có. Xem xét siêu dữ liệu cho phép họ đảm bảo chỉ người được ủy quyền mới truy cập dữ liệu nhạy cảm, từ đó thực thi tuân thủ các chính sách nội bộ và quy định.
Cải thiện quản lý chất lượng dữ liệu
Giả sử một nhà phân tích dữ liệu phát hiện sự sai lệch trong dữ liệu khách hàng khi xem báo cáo bán hàng... Sử dụng catalog dữ liệu, họ có thể truy vết dòng đời của tập dữ liệu, xác định nơi vấn đề chất lượng dữ liệu phát sinh và nhanh chóng khắc phục để đảm bảo dữ liệu chính xác, tin cậy cho các báo cáo sau này.
Công cụ catalog dữ liệu phổ biến
Chúng ta đã xác định rằng các công cụ catalog dữ liệu hỗ trợ tổ chức quản lý, tổ chức và khám phá tài sản dữ liệu. Chúng đạt được điều này bằng cách xây dựng một kho kiểm kê các tài sản và ghi nhận siêu dữ liệu liên quan.
Vậy bắt đầu với catalog dữ liệu từ đâu? Ở phần này, chúng ta sẽ khám phá một số công cụ catalog dữ liệu phổ biến đang tạo dấu ấn trong ngành.
AWS Glue Data Catalog
Ví dụ kiến trúc dữ liệu sử dụng Glue Data Catalog. Ảnh nguồn: AWS
AWS Glue Data Catalog là một catalog dữ liệu được quản lý hoàn toàn, không máy chủ, đóng vai trò kho trung tâm cho toàn bộ siêu dữ liệu của bạn. Nó tích hợp với các dịch vụ AWS như Amazon Redshift, Amazon S3 và AWS Athena.
Nó giúp người dùng nhanh chóng tìm và truy cập các tập dữ liệu của họ bằng cách tự động phát hiện và phân loại siêu dữ liệu từ các nguồn dữ liệu. Lưu ý rằng Glue Data Catalog cũng hỗ trợ quản trị và bảo mật dữ liệu.
Alation
Hệ sinh thái Alation và vị trí của giải pháp catalog dữ liệu. Ảnh nguồn: Alation.
Alation là một catalog dữ liệu sử dụng AI giúp tổ chức cải thiện việc khám phá và quản trị dữ liệu. Nó tận dụng các thuật toán máy học mạnh mẽ để tự động lập chỉ mục, phân loại và biên tập siêu dữ liệu, giúp người dùng dễ dàng tìm các tập dữ liệu phù hợp.
Các tính năng cộng tác của Alation, như khả năng đặt câu hỏi, gắn thẻ dữ liệu và tạo thảo luận, khuyến khích làm việc nhóm giữa các nhóm dữ liệu và người dùng nghiệp vụ. Một tính năng hữu ích khác là theo dõi dòng dữ liệu chi tiết. Điều này giúp tổ chức hiểu bối cảnh dữ liệu và đảm bảo chất lượng cũng như tuân thủ.
Collibra
Giao diện người dùng catalog dữ liệu Collibra. Ảnh nguồn: Collibra
Catalog của Collibra có các tính năng tự động khám phá dữ liệu, biên tập siêu dữ liệu và năng lực quản trị dữ liệu. Nó cũng cung cấp công cụ theo dõi dòng dữ liệu và quản lý yêu cầu tuân thủ. Collibra đảm bảo các quy trình quản trị dữ liệu được duy trì trên toàn tổ chức bằng cách thúc đẩy cộng tác giữa chuyên gia dữ liệu và người dùng nghiệp vụ. Nó cũng tích hợp với nhiều nguồn và nền tảng dữ liệu, giúp thích ứng với các hệ sinh thái dữ liệu đa dạng.
Apache Atlas
Tổng quan kiến trúc cấp cao của Apache Atlas. Ảnh nguồn: Apache Atlas
Apache Atlas là công cụ mã nguồn mở về quản trị dữ liệu và quản lý siêu dữ liệu, giúp tổ chức quản lý tài sản dữ liệu trên các môi trường phức tạp, đặc biệt là bên trong hệ sinh thái Hadoop. Nó cung cấp cho người dùng một khung thống nhất để quản lý siêu dữ liệu, dòng dữ liệu và quản trị dữ liệu.
Cụ thể, Atlas cho phép tổ chức định nghĩa các kiểu và mối quan hệ tùy chỉnh cho dữ liệu của mình, giúp theo dõi và quản lý luồng dữ liệu tốt hơn. Ngoài ra, bộ API phong phú và khả năng tích hợp của Atlas cho phép tùy biến để đáp ứng nhu cầu đặc thù của các doanh nghiệp lớn, từ đó đảm bảo tuân thủ và thúc đẩy ra quyết định dựa trên dữ liệu.
Thực tiễn tốt nhất khi triển khai catalog dữ liệu
Để tận dụng tối đa lợi ích của catalog dữ liệu, tổ chức cần tuân theo các thực tiễn tốt nhất nhằm đảm bảo việc tiếp nhận và sử dụng hiệu quả. Trong phần này, chúng ta sẽ khám phá các chiến lược then chốt để triển khai và duy trì catalog dữ liệu thành công trong tổ chức của bạn.
Bắt đầu với mục tiêu rõ ràng
Bạn sẽ không lên đường cho một chuyến đi mà không có điểm đến, đúng không? Tất nhiên là không. Vậy thì đừng làm vậy với catalog dữ liệu. Có thể bạn sẽ đến nơi nào đó thú vị, nhưng khó mà là nơi mình muốn. Nếu bạn không có mục tiêu rõ ràng cho catalog dữ liệu, bạn đang điều hướng trong mù mờ - và đó là công thức cho thất bại.
Hãy nhớ: catalog dữ liệu là một công cụ. Nhiệm vụ của công cụ là giúp bạn đáp ứng nhu cầu hiệu quả hơn. Nếu bạn không rõ nhu cầu, bạn sẽ không khai thác tốt công cụ của mình.
Tập trung vào việc người dùng tiếp nhận
Catalog dữ liệu quá đắt để “phủ bụi trong góc” chỉ vì chẳng ai thật sự biết cách dùng. Nhưng điều này xảy ra thường xuyên hơn bạn nghĩ. Nếu người dùng không tiếp nhận công cụ, nó xem như vô dụng.
Để tận dụng tối đa catalog dữ liệu, bạn cần tập trung thuyết phục mọi người cùng tham gia. Đào tạo đội ngũ, cho họ thấy giá trị của catalog và đảm bảo nó được tích hợp vào quy trình công việc hằng ngày.
Thường xuyên cập nhật và bảo trì siêu dữ liệu
Siêu dữ liệu phải luôn được cập nhật để duy trì tính hữu dụng của catalog dữ liệu. Nếu bạn không thường xuyên cập nhật và bảo trì, nó sẽ lỗi thời và kém tin cậy, khiến catalog trở nên kém hiệu quả. Hãy coi đó như việc bảo dưỡng xe. Bạn sẽ không lái một chiếc xe mà không bảo dưỡng định kỳ và thay dầu, đúng không? Siêu dữ liệu cũng vậy.
Thu hút các bên liên quan tham gia
Xây dựng catalog dữ liệu thành công không phải nỗ lực đơn lẻ. Việc gắn kết các bên liên quan từ mọi bộ phận trong tổ chức là điều tối quan trọng để đảm bảo catalog đáp ứng nhu cầu của tất cả. Việc thu hút mọi bên liên quan ngay từ đầu giúp catalog phản ánh đúng nhu cầu cụ thể của từng nhóm trong tổ chức bạn.
Kết luận
Catalog dữ liệu là “vũ khí bí mật” của tổ chức trong hành trình hướng tới sự rõ ràng, hiệu quả và thấu hiểu dữ liệu. Nó giống như GPS ở chỗ dẫn bạn đến đúng thông tin mình cần, đúng lúc cần, loại bỏ mọi phỏng đoán. Nhưng cũng như mọi công cụ mạnh mẽ khác, thành công của nó phụ thuộc vào cách bạn triển khai.
Nếu bạn bắt đầu với mục tiêu rõ ràng, đưa cả đội ngũ cùng tham gia, giữ dữ liệu luôn mới và mời các bên liên quan tham gia ngay từ đầu, catalog dữ liệu sẽ trở thành một kho tàng tri thức.
Hãy nhớ, mục tiêu không chỉ là thu thập dữ liệu; mà là khai mở toàn bộ tiềm năng của nó – và nếu bạn làm theo các thực tiễn tốt trong bài viết này, catalog dữ liệu sẽ giúp bạn đạt được mục tiêu đó.
Để tiếp tục học tập, tôi khuyên bạn tham khảo các tài nguyên sau: