Khóa học
Các khái niệm về Bảo mật và Quản lý Chi phí trên AWS
3 giờ
11.2K
Với các tính năng vừa đề cập, dưới đây là tổng quan ngắn gọn về những ưu điểm của Athena:
|
Lợi ích |
Tính năng |
Mô tả |
|
Hiệu quả chi phí |
Mô hình trả theo truy vấn |
Chỉ trả cho lượng dữ liệu mà truy vấn của bạn tương tác; không có chi phí trả trước hay giấy phép phức tạp; có thể tối ưu chi phí bằng phân vùng, nén dữ liệu và định dạng dạng cột. |
|
Dễ sử dụng |
Serverless & SQL chuẩn |
Không cần thiết lập hay quản lý hạ tầng; người dùng có thể bắt đầu truy vấn dữ liệu trong vài phút với cú pháp SQL quen thuộc, giúp việc sử dụng trở nên dễ tiếp cận và đơn giản. |
|
Linh hoạt |
Hỗ trợ đa định dạng |
Hỗ trợ nhiều định dạng dữ liệu (ví dụ CSV, JSON, Parquet), cho phép người dùng truy vấn dữ liệu ở định dạng gốc trực tiếp từ S3 mà không cần quy trình ETL. |
|
Insight nhanh |
Phân tích nhanh & truy vấn trực tiếp S3 |
Cho phép phân tích dữ liệu ngay lập tức với kiến trúc serverless, trích xuất insight nhanh trực tiếp từ dữ liệu lưu trong S3 và rút ngắn thời gian tạo giá trị cho các quyết định dựa trên dữ liệu. |
Chúng ta đã định nghĩa Athena và nêu các tính năng, lợi ích—vậy nó được dùng để làm gì? Phần này sẽ điểm qua một số trường hợp sử dụng phổ biến nhất.
Amazon Athena thường được dùng để phân tích log, đặc biệt là truy vấn và phân tích các log lưu trong Amazon S3. Tổ chức thường tạo ra khối lượng log khổng lồ từ nhiều nguồn như log ứng dụng, log máy chủ và log truy cập.
Bằng cách lưu các log này vào S3 và truy vấn bằng Athena, người dùng có thể nhanh chóng xác định xu hướng, chẩn đoán sự cố, và giám sát hiệu năng hệ thống mà không cần thiết lập phức tạp.
Kiến trúc serverless và hỗ trợ SQL chuẩn khiến Athena trở thành công cụ tuyệt vời cho khám phá dữ liệu ad-hoc. Dù bạn là nhà khoa học dữ liệu, nhà phân tích hay kỹ sư, Athena cho phép bạn nhanh chóng truy vấn dữ liệu lưu trong S3 mà không cần nạp vào cơ sở dữ liệu truyền thống.
Khi các tổ chức ngày càng áp dụng data lake để lưu trữ lượng lớn dữ liệu thô và đã xử lý, Athena đóng vai trò là động cơ truy vấn mạnh mẽ cho các data lake này. Nó cho phép người dùng phân tích trực tiếp trên dữ liệu lưu trong S3, trở thành thành phần không thể thiếu của kiến trúc data lake hiện đại.
Athena cũng thường được dùng như một phần của ngăn xếp BI (business intelligence), nơi nó tích hợp với các công cụ BI như Amazon QuickSight để trực quan hóa và báo cáo. Bằng cách truy vấn dữ liệu trong S3 với Athena và trực quan hóa trong QuickSight, tổ chức có thể tạo dashboard và báo cáo tương tác phục vụ quyết định.
Nếu bạn quen với Amazon Redshift, bạn có thể tự hỏi nó khác Athena như thế nào.
Dù cả Athena và Redshift đều xử lý tập dữ liệu, mục tiêu của chúng khác nhau. Trường hợp sử dụng chính của Redshift là lưu trữ dữ liệu và phân tích thường xuyên liên quan đến dữ liệu lớn. AWS Athena tập trung cho phép người dùng thực hiện phân tích ad hoc trên dữ liệu lưu trong S3.
Dưới đây là so sánh chi tiết giữa Athena và Redshift:
|
Tiêu chí |
Amazon Athena |
Amazon Redshift |
|
Kiến trúc |
Dịch vụ truy vấn serverless; chạy truy vấn SQL trực tiếp trên dữ liệu lưu trong Amazon S3 với khả năng mở rộng tự động; không cần quản lý hạ tầng. |
Kho dữ liệu được quản lý hoàn toàn; yêu cầu cụm kho dữ liệu với hạ tầng chuyên dụng; có thể mở rộng theo nhu cầu. Có tùy chọn Redshift Serverless. |
|
Trường hợp sử dụng |
Lý tưởng cho truy vấn và phân tích ad hoc trên dữ liệu S3, và các tình huống ưu tiên linh hoạt, tiết kiệm chi phí mà không cần biến đổi dữ liệu. |
Phù hợp cho phân tích và báo cáo phức tạp, quy mô lớn; lý tưởng cho dữ liệu có cấu trúc cần truy vấn và biến đổi thường xuyên. |
|
Cấu trúc chi phí |
Mô hình trả theo truy vấn: tính phí dựa trên dữ liệu được quét bởi truy vấn, hiệu quả chi phí cho khối lượng công việc gián đoạn hoặc biến thiên. |
Giá dựa trên kích thước cụm và mức sử dụng; có giá theo phiên bản dự trữ cho truy vấn có khối lượng lớn, dự đoán được. |
|
Hiệu năng |
Phụ thuộc vào kích thước và định dạng dữ liệu; được tối ưu bằng phân vùng và nén; phù hợp nhất cho truy vấn nhỏ hơn, ít phức tạp. |
Hiệu năng cao cho truy vấn phức tạp; sử dụng lưu trữ dạng cột, xử lý song song và tối ưu hóa nâng cao cho khối lượng công việc nặng. |
|
Tích hợp dữ liệu |
Truy vấn trực tiếp dữ liệu trong S3 mà không cần biến đổi hay nạp vào; hỗ trợ nhiều định dạng và các connector mở rộng, bao gồm Redshift. |
Yêu cầu nạp dữ liệu vào kho; tích hợp với dịch vụ AWS và hỗ trợ nhiều phương thức nạp dữ liệu nhưng chỉ đọc từ dữ liệu được lưu trữ trong chính nó. |
Đến lúc thực hành: thiết lập Athena và chạy một số truy vấn!
Để dùng AWS Athena, bạn cần tài khoản AWS. Nếu chưa có, bạn phải tạo một tài khoản. Hãy làm theo hướng dẫn trong hướng dẫn thiết lập AWS.
Mặc dù không có gói miễn phí cho AWS Athena, bạn vẫn có thể chạy 2–3 truy vấn thử nhỏ (~10MB) để hiểu hệ thống vận hành ra sao. Làm theo hướng dẫn trên cổng thông tin và xác minh danh tính. Sau đó đăng nhập vào tài khoản AWS của bạn.
Giống các sản phẩm khác của Amazon AWS, Athena sử dụng chính sách IAM (quản lý danh tính và truy cập) cho quyền hạn. Bạn sẽ là người dùng gốc (root) cho tài khoản và nên có đủ quyền để chạy truy vấn Athena trên các bucket S3 của riêng mình.
Bạn có thể quản lý quyền IAM bằng cách tìm dịch vụ IAM trong thanh tìm kiếm trên cùng tại trang chủ AWS và sử dụng hướng dẫn IAM đầy đủ này. Tài liệu AWS cũng cung cấp thêm thông tin về thiết lập cụ thể cho Athena.
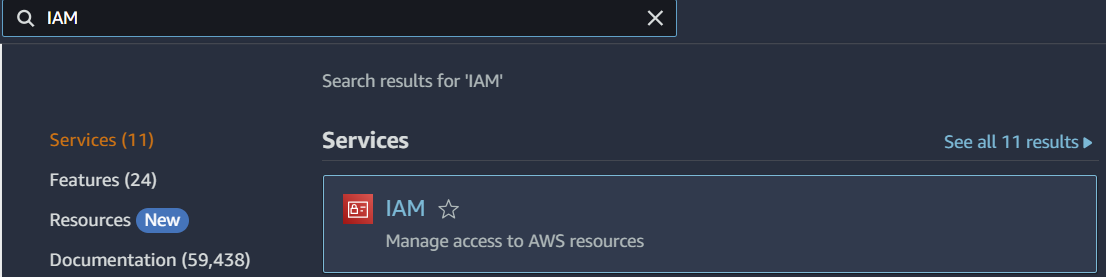
Trước khi chạy truy vấn, chúng ta cần thiết lập một S3 bucket để lưu dữ liệu.
Amazon S3 là viết tắt của Simple Storage Service và là thành phần quan trọng trong cách AWS quản lý lưu trữ và dữ liệu trên môi trường đám mây. Theo hướng dẫn tạo bucket Amazon S3 được viết rất rõ, chúng ta có thể tạo môi trường lưu trữ cho dữ liệu và truy vấn của mình.
Tóm lại, bạn sẽ tìm dịch vụ S3 trong thanh tìm kiếm để vào trang chủ S3:
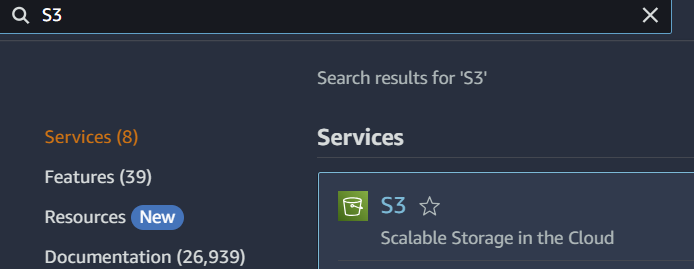
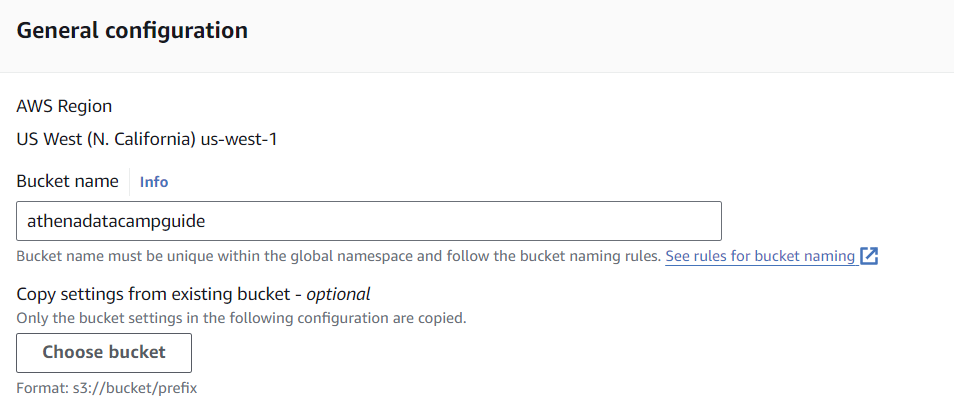
Bạn sẽ thấy nút “Create Bucket” ở thanh bên phải trên trang chủ. Làm theo hướng dẫn trên trang này, bạn sẽ tạo một bucket cho phép dịch vụ Athena lưu kết quả truy vấn.
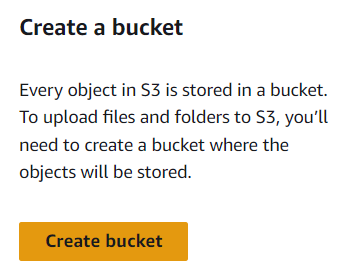
Tôi sẽ tạo một bucket tên “athenadatacampguide” với các tùy chọn mặc định khác. Do bucket phải là duy nhất trên toàn cầu trong AWS, bạn cần chọn một tên khác cho bài hướng dẫn này.
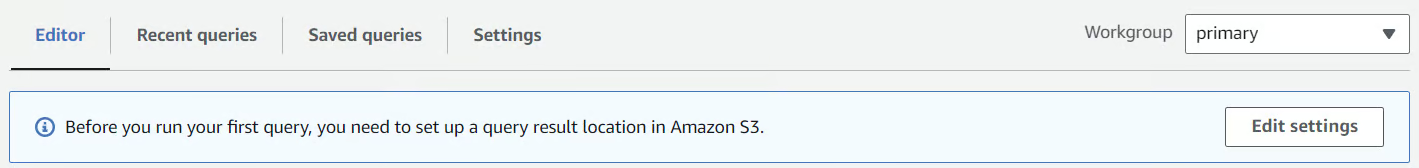
Giờ chúng ta cần kết nối bucket này với Athena. Tôi sẽ vào bảng điều khiển Athena và nhấp “Edit Settings” ở thanh thông báo nhỏ gần phía trên.
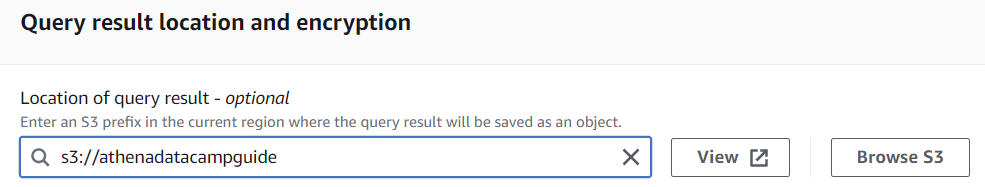
Sau đó tôi sẽ chọn bucket vừa tạo. Để tìm bucket của bạn, dùng nút “Browse S3” bên phải hoặc nhập tên kèm tiền tố “s3://”.
Khi đã chọn bucket, nhấp “Save” và quay về Editor bằng cách nhấp vào nó trên thanh công cụ trên cùng.
AWS Athena tổ chức dữ liệu theo thứ bậc. Nó sử dụng “data catalog”, một nhóm cơ sở dữ liệu còn gọi là schema.
Các bảng thực tế mà chúng ta truy vấn nằm trong các cơ sở dữ liệu. Để tạo data catalog mới, bạn có thể dùng Amazon Lambda và kết nối tới nguồn dữ liệu bên ngoài. Data catalog sau đó có thể được lưu dưới dạng Lambda, Hive hoặc Glue data catalog.
Mặc định trên AWS là dùng dịch vụ Glue làm kho lưu trữ data catalog trung tâm. Chúng ta sẽ tập trung xây dựng một cơ sở dữ liệu để chứa các bảng phục vụ truy vấn.
Trong Editor, vào khung Query Editor. Đây là nơi chúng ta sẽ viết truy vấn để tạo cơ sở dữ liệu, truy vấn bảng và chạy phân tích.
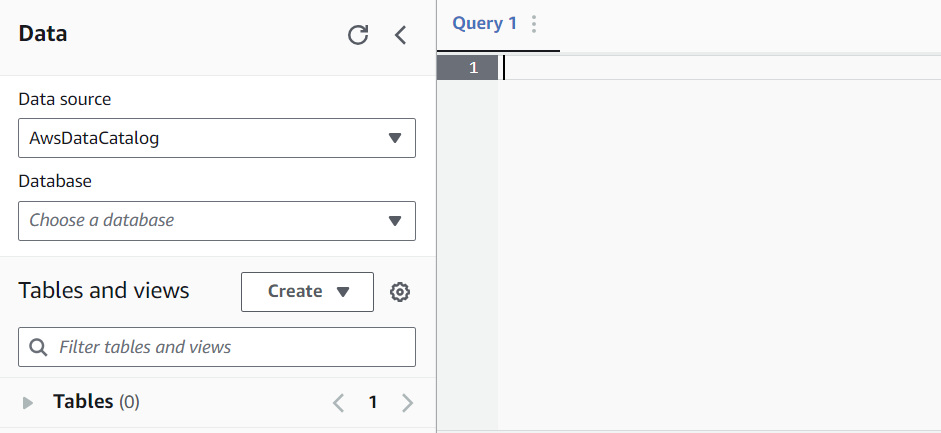
Để tạo cơ sở dữ liệu đầu tiên, chúng ta sẽ chạy truy vấn sau:
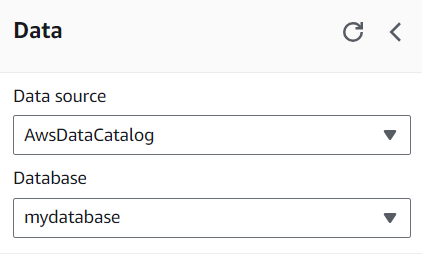
CREATE DATABASE mydatabaseChạy truy vấn này sẽ cho phép bạn chọn một cơ sở dữ liệu từ danh sách thả xuống dưới “Database” ở thanh bên trái.
Giờ khi đã có cơ sở dữ liệu, chúng ta sẽ tập trung tạo một bảng để có dữ liệu mà truy vấn!
Đưa dữ liệu vào cơ sở dữ liệu của bạn sẽ khác nhau đôi chút tùy thiết lập AWS. Bạn có thể sử dụng dữ liệu lưu trong kho dữ liệu như Redshift hoặc dữ liệu streaming với AWS Kinesis và Lambda để tạo dữ liệu dạng bảng.
Hôm nay, chúng ta sẽ dùng dữ liệu mẫu từ AWS Cloudfront Logs. Do dữ liệu phức tạp, một phần quá trình tạo dùng nhóm RegEx để phân tích URL thành các cột.
Sử dụng SQL sau, chúng ta có thể tạo một bảng. Lưu ý: bên dưới, thay “myregion” bằng vùng AWS của bạn.
CREATE EXTERNAL TABLE IF NOT EXISTS cloudfront_logs (
  Date DATE,
  Time STRING,
  Location STRING,
  Bytes INT,
  RequestIP STRING,
  Method STRING,
  Host STRING,
  Uri STRING,
  Status INT,
  Referrer STRING,
  os STRING,
  Browser STRING,
  BrowserVersion STRING
  )
  ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.RegexSerDe'
  WITH SERDEPROPERTIES (
  "input.regex" = "^(?!#)([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+[^\(]+[\(]([^\;]+).*\%20([^\/]+)[\/](.*)
Nếu bảng xuất hiện ở thanh bên trái, bạn đã sẵn sàng bắt đầu truy vấn!
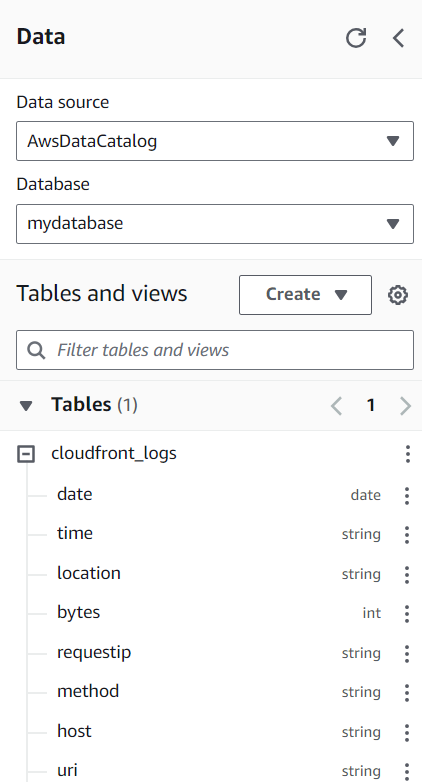
Viết truy vấn trong Athena tương tự như viết truy vấn SQL truyền thống. Bạn chỉ cần viết và gửi truy vấn tới Athena, kết quả mong muốn sẽ được trả về.
Một thực hành tốt là viết mệnh đề FROM theo cú pháp: “DataSource”.“database”.“table”. Như vậy sẽ không bao giờ nhầm lẫn về nguồn dữ liệu.
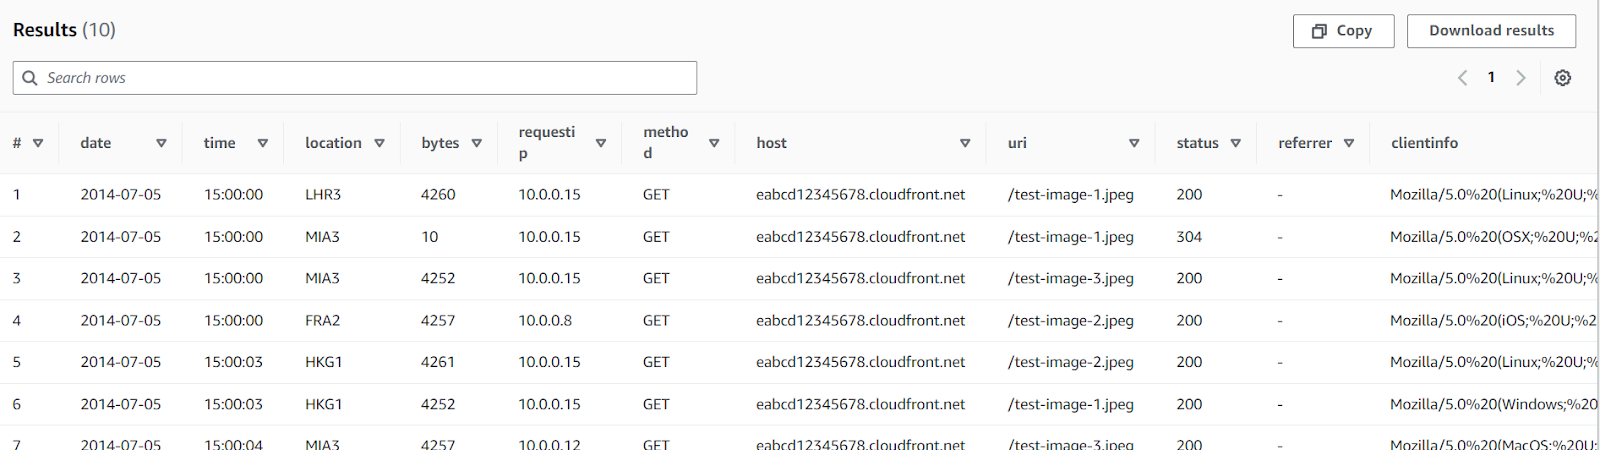
Hãy thử một lệnh SELECT đơn giản để bắt đầu.
SELECT *
FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
LIMIT 10
Điều này sẽ trả về một bảng gồm 10 kết quả. Athena cho phép bạn sao chép hoặc tải xuống kết quả. Đồng thời, các kết quả này được lưu vào S3 bucket mà bạn đã kết nối với dịch vụ Athena.
Chúng ta thậm chí có thể viết truy vấn GROUP BY đơn giản. Truy vấn này cho biết có bao nhiêu requestip (không nhất thiết là duy nhất) liên quan tới các phương thức HTTP nhất định.
SELECT
   method,
   COUNT(requestip)
FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
GROUP BY 1
Một cách hay để tận dụng Athena là cho các truy vấn phức tạp hơn như hàm cửa sổ. Nhờ tối ưu hóa của Athena, chúng ta có thể thực hiện các phép tính phức tạp nhanh hơn.
Ví dụ, chúng ta có thể dùng Athena để tạo ROW NUMBER() cho mỗi bản ghi được phân vùng theo khu vực và ngày, sắp xếp theo thời gian giảm dần. Sau đó chọn bản ghi mới nhất cho mỗi khu vực và ngày bằng WHERE lọc hàng đầu tiên.
SELECT *
FROM (
   SELECT
      location,
      date,
      time,
      ROW_NUMBER() OVER(PARTITION BY location, date ORDER BY time DESC) row_num
   FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
)
WHERE row_num = 1
Đây mới chỉ là khởi đầu với Athena. Bạn có thể tiếp tục viết bất kỳ truy vấn nào mà bạn cho rằng sẽ tận dụng được khả năng của Athena.
Giống như bất kỳ công cụ xử lý dữ liệu nào, AWS Athena có một loạt thực hành tốt. Những thực hành này không chỉ giúp bạn làm việc dễ dàng hơn mà còn cải thiện hiệu năng.
Ngoài ra, vì AWS là dịch vụ đám mây và người dùng bị tính phí theo các yếu tố lưu trữ và tính toán khác nhau, các thực hành này có thể mang lại tiết kiệm chi phí đáng kể!
Có nhiều định dạng dữ liệu tiện lợi hơn khi dùng trong AWS Athena. Vì Athena đọc từ S3 bucket, chọn định dạng dữ liệu dễ đọc và được nén sẽ cải thiện hiệu năng và chi phí.
Dữ liệu thô lưu dưới dạng CSV có thể đơn giản nhất nhưng kém hiệu quả. Lưu dữ liệu ở định dạng nén như Parquet hoặc ORC sẽ tiết kiệm chi phí đọc dữ liệu.
Một lợi ích bổ sung của Parquet và ORC là nén theo cột. Bộ tối ưu của Athena cho phép chỉ tìm các cột dữ liệu cụ thể thay vì duyệt toàn bộ bảng để tính toán.
Phân vùng dữ liệu nghĩa là thường xuyên chia nhỏ tập dữ liệu theo một khóa cụ thể, như ngày tháng. Ví dụ, chúng ta có thể có các phân vùng theo ngày, trong đó dữ liệu được tự động chia và lưu theo từng ngày.
Khi dữ liệu được phân vùng, công cụ SQL có thể tối ưu tốt hơn bằng cách chỉ xem các phân vùng liên quan. Điều này cải thiện trực tiếp việc giảm dữ liệu cần quét, từ đó giảm chi phí tổng thể.
Mặc dù một mức độ phức tạp là điều hiển nhiên trong phân tích dữ liệu, tối ưu truy vấn có thể giúp giảm thời gian tính toán và chi phí. Một số chi phí không trực tiếp từ Athena mà đến từ các dịch vụ khác mà Athena sử dụng.
Thành phần chi phí chính của Athena là quét và xử lý dữ liệu, nhưng bạn có thể phát sinh chi phí từ S3 nếu lưu kết quả rất lớn. Chúng ta cũng có thể cải thiện hiệu năng truy vấn và giảm chi phí bằng cách đảm bảo truy vấn được tối ưu theo các thực hành tốt SQL thông thường.
Ví dụ, tất cả các cách sau sẽ hỗ trợ tối ưu:
SELECT * khi có thểLIMIT khi thử nghiệm truy vấnNhững thực hành tốt này sẽ cải thiện hiệu năng truy vấn và giảm chi phí!
AWS Athena có thể kết nối với Amazon CloudWatch để lưu trữ số liệu truy vấn. Chúng ta có thể phát hiện truy vấn kém hiệu quả hoặc vấn đề bằng cách xem log hiệu năng truy vấn.
Như đã đề cập, AWS Athena tích hợp với nhiều dịch vụ AWS khác, tăng cường khả năng lập danh mục dữ liệu, trực quan hóa, xử lý và lưu trữ dữ liệu.
Dưới đây là cách Athena hoạt động cùng các dịch vụ như AWS Glue, Amazon QuickSight, AWS Lambda và Amazon Redshift.
Khi tích hợp với AWS Athena, AWS Glue đóng vai trò kho siêu dữ liệu trung tâm, tự động lập danh mục dữ liệu trong Amazon S3. Sự tích hợp này loại bỏ nhu cầu định nghĩa schema thủ công, đơn giản hóa việc truy vấn dữ liệu trong Athena.
Glue cũng cung cấp khả năng ETL, biến đổi và chuẩn bị dữ liệu cho việc truy vấn tối ưu trong Athena bằng cách tự động hóa các tác vụ như nén dữ liệu, phân vùng và chuyển đổi định dạng, đảm bảo xử lý dữ liệu hiệu quả.
Amazon QuickSight tích hợp với AWS Athena để biến kết quả truy vấn thành các dashboard và báo cáo tương tác. Kết nối này cho phép bạn trực quan hóa dữ liệu trực tiếp từ truy vấn Athena, giúp tạo insight trực quan nhanh chóng, dễ dàng.
QuickSight hỗ trợ các tính năng như làm mới dữ liệu tự động và phân tích nâng cao, là công cụ mạnh để khám phá và trình bày dữ liệu.
AWS Lambda tự động hóa các quy trình xử lý dữ liệu với Athena trong môi trường serverless. Hàm Lambda có thể kích hoạt truy vấn Athena theo sự kiện, như khi có dữ liệu mới trong S3, cho phép xử lý theo thời gian thực.
Lambda cũng có thể tự động hóa các hành động kế tiếp dựa trên kết quả truy vấn, tạo các luồng công việc theo sự kiện có khả năng mở rộng mà không cần can thiệp thủ công.
Trong khi Athena lý tưởng để truy vấn ad hoc dữ liệu S3, Amazon Redshift cung cấp giải pháp phân tích có cấu trúc và phức tạp. Bạn có thể dùng Athena cho phân tích nhanh dữ liệu thô và Redshift cho truy vấn chuyên sâu, hiệu năng cao.
Việc tích hợp cho phép di chuyển dữ liệu giữa S3 và Redshift, tận dụng điểm mạnh của cả hai để có giải pháp phân tích toàn diện.
AWS Athena là một động cơ truy vấn mạnh mẽ nằm ngay trong hệ sinh thái AWS. Bằng cách cho phép người dùng nhanh chóng truy cập dữ liệu lưu trong S3 bucket đồng thời lưu kết quả truy vấn vào S3, AWS Athena giúp người dùng khai thác dữ liệu linh hoạt hơn. Nó tận dụng lợi thế của các dịch vụ AWS khác như tính serverless, khả năng mở rộng và sự đơn giản.
Nếu bạn muốn tìm hiểu thêm về AWS, DataCamp cung cấp nhiều tài nguyên:
Tìm hiểu thêm về AWS và kỹ thuật dữ liệu với các khóa học này!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
