Apache Hadoop, thường được gọi tắt là Hadoop, là một khung mã nguồn mở mạnh mẽ được xây dựng để xử lý và lưu trữ các tập dữ liệu khổng lồ bằng cách phân tán chúng trên các cụm phần cứng phổ thông, giá rẻ. Thế mạnh của Hadoop nằm ở khả năng mở rộng và linh hoạt, cho phép làm việc với cả dữ liệu có cấu trúc và phi cấu trúc.
Trong bài viết này, tôi sẽ trình bày các thành phần chính tạo nên Hadoop—cách nó lưu trữ, xử lý và quản lý dữ liệu ở quy mô lớn. Kết thúc bài, bạn sẽ có bức tranh rõ ràng về cách công nghệ nền tảng này phù hợp trong hệ sinh thái dữ liệu lớn.
Tổng quan về Hệ sinh thái Hadoop
Hadoop không phải là một công cụ đơn lẻ. Đó là một hệ sinh thái gồm nhiều mô-đun phối hợp với nhau để quản lý lưu trữ dữ liệu, xử lý và điều phối tài nguyên.
Các mô-đun cốt lõi của Hadoop
Hadoop bao gồm bốn mô-đun nền tảng:
- HDFS (Hadoop Distributed File System): Hệ thống lưu trữ phân tán, tách tệp thành các khối và phân phối chúng trên cụm.
- MapReduce: Mô hình lập trình để xử lý dữ liệu song song trên các nút.
- YARN (Yet Another Resource Negotiator): Quản lý tài nguyên và lập lịch công việc trong cụm.
- Hadoop Common: Tập hợp thư viện và tiện ích dùng chung hỗ trợ các mô-đun khác.
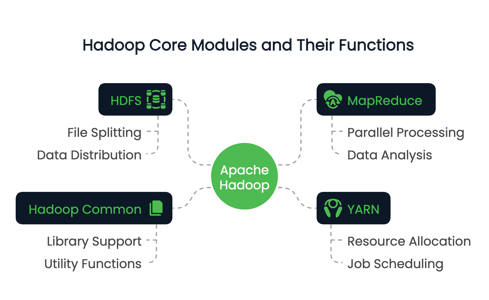
Các mô-đun này phối hợp để tạo nên môi trường điện toán phân tán có khả năng xử lý dữ liệu đến quy mô petabyte.
Để khám phá cách xử lý dữ liệu phân tán so sánh giữa các nền tảng, khóa Big Data Fundamentals with PySpark cung cấp phần thực hành phù hợp để bổ sung hiểu biết của bạn về Hadoop.
Vai trò của Hadoop trong dữ liệu lớn
Vai trò chính của Hadoop nằm ở khả năng giải quyết một thách thức cốt lõi trong dữ liệu lớn — đó là khả năng mở rộng.
Các hệ thống truyền thống thường gặp khó với các tập dữ liệu vượt quá khả năng của một máy đơn, cả về lưu trữ lẫn tính toán. Hadoop giải quyết bằng cách phân tán dữ liệu qua nhiều nút và thực thi phép tính song song.
Nhờ vậy, Hadoop có thể xử lý dữ liệu ở mức terabyte hay thậm chí petabyte một cách hiệu quả. Ngoài khả năng mở rộng, Hadoop còn có độ chịu lỗi cao nhờ cơ chế sao chép dữ liệu và cho phép tổ chức xây dựng hạ tầng dữ liệu tiết kiệm chi phí với phần cứng phổ thông.
Các tính năng chính của Hadoop
Chúng ta đã bàn về vai trò và cấu trúc của Hadoop, giờ hãy xem một số thuộc tính giá trị nhất của Hadoop. Bao gồm:
- Lưu trữ và xử lý phân tán cho phép lưu trữ các tập dữ liệu cực lớn và truy vấn chúng.
- Mở rộng theo chiều ngang mà không cần máy cấu hình cao.
- Tối ưu tính cục bộ dữ liệu, đưa tính toán đến nơi dữ liệu nằm.
- Khả năng chống lỗi nhờ sao chép và thực thi lại tác vụ.
Những tính năng này khiến Hadoop phù hợp với xử lý dữ liệu theo lô, phân tích log và các pipeline ETL. Hadoop là một nghiên cứu điển hình về điện toán phân tán, nơi tính toán diễn ra trên nhiều nút để tăng hiệu suất và khả năng mở rộng.
Giờ hãy đi sâu vào từng mô-đun cốt lõi của Hadoop.
Muốn kiểm chứng kiến thức Hadoop hoặc chuẩn bị cho vai trò dữ liệu? Đây là 24 câu hỏi phỏng vấn Hadoop kèm đáp án cho năm 2025 để bạn bắt đầu.
Hệ thống Tệp Phân tán Hadoop (HDFS)
Trong bốn thành phần chính, HDFS là hệ thống lưu trữ chủ đạo của Hadoop. Nó được thiết kế để lưu trữ đáng tin cậy lượng dữ liệu khổng lồ trên cụm máy như đã đề cập trước đó. Kiến trúc của HDFS được tối ưu cho loại truy cập vào tập dữ liệu lớn này, với trọng tâm là khả năng chịu lỗi, mở rộng và tính cục bộ dữ liệu.
Kiến trúc và các thành phần
Kiến trúc HDFS xoay quanh mô hình chủ - tớ (master-slave). Ở trên cùng là NameNode, quản lý siêu dữ liệu—về bản chất là cây thư mục của hệ thống tệp và thông tin về vị trí của từng tệp. Nó không lưu trữ dữ liệu thực tế.
Các DataNode là lực lượng chủ lực. Chúng quản lý lưu trữ gắn với các nút và phục vụ yêu cầu đọc/ghi từ client. Mỗi DataNode thường xuyên báo cáo về NameNode bằng heartbeat và báo cáo khối (block report) để đảm bảo theo dõi trạng thái nhất quán.
Cuối cùng, HDFS có Secondary NameNode, không phải là nút chuyển đổi dự phòng. Thay vào đó, nó định kỳ tạo checkpoint cho siêu dữ liệu của NameNode để giảm thời gian khởi động và chi phí bộ nhớ.
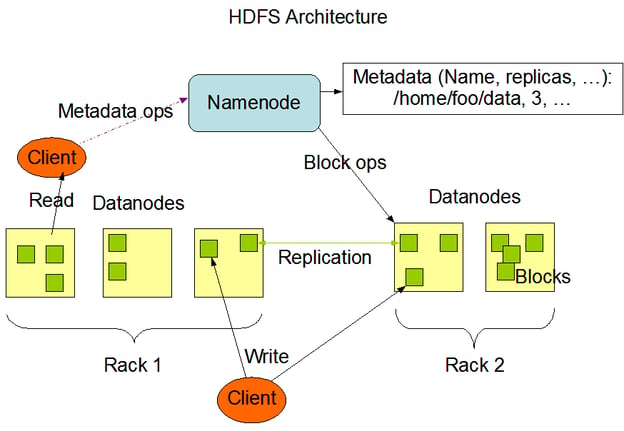
Kiến trúc HDFS. Hình ảnh: Tài liệu Apache Hadoop
Cách dữ liệu được lưu trong HDFS
Khi một tệp được ghi vào HDFS, nó được chia thành các khối 64MB có kích thước cố định. Mỗi khối sau đó được phân phối trên các DataNode khác nhau. Chiến lược phân phối này hỗ trợ truy cập song song và tăng cường khả năng chịu lỗi.
Dữ liệu trong HDFS không chỉ được lưu một lần. Mỗi khối được sao chép (mặc định là ba bản) và rải khắp cụm. Trong thao tác đọc, hệ thống lấy dữ liệu từ bản sao gần nhất để tối đa băng thông và giảm độ trễ. Việc ghi sẽ vào một bản sao trước rồi lan truyền sang bản khác, đảm bảo độ bền mà không gây nút thắt ngay lập tức.
Thiết kế ở mức khối này cũng cho phép HDFS mở rộng theo chiều ngang. Có thể thêm nút mới vào cụm và hệ thống sẽ cân bằng lại dữ liệu để tận dụng dung lượng bổ sung.
Để so sánh với các định dạng dữ liệu lớn khác, hãy khám phá cách Apache Parquet tối ưu lưu trữ dạng cột cho khối lượng công việc phân tích.
Khả năng chịu lỗi trong HDFS
HDFS được xây dựng với giả định sẽ có lỗi. Trong các hệ phân tán lớn, lỗi nút là điều dự kiến chứ không phải ngoại lệ. HDFS đảm bảo tính sẵn sàng dữ liệu thông qua cơ chế sao chép. Nếu một DataNode gặp sự cố, NameNode phát hiện qua heartbeat bị lỡ và lập lịch sao chép lại các khối bị mất sang các nút khỏe mạnh.
Ngoài ra, hệ thống liên tục giám sát tình trạng khối và khởi động sao chép khi cần. Chiến lược lưu trữ dự phòng kết hợp với giám sát chủ động đảm bảo không điểm lỗi đơn nào có thể làm ảnh hưởng đến tính toàn vẹn hay khả năng truy cập dữ liệu.
Khung MapReduce
Tiếp theo là động cơ xử lý của Hadoop, MapReduce. Nó cho phép tính toán phân tán trên các tập dữ liệu lớn bằng cách chia nhỏ công việc thành các thao tác độc lập, nhỏ hơn có thể thực thi song song.
Mô hình này đơn giản hóa các phép biến đổi dữ liệu phức tạp và đặc biệt phù hợp với xử lý theo lô trong môi trường phân tán.
Tổng quan về MapReduce
MapReduce tuân theo mô hình lập trình hai pha: pha Map và Reduce.
Trong pha Map, tập dữ liệu đầu vào được chia thành các phần nhỏ hơn và mỗi phần được xử lý để tạo ra các cặp khóa-giá trị. Các kết quả trung gian này sau đó được xáo trộn và sắp xếp trước khi chuyển sang pha Reduce, nơi chúng được tổng hợp hoặc biến đổi thành đầu ra cuối cùng.
Mô hình này rất hiệu quả cho các tác vụ như đếm tần suất từ, lọc log hoặc join tập dữ liệu ở quy mô lớn.
Lập trình viên triển khai logic tùy chỉnh thông qua các hàm map() và reduce(), được khuôn khổ điều phối trên toàn cụm.
Luồng thực thi của một job MapReduce
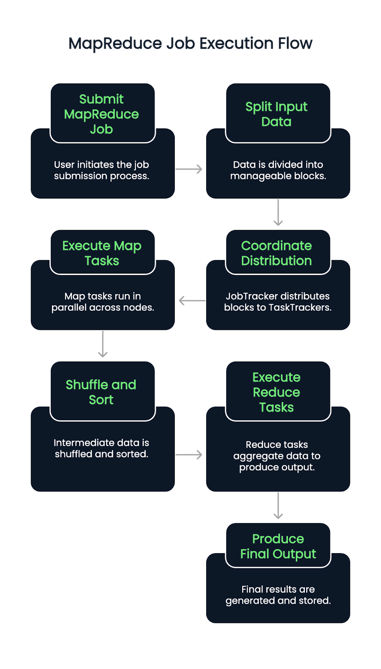
Khi một job MapReduce được gửi đi, dữ liệu đầu vào trước tiên được tách thành các khối. JobTracker (hoặc ResourceManager trong các phiên bản bật YARN) điều phối việc phân phối các khối này đến các TaskTracker hoặc NodeManager khả dụng.
Các tác vụ Map chạy song song trên các nút, đọc các phần đầu vào và phát sinh các cặp khóa-giá trị trung gian. Những cặp này được hệ thống tự động xáo trộn và sắp xếp. Khi giai đoạn này hoàn tất, các tác vụ Reduce bắt đầu, nhận dữ liệu đã nhóm và áp dụng logic tổng hợp để tạo ra đầu ra cuối cùng.
Quy trình đảm bảo tính cục bộ dữ liệu bằng cách gán tác vụ gần nơi dữ liệu cư trú, giảm tắc nghẽn mạng và cải thiện thông lượng. Lỗi tác vụ được phát hiện và gán lại tự động, góp phần tăng khả năng chịu lỗi của hệ thống.
Lợi ích và hạn chế của MapReduce
MapReduce mang lại nhiều lợi thế rõ rệt:
- Khả năng song song hóa xuất sắc cho xử lý theo lô quy mô lớn
- Mở rộng đến hàng nghìn nút
- Chịu lỗi tốt nhờ thực thi lại tác vụ và checkpoint
Nhưng cũng có những đánh đổi:
- Mô hình có độ trễ cao, nên ít phù hợp với xử lý thời gian thực
- Viết job MapReduce tùy chỉnh có thể tốn công và khó gỡ lỗi
- Thiếu tính tương tác và linh hoạt so với các công cụ mới hơn như Apache Spark.
Phân vân giữa Hadoop và Spark? Đọc hướng dẫn chọn khung Big Data phù hợp với bạn.
YARN: Yet Another Resource Negotiator
YARN đóng vai trò là lớp quản lý tài nguyên của Hadoop. Nó tách việc lập lịch công việc và phân bổ tài nguyên khỏi mô hình xử lý, giúp Hadoop hỗ trợ nhiều công cụ xử lý dữ liệu ngoài MapReduce.
Vai trò trong kiến trúc Hadoop
YARN hoạt động như nền tảng trung tâm để quản lý tài nguyên tính toán trên toàn cụm. Nó phân bổ tài nguyên hệ thống sẵn có cho nhiều ứng dụng và điều phối việc thực thi. Sự tách biệt này giúp Hadoop mở rộng hiệu quả và mở đường hỗ trợ các khuôn khổ khác như Apache Spark, Hive và Tez.
Các thành phần chính của YARN
YARN giới thiệu ba thành phần:
- ResourceManager: Tiến trình nền (daemon) chủ quản lý toàn bộ tài nguyên và lập lịch ứng dụng.
- NodeManager: Tác nhân trên mỗi nút, theo dõi sử dụng tài nguyên và báo cáo về ResourceManager.
- ApplicationMaster: Thực thể dành riêng cho từng job, sử dụng tài nguyên từ ResourceManager và điều phối thực thi với NodeManager.
Mỗi ứng dụng (như một job MapReduce) có ApplicationMaster riêng, cho phép cách ly lỗi tốt hơn và theo dõi job hiệu quả.
Quy trình quản lý tài nguyên của YARN
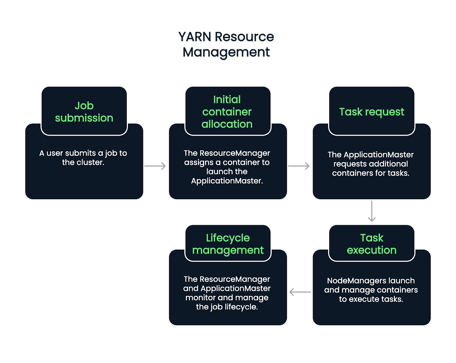
Luồng bắt đầu khi người dùng gửi một job. ResourceManager nhận job và cấp một container để khởi chạy ApplicationMaster. Từ đó, ApplicationMaster yêu cầu thêm container để thực thi các tác vụ, dựa trên khối lượng công việc và mức sẵn có hiện tại.
NodeManager khởi chạy và quản lý các container này, vốn chạy các tác vụ riêng lẻ. Xuyên suốt vòng đời job, ResourceManager và ApplicationMaster xử lý giám sát, khôi phục khi lỗi và báo cáo hoàn thành. Về cơ bản là một quy trình năm bước.
- Gửi job: Người dùng gửi một job lên cụm.
- Cấp container ban đầu: ResourceManager nhận job và cấp một container để khởi chạy ApplicationMaster.
- Yêu cầu tác vụ: ApplicationMaster yêu cầu thêm container để chạy các tác vụ cụ thể, dựa trên khối lượng công việc và tài nguyên sẵn có.
- Thực thi tác vụ: NodeManager khởi chạy và quản lý các container này để thực hiện tác vụ.
- Quản lý vòng đời: ResourceManager và ApplicationMaster phối hợp giám sát tiến độ, xử lý lỗi và xác nhận hoàn thành tác vụ. Xuyên suốt vòng đời job, ResourceManager và ApplicationMaster đảm nhiệm giám sát, khôi phục lỗi và báo cáo hoàn tất.
Hadoop Common và các Tiện ích
“Chất keo” gắn kết mọi thành phần của Hadoop là Hadoop Common. Đây là bộ sưu tập thư viện, tệp cấu hình và tiện ích cần thiết cho tất cả các mô-đun.
Hadoop Common là gì
Hadoop Common cung cấp mã nền tảng và công cụ cho phép HDFS, YARN và MapReduce giao tiếp và phối hợp. Bao gồm thư viện Java, client hệ thống tệp và API được dùng trong toàn hệ sinh thái.
Nó cũng đảm bảo tính nhất quán và tương thích giữa các mô-đun, cho phép nhà phát triển xây dựng trên một tập primitive dùng chung.
Tầm quan trọng của cấu hình và công cụ
Cấu hình đúng cho Hadoop là điều tối quan trọng. Hadoop Common chứa các tệp cấu hình như core-site.xml, định nghĩa hành vi mặc định như URI hệ thống tệp và thiết lập I/O.
Các công cụ dòng lệnh và script đi kèm trong Hadoop Common hỗ trợ các tác vụ như khởi động dịch vụ, kiểm tra tình trạng nút và quản lý job. Phần lớn các công cụ này là thứ mà quản trị viên hệ thống và nhà phát triển dựa vào cho vận hành cụm hàng ngày.
Ứng dụng Thực tế của Hadoop
Nếu có sử dụng tập dữ liệu khổng lồ, xử lý phân tán hoặc phân tích theo lô, khả năng cao Hadoop cũng được dùng. Cụ thể hơn, Hadoop được dùng trong nhiều ngành để xử lý lượng lớn dữ liệu có cấu trúc và phi cấu trúc. Thiết kế phân tán và tính linh hoạt mã nguồn mở khiến nó phù hợp với các tác vụ đòi hỏi dữ liệu cao.
Các ngành tận dụng Hadoop
Tổ chức trong tài chính, y tế, viễn thông, thương mại điện tử và mạng xã hội thường xuyên dùng Hadoop. Nó giúp ngân hàng phát hiện gian lận theo thời gian thực, hỗ trợ nghiên cứu hệ gen trong y tế, và vận hành hệ gợi ý trong bán lẻ trực tuyến.
Ví dụ trường hợp sử dụng
- Xử lý log: Tổng hợp và phân tích dữ liệu log từ máy chủ và ứng dụng.
- Hệ thống gợi ý: Xây dựng mô hình gợi ý nội dung hoặc sản phẩm.
- Phát hiện gian lận: Nhận diện mẫu hành vi đáng ngờ trong giao dịch.
Các kịch bản này hưởng lợi từ khả năng xử lý tập dữ liệu lớn với tính chịu lỗi và song song của Hadoop.
Để có một lựa chọn hiện đại, thuần đám mây thay cho Hadoop, hãy thử khóa Introduction to Databricks, hỗ trợ Spark và các công cụ có khả năng mở rộng khác.
Tích hợp với các công cụ khác
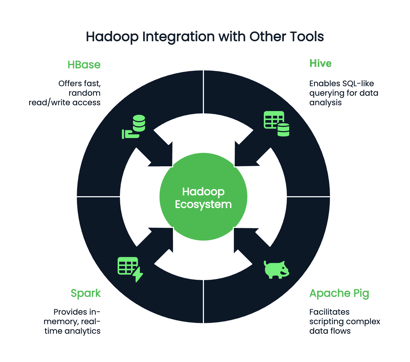
Hadoop hiếm khi hoạt động độc lập và có thể tích hợp với hàng trăm chương trình bổ trợ. Tùy sở thích và môi trường mã hóa, bạn có thể kết hợp Hadoop với:
- Hive: Cho truy vấn kiểu SQL
- Apache Pig: Cho viết script luồng dữ liệu phức tạp
- Spark: Cho phân tích trong bộ nhớ, thời gian thực
- HBase: Cho truy cập đọc/ghi ngẫu nhiên, nhanh trên tập dữ liệu lớn
Kết luận
Dù không còn là từ khóa “hot” như trước, Hadoop vẫn là công nghệ nền tảng trong bức tranh dữ liệu lớn. Hiểu về Hadoop vẫn vô cùng giá trị cho bất kỳ chuyên gia dữ liệu nào làm việc với hệ thống quy mô lớn. Các thành phần cốt lõi—HDFS cho lưu trữ, MapReduce cho xử lý, YARN cho quản lý tài nguyên và Hadoop Common cho tiện ích thiết yếu—tiếp tục định hình cách thiết kế và mở rộng quy trình dữ liệu.
Trước khi bắt tay triển khai hay tối ưu, hãy dành thời gian hiểu cách dữ liệu được phân phối và cấu hình trong một cụm Hadoop. Kiến thức đó giúp đơn giản hóa xử lý sự cố và tinh chỉnh hiệu năng, đồng thời mở đường tích hợp các công cụ mạnh như Apache Spark và Hive cho phân tích nâng cao.
Để biết thêm về xử lý dữ liệu lớn, hãy xem:


Apache Hadoop, thường được gọi tắt là Hadoop, là một khung mã nguồn mở mạnh mẽ được xây dựng để xử lý và lưu trữ các tập dữ liệu khổng lồ bằng cách phân tán chúng trên các cụm phần cứng phổ thông, giá rẻ. Thế mạnh của Hadoop nằm ở khả năng mở rộng và linh hoạt, cho phép làm việc với cả dữ liệu có cấu trúc và phi cấu trúc.
Trong bài viết này, tôi sẽ trình bày các thành phần chính tạo nên Hadoop—cách nó lưu trữ, xử lý và quản lý dữ liệu ở quy mô lớn. Kết thúc bài, bạn sẽ có bức tranh rõ ràng về cách công nghệ nền tảng này phù hợp trong hệ sinh thái dữ liệu lớn.
Tổng quan về Hệ sinh thái Hadoop
Hadoop không phải là một công cụ đơn lẻ. Đó là một hệ sinh thái gồm nhiều mô-đun phối hợp với nhau để quản lý lưu trữ dữ liệu, xử lý và điều phối tài nguyên.
Các mô-đun cốt lõi của Hadoop
Hadoop bao gồm bốn mô-đun nền tảng:
Các mô-đun này phối hợp để tạo nên môi trường điện toán phân tán có khả năng xử lý dữ liệu đến quy mô petabyte.
Để khám phá cách xử lý dữ liệu phân tán so sánh giữa các nền tảng, khóa Big Data Fundamentals with PySpark cung cấp phần thực hành phù hợp để bổ sung hiểu biết của bạn về Hadoop.
Vai trò của Hadoop trong dữ liệu lớn
Vai trò chính của Hadoop nằm ở khả năng giải quyết một thách thức cốt lõi trong dữ liệu lớn — đó là khả năng mở rộng.
Các hệ thống truyền thống thường gặp khó với các tập dữ liệu vượt quá khả năng của một máy đơn, cả về lưu trữ lẫn tính toán. Hadoop giải quyết bằng cách phân tán dữ liệu qua nhiều nút và thực thi phép tính song song.
Nhờ vậy, Hadoop có thể xử lý dữ liệu ở mức terabyte hay thậm chí petabyte một cách hiệu quả. Ngoài khả năng mở rộng, Hadoop còn có độ chịu lỗi cao nhờ cơ chế sao chép dữ liệu và cho phép tổ chức xây dựng hạ tầng dữ liệu tiết kiệm chi phí với phần cứng phổ thông.
Các tính năng chính của Hadoop
Chúng ta đã bàn về vai trò và cấu trúc của Hadoop, giờ hãy xem một số thuộc tính giá trị nhất của Hadoop. Bao gồm:
Những tính năng này khiến Hadoop phù hợp với xử lý dữ liệu theo lô, phân tích log và các pipeline ETL. Hadoop là một nghiên cứu điển hình về điện toán phân tán, nơi tính toán diễn ra trên nhiều nút để tăng hiệu suất và khả năng mở rộng.
Giờ hãy đi sâu vào từng mô-đun cốt lõi của Hadoop.
Muốn kiểm chứng kiến thức Hadoop hoặc chuẩn bị cho vai trò dữ liệu? Đây là 24 câu hỏi phỏng vấn Hadoop kèm đáp án cho năm 2025 để bạn bắt đầu.
Hệ thống Tệp Phân tán Hadoop (HDFS)
Trong bốn thành phần chính, HDFS là hệ thống lưu trữ chủ đạo của Hadoop. Nó được thiết kế để lưu trữ đáng tin cậy lượng dữ liệu khổng lồ trên cụm máy như đã đề cập trước đó. Kiến trúc của HDFS được tối ưu cho loại truy cập vào tập dữ liệu lớn này, với trọng tâm là khả năng chịu lỗi, mở rộng và tính cục bộ dữ liệu.
Kiến trúc và các thành phần
Kiến trúc HDFS xoay quanh mô hình chủ - tớ (master-slave). Ở trên cùng là NameNode, quản lý siêu dữ liệu—về bản chất là cây thư mục của hệ thống tệp và thông tin về vị trí của từng tệp. Nó không lưu trữ dữ liệu thực tế.
Các DataNode là lực lượng chủ lực. Chúng quản lý lưu trữ gắn với các nút và phục vụ yêu cầu đọc/ghi từ client. Mỗi DataNode thường xuyên báo cáo về NameNode bằng heartbeat và báo cáo khối (block report) để đảm bảo theo dõi trạng thái nhất quán.
Cuối cùng, HDFS có Secondary NameNode, không phải là nút chuyển đổi dự phòng. Thay vào đó, nó định kỳ tạo checkpoint cho siêu dữ liệu của NameNode để giảm thời gian khởi động và chi phí bộ nhớ.
Kiến trúc HDFS. Hình ảnh: Tài liệu Apache Hadoop
Cách dữ liệu được lưu trong HDFS
Khi một tệp được ghi vào HDFS, nó được chia thành các khối 64MB có kích thước cố định. Mỗi khối sau đó được phân phối trên các DataNode khác nhau. Chiến lược phân phối này hỗ trợ truy cập song song và tăng cường khả năng chịu lỗi.
Dữ liệu trong HDFS không chỉ được lưu một lần. Mỗi khối được sao chép (mặc định là ba bản) và rải khắp cụm. Trong thao tác đọc, hệ thống lấy dữ liệu từ bản sao gần nhất để tối đa băng thông và giảm độ trễ. Việc ghi sẽ vào một bản sao trước rồi lan truyền sang bản khác, đảm bảo độ bền mà không gây nút thắt ngay lập tức.
Thiết kế ở mức khối này cũng cho phép HDFS mở rộng theo chiều ngang. Có thể thêm nút mới vào cụm và hệ thống sẽ cân bằng lại dữ liệu để tận dụng dung lượng bổ sung.
Để so sánh với các định dạng dữ liệu lớn khác, hãy khám phá cách Apache Parquet tối ưu lưu trữ dạng cột cho khối lượng công việc phân tích.
Khả năng chịu lỗi trong HDFS
HDFS được xây dựng với giả định sẽ có lỗi. Trong các hệ phân tán lớn, lỗi nút là điều dự kiến chứ không phải ngoại lệ. HDFS đảm bảo tính sẵn sàng dữ liệu thông qua cơ chế sao chép. Nếu một DataNode gặp sự cố, NameNode phát hiện qua heartbeat bị lỡ và lập lịch sao chép lại các khối bị mất sang các nút khỏe mạnh.
Ngoài ra, hệ thống liên tục giám sát tình trạng khối và khởi động sao chép khi cần. Chiến lược lưu trữ dự phòng kết hợp với giám sát chủ động đảm bảo không điểm lỗi đơn nào có thể làm ảnh hưởng đến tính toàn vẹn hay khả năng truy cập dữ liệu.
Khung MapReduce
Tiếp theo là động cơ xử lý của Hadoop, MapReduce. Nó cho phép tính toán phân tán trên các tập dữ liệu lớn bằng cách chia nhỏ công việc thành các thao tác độc lập, nhỏ hơn có thể thực thi song song.
Mô hình này đơn giản hóa các phép biến đổi dữ liệu phức tạp và đặc biệt phù hợp với xử lý theo lô trong môi trường phân tán.
Tổng quan về MapReduce
MapReduce tuân theo mô hình lập trình hai pha: pha Map và Reduce.
Trong pha Map, tập dữ liệu đầu vào được chia thành các phần nhỏ hơn và mỗi phần được xử lý để tạo ra các cặp khóa-giá trị. Các kết quả trung gian này sau đó được xáo trộn và sắp xếp trước khi chuyển sang pha Reduce, nơi chúng được tổng hợp hoặc biến đổi thành đầu ra cuối cùng.
Mô hình này rất hiệu quả cho các tác vụ như đếm tần suất từ, lọc log hoặc join tập dữ liệu ở quy mô lớn.
Lập trình viên triển khai logic tùy chỉnh thông qua các hàm
map()vàreduce(), được khuôn khổ điều phối trên toàn cụm.Luồng thực thi của một job MapReduce
Khi một job MapReduce được gửi đi, dữ liệu đầu vào trước tiên được tách thành các khối. JobTracker (hoặc ResourceManager trong các phiên bản bật YARN) điều phối việc phân phối các khối này đến các TaskTracker hoặc NodeManager khả dụng.
Các tác vụ Map chạy song song trên các nút, đọc các phần đầu vào và phát sinh các cặp khóa-giá trị trung gian. Những cặp này được hệ thống tự động xáo trộn và sắp xếp. Khi giai đoạn này hoàn tất, các tác vụ Reduce bắt đầu, nhận dữ liệu đã nhóm và áp dụng logic tổng hợp để tạo ra đầu ra cuối cùng.
Quy trình đảm bảo tính cục bộ dữ liệu bằng cách gán tác vụ gần nơi dữ liệu cư trú, giảm tắc nghẽn mạng và cải thiện thông lượng. Lỗi tác vụ được phát hiện và gán lại tự động, góp phần tăng khả năng chịu lỗi của hệ thống.
Lợi ích và hạn chế của MapReduce
MapReduce mang lại nhiều lợi thế rõ rệt:
Nhưng cũng có những đánh đổi:
Phân vân giữa Hadoop và Spark? Đọc hướng dẫn chọn khung Big Data phù hợp với bạn.
YARN: Yet Another Resource Negotiator
YARN đóng vai trò là lớp quản lý tài nguyên của Hadoop. Nó tách việc lập lịch công việc và phân bổ tài nguyên khỏi mô hình xử lý, giúp Hadoop hỗ trợ nhiều công cụ xử lý dữ liệu ngoài MapReduce.
Vai trò trong kiến trúc Hadoop
YARN hoạt động như nền tảng trung tâm để quản lý tài nguyên tính toán trên toàn cụm. Nó phân bổ tài nguyên hệ thống sẵn có cho nhiều ứng dụng và điều phối việc thực thi. Sự tách biệt này giúp Hadoop mở rộng hiệu quả và mở đường hỗ trợ các khuôn khổ khác như Apache Spark, Hive và Tez.
Các thành phần chính của YARN
YARN giới thiệu ba thành phần:
Mỗi ứng dụng (như một job MapReduce) có ApplicationMaster riêng, cho phép cách ly lỗi tốt hơn và theo dõi job hiệu quả.
Quy trình quản lý tài nguyên của YARN
Luồng bắt đầu khi người dùng gửi một job. ResourceManager nhận job và cấp một container để khởi chạy ApplicationMaster. Từ đó, ApplicationMaster yêu cầu thêm container để thực thi các tác vụ, dựa trên khối lượng công việc và mức sẵn có hiện tại.
NodeManager khởi chạy và quản lý các container này, vốn chạy các tác vụ riêng lẻ. Xuyên suốt vòng đời job, ResourceManager và ApplicationMaster xử lý giám sát, khôi phục khi lỗi và báo cáo hoàn thành. Về cơ bản là một quy trình năm bước.
Hadoop Common và các Tiện ích
“Chất keo” gắn kết mọi thành phần của Hadoop là Hadoop Common. Đây là bộ sưu tập thư viện, tệp cấu hình và tiện ích cần thiết cho tất cả các mô-đun.
Hadoop Common là gì
Hadoop Common cung cấp mã nền tảng và công cụ cho phép HDFS, YARN và MapReduce giao tiếp và phối hợp. Bao gồm thư viện Java, client hệ thống tệp và API được dùng trong toàn hệ sinh thái.
Nó cũng đảm bảo tính nhất quán và tương thích giữa các mô-đun, cho phép nhà phát triển xây dựng trên một tập primitive dùng chung.
Tầm quan trọng của cấu hình và công cụ
Cấu hình đúng cho Hadoop là điều tối quan trọng. Hadoop Common chứa các tệp cấu hình như
core-site.xml, định nghĩa hành vi mặc định như URI hệ thống tệp và thiết lập I/O.Các công cụ dòng lệnh và script đi kèm trong Hadoop Common hỗ trợ các tác vụ như khởi động dịch vụ, kiểm tra tình trạng nút và quản lý job. Phần lớn các công cụ này là thứ mà quản trị viên hệ thống và nhà phát triển dựa vào cho vận hành cụm hàng ngày.
Ứng dụng Thực tế của Hadoop
Nếu có sử dụng tập dữ liệu khổng lồ, xử lý phân tán hoặc phân tích theo lô, khả năng cao Hadoop cũng được dùng. Cụ thể hơn, Hadoop được dùng trong nhiều ngành để xử lý lượng lớn dữ liệu có cấu trúc và phi cấu trúc. Thiết kế phân tán và tính linh hoạt mã nguồn mở khiến nó phù hợp với các tác vụ đòi hỏi dữ liệu cao.
Các ngành tận dụng Hadoop
Tổ chức trong tài chính, y tế, viễn thông, thương mại điện tử và mạng xã hội thường xuyên dùng Hadoop. Nó giúp ngân hàng phát hiện gian lận theo thời gian thực, hỗ trợ nghiên cứu hệ gen trong y tế, và vận hành hệ gợi ý trong bán lẻ trực tuyến.
Ví dụ trường hợp sử dụng
Các kịch bản này hưởng lợi từ khả năng xử lý tập dữ liệu lớn với tính chịu lỗi và song song của Hadoop.
Để có một lựa chọn hiện đại, thuần đám mây thay cho Hadoop, hãy thử khóa Introduction to Databricks, hỗ trợ Spark và các công cụ có khả năng mở rộng khác.
Tích hợp với các công cụ khác
Hadoop hiếm khi hoạt động độc lập và có thể tích hợp với hàng trăm chương trình bổ trợ. Tùy sở thích và môi trường mã hóa, bạn có thể kết hợp Hadoop với:
Kết luận
Dù không còn là từ khóa “hot” như trước, Hadoop vẫn là công nghệ nền tảng trong bức tranh dữ liệu lớn. Hiểu về Hadoop vẫn vô cùng giá trị cho bất kỳ chuyên gia dữ liệu nào làm việc với hệ thống quy mô lớn. Các thành phần cốt lõi—HDFS cho lưu trữ, MapReduce cho xử lý, YARN cho quản lý tài nguyên và Hadoop Common cho tiện ích thiết yếu—tiếp tục định hình cách thiết kế và mở rộng quy trình dữ liệu.
Trước khi bắt tay triển khai hay tối ưu, hãy dành thời gian hiểu cách dữ liệu được phân phối và cấu hình trong một cụm Hadoop. Kiến thức đó giúp đơn giản hóa xử lý sự cố và tinh chỉnh hiệu năng, đồng thời mở đường tích hợp các công cụ mạnh như Apache Spark và Hive cho phân tích nâng cao.
Để biết thêm về xử lý dữ liệu lớn, hãy xem: