कल्पना करें कि आप एक ऐसी किताबों की दुकान में जाते हैं जहाँ किताबें बिना किसी लेबल के इधर-उधर बिखरी हों... आपको खोजने में बहुत समय लगेगा और शायद आप ज़रूरी चीज़ को मिस भी कर दें।
अब एक सुव्यवस्थित किताबों की दुकान के बारे में सोचिए जहाँ स्पष्ट सेक्शन, किताबों के सारांश, और लेखक के विवरण मौजूद हों। आप तुरंत वही किताब ढूंढ लेंगे जिसकी आपको तलाश है।
यही डेटा कैटलॉग का सार है।
यह आपकी कंपनी के सभी डेटा के लिए एक सुव्यवस्थित लाइब्रेरी जैसा है। यह सभी डेटा एसेट्स को व्यवस्थित, लेबल और उनके बारे में विवरण प्रदान करता है, जिससे उन्हें खोजना और समझना आसान हो जाता है – यह विशेष रूप से उन व्यवसायों के लिए महत्वपूर्ण है जो बहुत सा डेटा बनाते हैं।
इस लेख में, मैं डेटा कैटलॉग पर एक गहन मार्गदर्शिका दूंगा। विशेष रूप से, मैं निम्नलिखित पर चर्चा करूंगा:
- डेटा कैटलॉग क्या है?
- डेटा कैटलॉग की विशेषताएँ
- डेटा कैटलॉग कैसे काम करते हैं
- डेटा कैटलॉग के उपयोग के मामले
- लोकप्रिय डेटा कैटलॉग टूल
- डेटा कैटलॉग लागू करने के सर्वोत्तम तरीके
चलिए शुरू करते हैं!
डेटा कैटलॉग क्या है?
डेटा कैटलॉग मूल रूप से एक केंद्रीकृत सूची है जो मेटाडेटा – या डेटा के बारे में जानकारी – को संगठन के डेटा एसेट्स से संबंधित रूप में संग्रहीत करता है। इन एसेट्स में शामिल हैं:
- डेटा सेट
- टेबल्स
- डेटाबेस
- विभिन्न डेटा स्रोतों से आई फाइलें
डेटा कैटलॉग का प्रमुख उद्देश्य संगठन के डेटा में दृश्यता प्रदान करना है। क्यों? अधिक दृश्यता उपयोगकर्ताओं के लिए डेटा को ढूंढना, समझना और कुशलतापूर्वक उपयोग करना आसान बनाती है।
इस प्रकार, मेटाडेटा को व्यवस्थित करके, डेटा कैटलॉग डेटा डिस्कवरी को सुव्यवस्थित करता है, डेटा गवर्नेंस पहलों का समर्थन करता है, और डेटा टीमों के बीच सहयोग को बढ़ाता है।
डेटा कैटलॉग की विशेषताएँ
डेटा कैटलॉग आमतौर पर कई प्रमुख सुविधाएँ प्रदान करता है, जिनका उद्देश्य किसी संगठन के भीतर डेटा की उपयोगिता और गवर्नेंस में सुधार करना होता है।
यहाँ कुछ सबसे सामान्य सुविधाएँ दी गई हैं।
मेटाडेटा प्रबंधन
डेटा कैटलॉग का एक मुख्य कार्य मेटाडेटा का प्रबंधन करना है। मेटाडेटा, डेटा एसेट्स के बारे में वर्णनात्मक विवरण प्रदान करता है (जैसे स्रोत, संरचना, व्यावसायिक संदर्भ आदि)।
यह ऐसे महत्वपूर्ण प्रश्नों के उत्तर देता है:
- "डेटा कहाँ से आता है?"
- "यह डेटा क्या दर्शाता है?"
- "इस डेटा का उपयोग कैसे किया जा सकता है?"
इससे उपयोगकर्ताओं के लिए डेटा की प्रासंगिकता और गुणवत्ता को जल्दी समझना आसान हो जाता है।
डेटा डिस्कवरी और सर्च
डेटा कैटलॉग मज़बूत खोज क्षमताओं के साथ डेटा डिस्कवरी को सरल बनाते हैं। यानी उपयोगकर्ता कीवर्ड, टैग, फ़िल्टर या व्यावसायिक शब्दों के आधार पर प्रासंगिक डेटा सेट जल्दी ढूंढ सकते हैं।
यदि आप हजारों डेटा सेट वाले बड़े संगठन में काम करते हैं, तो यह सुविधा बहुत मददगार है क्योंकि यह डेटा एक्सप्लोरेशन में लगने वाला समय काफी कम कर देती है।
डेटा लीनिएज
डेटा लीनिएज ट्राक करता है कि डेटा विभिन्न सिस्टमों से होकर कैसे प्रवाहित होता है। डेटा कैटलॉग के साथ, उपयोगकर्ता किसी डेटा सेट की उत्पत्ति का पता लगा सकते हैं, समझ सकते हैं कि यह कैसे विकसित हुआ है, और उसकी अखंडता में संभावित समस्याओं की पहचान कर सकते हैं। यह सुविधा डेटा पर विश्वास सुनिश्चित करने के लिए आवश्यक है और गवर्नेंस तथा अनुपालन प्रयासों का एक प्रमुख घटक है।
डेटा वर्गीकरण और टैगिंग
वर्गीकरण और टैगिंग सुविधाएँ संगठनों को विभिन्न गुणों के आधार पर डेटा को श्रेणीबद्ध करने देती हैं। ये टैग डेटा को संदर्भ प्रदान करते हैं। संदर्भ संबंधित एसेट्स को समूहित करना और डेटा डिस्कवरी को सुव्यवस्थित करना आसान बनाता है।
सहयोग सुविधाएँ
आधुनिक डेटा कैटलॉग डेटा टीमों के काम करने के तरीकों को बदल देते हैं। सिलो में काम करने के बजाय, टीम सदस्य रियल-टाइम में आसानी से अंतर्दृष्टि और फीडबैक साझा कर सकते हैं। वे सीधे डेटा सेट पर टिप्पणी कर सकते हैं, महत्वपूर्ण विवरणों को फ़्लैग कर सकते हैं, और डेटा गुणवत्ता को रेट कर सकते हैं, जिससे कैटलॉग एक गतिशील सूचना हब में बदल जाता है।
यह दृष्टिकोण पारदर्शिता बढ़ाता है – सभी जानते हैं कि कौन सा डेटा भरोसेमंद है और क्यों। नोट्स जोड़ना और गुणवत्ता स्कोर असाइन करना, एक जीवंत दस्तावेज़ की नींव रखता है जो डेटा की यात्रा को ट्रैक करता है।
डेटा गवर्नेंस समर्थन
डेटा कैटलॉग डेटा गवर्नेंस को आगे बढ़ाता है, यानी वह सक्रिय रूप से वे नियम लागू करता है जो डेटा को सुरक्षित और सुव्यवस्थित रखते हैं। कैसे? यह स्पष्ट रूप से परिभाषित करता है:
- प्रत्येक डेटा सेट का स्वामी कौन है
- किसके पास पहुँच है
- उपयोग दिशानिर्देश क्या हैं
यह संरचना संगठनों को अपने डेटा पर नियंत्रण में रहने, उसे जिम्मेदारी से उपयोग करने, और नियामकीय अनुपालन सुनिश्चित करने में सक्षम बनाती है।
डेटा कैटलॉग कैसे काम करता है?
डेटा कैटलॉग कैसे काम करते हैं, इसे समझने का सबसे अच्छा तरीका है अपने संगठन के डेटा को एक व्यस्त हवाई अड्डे की तरह सोचना। आपके पास विमान (डेटा) लगातार आ रहे हैं, जा रहे हैं, और कनेक्ट हो रहे हैं।
हवाई अड्डों पर एयर ट्रैफिक कंट्रोल टावर हवाई यातायात के सुरक्षित और कुशल प्रबंधन के लिए ज़िम्मेदार होते हैं – यदि वे न हों तो अराजकता फैल जाए।
आपका डेटा कैटलॉग उसी कंट्रोल टावर की तरह काम करता है। कैसे? यह हर रूट को मैप करता है, हर फ्लाइट की यात्रा को ट्रैक करता है, और समग्र रूप से सुनिश्चित करता है कि सब कुछ सुचारू रूप से चले। यह प्रत्येक विमान की उत्पत्ति, गंतव्य, और रास्ते में हुए ठहराव के बारे में भी विवरण एकत्र करता है।
लेकिन यह तो सिर्फ एक सामान्य सारांश है…
इस खंड में, हम डेटा कैटलॉग के काम करने की आंतरिक प्रक्रियाओं को कवर करेंगे, जिससे आप इसके संचालन को बेहतर तरीके से समझ पाएँगे।
मेटाडेटा एकत्र करना
डेटा कैटलॉग किसी जासूस की तरह होते हैं जो किसी मामले की जानकारी इकट्ठी करता है; वे हर कोने से सुराग जुटाते हैं ताकि हल मिल सके। हालाँकि, डेटा कैटलॉग के मामले में ये सुराग मेटाडेटा होते हैं।
दूसरे शब्दों में, डेटा कैटलॉग विभिन्न स्रोतों से मेटाडेटा एकत्र करते हैं। यह कोई डेटाबेस, डेटा लेक, क्लाउड स्टोरेज, या अन्य डेटा रिपॉजिटरी हो सकता है। स्वचालित प्रक्रियाएँ जासूस के औज़ारों की तरह काम करती हैं, यह पहचानने के लिए कि डेटा कहाँ से आया, इसकी संरचना क्या है, और इसका उद्देश्य क्या है।
जैसे कोई जासूस लगातार सुराग जुटाकर मामले पर अपनी समझ अपडेट करता रहता है, वैसे ही डेटा कैटलॉग स्वयं को निरंतर अपडेट करता है ताकि आपकी टीम के पास हमेशा ताज़ा और सटीक जानकारी रहे और वह आपकी डेटा ज़रूरतों को सुलझा सके।
डेटा का इंडेक्सिंग और संगठन
जब जासूस सुराग एकत्र करता है, तो वह उन्हें ढेर में नहीं फेंकता – वह सब कुछ बारीकी से व्यवस्थित करता है। डेटा कैटलॉग भी वही करता है; यह मेटाडेटा का इंडेक्स बनाता है, यानी प्रकार, स्रोत, और टैग जैसे प्रमुख गुणों के अनुसार उसे छाँटता है।
यह ऐसा है जैसे एक केस फ़ाइल बनाई जा रही हो जहाँ हर सुराग अपनी जगह पर हो, जैसे फिल्मों में दीवार पर सुरागों को आपस में जोड़ा जाता है। डेटा का इंडेक्सिंग और संगठन टीम के लिए कड़ियाँ जोड़ना कहीं आसान बना देता है। यानी, यह उपयोगकर्ताओं को डेटा परिदृश्य में नेविगेट करने और तुरंत वही ढूंढने में मदद करता है जिसकी उन्हें ज़रूरत है।
डेटा कैटलॉग के साथ उपयोगकर्ता की सहभागिता
जब तक जेम्स बॉन्ड केस नहीं संभाल रहे, जासूस आमतौर पर केस फ़ाइल अपने तक सीमित नहीं रखते। वे उन्हें दस्तावेज़ित करते हैं और केंद्रीकृत सिस्टम में साझा करते हैं ताकि दूसरे भी पहेली सुलझाने में मदद कर सकें।
फिर से, डेटा कैटलॉग इसी तरह काम करता है। यह एक सहज इंटरफ़ेस प्रदान करता है जिसका उपयोग कोई भी डेटा सेट खोजने, डेटा के पीछे की कहानी जानने, और उसके मेटाडेटा का अन्वेषण करने के लिए कर सकता है।
एडवांस्ड फ़िल्टर, आकर्षक डैशबोर्ड, और अनुकूलित दृश्य अनुभव को आसान बना देते हैं, जिससे हर उपयोगकर्ता तकनीकी विशेषज्ञता न होने पर भी डेटा जासूस बन सकता है।
डेटा कैटलॉग के उपयोग के मामले
डेटा कैटलॉग बहुउद्देशीय टूल हैं जो संगठनों में कई तरह की ज़रूरतें पूरी करते हैं। उदाहरण के लिए, वे संगठनों को डेटा गुणवत्ता में सुधार करने में मदद करते हैं। हालाँकि, वे गवर्नेंस नीतियों को लागू करने और डेटा वैज्ञानिकों को सही डेटा सेट खोजने में भी मदद कर सकते हैं।
आइए कुछ व्यावहारिक परिदृश्यों का अन्वेषण करें जहाँ डेटा कैटलॉग महत्वपूर्ण प्रभाव डालते हैं।
डेटा वैज्ञानिकों और विश्लेषकों के लिए डेटा डिस्कवरी
एक डेटा साइंटिस्ट जो कस्टमर चर्न की भविष्यवाणी करने वाला मॉडल बना रहा हो, वह अपने सिस्टम को फ़ीड करने के लिए ऐतिहासिक ग्राहक डेटा, बिक्री लेनदेन, और एंगेजमेंट मेट्रिक्स जल्दी से ढूँढने हेतु डेटा कैटलॉग का उपयोग कर सकता है। कई डेटाबेस में खोजबीन करने की बजाय, वे कैटलॉग के सर्च फ़िल्टर का उपयोग करके मिनटों में सबसे प्रासंगिक डेटा सेट ढूँढ लेते हैं, जिससे उनके विश्लेषण और मॉडल निर्माण की प्रक्रिया तेज़ हो जाती है।
डेटा गवर्नेंस पहलों का समर्थन
एक डेटा स्टुअर्ड डेटा कैटलॉग में यह जाँचने के लिए लॉग इन कर सकता है कि प्रत्येक डेटा सेट का स्वामी कौन है और कौन सी एक्सेस परमिशन लागू हैं। मेटाडेटा की समीक्षा करके वे सुनिश्चित करते हैं कि केवल अधिकृत उपयोगकर्ता ही संवेदनशील डेटा तक पहुँचें, जिससे आंतरिक नीतियों और विनियमों का अनुपालन लागू करने में मदद मिलती है।
डेटा गुणवत्ता प्रबंधन में सुधार
मान लीजिए कोई डेटा विश्लेषक सेल्स रिपोर्ट की समीक्षा करते समय ग्राहक डेटा में असंगतियाँ नोटिस करता है... डेटा कैटलॉग का उपयोग करके, वह डेटा सेट की लीनिएज ट्रेस कर सकता है, पहचान सकता है कि डेटा गुणवत्ता की समस्या कहाँ से उत्पन्न हुई, और उसे जल्दी ठीक कर सकता है ताकि भविष्य की रिपोर्टों के लिए सटीक और विश्वसनीय डेटा सुनिश्चित किया जा सके।
लोकप्रिय डेटा कैटलॉग टूल
हमने यह स्थापित किया है कि डेटा कैटलॉग टूल संगठनों को उनके डेटा एसेट्स का प्रबंधन, संगठन, और डिस्कवरी करने में सहायता करते हैं। वे इन एसेट्स की सूची बनाकर और प्रासंगिक मेटाडेटा कैप्चर करके ऐसा करते हैं।
लेकिन डेटा कैटलॉग के साथ शुरुआत कहाँ से करें? इस खंड में, हम कुछ सबसे लोकप्रिय डेटा कैटलॉग टूल का अन्वेषण करेंगे जो उद्योग में प्रभाव डाल रहे हैं।
AWS Glue Data Catalog
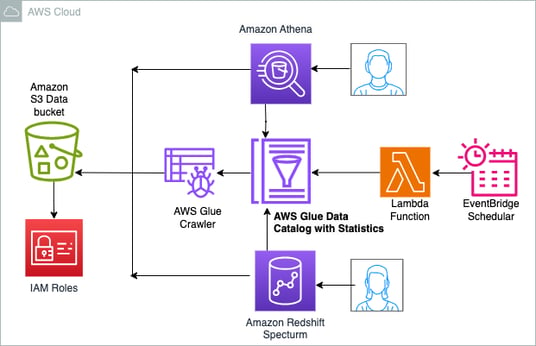
Glue Data Catalog का उपयोग करके डेटा आर्किटेक्चर का उदाहरण। चित्र सोर्स: AWS
AWS Glue Data Catalog एक पूर्णतः प्रबंधित, सर्वरलेस डेटा कैटलॉग है जो आपके सभी मेटाडेटा के लिए केंद्रीय रिपॉजिटरी के रूप में कार्य करता है। यह अन्य AWS सर्विसेज जैसे Amazon Redshift, Amazon S3, और AWS Athena के साथ इंटीग्रेट होता है।
यह आपके डेटा स्रोतों से मेटाडेटा को स्वतः खोजकर और वर्गीकृत करके उपयोगकर्ताओं को अपने डेटा सेट जल्दी ढूँढने और एक्सेस करने में मदद करता है। ध्यान दें कि Glue Data Catalog डेटा गवर्नेंस और सुरक्षा का भी समर्थन करता है।
Alation
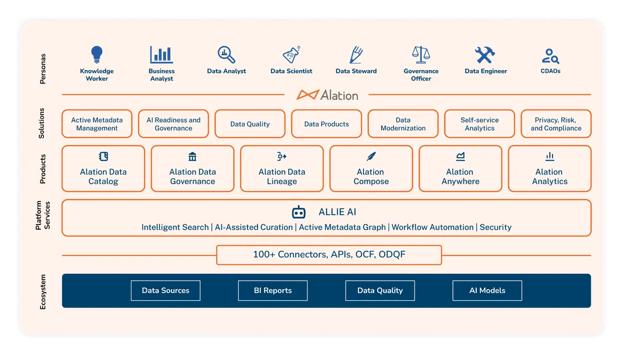
Alation इकोसिस्टम और जहाँ डेटा कैटलॉग समाधान फिट होता है। चित्र सोर्स: Alation.
Alation एक AI-संचालित डेटा कैटलॉग है जो संगठनों को डेटा डिस्कवरी और गवर्नेंस में सुधार करने में मदद करता है। यह शक्तिशाली मशीन लर्निंग एल्गोरिद्म का लाभ उठाकर मेटाडेटा को स्वतः इंडेक्स, वर्गीकृत, और क्यूरेट करता है, जिससे उपयोगकर्ताओं के लिए प्रासंगिक डेटा सेट ढूँढना आसान हो जाता है।
Alation की सहयोगात्मक विशेषताएँ, जैसे प्रश्न पूछना, डेटा को टैग करना, और चर्चाएँ बनाना, डेटा टीमों और व्यावसायिक उपयोगकर्ताओं के बीच टीमवर्क को प्रोत्साहित करती हैं। एक और लाभकारी सुविधा इसका विस्तृत डेटा लीनिएज ट्रैकिंग है। यह संगठनों को अपने डेटा के संदर्भ को समझने और उसकी गुणवत्ता और अनुपालन सुनिश्चित करने में मदद करता है।
Collibra
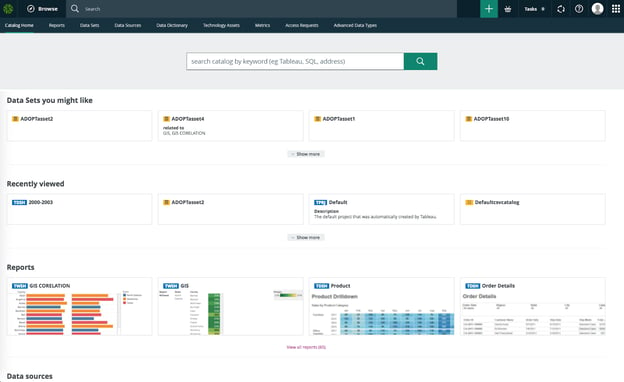
Collibra डेटा कैटलॉग का यूज़र इंटरफ़ेस। चित्र सोर्स: Collibra
Collibra के कैटलॉग में स्वचालित डेटा डिस्कवरी, मेटाडेटा क्यूरेशन, और डेटा स्टुअर्डशिप क्षमताएँ शामिल हैं। यह डेटा लीनिएज को ट्रैक करने और अनुपालन आवश्यकताओं को प्रबंधित करने के लिए टूल भी प्रदान करता है। Collibra डेटा पेशेवरों और व्यावसायिक उपयोगकर्ताओं के बीच सहयोग को बढ़ावा देकर पूरे संगठन में डेटा गवर्नेंस प्रक्रियाओं को बनाए रखता है। यह विभिन्न डेटा स्रोतों और प्लेटफ़ॉर्म के साथ एकीकृत भी होता है, जिससे यह विविध डेटा इकोसिस्टम के अनुकूल हो जाता है।
Apache Atlas
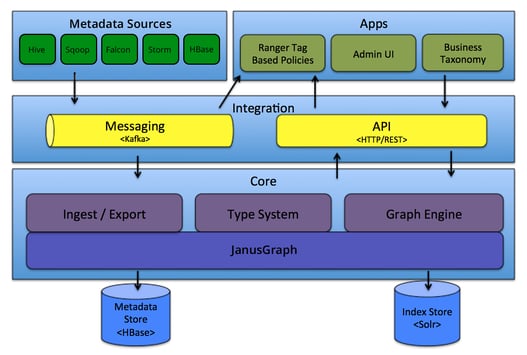
Apache Atlas का उच्च-स्तरीय आर्किटेक्चर अवलोकन। चित्र सोर्स: Apache Atlas
Apache Atlas एक ओपन-सोर्स डेटा गवर्नेंस और मेटाडेटा प्रबंधन टूल है जो जटिल वातावरणों में संगठनों को उनके डेटा एसेट्स का प्रबंधन करने में मदद करता है, विशेषकर Hadoop इकोसिस्टम के भीतर। यह उपयोगकर्ताओं को मेटाडेटा, लीनिएज, और डेटा गवर्नेंस प्रबंधित करने के लिए एक एकीकृत ढाँचा प्रदान करता है।
अर्थात, Atlas संगठनों को अपने डेटा के लिए कस्टम प्रकार और संबंध परिभाषित करने देता है, जिससे डेटा प्रवाह का बेहतर ट्रैकिंग और प्रबंधन संभव होता है। इसके अलावा, Atlas के समृद्ध API सेट और एकीकरण क्षमताएँ इसका बड़े उद्यमों की विशिष्ट आवश्यकताओं के अनुरूप अनुकूलन संभव बनाती हैं, जिससे अनुपालन सुनिश्चित होता है और डेटा-आधारित निर्णय लेने में सहूलियत मिलती है।
डेटा कैटलॉग लागू करने के सर्वोत्तम तरीके
डेटा कैटलॉग के फ़ायदों का पूरा लाभ उठाने के लिए, संगठनों को ऐसे सर्वोत्तम तरीकों का पालन करना चाहिए जो प्रभावी अपनाने और उपयोग को सुनिश्चित करें। इस खंड में, हम आपके संगठन में डेटा कैटलॉग को सफलतापूर्वक लागू और बनाए रखने के लिए प्रमुख रणनीतियों का अन्वेषण करेंगे।
स्पष्ट उद्देश्यों से शुरुआत करें
क्या आप बिना गंतव्य तय किए रोड ट्रिप पर निकलेंगे? बिल्कुल नहीं। तो डेटा कैटलॉग के साथ भी ऐसा न करें। हो सकता है आप किसी दिलचस्प जगह पहुँच जाएँ, पर संभव है कि वह वह जगह न हो जहाँ आप जाना चाहते थे। यदि आपके डेटा कैटलॉग के लिए स्पष्ट उद्देश्य नहीं हैं, तो आप आँख मूँदकर नेविगेट कर रहे हैं – और यह नुस्ख़ा विफलता का है।
याद रखें: डेटा कैटलॉग एक औज़ार है। औज़ारों का काम आपकी ज़रूरतों को अधिक कुशलता से पूरा करना है। यदि आपकी ज़रूरतें स्पष्ट नहीं हैं, तो आप अपने औज़ार का सर्वोत्तम उपयोग नहीं कर पाएँगे।
उपयोगकर्ता अपनाने पर ध्यान दें
डेटा कैटलॉग इतना महँगा होता है कि वह कोने में धूल खाता रहे क्योंकि किसी को सच में इसका उपयोग करना न आता हो। लेकिन ऐसा अक्सर होता है। यदि उपयोगकर्ता इस टूल को नहीं अपनाते, तो यह बेकार है।
अपने डेटा कैटलॉग का अधिकतम लाभ लेने के लिए, सभी को साथ लाना ज़रूरी है। अपनी टीम को प्रशिक्षित करें, उन्हें कैटलॉग का मूल्य दिखाएँ, और सुनिश्चित करें कि यह उनके दैनिक कार्यप्रवाह में एकीकृत हो।
मेटाडेटा को नियमित रूप से अपडेट और मेंटेन करें
डेटा कैटलॉग की उपयोगिता बनाए रखने के लिए मेटाडेटा को अद्यतन रखना आवश्यक है। यदि आप इसे नियमित रूप से अपडेट और मेंटेन नहीं करते, तो यह पुराना और अविश्वसनीय हो जाता है, जिससे आपका डेटा कैटलॉग अप्रभावी बन जाता है। इसे कार की मेंटेनेंस जैसा समझें। क्या आप बिना नियमित ट्यून-अप और ऑयल चेंज के कार चलाएँगे? मेटाडेटा पर भी यही लागू होता है।
हितधारकों को प्रक्रिया में शामिल करें
सफल डेटा कैटलॉग बनाना एक अकेले व्यक्ति का काम नहीं है। आपके संगठन के सभी क्षेत्रों के हितधारकों को शामिल करना आवश्यक है ताकि कैटलॉग संबंधित सभी लोगों की ज़रूरतों को पूरा करे। शुरुआत से ही सभी हितधारकों की भागीदारी सुनिश्चित करती है कि कैटलॉग आपके संगठन के प्रत्येक समूह की विशिष्ट आवश्यकताओं को दर्शाए।
निष्कर्ष
डेटा कैटलॉग किसी संगठन के लिए डेटा की स्पष्टता, दक्षता, और अंतर्दृष्टि की खोज में एक गुप्त हथियार है। यह GPS की तरह है, जो आपको ठीक उसी समय वही जानकारी तक पहुँचाता है जिसकी आपको ज़रूरत है, वह भी बिना अनुमान के। लेकिन अन्य किसी शक्तिशाली औज़ार की तरह, इसकी सफलता इस बात पर निर्भर करती है कि इसे कैसे लागू किया जाता है।
यदि आप स्पष्ट उद्देश्यों से शुरुआत करते हैं, पूरी टीम को साथ लाते हैं, डेटा को ताज़ा रखते हैं, और शुरुआत से ही हितधारकों को शामिल करते हैं, तो आपका डेटा कैटलॉग एक अंतर्दृष्टि भंडार के रूप में काम करेगा।
याद रखें, लक्ष्य केवल डेटा इकट्ठा करना नहीं है; उसका पूरा सामर्थ्य खोलना है – और यदि आप इस लेख में साझा किए गए सर्वोत्तम तरीकों का पालन करते हैं, तो आपका डेटा कैटलॉग आपको इस लक्ष्य तक पहुँचने में मदद करेगा।
आगे की सीख के लिए, मैं अनुशंसा करता हूँ कि आप निम्न संसाधन देखें:


कल्पना करें कि आप एक ऐसी किताबों की दुकान में जाते हैं जहाँ किताबें बिना किसी लेबल के इधर-उधर बिखरी हों... आपको खोजने में बहुत समय लगेगा और शायद आप ज़रूरी चीज़ को मिस भी कर दें।
अब एक सुव्यवस्थित किताबों की दुकान के बारे में सोचिए जहाँ स्पष्ट सेक्शन, किताबों के सारांश, और लेखक के विवरण मौजूद हों। आप तुरंत वही किताब ढूंढ लेंगे जिसकी आपको तलाश है।
यही डेटा कैटलॉग का सार है।
यह आपकी कंपनी के सभी डेटा के लिए एक सुव्यवस्थित लाइब्रेरी जैसा है। यह सभी डेटा एसेट्स को व्यवस्थित, लेबल और उनके बारे में विवरण प्रदान करता है, जिससे उन्हें खोजना और समझना आसान हो जाता है – यह विशेष रूप से उन व्यवसायों के लिए महत्वपूर्ण है जो बहुत सा डेटा बनाते हैं।
इस लेख में, मैं डेटा कैटलॉग पर एक गहन मार्गदर्शिका दूंगा। विशेष रूप से, मैं निम्नलिखित पर चर्चा करूंगा:
चलिए शुरू करते हैं!
डेटा कैटलॉग क्या है?
डेटा कैटलॉग मूल रूप से एक केंद्रीकृत सूची है जो मेटाडेटा – या डेटा के बारे में जानकारी – को संगठन के डेटा एसेट्स से संबंधित रूप में संग्रहीत करता है। इन एसेट्स में शामिल हैं:
डेटा कैटलॉग का प्रमुख उद्देश्य संगठन के डेटा में दृश्यता प्रदान करना है। क्यों? अधिक दृश्यता उपयोगकर्ताओं के लिए डेटा को ढूंढना, समझना और कुशलतापूर्वक उपयोग करना आसान बनाती है।
इस प्रकार, मेटाडेटा को व्यवस्थित करके, डेटा कैटलॉग डेटा डिस्कवरी को सुव्यवस्थित करता है, डेटा गवर्नेंस पहलों का समर्थन करता है, और डेटा टीमों के बीच सहयोग को बढ़ाता है।
डेटा कैटलॉग की विशेषताएँ
डेटा कैटलॉग आमतौर पर कई प्रमुख सुविधाएँ प्रदान करता है, जिनका उद्देश्य किसी संगठन के भीतर डेटा की उपयोगिता और गवर्नेंस में सुधार करना होता है।
यहाँ कुछ सबसे सामान्य सुविधाएँ दी गई हैं।
मेटाडेटा प्रबंधन
डेटा कैटलॉग का एक मुख्य कार्य मेटाडेटा का प्रबंधन करना है। मेटाडेटा, डेटा एसेट्स के बारे में वर्णनात्मक विवरण प्रदान करता है (जैसे स्रोत, संरचना, व्यावसायिक संदर्भ आदि)।
यह ऐसे महत्वपूर्ण प्रश्नों के उत्तर देता है:
इससे उपयोगकर्ताओं के लिए डेटा की प्रासंगिकता और गुणवत्ता को जल्दी समझना आसान हो जाता है।
डेटा डिस्कवरी और सर्च
डेटा कैटलॉग मज़बूत खोज क्षमताओं के साथ डेटा डिस्कवरी को सरल बनाते हैं। यानी उपयोगकर्ता कीवर्ड, टैग, फ़िल्टर या व्यावसायिक शब्दों के आधार पर प्रासंगिक डेटा सेट जल्दी ढूंढ सकते हैं।
यदि आप हजारों डेटा सेट वाले बड़े संगठन में काम करते हैं, तो यह सुविधा बहुत मददगार है क्योंकि यह डेटा एक्सप्लोरेशन में लगने वाला समय काफी कम कर देती है।
डेटा लीनिएज
डेटा लीनिएज ट्राक करता है कि डेटा विभिन्न सिस्टमों से होकर कैसे प्रवाहित होता है। डेटा कैटलॉग के साथ, उपयोगकर्ता किसी डेटा सेट की उत्पत्ति का पता लगा सकते हैं, समझ सकते हैं कि यह कैसे विकसित हुआ है, और उसकी अखंडता में संभावित समस्याओं की पहचान कर सकते हैं। यह सुविधा डेटा पर विश्वास सुनिश्चित करने के लिए आवश्यक है और गवर्नेंस तथा अनुपालन प्रयासों का एक प्रमुख घटक है।
डेटा वर्गीकरण और टैगिंग
वर्गीकरण और टैगिंग सुविधाएँ संगठनों को विभिन्न गुणों के आधार पर डेटा को श्रेणीबद्ध करने देती हैं। ये टैग डेटा को संदर्भ प्रदान करते हैं। संदर्भ संबंधित एसेट्स को समूहित करना और डेटा डिस्कवरी को सुव्यवस्थित करना आसान बनाता है।
सहयोग सुविधाएँ
आधुनिक डेटा कैटलॉग डेटा टीमों के काम करने के तरीकों को बदल देते हैं। सिलो में काम करने के बजाय, टीम सदस्य रियल-टाइम में आसानी से अंतर्दृष्टि और फीडबैक साझा कर सकते हैं। वे सीधे डेटा सेट पर टिप्पणी कर सकते हैं, महत्वपूर्ण विवरणों को फ़्लैग कर सकते हैं, और डेटा गुणवत्ता को रेट कर सकते हैं, जिससे कैटलॉग एक गतिशील सूचना हब में बदल जाता है।
यह दृष्टिकोण पारदर्शिता बढ़ाता है – सभी जानते हैं कि कौन सा डेटा भरोसेमंद है और क्यों। नोट्स जोड़ना और गुणवत्ता स्कोर असाइन करना, एक जीवंत दस्तावेज़ की नींव रखता है जो डेटा की यात्रा को ट्रैक करता है।
डेटा गवर्नेंस समर्थन
डेटा कैटलॉग डेटा गवर्नेंस को आगे बढ़ाता है, यानी वह सक्रिय रूप से वे नियम लागू करता है जो डेटा को सुरक्षित और सुव्यवस्थित रखते हैं। कैसे? यह स्पष्ट रूप से परिभाषित करता है:
यह संरचना संगठनों को अपने डेटा पर नियंत्रण में रहने, उसे जिम्मेदारी से उपयोग करने, और नियामकीय अनुपालन सुनिश्चित करने में सक्षम बनाती है।
डेटा कैटलॉग कैसे काम करता है?
डेटा कैटलॉग कैसे काम करते हैं, इसे समझने का सबसे अच्छा तरीका है अपने संगठन के डेटा को एक व्यस्त हवाई अड्डे की तरह सोचना। आपके पास विमान (डेटा) लगातार आ रहे हैं, जा रहे हैं, और कनेक्ट हो रहे हैं।
हवाई अड्डों पर एयर ट्रैफिक कंट्रोल टावर हवाई यातायात के सुरक्षित और कुशल प्रबंधन के लिए ज़िम्मेदार होते हैं – यदि वे न हों तो अराजकता फैल जाए।
आपका डेटा कैटलॉग उसी कंट्रोल टावर की तरह काम करता है। कैसे? यह हर रूट को मैप करता है, हर फ्लाइट की यात्रा को ट्रैक करता है, और समग्र रूप से सुनिश्चित करता है कि सब कुछ सुचारू रूप से चले। यह प्रत्येक विमान की उत्पत्ति, गंतव्य, और रास्ते में हुए ठहराव के बारे में भी विवरण एकत्र करता है।
लेकिन यह तो सिर्फ एक सामान्य सारांश है…
इस खंड में, हम डेटा कैटलॉग के काम करने की आंतरिक प्रक्रियाओं को कवर करेंगे, जिससे आप इसके संचालन को बेहतर तरीके से समझ पाएँगे।
मेटाडेटा एकत्र करना
डेटा कैटलॉग किसी जासूस की तरह होते हैं जो किसी मामले की जानकारी इकट्ठी करता है; वे हर कोने से सुराग जुटाते हैं ताकि हल मिल सके। हालाँकि, डेटा कैटलॉग के मामले में ये सुराग मेटाडेटा होते हैं।
दूसरे शब्दों में, डेटा कैटलॉग विभिन्न स्रोतों से मेटाडेटा एकत्र करते हैं। यह कोई डेटाबेस, डेटा लेक, क्लाउड स्टोरेज, या अन्य डेटा रिपॉजिटरी हो सकता है। स्वचालित प्रक्रियाएँ जासूस के औज़ारों की तरह काम करती हैं, यह पहचानने के लिए कि डेटा कहाँ से आया, इसकी संरचना क्या है, और इसका उद्देश्य क्या है।
जैसे कोई जासूस लगातार सुराग जुटाकर मामले पर अपनी समझ अपडेट करता रहता है, वैसे ही डेटा कैटलॉग स्वयं को निरंतर अपडेट करता है ताकि आपकी टीम के पास हमेशा ताज़ा और सटीक जानकारी रहे और वह आपकी डेटा ज़रूरतों को सुलझा सके।
डेटा का इंडेक्सिंग और संगठन
जब जासूस सुराग एकत्र करता है, तो वह उन्हें ढेर में नहीं फेंकता – वह सब कुछ बारीकी से व्यवस्थित करता है। डेटा कैटलॉग भी वही करता है; यह मेटाडेटा का इंडेक्स बनाता है, यानी प्रकार, स्रोत, और टैग जैसे प्रमुख गुणों के अनुसार उसे छाँटता है।
यह ऐसा है जैसे एक केस फ़ाइल बनाई जा रही हो जहाँ हर सुराग अपनी जगह पर हो, जैसे फिल्मों में दीवार पर सुरागों को आपस में जोड़ा जाता है। डेटा का इंडेक्सिंग और संगठन टीम के लिए कड़ियाँ जोड़ना कहीं आसान बना देता है। यानी, यह उपयोगकर्ताओं को डेटा परिदृश्य में नेविगेट करने और तुरंत वही ढूंढने में मदद करता है जिसकी उन्हें ज़रूरत है।
डेटा कैटलॉग के साथ उपयोगकर्ता की सहभागिता
जब तक जेम्स बॉन्ड केस नहीं संभाल रहे, जासूस आमतौर पर केस फ़ाइल अपने तक सीमित नहीं रखते। वे उन्हें दस्तावेज़ित करते हैं और केंद्रीकृत सिस्टम में साझा करते हैं ताकि दूसरे भी पहेली सुलझाने में मदद कर सकें।
फिर से, डेटा कैटलॉग इसी तरह काम करता है। यह एक सहज इंटरफ़ेस प्रदान करता है जिसका उपयोग कोई भी डेटा सेट खोजने, डेटा के पीछे की कहानी जानने, और उसके मेटाडेटा का अन्वेषण करने के लिए कर सकता है।
एडवांस्ड फ़िल्टर, आकर्षक डैशबोर्ड, और अनुकूलित दृश्य अनुभव को आसान बना देते हैं, जिससे हर उपयोगकर्ता तकनीकी विशेषज्ञता न होने पर भी डेटा जासूस बन सकता है।
डेटा कैटलॉग के उपयोग के मामले
डेटा कैटलॉग बहुउद्देशीय टूल हैं जो संगठनों में कई तरह की ज़रूरतें पूरी करते हैं। उदाहरण के लिए, वे संगठनों को डेटा गुणवत्ता में सुधार करने में मदद करते हैं। हालाँकि, वे गवर्नेंस नीतियों को लागू करने और डेटा वैज्ञानिकों को सही डेटा सेट खोजने में भी मदद कर सकते हैं।
आइए कुछ व्यावहारिक परिदृश्यों का अन्वेषण करें जहाँ डेटा कैटलॉग महत्वपूर्ण प्रभाव डालते हैं।
डेटा वैज्ञानिकों और विश्लेषकों के लिए डेटा डिस्कवरी
एक डेटा साइंटिस्ट जो कस्टमर चर्न की भविष्यवाणी करने वाला मॉडल बना रहा हो, वह अपने सिस्टम को फ़ीड करने के लिए ऐतिहासिक ग्राहक डेटा, बिक्री लेनदेन, और एंगेजमेंट मेट्रिक्स जल्दी से ढूँढने हेतु डेटा कैटलॉग का उपयोग कर सकता है। कई डेटाबेस में खोजबीन करने की बजाय, वे कैटलॉग के सर्च फ़िल्टर का उपयोग करके मिनटों में सबसे प्रासंगिक डेटा सेट ढूँढ लेते हैं, जिससे उनके विश्लेषण और मॉडल निर्माण की प्रक्रिया तेज़ हो जाती है।
डेटा गवर्नेंस पहलों का समर्थन
एक डेटा स्टुअर्ड डेटा कैटलॉग में यह जाँचने के लिए लॉग इन कर सकता है कि प्रत्येक डेटा सेट का स्वामी कौन है और कौन सी एक्सेस परमिशन लागू हैं। मेटाडेटा की समीक्षा करके वे सुनिश्चित करते हैं कि केवल अधिकृत उपयोगकर्ता ही संवेदनशील डेटा तक पहुँचें, जिससे आंतरिक नीतियों और विनियमों का अनुपालन लागू करने में मदद मिलती है।
डेटा गुणवत्ता प्रबंधन में सुधार
मान लीजिए कोई डेटा विश्लेषक सेल्स रिपोर्ट की समीक्षा करते समय ग्राहक डेटा में असंगतियाँ नोटिस करता है... डेटा कैटलॉग का उपयोग करके, वह डेटा सेट की लीनिएज ट्रेस कर सकता है, पहचान सकता है कि डेटा गुणवत्ता की समस्या कहाँ से उत्पन्न हुई, और उसे जल्दी ठीक कर सकता है ताकि भविष्य की रिपोर्टों के लिए सटीक और विश्वसनीय डेटा सुनिश्चित किया जा सके।
लोकप्रिय डेटा कैटलॉग टूल
हमने यह स्थापित किया है कि डेटा कैटलॉग टूल संगठनों को उनके डेटा एसेट्स का प्रबंधन, संगठन, और डिस्कवरी करने में सहायता करते हैं। वे इन एसेट्स की सूची बनाकर और प्रासंगिक मेटाडेटा कैप्चर करके ऐसा करते हैं।
लेकिन डेटा कैटलॉग के साथ शुरुआत कहाँ से करें? इस खंड में, हम कुछ सबसे लोकप्रिय डेटा कैटलॉग टूल का अन्वेषण करेंगे जो उद्योग में प्रभाव डाल रहे हैं।
AWS Glue Data Catalog
Glue Data Catalog का उपयोग करके डेटा आर्किटेक्चर का उदाहरण। चित्र सोर्स: AWS
AWS Glue Data Catalog एक पूर्णतः प्रबंधित, सर्वरलेस डेटा कैटलॉग है जो आपके सभी मेटाडेटा के लिए केंद्रीय रिपॉजिटरी के रूप में कार्य करता है। यह अन्य AWS सर्विसेज जैसे Amazon Redshift, Amazon S3, और AWS Athena के साथ इंटीग्रेट होता है।
यह आपके डेटा स्रोतों से मेटाडेटा को स्वतः खोजकर और वर्गीकृत करके उपयोगकर्ताओं को अपने डेटा सेट जल्दी ढूँढने और एक्सेस करने में मदद करता है। ध्यान दें कि Glue Data Catalog डेटा गवर्नेंस और सुरक्षा का भी समर्थन करता है।
Alation
Alation इकोसिस्टम और जहाँ डेटा कैटलॉग समाधान फिट होता है। चित्र सोर्स: Alation.
Alation एक AI-संचालित डेटा कैटलॉग है जो संगठनों को डेटा डिस्कवरी और गवर्नेंस में सुधार करने में मदद करता है। यह शक्तिशाली मशीन लर्निंग एल्गोरिद्म का लाभ उठाकर मेटाडेटा को स्वतः इंडेक्स, वर्गीकृत, और क्यूरेट करता है, जिससे उपयोगकर्ताओं के लिए प्रासंगिक डेटा सेट ढूँढना आसान हो जाता है।
Alation की सहयोगात्मक विशेषताएँ, जैसे प्रश्न पूछना, डेटा को टैग करना, और चर्चाएँ बनाना, डेटा टीमों और व्यावसायिक उपयोगकर्ताओं के बीच टीमवर्क को प्रोत्साहित करती हैं। एक और लाभकारी सुविधा इसका विस्तृत डेटा लीनिएज ट्रैकिंग है। यह संगठनों को अपने डेटा के संदर्भ को समझने और उसकी गुणवत्ता और अनुपालन सुनिश्चित करने में मदद करता है।
Collibra
Collibra डेटा कैटलॉग का यूज़र इंटरफ़ेस। चित्र सोर्स: Collibra
Collibra के कैटलॉग में स्वचालित डेटा डिस्कवरी, मेटाडेटा क्यूरेशन, और डेटा स्टुअर्डशिप क्षमताएँ शामिल हैं। यह डेटा लीनिएज को ट्रैक करने और अनुपालन आवश्यकताओं को प्रबंधित करने के लिए टूल भी प्रदान करता है। Collibra डेटा पेशेवरों और व्यावसायिक उपयोगकर्ताओं के बीच सहयोग को बढ़ावा देकर पूरे संगठन में डेटा गवर्नेंस प्रक्रियाओं को बनाए रखता है। यह विभिन्न डेटा स्रोतों और प्लेटफ़ॉर्म के साथ एकीकृत भी होता है, जिससे यह विविध डेटा इकोसिस्टम के अनुकूल हो जाता है।
Apache Atlas
Apache Atlas का उच्च-स्तरीय आर्किटेक्चर अवलोकन। चित्र सोर्स: Apache Atlas
Apache Atlas एक ओपन-सोर्स डेटा गवर्नेंस और मेटाडेटा प्रबंधन टूल है जो जटिल वातावरणों में संगठनों को उनके डेटा एसेट्स का प्रबंधन करने में मदद करता है, विशेषकर Hadoop इकोसिस्टम के भीतर। यह उपयोगकर्ताओं को मेटाडेटा, लीनिएज, और डेटा गवर्नेंस प्रबंधित करने के लिए एक एकीकृत ढाँचा प्रदान करता है।
अर्थात, Atlas संगठनों को अपने डेटा के लिए कस्टम प्रकार और संबंध परिभाषित करने देता है, जिससे डेटा प्रवाह का बेहतर ट्रैकिंग और प्रबंधन संभव होता है। इसके अलावा, Atlas के समृद्ध API सेट और एकीकरण क्षमताएँ इसका बड़े उद्यमों की विशिष्ट आवश्यकताओं के अनुरूप अनुकूलन संभव बनाती हैं, जिससे अनुपालन सुनिश्चित होता है और डेटा-आधारित निर्णय लेने में सहूलियत मिलती है।
डेटा कैटलॉग लागू करने के सर्वोत्तम तरीके
डेटा कैटलॉग के फ़ायदों का पूरा लाभ उठाने के लिए, संगठनों को ऐसे सर्वोत्तम तरीकों का पालन करना चाहिए जो प्रभावी अपनाने और उपयोग को सुनिश्चित करें। इस खंड में, हम आपके संगठन में डेटा कैटलॉग को सफलतापूर्वक लागू और बनाए रखने के लिए प्रमुख रणनीतियों का अन्वेषण करेंगे।
स्पष्ट उद्देश्यों से शुरुआत करें
क्या आप बिना गंतव्य तय किए रोड ट्रिप पर निकलेंगे? बिल्कुल नहीं। तो डेटा कैटलॉग के साथ भी ऐसा न करें। हो सकता है आप किसी दिलचस्प जगह पहुँच जाएँ, पर संभव है कि वह वह जगह न हो जहाँ आप जाना चाहते थे। यदि आपके डेटा कैटलॉग के लिए स्पष्ट उद्देश्य नहीं हैं, तो आप आँख मूँदकर नेविगेट कर रहे हैं – और यह नुस्ख़ा विफलता का है।
याद रखें: डेटा कैटलॉग एक औज़ार है। औज़ारों का काम आपकी ज़रूरतों को अधिक कुशलता से पूरा करना है। यदि आपकी ज़रूरतें स्पष्ट नहीं हैं, तो आप अपने औज़ार का सर्वोत्तम उपयोग नहीं कर पाएँगे।
उपयोगकर्ता अपनाने पर ध्यान दें
डेटा कैटलॉग इतना महँगा होता है कि वह कोने में धूल खाता रहे क्योंकि किसी को सच में इसका उपयोग करना न आता हो। लेकिन ऐसा अक्सर होता है। यदि उपयोगकर्ता इस टूल को नहीं अपनाते, तो यह बेकार है।
अपने डेटा कैटलॉग का अधिकतम लाभ लेने के लिए, सभी को साथ लाना ज़रूरी है। अपनी टीम को प्रशिक्षित करें, उन्हें कैटलॉग का मूल्य दिखाएँ, और सुनिश्चित करें कि यह उनके दैनिक कार्यप्रवाह में एकीकृत हो।
मेटाडेटा को नियमित रूप से अपडेट और मेंटेन करें
डेटा कैटलॉग की उपयोगिता बनाए रखने के लिए मेटाडेटा को अद्यतन रखना आवश्यक है। यदि आप इसे नियमित रूप से अपडेट और मेंटेन नहीं करते, तो यह पुराना और अविश्वसनीय हो जाता है, जिससे आपका डेटा कैटलॉग अप्रभावी बन जाता है। इसे कार की मेंटेनेंस जैसा समझें। क्या आप बिना नियमित ट्यून-अप और ऑयल चेंज के कार चलाएँगे? मेटाडेटा पर भी यही लागू होता है।
हितधारकों को प्रक्रिया में शामिल करें
सफल डेटा कैटलॉग बनाना एक अकेले व्यक्ति का काम नहीं है। आपके संगठन के सभी क्षेत्रों के हितधारकों को शामिल करना आवश्यक है ताकि कैटलॉग संबंधित सभी लोगों की ज़रूरतों को पूरा करे। शुरुआत से ही सभी हितधारकों की भागीदारी सुनिश्चित करती है कि कैटलॉग आपके संगठन के प्रत्येक समूह की विशिष्ट आवश्यकताओं को दर्शाए।
निष्कर्ष
डेटा कैटलॉग किसी संगठन के लिए डेटा की स्पष्टता, दक्षता, और अंतर्दृष्टि की खोज में एक गुप्त हथियार है। यह GPS की तरह है, जो आपको ठीक उसी समय वही जानकारी तक पहुँचाता है जिसकी आपको ज़रूरत है, वह भी बिना अनुमान के। लेकिन अन्य किसी शक्तिशाली औज़ार की तरह, इसकी सफलता इस बात पर निर्भर करती है कि इसे कैसे लागू किया जाता है।
यदि आप स्पष्ट उद्देश्यों से शुरुआत करते हैं, पूरी टीम को साथ लाते हैं, डेटा को ताज़ा रखते हैं, और शुरुआत से ही हितधारकों को शामिल करते हैं, तो आपका डेटा कैटलॉग एक अंतर्दृष्टि भंडार के रूप में काम करेगा।
याद रखें, लक्ष्य केवल डेटा इकट्ठा करना नहीं है; उसका पूरा सामर्थ्य खोलना है – और यदि आप इस लेख में साझा किए गए सर्वोत्तम तरीकों का पालन करते हैं, तो आपका डेटा कैटलॉग आपको इस लक्ष्य तक पहुँचने में मदद करेगा।
आगे की सीख के लिए, मैं अनुशंसा करता हूँ कि आप निम्न संसाधन देखें: