
大型语言模型(LLM)框架
随着 GPT-4 及其后续的 GPT-4o 推出,各方竞相研发大型语言模型,力图释放现代 AI 的全部潜力。构建智能 AI 应用需要向量数据库与集成框架来支持 LLM。
1. Qdrant
Qdrant 是一个开源的向量相似度搜索引擎和向量数据库,提供可用于生产的服务与便捷的 API,便于您存储、搜索和管理向量嵌入。
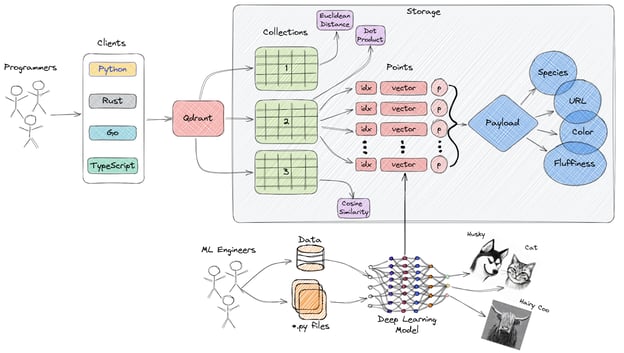
Qdrant 架构高层概览
关键特性:
- 易用的 API:提供易于使用的 Python API,并支持为多种编程语言生成客户端库。
- 快速且准确:采用对 HNSW 算法的自定义改造来进行近似最近邻搜索,在不牺牲准确性的前提下实现业界领先的搜索速度。
- 丰富的数据类型:Qdrant 支持多种数据类型和查询条件,包括字符串匹配、数值范围、地理位置等。
- 分布式:云原生,可水平扩展,让开发者能为任意规模的数据灵活配置恰当的计算资源。
- 高效:Qdrant 完全使用 Rust 开发,以其高性能与资源效率著称。
阅读5 大最佳向量数据库 | 清单与示例,发现顶级向量数据库。
2. LangChain
LangChain 是一个多功能且强大的框架,用于开发由语言模型驱动的应用。它提供多个组件,帮助开发者构建、部署与监控具备上下文感知与推理能力的应用。
该框架包含 4 个主要组件:
- LangChain 库:Python 与 JavaScript 库提供接口与集成,助您开发上下文感知的推理应用。
- LangChain 模板:一组易于部署的参考架构,覆盖多种任务,为开发者提供预构建解决方案。
- LangServe:该库支持将 LangChain 的链部署为 REST API。
- LangSmith:一个平台,可用于调试、测试、评估和监控基于任意 LLM 框架构建的链。
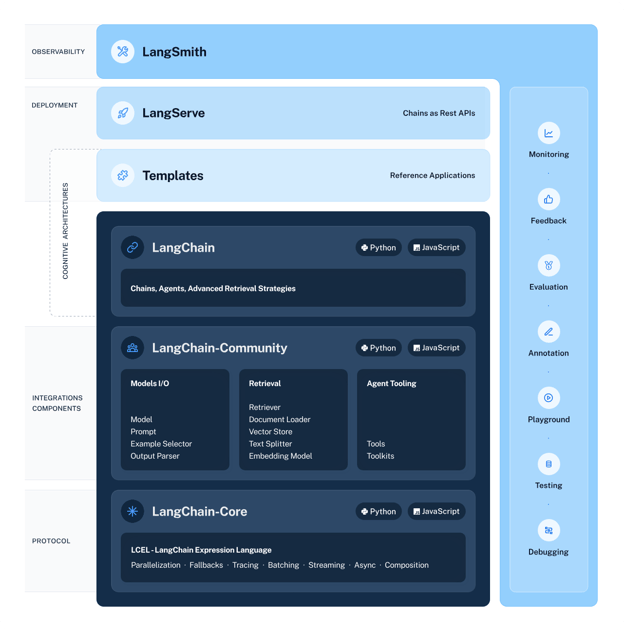
LangChain 生态
学习如何使用 LangChain 构建 LLM 应用,发掘大型语言模型的潜能。
实验追踪与模型元数据管理工具
这些工具可用于管理模型元数据并辅助实验追踪:
3. MLFlow
MLflow 是一个开源工具,帮助您管理机器学习生命周期的核心环节。它通常用于实验追踪,也可用于可复现性、部署与模型注册。您可以通过 CLI、Python、R、Java 和 REST API 管理机器学习实验与模型元数据。
MLflow 包含四大核心功能:
- MLflow tracking:存储与访问代码、数据、配置与结果。
- MLflow projects:封装数据科学源码以实现可复现性。
- MLflow models:在多种服务环境中部署与管理机器学习模型。
- MLflow model registry:集中式模型库,提供版本管理、阶段流转、注释及模型管理功能。
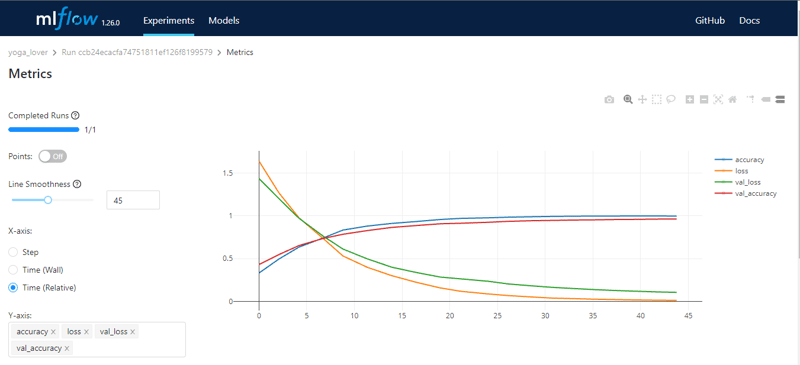
图片由作者提供
4. Comet ML
Comet ML 是一个用于追踪、比较、解释与优化机器学习模型和实验的平台。您可以将其与任意机器学习库配合使用,如 Scikit-learn、Pytorch、TensorFlow 和 HuggingFace。
Comet ML 适用于个人、团队、企业与学术用户。它让任何人都能轻松可视化并比较实验。此外,它还能可视化图像、音频、文本与表格数据的样本。
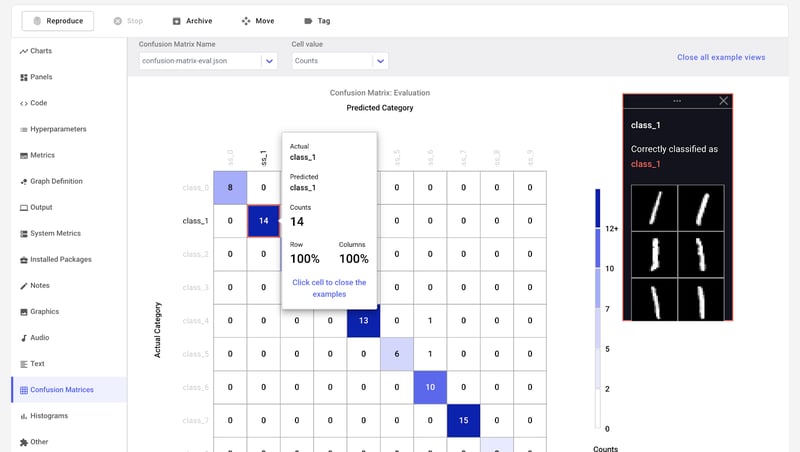
图片来自 Comet ML
5. Weights & Biases
Weights & Biases 是一个用于实验追踪、数据与模型版本管理、超参数优化与模型管理的 ML 平台。此外,您可以用它来记录制品(数据集、模型、依赖、流水线与结果)并可视化数据集(音频、视觉、文本与表格)。
Weights & Biases 提供用户友好的集中式机器学习实验看板。与 Comet ML 类似,您可以将其与 Fastai、Keras、PyTorch、Hugging face、Yolov5、Spacy 等众多机器学习库集成。您可以查看我们的Weights & BIases 入门介绍一文。

动图来自 Weights & Biases
注:您也可以使用 TensorBoard、Pachyderm、DagsHub 和 DVC Studio 进行实验追踪与 ML 元数据管理。
编排与工作流流水线 MLOps 工具
这些工具帮助您创建数据科学项目并管理机器学习工作流:
6. Prefect
Prefect 是一套现代数据栈,用于在应用之间及跨应用监控、协调与编排工作流。它是开源、轻量的工具,适用于端到端的机器学习流水线。
您可以使用 Prefect Orion UI 或 Prefect Cloud 作为数据库端。
- Prefect Orion UI 是开源的本地托管编排引擎与 API 服务器。它为您提供对本地 Prefect Orion 实例与工作流的洞察。
- Prefect Cloud 是托管服务,用于可视化流程、流程运行与部署。此外,您还可以管理账户、工作区与团队协作。
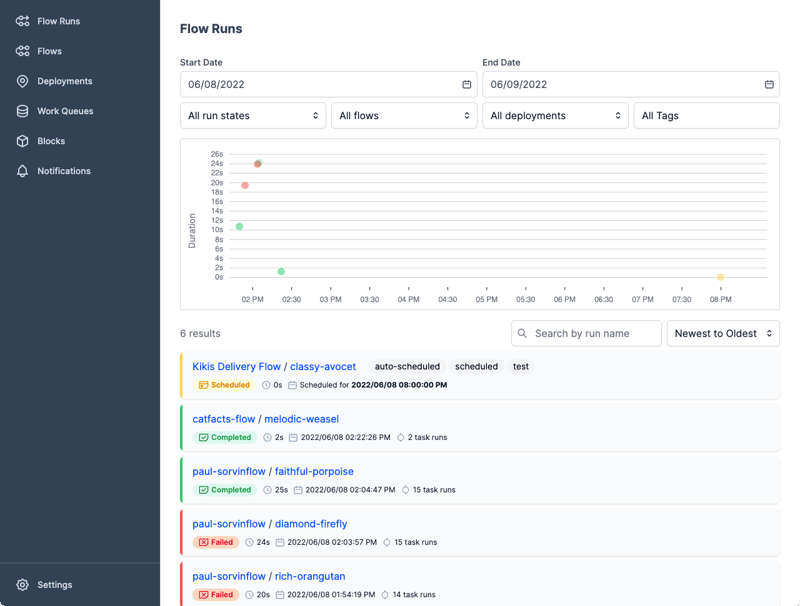
图片来自 Prefect
7. Metaflow
Metaflow 是一款强大且久经考验的工作流管理工具,面向数据科学与机器学习项目。它为数据科学家而建,让他们专注于构建模型,而无需为 MLOps 工程操心。
借助 Metaflow,您可以设计工作流、按规模运行并在生产中部署模型。它会自动追踪与版本化机器学习实验和数据。此外,您还可以在笔记本中可视化结果。
Metaflow 支持多家云(包括 AWS、GCP 与 Azure)与多种机器学习 Python 包(如 Scikit-learn 与 Tensorflow),同时也提供 R 语言的 API。
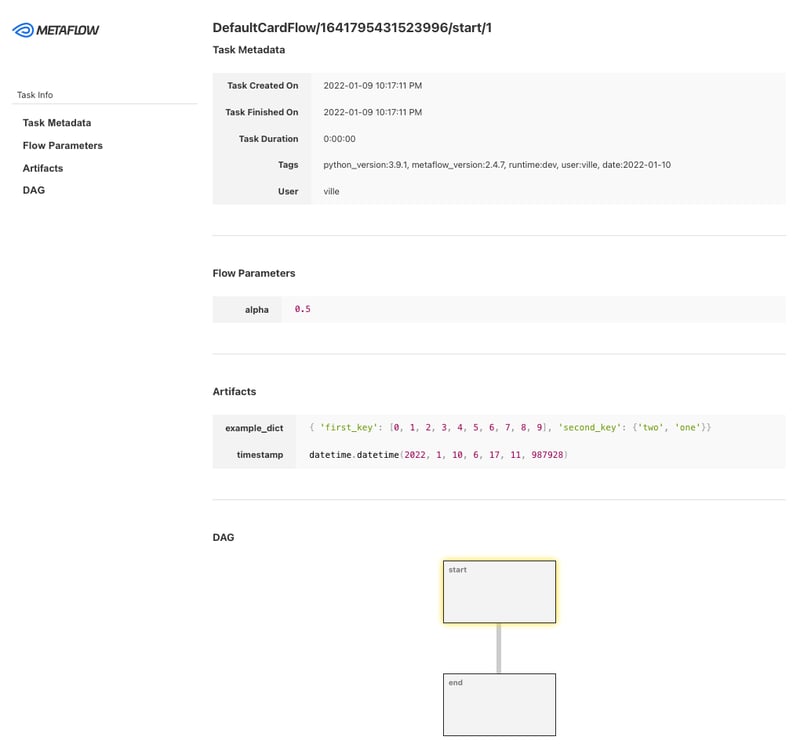
图片来自 Metaflow
8. Kedro
Kedro 是基于 Python 的工作流编排工具。您可以用它创建可复现、可维护且模块化的数据科学项目。它将软件工程的理念(如模块化、关注点分离与版本管理)引入机器学习。
使用 Kedro,您可以:
- 设置依赖与配置。
- 配置数据。
- 创建、可视化并运行流水线。
- 记录日志与进行实验追踪。
- 在单机或分布式环境中部署。
- 编写可维护的数据科学代码。
- 创建模块化、可复用的代码。
- 与团队成员协作完成项目。

动图来自 Kedro
注:您也可以使用 Kubeflow 和 DVC 进行编排与工作流流水线管理。
数据与流水线版本管理工具
借助这些 MLOps 工具,您可以处理数据与流水线版本管理相关的任务:
9. Pachyderm
Pachyderm 基于 Kubernetes 实现数据版本管理、血缘追踪与端到端流水线,自动化数据转换。您可以集成任意数据(图像、日志、视频、CSV)、任意语言(Python、R、SQL、C/C++),并支持任意规模(PB 级数据、上千个作业)。
社区版是开源的,适合小团队使用。希望获得高级功能的组织与团队可选择企业版。
与 Git 类似,您可以用相近的语法对数据进行版本管理。在 Pachyderm 中,最高层对象是 Repository,您可以使用 Commit、Branches、File、History 和 Provenance 来追踪与版本化数据集。
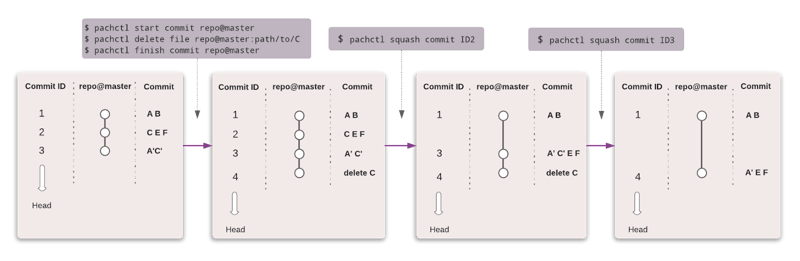
图片来自 Pachyderm
10. Data Version Control (DVC)
Data Version Control 是一款开源且广受欢迎的机器学习项目工具。它与 Git 无缝协作,为您提供代码、数据、模型、元数据与流水线的版本管理。
DVC 不只是数据追踪与版本管理工具。
您可以将其用于:
- 实验追踪(模型指标、参数、版本管理)。
- 创建、可视化并运行机器学习流水线。
- 用于部署与协作的工作流。
- 可复现性。
- 数据与模型注册。
- 借助 CML 实现机器学习的持续集成与部署。
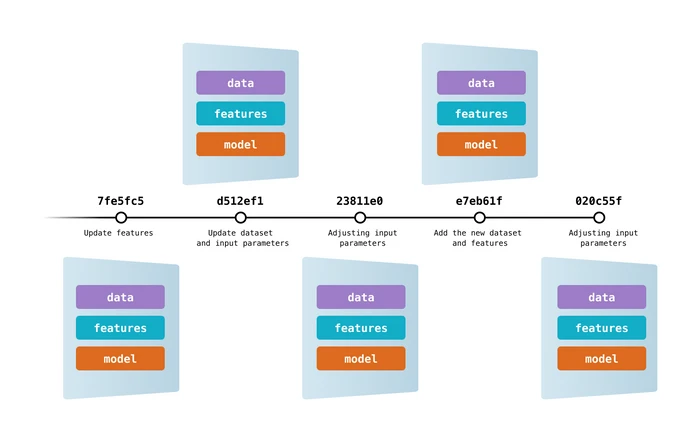
图片来自 DVC
注:DagsHub 也可用于数据与流水线版本管理。
11. LakeFS
LakeFS 是一款开源、可扩展的数据版本管理工具,为对象存储提供类 Git 的版本控制界面,使用户能够像管理代码一样管理数据湖。借助 LakeFS,用户可以在 EB 级规模上进行数据版本管理,对于管理大型数据湖而言具有极高的可扩展性。
附加能力:
- 在任意存储服务之上执行分支、提交与合并等 Git 操作
- 零拷贝分支带来无阻碍的实验与便捷协作,加速开发
- 使用预提交与合并钩子启用 CI/CD 工作流,确保流程清晰
- 具备回滚能力的高弹性平台,可更快从数据问题中恢复。
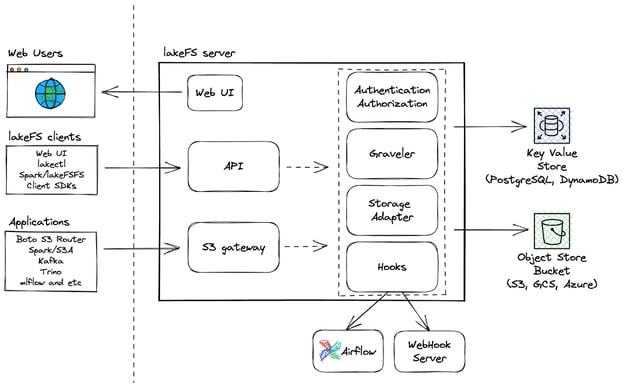
LakeFS 架构
特征库
特征库是集中式存储库,用于在生产与训练阶段存储、版本管理、管理与服务特征(用于训练机器学习模型的处理后数据属性)。
12. Feast
Feast 是一个开源特征库,帮助机器学习团队将实时模型投入生产,并构建促进工程师与数据科学家协作的特征平台。
关键特性:
- 管理离线存储、低延迟在线存储和特征服务器,确保训练与服务阶段特征的一致可用性。
- 通过创建准确的时点特征集来避免数据泄漏,免去数据科学家处理易出错数据集连接的烦恼。
- 通过单一访问层将 ML 与数据基础设施解耦。
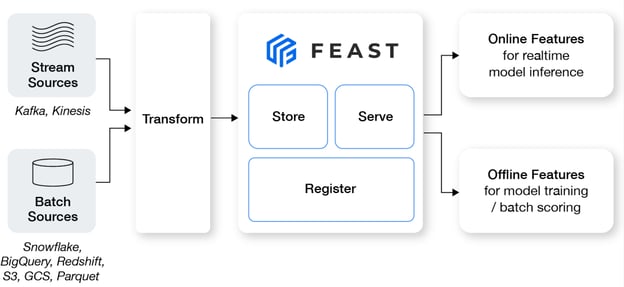
图片来自 Feast
13. Featureform
Featureform 是一个虚拟特征库,使数据科学家能够定义、管理并服务其 ML 模型特征。它可帮助数据科学团队加强协作、组织实验、促进部署、提升可靠性并保障合规。
关键特性:
- 通过在团队内共享、复用与理解特征来增强协作。
- 当您的特征准备好部署时,Featureform 将编排您的数据基础设施,使其具备生产就绪能力。
- 系统确保无法修改任何特征、标签或训练集,从而提升可靠性。
- 借助内置的基于角色的访问控制、审计日志与动态服务规则,Featureform 可直接执行您的合规逻辑。
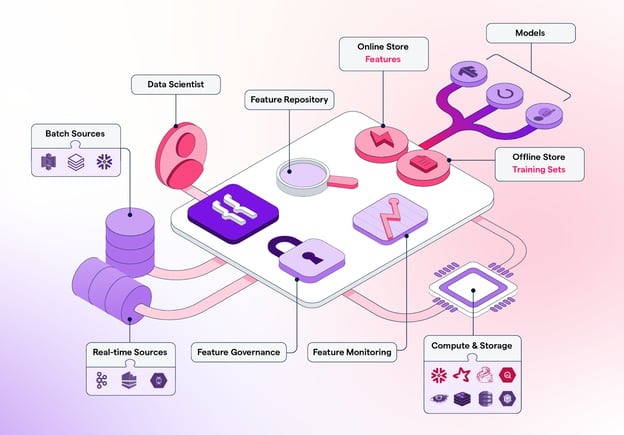
图片来自 Featureform
模型测试
借助这些 MLOps 工具,您可以测试模型质量,确保机器学习模型的可靠性、鲁棒性与准确性:
14. Deepchecks ML Models Testing
Deepchecks 是一款开源解决方案,满足您在研究到生产各阶段的 ML 验证需求,确保数据与模型得到充分测试。它通过多个组件提供对数据与模型的整体性验证。
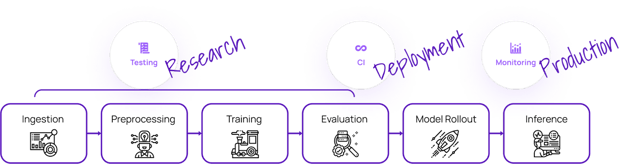
图片来自 Deepchecks
Deepchecks 由三个组件组成:
- Deepchecks testing:可为表格、自然语言处理与计算机视觉验证构建自定义检查与套件。
- CI 与测试管理:提供 CI 与测试管理,帮助您与团队协作并高效管理测试结果。
- Deepchecks monitoring:在生产环境中追踪并验证模型。
15. TruEra
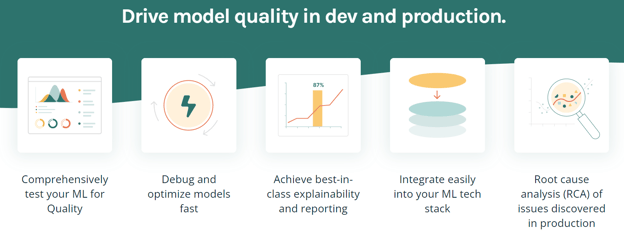
TruEra 是一个先进平台,通过自动化测试、可解释性与根因分析来驱动模型质量与性能。它提供多种功能,帮助优化与调试模型,实现一流的可解释性,并轻松集成到您的 ML 技术栈中。
关键特性:
- 模型测试与调试功能可在开发与生产阶段提升模型质量。
- 可执行自动化与系统化测试,确保性能、稳定性与公平性。
- 理解模型版本的演进,从而提炼洞察,指导更快更高效的模型开发。
- 识别并定位导致模型偏差的具体特征。
- TruEra 可轻松集成至您当前的基础设施与工作流。
图片来自 TruEra
模型部署与服务工具
在模型部署方面,这些 MLOps 工具能发挥巨大作用:
16. Kubeflow
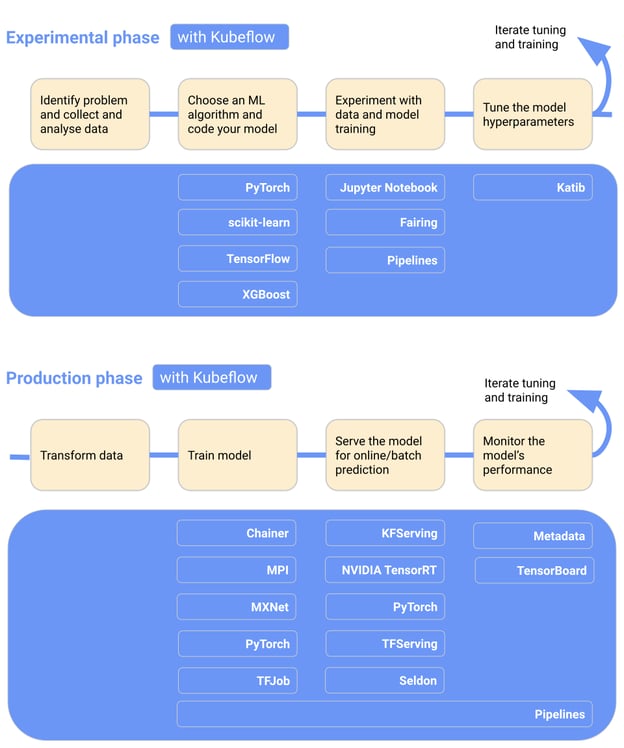
Kubeflow 让在 Kubernetes 上部署机器学习模型变得简单、可移植且可扩展。您可以用它进行数据准备、模型训练、模型优化、预测服务,并在生产中监控模型性能。您可将机器学习工作流部署在本地、私有环境或云端。简言之,它让数据科学团队更易用好 Kubernetes。
关键特性:
- 带有交互式 UI 的集中式看板。
- 用于可复现与流程化的机器学习流水线。
- 原生支持 JupyterLab、RStudio 与 Visual Studio Code。
- 超参数调优与神经架构搜索。
- 支持 Tensorflow、Pytorch、PaddlePaddle、MXNet 与 XGboost 的训练作业。
- 作业调度。
- 为管理员提供多用户隔离。
- 适配所有主流云服务商。
图片来自 Kubeflow
10. BentoML
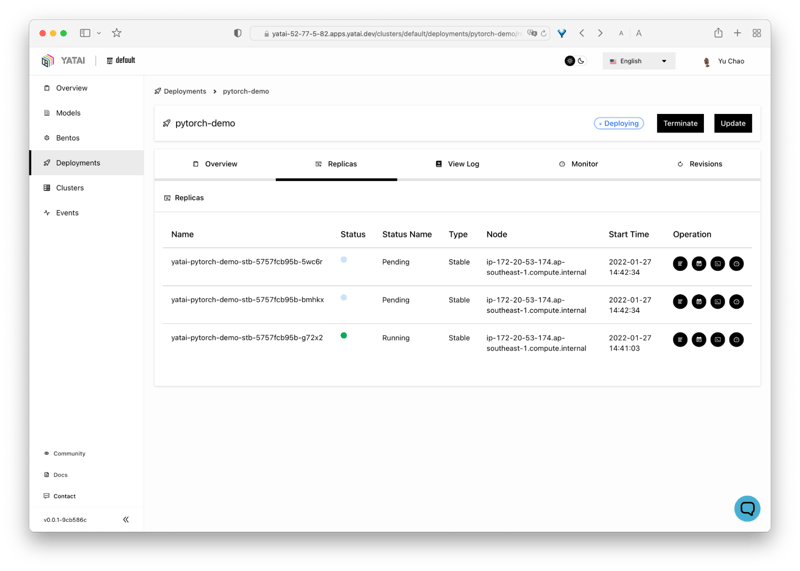
BentoML 让机器学习应用的交付更简单、更快速。它是一个以 Python 为先的工具,用于在生产中部署与维护 API。通过并行推理与自适应批处理等强大优化实现扩展,并提供硬件加速。
BentoML 的交互式集中看板让部署机器学习模型时的组织与监控变得轻松。最大优点是它适配各种机器学习框架,如 Keras、ONNX、LightGBM、Pytorch 与 Scikit-learn。简言之,BentoML 为模型部署、服务与监控提供了完整方案。
图片来自 BentoML
18. Hugging Face Inference Endpoints
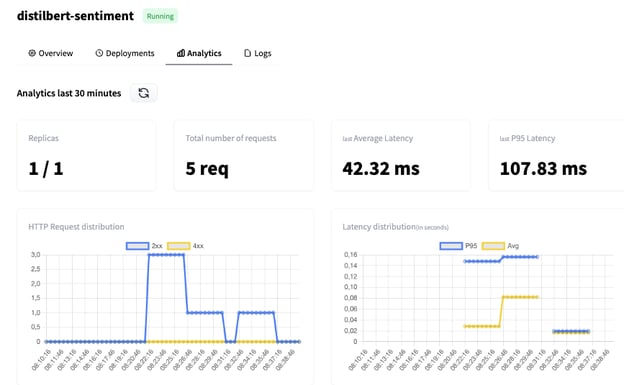
Hugging Face Inference Endpoints 是 Hugging Face 提供的云端服务。Hugging Face 是一体化 ML 平台,支持训练、托管与共享模型、数据集与演示。这些端点旨在帮助用户将已训练的机器学习模型部署用于推理,而无需自建与管理所需的基础设施。
关键特性:
- 根据您的需求,将成本控制在每 CPU core/小时 $0.06、每 GPU/小时 $0.6 起。
- 数秒内即可轻松部署。
- 全托管与自动伸缩。
- Hugging Face 生态的一部分。
- 企业级安全。
图片来自 Hugging Face
注:您也可以使用 MLflow 与 AWS SageMaker 进行模型部署与服务。
生产环境模型监控 MLOps 工具
无论您的 ML 模型处于开发、验证阶段,还是已部署到生产,这些工具都能帮助您监控多种因素:
19. Evidently
Evidently AI 是一个开源 Python 库,用于在开发、验证和生产阶段监控 ML 模型。它会检查数据与模型质量、数据漂移、目标漂移,以及回归与分类性能。
Evidently 有三大组件:
- Tests(批量模型检查):用于执行结构化数据与模型质量检查。
- Reports(交互式仪表板):交互式数据漂移、模型性能与目标可视化。
- Monitors(实时监控):监控已部署 ML 服务的数据与模型指标。
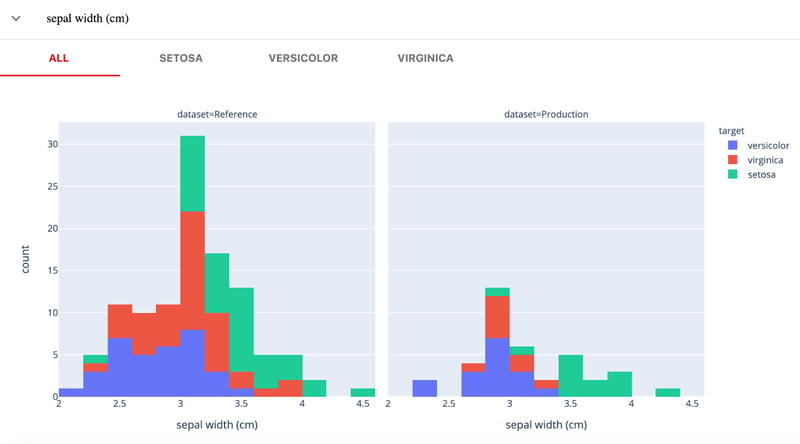
图片来自 Evidently
20. Fiddler
Fiddler AI 是一款具备简洁易用 UI 的 ML 模型监控工具。它可帮助您解释与调试预测、分析整个数据集上的模型行为、规模化部署机器学习模型并监控模型性能。
让我们看看 Fiddler AI 在 ML 监控方面的主要功能:
- 性能监控:深入可视化数据漂移、漂移发生的时间与方式。
- 数据完整性:避免将不正确的数据用于模型训练。
- 异常点追踪:展示单变量与多变量异常点。
- 服务指标:展示 ML 服务运行的基础洞察。
- 告警:为单个或一组模型设置告警,提示生产中的问题。
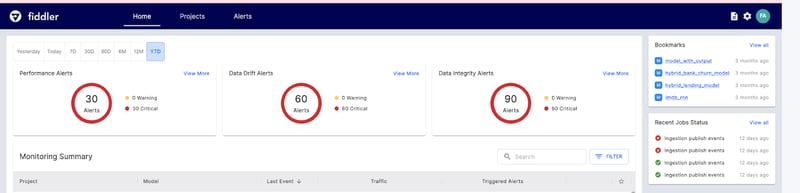
图片来自 Fiddler
运行时引擎
运行时引擎负责加载模型、对输入数据进行预处理、执行推理,并将结果返回给客户端应用。
21. Ray
Ray 是一个多功能框架,旨在扩展 AI 与 Python 应用,便于开发者管理与优化其机器学习项目。
该平台由两个主要组件构成:核心分布式运行时,以及一组面向简化 ML 计算的 AI 库。
Ray Core 提供一组有限但基础的元素,可用于构建与扩展分布式应用。
- Tasks 是无状态函数,在集群内执行。
- Actors 是有状态的工作进程,在集群内创建。
- Objects 是不可变值,可被集群内任一组件访问。
Ray 还提供用于可扩展数据集、分布式训练、超参数调优、强化学习以及可扩展与可编程服务的 AI 库。
以下示例演示了梯度提升分类器模型的训练与服务。
import requests
from starlette.requests import Request
from typing import Dict
from sklearn.datasets import load_iris
from sklearn.ensemble import GradientBoostingClassifier
from ray import serve
# Train model.
iris_dataset = load_iris()
model = GradientBoostingClassifier()
model.fit(iris_dataset["data"], iris_dataset["target"])
@serve.deployment
class BoostingModel:
def __init__(self, model):
self.model = model
self.label_list = iris_dataset["target_names"].tolist()
async def __call__(self, request: Request) -> Dict:
payload = (await request.json())["vector"]
print(f"Received http request with data {payload}")
prediction = self.model.predict([payload])[0]
human_name = self.label_list[prediction]
return {"result": human_name}
# Deploy model.
serve.run(BoostingModel.bind(model), route_prefix="/iris")22. Nuclio
Nuclio 是一个专注于数据、I/O 与计算密集型工作负载的强大框架。它采用无服务器设计,您无需管理服务器。Nuclio 与 Jupyter 和 Kubeflow 等主流数据科学工具集成良好,同时支持多种数据与流式来源,并可在 CPU 与 GPU 上运行。
关键特性:
- 在最大化并行度的同时,仅需最少的 CPU/GPU 与 I/O 资源即可进行实时处理。
- 可与广泛的数据源与 ML 框架集成。
- 提供具备数据路径加速的有状态函数
- 在各类设备与云平台间具备可移植性,尤其适用于低功耗设备。
- 面向企业设计。
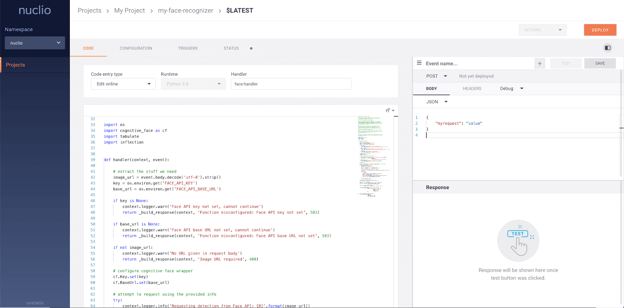
图片来自 Nuclio
端到端 MLOps 平台
如果您在寻找贯穿全流程的综合性 MLOps 工具,以下是一些最佳选择:
23. AWS SageMaker
Amazon Web Services SageMaker 是一站式 MLOps 解决方案。您可以进行模型训练与加速开发、追踪与版本化实验、编目 ML 制品、集成 CI/CD ML 流水线,并在生产中无缝部署、服务与监控模型。
关键特性:
- 面向数据科学团队的协作环境。
- 自动化 ML 训练工作流。
- 在生产中部署与管理模型。
- 追踪与维护模型版本。
- 用于自动集成与部署的 CI/CD。
- 持续监控并重新训练模型以维持质量。
- 优化成本与性能。
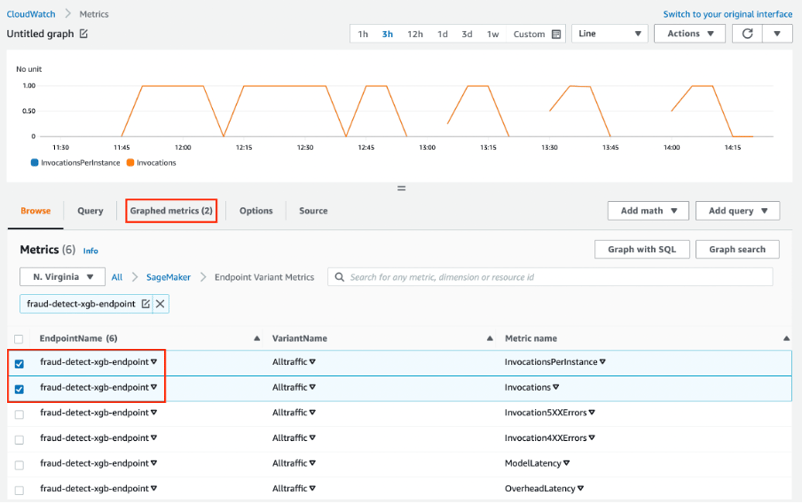
图片来自 Amazon SageMaker
24. DagsHub
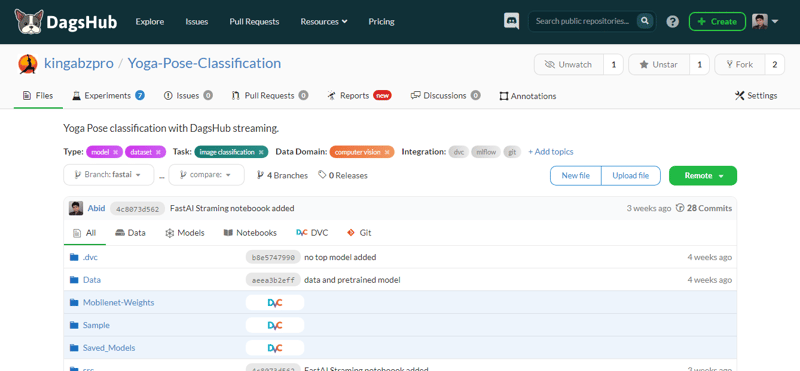
DagsHub 是为机器学习社区打造的平台,用于追踪与版本化数据、模型、实验、ML 流水线与代码。它让您的团队能够构建、评审并共享机器学习项目。
简单来说,它是机器学习领域的 GitHub,您将获得多种工具来优化端到端的机器学习流程。
关键特性:
- 为您的 ML 项目提供 Git 与 DVC 仓库。
- 用于实验追踪的 DagsHub logger 与 MLflow 实例。
- 通过 Label Studio 实例进行数据集标注。
- 对 Jupyter 笔记本、代码、数据集与图像进行差异比对。
- 可对文件、代码行或数据集进行评论。
- 像 GitHub Wiki 一样为项目创建报告。
- ML 流水线可视化。
- 结果可复现。
- 运行用于模型训练与部署的 CI/CD。
- 数据合并。
- 提供与 GitHub、Google Colab、DVC、Jenkins、外部存储、webhooks 与 New Relic 的集成。
图片由作者提供
25. Iguazio MLOps Platform
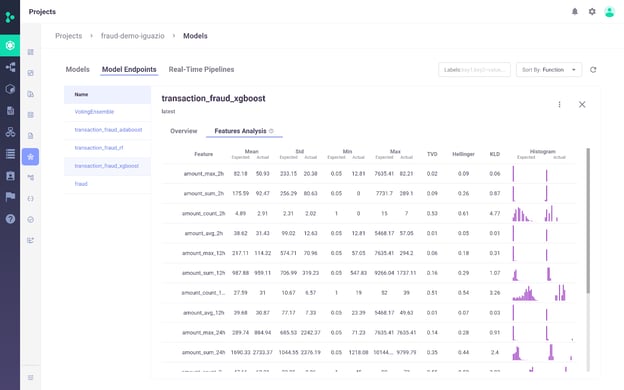
Iguazio MLOps Platform 是一款端到端 MLOps 平台,帮助组织将机器学习流水线从数据采集与准备自动化到训练、部署与生产监控。它提供开放(MLRun)与托管平台。
Iguazio MLOps Platform 的一大差异化优势在于其灵活的部署选项。用户可在任意位置部署 AI 应用,包括任意云、混合或本地环境。这对医疗与金融等行业尤为重要,因为数据隐私要求可能使本地部署成为刚需。
图片来自 Iguazio MLOps Platform
关键特性:
- 平台支持从任意来源摄取数据,并借助集成特征库构建可复用的在线与离线特征。
- 通过可扩展的无服务器架构,持续训练与评估大规模模型,并实现自动追踪、数据版本管理与持续集成/部署。
- 仅需数次点击即可轻松将模型部署到生产,持续监控模型性能并缓解模型漂移。
- 平台配有简洁的看板,用于管理、治理与监控模型和实时生产环境。
MLOps 工具总览
下面的对比表可帮助您将这些工具并排评估,从而为项目挑选最佳方案:
| Tool | Main functionality | Supported frameworks | Deployment options |
|---|---|---|---|
| Qdrant | 向量相似度搜索与数据库管理 | Python,多种语言 | 云原生,水平可扩展 |
| LangChain | 用语言模型开发应用 | Python、JavaScript | REST API、模板 |
| MLFlow | 实验追踪、模型注册、部署 | Python、R、Java、REST API | 本地、云端 |
| Comet ML | 实验追踪与优化 | Scikit-learn、PyTorch、TensorFlow、HuggingFace | 本地、云端 |
| Weights & Biases | 实验追踪、数据与模型版本管理 | Fastai、Keras、PyTorch、HuggingFace、Yolov5、Spacy | 本地、云端 |
| Prefect | 工作流编排与监控 | Python | 本地(Orion UI)、云端 |
| Metaflow | 数据科学工作流管理 | Scikit-learn、TensorFlow、Python、R | AWS、GCP、Azure、本地 |
| Kedro | 工作流编排、可复现性 | Python | 本地、分布式 |
| Pachyderm | 数据转换、版本管理与血缘 | 任意语言 | Kubernetes |
| DVC | 数据与流水线版本管理 | Git、Python | 本地、云端 |
| LakeFS | 数据湖的类 Git 版本控制 | 任意存储服务 | 本地、云端 |
| Feast | 面向 ML 模型的集中式特征库 | Python | 本地、云端 |
| Featureform | 面向 ML 模型的虚拟特征库 | Python | 本地、云端 |
| Deepchecks | ML 模型测试与验证 | Python | 本地、云端 |
| TruEra | 模型质量与性能测试 | Python | 本地、云端 |
| Kubeflow | ML 模型部署与编排 | TensorFlow、PyTorch、PaddlePaddle、MXNet、XGboost | Kubernetes、云端 |
| BentoML | 模型部署与 API 管理 | Keras、ONNX、LightGBM、PyTorch、Scikit-learn | 本地、云端 |
| Hugging Face | 推理与模型部署 | 任意模型 | 云端 |
| Evidently | 监控数据与目标漂移的 ML 模型 | Python | 本地、云端 |
| Fiddler | ML 模型监控与调试 | Python | 本地、云端 |
| Ray | 扩展 AI 与 Python 应用 | Python | 本地、云端 |
| Nuclio | 面向数据与计算密集型负载的无服务器框架 | Jupyter、Kubeflow | 云端、本地部署 |
| AWS SageMaker | 端到端 ML 全生命周期管理 | Python、R、Java、TensorFlow、PyTorch | AWS 云 |
| DagsHub | ML 项目的版本管理与协作 | Git、DVC、MLflow | 本地、云端 |
| Iguazio | ML 流水线的端到端自动化 | Python、MLRun | 云端、混合、本地 |
结语
我们正处于 MLOps 行业蓬勃发展的时期。几乎每周都有新进展、新创企与新工具发布,致力于解决将笔记本转化为生产级应用的基本难题。即便是现有工具,也在不断拓展边界并集成新功能,向“超强 MLOps 工具”演进。
在本文中,我们了解了 MLOps 流程各环节的优秀工具。这些工具将在实验、开发、部署与监控阶段助您一臂之力。
如果您刚接触机器学习,并希望掌握必要技能以胜任机器学习科学家岗位,建议学习我们的Python 机器学习科学家职业路径。
如果您已是从业者并希望进一步了解标准的 MLOps 实践,请阅读我们的MLOps 最佳实践及其应用,并查看我们的MLOps 基础技能路径。
MLOps 工具常见问题
什么是 MLOps 工具?
MLOps 工具有助于标准化、简化并优化 ML 生态。这些工具用于实验追踪、模型元数据管理、编排、模型优化、工作流版本管理、模型部署与服务,以及生产环境中的模型监控。
成为 MLOps 工程师需要哪些技能?
- 具备实现云端解决方案的能力。
- 具备 Docker 与 Kubernetes 经验。
- 具备用实验追踪与工作流版本管理开展质量保障的经验。
- 具备构建 MLOps 流水线的能力。
- 熟悉 Linux 操作系统。
- 具备 PyTorch、Tensorflow 与 TFX 等 ML 框架经验。
- 具备 DevOps 与软件开发经验。
- 具备单元与集成测试、数据与模型验证,以及部署后监控的经验。
哪个云更适合做 MLOps?
AWS、GCP 与 Azure 为机器学习生命周期提供多样工具,它们都提供端到端的 MLOps 解决方案。就受欢迎程度与市场份额而言,AWS 略胜一筹。同时它也为模型训练、服务与监控提供了简便方案。
MLOps 容易学吗?
这取决于您的既有经验。要掌握 MLOps,您需要学习机器学习与软件开发生命周期。除需具备扎实的编程能力外,您还需要学习多种 MLOps 工具。对于 DevOps 工程师而言,学习 MLOps 更容易一些,因为多数工具与策略源自软件开发。
Kubeflow 比 MLflow 更好吗?
取决于使用场景。由于负责编排,Kubeflow 在更大范围内提供可复现性。
- Kubeflow 通常用于规模化部署与管理复杂 ML 系统。
- MLFlow 通常用于 ML 实验追踪,以及存储与管理模型元数据。
MLOps 与 DevOps 有何不同?
二者都是软件开发策略。DevOps 侧重于开发与管理大规模软件系统,而 MLOps 侧重于在生产环境中部署与维护机器学习模型。
- DevOps: 持续集成(CI)与持续交付(CD)。
- MLOps: 持续集成、持续交付、持续训练与持续监控。
MLOps 工具如何与现有数据科学工作流集成?
MLOps 工具旨在与现有数据科学工作流无缝集成。它们通常支持多种数据科学工具与平台、提供用于集成的 API,并为常见数据科学环境提供插件或扩展。借助这些集成,数据科学家可在保持现有工作流的同时,利用 MLOps 带来的更强可扩展性、可复现性与部署效率。
MLOps 工具能帮助提升模型的可解释性与公平性吗?
是的,许多 MLOps 工具包含提升模型可解释性与公平性的功能。它们提供模型解释、偏差检测与公平性指标等能力,帮助理解与改进模型的决策方式。这对于负责任地部署 AI 并遵循合规要求至关重要。
我可以考取 MLOps 认证吗?
MLOps 专项认证仍在逐步涌现,但已有多种面向机器学习与数据科学的认证涵盖 MLOps 技能。请阅读我们的MLOps 认证指南获取详细解析。

作为一名持证的数据科学家,我热衷于利用前沿技术打造创新的机器学习应用。凭借在语音识别、数据分析与报告、MLOps、对话式人工智能以及自然语言处理方面的扎实背景,我不断打磨构建智能系统的能力,力求带来切实影响。除技术专长外,我也擅长沟通,能够将复杂概念提炼为清晰、简明的表述。因此,我成为数据科学领域备受关注的博主,与不断壮大的数据专业人士社区分享洞见与实践经验。目前,我专注于内容创作与编辑,借助大语言模型打造有力且吸引人的内容,帮助企业与个人更好地发挥数据价值。
正如我们在MLOps 入门一文中所探讨的,MLOps 构建在 DevOps 的基础之上——这是一种高效编写、部署和运行企业级应用的软件开发策略。
它是一种用于大规模管理机器学习项目的方法。MLOps 加强了开发、运维与数据科学团队之间的协作。因此,您将获得更快的模型部署、优化的团队生产力、更低的风险和成本,以及在生产环境中的持续模型监控。
阅读我们的博文MLOps 的过去、现在与未来,了解为什么 MLOps 很重要以及它旨在解决哪些问题。
在本文中,我们将了解用于模型开发、部署和监控的最佳 MLOps 工具,以标准化、简化并优化机器学习生态。想要系统入门 MLOps 基础,请查看我们的技能路径。