
Kurs
Software Development with Claude Code
4 Std.
8.8K
Update (1. Juli 2026): Der Zugriff auf Claude Fable 5 wurde wiederhergestellt und ist jetzt weltweit auf Claude Platform, Claude.ai, Claude Code und Claude Cowork verfügbar, nachdem die Exportbeschränkung aufgehoben wurde. Mythos 5 bleibt auf geprüfte Project-Glasswing-Partner beschränkt.
Update (2. September 2026): Anthropic hat den Nachfolger des Modells veröffentlicht. Lies alles dazu in unserem Claude Fable 5.1 Guide und unserem Claude Fable 5.1 API-Tutorial.
Erstmals hörten wir im April von Claude Mythos, als wir über den Release von Claude Opus 4.7 schrieben. Schon damals war klar: Opus 4.7 ist zwar für sich genommen äußerst beeindruckend, aber nur deshalb das beste öffentlich verfügbare Modell, weil die Mythos-Klassenmodelle nicht breit ausgerollt wurden.
Jetzt liefert Anthropic mit Claude Fable 5 ein Mythos-Klassenmodell, das für den allgemeinen Einsatz ausreichend abgesichert ist. Es ist klar der neue Spitzenreiter bei den wichtigsten Benchmarks – von Wissensarbeit über Software Engineering bis zur wissenschaftlichen Forschung. Ein großer Erfolg für Anthropic, das erst vor acht Tagen den Antrag für einen US-Börsengang eingereicht hat.
In diesem Artikel schauen wir uns Claude Fable 5 genau an: wie es im Vergleich zu anderen Modellen wie GPT-5.5 und Gemini 3.1 Pro abschneidet sowie zu Claude-eigenen Modellen wie Opus 4.8. Außerdem geben wir Hinweise, wann sich das Modell lohnt – denn es ist teurer. Wenn du neu bei Claude bist und schnell einsteigen willst, empfehle ich unseren Leitfaden zum Lernen mit Claude.
Claude Fable 5 ist der Name für Anthropics neuestes und leistungsstärkstes Modell. Es gehört zur Mythos-Klasse, bringt aber wichtige Schutzmechanismen mit – insbesondere bei Cybersicherheit.
Für dich als Nutzer bedeutet das: Bestimmte Anfragen werden vom nächstniedrigeren Modell, Claude Opus 4.8, beantwortet. Anthropic schätzt, dass dieses Umleiten bei weniger als 5% aller Anfragen passiert – eher konservativ gerechnet. Angesichts der Sicherheitsthemen ist das sinnvoll. Und natürlich hängt die Quote stark davon ab, welche Art von Arbeit du erledigst.
Wir sind besonders gespannt auf Claude Fable 5. Das Modell ist so leistungsfähig, dass es neue Anwendungsfelder erschließt: Cyberabwehr-Teams können kritische Systeme härten, Life-Science-Forschende neue Therapeutika verbessern. Astrophysiker kartieren Galaxien. Und so weiter.
Falls du es im Release gelesen hast: Claude Mythos 5 wird ebenfalls erwähnt. Zur Einordnung: Claude Mythos 5 ist dasselbe Grundmodell, allerdings mit gelockerten Schutzmechanismen. Es ist nicht für die breite Nutzung gedacht, sondern im Rahmen von Project Glasswing in Partnerschaft mit der US-Regierung im Einsatz und ersetzt effektiv Claude Mythos Preview. Über Claude Mythos 5 wissen wir weniger, aber klar ist: Es hat die stärksten Cybersecurity-Fähigkeiten aller Modelle weltweit – die Partnerschaft spricht für sich.
Fable 5 bringt spürbare Verbesserungen bei Sicherheit, Transparenz, Speicher und Datenhandhabung.
Die größte strukturelle Neuerung in Fable 5 ist ein zweistufiges Klassifiziersystem, das den Missbrauch der gefährlichsten Fähigkeiten des Modells verhindern soll. Eine Probe überwacht die internen Aktivierungen des Modells über den gesamten Traffic. Markierte Anfragen werden an einen separaten, trainierten LLM-Klassifizierer eskaliert, der die finale Entscheidung trifft. Wird eine Anfrage blockiert, leitet das System sie an Opus 4.8 um, statt sie komplett abzulehnen – so bekommst du trotzdem eine hilfreiche Antwort.
Ähnlich wie oben: Wenn die Klassifizierer von Fable 5 eine Anfrage an Opus 4.8 umleiten, wirst du darüber informiert, welches Modell geantwortet hat. Diese neue Transparenz sorgt dafür, dass du nicht rätseln musst, falls sich eine Antwort anders anfühlt.
Fable 5 kann mitten in einer Aufgabe Notizen in eine Datei schreiben und später darauf zurückgreifen – anders als nur ein großes Kontextfenster. Das ist ein aktiver Arbeitsspeicher. In Anthropics eigenen Tests verbesserte das die Leistung deutlich stärker als bei Opus 4.8.
Anthropic führt für sämtlichen Fable-5-Traffic eine neue Datenaufbewahrungsrichtlinie ein. Daten werden 30 Tage vorgehalten, um neue Jailbreaks zu erkennen und Fehlalarme zu reduzieren. Laut Anthropic werden diese Daten nicht zum Training verwendet, und menschliche Zugriffe werden protokolliert.
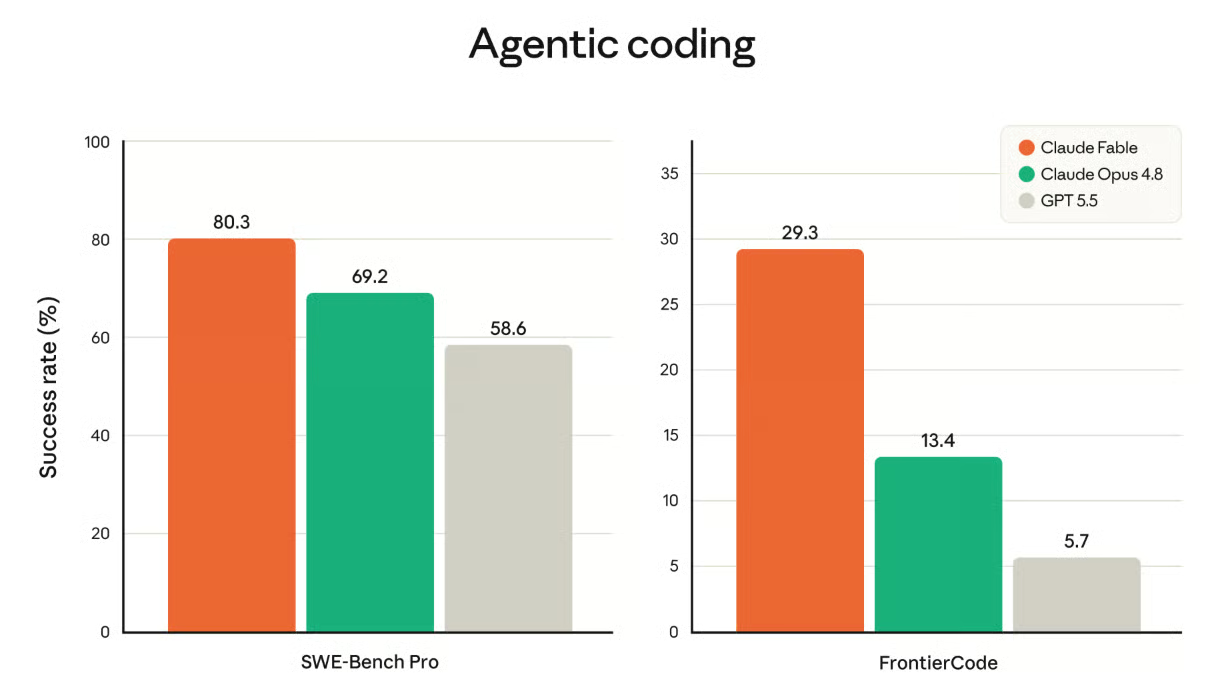
Claude Fable 5 gewinnt klar bei allen Benchmarks, die wir genau verfolgen. Auf SWE-Bench Pro erzielt es 80,3% und liegt damit vor den 69,2% von Opus 4.8. Beim Humanity's Last Exam mit Tools kommt es auf 64,5% – gegenüber 57,9% für Opus 4.8 und 52,2% für GPT-5.5.
| Kategorie | Benchmark | Claude Mythos 5 / Fable 5 | Claude Mythos Preview | Claude Opus 4.8 | GPT 5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|---|---|
| Agentisches Coding | SWE-Bench Pro | 80.3% | 77.8% | 69.2% | 58.6% | 54.2% |
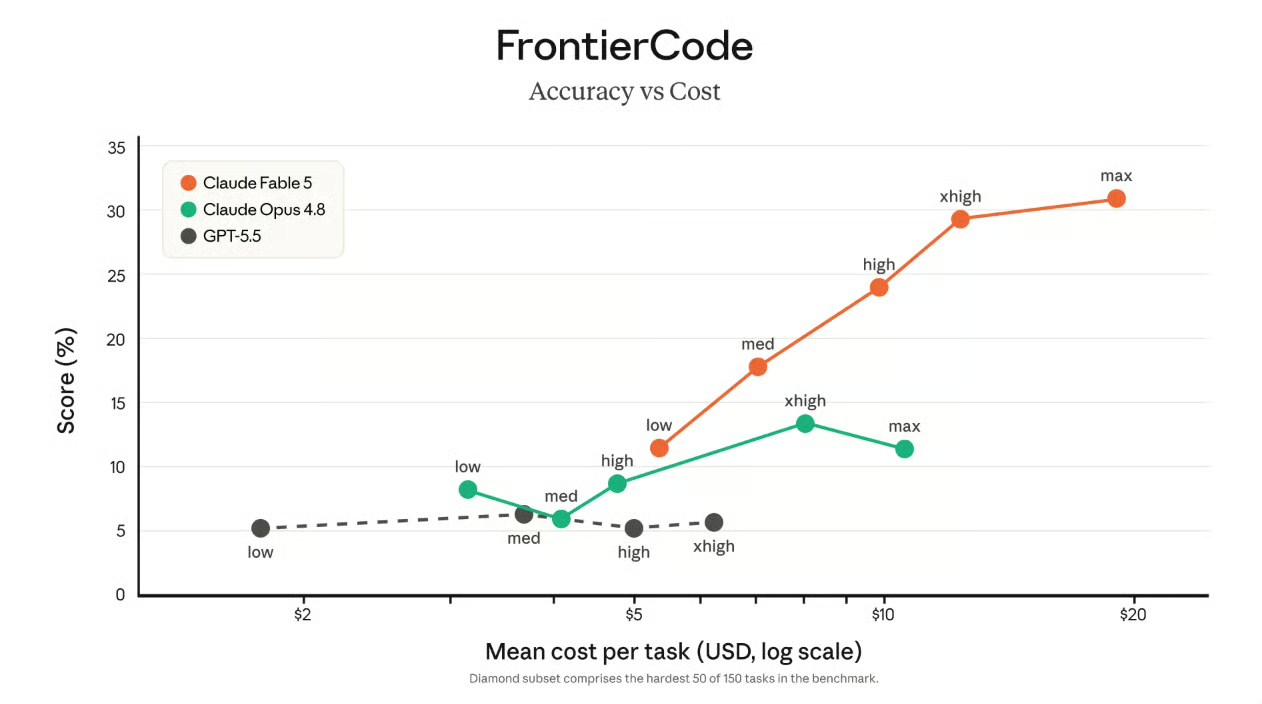
| Agentisches Coding | FrontierCode (Diamond) | 29.3% (xhigh) | — | 13.4% (xhigh) | 5.7% (xhigh) | — |
| Wissensarbeit | GDPval-AA | 1932 | — | 1890 | 1769 | 1314 |
| Wissensarbeit Vision | GDP.pdf | 29.8% (no tools) | — | 22.5% (no tools) | 24.9% (no tools) | 16.7% (no tools) |
| Räumliches Denken | Blueprint-Bench 2 | 38.6% | — | 14.5% | 36.2% | 26.5% |
| Tool-Nutzung | AutomationBench | 17.4% | — | 15.5% | 12.9% | 9.6% |
| Computer-Nutzung | OSWorld-Verified | 85.0% | 85.4% | 83.4% | 78.7% | 76.2% |
| Recht | Legal Agent Benchmark | 13.3% | — | 10.4% | 2.1% | 0.0% |
| Multidisziplinäres Denken | Humanity's Last Exam (no tools) | 59.0%* | 56.8% | 49.8% | 41.4% | 44.4% |
| Multidisziplinäres Denken | Humanity's Last Exam (with tools) | 64.5%* | 64.7% | 57.9% | 52.2% | 51.4% |
| Biologie | BioMysteryBench (hard) | 46.1%* | 29.6% | 40.0% | — | — |
| Biologie | BioMysteryBench (human solved) | 83.9%* | 82.6% | 80.4% | — | — |
| Agentisches Coding | Terminal-Bench 2.1 | 88.0%* | — | 82.7% | 83.4% (Codex CLI) | 70.7% (Gemini CLI) |
| Cybersicherheit | ExploitBench (Cap%) | 78.0%* | 69.0% | 40.0% | 34.0% | — |
| Gesundheit | HealthBench Professional | 66.0%* | 64.7% | 56.9% | 51.8% | — |
Ich habe den FrontierCode-Benchmark erwähnt, ohne ins Detail zu gehen. FrontierCode prüft nicht nur, ob ein Modell einen Coding-Test besteht – was schon schwer ist –, sondern auch, ob es höhere, allgemeinere Standards für hochwertige produktive Codebasen erfüllt: Performance im großen Maßstab, idiomatischer Stil, langfristige Wartbarkeit etc.
Claude Fable 5 erzielt beim FrontierCode-Test ohne die high- oder xhigh-Aufwandsparameter bessere Werte als jedes andere Modell.
Claude Fable 5 ist das derzeit beste Modell für Vision-Aufgaben. In Anthropics Tests konnte Fable 5 aus reinen Screenshots und ohne Gerüst den Quellcode einer Webanwendung rekonstruieren. Diese Fähigkeit zeigt sich auch in 93,2% bei CharXiv Reasoning mit Tools.
Außerdem löst Fable 5 ein Problem, das viele kennen: Es extrahiert präzise Zahlen aus detaillierten wissenschaftlichen Abbildungen – mit sehr wenigen Fehlern.
Dieses Jahr sprechen wir viel über Memory und Long-Context bei KI-Modellen. Mit Fable 5 setzt Anthropic neue Akzente.
Zum einen bleibt Fable 5 über Millionen Tokens hinweg fokussiert. Wenn dir das Konzept neu ist: KI-Modelle „vergessen“ bei langen Aufgaben früheren Kontext. Fable 5 hält kohärentes, konsistentes Verhalten auch bei sehr langen Tasks besser durch. Wie lang ist „sehr lang“? Zur Einordnung: Eine Million Tokens entspricht einem 700-seitigen Roman.
Spannend ist auch: Fable 5 verbessert seine Ausgaben mit eigenen Notizen. Das Modell kann während der Aufgabe Dinge notieren (z. B. in eine Datei) und später darauf zurückgreifen – wie ein Mensch, der beim Problemlösen mitschreibt. Das ist etwas anderes als „lange Erinnerung“: Das Modell nutzt externen Speicher als Denkwerkzeug.
Die Tabelle oben zeigt bereits, dass Fable 5 in jeder Kategorie vorn liegt. Interessant ist die Form des Vorsprungs: Wo es ein tiefer Graben ist, wo ein Münzwurf – und warum.
GPT-5.5 ist der engste Konkurrent, und bei vielen Aufgaben liegen beide fast gleichauf. Beim räumlichen Denken (Blueprint-Bench 2) kommt GPT-5.5 auf 36,2 und Fable 5 auf 38,6. Auch bei langen agentischen Aufgaben bleiben sie nah beieinander, solange das Modell beim Arbeiten Feedback erhält. Auf Terminal-Bench 2.1 – wo der Terminal Fehler sofort anzeigt – steht es 83,4 zu 88,0.
Ein Szenario durchbricht das Muster: eine lange Aufgabe, die erst am Ende bewertet wird. Dann kann das Modell eigene Fehler nicht abfangen, sie summieren sich – und das stärkere Modell setzt sich ab. SWE-Bench Pro ist der deutlichste Fall: 58,6 für GPT-5.5 gegenüber 80,3 für Fable 5.
Eine detaillierte Gegenüberstellung findest du in unserem Beitrag: Claude Fable 5 vs GPT-5.5: Benchmarks, Preise und die richtige Wahl.
Gemini 3.1 Pro liegt durchgehend hinter Fable 5, und der Abstand wächst bei den Aufgaben, die am meisten zählen. In der Wissensarbeit (GDPval-AA) erreicht es 1314 gegenüber 1932 bei Fable 5. Auf Terminal-Bench 2.1 steht es 70,7 zu 88,0. Bei kürzeren, in sich geschlossenen Tasks ist der Abstand kleiner — räumliches Denken 26,5 zu 38,6 —, schließt sich aber nie. Das Muster zeigt: ein Modell, das kurze Probleme ordentlich behandelt, aber bei langen, tool-lastigen Workflows den Faden verliert – genau dort, wo Fable 5 stark ist.
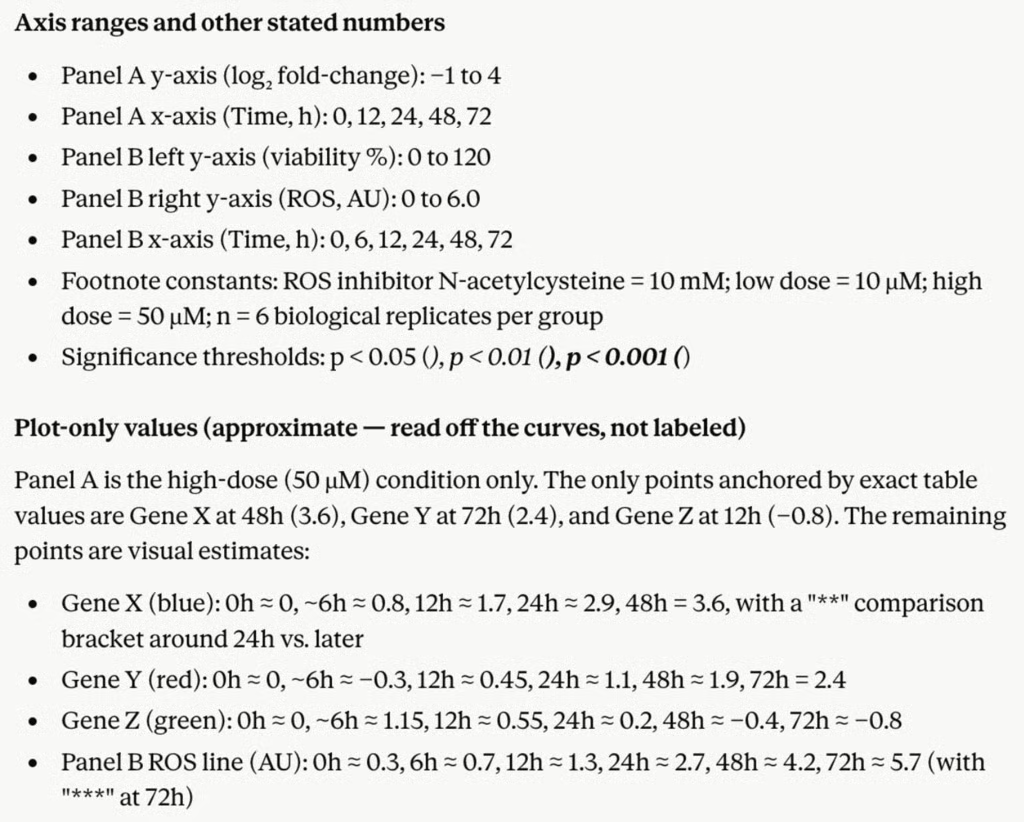
Eine konkrete Behauptung im Release: Fable 5 kann präzise Zahlen aus detaillierten wissenschaftlichen Abbildungen extrahieren – mit sehr wenigen Fehlern.
Um das zu prüfen, haben wir eine wissenschaftliche Abbildung mit zwei Panels erstellt – wie man sie in Zellbiologie-Papern findet: überlappende Genexpressions-Zeitreihen auf einer log₂-Achse, ein Dual-Achsen-Panel mit Prozentwerten und weiteren Messgrößen in Arbitrary Units usw.
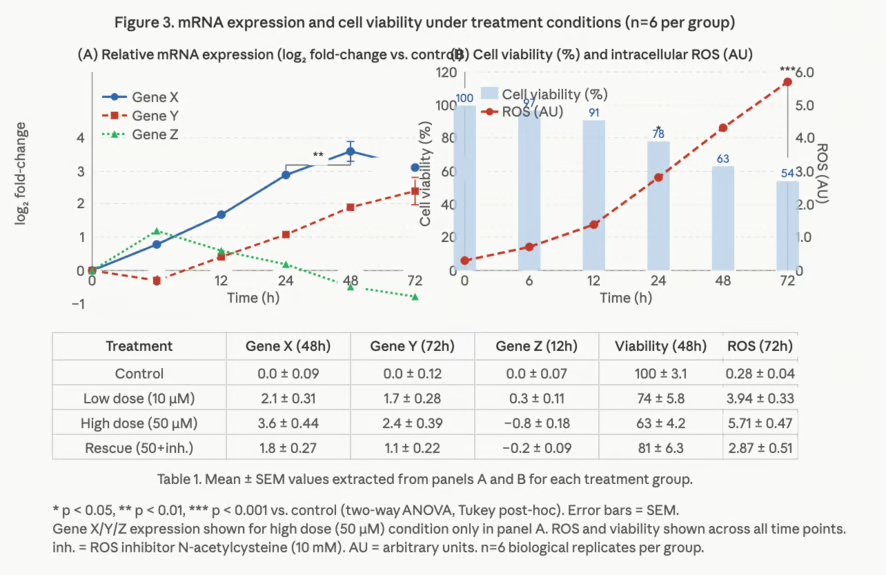
Wir dachten, das wird knifflig. Die zwei y-Achsen in Panel B haben unterschiedliche Skalen und Einheiten. Gen Z wird stellenweise negativ auf der log₂-Skala.
Wir baten Fable 5, alle numerischen Werte aus beiden Panels und der Tabelle zu extrahieren.
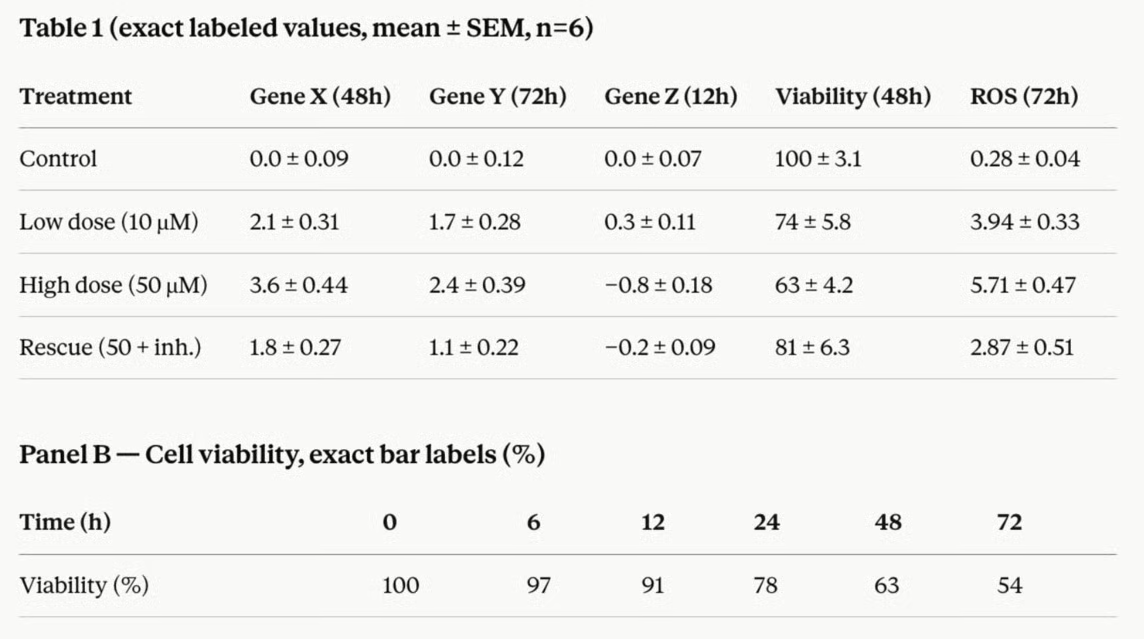
please extract all numeric valuesDas Ergebnis war praktisch perfekt. Meine eigene Tabelle zur Erstellung des Diagramms hatte für Gen Z einen Wert von -0,05 bei 48 Stunden. Fable 5 meldete -0,04 an dieser Stelle, nicht -0,05.
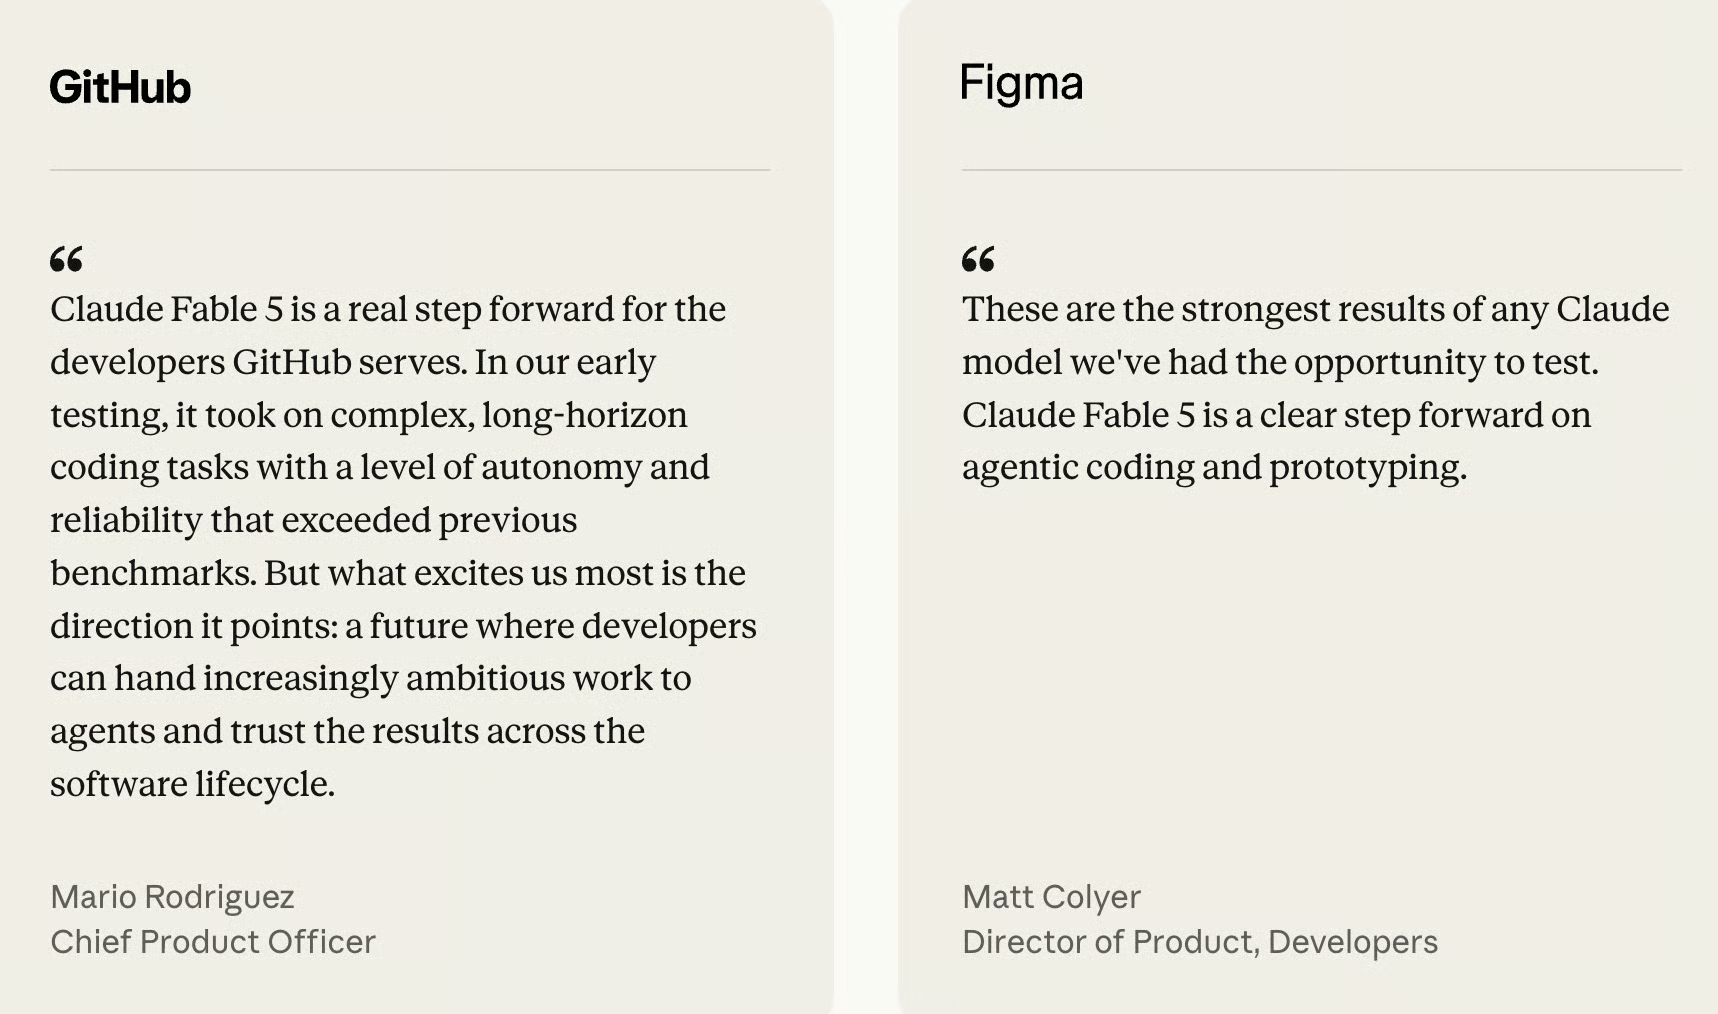
Im Release zeigt Anthropic Early-Access-Feedback bzw. Produktstimmen von Kunden oder Partnern wie GitHub und Figma. Klar positiv – das ist zu erwarten. Jede Modelleinführung bei Anthropic hat diesen Abschnitt.
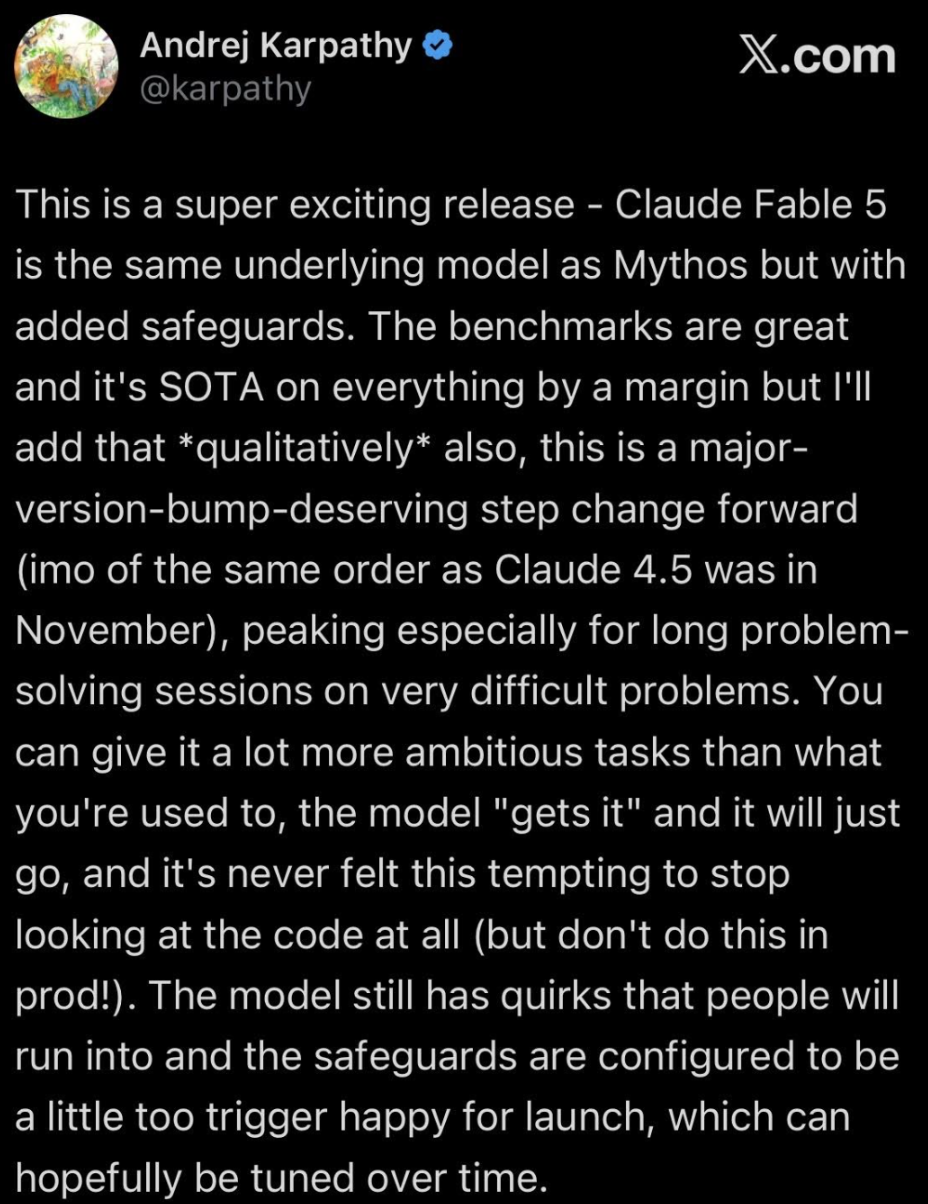
X liefert eine weniger kuratierte Sicht. Was sofort auffällt: Andrej Karpathy gibt dem Modell eine durchweg sehr positive Bewertung, erkennt Fable 5 als State of the Art über alle relevanten Benchmarks hinweg und spricht – wie schon bei Opus 4.5 im November – von einem echten Schrittwechsel. Außerdem nennt er viele Einsatzideen für Fable 5, etwa:
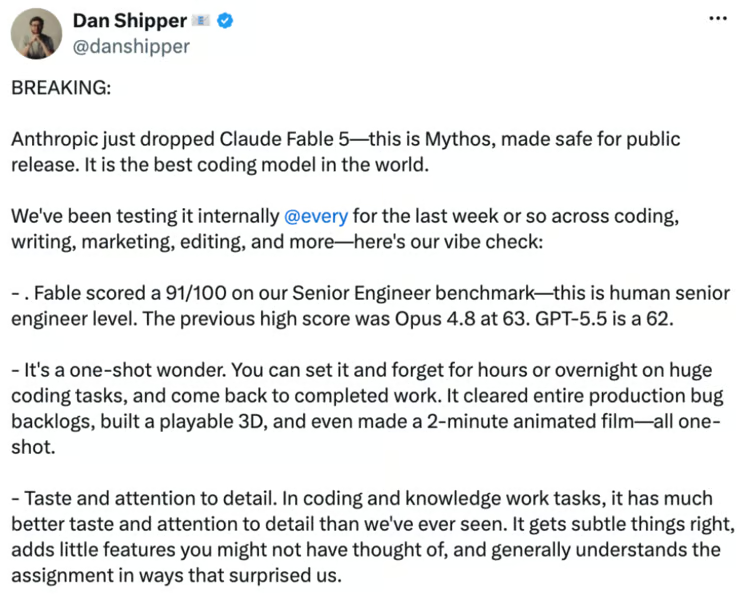
Dan Shipper, CEO von Every, sagt Ähnliches: Fable 5 fegt die Benchmarks davon und ist ein „One-Shot-Wunder“ – du setzt es auf ein großes Projekt an und hast am nächsten Morgen fertige Arbeit. (Er hatte Early Access.)
Etwas Gegenwind gibt es auch: Er sagt, das Modell ist langsam und tokenhungrig – sprich teuer. Es sei doppelt so teuer wie Opus. Sein Fazit: Nutze es gezielt für Aufgaben, die die zusätzliche Leistung wirklich brauchen.
Ich habe erwähnt: Claude Fable 5 ist Claude Mythos 5 – nur mit Schutzmechanismen. Hintergrund ist, dass Fable 5 ohne Beschränkungen in Bereichen wie Cybersicherheit und Biologie potenziell schädliche Unterstützung leisten könnte. Das ist die Einschätzung.
So funktionieren die Schutzmechanismen grob: ein zweistufiges Klassifiziersystem.
Die Klassifizierer decken drei Hauptbereiche ab.
Ein Vorher/Nachher in einer Grafik: Die pinken Balken zeigen Claude Mythos 5 ohne Schutz – das rohe Grundmodell. Es ist in allen vier Benchmarks extrem leistungsfähig: 88,4% bei Firefox-Exploit-Entwicklung, 83,8% bei CyberGym-Schwachstellen-Reproduktion usw.
Die orangen Balken zeigen Claude Fable 5 mit aktiven Klassifizierern – überall 0,0%. Die Schutzmechanismen drücken die Leistung auf null, was gut ist: Genau das ist das Ziel.
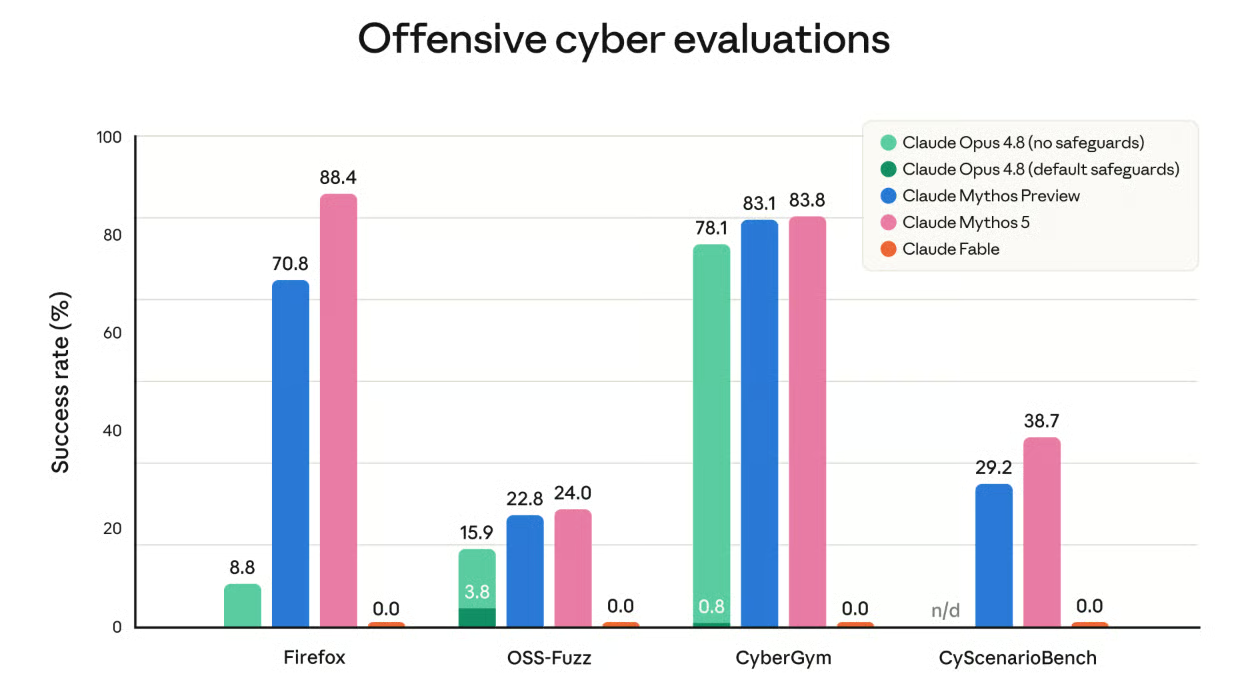
Diese Grafik ordnet auch Opus 4.8 ein: Selbst ohne Schutz liegt Opus 4.8 deutlich unter Mythos 5. Das zeigt, warum die Klassifizierer überhaupt nötig waren. Der Sprung zwischen Opus und Mythos machte eine breite Veröffentlichung riskant und verzögerte sie.
Wenn du einen Pro-, Max-, Team- oder Enterprise-Plan hast, kannst du Fable 5 ab sofort ohne Aufpreis nutzen — allerdings nur bis zum 22. Juni.
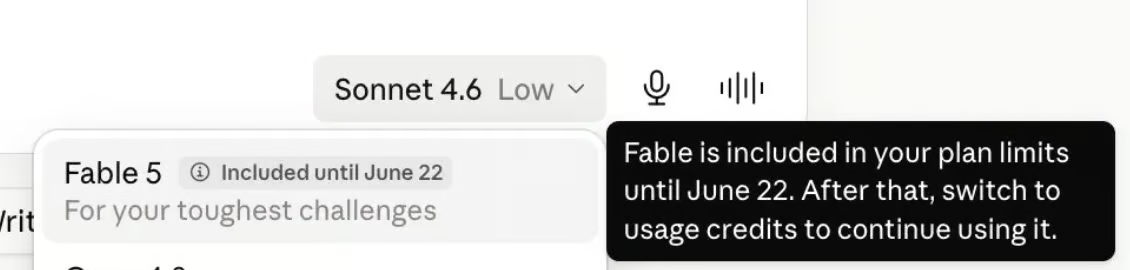
Nach dem 22. Juni ist der Zugriff über Usage Credits möglich – Anthropics nutzungsbasiertes Bezahlsystem, das zusätzlich zu deinem bestehenden Abo liegt. Das erklärt wohl auch Dans Kostenwarnung.
Für Entwickler über die API ist es einfacher:
Verglichen mit den Standardpreisen von Opus 4.8 (5 $ Input / 25 $ Output) ist Fable 5 tatsächlich doppelt so teuer – wie Dan sagt. Wenn du aber ohnehin Opus 4.8 im Fast-Modus nutzt, kostet Fable 5 gleich viel und ist zugleich leistungsfähiger.
Wichtig, falls du dich fragst: Wenn eine Anfrage wegen der Sicherheitsklassifizierung auf Opus 4.8 zurückfällt, wird sie zu den Opus-4.8-Tarifen abgerechnet – nicht zu Fable-5-Tarifen.
Claude Mythos 5, die Mythos-Variante ohne Schutzmechanismen, ist nicht öffentlich verfügbar. Der Zugriff ist auf Project-Glasswing-Partner beschränkt.
Anthropic hat uns mit Project Glasswing und dem verlockend benannten Mythos-Modell lange auf die Folter gespannt. Monatelang war dieses weltweit führende Modell – und das ist es wirklich – hinter einer Regierungspartnerschaft verschlossen.
Das hat sich geändert – eine Woche nachdem Anthropic den US-IPO beantragt hat. Jetzt ist das Mythos-Klassenmodell im Pro-Plan verfügbar. (Der Zugriff läuft zusätzlich über Usage Credits. Details im vorherigen Abschnitt.)
Status quo: Anthropic hat Modelle, die ohne Restriktionen ernsthaften Schaden anrichten könnten. Das ist kein Marketing – das belegt schon die eigens aufgebaute, parallele Klassifizierinfrastruktur.
Wohin die Reise geht: Die Leistungsgrenze wandert nach oben, Benchmarks werden durch härtere ersetzt, Release-Zyklen werden kürzer. Gleichzeitig wird die Schutzinfrastruktur komplexer. Mit einem möglichen IPO noch dieses Jahr wird viel darüber diskutiert werden, wie Wettbewerb und Sicherheit zusammengehen.
Lerne mit DataCamp
Kurs
Kurs
Kurs
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Zoumana Keita
15 Min.
Tutorial
Derrick Mwiti
10 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Matt Crabtree
5 Min.




