Curso
Desenvolvimento de Software com Claude Code
4 h
9.1K
Pratique e programa seu progresso.
Continuar Com O GoogleAtualização (1º de julho de 2026): o acesso ao Claude Fable 5 foi restaurado e agora está disponível globalmente no Claude Platform, Claude.ai, Claude Code e Claude Cowork, após a revogação da ordem de controle de exportação. O Mythos 5 continua restrito a parceiros avaliados do Project Glasswing.
Atualização (2 de setembro de 2026): a Anthropic publicou o sucessor do modelo. Saiba tudo no nosso guia do Claude Fable 5.1 e no nosso tutorial da API do Claude Fable 5.1.
Começamos a ouvir falar do Claude Mythos lá em abril, quando escrevemos sobre o lançamento do Claude Opus 4.7. Na época, entendemos que o Opus 4.7, apesar de extremamente impressionante por si só, só era o melhor modelo disponível publicamente porque os modelos classe Mythos estavam sendo mantidos fora de um lançamento amplo.
Pois bem, a Anthropic agora nos trouxe o Claude Fable 5, um modelo classe Mythos seguro para uso geral. É, sem dúvida, o novo líder nos principais benchmarks, incluindo trabalho de conhecimento, engenharia de software e pesquisa científica. É uma grande vitória para a Anthropic, que há apenas oito dias entrou com pedido de IPO nos EUA.
Neste artigo, vamos analisar de perto o Claude Fable 5, como ele se compara com outros modelos do mercado, como o GPT-5.5 e o Gemini 3.1 Pro, além dos próprios modelos da Claude, como o Opus 4.8. Também vamos dar algumas orientações de quando usar o modelo, já que ele é mais caro. Se você é novo no Claude e quer aprender, recomendo conferir nosso guia de como aprender Claude.
Claude Fable 5 é o nome que a Anthropic deu ao seu modelo mais novo e mais capaz. É um modelo classe Mythos, mas inclui proteções importantes em áreas sensíveis, especialmente cibersegurança.
Para você, isso significa que certas perguntas serão respondidas pelo próximo modelo na fila, o Claude Opus 4.8. A Anthropic estima que esse redirecionamento aconteça em menos de 5% de todas as consultas, e considera essa estimativa conservadora. O que faz sentido, já que envolve questões de cibersegurança. E, claro, essa porcentagem vai variar bastante dependendo do tipo de trabalho que você faz.
Estamos especialmente empolgados com o Claude Fable 5. O modelo ficou tão capaz que avançou para novas áreas de utilidade: defensores de sistemas usarão o modelo para proteger infraestruturas críticas, pesquisadores em ciências da vida poderão melhorar novos tratamentos. Astrofísicos podem usar esses modelos para mapear galáxias. E por aí vai.
Se você leu o anúncio, talvez tenha ouvido falar também do Claude Mythos 5. Se está se perguntando: o Claude Mythos 5 é o mesmo modelo subjacente, mas com algumas proteções desativadas. Não é para uso geral: ele é implantado como parte do Project Glasswing em parceria com o governo dos EUA, substituindo efetivamente o Claude Mythos Preview. Não sabemos tanto sobre o Claude Mythos 5, mas sabemos que ele tem as capacidades de cibersegurança mais fortes de qualquer modelo no mundo. A parceria da Anthropic com o governo dos EUA já é uma evidência disso.
O Fable 5 traz várias melhorias notáveis em segurança, transparência, memória e tratamento de dados.
A maior novidade estrutural no Fable 5 é um sistema de classificadores em duas etapas, projetado para evitar uso indevido das capacidades mais perigosas do modelo. Uma sonda monitora as ativações internas do modelo em todo o tráfego e, se algo for sinalizado, a solicitação é escalada para um LLM classificador separado, que dá a palavra final. Quando um pedido é bloqueado, ele é redirecionado ao Opus 4.8 em vez de ser recusado de imediato, então o usuário ainda recebe uma resposta útil.
É semelhante ao ponto acima. Quando os classificadores do Fable 5 redirecionam uma consulta para o Opus 4.8, os usuários são informados sobre qual modelo respondeu ao pedido. É um novo comportamento de transparência, para que o usuário não precise ficar se perguntando se a resposta pareceu diferente.
O Fable 5 consegue escrever anotações em um arquivo no meio da tarefa e consultá-las depois, o que é diferente de simplesmente ter uma janela de contexto longa. É um comportamento de memória de trabalho ativa. Nos testes da própria Anthropic, isso melhorou o desempenho significativamente mais do que no Opus 4.8.
A Anthropic está introduzindo uma nova política de retenção de dados que se aplica a todo o tráfego do Fable 5. Os dados são mantidos por 30 dias para ajudar a detectar novos jailbreaks e reduzir falsos positivos. A Anthropic afirma que esses dados não serão usados para treinar modelos e que o acesso humano é registrado.
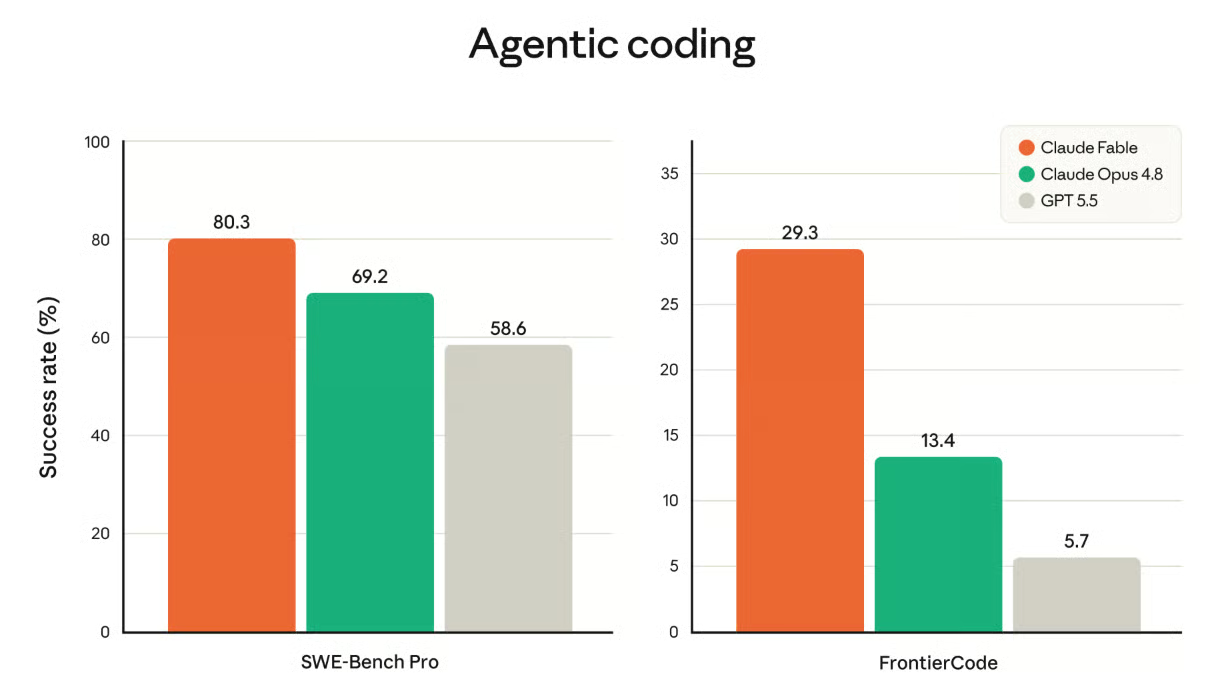
O Claude Fable 5 vence com folga todos os benchmarks que acompanhamos de perto. No SWE-Bench Pro, ele marca 80,3%, à frente dos 69,2% do Opus 4.8. No Humanity's Last Exam com ferramentas, ele faz 64,5%, contra 57,9% do Opus 4.8 e 52,2% do GPT-5.5.
| Categoria | Benchmark | Claude Mythos 5 / Fable 5 | Claude Mythos Preview | Claude Opus 4.8 | GPT 5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|---|---|
| Agentic coding | SWE-Bench Pro | 80,3% | 77,8% | 69,2% | 58,6% | 54,2% |
| Agentic coding | FrontierCode (Diamond) | 29,3% (xhigh) | — | 13,4% (xhigh) | 5,7% (xhigh) | — |
| Trabalho de conhecimento | GDPval-AA | 1932 | — | 1890 | 1769 | 1314 |
| Trabalho de conhecimento com visão | GDP.pdf | 29,8% (sem ferramentas) | — | 22,5% (sem ferramentas) | 24,9% (sem ferramentas) | 16,7% (sem ferramentas) |
| Raciocínio espacial | Blueprint-Bench 2 | 38,6% | — | 14,5% | 36,2% | 26,5% |
| Uso de ferramentas | AutomationBench | 17,4% | — | 15,5% | 12,9% | 9,6% |
| Uso de computador | OSWorld-Verified | 85,0% | 85,4% | 83,4% | 78,7% | 76,2% |
| Jurídico | Legal Agent Benchmark | 13,3% | — | 10,4% | 2,1% | 0,0% |
| Raciocínio multidisciplinar | Humanity's Last Exam (sem ferramentas) | 59,0%* | 56,8% | 49,8% | 41,4% | 44,4% |
| Raciocínio multidisciplinar | Humanity's Last Exam (com ferramentas) | 64,5%* | 64,7% | 57,9% | 52,2% | 51,4% |
| Biologia | BioMysteryBench (difícil) | 46,1%* | 29,6% | 40,0% | — | — |
| Biologia | BioMysteryBench (resolvido por humanos) | 83,9%* | 82,6% | 80,4% | — | — |
| Agentic coding | Terminal-Bench 2.1 | 88,0%* | — | 82,7% | 83,4% (Codex CLI) | 70,7% (Gemini CLI) |
| Cibersegurança | ExploitBench (Cap%) | 78,0%* | 69,0% | 40,0% | 34,0% | — |
| Saúde | HealthBench Professional | 66,0%* | 64,7% | 56,9% | 51,8% | — |
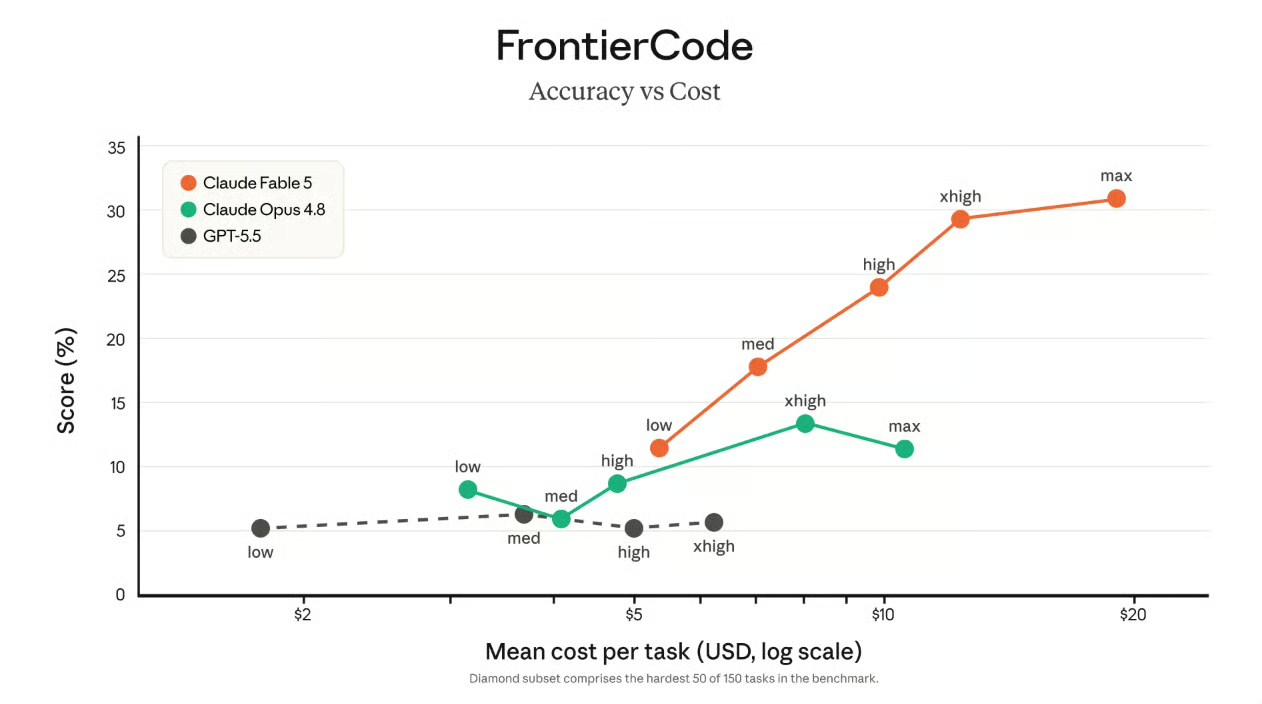
Mencionei o benchmark FrontierCode, mas não entrei em detalhes. O FrontierCode avalia se um modelo não só passa em um teste de código, o que já é difícil, mas também se atende a padrões mais amplos de bases de código de produção de alta qualidade, o que exige que o código seja performático em escala, idiomático, estruturado para manutenção de longo prazo etc.
O Claude Fable 5 tem a melhor pontuação no FrontierCode entre todos os modelos, mesmo sem usar os parâmetros de esforço high ou xhigh.
O Claude Fable 5 é o novo melhor modelo para tarefas de visão. Nos testes da Anthropic, o Fable 5 reconstruiu o código-fonte de um aplicativo web apenas a partir de screenshots, sem qualquer scaffolding. É a mesma capacidade refletida na pontuação de 93,2% no CharXiv Reasoning com ferramentas.
O Fable 5 também vai muito bem em um problema que muita gente encontra no dia a dia: ele consegue extrair números precisos de figuras científicas detalhadas com pouquíssimos erros.
Falamos bastante, ao longo do ano, sobre memória de modelos de IA e habilidades de long-context. Com o Fable 5, a Anthropic traz novidades importantes.
Para começar, o Fable 5 mantém o foco ao longo de milhões de tokens. Se você não está familiarizado, modelos de IA, em tarefas longas, podem “esquecer” ou perder o fio do contexto inicial conforme a conversa se estende. O Fable 5 é melhor em manter um comportamento coerente e consistente mesmo quando a tarefa é muito longa. Quão longa? Para comparar, um milhão de tokens equivale a um romance de 700 páginas.
A Anthropic também conta, de forma interessante, que o Fable 5 melhora suas saídas usando as próprias anotações. Ou seja, o modelo pode escrever coisas no meio da tarefa (por exemplo, em um arquivo) e consultar depois o que ele mesmo anotou. É como uma pessoa que rabisca notas enquanto resolve um problema. Isso é diferente de ter “memória longa”: o modelo usa armazenamento externo como ferramenta de raciocínio.
A tabela acima já mostra o Fable 5 vencendo em todas as categorias. Mas vale perguntar qual é o “formato” dessa liderança: onde é um abismo, onde é páreo duro e por quê.
GPT-5.5 é o concorrente mais próximo e, na maioria das tarefas, os dois ficam quase empatados. No raciocínio espacial do Blueprint-Bench 2, são 36,2 para o GPT-5.5 e 38,6 para o Fable 5. Eles continuam próximos até em tarefas agentic longas, desde que o modelo receba feedback enquanto trabalha. No Terminal-Bench 2.1, em que o terminal sinaliza erros na hora, fica 83,4 contra 88,0.
Uma situação foge do padrão: uma tarefa longa avaliada só no final. Aí o modelo não consegue pegar seus próprios erros, eles se acumulam e o modelo mais forte dispara. O SWE-Bench Pro é o caso mais claro: 58,6 para o GPT-5.5 contra 80,3 para o Fable 5.
Para uma comparação detalhada, leia nosso post: Claude Fable 5 vs GPT-5.5: benchmarks, preços e qual escolher.
Gemini 3.1 Pro fica atrás do Fable 5 em toda a linha, e a distância aumenta justamente no trabalho que mais importa. No GDPval-AA (trabalho de conhecimento), ele marca 1314 contra 1932 do Fable 5. No Terminal-Bench 2.1, é 70,7 contra 88,0. A diferença é menor em tarefas curtas e delimitadas — no raciocínio espacial, 26,5 contra 38,6 — mas nunca zera. O padrão aponta para um modelo que lida razoavelmente bem com problemas curtos, mas perde o fio em fluxos longos e pesados em ferramentas, onde o Fable 5 foi feito para brilhar.
Uma das afirmações específicas no anúncio da Anthropic é que o Fable 5 consegue extrair números precisos de figuras científicas detalhadas com pouquíssimos erros.
Para testar isso, criamos uma figura científica com dois painéis, inspirada no tipo de gráfico que você encontra em artigos de biologia celular: séries temporais de expressão gênica sobre eixo log₂, um painel de eixo duplo combinando porcentagens com outras medidas em unidades arbitrárias etc.
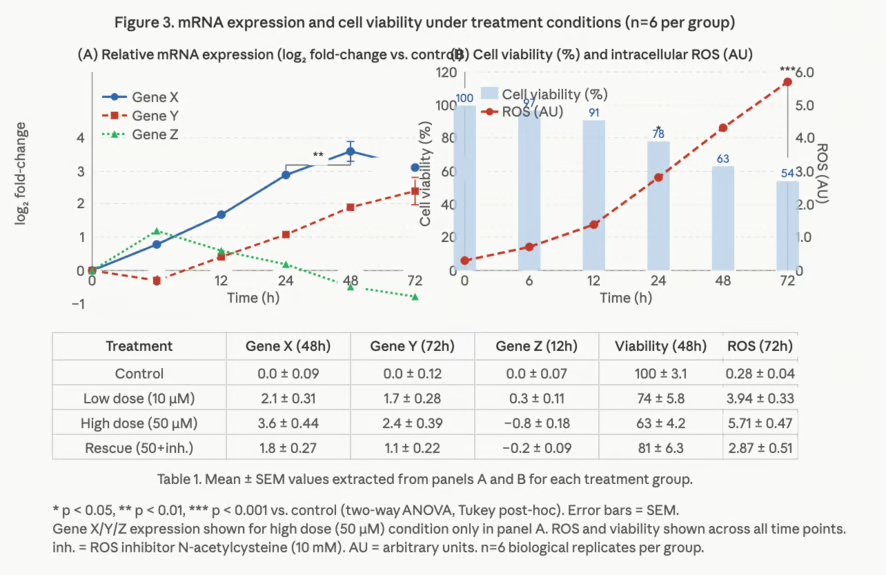
Achamos que seria difícil. Os dois eixos y do painel B usam escalas e unidades diferentes. O Gene Z cruza para valores log₂ negativos em alguns pontos.
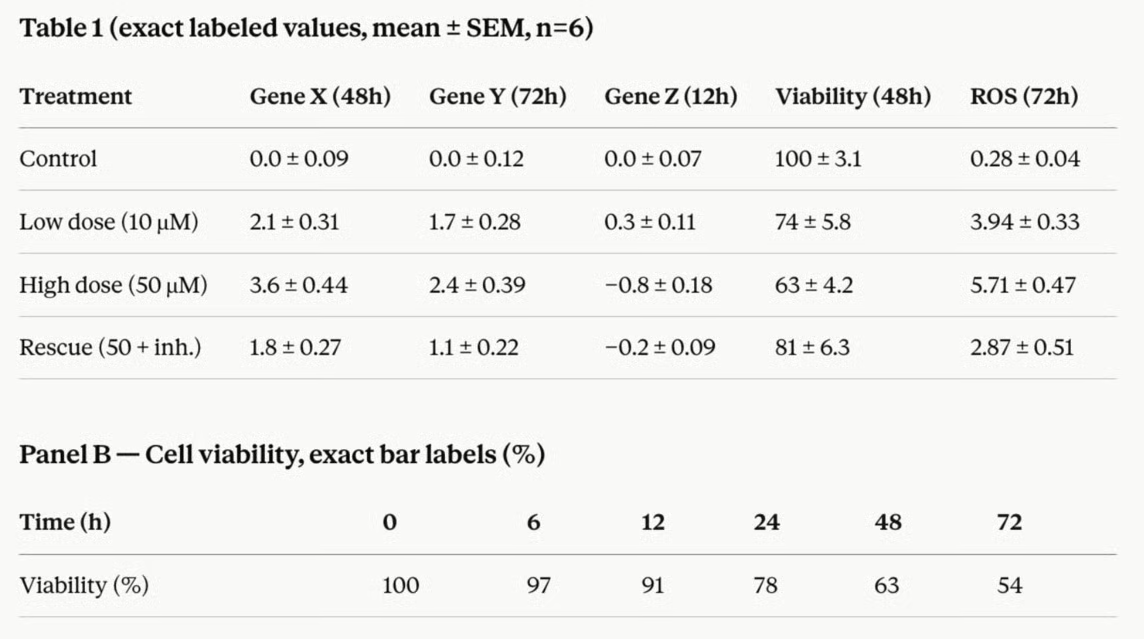
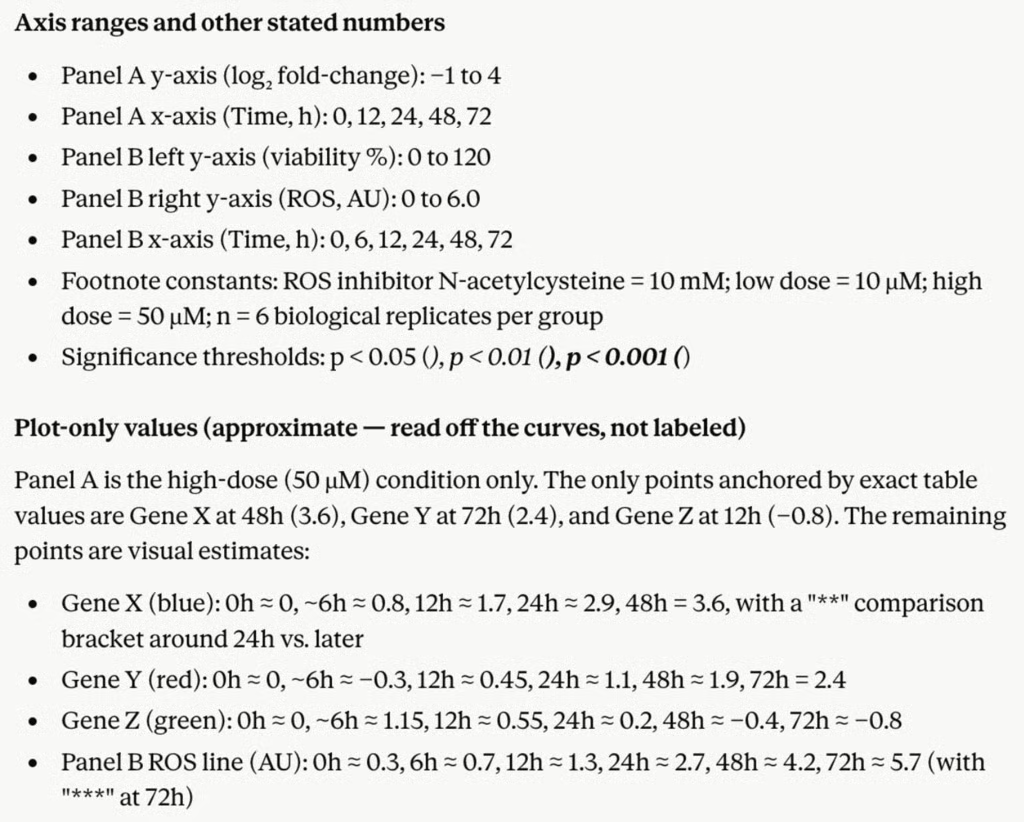
Pedimos ao Fable 5 para extrair todos os valores numéricos de ambos os painéis e da tabela.
please extract all numeric valuesO resultado foi praticamente perfeito. Minha própria tabela usada para criar o gráfico tinha o Gene Z com valor de -0,05 em 48 horas. O Fable 5 disse que era -0,04 nesse ponto, não -0,05.
No anúncio, a Anthropic mostra depoimentos/feedbacks de acesso antecipado de clientes e parceiros como GitHub e Figma. Eles falam bem, o que é esperado. Todo lançamento de modelo da Anthropic tem essa seção.
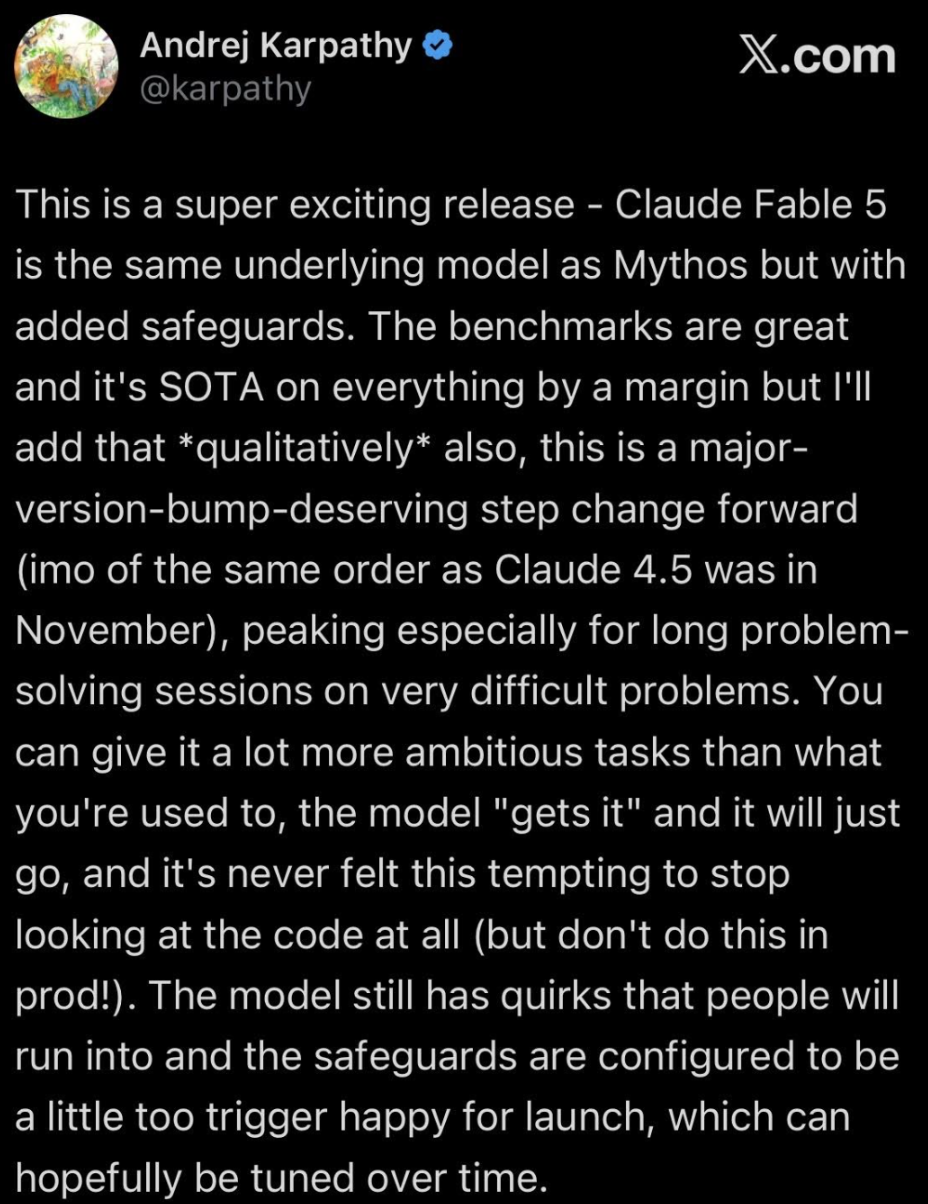
O X traz uma visão menos curada. O que chamou atenção de cara: Andrej Karpathy fez uma avaliação praticamente elogiosa, reconhecendo que o Fable 5 é o estado da arte nos benchmarks relevantes com folga e chamando o modelo de uma mudança de patamar, como o Opus 4.5 foi em novembro. No restante do post, ele dá várias ideias do que você pode fazer com o Fable 5, como:
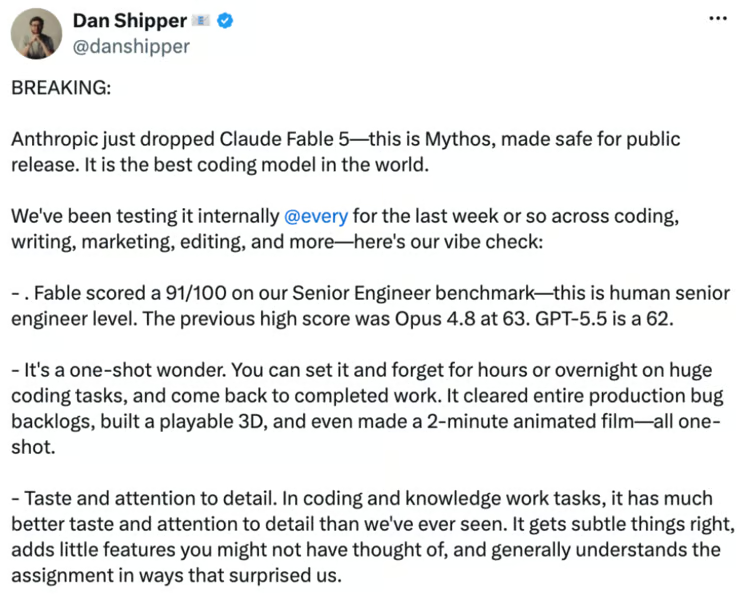
Dan Shipper, CEO da Every, diz algo parecido, que o Fable 5 detonou os benchmarks e que é um “one-shot wonder” — você pode deixá-lo num projeto grande e, no dia seguinte, voltar com o trabalho pronto. (Ele teve acesso antecipado, por isso fala com propriedade.)
Há um pouco de crítica para equilibrar: ele diz que o modelo é lento e consome muitos tokens — em outras palavras, é caro. Afirma que custa o dobro do Opus. Então ele reconhece, com razão, que você deve usar o modelo apenas para o que realmente exige essa potência.
Comentei que o Claude Fable 5 é o Claude Mythos 5, só que com proteções. Na prática, isso significa que o Fable 5 é potente o suficiente para, sem restrições, dar assistência significativa a agentes mal-intencionados em áreas como cibersegurança e biologia. Essa é a avaliação.
Veja como funcionam as proteções em alto nível. É um sistema de classificação em duas etapas:
Agora, há três áreas principais cobertas pelos classificadores.
Veja o antes/depois das proteções em um gráfico. As barras rosas são o Claude Mythos 5 sem proteções — o modelo bruto. Ele é extremamente capaz nos quatro benchmarks: 88,4% em desenvolvimento de exploit no Firefox, 83,8% em reprodução de vulnerabilidades no CyberGym e assim por diante.
As barras laranja são o Claude Fable 5 com os classificadores ativos, e todas estão em 0,0% em cada benchmark. As proteções derrubam o desempenho, o que é bom — zero é o objetivo aqui.
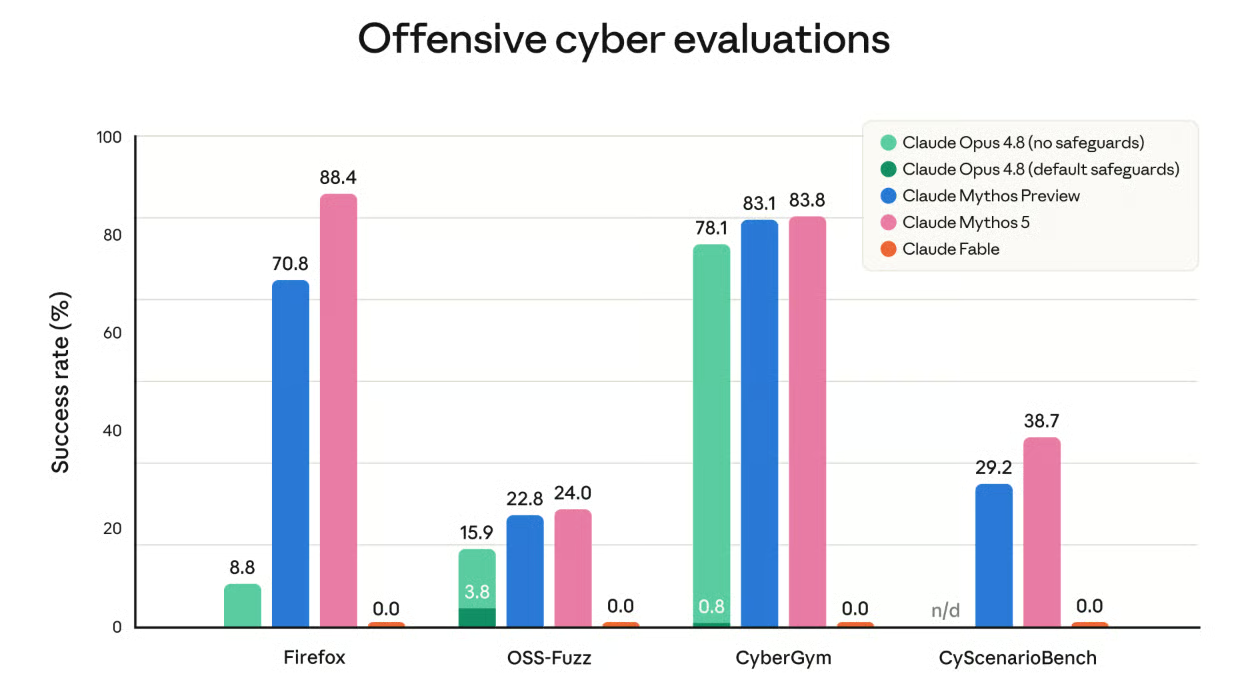
Gosto desse gráfico porque coloca o Opus 4.8 em contexto. Mesmo sem proteções, o Opus 4.8 marca bem menos que o Mythos 5. Isso mostra por que os classificadores foram necessários desde o início. O salto de capacidade entre Opus e Mythos foi o que tornou arriscado um lançamento amplo e o que o atrasou.
Se você tem um plano Pro, Max, Team ou Enterprise, o Fable 5 está disponível agora sem custo extra — mas só até 22 de junho.
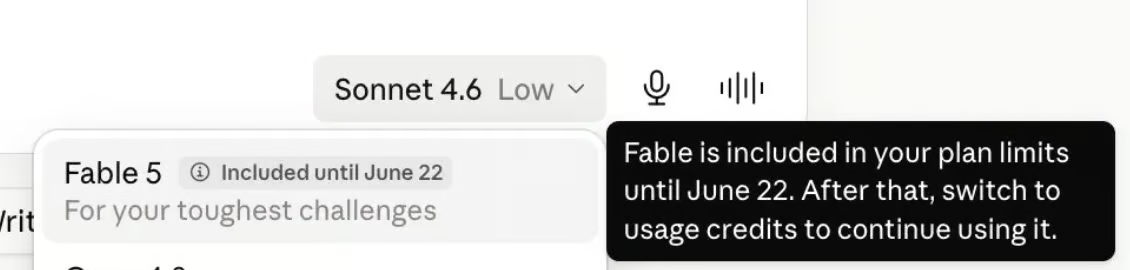
Depois de 22 de junho, o acesso exigirá usage credits, o sistema de pagamento conforme o uso da Anthropic que fica por cima da sua assinatura atual. Provavelmente é parte do motivo pelo qual o Dan Shipper alertou sobre os custos.
Para desenvolvedores na API, é mais simples:
Se você comparar com os preços padrão do Opus 4.8 (US$ 5 entrada / US$ 25 saída), o Fable 5 é mesmo duas vezes mais caro, como disse o Dan. Mas se você já usa o Opus 4.8 no modo rápido, o Fable 5 custa o mesmo e é um modelo mais capaz.
Observação importante, caso você esteja em dúvida como eu estava: quando uma consulta faz fallback para o Opus 4.8, como acontece pelo sistema de classificadores de segurança, a cobrança é feita nas tarifas do Opus 4.8, não do Fable 5.
O Claude Mythos 5, a versão Mythos sem proteções, não está disponível ao público em geral. O acesso é restrito a parceiros do Project Glasswing.
A Anthropic vinha nos provocando com o Project Glasswing e o modelo de nome tentador, Mythos. Mas por meses, esse melhor do mundo — e ele realmente é o melhor do mundo — ficou trancado atrás de uma parceria governamental.
Isso mudou, uma semana depois de a Anthropic entrar com pedido de IPO nos EUA. Agora, o modelo classe Mythos está disponível em um plano Pro. (O acesso também depende de usage credits. Veja a última seção para entender tudo.)
Onde estamos: a Anthropic tem modelos capazes o suficiente para causar danos sérios sem restrições. Sabemos que não é papo de marketing porque a empresa construiu todo um sistema paralelo de classificadores para adicionar salvaguardas.
Para onde vamos: o teto de capacidade continua subindo, os benchmarks continuam sendo substituídos por versões mais difíceis e o ciclo de lançamento de modelos fica cada vez mais curto. Além disso, a infraestrutura de salvaguardas fica mais elaborada para compensar. Com um IPO possivelmente ainda este ano, vai haver muita discussão sobre como a pressão competitiva pesa contra as questões de segurança.
Aprenda com a DataCamp
Curso
Curso
Pratique e programa seu progresso.
Continuar Com O Googleblog
Khalid Abdelaty
15 min
blog
Josep Ferrer
8 min
blog
Richie Cotton
blog
Javier Canales Luna
9 min
blog
Dr Ana Rojo-Echeburúa
9 min
Tutorial
Abid Ali Awan