Curso
Software Development with Claude Code
4 h
8.8K
Actualización (1 de julio de 2026): se ha restablecido el acceso a Claude Fable 5, ya disponible globalmente en Claude Platform, Claude.ai, Claude Code y Claude Cowork tras levantarse la orden de control de exportaciones. Mythos 5 sigue limitado a socios evaluados de Project Glasswing.
Actualización (2 de septiembre de 2026): Anthropic ha publicado el sucesor del modelo. Descúbrelo en nuestra guía de Claude Fable 5.1 y en nuestro tutorial del API de Claude Fable 5.1.
Empezamos a oír hablar de Claude Mythos en abril, cuando escribimos sobre el lanzamiento de Claude Opus 4.7. Ya entonces entendíamos que Opus 4.7, aunque muy impresionante, solo era el mejor modelo disponible públicamente porque los modelos de clase Mythos se estaban reservando y no salían a gran escala.
Pues bien, Anthropic nos trae ahora Claude Fable 5, un modelo de clase Mythos seguro para uso general. Es, sin duda, el nuevo líder en pruebas comparativas clave: trabajo de conocimiento, ingeniería de software e investigación científica, entre otras. Es un gran logro para Anthropic, que hace apenas ocho días presentó su solicitud de salida a bolsa en EE. UU.
En este artículo, analizamos de cerca Claude Fable 5, cómo se compara con otros modelos del mercado, como GPT-5.5 y Gemini 3.1 Pro, y también con modelos de la propia Claude, como Opus 4.8. Además, daremos algunas pautas sobre cuándo usar este modelo, porque es más caro. Si eres nuevo en Claude y tienes ganas de aprender, te recomiendo echar un vistazo a nuestra guía para aprender Claude.
Claude Fable 5 es el nombre que Anthropic da a su modelo más nuevo y capaz. Es un modelo de clase Mythos, pero incorpora salvaguardas importantes en áreas clave, especialmente en ciberseguridad.
Para el usuario, esto significa que ciertas preguntas serán respondidas por el siguiente modelo en la cadena, Claude Opus 4.8. Anthropic estima que este tipo de redirección ocurre en menos del 5% de las consultas, y consideran que es una estimación conservadora. Y mejor así, ya que entran en juego cuestiones de ciberseguridad. Por supuesto, ese porcentaje variará mucho según el tipo de trabajo que hagas.
Estamos especialmente entusiasmados con Claude Fable 5. El modelo es ya tan capaz que abre nuevas áreas de utilidad: los defensores en ciberseguridad lo usarán para proteger sistemas críticos, y personal investigador en ciencias de la vida podría emplearlo para mejorar nuevos tratamientos. Astrofísicos pueden usar estos modelos para cartografiar galaxias. Y así sucesivamente.
Si has leído el anuncio, quizá también oíste hablar de Claude Mythos 5. Si te lo preguntas: Claude Mythos 5 es el mismo modelo subyacente pero con algunas salvaguardas desactivadas. No es para uso general: se despliega como parte de Project Glasswing en colaboración con el gobierno de EE. UU., sustituyendo de facto a Claude Mythos Preview. No sabemos tanto sobre Claude Mythos 5, pero sí que cuenta con las capacidades de ciberseguridad más sólidas de cualquier modelo del mundo. La propia colaboración de Anthropic con el gobierno estadounidense es prueba de ello.
Fable 5 introduce mejoras destacadas en seguridad, transparencia, memoria y gestión de datos.
La mayor novedad estructural de Fable 5 es un sistema de dos clasificadores diseñado para evitar el uso indebido de las capacidades más peligrosas del modelo. Una sonda supervisa las activaciones internas del modelo en todo el tráfico y, si detecta algo, la solicitud se eleva a un segundo clasificador, un LLM entrenado aparte que toma la decisión final. Cuando una petición se bloquea, en lugar de rechazarla, se redirige a Opus 4.8 para que el usuario reciba igualmente una respuesta útil.
Muy en la línea del punto anterior. Cuando los clasificadores de Fable 5 redirigen una consulta a Opus 4.8, el usuario recibe un aviso indicando qué modelo respondió. Es un nuevo gesto de transparencia para que no tengas que preguntarte por qué una respuesta se siente diferente.
Fable 5 puede escribir notas en un archivo a mitad de una tarea y volver a consultarlas más tarde, algo distinto a contar simplemente con una ventana de contexto larga. Es una memoria de trabajo activa. En pruebas internas de Anthropic, esta función mejoró el rendimiento significativamente más que en Opus 4.8.
Anthropic introduce una nueva política de retención de datos que aplica a todo el tráfico de Fable 5. Los datos se conservan durante 30 días para ayudar a detectar nuevos jailbreaks y reducir falsos positivos. Anthropic afirma que estos datos no se usan para entrenar modelos y que el acceso humano queda registrado.
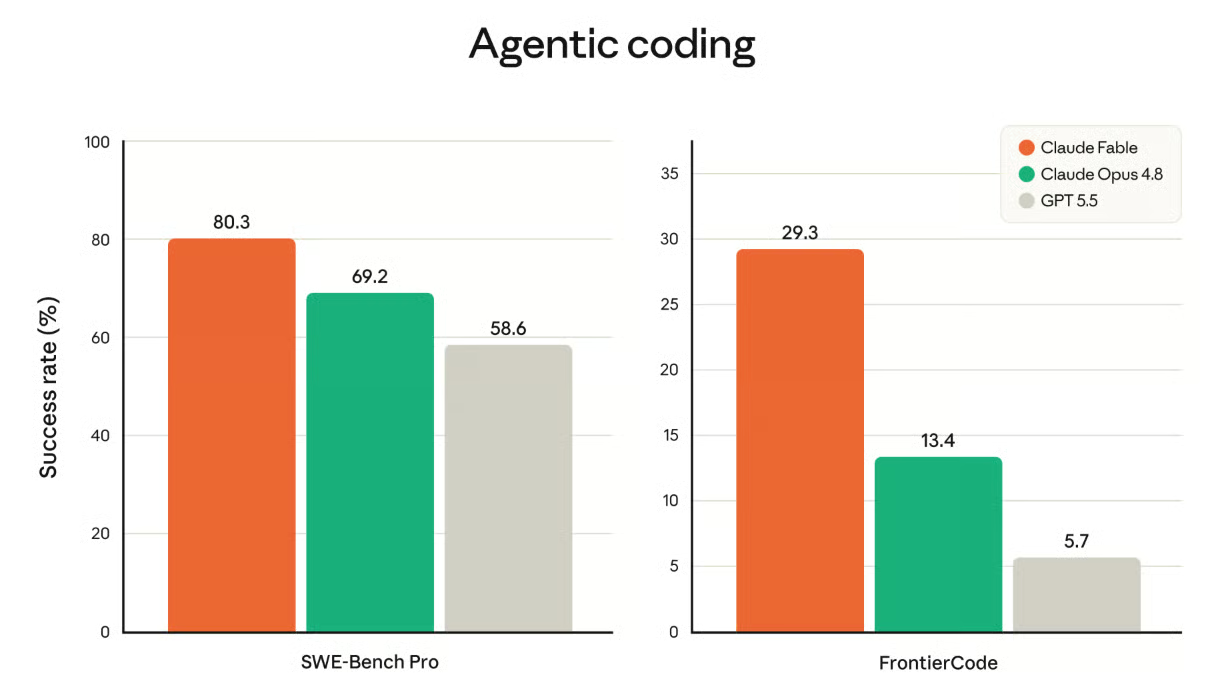
Claude Fable 5 gana con claridad en todas las pruebas comparativas que seguimos de cerca. En SWE-Bench Pro, logra un 80,3%, por delante del 69,2% de Opus 4.8. En Humanity's Last Exam con herramientas, alcanza el 64,5%, frente al 57,9% de Opus 4.8 y el 52,2% de GPT-5.5.
| Categoría | Benchmark | Claude Mythos 5 / Fable 5 | Claude Mythos Preview | Claude Opus 4.8 | GPT 5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|---|---|
| Programación agentiva | SWE-Bench Pro | 80,3% | 77,8% | 69,2% | 58,6% | 54,2% |
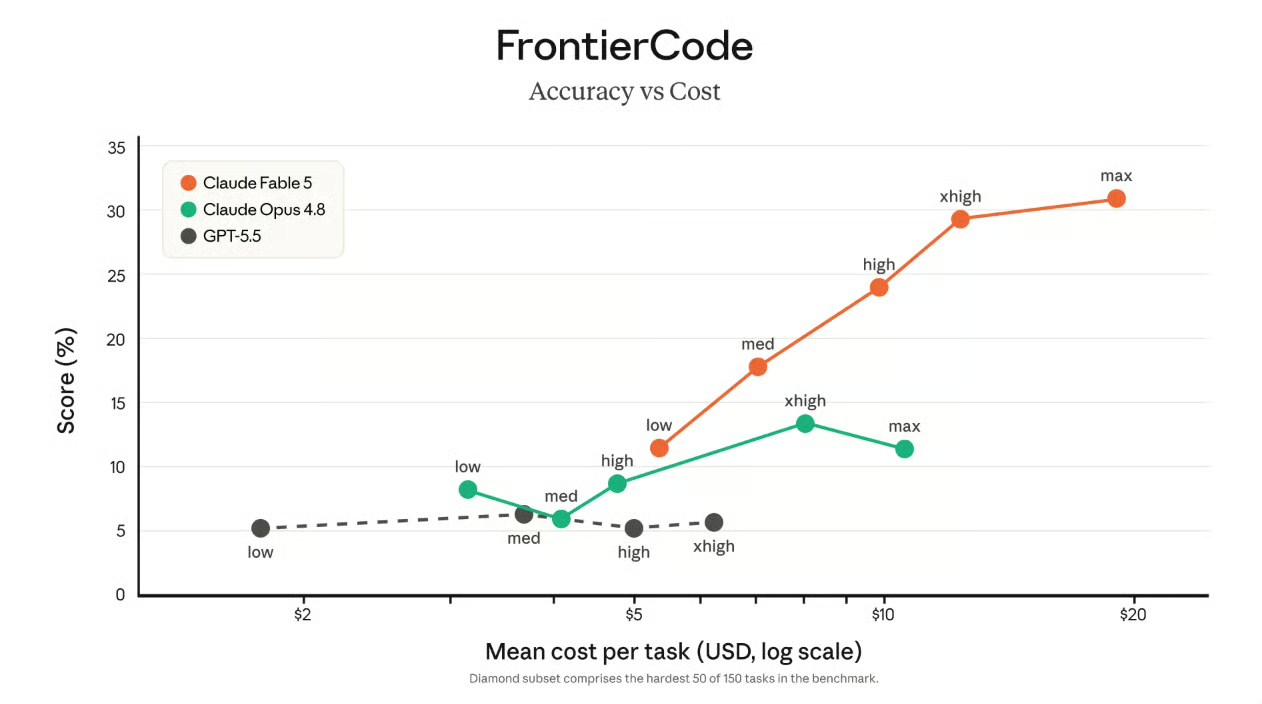
| Programación agentiva | FrontierCode (Diamond) | 29,3% (xhigh) | — | 13,4% (xhigh) | 5,7% (xhigh) | — |
| Trabajo de conocimiento | GDPval-AA | 1932 | — | 1890 | 1769 | 1314 |
| Trabajo de conocimiento con visión | GDP.pdf | 29,8% (sin herramientas) | — | 22,5% (sin herramientas) | 24,9% (sin herramientas) | 16,7% (sin herramientas) |
| Razonamiento espacial | Blueprint-Bench 2 | 38,6% | — | 14,5% | 36,2% | 26,5% |
| Uso de herramientas | AutomationBench | 17,4% | — | 15,5% | 12,9% | 9,6% |
| Uso del ordenador | OSWorld-Verified | 85,0% | 85,4% | 83,4% | 78,7% | 76,2% |
| Legal | Legal Agent Benchmark | 13,3% | — | 10,4% | 2,1% | 0,0% |
| Razonamiento multidisciplinar | Humanity's Last Exam (sin herramientas) | 59,0%* | 56,8% | 49,8% | 41,4% | 44,4% |
| Razonamiento multidisciplinar | Humanity's Last Exam (con herramientas) | 64,5%* | 64,7% | 57,9% | 52,2% | 51,4% |
| Biología | BioMysteryBench (difícil) | 46,1%* | 29,6% | 40,0% | — | — |
| Biología | BioMysteryBench (resuelto por humanos) | 83,9%* | 82,6% | 80,4% | — | — |
| Programación agentiva | Terminal-Bench 2.1 | 88,0%* | — | 82,7% | 83,4% (Codex CLI) | 70,7% (Gemini CLI) |
| Ciberseguridad | ExploitBench (Cap%) | 78,0%* | 69,0% | 40,0% | 34,0% | — |
| Salud | HealthBench Professional | 66,0%* | 64,7% | 56,9% | 51,8% | — |
Mencioné el benchmark FrontierCode pero no entré en detalle. FrontierCode evalúa si un modelo no solo pasa una prueba de programación —ya de por sí exigente—, sino si además cumple estándares más generales de código de producción de alta calidad: rendimiento a escala, estilo idiomático, arquitectura pensada para el mantenimiento a largo plazo, etc.
Claude Fable 5 obtiene mejor puntuación en FrontierCode que cualquier otro modelo sin siquiera usar los parámetros de esfuerzo high o xhigh.
Claude Fable 5 es el nuevo mejor modelo para tareas de visión. En pruebas de Anthropic, Fable 5 pudo reconstruir el código fuente de una aplicación web solo a partir de capturas de pantalla y sin andamiaje. Es la misma capacidad que se refleja en su 93,2% en CharXiv Reasoning con herramientas.
El modelo Fable 5 también destaca en un problema que mucha gente se encuentra: extraer números precisos de figuras científicas detalladas con muy pocos errores.
Llevamos todo el año hablando de la memoria y el contexto largo de los modelos de IA. Con Fable 5, Anthropic trae novedades interesantes.
Para empezar, Fable 5 mantiene el foco a lo largo de millones de tokens. Si no te suena el concepto, en tareas largas los modelos de IA pueden “olvidar” o perder el hilo del contexto inicial a medida que la conversación se alarga. Fable 5 es mejor manteniendo un comportamiento coherente y consistente incluso cuando la tarea es muy larga. ¿Qué es “muy larga”? A modo de referencia, un millón de tokens equivale a una novela de 700 páginas.
Anthropic también nos cuenta, y es interesante, que Fable 5 mejora sus salidas usando sus propias notas. Es decir, el modelo puede escribir cosas a mitad de una tarea (por ejemplo, en un archivo) y volver a consultarlas más tarde. Se parece a cómo una persona toma notas mientras resuelve un problema. Esto es distinto a tener “memoria larga”. El modelo usa almacenamiento externo como herramienta de pensamiento.
La tabla anterior ya muestra a Fable 5 ganando en todas las categorías. Pero una pregunta útil es cómo es esa ventaja: dónde es un abismo, dónde es un cara o cruz y por qué.
GPT-5.5 es el competidor más cercano y, en la mayoría de tareas, quedan casi empatados. En Blueprint-Bench 2 (razonamiento espacial) es 36,2 para GPT-5.5 y 38,6 para Fable 5. Se mantienen cerca incluso en tareas agentivas largas siempre que el modelo reciba feedback mientras trabaja. En Terminal-Bench 2.1, donde la terminal marca errores al momento, es 83,4 frente a 88,0.
Hay una situación que rompe el patrón: una tarea larga evaluada solo al final. Ahí, el modelo no puede detectar sus propios fallos, estos se acumulan y el modelo más fuerte se escapa. SWE-Bench Pro es el caso más claro: 58,6 para GPT-5.5 frente a 80,3 para Fable 5.
Para una comparación detallada, lee nuestro artículo: Claude Fable 5 vs GPT-5.5: benchmarks, precios y cuál elegir.
Gemini 3.1 Pro queda por detrás de Fable 5 en todo, y la brecha se amplía en el trabajo que más importa. En GDPval-AA (trabajo de conocimiento), obtiene 1314 frente a 1932 de Fable 5. En Terminal-Bench 2.1, 70,7 frente a 88,0. La distancia es menor en tareas más cortas y acotadas —en razonamiento espacial es 26,5 frente a 38,6—, pero nunca se cierra. El patrón apunta a un modelo que resuelve bien problemas cortos, pero pierde el hilo en flujos largos y con muchas herramientas, justo donde Fable 5 está diseñado para brillar.
Anthropic afirma específicamente que Fable 5 puede extraer números precisos de figuras científicas detalladas con muy pocos errores.
Para ponerlo a prueba, creamos una figura científica de dos paneles inspirada en el tipo de gráficos que verías en un artículo de biología celular: series temporales de expresión génica solapadas en un eje log₂, un panel de doble eje que combina porcentajes con otras medidas en unidades arbitrarias, etc.
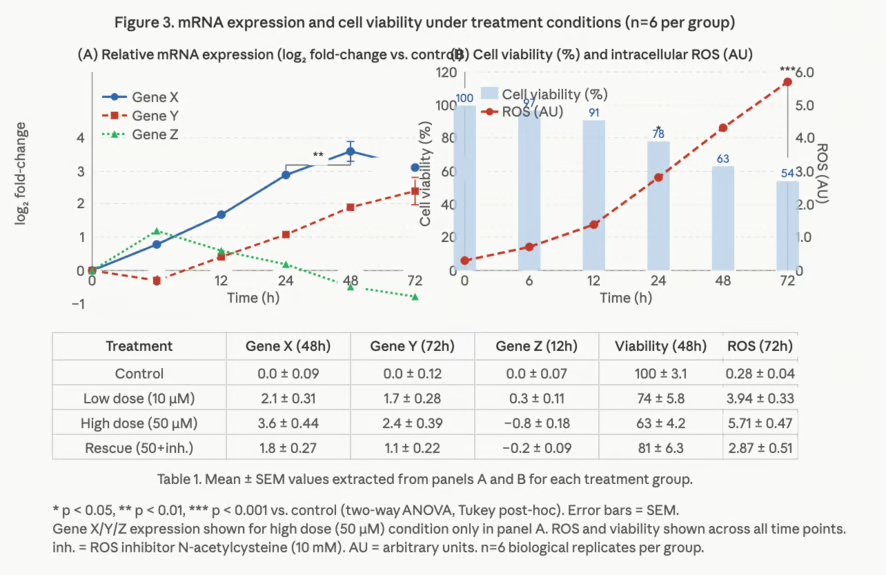
Pensábamos que sería complicado. Los dos ejes y de la figura B usan escalas y unidades distintas. En algunos puntos, el Gen Z entra en valores log₂ negativos.
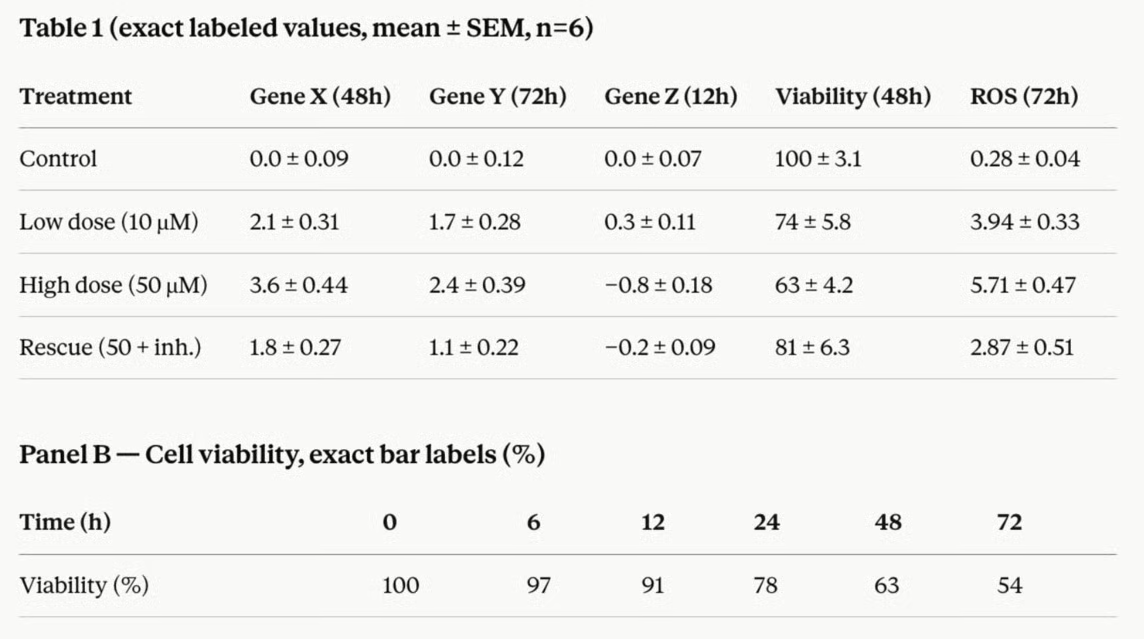
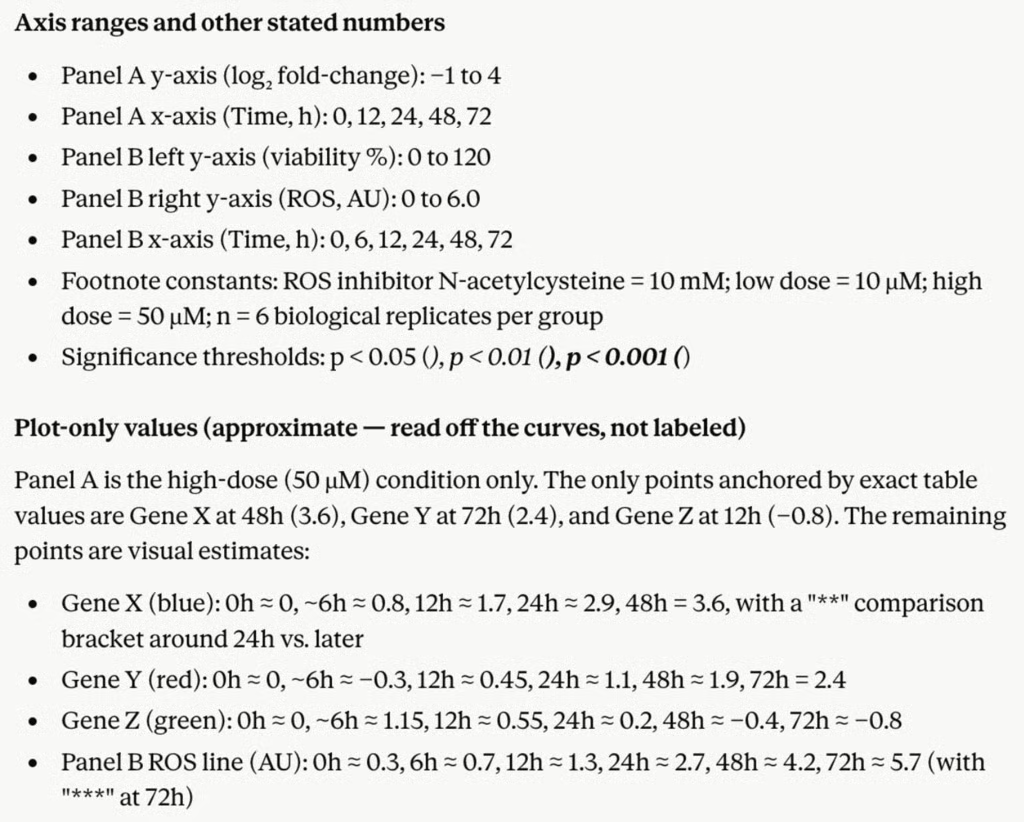
Pedimos a Fable 5 que extrajera todos los valores numéricos de ambos paneles y de la tabla.
please extract all numeric valuesEl resultado fue prácticamente perfecto. Mi propia tabla, con la que generé el gráfico, tenía para el Gen Z un valor de -0,05 a las 48 horas. Fable 5 me dijo que en ese punto era -0,04, no -0,05.
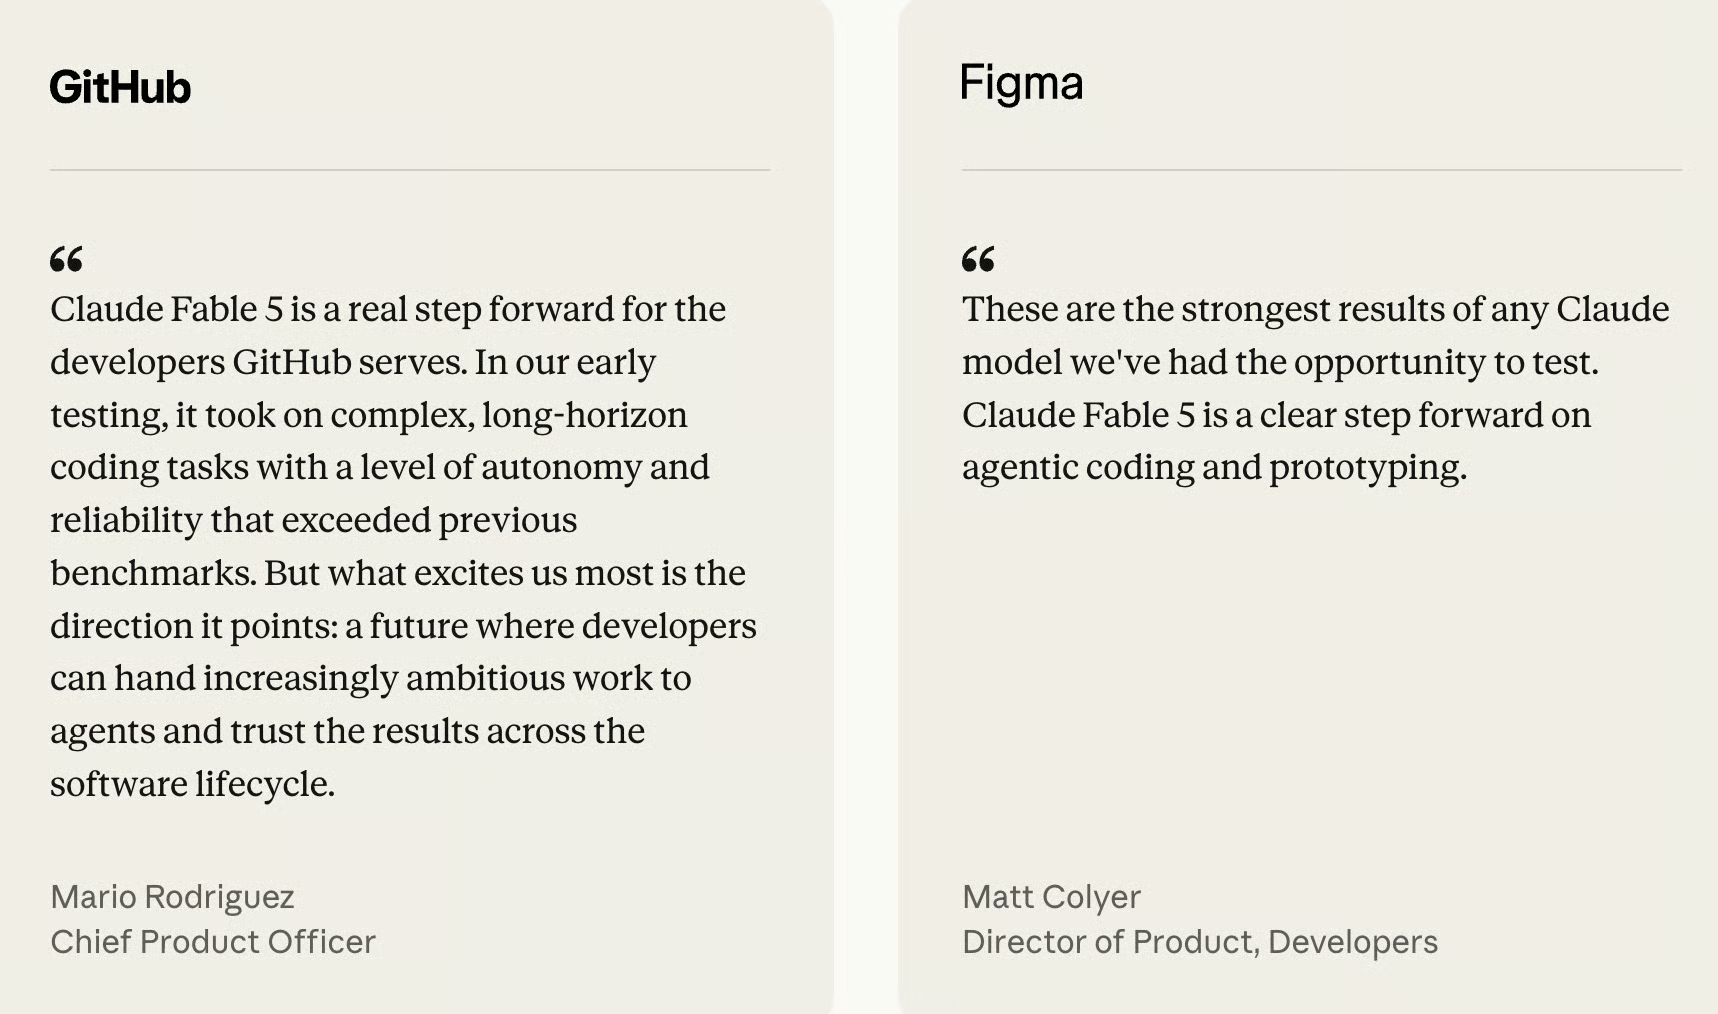
En el anuncio, Anthropic muestra comentarios tempranos/testimonios de producto de clientes o socios como GitHub y Figma. Son positivos, como era de esperar. En cada lanzamiento de modelos de Anthropic hay una sección así.
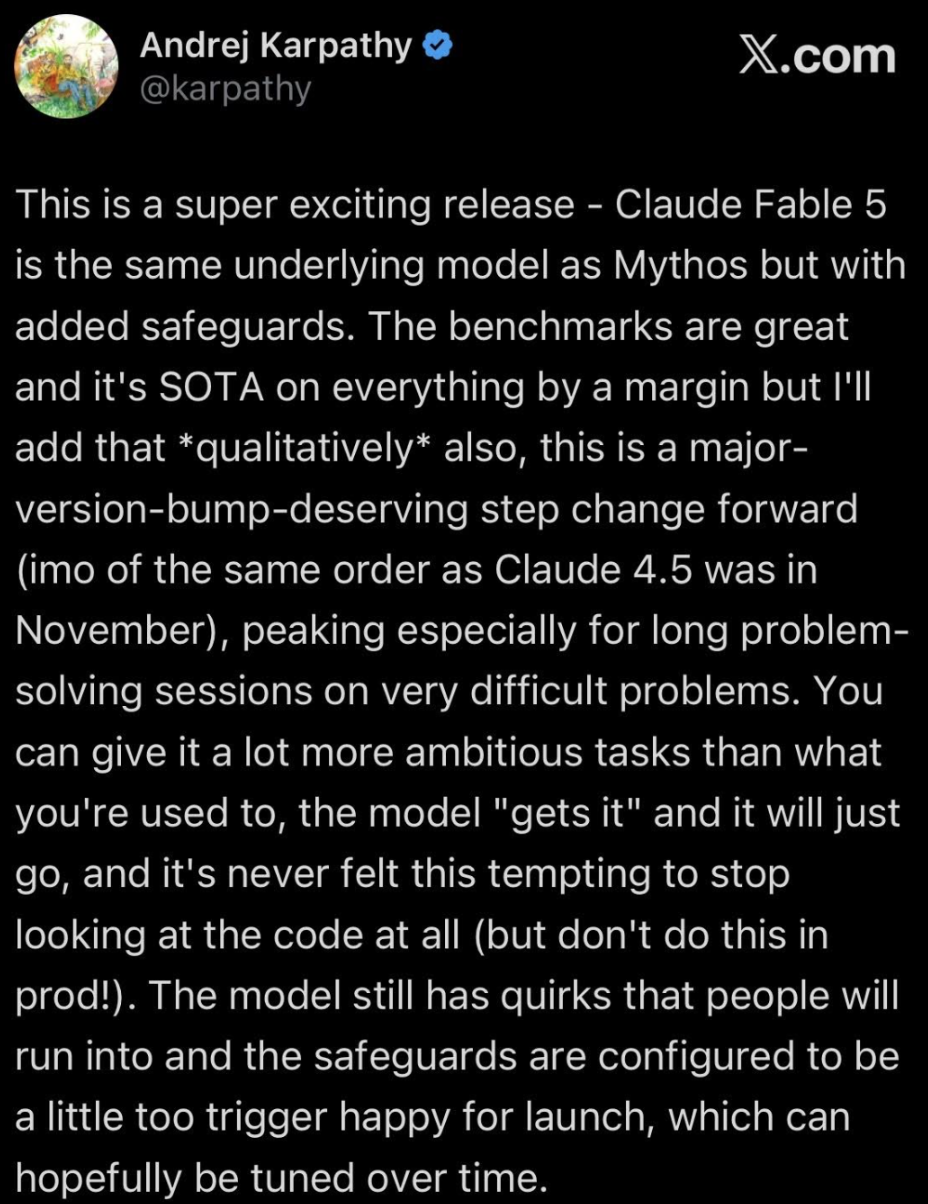
X nos ofrece opiniones menos filtradas. Lo primero que destaca: Andrej Karpathy ha hecho una reseña prácticamente entusiasta, reconociendo que Fable 5 es el estado del arte en todos los benchmarks relevantes con margen, y señalando además que el modelo supone un salto de nivel similar al de Opus 4.5 en noviembre. En el resto del hilo, da un buen puñado de ideas para usar Fable 5, como:
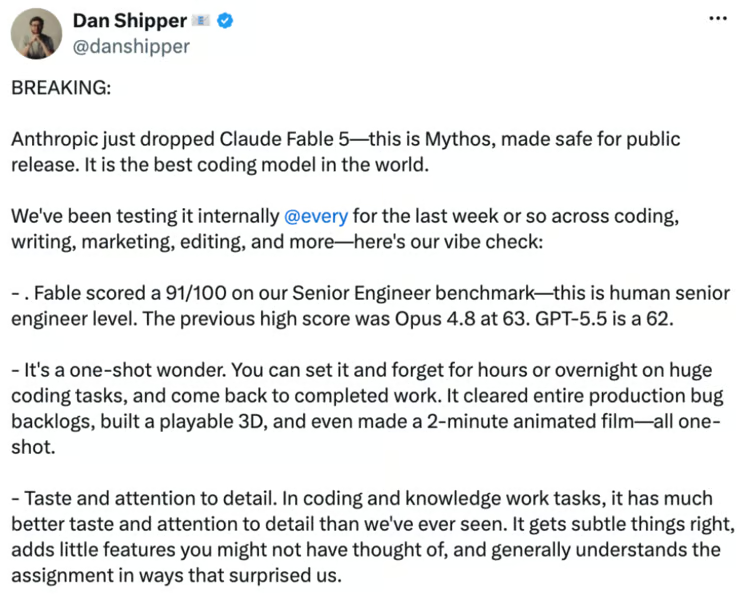
Dan Shipper, CEO de Every, dice algo parecido: Fable 5 arrasa en los benchmarks y es un “one-shot wonder”: puedes asignarle un gran proyecto y, al día siguiente, tener trabajo terminado. (Tuvo acceso anticipado, de ahí su experiencia.)
También aporta un punto crítico para equilibrar: dice que el modelo es lento y devora tokens; en otras palabras, es caro. Afirma que cuesta el doble que Opus. Así que, con buen criterio, recomienda usarlo solo cuando la tarea lo requiera.
Comenté que Claude Fable 5 es Claude Mythos 5, pero con salvaguardas. Es decir, Fable 5 es tan potente que, sin restricciones, podría ofrecer ayuda significativa a actores malintencionados en áreas como ciberseguridad y biología. Esa es la tesis.
Así funcionan las salvaguardas a alto nivel. Es un sistema de dos clasificadores:
Los clasificadores cubren tres áreas principales.
Observa el antes/después de las salvaguardas en un solo gráfico. Las barras rosas son Claude Mythos 5 sin salvaguardas —el modelo bruto subyacente—. Es extremadamente capaz en los cuatro benchmarks: 88,4% en desarrollo de exploits para Firefox, 83,8% en reproducción de vulnerabilidades en CyberGym, etc.
Las barras naranjas son Claude Fable 5 con los clasificadores activos, todas al 0,0% en cada benchmark. Las salvaguardas aplanan el rendimiento, que es lo deseado: cero es el objetivo.
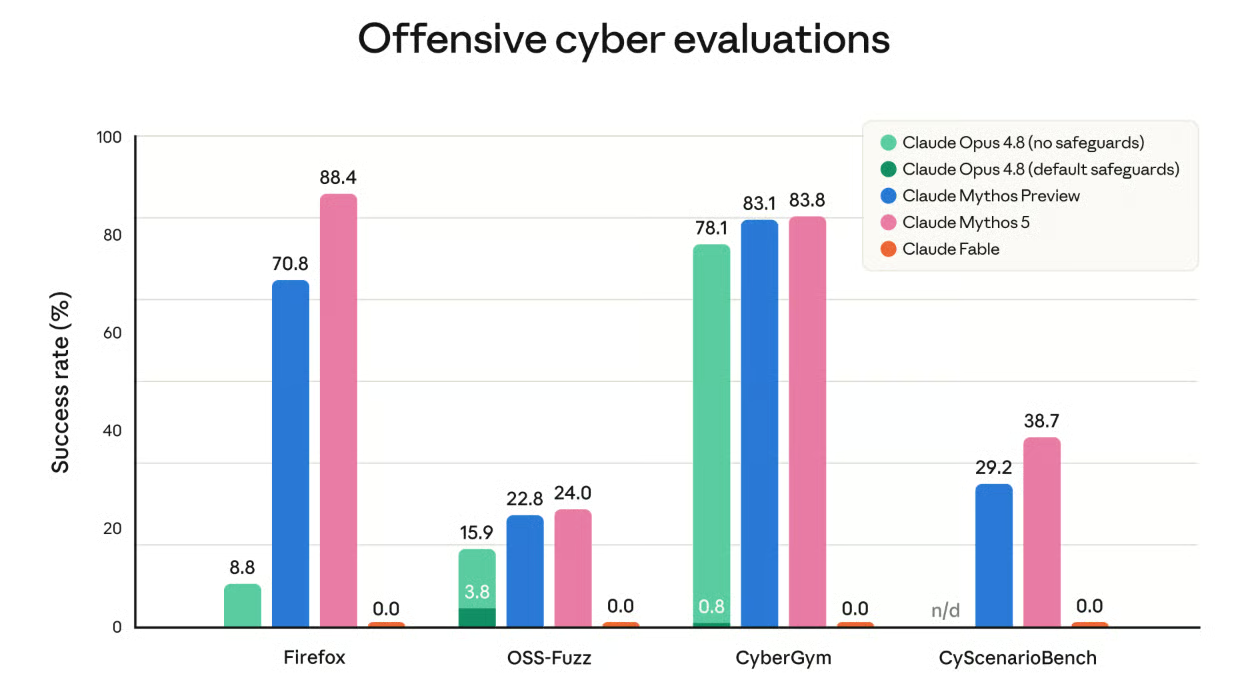
Este gráfico me gusta porque sitúa a Opus 4.8 en contexto. Incluso sin salvaguardas, Opus 4.8 puntúa bastante por debajo de Mythos 5. Esto muestra por qué eran necesarios los clasificadores desde el principio. El salto de capacidad entre Opus y Mythos es lo que hacía arriesgado y retrasaba el lanzamiento amplio.
Si tienes un plan Pro, Max, Team o Enterprise, Fable 5 está disponible ahora mismo sin coste adicional —pero solo hasta el 22 de junio.
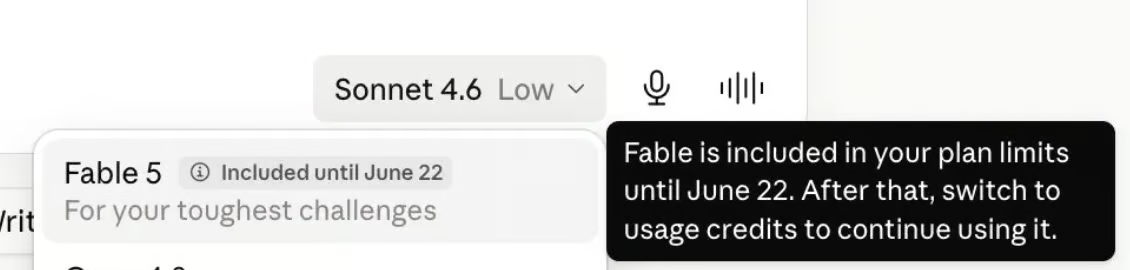
Después del 22 de junio, el acceso requerirá usage credits, el sistema de pago por uso de Anthropic que se añade a tu suscripción actual. Probablemente por eso Dan Shipper nos advertía sobre los costes.
Para desarrolladores en el API, es más sencillo:
Si lo comparas con los precios estándar de Opus 4.8 (5 $ entrada / 25 $ salida), Fable 5 es efectivamente el doble de caro, como dice Dan. Pero si ya usas Opus 4.8 en modo rápido, Fable 5 cuesta lo mismo siendo un modelo más capaz.
Nota importante, por si te lo preguntas como me pasó a mí: cuando una consulta hace fallback a Opus 4.8 por el sistema de clasificadores de seguridad, se factura a la tarifa de Opus 4.8, no a la de Fable 5.
Claude Mythos 5, la versión Mythos sin salvaguardas, no está disponible para el público general. El acceso está restringido a socios de Project Glasswing.
Anthropic nos había puesto la miel en los labios con Project Glasswing y el sugerente nombre de los modelos Mythos. Pero durante meses, este modelo —el mejor del mundo, y realmente lo es— estuvo tras la valla de una colaboración gubernamental.
Eso ha cambiado, una semana después de que Anthropic presentara su solicitud de OPI en EE. UU. Ahora, el modelo de clase Mythos está disponible con un plan Pro. (El acceso también depende de usage credits. Consulta la última sección para todos los detalles.)
Dónde estamos: Anthropic tiene modelos lo bastante capaces como para causar daños serios sin restricciones. Sabemos que no es puro marketing porque la empresa ha construido todo un sistema paralelo de clasificadores para añadir salvaguardas.
Hacia dónde vamos: el techo de capacidad no deja de subir, los benchmarks se renuevan por versiones más duras y los ciclos de lanzamiento se acortan. Además, la infraestructura de salvaguardas se vuelve cada vez más sofisticada para compensar. Con la OPI posiblemente este año, habrá mucho debate sobre cómo la presión competitiva choca con las cuestiones de seguridad.
Aprende con DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
8 min
Tutorial
Zoumana Keita
15 min
Tutorial
Abid Ali Awan
Tutorial
Zoumana Keita
12 min
Tutorial
Moez Ali
11 min