Cours
Développement logiciel avec Claude Code
4 h
9.1K
S'entraîner et cursus vos progrès.
Continuer Avec GoogleMise à jour (1 juillet 2026) : l'accès à Claude Fable 5 a été rétabli ; il est désormais disponible dans le monde entier sur Claude Platform, Claude.ai, Claude Code et Claude Cowork, après la levée de l'ordre de contrôle des exportations. Mythos 5 reste réservé aux partenaires validés du projet Glasswing.
Mise à jour (2 septembre 2026) : Anthropic a publié le successeur du modèle. Découvrez tous les détails dans notre guide Claude Fable 5.1 et notre tutoriel API Claude Fable 5.1.
Nous avons entendu parler pour la première fois de Claude Mythos en avril, lors de la sortie de Claude Opus 4.7. Nous savions déjà qu'Opus 4.7, aussi impressionnant soit-il, n'était que le meilleur modèle disponible publiquement, car les modèles de classe Mythos étaient retenus d'une diffusion générale.
Anthropic nous propose aujourd'hui Claude Fable 5, un modèle de classe Mythos sûr pour un usage général. Il prend clairement la tête sur les principaux benchmarks : productivité intellectuelle, génie logiciel, recherche scientifique, etc. Un gros succès pour Anthropic, qui a déposé sa demande d'IPO aux États-Unis il y a seulement huit jours.
Dans cet article, nous allons passer en revue Claude Fable 5, le comparer aux autres modèles du marché, comme GPT-5.5 et Gemini 3.1 Pro, ainsi qu'aux modèles de Claude eux-mêmes, comme Opus 4.8. Nous vous donnerons aussi des conseils pour savoir quand l'utiliser, car il est plus coûteux. Si vous débutez avec Claude et voulez apprendre rapidement, consultez notre guide pour apprendre à utiliser Claude.
Claude Fable 5 est le nom que donne Anthropic à son modèle le plus récent et le plus performant. Il s'agit d'un modèle de classe Mythos, qui intègre toutefois des garde-fous essentiels, notamment en cybersécurité.
Pour l'utilisateur, cela signifie que certaines questions seront traitées par le modèle immédiatement inférieur, Claude Opus 4.8. Anthropic estime que ce déroutage intervient dans moins de 5 % des requêtes, une estimation jugée prudente — ce qui se comprend au vu des enjeux de cybersécurité. Et bien sûr, ce pourcentage varie fortement selon votre type d'usage.
Nous sommes particulièrement enthousiastes à propos de Claude Fable 5. Le modèle est désormais si compétent qu'il ouvre de nouveaux cas d'usage : des défenseurs cyber pourront s'en servir pour sécuriser des systèmes critiques, des chercheurs en sciences de la vie pour améliorer de nouveaux thérapeutiques, des astrophysiciens pour cartographier des galaxies. Et la liste continue.
Si vous avez lu l'annonce, vous avez peut-être aussi vu passer Claude Mythos 5. Pour résumer : Claude Mythos 5 repose sur le même modèle sous-jacent, mais avec certains garde-fous levés. Il n'est pas destiné au grand public : il est déployé dans le cadre du projet Glasswing en partenariat avec le gouvernement américain, remplaçant de fait Claude Mythos Preview. Nous en savons moins sur Claude Mythos 5, mais nous savons qu'il affiche les capacités de cybersécurité les plus élevées de tous les modèles disponibles. Le partenariat d'Anthropic avec le gouvernement américain en est une preuve en soi.
Fable 5 introduit plusieurs améliorations marquantes en matière de sécurité, de transparence, de mémoire et de gestion des données.
La principale nouveauté structurelle de Fable 5 est un système de classification en deux étapes conçu pour empêcher l'usage abusif de ses capacités les plus sensibles. Une sonde surveille les activations internes du modèle sur l'ensemble du trafic, et toute requête signalée est transmise à un classifieur LLM dédié qui tranche en dernier ressort. Lorsqu'une requête est bloquée, elle est redirigée vers Opus 4.8 au lieu d'être refusée, afin que l'utilisateur reçoive tout de même une réponse utile.
Dans la même veine : lorsque les classifieurs de Fable 5 redirigent une requête vers Opus 4.8, les utilisateurs sont informés du modèle qui a traité leur demande. Ce nouveau mécanisme de transparence évite de se demander pourquoi une réponse pourrait sembler différente.
Fable 5 peut écrire des notes dans un fichier en cours de tâche et s'y référer ensuite, ce qui diffère d'une simple fenêtre de contexte étendue. C'est une mémoire de travail active. Les tests internes d'Anthropic montrent un gain de performance nettement supérieur à celui observé avec Opus 4.8.
Anthropic introduit une politique de rétention des données de 30 jours applicable à tout le trafic Fable 5. Les données sont conservées pour détecter de nouveaux jailbreaks et réduire les faux positifs. Anthropic précise que ces données ne servent pas à entraîner les modèles et que tout accès humain est journalisé.
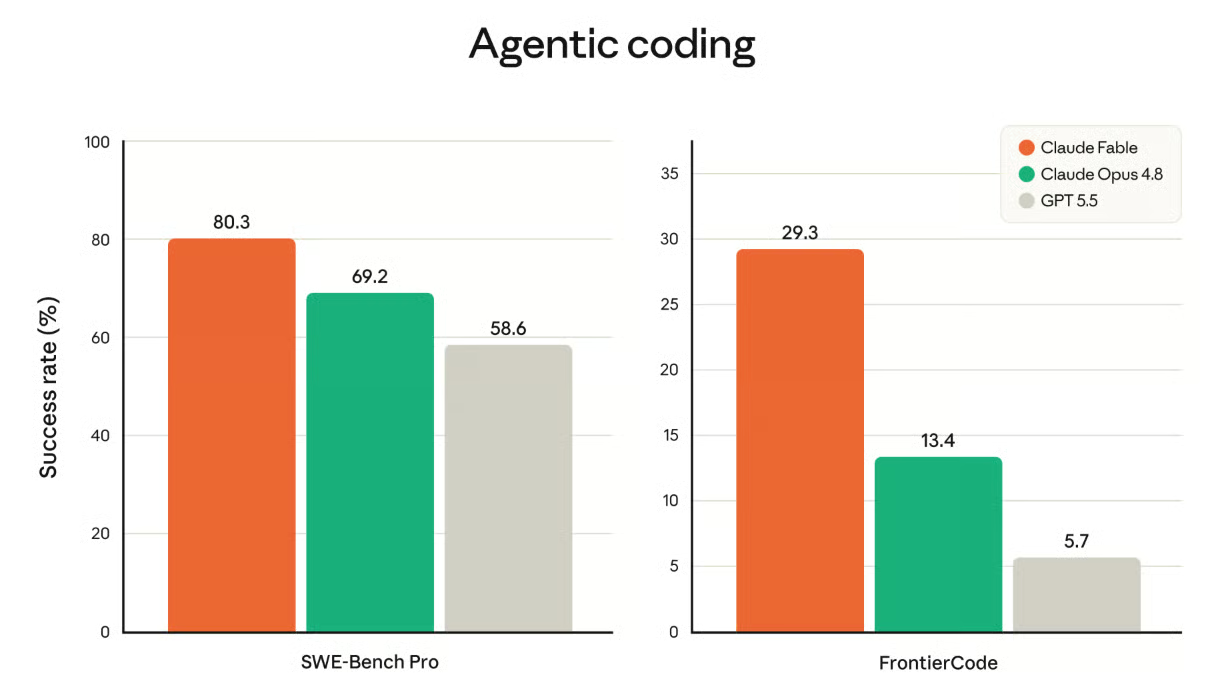
Claude Fable 5 s'impose nettement sur l'ensemble des benchmarks que nous suivons de près. Sur SWE-Bench Pro, il atteint 80,3 %, devant les 69,2 % d'Opus 4.8. Sur Humanity's Last Exam avec outils, il obtient 64,5 %, contre 57,9 % pour Opus 4.8 et 52,2 % pour GPT-5.5.
| Catégorie | Benchmark | Claude Mythos 5 / Fable 5 | Claude Mythos Preview | Claude Opus 4.8 | GPT 5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|---|---|
| Programmation agentique | SWE-Bench Pro | 80,3 % | 77,8 % | 69,2 % | 58,6 % | 54,2 % |
| Programmation agentique | FrontierCode (Diamond) | 29,3 % (xhigh) | — | 13,4 % (xhigh) | 5,7 % (xhigh) | — |
| Travail de connaissance | GDPval-AA | 1932 | — | 1890 | 1769 | 1314 |
| Travail de connaissance vision | GDP.pdf | 29,8 % (sans outils) | — | 22,5 % (sans outils) | 24,9 % (sans outils) | 16,7 % (sans outils) |
| Raisonnement spatial | Blueprint-Bench 2 | 38,6 % | — | 14,5 % | 36,2 % | 26,5 % |
| Utilisation d'outils | AutomationBench | 17,4 % | — | 15,5 % | 12,9 % | 9,6 % |
| Utilisation de l'ordinateur | OSWorld-Verified | 85,0 % | 85,4 % | 83,4 % | 78,7 % | 76,2 % |
| Légal | Legal Agent Benchmark | 13,3 % | — | 10,4 % | 2,1 % | 0,0 % |
| Raisonnement pluridisciplinaire | Humanity's Last Exam (sans outils) | 59,0 %* | 56,8 % | 49,8 % | 41,4 % | 44,4 % |
| Raisonnement pluridisciplinaire | Humanity's Last Exam (avec outils) | 64,5 %* | 64,7 % | 57,9 % | 52,2 % | 51,4 % |
| Biologie | BioMysteryBench (difficile) | 46,1 %* | 29,6 % | 40,0 % | — | — |
| Biologie | BioMysteryBench (résolu par l'humain) | 83,9 %* | 82,6 % | 80,4 % | — | — |
| Programmation agentique | Terminal-Bench 2.1 | 88,0 %* | — | 82,7 % | 83,4 % (Codex CLI) | 70,7 % (Gemini CLI) |
| Cybersécurité | ExploitBench (Cap %) | 78,0 %* | 69,0 % | 40,0 % | 34,0 % | — |
| Santé | HealthBench Professional | 66,0 %* | 64,7 % | 56,9 % | 51,8 % | — |
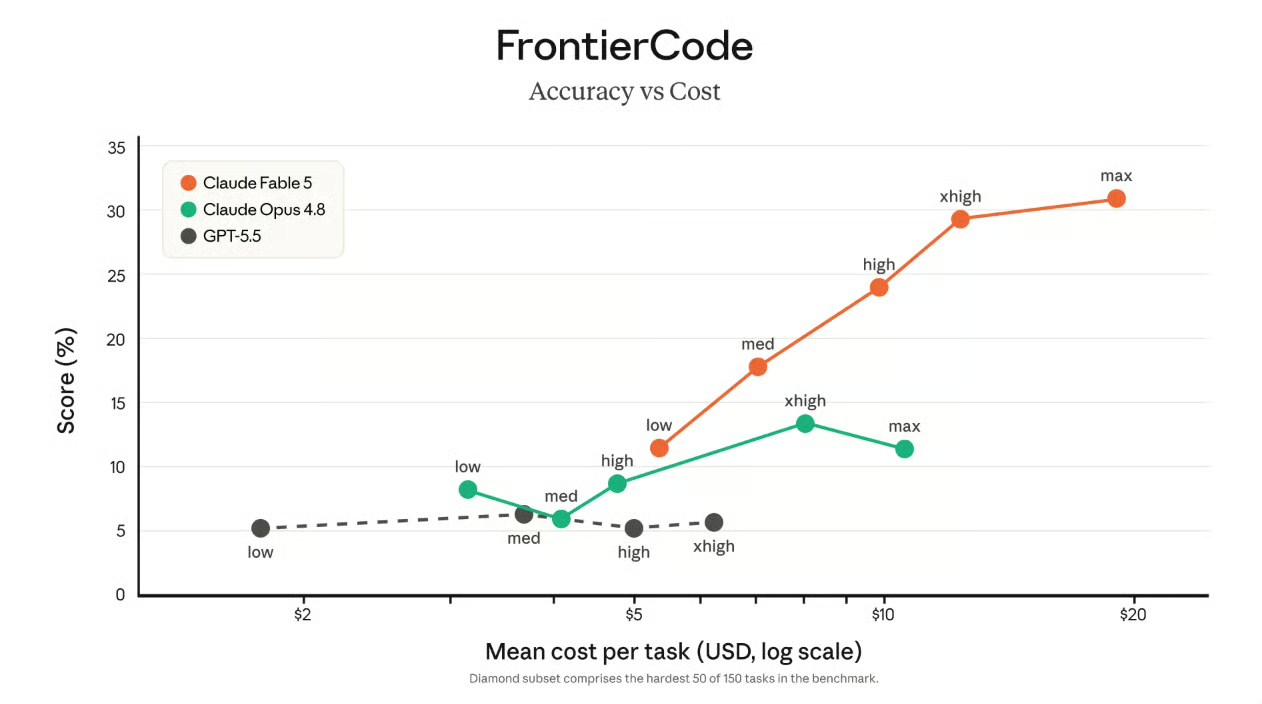
J'ai mentionné le benchmark FrontierCode sans entrer dans le détail. FrontierCode évalue la capacité d'un modèle non seulement à réussir un test de code (ce qui est déjà difficile), mais aussi à respecter des standards généraux de qualité pour du code de production : performance à l'échelle, style idiomatique, architecture propice à la maintenabilité long terme, etc.
Claude Fable 5 obtient le meilleur score au test FrontierCode, sans même recourir aux paramètres d'effort high ou xhigh.
Claude Fable 5 est le nouveau référent pour les tâches de vision. Dans les tests d'Anthropic, Fable 5 a pu reconstituer le code source d'une application web à partir de simples captures d'écran, sans échafaudage supplémentaire. C'est la même compétence qui se reflète dans son score de 93,2 % sur CharXiv Reasoning avec outils.
Le modèle Fable 5 excelle aussi sur un problème que beaucoup rencontrent : il extrait des valeurs numériques précises à partir de figures scientifiques détaillées, avec très peu d'erreurs.
Nous avons beaucoup parlé cette année de la mémoire des modèles d'IA et de leurs capacités de long contexte. Avec Fable 5, Anthropic apporte de nouvelles avancées.
D'abord, Fable 5 reste concentré sur des millions de tokens. Pour rappel, lors de longues tâches, les modèles d'IA peuvent « oublier » des éléments du contexte initial. Fable 5 maintient un comportement cohérent et stable, même lorsque la tâche s'étire. Et quand on dit long, on parle d'ordre de grandeur : un million de tokens, c'est un roman de 700 pages.
Anthropic indique aussi, fait intéressant, que Fable 5 améliore ses sorties grâce à ses propres notes. Le modèle peut donc consigner des informations en cours de tâche (par exemple dans un fichier) et s'y référer ensuite. Comme une personne qui prend des notes en résolvant un problème. Ce n'est pas la même chose qu'une simple mémoire longue : le modèle utilise un stockage externe comme outil de pensée.
Le tableau ci-dessus montre déjà Fable 5 en tête dans chaque catégorie. La bonne question, c'est la forme de cet avantage : où l'écart est abyssal, où il se joue à pile ou face, et pourquoi.
GPT-5.5 est le concurrent le plus proche, et sur beaucoup de tâches les deux se tiennent. Sur Blueprint-Bench 2 (raisonnement spatial), GPT-5.5 obtient 36,2 contre 38,6 pour Fable 5. Ils restent proches même sur des tâches agentiques longues, tant que le modèle reçoit du feedback au fil de l'eau. Sur Terminal-Bench 2.1, où le terminal signale immédiatement les erreurs, on a 83,4 contre 88,0.
Une situation fait exception : une tâche longue évaluée uniquement à la fin. Le modèle ne peut pas corriger ses erreurs en cours de route, elles s'accumulent, et le plus fort prend le large. SWE-Bench Pro l'illustre le mieux : 58,6 pour GPT-5.5 contre 80,3 pour Fable 5.
Pour une comparaison approfondie, lisez notre article : Claude Fable 5 vs GPT-5.5 : benchmarks, prix et comment choisir.
Gemini 3.1 Pro est derrière Fable 5 sur toute la ligne, et l'écart se creuse sur les tâches qui comptent le plus. Sur GDPval-AA (travail de connaissance), il affiche 1314 contre 1932 pour Fable 5. Sur Terminal-Bench 2.1, 70,7 contre 88,0. L'écart est plus réduit sur des tâches courtes et circonscrites — raisonnement spatial : 26,5 contre 38,6 — mais ne se referme jamais. Tout indique un modèle à l'aise sur des problèmes courts, mais qui perd le fil sur des workflows longs et riches en outils, là où Fable 5 excelle.
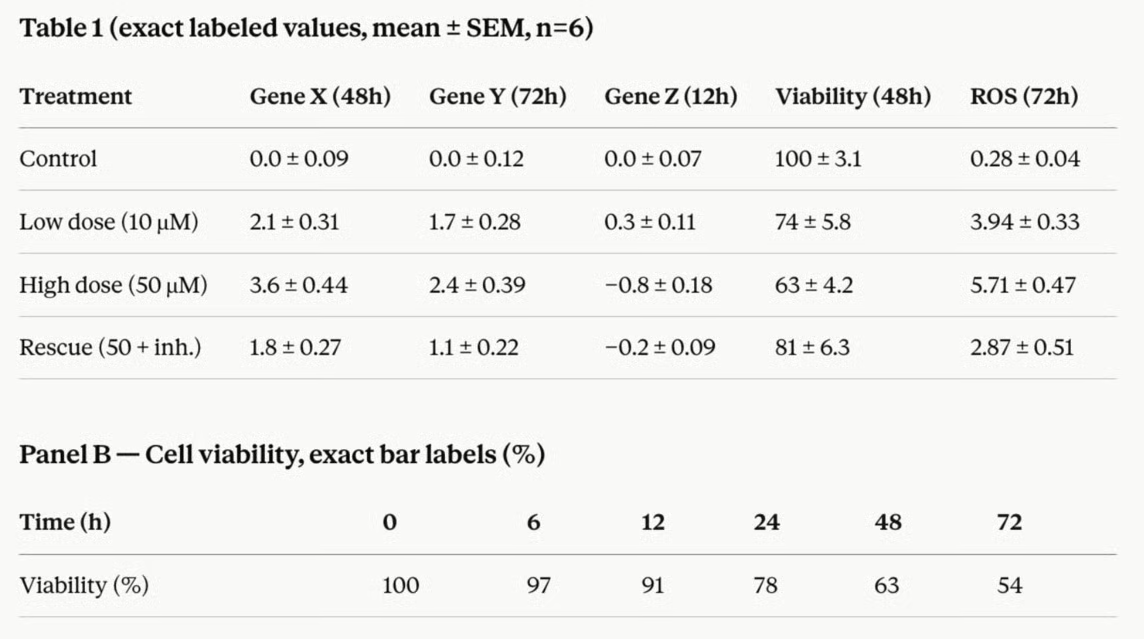
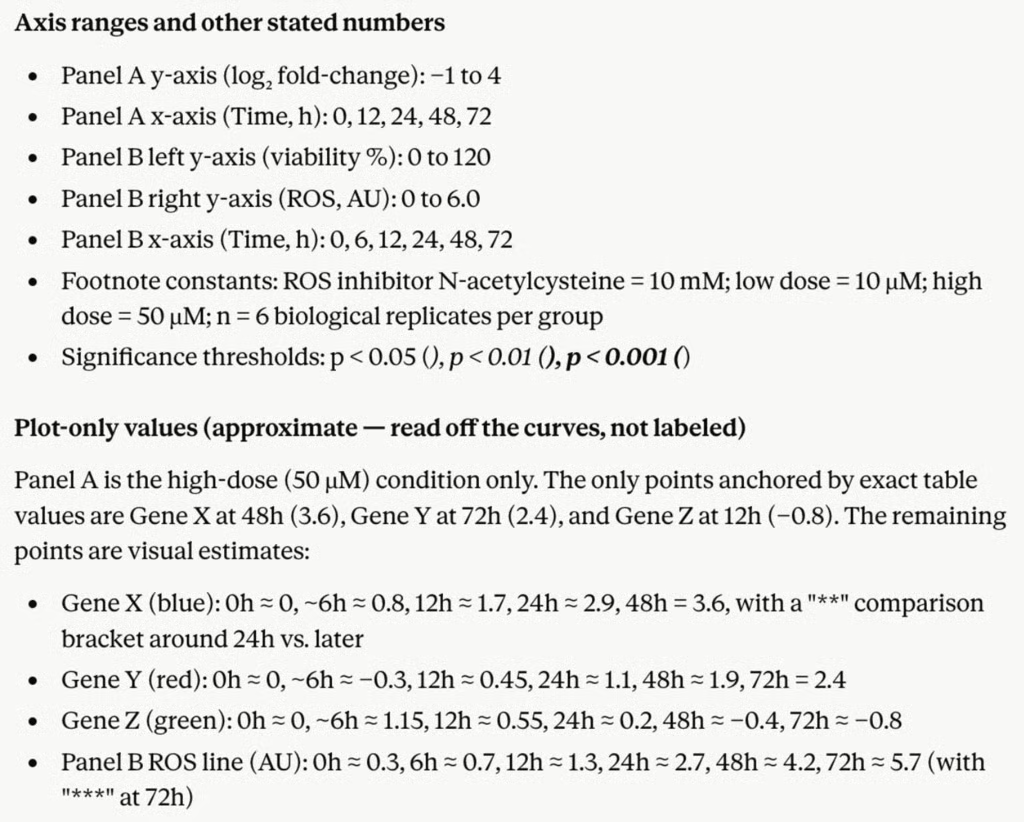
L'une des affirmations précises d'Anthropic est que Fable 5 sait extraire des valeurs numériques précises à partir de figures scientifiques détaillées, avec très peu d'erreurs.
Pour le vérifier, nous avons créé une figure scientifique en deux panneaux, inspirée de ce qu'on trouve dans des articles de biologie cellulaire : séries temporelles d'expression génique superposées sur un axe log₂, panneau à double axe y combinant pourcentages et unités arbitraires, etc.
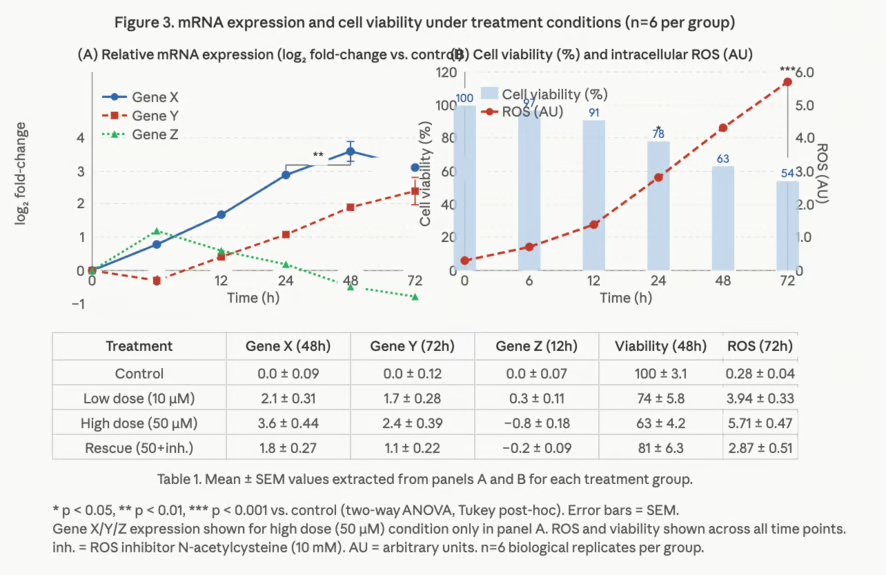
Nous pensions que ce serait piègeux. Les deux axes y du panneau B utilisent des échelles et des unités différentes. Le gène Z passe en log₂ négatif par endroits.
Nous avons demandé à Fable 5 d'extraire toutes les valeurs numériques des deux panneaux et du tableau.
please extract all numeric valuesLe résultat a été quasiment parfait. Mon tableau à l'origine du graphique indiquait une valeur de -0,05 pour le gène Z à 48 heures. Fable 5 m'a donné -0,04 à ce point, et non -0,05.
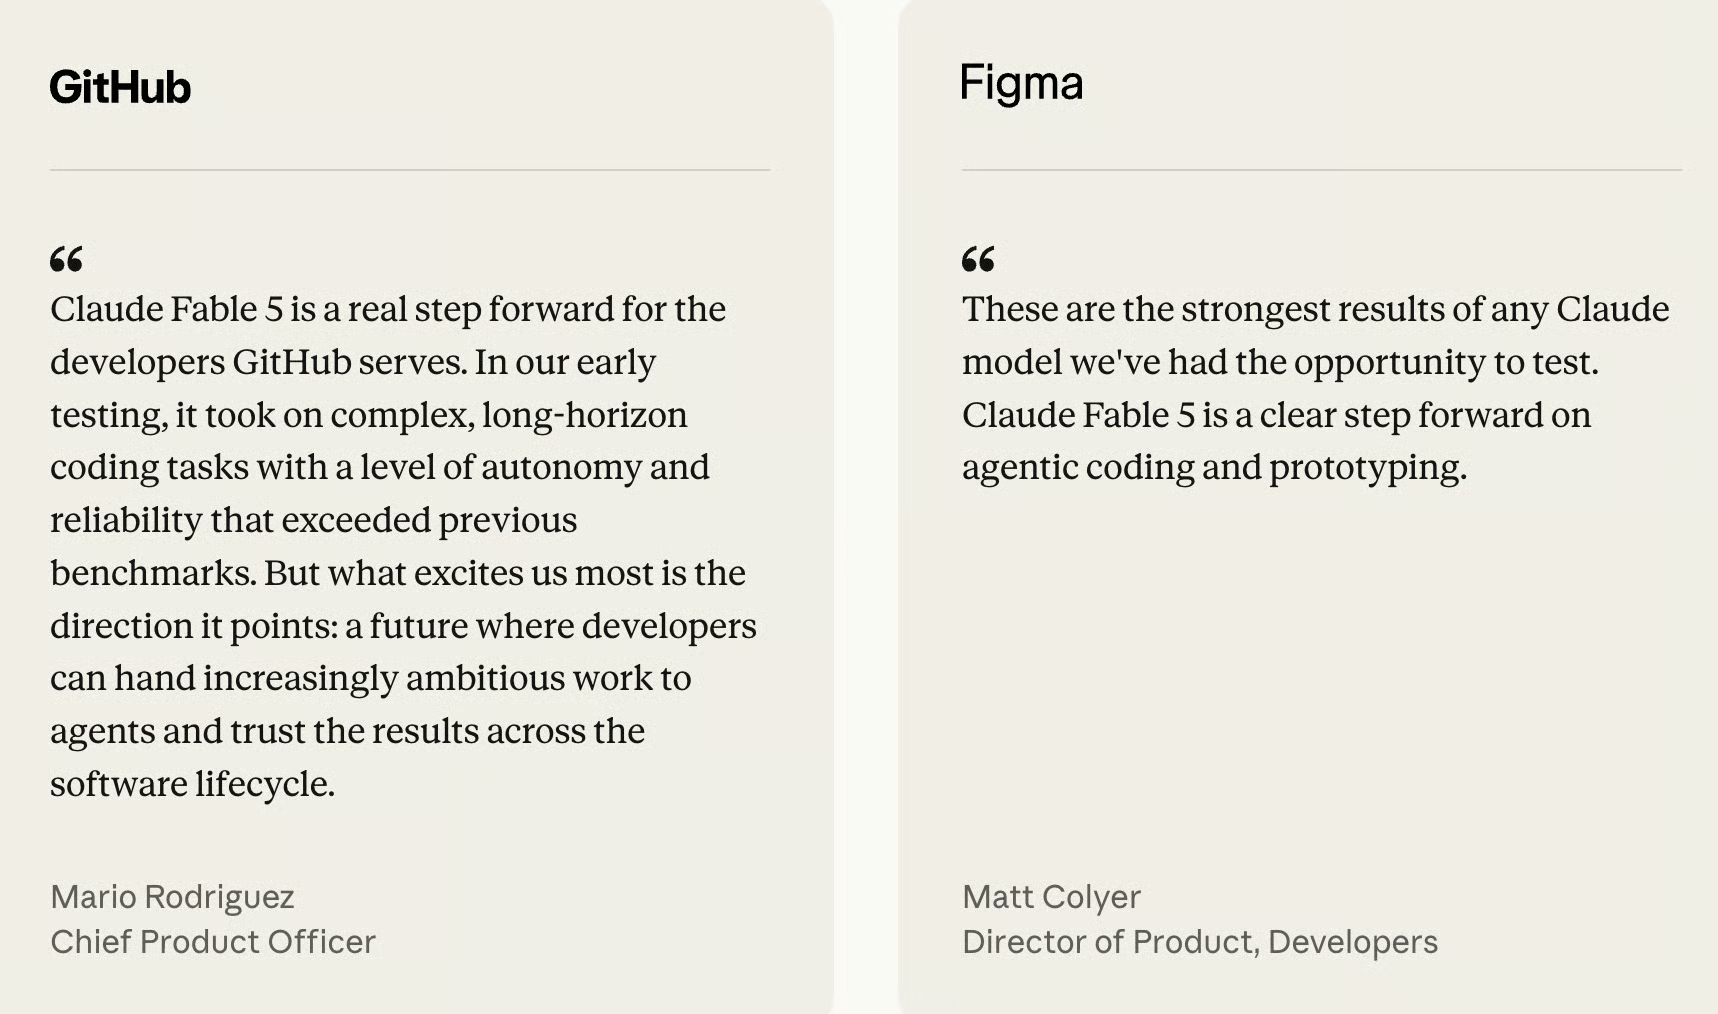
Dans son annonce, Anthropic met en avant des retours d'accès anticipé / témoignages clients ou partenaires, comme GitHub et Figma. C'est positif, sans surprise : chaque sortie de modèle Anthropic comporte cette section.
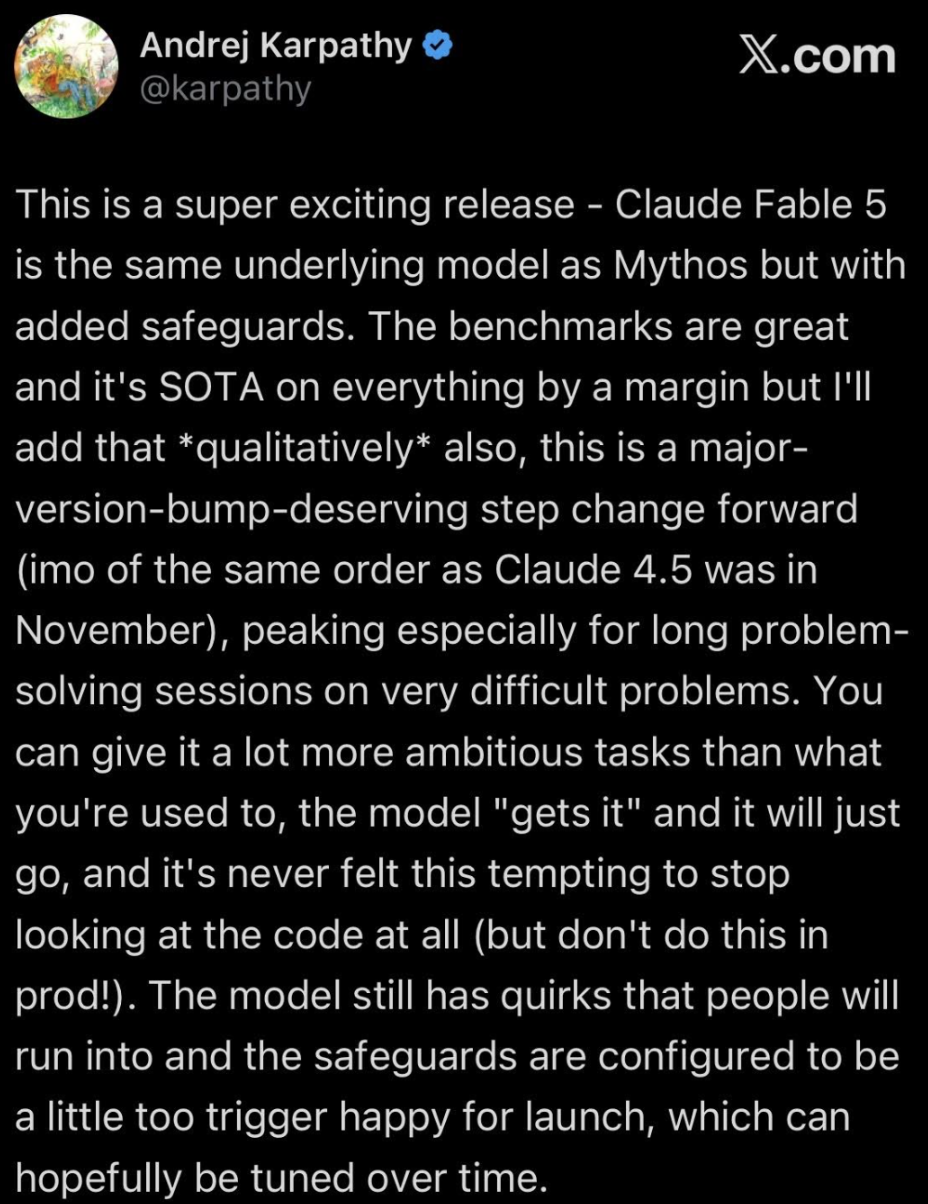
X offre une vision moins « curée ». Ce qui saute aux yeux : Andrej Karpathy a livré un avis quasi dithyrambique, reconnaissant que Fable 5 est à l'état de l'art sur tous les benchmarks pertinents avec une marge, et parlant d'un changement de palier comparable à Opus 4.5 en novembre. Il partage aussi plusieurs idées d'usage de Fable 5, comme :
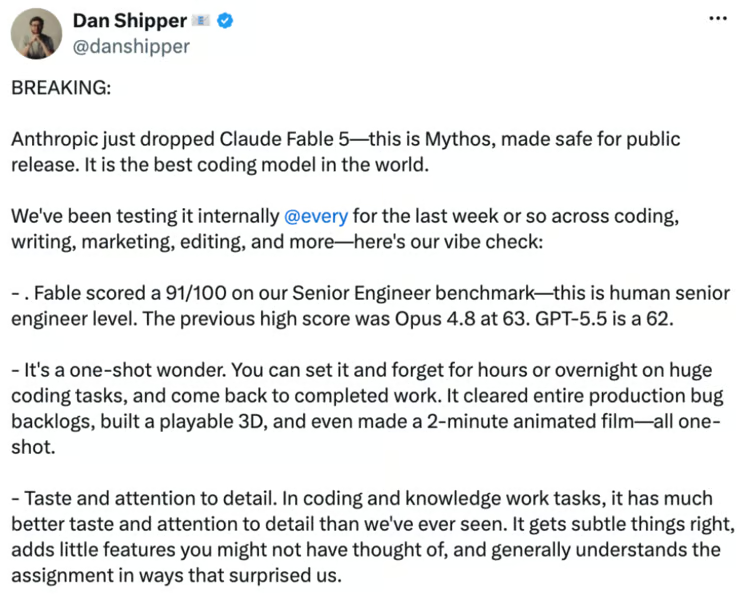
Dan Shipper, CEO d'Every, tient un discours similaire : Fable 5 a écrasé les benchmarks et c'est un « one-shot wonder » : vous pouvez le lancer sur un gros projet, revenir le lendemain matin et trouver le travail effectué. (Il y a eu accès en amont, d'où ses retours.)
Il nuance toutefois : le modèle est lent et gourmand en tokens, donc plus cher. Selon lui, il coûte deux fois plus qu'Opus. Conclusion très juste : ne l'utilisez que lorsque c'est nécessaire.
Nous l'avons dit : Claude Fable 5, c'est Claude Mythos 5 avec des garde-fous. Autrement dit, Fable 5 est suffisamment puissant pour, sans restrictions, apporter une aide tangible à des acteurs malveillants en cybersécurité ou en biologie. C'est l'hypothèse prise au sérieux.
Voici comment fonctionnent ces garde-fous, à haut niveau : un système de classification en deux étapes :
Ces classifieurs couvrent trois domaines principaux.
Voici l'avant/après des garde-fous en un seul visuel : les barres roses représentent Claude Mythos 5 sans garde-fous — le modèle brut. Il est extrêmement compétent sur les quatre benchmarks : 88,4 % sur le développement d'exploits Firefox, 83,8 % sur la reproduction de vulnérabilités CyberGym, etc.
Les barres orange représentent Claude Fable 5 avec classifieurs actifs : elles sont à 0,0 % partout. Les garde-fous « aplatissent » la performance, et c'est l'objectif : viser zéro.
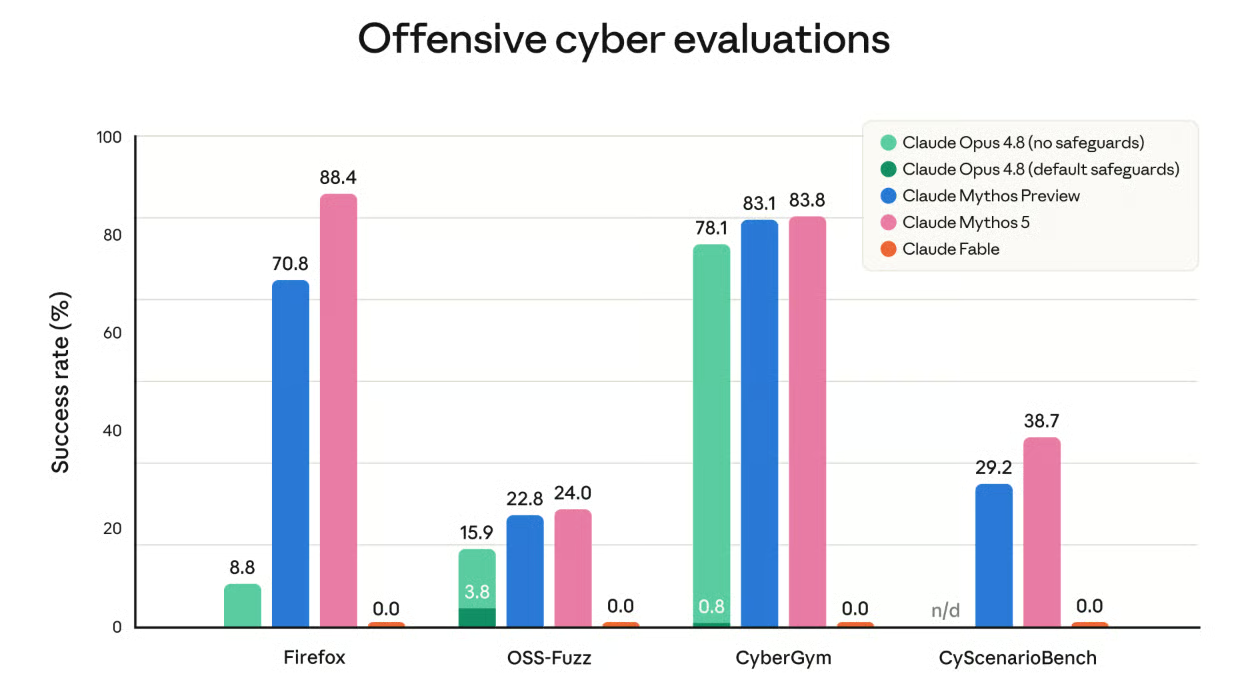
Ce graphique remet aussi Opus 4.8 en perspective. Même sans garde-fous, Opus 4.8 obtient des scores bien inférieurs à Mythos 5. On comprend mieux pourquoi des classifieurs étaient nécessaires : le saut de capacité entre Opus et Mythos rendait une diffusion large risquée et a retardé la sortie.
Si vous êtes sur un forfait Pro, Max, Team ou Enterprise, Fable 5 est disponible immédiatement, sans coût supplémentaire — mais seulement jusqu'au 22 juin.
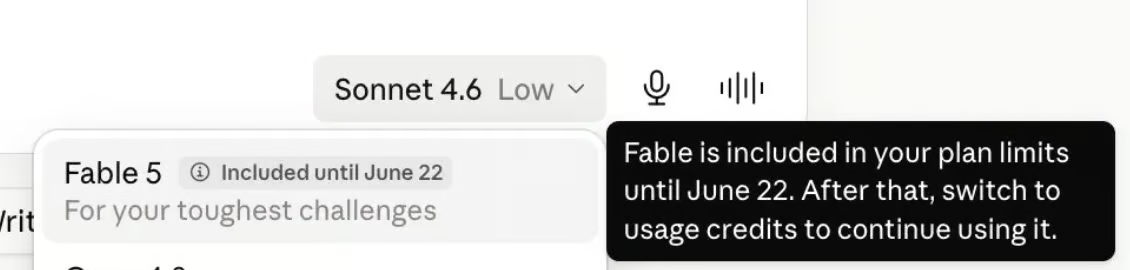
Après le 22 juin, l'accès nécessitera des crédits d'usage, le système à la consommation d'Anthropic qui vient s'ajouter à votre abonnement. C'est probablement l'une des raisons pour lesquelles Dan Shipper nous alerte sur les coûts.
Pour les développeurs via l'API, c'est plus simple :
Comparé à la tarification standard d'Opus 4.8 (5 $ entrée / 25 $ sortie), Fable 5 coûte bien le double, comme le dit Dan. Mais si vous utilisez déjà Opus 4.8 en mode rapide, Fable 5 revient au même prix tout en étant plus capable.
Point important : quand une requête bascule vers Opus 4.8 via le système de classifieurs de sécurité, la facturation se fait aux tarifs d'Opus 4.8, pas à ceux de Fable 5.
Claude Mythos 5, la version Mythos sans garde-fous, n'est pas accessible au grand public. L'accès est réservé aux partenaires du projet Glasswing.
Anthropic nous avait mis l'eau à la bouche avec le projet Glasswing et le modèle au nom évocatéur, Mythos. Pendant des mois, ce modèle parmi les meilleurs — et il l'est vraiment — est resté derrière un partenariat gouvernemental.
C'est désormais du passé, une semaine après le dépôt d'IPO d'Anthropic aux États-Unis. Le modèle de classe Mythos est accessible avec un forfait Pro. (L'accès dépend aussi de crédits d'usage : voir la section précédente.)
Où nous en sommes : Anthropic dispose de modèles assez puissants pour causer des préjudices sérieux sans restrictions. Ce n'est pas du marketing : l'entreprise a conçu tout un système de classifieurs parallèles pour instaurer des garde-fous.
Où nous allons : le plafond de capacité ne cesse de monter, les benchmarks sont régulièrement remplacés par des versions plus dures, et le rythme des sorties s'accélère. En miroir, l'infrastructure de sécurité se complexifie pour compenser. Avec une IPO peut-être dès cette année, le débat sera vif entre pression concurrentielle et impératifs de sécurité.
Formez-vous avec DataCamp
Cours
Cours
S'entraîner et cursus vos progrès.
Continuer Avec Googleblog
blog
Lynn Heidmann
blog
Kurtis Pykes
9 min
blog
Nathaniel Taylor-Leach
8 min
blog
Zoumana Keita
15 min
Tutoriel