
कॉन्टेक्स्ट इंजीनियरिंग क्या है?
कॉन्टेक्स्ट इंजीनियरिंग वह अभ्यास है जिसमें ऐसे सिस्टम डिज़ाइन किए जाते हैं जो तय करते हैं कि किसी AI मॉडल को उत्तर जनरेट करने से पहले कौन-सी जानकारी दिखाई जाएगी।
भले ही शब्दावली नई हो, पर कॉन्टेक्स्ट इंजीनियरिंग के पीछे के सिद्धांत काफी समय से मौजूद हैं। यह नया अमूर्त ढाँचा हमें AI सिस्टमों में आने-जाने वाले सूचना प्रवाह के सबसे महत्वपूर्ण और सर्वव्यापी पहलू पर ठोस ढंग से विचार करने देता है।
व्यक्तिगत अनुरोधों के लिए परफेक्ट प्रोम्प्ट लिखने के बजाय, आप ऐसे सिस्टम बनाते हैं जो कई स्रोतों से प्रासंगिक विवरण जुटाते हैं और उन्हें मॉडल की कॉन्टेक्स्ट विंडो में व्यवस्थित करते हैं। यानी आपका सिस्टम बातचीत का इतिहास, उपयोगकर्ता डेटा, बाहरी दस्तावेज़ और उपलब्ध टूल्स को साथ लाकर ऐसे फ़ॉर्मैट में रखता है कि मॉडल उनके साथ काम कर सके।
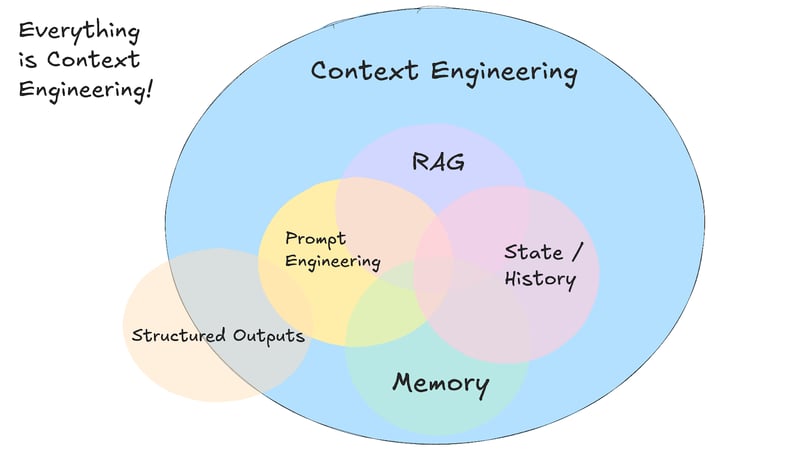
स्रोत: 12-factor-agents
यह दृष्टिकोण उस पूर्ण कॉन्टेक्स्ट की कई अलग-अलग प्रकार की जानकारियों का प्रबंधन करने की माँग करता है, जो मिलकर पूरा परिप्रेक्ष्य बनाती हैं:
- व्यवहार और नियम तय करने वाली सिस्टम हिदायतें
- बातचीत का इतिहास और उपयोगकर्ता की प्राथमिकताएँ
- दस्तावेज़ों या डेटाबेस से प्राप्त की गई जानकारी
- उपलब्ध टूल्स और उनके विवरण
- संरचित आउटपुट फ़ॉर्मैट और स्कीमा
- रीयल-टाइम डेटा और बाहरी API प्रतिक्रियाएँ
मुख्य चुनौती कॉन्टेक्स्ट विंडो की सीमाओं में रहते हुए समय के साथ सुसंगत बातचीत बनाए रखना है। आपके सिस्टम को हर अनुरोध के लिए सबसे प्रासंगिक चीज़ें चुननी होती हैं, जिसका मतलब प्रायः ऐसे रिट्रीवल सिस्टम बनाना होता है जो ज़रूरत पड़ने पर सही विवरण ढूँढ सकें।
इसमें ऐसे मेमोरी सिस्टम बनाना शामिल है जो अल्पकालिक बातचीत के प्रवाह और दीर्घकालिक उपयोगकर्ता प्राथमिकताओं—दोनों को ट्रैक करें, साथ ही वर्तमान ज़रूरतों के लिए जगह बनाने हेतु अप्रासंगिक जानकारी हटाएँ।
असली लाभ तब मिलता है जब कॉन्टेक्स्ट के अलग-अलग प्रकार मिलकर अधिक बुद्धिमान और जागरूक लगने वाले AI सिस्टम बनाते हैं। जब आपका AI सहायक एक साथ पिछली बातचीतों का संदर्भ दे सके, आपका कैलेंडर देख सके, और आपकी संप्रेषण शैली समझ सके, तो इंटरैक्शन दोहरावदार नहीं लगते—बल्कि ऐसा लगता है कि आप किसी ऐसी चीज़ के साथ काम कर रहे हैं जो आपको याद रखती है।
कॉन्टेक्स्ट इंजीनियरिंग बनाम प्रोम्प्ट इंजीनियरिंग
यदि आप ChatGPT से “एक प्रोफ़ेशनल ईमेल लिखो” कहते हैं, तो वह प्रोम्प्ट इंजीनियरिंग है—आप एकल कार्य के लिए निर्देश लिख रहे हैं। लेकिन यदि आप ऐसा कस्टमर सर्विस बॉट बना रहे हैं जिसे पिछले टिकट याद रखने हैं, उपयोगकर्ता खाते का विवरण देखना है, और कई इंटरैक्शनों में बातचीत का इतिहास बनाए रखना है, तो वह कॉन्टेक्स्ट इंजीनियरिंग है।
आंद्रेज़ कारपथी इसे अच्छी तरह समझाते हैं:
लोग प्रोम्प्ट्स को छोटे-छोटे कार्य-विवरणों से जोड़कर देखते हैं जो आप अपने रोज़मर्रा के LLM उपयोग में देते हैं। जबकि हर इंडस्ट्रियल-ग्रेड LLM ऐप में, कॉन्टेक्स्ट इंजीनियरिंग अगली क़दम के लिए कॉन्टेक्स्ट विंडो को बिल्कुल सही जानकारी से भरने की नाज़ुक कला और विज्ञान है।
अधिकांश AI अनुप्रयोगों में प्रोम्प्ट इंजीनियरिंग और कॉन्टेक्स्ट इंजीनियरिंग—दोनों का उपयोग होता है। कॉन्टेक्स्ट इंजीनियरिंग सिस्टम के भीतर भी आपको अच्छे से लिखे प्रोम्प्ट्स की ज़रूरत रहती है। फ़र्क यह है कि अब वे प्रोम्प्ट्स हर बार नए सिरे से शुरू होने के बजाय, सावधानी से प्रबंधित पृष्ठभूमि जानकारी के साथ काम करते हैं।
|
दृष्टिकोण |
सबसे उपयुक्त उपयोग |
|
प्रोम्प्ट इंजीनियरिंग |
एकमात्र कार्य, सामग्री निर्माण, फ़ॉर्मैट-विशिष्ट आउटपुट |
|
कॉन्टेक्स्ट इंजीनियरिंग |
संवादी AI, दस्तावेज़ विश्लेषण टूल, कोडिंग असिस्टेंट |
|
दोनों साथ में |
ऐसे प्रोडक्शन AI अनुप्रयोग जिन्हें सुसंगत, विश्वसनीय प्रदर्शन चाहिए |
व्यवहार में कॉन्टेक्स्ट इंजीनियरिंग
कॉन्टेक्स्ट इंजीनियरिंग तब सिद्धांत से वास्तविकता बनती है जब आप AI अनुप्रयोग बनाना शुरू करते हैं जिन्हें जटिल, आपस में जुड़ी जानकारी के साथ काम करना होता है। मान लें एक कस्टमर सर्विस बॉट जिसे पिछले सपोर्ट टिकट्स तक पहुँच चाहिए, अकाउंट की स्थिति देखनी है, और उत्पाद दस्तावेज़ों का संदर्भ देना है—वह भी मददगार लहजा बनाए रखते हुए। यहीं पारंपरिक प्रोम्प्टिंग टूटने लगती है और कॉन्टेक्स्ट इंजीनियरिंग आवश्यक हो जाती है।
RAG सिस्टम
कॉन्टेक्स्ट इंजीनियरिंग की शुरुआत संभवतः रिट्रीवल ऑग्मेंटेड जेनरेशन (RAG) सिस्टमों से हुई। RAG शुरुआती तकनीकों में से एक थी जिसने LLMs को उनके मूल प्रशिक्षण डेटा का हिस्सा न रही जानकारी से परिचित कराना संभव किया।
RAG सिस्टम उन्नत कॉन्टेक्स्स्ट इंजीनियरिंग तकनीकों का उपयोग करके जानकारी को अधिक प्रभावी ढंग से व्यवस्थित और प्रस्तुत करते हैं। वे दस्तावेज़ों को सार्थक हिस्सों में तोड़ते हैं, प्रासंगिकता के आधार पर जानकारी को रैंक करते हैं, और सबसे उपयोगी विवरणों को टोकन सीमाओं के भीतर समेटते हैं।
RAG से पहले, यदि आप चाहते थे कि AI आपकी कंपनी के आंतरिक दस्तावेज़ों पर सवालों के जवाब दे, तो आपको पूरे मॉडल को फिर से प्रशिक्षित करना या फ़ाइन-ट्यून करना पड़ता था। RAG ने इसे बदल दिया—ऐसे सिस्टम बनाकर जो आपके दस्तावेज़ों में खोज कर सकें, प्रासंगिक टुकड़े ढूँढ सकें, और उन्हें आपके प्रश्न के साथ कॉन्टेक्स्ट विंडो में शामिल कर सकें।
इसका मतलब यह हुआ कि LLMs अचानक कई दस्तावेज़ों और स्रोतों का विश्लेषण करके जटिल प्रश्नों के उत्तर दे सकते थे—ऐसे प्रश्न जिनके लिए सामान्यतः इंसान को सैकड़ों पन्ने पढ़ने पड़ते।
AI एजेंट
RAG सिस्टमों ने बाहरी जानकारी तक रास्ता खोला, लेकिन AI एजेंट्स ने इसे आगे बढ़ाकर कॉन्टेक्स्ट को गतिशील और प्रतिक्रियाशील बना दिया। केवल स्थिर दस्तावेज़ों को रिट्रीव करने के बजाय, एजेंट बातचीत के दौरान बाहरी टूल्स का उपयोग करते हैं।
AI यह तय करता है कि मौजूदा समस्या को हल करने के लिए कौन-सा टूल सबसे उपयुक्त है। कोई एजेंट बातचीत शुरू कर सकता है, समझ सकता है कि उसे मौजूदा स्टॉक डेटा चाहिए, किसी फ़ाइनैंशियल API को कॉल कर सकता है, और फिर उसी ताज़ा जानकारी का उपयोग करते हुए बातचीत जारी रख सकता है।
LLM टोकन्स की घटती लागत ने मल्टी-एजेंट सिस्टम भी संभव बना दिए हैं। एक ही मॉडल की कॉन्टेक्स्ट विंडो में सबकुछ ठूँसने के बजाय, आप विशेषीकृत एजेंट रख सकते हैं जो किसी समस्या के अलग-अलग पहलुओं को सँभालें और आपस में A2A या MCP जैसे प्रोटोकॉल्स के माध्यम से जानकारी साझा कर सकें।
AI एजेंट्स के बारे में और जानने के लिए यह AI एजेंट्स चीट शीट देखें।
AI कोडिंग असिस्टेंट
AI कोडिंग असिस्टेंट—जैसे Cursor या Windsurf—कॉन्टेक्स्ट इंजीनियरिंग के सबसे उन्नत अनुप्रयोगों में से हैं, क्योंकि वे अत्यधिक संरचित और परस्पर जुड़ी जानकारी के साथ काम करते हुए RAG और एजेंट—दोनों सिद्धांतों को मिलाते हैं।
इन सिस्टमों को केवल व्यक्तिगत फ़ाइलें ही नहीं, बल्कि पूरे प्रोजेक्ट की आर्किटेक्चर, मॉड्यूल्स के बीच निर्भरताएँ, और आपके कोडबेस में कोडिंग पैटर्न भी समझने होते हैं।
जब आप किसी कोडिंग असिस्टेंट से किसी फ़ंक्शन को रिफैक्टर करने को कहते हैं, तो उसे उस फ़ंक्शन के उपयोग-स्थलों, अपेक्षित डेटा प्रकारों और यह बदलाव प्रोजेक्ट के अन्य हिस्सों पर कैसे असर डालेंगे—इन सबका कॉन्टेक्स्ट चाहिए।
यहाँ कॉन्टेक्स्ट इंजीनियरिंग इसलिए निर्णायक हो जाती है क्योंकि कोड के रिश्ते कई फ़ाइलों और कभी-कभी कई रिपोज़िटरीज़ तक फैले होते हैं। एक अच्छा कोडिंग असिस्टेंट आपके प्रोजेक्ट स्ट्रक्चर, आपके द्वारा किए गए हालिया बदलावों, आपकी कोडिंग शैली और आपके द्वारा उपयोग किए जा रहे फ़्रेमवर्क्स का कॉन्टेक्स्ट बनाए रखता है।
इसी कारण Cursor जैसे टूल किसी प्रोजेक्ट में जितना अधिक समय तक उपयोग हों, उतना बेहतर काम करते हैं। वे आपके विशेष कोडबेस के बारे में कॉन्टेक्स्ट बनाते हैं और आपकी प्राथमिकताओं व पैटर्न्स के आधार पर अधिक प्रासंगिक सुझाव दे पाते हैं।
कॉन्टेक्स्ट विफलताएँ और उन्हें कम करने की तकनीकें
यह लेख पढ़ते समय आपको लग सकता है कि कॉन्टेक्स्ट इंजीनियरिंग अनावश्यक है या जल्द ही अनावश्यक हो जाएगी क्योंकि अग्रणी मॉडलों की कॉन्टेक्स्ट विंडो लगातार बढ़ रही हैं। यह सोचना स्वाभाविक है, क्योंकि यदि कॉन्टेक्स्ट पर्याप्त बड़ा हो, तो आप सब कुछ (टूल्स, दस्तावेज़, निर्देश आदि) एक प्रोम्प्ट में डाल सकते हैं और मॉडल बाकी संभाल लेगा।
लेकिन, ड्रू ब्रूनीग का यह उत्कृष्ट लेख दिखाता है कि आश्चर्यजनक चार तरीकों से कॉन्टेक्स्ट नियंत्रण से बाहर हो सकता है—भले ही मॉडल 1 मिलियन टोकन की कॉन्टेक्स्ट विंडो सपोर्ट करता हो। इस खंड में, मैं ड्रू ब्रूनीग द्वारा बताए गए मुद्दों और उन्हें हल करने वाले कॉन्टेक्स्ट इंजीनियरिंग पैटर्न्स का संक्षेप में वर्णन करूँगा—विस्तार के लिए ब्रूनीग का लेख अवश्य पढ़ें।
कॉन्टेक्स्ट पॉइज़निंग
कॉन्टेक्स्ट पॉइज़निंग तब होती है जब कोई हैलुसिनेशन या त्रुटि आपके AI सिस्टम के कॉन्टेक्स्ट में शामिल हो जाती है और फिर भविष्य के उत्तरों में बार-बार संदर्भित होती रहती है। डीपमाइंड टीम ने अपने Gemini 2.5 तकनीकी रिपोर्ट में यह समस्या तब पहचानी, जब वे एक पोकेमॉन-खेलने वाला एजेंट बना रहे थे। जब एजेंट कभी-कभी गेम स्टेट के बारे में हैलुसिनेट करता था, तो यह झूठी जानकारी उसके कॉन्टेक्स्ट के “goals” सेक्शन को ज़हरीला कर देती थी, जिससे एजेंट बेतुकी रणनीतियाँ बनाता और लंबे समय तक असंभव उद्देश्यों का पीछा करता रहता था।
यह समस्या खासकर एजेंट वर्कफ़्लो में गंभीर हो जाती है जहाँ जानकारी इकट्ठी होती रहती है। एक बार ज़हरीला कॉन्टेक्स्ट जम गया तो उसे ठीक करने में बहुत समय लग सकता है, क्योंकि मॉडल झूठी जानकारी को सच मानकर संदर्भित करता रहता है।
सर्वश्रेष्ठ उपाय है कॉन्टेक्स्ट वैलिडेशन और क्वारंटीन। आप अलग-अलग प्रकार के कॉन्टेक्स्ट को अलग थ्रेड्स में अलग-थलग रख सकते हैं और किसी जानकारी को दीर्घकालिक मेमोरी में जोड़ने से पहले वैलिडेट कर सकते हैं। कॉन्टेक्स्ट क्वारंटीन का मतलब है संभावित पॉइज़निंग दिखने पर नए थ्रेड्स से शुरुआत करना, जिससे गलत जानकारी भविष्य की इंटरैक्शनों में फैलने से रुकती है।
कॉन्टेक्स्ट डिस्ट्रैक्शन
कॉन्टेक्स्ट डिस्ट्रैक्शन तब होता है जब आपका कॉन्टेक्स्ट इतना बड़ा हो जाता है कि मॉडल अपने प्रशिक्षण से सीखी बातों का उपयोग करने के बजाय इकट्ठा हुए इतिहास पर अधिक ध्यान देने लगता है। पोकेमॉन खेलने वाले Gemini एजेंट में यह दिखा—जैसे ही कॉन्टेक्स्ट 100,000 टोकन से आगे बढ़ा, एजेंट नई रणनीतियाँ विकसित करने के बजाय अपने विस्तृत इतिहास की क्रियाएँ दोहराने लगा।
एक Databricks अध्ययन (बहुत रोचक; अवश्य पढ़ें) में पाया गया कि Llama 3.1 405b के लिए लगभग 32,000 टोकन के बाद मॉडल की शुद्धता घटने लगी, और छोटे मॉडल इससे भी पहले अपनी सीमा पर पहुँच गए। यानी मॉडल्स अपनी कॉन्टेक्स्ट विंडो पूरी भरने से काफी पहले ही गलतियाँ करने लगते हैं—जिससे यह सवाल उठता है कि जटिल तर्क कार्यों के लिए बहुत बड़ी कॉन्टेक्स्ट विंडो का वास्तविक मूल्य क्या है।
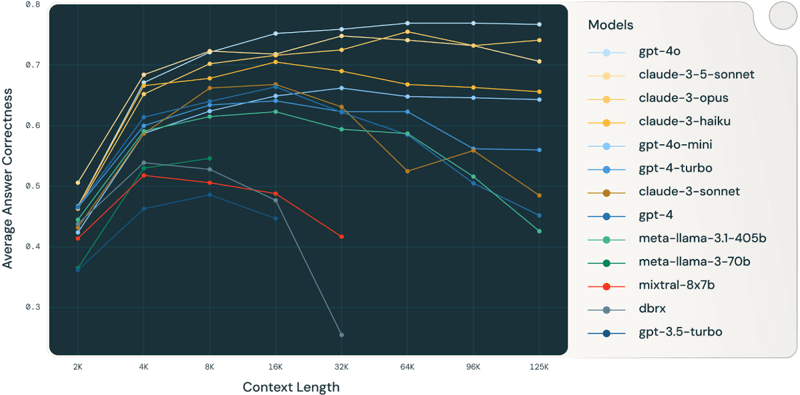
स्रोत: Databricks
सबसे अच्छा तरीका है कॉन्टेक्स्ट समरीकरण। कॉन्टेक्स्ट को अनिश्चितकाल तक बढ़ने देने के बजाय, आप संचित जानकारी को छोटी समरीज़ में संपीड़ित कर सकते हैं जो महत्वपूर्ण विवरणों को बचाए रखती हैं और अनावश्यक इतिहास हटाती हैं। यह तब मदद करता है जब आप डिस्ट्रैक्शन की छत से टकराएँ—आप अब तक की बातचीत का सार लेकर नई शुरुआत कर सकते हैं, जबकि संगति बनाए रखते हैं।
कॉन्टेक्स्ट कंफ़्यूज़न
कॉन्टेक्स्ट कंफ़्यूज़न तब होती है जब आप अपने कॉन्टेक्स्ट में अतिरिक्त जानकारी शामिल कर देते हैं और मॉडल वर्तमान कार्य से असंबंधित होने पर भी उसी का उपयोग करके गलत उत्तर बना देता है। बर्कले फ़ंक्शन-कॉलिंग लीडरबोर्ड में यह दिखता है—हर मॉडल तब बदतर प्रदर्शन करता है जब उसे एक से अधिक टूल दिए जाएँ, और कभी-कभी मॉडल ऐसे टूल भी कॉल कर देते हैं जिनका कार्य से कोई लेना-देना नहीं होता।
समस्या छोटे मॉडलों और अधिक टूल्स के साथ और बढ़ जाती है। एक हालिया अध्ययन में पाया गया कि क्वांटाइज़्ड Llama 3.1 8b GeoEngine बेंचमार्क पर तब विफल हुआ जब उसे सभी 46 उपलब्ध टूल दिए गए—हालाँकि कॉन्टेक्स्ट 16k विंडो सीमा के भीतर था। लेकिन जब शोधकर्ताओं ने उसी मॉडल को केवल 19 टूल दिए, तो वह ठीक काम करने लगा।
समाधान है टूल लोडआउट मैनेजमेंट, RAG तकनीकों का उपयोग करके। तियानतियान गैन और क़ियाओ सन का शोध दर्शाता है कि टूल विवरणों पर RAG लागू करने से प्रदर्शन में वास्तविक सुधार आता है। टूल विवरणों को वेक्टर डेटाबेस में संग्रहीत करके, आप हर कार्य के लिए केवल सबसे प्रासंगिक टूल्स का चयन कर सकते हैं। उनके अध्ययन में पाया गया कि टूल चयन को 30 से कम रखने पर टूल चयन सटीकता तीन गुना बेहतर हुई और प्रोम्प्ट्स भी बहुत छोटे रहे।
कॉन्टेक्स्ट क्लैश
कॉन्टेक्स्ट क्लैश तब होता है जब आप अपने कॉन्टेक्स्ट में ऐसी जानकारी और टूल्स इकट्ठे कर लेते हैं जो पहले से मौजूद अन्य जानकारियों से सीधे टकराते हैं। माइक्रोसॉफ़्ट और सेल्सफ़ोर्स के एक अध्ययन ने यह दिखाया—उन्होंने बेंचमार्क प्रोम्प्ट्स को “शार्डिंग” करके उनकी जानकारी कई बातचीत चरणों में बाँट दी, बजाय सब कुछ एक साथ देने के। नतीजे भारी थे—औसतन 39% प्रदर्शन में गिरावट, जिसमें OpenAI का o3 मॉडल 98.1 से 64.1 पर आ गया।
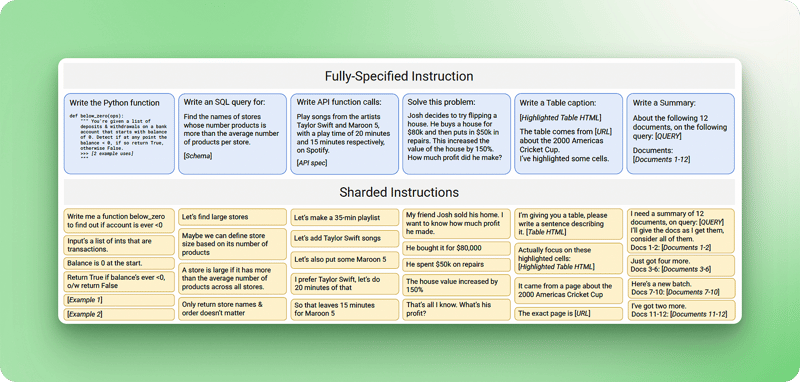
स्रोत: Laban et. al, 2025
समस्या इसलिए होती है क्योंकि जब जानकारी चरणों में आती है, तो इकट्ठा हुआ कॉन्टेक्स्ट मॉडल के उन शुरुआती प्रयासों को समेट लेता है जो उसने पूरी जानकारी मिलने से पहले दिए थे। ये गलत प्रारंभिक उत्तर कॉन्टेक्स्ट में बने रहते हैं और अंतिम उत्तर जनरेट करते समय मॉडल को प्रभावित करते हैं।
सबसे अच्छे उपाय हैं कॉन्टेक्स्ट प्रूनिंग और ऑफ़लोडिंग। कॉन्टेक्स्ट प्रूनिंग का मतलब है नई जानकारी आते ही पुरानी या परस्पर-विरोधी जानकारी हटाना। कॉन्टेक्स्ट ऑफ़लोडिंग, जैसे एंथ्रॉपिक का “think” टूल, मॉडलों को मुख्य कॉन्टेक्स्ट को अव्यवस्थित किए बिना जानकारी संसाधित करने के लिए अलग कार्यक्षेत्र देता है। यह स्क्रैचपैड तरीका विशेष एजेंट बेंचमार्क्स में 54% तक सुधार दे सकता है—क्योंकि यह आंतरिक विरोधाभासों को तर्क पर हावी होने से रोकता है।
निष्कर्ष
कॉन्टेक्स्ट इंजीनियरिंग AI विकास के अगले चरण का प्रतिनिधित्व करती है, जहाँ ध्यान परफेक्ट प्रोम्प्ट गढ़ने से हटकर ऐसे सिस्टम बनाने पर जाता है जो समय के साथ सूचना प्रवाह का प्रबंधन करें। कई इंटरैक्शनों में प्रासंगिक कॉन्टेक्स्ट बनाए रखने की क्षमता तय करती है कि आपका AI वाकई बुद्धिमान लगता है या केवल एकबारगी अच्छे जवाब देता है।
इस ट्यूटोरियल में शामिल तकनीकें—RAG सिस्टम से लेकर कॉन्टेक्स्ट वैलिडेशन और टूल मैनेजमेंट तक—पहले से ही उन प्रोडक्शन सिस्टमों में इस्तेमाल हो रही हैं जो लाखों उपयोगकर्ताओं को सँभालते हैं।
यदि आप साधारण कंटेंट जेनरेटर से अधिक जटिल कुछ भी बना रहे हैं, तो आपको संभवतः कॉन्टेक्स्ट इंजीनियरिंग तकनीकों की आवश्यकता होगी। अच्छी बात यह है कि आप बेसिक RAG इम्प्लीमेंटेशन से छोटा शुरू कर सकते हैं और अपनी ज़रूरत बढ़ने के साथ धीरे-धीरे अधिक उन्नत मेमोरी और टूल मैनेजमेंट जोड़ सकते हैं।
और जानने के लिए, मैं ये संसाधन सुझाता हूँ:
- Cursor AI Code Editor ट्यूटोरियल—AI कोडिंग असिस्टेंट्स के साथ व्यवहार में कॉन्टेक्स्ट इंजीनियरिंग कैसे काम करती है, सीखें
- Cursor बनाम Windsurf तुलना—Cursor और Windsurf के बीच के फ़र्क़ जानें
- Best AI Coding Assistants—विभिन्न टूल्स और उनके कॉन्टेक्स्ट मैनेजमेंट दृष्टिकोणों की तुलना
- Retrieval Augmented Generation (RAG) with LangChain कोर्स—RAG सिस्टम बनाने के लिए हैंड्स-ऑन कोर्स
- Retrieval Augmented Generation (RAG) क्या है?—कॉन्टेक्स्ट इंजीनियरिंग की नींव
- एजेंटिक RAG ट्यूटोरियल—गतिशील कॉन्टेक्स्ट प्रबंधन के उन्नत तरीके
- प्रोम्प्ट इंजीनियरिंग क्या है?—प्रोम्प्ट और कॉन्टेक्स्ट इंजीनियरिंग के बीच का अंतर समझें
- Multi-Agent Systems With LangGraph कोर्स—LangGraph के साथ मल्टी-एजेंट सिस्टम बनाना सीखें
- Introduction to AI Agents कोर्स—ऐसे सिस्टम बनाना जो टूल्स का उपयोग करें और समय के साथ कॉन्टेक्स्ट बनाए रखें
FAQs
सिर्फ प्रोम्प्ट्स के बजाय मुझे कॉन्टेक्स्ट इंजीनियरिंग का उपयोग कब शुरू करना चाहिए?
जब आपकी AI को बातचीतों के बीच चीज़ें याद रखनी हों, कई सूचना स्रोतों के साथ काम करना हो, या लंबे समय तक चलने वाले कार्य सँभालने हों—तभी से कॉन्टेक्स्ट इंजीनियरिंग का उपयोग शुरू करें। यदि आप साधारण कंटेंट जेनरेटर से अधिक जटिल कुछ बना रहे हैं, तो आपको ये तकनीकें संभवतः चाहिए होंगी।
कॉन्टेक्स्ट इंजीनियरिंग और प्रोम्प्ट इंजीनियरिंग में मुख्य अंतर क्या है?
प्रोम्प्ट इंजीनियरिंग एकल कार्यों के लिए निर्देश लिखने पर केंद्रित है, जबकि कॉन्टेक्स्ट इंजीनियरिंग ऐसे सिस्टम डिज़ाइन करती है जो कई इंटरैक्शनों में सूचना प्रवाह का प्रबंधन करें। कॉन्टेक्स्ट इंजीनियरिंग मेमोरी और रिट्रीवल सिस्टम बनाती है, जबकि प्रोम्प्ट इंजीनियरिंग व्यक्तिगत अनुरोध गढ़ती है।
क्या मैं कॉन्टेक्स्ट इंजीनियरिंग की जगह बड़ी कॉन्टेक्स्ट विंडो का उपयोग कर सकता/सकती हूँ?
बड़ी कॉन्टेक्स्ट विंडो मूल समस्याओं का हल नहीं हैं। शोध से पता चलता है कि कॉन्टेक्स्ट डिस्ट्रैक्शन और कंफ़्यूज़न के कारण प्रदर्शन लगभग 32,000 टोकन पर घटने लगता है—चाहे मिलियन-टोकन विंडो ही क्यों न हो। इसलिए, कॉन्टेक्स्ट आकार चाहे जो हो, समरीकरण, प्रूनिंग और स्मार्ट सूचना चयन जैसी तकनीकें फिर भी आवश्यक हैं।
जब मैं मॉडलों को अधिक टूल्स या जानकारी देता/देती हूँ तो वे बदतर प्रदर्शन क्यों करते हैं?
इसे कॉन्टेक्स्ट कंफ़्यूज़न कहते हैं—मॉडल अप्रासंगिक जानकारी से भटककर ऐसे टूल्स का उपयोग कर लेते हैं जो कार्य से मेल नहीं खाते। समाधान है टूल लोडआउट मैनेजमेंट: प्रत्येक विशिष्ट कार्य के लिए केवल सबसे प्रासंगिक टूल चुनने हेतु RAG तकनीकों का उपयोग करें, और चयन 30 टूल्स से कम रखें।

मैं 2 से अधिक वर्षों के अनुभव वाला डेटा साइंस कंटेंट क्रिएटर हूँ और Medium पर सबसे बड़े फॉलोइंग्स में से एक रखता हूँ। मुझे एआई और एमएल पर विस्तार से लेख लिखना पसंद है, जिसमें हल्का-सा व्यंग्यात्मक अंदाज रहता है—क्योंकि कुछ तो करना पड़ता है ताकि वे कम उबाऊ लगें। मैंने 130 से अधिक लेख और एक DataCamp कोर्स तैयार किया है, और एक और बन रहा है। मेरा कंटेंट 50 लाख से अधिक लोगों ने देखा है, जिनमें से 20 हज़ार लोग Medium और LinkedIn पर फॉलोअर्स बन गए।
आप भले ही प्रोम्प्ट इंजीनियरिंग के माहिर हों, लेकिन बातचीत बढ़ने पर आपका चैटबॉट अक्सर आपकी शुरुआती और सबसे महत्वपूर्ण हिदायतें भूल जाता है, आपका कोड असिस्टेंट प्रोजेक्ट की आर्किटेक्चर से भटक जाता है, और आपका RAG टूल जटिल दस्तावेज़ों व डोमेनों के बीच जानकारी जोड़ नहीं पाता।
जैसे-जैसे AI के उपयोग मामलों की जटिलता बढ़ती है, चतुर प्रोम्प्ट लिखना एक बहुत बड़ी चुनौती का केवल छोटा-सा हिस्सा है: कॉन्टेक्स्ट इंजीनियरिंग.
इस ट्यूटोरियल में, मैं बताऊँगा कि कॉन्टेक्स्ट इंजीनियरिंग क्या है, यह कैसे काम करती है, कब इसे सामान्य प्रोम्प्ट इंजीनियरिंग की जगह उपयोग करना चाहिए, और वे व्यावहारिक तकनीकें जो AI सिस्टमों को अधिक स्मार्ट और कॉन्टेक्स्ट-सचेत बनाती हैं।
यदि आप वीडियो के साथ सीखना पसंद करते हैं, तो यह पाठ देखें: