
बिगिनर्स के लिए मशीन लर्निंग प्रोजेक्ट्स
ये शुरुआती मशीन लर्निंग प्रोजेक्ट्स संरचित, टैब्युलर डेटा पर केंद्रित हैं। आप विश्लेषणात्मक उद्देश्यों के लिए डेटा क्लीनिंग, प्रोसेसिंग और विज़ुअलाइज़ेशन का प्रयोग करेंगे और scikit-learn फ्रेमवर्क से मशीन लर्निंग मॉडल ट्रेन और वैलिडेट करेंगे।
यदि आप पहले मशीन लर्निंग की मूल अवधारणाएँ सीखना चाहते हैं, तो हमारे पास एक नो-कोड Understanding Machine Learning कोर्स है। आप हमारे कुछ AI प्रोजेक्ट्स भी देख सकते हैं यदि आप उस क्षेत्र में अपने कौशल को निखारना चाहते हैं।
1. ऊर्जा खपत की भविष्यवाणी
Predict Energy Consumption प्रोजेक्ट में, आप समय-संबंधी कारकों जैसे दिन का समय और तापमान के आधार पर प्रतिदिन की बिजली खपत की भविष्यवाणी करने के लिए रिग्रेशन और मशीन लर्निंग मॉडल्स का उपयोग करेंगे। लक्ष्य ऐसे पैटर्न्स खोजना है जो ऊर्जा उपयोग को अनुकूलित कर सकें, दक्षता बढ़ाएँ और लागत घटाएँ। यह विशेष रूप से उन यूटिलिटीज और व्यवसायों के लिए महत्वपूर्ण है जो परिचालन खर्च कम करना, ऊर्जा संरक्षण को बढ़ावा देना और संसाधनों का अधिक टिकाऊ तरीक़े से प्रबंधन करना चाहते हैं।
Predict Energy Consumption एक गाइडेड प्रोजेक्ट है, लेकिन आप इसके उद्देश्यों को किसी अन्य डेटासेट पर भी दोहरा सकते हैं, जैसे सियोल की Bike Sharing Demand। पूरी तरह नए डेटासेट पर काम करना कोड डिबगिंग में मदद करेगा और आपकी समस्या-समाधान क्षमता सुधारेगा।
2. इंश्योरेंस चार्जेस की भविष्यवाणी
From Data to Dollars - Predicting Insurance Charges प्रोजेक्ट में, आप एक हेल्थ इंश्योरेंस कंपनी में डेटा साइंटिस्ट की भूमिका निभाते हैं। आप किसी क्लाइंट के गुणों—जैसे उम्र और स्वास्थ्य कारक—के आधार पर इंश्योरेंस चार्जेस का अनुमान लगाने के लिए एक प्रेडिक्टिव मॉडल बनाएँगे। यह प्रोजेक्ट बिज़नेस में मशीन लर्निंग का व्यावहारिक उपयोग सिखाता है, जिससे अधिक सटीक प्राइसिंग मॉडल बनते हैं और कंपनियाँ जोखिम को प्रबंधित करते हुए पर्सनलाइज़्ड प्राइसिंग रणनीतियाँ दे पाती हैं।
Predicting Insurance Charges एक गाइडेड प्रोजेक्ट है। आप परिणामों को किसी अन्य डेटासेट पर दोहरा सकते हैं, जैसे Hotel Booking Demand। इसमें आप यह भविष्यवाणी कर सकते हैं कि ग्राहक बुकिंग रद्द करेगा या नहीं।
3. क्रेडिट कार्ड अप्रूवल्स की भविष्यवाणी
Predicting Credit Card Approvals प्रोजेक्ट में, आप हाइपरपैरामीटर ऑप्टिमाइज़ेशन और Logistic Regression का उपयोग करके एक स्वचालित क्रेडिट कार्ड अप्रूवल एप्लिकेशन बनाएँगे।
आप मिसिंग वैल्यूज़ को संभालना, श्रेणीबद्ध फीचर्स को प्रोसेस करना, फीचर स्केलिंग, असंतुलित डेटा से निपटना, और GridCV से स्वचालित हाइपरपैरामीटर ऑप्टिमाइज़ेशन लागू करने जैसे कौशलों का प्रयोग करेंगे। यह प्रोजेक्ट आपको सरल और साफ डेटा से आगे की चुनौती देगा।
चित्र: लेखक द्वारा
Predicting Credit Card Approvals एक गाइडेड प्रोजेक्ट है। आप परिणामों को किसी अन्य डेटासेट पर दोहरा सकते हैं, जैसे LendingClub.com का Loan Data। इसमें आप स्वचालित लोन अप्रूवल प्रिडिक्टर बना सकते हैं।
4. वाइन क्वालिटी प्रेडिक्शन
आप वाइन की भौतिक-रसायनिक विशेषताओं—जैसे अल्कोहल कंटेंट, अम्लता और शुगर स्तर—के डेटासेट का उपयोग करते हुए वाइन क्वालिटी प्रेडिक्शन प्रोजेक्ट बना सकते हैं। scikit-learn में लॉजिस्टिक रिग्रेशन जैसे क्लासिफिकेशन मॉडल्स लगाकर आप वाइन को 1-10 के पैमाने पर वर्गीकृत कर सकते हैं।
यह प्रोजेक्ट वाइन उत्पादन और क्वालिटी कंट्रोल से जुड़े उद्योगों के लिए महत्वपूर्ण है क्योंकि यह उन्हें वाइन की गुणवत्ता का लगातार मॉनिटर और पूर्वानुमान करने में सक्षम बनाता है, जिससे उत्पाद उत्कृष्टता सुनिश्चित होती है।
5. कृषि के लिए प्रेडिक्टिव मॉडलिंग
Predictive Modeling for Agriculture Data Science Project में, आप सुपरवाइज्ड मशीन लर्निंग और फीचर सेलेक्शन का उपयोग कर एक सरल फसल अनुशंसा प्रणाली बनाएँगे। चार आवश्यक मृदा गुणों—नाइट्रोजन, फॉस्फोरस, पोटेशियम और pH—के साथ काम करेंगे। आपको एक वास्तविक बाधा का सामना करना होगा: किसान केवल एक गुण माप सकता है। आपका काम यह पहचानना है कि कौन-सा एकल फीचर सही फसल की भविष्यवाणी सबसे बेहतर करता है और फिर एक हल्का क्लासिफायर ट्रेन करना है जो वह अनुशंसा भरोसेमंद ढंग से दे सके।
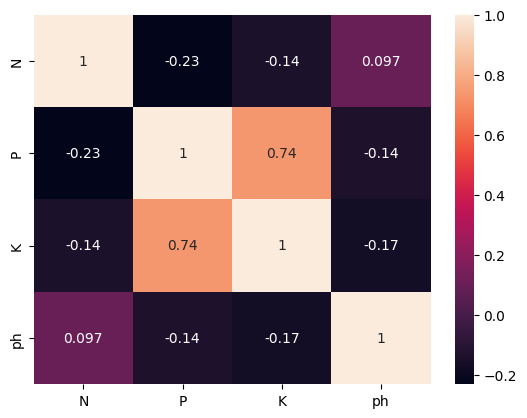
आप मिसिंग वैल्यूज़ को संभालना, लेबल एनकोडिंग, फीचर स्केलिंग, मॉडल का मूल्यांकन, और सबसे महत्वपूर्ण, दो फीचर सेलेक्शन तकनीकों को लागू और तुलना करके मिट्टी के मापों की रैंकिंग करना जैसे व्यावहारिक कौशलों का अभ्यास करेंगे।
6. स्टोर सेल्स
Store Sales Kaggle का एक गेटिंग-स्टार्टेड प्रतियोगिता है जहाँ प्रतिभागी विभिन्न टाइम सीरीज़ मॉडल्स ट्रेन करके लीडरबोर्ड पर अपना स्कोर सुधारते हैं। इस प्रोजेक्ट में आपको स्टोर सेल्स डेटा दिया जाएगा, और आप डेटा को साफ करेंगे, व्यापक टाइम सीरीज़ विश्लेषण करेंगे, फीचर स्केलिंग करेंगे, और मल्टीवेरिएट टाइम सीरीज़ मॉडल ट्रेन करेंगे।
लीडरबोर्ड पर स्कोर सुधारने के लिए आप Bagging और Voting Regressors जैसी एन्सेम्बलिंग तकनीकों का उपयोग कर सकते हैं।
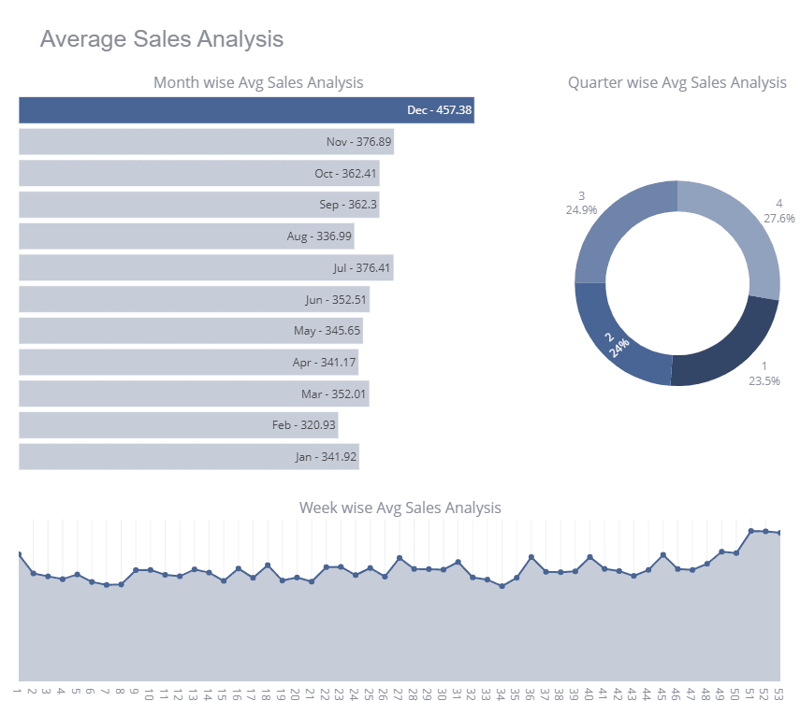
चित्र स्रोत: Kaggle
Store Sales एक Kaggle-आधारित प्रोजेक्ट है जहाँ आप अन्य प्रतिभागियों के नोटबुक्स देख सकते हैं।
टाइम सीरीज़ फोरकास्टिंग की समझ बेहतर करने के लिए, Stock Exchange डेटासेट पर अपनी स्किल्स लागू करें और Facebook Prophet से एक यूनिवेरिएट टाइम सीरीज़ फोरकास्टिंग मॉडल ट्रेन करें।
इंटरमीडिएट मशीन लर्निंग प्रोजेक्ट्स
ये इंटरमीडिएट प्रोजेक्ट्स संरचित और असंरचित डेटासेट्स के लिए डेटा प्रोसेसिंग और मॉडल ट्रेनिंग पर केंद्रित हैं। विभिन्न सांख्यिकीय टूल्स से डेटासेट को साफ, प्रोसेस और ऑगमेंट करना सीखें।
7. डेटा में मौजूद श्रेणियाँ उजागर करें
Reveal Categories Found in Data प्रोजेक्ट आपको क्लस्टरिंग और नैचुरल लैंग्वेज प्रोसेसिंग (NLP) से ग्राहक फीडबैक एक्सप्लोर करना सिखाता है। आप Google Play Store की समीक्षाओं को K-means क्लस्टरिंग से अलग-अलग श्रेणियों में व्यवस्थित करेंगे। ग्राहक फीडबैक से उभरने वाले सामान्य थीम्स को समझना प्रोडक्ट टीमों के लिए आवश्यक है ताकि वे यूज़र की तकलीफ़ों का समाधान कर सकें, फ़ीचर्स सुधार सकें, और उपयोगी इनसाइट्स के ज़रिए संतुष्टि बढ़ा सकें।
इसी परिणाम को किसी अन्य डेटासेट, जैसे Netflix Movie डेटासेट पर दोहराने की कोशिश करें।
8. मोबी डिक में शब्द आवृत्ति
Word Frequency in Moby Dick प्रोजेक्ट में, आप हरमन मेलविल की Moby Dick का टेक्स्ट स्क्रैप करेंगे और Python की nltk लाइब्रेरी से शब्द आवृत्ति का विश्लेषण करेंगे। यह प्रोजेक्ट प्रमुख NLP तकनीकों से परिचय कराता है और यह समझने में मदद करता है कि अक्सर आने वाले शब्द टेक्स्ट में पैटर्न कैसे दर्शाते हैं। साहित्य-रुचि रखने वालों, इतिहासकारों या टेक्स्ट माइनिंग और भाषावैज्ञानिक विश्लेषण में रुचि रखने वाले शोधकर्ताओं के लिए यह उत्कृष्ट प्रोजेक्ट है।
9. सुपरवाइज्ड लर्निंग से फेसियल रिकग्निशन
Facial Recognition with Supervised Learning प्रोजेक्ट में, आप Python और scikit-learn के साथ सुपरवाइज्ड लर्निंग तकनीकों से एक फेसियल रिकग्निशन मॉडल बनाएँगे। मॉडल अर्नोल्ड श्वार्ज़नेगर और अन्य लोगों की छवियों में अंतर करता है। यह प्रोजेक्ट फेसियल रिकग्निशन टेक्नोलॉजी के बढ़ते क्षेत्र में महत्वपूर्ण है, जिसके व्यापक उपयोग सुरक्षा, ऑथेंटिकेशन सिस्टम्स और सोशल मीडिया प्लेटफ़ॉर्म्स तक हैं।
10. एक अच्छी किताब को क्या बनाता है?
एक बुक-पॉपुलैरिटी प्रेडिक्टर बनाइए जो एक ऑनलाइन बुकस्टोर के लिए मिश्रित डेटा—जैसे टेक्स्ट (उदा., बुक टाइटल्स और विवरण) और संख्यात्मक डेटा (उदा., रेटिंग्स और काउंट्स)—को प्रभावी फीचर्स में बदलता है। आप संपूर्ण मशीन लर्निंग वर्कफ़्लो में संलग्न होंगे, जिसमें त्वरित EDA, डेटा टाइप्स दुरुस्त करना, टेक्स्ट और संख्यात्मक वेरिएबल्स को ट्रांसफॉर्म करना, और सर्वोत्तम सटीकता के लिए मॉडल को फाइन-ट्यून करना शामिल है।
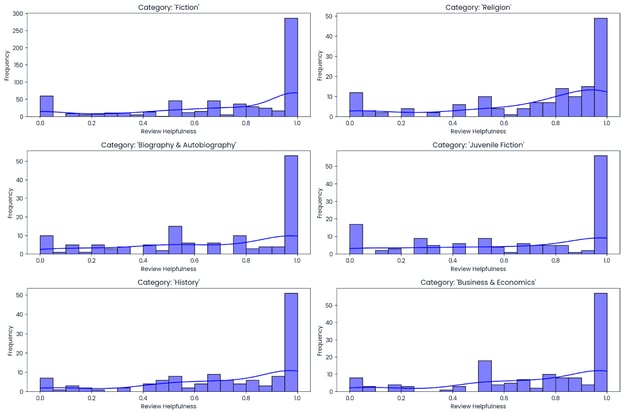
आप अस्त-व्यस्त, बहु-फ़ॉर्मेट डेटा को प्रबंधित करना और एक साफ, पुन: प्रयोज्य पाइपलाइन के साथ परिणामों का मूल्यांकन करना सीखेंगे। अंत तक, आप इन्हीं तरीकों को किसी भी कैटलॉग—चाहे आपकी निजी रीडिंग लिस्ट हो या सार्वजनिक डेटासेट्स—पर लागू करके संभावित बेस्टसेलर्स की भविष्यवाणी और सिफारिश प्रणालियों को बेहतर कर पाएँगे।
11. अंटार्कटिक पेंगुइन प्रजातियों का क्लस्टरिंग
Clustering Antarctic Penguin Species प्रोजेक्ट में, आप बिना लेबल के पेंगुइनों के प्राकृतिक समूह खोजने के लिए अनसुपरवाइज्ड लर्निंग का प्रयोग करते हैं। आप Palmer Penguins-शैली के डेटासेट को साफ करेंगे, मिसिंग वैल्यूज़ संभालेंगे, बिल लंबाई, बिल गहराई, फ्लिपर लंबाई और बॉडी मास जैसे संख्यात्मक फीचर्स को स्केल करेंगे, और वैकल्पिक रूप से आइलैंड या सेक्स जैसे सरल कैटेगोरिकल वेरिएबल्स को एन्कोड करेंगे, इसके बाद K-means क्लस्टरिंग लागू करेंगे।
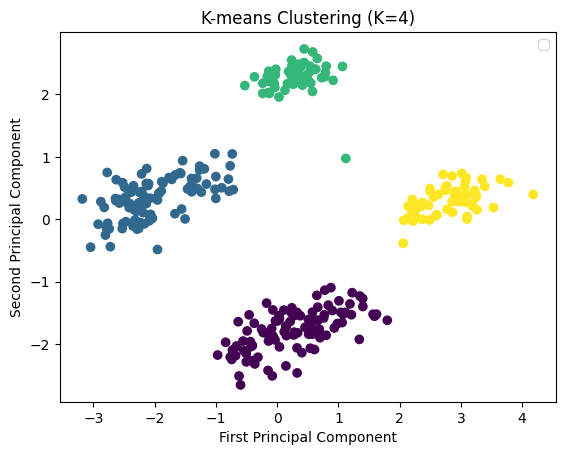
फिर आप एल्बो और सिल्हूट स्कोर्स से क्लस्टर्स की संख्या चुनते हैं, PCA से संरचना का विज़ुअलाइज़ेशन करते हैं, और त्वरित सैनीटी चेक के लिए क्लस्टर्स की ज्ञात प्रजातियों से तुलना करते हैं।
12. रिइनफोर्समेंट लर्निंग से टैक्सी रूट ऑप्टिमाइज़ेशन
Taxi Route Optimization with Reinforcement Learning प्रोजेक्ट में, आप Q-learning एजेंट को Taxi-v3 Gymnasium पर्यावरण में कुशल पिकअप और ड्रॉप-ऑफ रूट सीखने के लिए ट्रेन करते हैं। आप एक state–action वैल्यू टेबल बनाते हैं, epsilon-greedy पॉलिसी से exploration और exploitation में संतुलन रखते हैं, और कोर हाइपरपैरामीटर्स—जैसे लर्निंग रेट, डिस्काउंट फैक्टर, और epsilon decay—को ट्यून करके कन्वर्जेंस तेज़ करते हैं।
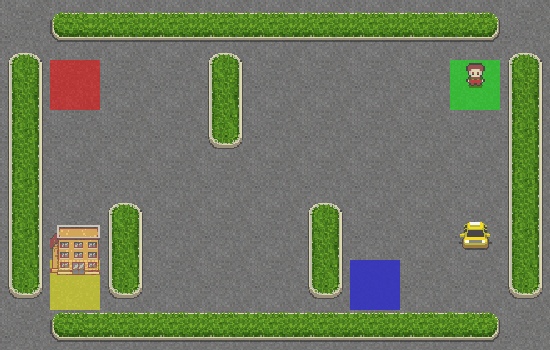
उसके बाद आप प्रति एपिसोड औसत रिवॉर्ड और कंप्लीशन तक लिए गए स्टेप्स से प्रदर्शन का मूल्यांकन करते हैं, लर्निंग कर्व विज़ुअलाइज़ करते हैं, और अनदेखे एपिसोड्स पर प्रशिक्षित पॉलिसी का परीक्षण करते हैं।
13. ब्रेस्ट कैंसर डिटेक्शन
Wisconsin Breast Cancer डेटासेट का उपयोग करके भविष्यवाणी करें कि ट्यूमर malignant है या benign। डेटासेट में बनावट, परिमाप और क्षेत्रफल जैसे ट्यूमर फीचर्स का विवरण है, और आपका लक्ष्य इन विशेषताओं के आधार पर डायग्नोसिस का अनुमान लगाने वाला क्लासिफिकेशन मॉडल बनाना है।
यह प्रोजेक्ट हेल्थकेयर अनुप्रयोगों में आवश्यक है, क्योंकि यह चिकित्सा डेटा विश्लेषण में उपयोगी अंतर्दृष्टि देता है और ऐसे डायग्नोस्टिक टूल्स विकसित करने की संभावना दिखाता है जो कैंसर का जल्द पता लगाने में सहायक हों।
14. librosa के साथ स्पीच इमोशन रिकग्निशन
Speech Emotion Recognition with Librosa प्रोजेक्ट में, आप Librosa, sound file, और sklearn के MLPClassifier का उपयोग करके साउंड फाइल्स से भावनाएँ पहचानेंगे।
आप साउंड फाइल्स को लोड और प्रोसेस करेंगे, फीचर एक्सट्रैक्शन करेंगे, और Multi-Layer Perceptron क्लासिफायर मॉडल ट्रेन करेंगे। यह प्रोजेक्ट आपको ऑडियो प्रोसेसिंग की बुनियाद सिखाएगा ताकि आप बेहतर सटीकता के लिए डीप लर्निंग मॉडल ट्रेन करने की दिशा में आगे बढ़ सकें।
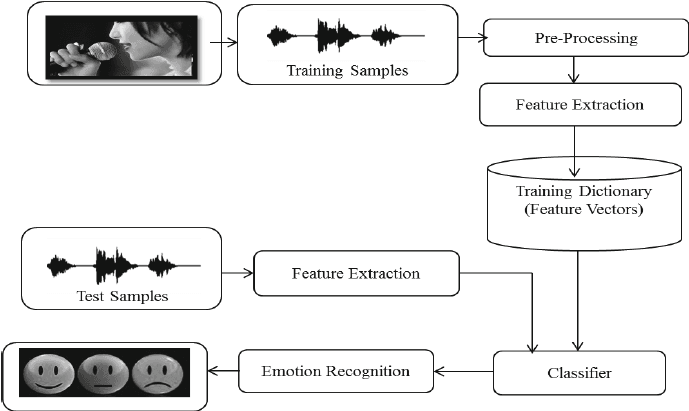
चित्र स्रोत: researchgate.net
एडवांस्ड मशीन लर्निंग प्रोजेक्ट्स
ये एडवांस्ड मशीन लर्निंग प्रोजेक्ट्स असंरचित डेटासेट्स पर डीप लर्निंग मॉडल्स बनाने और ट्रेन करने पर केंद्रित हैं। आप convolutional neural networks, gated recurrent units ट्रेन करेंगे, बड़े भाषा मॉडल्स को फाइन-ट्यून करेंगे, और रिइनफोर्समेंट लर्निंग मॉडल्स पर काम करेंगे।
15. डीप लर्निंग से सर्विस डेस्क टिकट क्लासिफिकेशन
Service Desk Ticket Classification with Deep Learning प्रोजेक्ट में, आप PyTorch से एक टेक्स्ट क्लासिफायर बनाते हैं जो आने वाले टिकट्स को स्वतः सही श्रेणी में रूट करता है। आप टेक्स्ट को क्लीन और टोकनाइज़ करेंगे, ट्रेन और वैलिडेशन स्प्लिट्स बनाएँगे, टिकट्स को वेक्टर रिप्रेज़ेंटेशंस में बदलेंगे, और बैच साइज, लर्निंग रेट और रेग्युलराइज़ेशन को ट्यून करते हुए एक कॉम्पैक्ट न्यूरल मॉडल ट्रेन करेंगे ताकि स्थिर कन्वर्जेंस मिले।
इसके बाद आप accuracy और weighted F1 से मूल्यांकन करेंगे, कन्फ्यूज़न मैट्रिक्स देखेंगे ताकि गलत लेबलिंग या ओवरलैपिंग कैटेगरीज दिखें, और क्लास इम्बैलेंस के लिए weighted loss जैसी तकनीकें लागू करेंगे।
16. ट्रांसफॉर्मर्स से रिक सांचेज़ बॉट बनाना
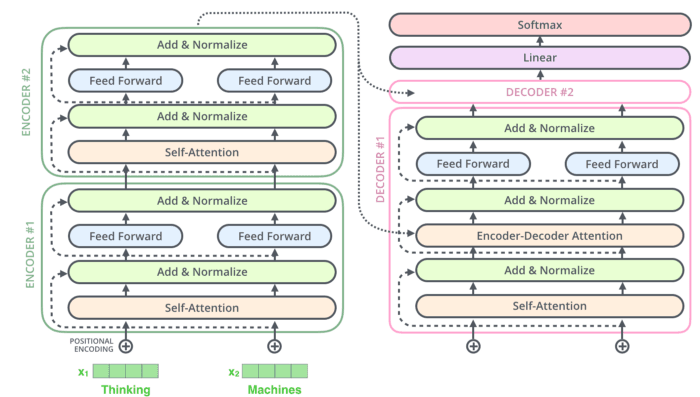
Build Rick Sanchez Bot Using Transformers प्रोजेक्ट में, आप DialoGPT और Hugging Face Transformer लाइब्रेरी से अपना AI-संचालित चैटबॉट बनाएँगे।
आप अपने डेटा को प्रोसेस और ट्रांसफॉर्म करेंगे, Microsoft के Large-scale Pretrained Response Generation Model (DialoGPT) को Rick and Morty डायलॉग डेटासेट पर बिल्ड और फाइन-ट्यून करेंगे। आप एक सरल Gradio ऐप भी बना सकते हैं ताकि रियल-टाइम में मॉडल को टेस्ट कर सकें: Rick & Morty Block Party।
17. Keras से ई-कॉमर्स क्लोदिंग क्लासिफायर मॉडल बनाना
Building an E-Commerce Clothing Classifier Model with Keras प्रोजेक्ट ई-कॉमर्स संदर्भ में इमेज क्लासिफिकेशन पर केंद्रित है। आप Keras से ऐसा मशीन लर्निंग मॉडल बनाएँगे जो इमेज के आधार पर कपड़ों का क्लासिफिकेशन स्वचालित कर दे। इससे शॉपिंग अनुभव बेहतर होता है क्योंकि ग्राहक तेज़ी से प्रोडक्ट ढूँढ पाते हैं, और इन्वेंटरी मैनेजमेंट भी सुगम होता है। सटीक क्लासिफिकेशन पर्सनलाइज़्ड रिकमेंडेशंस को भी सहारा देता है, जिससे एंगेजमेंट और सेल्स बढ़ते हैं।
18. डीप लर्निंग से ट्रैफिक साइन डिटेक्शन
Detect Traffic Signs with Deep Learning प्रोजेक्ट में, आप Keras से ऐसा डीप लर्निंग मॉडल विकसित करेंगे जो स्टॉप साइन और ट्रैफिक लाइट्स जैसे ट्रैफिक साइन का पता लगा सके। यह तकनीक स्वचालित वाहनों के लिए महत्वपूर्ण है, जहाँ सड़क संकेतों की तेज़ और सटीक पहचान सुरक्षित नेविगेशन के लिए आवश्यक है। यह प्रोजेक्ट अधिक उन्नत, सुरक्षित और भरोसेमंद सेल्फ-ड्राइविंग सिस्टम्स के विकास की बुनियाद रखता है।
19. डिमांड फोरकास्टिंग मॉडल बनाना
Building a Demand Forecasting Model प्रोजेक्ट में, आप PySpark से बड़े पैमाने पर ई-कॉमर्स प्रोडक्ट डिमांड की भविष्यवाणी करते हैं। आप ट्रांज़ैक्शनल डेटा लोड करेंगे, लैग्स और रोलिंग मीन जैसे समय-आधारित फीचर्स इंजीनियर करेंगे, ईमानदार मूल्यांकन के लिए समय-आधारित स्प्लिट करेंगे, और ट्रेंड्स व सीज़नैलिटी पकड़ने के लिए बेसलाइन के साथ Gradient-Boosted Trees या Random Forest जैसे लर्निंग मॉडल्स ट्रेन करेंगे।
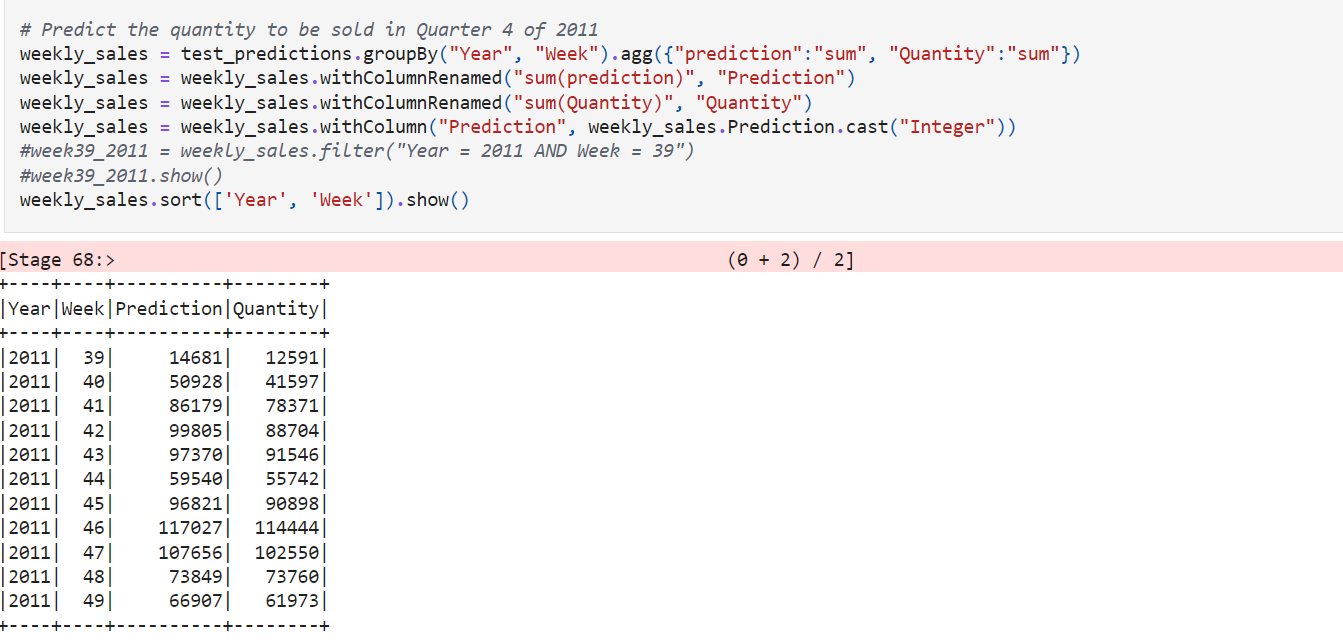
फिर आप MAE, RMSE, और MAPE से मूल्यांकन करते हैं, बेसलाइन से तुलना करते हैं, और SKU तथा समय-विंडो के हिसाब से त्रुटियों का विश्लेषण कर बायस और वॉलेटिलिटी पहचानते हैं।
20. लंदन में तापमान की भविष्यवाणी
Predicting Temperature in London प्रोजेक्ट में, आप ऐतिहासिक मौसम डेटा से औसत दैनिक तापमान का पूर्वानुमान लगाने के लिए एक संरचित ML प्रयोग चलाते हैं। आप डेटासेट लोड और क्लीन करेंगे, समय-सचेत स्प्लिट्स बनाएँगे, रोलिंग मीन और लैग्ड वैल्यूज़ जैसे फीचर्स इंजीनियर करेंगे, और scikit-learn के साथ कई संभावित मॉडल्स ट्रेन करेंगे।
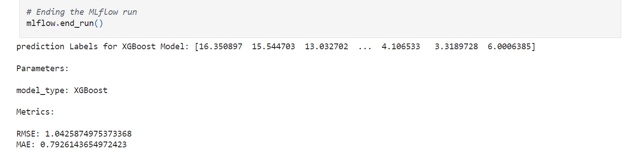
इसके बाद आप पुन: प्रयोज्य फ़ंक्शन्स से वर्कफ़्लो को ऑर्केस्ट्रेट करते हैं और MLflow में पैरामीटर्स, मेट्रिक्स और आर्टिफैक्ट्स लॉग करके सभी रन ट्रैक करते हैं।
21. Connect X के लिए रिइनफोर्समेंट लर्निंग
Connect X Kaggle की एक सिमुलेशन प्रतियोगिता है। अन्य Kaggle प्रतिभागियों से प्रतिस्पर्धा करने के लिए एक RL (Reinforcement Learning) एजेंट बनाइए।
पहले आप गेम कैसे काम करता है, यह सीखेंगे और बेसलाइन के लिए एक डमी फंक्शनल एजेंट बनाएँगे। उसके बाद आप विभिन्न RL एल्गोरिद्म्स और मॉडल आर्किटेक्चर्स के साथ प्रयोग शुरू करेंगे। आप Deep Q-learning या Proximal Policy Optimization एल्गोरिद्म पर मॉडल बनाने की कोशिश कर सकते हैं।
अंतिम-वर्ष के छात्रों के लिए मशीन लर्निंग प्रोजेक्ट्स
अंतिम-वर्ष का प्रोजेक्ट आपसे एक अनूठा समाधान विकसित करने के लिए पर्याप्त समय समर्पित करने की अपेक्षा करता है। आप कई मॉडल आर्किटेक्चर्स पर शोध करेंगे, विभिन्न मशीन लर्निंग फ्रेमवर्क्स से डेटासेट्स को नॉर्मलाइज़ और ऑगमेंट करेंगे, प्रक्रिया के पीछे के गणित को समझेंगे, और अपने परिणामों के आधार पर एक थीसिस लिखेंगे।
22. ट्रांसफॉर्मर्स के साथ मल्टीलिंगुअल ASR
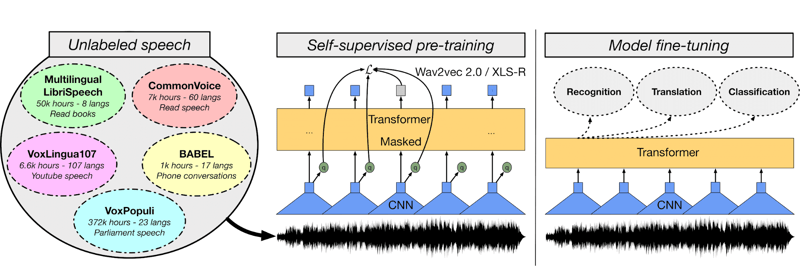
Multi-Lingual ASR मॉडल में, आप Wave2Vec XLS-R मॉडल को तुर्की ऑडियो और ट्रांसक्रिप्शन से फाइन-ट्यून करेंगे ताकि एक ऑटोमैटिक स्पीच रिकग्निशन सिस्टम बनाया जा सके।
पहले आप ऑडियो फाइल्स और टेक्स्ट डेटासेट को समझेंगे, फिर टेक्स्ट टोकनाइज़र, फीचर एक्सट्रैक्शन का उपयोग करेंगे और ऑडियो फाइल्स प्रोसेस करेंगे। उसके बाद आप ट्रेनर, WER फ़ंक्शन बनाएँगे, प्री-ट्रेंड मॉडल्स लोड करेंगे, हाइपरपैरामीटर्स ट्यून करेंगे, और मॉडल को ट्रेन व मूल्यांकित करेंगे।
आप Hugging Face प्लेटफ़ॉर्म का उपयोग मॉडल वेट्स स्टोर करने और वेब ऐप्स प्रकाशित करने के लिए कर सकते हैं ताकि रियल-टाइम में स्पीच का ट्रांसक्रिप्शन हो: Streaming Urdu Asr।
चित्र स्रोत: huggingface.co
23. वन-शॉट फेस स्टाइलाइज़ेशन
One Shot Face Stylization प्रोजेक्ट में, आप या तो मॉडल में संशोधन कर परिणाम सुधार सकते हैं या JoJoGAN को नए डेटासेट पर फाइन-ट्यून करके अपना स्टाइलाइज़ेशन एप्लिकेशन बना सकते हैं।
यह मूल छवि का उपयोग GAN inversion और प्री-ट्रेंड StyleGAN को फाइन-ट्यून करके नई छवि बनाने में करेगा। आप विभिन्न जनरेटिव एडवर्सैरियल नेटवर्क आर्किटेक्चर्स समझेंगे। उसके बाद, अपनी पसंद की शैली बनाने के लिए पेयर्ड डेटासेट इकट्ठा करना शुरू करेंगे।
फिर, StyleGAN के पिछले संस्करण के नमूना समाधान की मदद से, आप नई आर्किटेक्चर के साथ प्रयोग करके यथार्थपरक कला तैयार करेंगे।
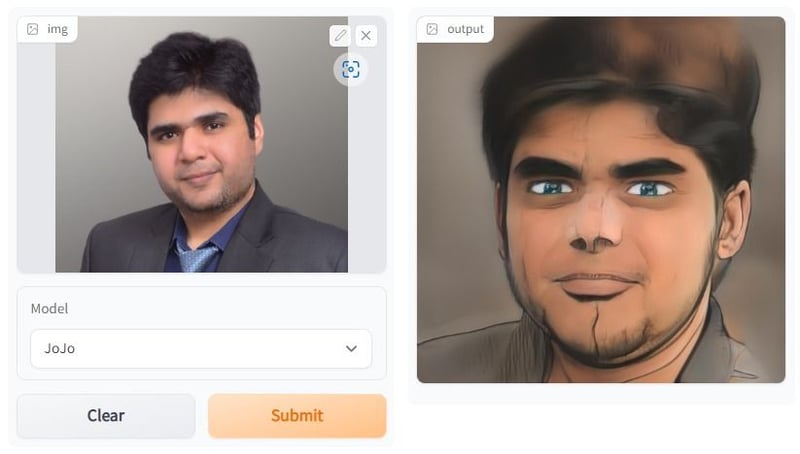
चित्र JoJoGAN से बनाया गया
24. H&M पर्सनलाइज़्ड फ़ैशन रिकमेंडेशंस
H&M Personalized Fashion Recommendations प्रोजेक्ट में, आप पिछली ट्रांज़ैक्शन्स, ग्राहक डेटा, और प्रोडक्ट मेटाडेटा के आधार पर प्रोडक्ट सिफारिशें बनाएँगे।
यह प्रोजेक्ट आपके NLP, CV (Computer Vision) और डीप लर्निंग कौशलों को परखेगा। शुरुआती हफ्तों में आप डेटा को समझेंगे और विभिन्न फीचर्स से बेसलाइन कैसे बनाया जा सकता है, यह जानेंगे।
फिर ऐसा सरल मॉडल बनाएँ जो केवल टेक्स्ट और कैटेगोरिकल फीचर्स लेकर रिकमेंडेशन की भविष्यवाणी करे। उसके बाद, NLP और CV को मिलाकर लीडरबोर्ड पर अपना स्कोर बेहतर करें। कम्युनिटी चर्चाएँ और कोड समीक्षा करके आप समस्या की समझ को और सुदृढ़ कर सकते हैं।
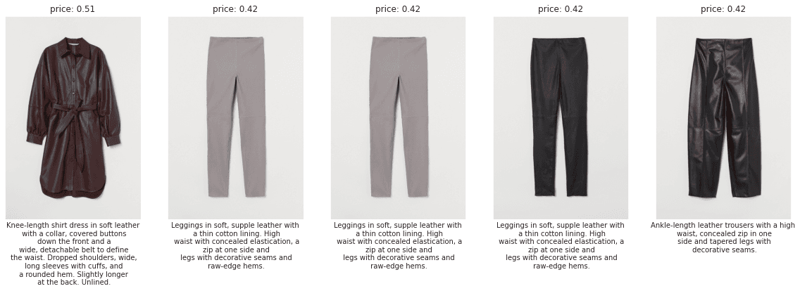
चित्र स्रोत: H&M EDA FIRST LOOK
25. कस्टमर सपोर्ट कॉल्स का विश्लेषण
Analyzing Customer Support Calls प्रोजेक्ट में, आप एक एंड-टू-एंड पाइपलाइन बनाते हैं जो कच्चे ऑडियो को इनसाइट्स में बदलती है। आप ASR मॉडल से कॉल्स ट्रांसक्राइब करेंगे, टेक्स्ट को क्लीन और सेगमेंट करेंगे, सेंटिमेंट एनालिसिस चलाएँगे, और products, plans, locations, तथा names जैसी एंटिटीज़ निकालेंगे। आप एम्बेडिंग्स से ट्रांसक्रिप्ट्स को इंडेक्स भी करेंगे ताकि वार्तालापों में तेज़ सेमांटिक सर्च संभव हो।
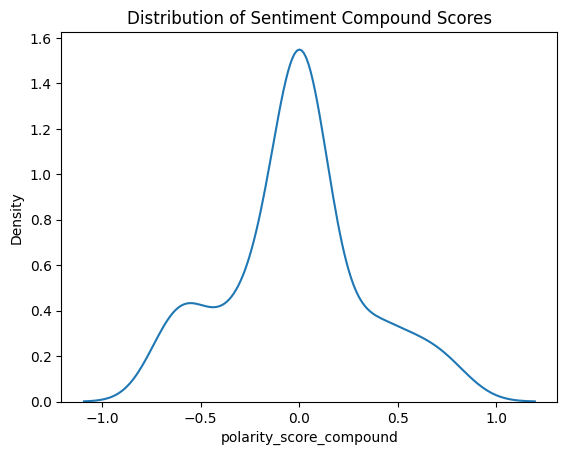
इसके बाद आप ट्रांसक्रिप्शन क्वालिटी और मॉडल प्रदर्शन का मूल्यांकन करेंगे, थीम्स को क्लस्टर कर कॉमन कॉल ड्राइवर्स उजागर करेंगे, और नेगेटिव सेंटिमेंट स्पाइक्स या एस्केलेशन कीवर्ड्स जैसे हाइलाइट्स निकालेंगे।
26. वित्तीय फ्रॉड डिटेक्शन मॉडल की मॉनिटरिंग
Monitoring A Financial Fraud Detection Model प्रोजेक्ट में, आप एक यूके बैंक के लिए पोस्ट-डिप्लॉयमेंट डेटा साइंटिस्ट की भूमिका निभाते हैं और जाँचते हैं कि लाइव फ्रॉड मॉडल क्यों फिसल रहा है। आप प्रोडक्शन प्रिडिक्शन्स और आउटकम्स लोड करेंगे, precision, recall, PR-AUC और calibration जैसी कोर मेट्रिक्स ट्रैक करेंगे, और समय के साथ प्रदर्शन का विज़ुअलाइज़ेशन कर गिरावट पहचानेंगे। आप चैनल, रीजन और कस्टमर सेगमेंट के अनुसार स्लाइस करके देखते हैं कि फॉल्स पॉज़िटिव्स या फॉल्स नेगेटिव्स कहाँ केंद्रित हैं।
इसके बाद आप डिस्ट्रीब्यूशन चेक्स और स्टेबिलिटी इंडाइसेज़ से डेटा और कॉन्सेप्ट ड्रिफ्ट की जाँच करते हैं, फीचर इम्पोर्टेंस में बदलाव देखते हैं, और एक्सप्लेनेबिलिटी टूल्स से वर्तमान बनाम बेसलाइन व्यवहार की तुलना करते हैं।
27. Atari 2600 के लिए रिइनफोर्समेंट लर्निंग एजेंट
MuZero for Atari 2600 प्रोजेक्ट में, आप Atari 2600 गेम्स के लिए MuZero एल्गोरिद्म का उपयोग कर रिइनफोर्समेंट लर्निंग एजेंट बनाएँगे, ट्रेन करेंगे और वैलिडेट करेंगे। MuZero एल्गोरिद्म के बारे में अधिक समझने के लिए यह ट्यूटोरियल पढ़ें।
उद्देश्य एक नई या मौजूदा आर्किटेक्चर में सुधार कर वैश्विक लीडरबोर्ड पर स्कोर बढ़ाना है। रिइनफोर्समेंट लर्निंग में एल्गोरिद्म कैसे काम करता है, इसे समझने में तीन महीने से अधिक लग सकते हैं।
यह प्रोजेक्ट गणित-प्रधान है और आपको Python में दक्षता चाहिए। प्रस्तावित समाधान मिलेंगे, लेकिन विश्व-स्तरीय रैंक पाने के लिए आपको अपना समाधान बनाना होगा।
28. MLOps एंड-टू-एंड मशीन लर्निंग
MLOps End-To-End Machine Learning प्रोजेक्ट शीर्ष कंपनियों में नौकरी पाने के लिए आवश्यक है। आजकल भर्तीकर्ता ऐसे ML इंजीनियर्स चाहते हैं जो MLOps टूल्स, डेटा ऑर्केस्ट्रेशन और क्लाउड कंप्यूटिंग से एंड-टू-एंड सिस्टम बना सकें।
इस प्रोजेक्ट में, आप TensorFlow, Streamlit, Docker, Kubernetes, cloudbuild, GitHub और Google Cloud से एक लोकेशन इमेज क्लासिफायर बनाएँगे और डिप्लॉय करेंगे। मुख्य लक्ष्य CI/CD से मशीन लर्निंग मॉडल्स के बिल्ड और डिप्लॉयमेंट को ऑटोमेट करना है। मार्गदर्शन के लिए Machine Learning, Pipelines, Deployment, and MLOps ट्यूटोरियल पढ़ें।
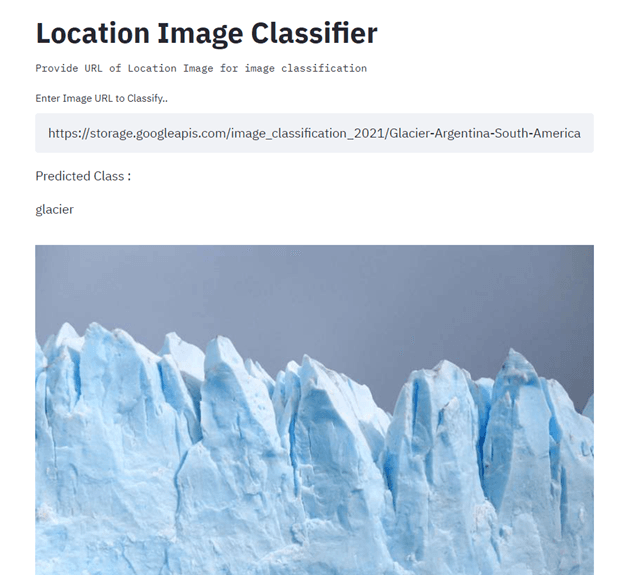
चित्र स्रोत: Senthil E
पोर्टफोलियो बनाने के लिए मशीन लर्निंग प्रोजेक्ट्स
अपना मशीन लर्निंग पोर्टफोलियो बनाने के लिए, आपको अलग दिखने वाले प्रोजेक्ट्स चाहिए। हायरिंग मैनेजर या रिक्रूटर को दिखाएँ कि आप कई भाषाओं में कोड लिख सकते हैं, विभिन्न ML फ्रेमवर्क्स समझते हैं, मशीन लर्निंग से अनोखी समस्याएँ हल कर सकते हैं, और एंड-टू-एंड ML इकोसिस्टम को समझते हैं।
29. GPT-OSS का फाइन-ट्यूनिंग
Fine-Tuning GPT-OSS प्रोजेक्ट में, आप डिपेंडेंसियाँ इंस्टॉल करेंगे, मॉडल और टोकनाइज़र लोड करेंगे, Harmony Python पैकेज से एक स्पष्ट प्रॉम्प्ट शैली परिभाषित करेंगे, और एंड-टू-एंड सब कुछ काम कर रहा है यह सुनिश्चित करने के लिए एक त्वरित बेसलाइन इंफ़ेरेंस चलाएँगे।
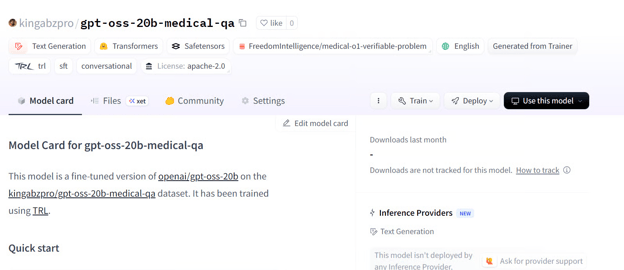
इसके बाद आप Harmony फ़ॉर्मेटिंग के साथ एक मेडिकल Q&A डेटासेट तैयार करेंगे, ट्रेनिंग कॉन्फ़िगर करेंगे, और मॉडल को फाइन-ट्यून करेंगे, जिसके बाद सुधार मापने के लिए पोस्ट-ट्यूनिंग मूल्यांकन करेंगे।
30. ब्रेन MRI डेटासेट पर MedGemma का फाइन-ट्यूनिंग
Fine-Tuning MedGemma on a Brain MRI Dataset प्रोजेक्ट में, आप MedGemma 4B मल्टीमॉडल मॉडल, SigLIP इमेज एन्कोडर और एक मेडिकल-ट्यून LLM को अनुकूलित करके ब्रेन MRI स्कैन्स का क्लासिफिकेशन करेंगे। आप RunPod पर एनवायरनमेंट सेटअप करेंगे, आवश्यक Python पैकेज इंस्टॉल करेंगे, MRI डेटासेट लोड और क्लीन करेंगे, और रन करने से पहले इनपुट्स को सुसंगत resizing, normalization और label mapping से तैयार करेंगे।
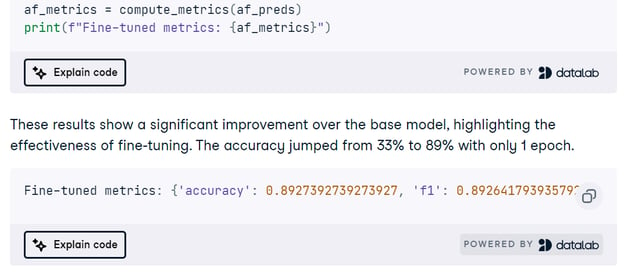
फिर आप MedGemma को MRI कार्य पर फाइन-ट्यून करेंगे, ट्रेनिंग कर्व्स ट्रैक करेंगे, और accuracy, ROC AUC, precision, recall, तथा कन्फ्यूज़न मैट्रिसेज़ से मूल्यांकन कर फेल्योर मोड्स पहचानेंगे।
31. DreamBooth और LoRA के साथ Stable Diffusion XL का फाइन-ट्यूनिंग
Fine-tuning Stable Diffusion XL with DreamBooth and LoRA प्रोजेक्ट में, आप Python में Diffusers के साथ SDXL सेटअप करेंगे, CUDA GPU पर FP16 बेस मॉडल और VAE लोड करेंगे, और छोटे प्रॉम्प्ट्स से इमेज जनरेट करेंगे। आप SDXL refiner से क्वालिटी बूस्ट्स एक्सप्लोर करेंगे, आउटपुट्स की तुलना करेंगे, और कई जेनरेशन को साथ-साथ देखने के लिए एक सरल ग्रिड यूटिलिटी इस्तेमाल करेंगे।
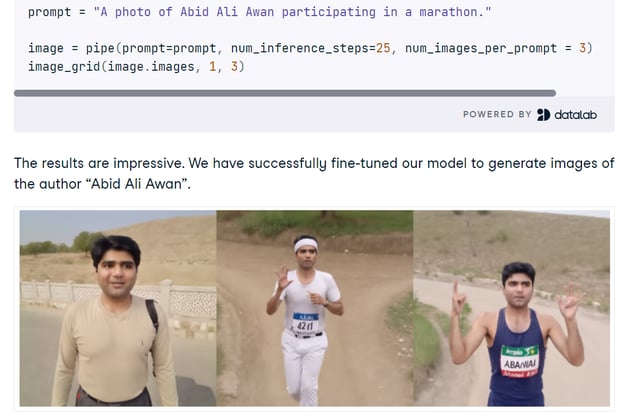
इसके बाद आप AutoTrain Advanced के साथ DreamBooth का उपयोग कर व्यक्तिगत फोटोज़ के एक छोटे सेट पर SDXL को फाइन-ट्यून करेंगे, जिससे तेज़ और मेमोरी-एफिशिएंट इंफ़ेरेंस के लिए फुल चेकपॉइंट की जगह एक कॉम्पैक्ट LoRA एडेप्टर बनेगा। ट्रेनिंग के बाद, आप LoRA वेट्स को बेस पाइपलाइन से जोड़ेंगे, नए प्रॉम्प्ट्स टेस्ट करेंगे, और देखेंगे कि refiner कब पहचान की स्थिरता में मदद करता है या नुकसान पहुँचाता है।
32. लेटेंट डिफ्यूज़न से गीत निर्माण
Song Generation with Latent Diffusion प्रोजेक्ट में, आप एक ओपन-सोर्स डिफ्यूज़न म्यूज़िक मॉडल सेटअप करेंगे जो टेक्स्ट-स्टाइल प्रॉम्प्ट्स या किसी रेफरेंस ऑडियो क्लिप से पूरे गीत जनरेट करता है। आप Conda या Docker से इंस्टॉल करेंगे, एनवायरनमेंट तैयार करेंगे (Windows पर espeak-ng, phonemizer paths), और दिए गए इंफ़ेरेंस स्क्रिप्ट्स चला कर base या full चेकपॉइंट्स से ट्रैक्स बनाएँगे, जब VRAM कम हो तो chunked decoding सक्षम करेंगे।
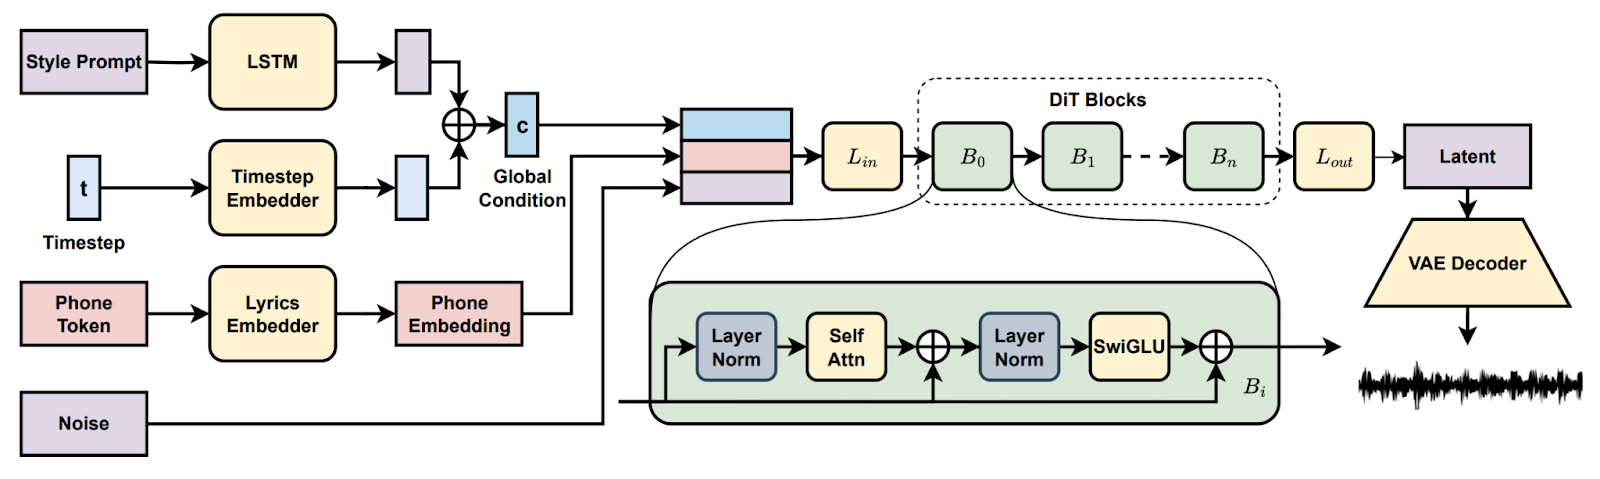
इसके बाद आप गीत कंटिन्यूएशन और एडिटिंग जैसी सुविधाएँ एक्सप्लोर करेंगे, प्रॉम्प्ट्स के बीच एरेंजमेंट्स की तुलना करेंगे, और पुनरुत्पादनयोग्यता के लिए सेटिंग्स का दस्तावेज़ बनाएँगे। अंत तक, आपके पास एंड-टू-एंड म्यूज़िक क्रिएशन के लिए एक व्यावहारिक पाइपलाइन होगी।
33. मशीन लर्निंग एप्लिकेशन को प्रोडक्शन में डिप्लॉय करना
Deploying a Machine Learning Application to Production प्रोजेक्ट में, आप GitHub Actions से पूरी तरह स्वचालित ML पाइपलाइन बनाते हैं जो एक साधारण ड्रग-क्लासिफिकेशन मॉडल को ट्रेन, इवैल्यूएट, वर्ज़न और डिप्लॉय करती है। आप रिपो स्ट्रक्चर और Makefile सेट करते हैं, एनवायरनमेंट सेटअप, लिंटिंग, यूनिट टेस्ट्स और डेटा चेक्स जोड़ते हैं, फिर पुनरुत्पादनयोग्य ट्रेनिंग और इवैल्यूएशन रन स्क्रिप्ट करते हैं जो मेट्रिक्स और आर्टिफैक्ट्स लॉग करते हैं।
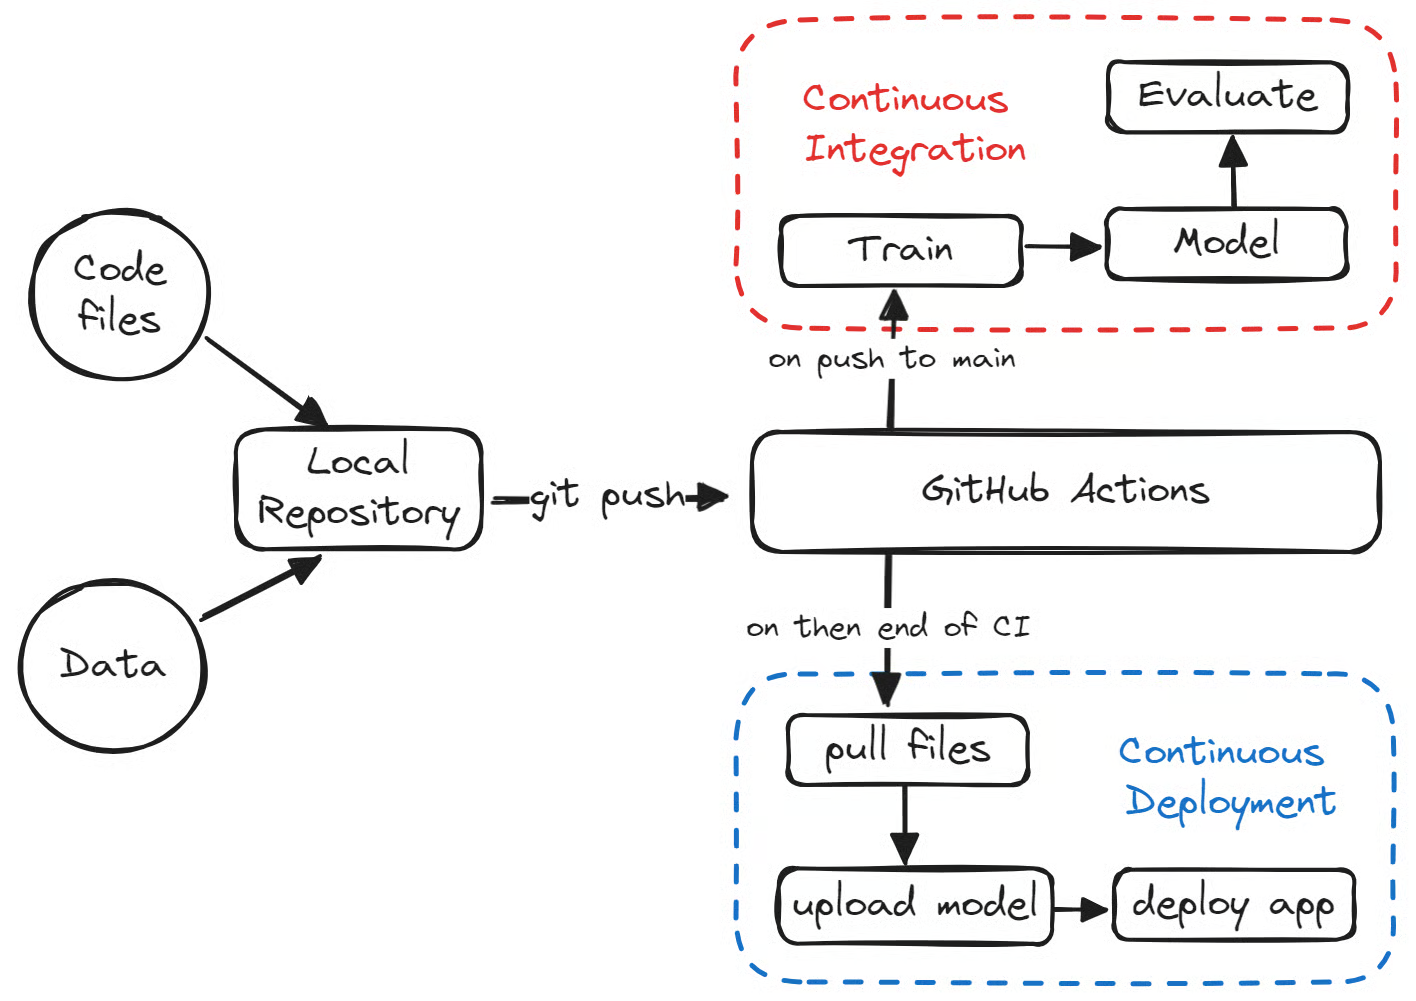
इसके बाद आप continuous integration को pull requests और main pushes पर ट्रिगर होने के लिए वायर करते हैं, CML और Hugging Face CLI से मॉडल आर्टिफैक्ट्स पब्लिश करते हैं, और continuous deployment वर्कफ़्लोज़ के ज़रिए पासिंग मॉडल को डिप्लॉयमेंट तक प्रमोट करते हैं।
मशीन लर्निंग प्रोजेक्ट कैसे शुरू करें?
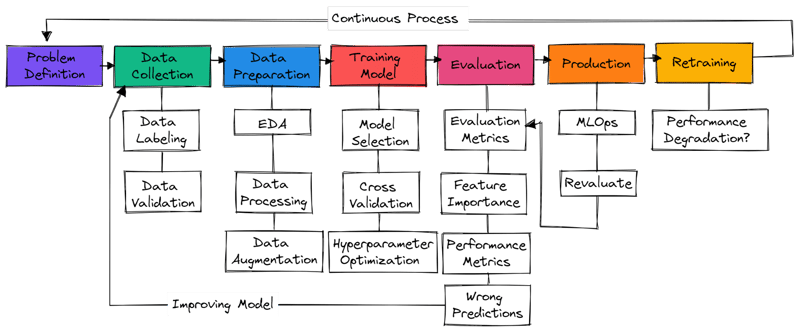
चित्र: लेखक द्वारा
एक सामान्य मशीन लर्निंग प्रोजेक्ट में मानक चरण तय नहीं होते। यह सिर्फ़ डेटा कलेक्शन, डेटा प्रिपरेशन और मॉडल ट्रेनिंग भी हो सकता है। इस खंड में, हम प्रोडक्शन-रेडी मशीन लर्निंग प्रोजेक्ट बनाने के लिए आवश्यक चरणों के बारे में जानेंगे।
समस्या परिभाषा
आपको बिज़नेस समस्या समझनी होगी और एक मोटा विचार बनाना होगा कि उसे हल करने के लिए आप मशीन लर्निंग का कैसे इस्तेमाल करेंगे। शोध-पत्र, ओपन सोर्स प्रोजेक्ट्स, ट्यूटोरियल्स और अन्य कंपनियों द्वारा इस्तेमाल किए गए समान अनुप्रयोग देखें। सुनिश्चित करें कि आपका समाधान यथार्थवादी हो और डेटा आसानी से उपलब्ध हो।
डेटा संग्रह
आप विभिन्न स्रोतों से डेटा इकट्ठा करेंगे, उसे साफ़ और लेबल करेंगे, और डेटा वैलिडेशन के लिए स्क्रिप्ट्स बनाएँगे। सुनिश्चित करें कि आपका डेटा पक्षपाती न हो या उसमें संवेदनशील जानकारी न हो।
डेटा प्रिपरेशन
मिसिंग वैल्यूज़ भरें, डेटा को साफ़ करें और डेटा विश्लेषण के लिए प्रोसेस करें। डेटा के वितरण को समझने और फीचर्स से मॉडल प्रदर्शन कैसे सुधर सकता है, यह जानने के लिए विज़ुअलाइज़ेशन टूल्स का उपयोग करें। मशीन लर्निंग मॉडल के लिए डेटा को ट्रांसफॉर्म करने हेतु फीचर स्केलिंग और डेटा ऑगमेंटेशन का इस्तेमाल करें।
मॉडल ट्रेनिंग
विशिष्ट समस्याओं के लिए आमतौर पर इस्तेमाल होने वाले न्यूरल नेटवर्क्स या मशीन लर्निंग एल्गोरिद्म्स का चयन करें। क्रॉस-वैलिडेशन से मॉडल ट्रेन करें और इष्टतम परिणामों के लिए विभिन्न हाइपरपैरामीटर ऑप्टिमाइज़ेशन तकनीकों का उपयोग करें।
मॉडल मूल्यांकन
टेस्ट डेटासेट पर मॉडल का मूल्यांकन करें। सुनिश्चित करें कि आप विशिष्ट समस्याओं के लिए सही इवैल्यूएशन मेट्रिक का उपयोग कर रहे हैं। सटीकता (accuracy) हर समस्या के लिए मान्य मेट्रिक नहीं होती। क्लासिफिकेशन के लिए F1 या AUC स्कोर, और रिग्रेशन के लिए RMSE देखें। महत्वहीन फीचर्स हटाने के लिए मॉडल फीचर इम्पोर्टेंस का विज़ुअलाइज़ेशन करें। मॉडल ट्रेनिंग और इंफ़ेरेंस समय जैसे प्रदर्शन मेट्रिक्स का आकलन करें।
सुनिश्चित करें कि मॉडल ने मानव बेसलाइन को पार कर लिया है। यदि नहीं, तो अधिक गुणवत्तापूर्ण डेटा एकत्र करने पर लौटें और प्रक्रिया फिर शुरू करें। यह एक आवर्ती प्रक्रिया है जिसमें आप अलग-अलग फीचर इंजीनियरिंग तकनीकों, मॉडल आर्किटेक्चर्स और ML फ्रेमवर्क्स के साथ ट्रेनिंग जारी रखेंगे ताकि प्रदर्शन सुधरे।
प्रोडक्शन
स्टेट-ऑफ़-द-आर्ट परिणाम पाने के बाद, अब अपने मशीन लर्निंग मॉडल को MLOps टूल्स से प्रोडक्शन/क्लाउड में डिप्लॉय करने का समय है। मॉडल को रियल-टाइम डेटा पर मॉनिटर करें। अधिकांश मॉडल प्रोडक्शन में फेल हो जाते हैं, इसलिए बेहतर है कि पहले उन्हें सीमित यूज़र्स के समूह के लिए डिप्लॉय करें।
रीट्रेन
यदि मॉडल वांछित परिणाम नहीं देता, तो आप फिर से शुरुआत करेंगे और बेहतर समाधान निकालेंगे। भले ही बेहतरीन परिणाम मिलें, समय के साथ डेटा ड्रिफ्ट और कॉन्सेप्ट ड्रिफ्ट के कारण मॉडल बिगड़ सकता है। नए डेटा पर रीट्रेनिंग से आपका मॉडल वास्तविक-समय के परिवर्तनों के अनुरूप होता रहता है।
DataCamp for Business के साथ अपनी टीम की वृद्धि को समर्थन दें
जहाँ व्यक्तिगत प्रोजेक्ट्स निजी कौशल विकास के लिए आवश्यक हैं, वहीं संस्थाओं को भी यह सुनिश्चित करना होता है कि उनकी टीमें डेटा एनालिटिक्स की जटिलताओं को संभालने के लिए सक्षम हों। DataCamp for Business कंपनियों को डेटा साइंस, एनालिटिक्स और मशीन लर्निंग में अपने कर्मचारियों को अपस्किल करने में मदद करने के लिए अनुकूल समाधान प्रदान करता है। इंटरैक्टिव कोर्सेज़ की विशाल लाइब्रेरी, कस्टम लर्निंग ट्रैक्स और वास्तविक-जीवन प्रोजेक्ट्स तक पहुँच के साथ टीमें डेटा ingestion, क्लीनिंग, मैनिपुलेशन, विज़ुअलाइज़ेशन और प्रेडिक्टिव एनालिटिक्स—इस ब्लॉग में हाइलाइट किए गए सभी प्रमुख क्षेत्रों—में अपने कौशल विकसित कर सकती हैं।
चाहे आप एक छोटा स्टार्टअप हों या बड़ा एंटरप्राइज़, DataCamp for Business आपको अपस्किल, रिस्किल और डेटा-ड्रिवन संस्कृति बनाने के उपकरण देता है, ताकि आप आज के बाज़ार में प्रतिस्पर्धी बने रहें। अधिक जानने के लिए आप आज ही डेमो का अनुरोध करें।
निष्कर्ष
मशीन लर्निंग प्रोजेक्ट शुरू करना आपको व्यावहारिक अनुभव दिला सकता है, आपका पोर्टफोलियो मज़बूत कर सकता है, और महत्वपूर्ण समस्या-समाधान कौशल विकसित कर सकता है। जिन प्रोजेक्ट्स पर हमने चर्चा की, वे न केवल सिद्धांत और व्यवहार के बीच की खाई पाट सकते हैं, बल्कि आपके सतत सीखने और नवाचार के मार्ग भी खोल सकते हैं।
विविध डेटासेट्स और जटिल चुनौतियों से जुड़कर, आप मशीन लर्निंग में मजबूत नींव बना सकते हैं और शैक्षणिक तथा पेशेवर दोनों क्षेत्रों में सफलता के लिए खुद को तैयार कर सकते हैं। चाहे आप शुरुआती हों या उन्नत शिक्षार्थी, हर प्रोजेक्ट आपको मशीन लर्निंग की कला और विज्ञान में महारत के और करीब लाता है। आज ही हमारे Machine Learning Scientist with Python स्किल ट्रैक के साथ अपनी यात्रा शुरू करें।
FAQs
एक मशीन लर्निंग प्रोजेक्ट के 3 प्रमुख चरण क्या हैं?
डेटा प्रिपरेशन, फीचर इंजीनियरिंग, और मॉडल चयन/ट्रेनिंग। प्रमुख चरण प्रोजेक्ट के अनुसार बदल सकते हैं। डीप लर्निंग प्रोजेक्ट्स में यह डेटा प्रोसेसिंग, मॉडल चयन और मॉडल वैलिडेशन होता है।
आप AI/ML प्रोजेक्ट कैसे शुरू करते हैं?
- बिज़नेस समस्या समझें और देखें कि मशीन लर्निंग उसे कैसे हल कर सकती है।
- सुनिश्चित करें कि आपके पास ट्रेनिंग के लिए आवश्यक गुणवत्तापूर्ण डेटा है।
- डेटा की सफाई और प्रोसेसिंग।
- किसी बिज़नेस केस स्टडी की समीक्षा कर और डेटा एनालिटिक्स करके अपने डेटा के वितरण को समझें।
- मॉडल और बिज़नेस परफॉर्मेंस मेट्रिक्स परिभाषित करें।
- मॉडल चयन और ट्रेनिंग।
- मॉडल वैलिडेशन और रीट्रेनिंग।
- MLOps (Machine Learning Operations) लागू करना
- मॉडल को प्रोडक्शन में डिप्लॉय करना।
क्या मशीन लर्निंग मुश्किल है?
हाँ। एक मशीन लर्निंग इंजीनियर के रूप में नौकरी पाने के लिए, आपको कई प्रोग्रामिंग भाषाओं में महारत, मशीन लर्निंग और डीप लर्निंग एल्गोरिद्म्स की समझ, और मॉडल आर्किटेक्चर सुधारने के लिए उन्नत गणित सीखना ज़रूरी है।
आप ऑपरेशंस पक्ष के बारे में भी सीखेंगे, जैसे MLOps, क्लाउड कंप्यूटिंग, एक्टिव लर्निंग, एक्सपेरिमेंट ट्रैकिंग, डैशबोर्डिंग, CI/CD, और वास्तविक डेटा पर मॉडलों का परीक्षण।
क्या मशीन लर्निंग के लिए Python अच्छा है?
हाँ, यह मशीन लर्निंग प्रैक्टिशनर्स और रिसर्चर्स के बीच लोकप्रिय है।
- इसे सीखना और पढ़ना आसान है।
- आधुनिक मशीन लर्निंग टूल्स Python पर आधारित हैं
- इसका विशाल सहायक समुदाय है
- अन्य भाषाओं और टूल्स के साथ कई इंटीग्रेशंस
- आप डेटा एनालिटिक्स से लेकर वेब डेवलपमेंट तक लगभग सभी कार्य कर सकते हैं।
क्या मैं बिना कोडिंग के मशीन लर्निंग सीख सकता/सकती हूँ?
हाँ, लेकिन आप स्टेट-ऑफ़-द-आर्ट परिणाम पाने में सीमित रहेंगे। अपना ML मॉडल कोड करने से आपको डेटा, पैरामीटर्स, मॉडल आर्किटेक्चर, सिस्टम प्रदर्शन और मॉडल वैलिडेशन पर नियंत्रण मिलता है।
नो-कोड टूल्स औसत डेटा पर अच्छे परिणाम देने में बेहतर होते जा रहे हैं, लेकिन यदि आप नौकरी पाना चाहते हैं, तो आपको मूल बातें सीखनी होंगी और पूरा इकोसिस्टम शून्य से बनाना सीखना होगा।
क्या मशीन लर्निंग एक अच्छा करियर है?
हाँ, मशीन लर्निंग एक शानदार करियर है जो आपको सीखने और आर्टिफिशल इंटेलिजेंस के विकास में योगदान करने का अवसर देता है। विकसित देशों में इसकी मांग अधिक है, और औसतन USA में आप प्रति वर्ष $111,139+ कमा सकते हैं। हमारा मार्गदर्शक पढ़ें: मशीन लर्निंग इंजीनियर कैसे बनें।
क्या अन्य ऐसे प्रोजेक्ट्स हैं जो मेरे लिए प्रासंगिक हो सकते हैं?
हमारे पास ऐसे कई प्रोजेक्ट्स हैं जो हर तरह की रुचि और कौशल स्तर के अनुकूल हैं। इन पर नज़र डालें:
ur:
क्या मशीन लर्निंग अभ्यास के लिए नि:शुल्क संसाधन हैं?
हाँ! यदि आप विश्वविद्यालय के शिक्षक या छात्र हैं, तो आप DataCamp Classrooms का उपयोग करके हमारा पूरा कोर्स/एक्सरसाइज़ कैटलॉग निशुल्क प्राप्त कर सकते हैं।
मशीन लर्निंग प्रोजेक्ट पूरे करने से कई फायदे होते हैं: