训练大语言模型(LLM)的计算成本正日益失控。例如,训练 GPT-4 就让 OpenAI 花费了约 1 亿美元。成本主要来自矩阵乘法运算(简称 MatMul),因此研究人员和开发者自然而然地尝试彻底消除或显著提升其效率。
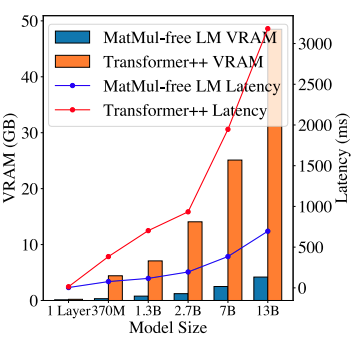
论文 “Scalable MatMul-free Language Modeling” 提出了一个正面解决这一问题的突破性方法。通过完全在 LLM 中消除 MatMul,作者开发出一种在显著降低计算与内存需求的同时,仍能保持有竞争力表现的模型。
来源:Rui-Jie Zhu 等
论文中的所有模型均已发布在 HuggingFace——您可以在线或本地配合 HuggingFace 的库进行试用。此外,研究人员还在 GitHub 提供了代码,方便他人训练模型。
如果您想更好地理解矩阵乘法的立方时间复杂度,推荐阅读这篇关于 大 O 记号与时间复杂度 的入门文章,其中专门介绍了 MatMul 在 LLM 中的时间复杂度。
我也做过无 MatMul 与含 MatMul LLM 的对比——可在这篇文章中查看:无 MatMul 与 MatMul LLM:速度与内存消耗。
大语言模型中的 MatMul 瓶颈
现代基于 Transformer 的 LLM 严重依赖矩阵乘法运算,它们是注意力机制与前馈层等核心组件的基础。MatMul 带来的计算与内存成本巨大,影响训练与推理两个阶段。随着 LLM 规模增大,参数数量与计算复杂度同步增长,使得 MatMul 成为主要瓶颈。
一个常见情形是,GPU 的显存不足以容纳模型规模,被迫转而用 CPU 训练或推理。CPU 并不像 GPU 那样针对并行 MatMul 做了优化,导致计算显著变慢。这会造成一种令人沮丧的循环:即便算力足够,由于内存限制也无法充分利用现有硬件。
多年来,研究者探索了多种减轻 MatMul 计算负担的策略。量化(降低权重与激活的数值精度)是一种常见方法。通过用更少的比特表示数值,量化可以降低 MatMul 的计算成本与内存占用。
然而,这种方法往往以牺牲模型精度为代价,且并未彻底消除 MatMul。微软的 BitNet 等工作表明,用二值或三值量化也能扩展 LLM,但这些模型在某些部分(如自注意力机制)仍依赖 MatMul。
为解决 MatMul 的低效问题,人们也提出了一些替代架构。例如 AdderNet 在部分网络组件中用加法替代乘法,而 二值/三值神经网络 则采用简化的算术运算。
尽管这些方法带来了一定改进,但通常无法彻底移除 MatMul,只能作用于模型的特定部分。结果是总体计算成本依然高企,限制了 LLM 的可扩展性与效率。
无 MatMul 语言模型如何工作
要理解无 MatMul 语言模型(LM)的原理,我们来看看其底层架构与关键组件。
用三值运算取代 MatMul
在传统神经网络中,全连接层(连接相邻两层的所有神经元)依赖 MatMul 来变换输入数据。作者将其替换为使用三值权重的 BitLinear 层。权重不再是任意实数,而被限制为 -1、0 或 1 三个取值。
权重最初以全精度训练,在训练中通过“绝对均值量化(absmean quantization)”被量化为三值。该过程先按权重矩阵元素绝对值的平均值进行缩放,然后把每个元素四舍五入到最近的三值整数(-1、0 或 1)。
这一简化使得可用加减法替代 MatMul 中的乘法。例如,一个数乘以 -1 等同于取相反数,乘以 0 得 0,乘以 1 则不变。
核心组件:MLGRU 与 GLU
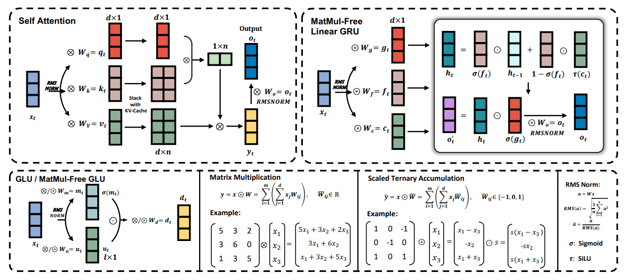
下图概览了无 MatMul 语言模型的关键组件,包括无 MatMul 线性门控循环单元(MLGRU)与无 MatMul 门控线性单元(GLU):
来源:Rui-Jie Zhu 等
该图自左上至右下分为几个部分:
- 自注意力: 展示了传统自注意力机制如何通过矩阵乘法运作。
- 无 MatMul 线性 GRU: 说明了 MLGRU 的结构,突出其如何用逐元素运算与门控机制处理输入序列,而非 MatMul。
- GLU / 无 MatMul GLU: 展示了 GLU 如何在模型嵌入的不同维度间混合信息,并用三值权重消除 MatMul。
- 矩阵乘法 vs. 缩放三值累加: 比较了标准矩阵乘法如何被缩放三值累加所替代,从而简化计算。
- RMS Norm: 介绍了 RMSNorm 操作,在量化前对激活进行归一化。
MLGRU 以逐标记的方式处理输入序列。每一步都将当前标记的嵌入与上一时刻的隐藏状态作为输入。隐藏状态相当于记忆,保存先前标记的信息。MLGRU 随后通过一系列逐元素运算与门控机制更新隐藏状态。这些门控本质上是取值在 0 与 1 之间的向量,通过判断上一隐藏状态与当前标记嵌入的哪些部分与下一步最相关,来控制信息流。这一过程持续到整个序列被处理完毕。
无 MatMul 门控线性单元(GLU)是无 MatMul 语言模型的另一关键组件。它在模型对词语的内部表示(嵌入)的不同维度之间混合信息。简单说,它帮助模型理解每个词的不同方面或特征。
GLU 通过门控机制来控制不同嵌入通道之间的信息流。这一门控机制类似于 MLGRU 的门控,但作用在通道维而非标记维。
无 MatMul GLU 是标准 GLU 的改造版本,借助 BitLinear 层(仅使用 -1、0、1 三值权重的全连接层)来消除矩阵乘法。在无 MatMul GLU 中,输入首先经过两个独立的 BitLinear 层变换。其中一支输出经 SiLU 激活后,与另一支输出做逐元素相乘,形成门控后的结果;随后再通过另一个 BitLinear 层得到最终输出。
以上只是对 MLGRU 与 GLU 的高层次解释。建议您参考原论文以更深入地了解其内部机理与数学形式化。
该研究考察了无 MatMul 模型的缩放定律,并在模型规模增加时,将其表现与传统 Transformer 架构进行比较。
性能与可扩展性
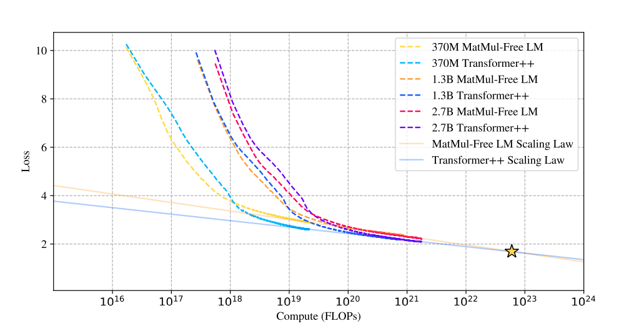
令人惊讶的是,发现随着模型规模增长,两种方法之间的性能差距会缩小。这一重要观察表明,无 MatMul 模型在扩展后将愈发具备与传统 Transformer 竞争的实力,并有望在极大规模下实现超越。
来源:Rui-Jie Zhu 等
这张缩放定律对比图显示,随着浮点运算次数(FLOPs)增加,无 MatMul LM 与传统 Transformer 的损失曲线逐渐收敛。
起初,无 MatMul LM 因三值权重的约束而损失更高。但随着模型规模增长,这一差距缩小,并在某个点(星标)出现交叉,表明二者表现相当。这意味着无 MatMul 模型具有更陡峭的缩放定律:与传统 Transformer 相比,其性能随规模提升而改善得更快。
基准测试结果
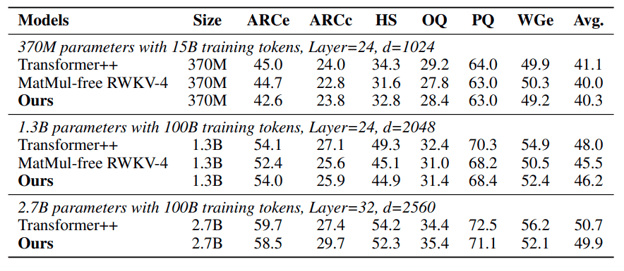
在多种零样本学习基准上,无 MatMul LM 的强劲表现进一步证明了其竞争力。在 ARC-Easy、ARC-Challenge、Hellaswag、Winogrande、PIQA 与 OpenbookQA 等任务中,这些模型常常与传统 Transformer 持平甚至更优,尽管其计算复杂度显著降低。这证明了无 MatMul LM 在替代运算与架构选择上的有效性。
来源:Rui-Jie Zhu 等
这张零样本准确率表明,无 MatMul LM 在各类任务上表现不俗。例如,在难度较高的 ARC-Challenge 基准上,参数量为 27 亿的无 MatMul LM 准确率高于某个传统 Transformer 模型。
同样地,在 Winogrande 与 OpenbookQA 任务上,无 MatMul LM 展现出稳健表现,说明移除 MatMul 并未削弱模型理解与生成语言的能力。
内存效率
无 MatMul LM 的一大亮点是其卓越的内存效率。通过用三值权重支持的更简单加减法替代以乘法为主的运算,这些模型实现了可观的内存节省。
在训练中,优化过的 GPU 实现相较未优化模型可将内存占用降低最多 61%。在推理阶段,内存节省更为显著,可超过 10 倍。这使无 MatMul LM 特别适合在智能手机等资源受限设备上部署,而内存往往是此类设备的限制因素。
来源:Rui-Jie Zhu 等
这张 GPU 内存与时延对比图展示了无 MatMul LM 的效率收益。参数量为 27 亿的无 MatMul LM 在推理内存占用上显著低于相当规模的传统 Transformer。更小的内存占用不仅支持在受限硬件上部署更大的模型,还能转化为更低的时延,使其更适合对响应速度要求极高的实时应用。
从优化 GPU 到定制 FPGA 设计
论文的一项关键进展是无 MatMul LM 的优化 GPU 实现。作者通过在自研 GPU 实现中使用融合内核(fused kernels),将训练速度提升 25.6%,内存占用降低最多 61.0%。融合内核将多步操作合并为单一、更高效的流程,减少与内存访问和数据搬运相关的开销。
为进一步发挥无 MatMul LM 的轻量级运算优势,作者用 SystemVerilog 开发了定制 FPGA 加速器。FPGA(现场可编程门阵列)为实现专用计算任务提供了灵活且高效的硬件平台。
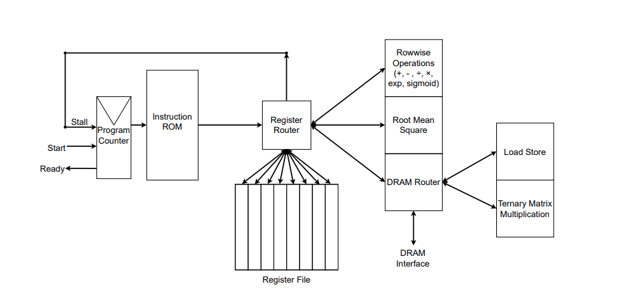
该定制加速器旨在利用三值运算与逐元素乘积的简洁性,从而获得显著效率提升。RTL(寄存器传输级)实现是 FPGA 设计流程中的关键环节:先在较高层次上描述硬件行为,再综合为实际的 FPGA 配置。针对无 MatMul LM 的定制 RTL 设计确保 FPGA 能高效处理这些轻量运算,降低功耗并提高吞吐量。
来源:Rui-Jie Zhu 等
该图展示了定制 FPGA 加速器的 RTL 实现。您可以在 Register Router(寄存器路由器)右侧看到其实现的功能。作者还开发了自有汇编器,将带有自定义指令的汇编文件转换为指令 ROM,如图右侧所示。指令被送入 Register Router,由其管理内存(寄存器文件)并执行指令。
此外,作者在一条 GitHub 议题 的评论中提到,其 FPGA 实现的完整规格仍在优化中,SystemVerilog 代码将于后续公开。
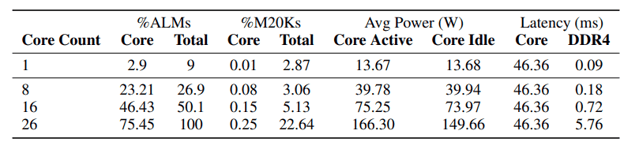
下表给出了无 MatMul 生成 token 的 FPGA 实现所用资源与性能指标。
来源:Rui-Jie Zhu 等
数据显示,随着 FPGA 内部核心(处理单元)数量增加,总体时延最初相对稳定。但当核心数从 16 增至 26 时,时延显著上升,表明负责数据传输的 DDR4 接口在核心数增多、数据传输需求上升时正成为瓶颈。
尽管目前三值矩阵乘法单元主导了总体时延,作者预计在未来版本中优化该单元后,瓶颈将转移到 DDR4 接口。
论文最引人注目的论断之一是,无 MatMul 方法在计算与能耗方面让 LLM 更接近类脑效率。作者认为,其模型在一定程度上模拟了生物神经网络的高效性,并达到了类人阅读速度。
不过,将这些模型的效率与生物神经网络的精妙机制直接比较,是一个复杂且有待深入研究的问题。大脑的计算机制与无 MatMul LM 所用的简化运算有着本质差异且复杂得多。
无 MatMul:影响与未来方向
“Scalable MatMul-free Language Modeling” 这篇论文挑战了自然语言处理中的一个基本假设:矩阵乘法(MatMul)是构建高性能 LLM 的必要条件。
通过论证无 MatMul 架构的可行性,这项研究为 LLM 设计开辟了新前沿,鼓励探索替代性运算与计算范式。这可能引发一波创新浪潮,促使研究人员开发新的模型架构。
面向轻量模型的硬件加速
向无 MatMul 模型的转变不仅关乎软件——也关乎硬件。传统 GPU 等芯片擅长矩阵乘法,但未必最适配这些新型轻量模型。
研究人员打造的定制 FPGA 加速器,展示了 AI 硬件的未来图景——专为从高效模型中榨取每一分性能而设计的特定芯片。这或将催生新一代更快、更节能、并能触及更广泛用户的 AI 设备。
环境影响与可持续性
作为关注环境的人,我对无 MatMul 模型有望降低 AI 碳足迹尤其感到振奋。如今大语言模型巨大的能耗令人担忧。通过显著降低计算需求,这项研究有望为更节能、环境负担更小的 AI 技术铺路。
开放研究问题与未来方向
尽管 “Scalable MatMul-free Language Modeling” 代表着重大进步,它也开启了多条后续研究路径——探索不同的无 MatMul 架构、在更广泛任务上评估其表现、以及从数学上理解此方法的理论极限,都是令人期待的方向。
此外,专门为无 MatMul 模型制定标准化基准与评估指标,将有助于公平比较并加速该领域的进展。迈向真正高效且可及的 AI 的旅程才刚刚开始,前景广阔。我个人也非常期待未来的无 MatMul 助手机器人!
总结
“Scalable MatMul-free Language Modeling” 论文通过引入一种消除矩阵乘法(MatMul)运算的新方法,为 LLM 领域做出了重要贡献。
这一突破解决了传统 LLM 的计算与内存瓶颈,为更高效、更可扩展的模型铺平道路。通过利用加法性运算与三值权重,作者展示了在显著降低资源需求的同时,仍可保持有竞争力的性能。
此研究对 LLM 的未来开发与部署具有深远影响。无 MatMul 模型为传统架构提供了可行替代,能够打造轻量高效、适合边缘设备与移动平台等资源受限环境的模型。
如果您想进一步学习人工智能,欢迎查看这些AI 课程。


训练大语言模型(LLM)的计算成本正日益失控。例如,训练 GPT-4 就让 OpenAI 花费了约 1 亿美元。成本主要来自矩阵乘法运算(简称 MatMul),因此研究人员和开发者自然而然地尝试彻底消除或显著提升其效率。
论文 “Scalable MatMul-free Language Modeling” 提出了一个正面解决这一问题的突破性方法。通过完全在 LLM 中消除 MatMul,作者开发出一种在显著降低计算与内存需求的同时,仍能保持有竞争力表现的模型。
来源:Rui-Jie Zhu 等
论文中的所有模型均已发布在 HuggingFace——您可以在线或本地配合 HuggingFace 的库进行试用。此外,研究人员还在 GitHub 提供了代码,方便他人训练模型。
如果您想更好地理解矩阵乘法的立方时间复杂度,推荐阅读这篇关于 大 O 记号与时间复杂度 的入门文章,其中专门介绍了 MatMul 在 LLM 中的时间复杂度。
我也做过无 MatMul 与含 MatMul LLM 的对比——可在这篇文章中查看:无 MatMul 与 MatMul LLM:速度与内存消耗。
大语言模型中的 MatMul 瓶颈
现代基于 Transformer 的 LLM 严重依赖矩阵乘法运算,它们是注意力机制与前馈层等核心组件的基础。MatMul 带来的计算与内存成本巨大,影响训练与推理两个阶段。随着 LLM 规模增大,参数数量与计算复杂度同步增长,使得 MatMul 成为主要瓶颈。
一个常见情形是,GPU 的显存不足以容纳模型规模,被迫转而用 CPU 训练或推理。CPU 并不像 GPU 那样针对并行 MatMul 做了优化,导致计算显著变慢。这会造成一种令人沮丧的循环:即便算力足够,由于内存限制也无法充分利用现有硬件。
多年来,研究者探索了多种减轻 MatMul 计算负担的策略。量化(降低权重与激活的数值精度)是一种常见方法。通过用更少的比特表示数值,量化可以降低 MatMul 的计算成本与内存占用。
然而,这种方法往往以牺牲模型精度为代价,且并未彻底消除 MatMul。微软的 BitNet 等工作表明,用二值或三值量化也能扩展 LLM,但这些模型在某些部分(如自注意力机制)仍依赖 MatMul。
为解决 MatMul 的低效问题,人们也提出了一些替代架构。例如 AdderNet 在部分网络组件中用加法替代乘法,而 二值/三值神经网络 则采用简化的算术运算。
尽管这些方法带来了一定改进,但通常无法彻底移除 MatMul,只能作用于模型的特定部分。结果是总体计算成本依然高企,限制了 LLM 的可扩展性与效率。
无 MatMul 语言模型如何工作
要理解无 MatMul 语言模型(LM)的原理,我们来看看其底层架构与关键组件。
用三值运算取代 MatMul
在传统神经网络中,全连接层(连接相邻两层的所有神经元)依赖 MatMul 来变换输入数据。作者将其替换为使用三值权重的 BitLinear 层。权重不再是任意实数,而被限制为 -1、0 或 1 三个取值。
权重最初以全精度训练,在训练中通过“绝对均值量化(absmean quantization)”被量化为三值。该过程先按权重矩阵元素绝对值的平均值进行缩放,然后把每个元素四舍五入到最近的三值整数(-1、0 或 1)。
这一简化使得可用加减法替代 MatMul 中的乘法。例如,一个数乘以 -1 等同于取相反数,乘以 0 得 0,乘以 1 则不变。
核心组件:MLGRU 与 GLU
下图概览了无 MatMul 语言模型的关键组件,包括无 MatMul 线性门控循环单元(MLGRU)与无 MatMul 门控线性单元(GLU):
来源:Rui-Jie Zhu 等
该图自左上至右下分为几个部分:
MLGRU 以逐标记的方式处理输入序列。每一步都将当前标记的嵌入与上一时刻的隐藏状态作为输入。隐藏状态相当于记忆,保存先前标记的信息。MLGRU 随后通过一系列逐元素运算与门控机制更新隐藏状态。这些门控本质上是取值在 0 与 1 之间的向量,通过判断上一隐藏状态与当前标记嵌入的哪些部分与下一步最相关,来控制信息流。这一过程持续到整个序列被处理完毕。
无 MatMul 门控线性单元(GLU)是无 MatMul 语言模型的另一关键组件。它在模型对词语的内部表示(嵌入)的不同维度之间混合信息。简单说,它帮助模型理解每个词的不同方面或特征。
GLU 通过门控机制来控制不同嵌入通道之间的信息流。这一门控机制类似于 MLGRU 的门控,但作用在通道维而非标记维。
无 MatMul GLU 是标准 GLU 的改造版本,借助 BitLinear 层(仅使用 -1、0、1 三值权重的全连接层)来消除矩阵乘法。在无 MatMul GLU 中,输入首先经过两个独立的 BitLinear 层变换。其中一支输出经 SiLU 激活后,与另一支输出做逐元素相乘,形成门控后的结果;随后再通过另一个 BitLinear 层得到最终输出。
以上只是对 MLGRU 与 GLU 的高层次解释。建议您参考原论文以更深入地了解其内部机理与数学形式化。
无 MatMul 与 Transformer 对比
该研究考察了无 MatMul 模型的缩放定律,并在模型规模增加时,将其表现与传统 Transformer 架构进行比较。
性能与可扩展性
令人惊讶的是,发现随着模型规模增长,两种方法之间的性能差距会缩小。这一重要观察表明,无 MatMul 模型在扩展后将愈发具备与传统 Transformer 竞争的实力,并有望在极大规模下实现超越。
来源:Rui-Jie Zhu 等
这张缩放定律对比图显示,随着浮点运算次数(FLOPs)增加,无 MatMul LM 与传统 Transformer 的损失曲线逐渐收敛。
起初,无 MatMul LM 因三值权重的约束而损失更高。但随着模型规模增长,这一差距缩小,并在某个点(星标)出现交叉,表明二者表现相当。这意味着无 MatMul 模型具有更陡峭的缩放定律:与传统 Transformer 相比,其性能随规模提升而改善得更快。
基准测试结果
在多种零样本学习基准上,无 MatMul LM 的强劲表现进一步证明了其竞争力。在 ARC-Easy、ARC-Challenge、Hellaswag、Winogrande、PIQA 与 OpenbookQA 等任务中,这些模型常常与传统 Transformer 持平甚至更优,尽管其计算复杂度显著降低。这证明了无 MatMul LM 在替代运算与架构选择上的有效性。
来源:Rui-Jie Zhu 等
这张零样本准确率表明,无 MatMul LM 在各类任务上表现不俗。例如,在难度较高的 ARC-Challenge 基准上,参数量为 27 亿的无 MatMul LM 准确率高于某个传统 Transformer 模型。
同样地,在 Winogrande 与 OpenbookQA 任务上,无 MatMul LM 展现出稳健表现,说明移除 MatMul 并未削弱模型理解与生成语言的能力。
内存效率
无 MatMul LM 的一大亮点是其卓越的内存效率。通过用三值权重支持的更简单加减法替代以乘法为主的运算,这些模型实现了可观的内存节省。
在训练中,优化过的 GPU 实现相较未优化模型可将内存占用降低最多 61%。在推理阶段,内存节省更为显著,可超过 10 倍。这使无 MatMul LM 特别适合在智能手机等资源受限设备上部署,而内存往往是此类设备的限制因素。
来源:Rui-Jie Zhu 等
这张 GPU 内存与时延对比图展示了无 MatMul LM 的效率收益。参数量为 27 亿的无 MatMul LM 在推理内存占用上显著低于相当规模的传统 Transformer。更小的内存占用不仅支持在受限硬件上部署更大的模型,还能转化为更低的时延,使其更适合对响应速度要求极高的实时应用。
从优化 GPU 到定制 FPGA 设计
论文的一项关键进展是无 MatMul LM 的优化 GPU 实现。作者通过在自研 GPU 实现中使用融合内核(fused kernels),将训练速度提升 25.6%,内存占用降低最多 61.0%。融合内核将多步操作合并为单一、更高效的流程,减少与内存访问和数据搬运相关的开销。
为进一步发挥无 MatMul LM 的轻量级运算优势,作者用 SystemVerilog 开发了定制 FPGA 加速器。FPGA(现场可编程门阵列)为实现专用计算任务提供了灵活且高效的硬件平台。
该定制加速器旨在利用三值运算与逐元素乘积的简洁性,从而获得显著效率提升。RTL(寄存器传输级)实现是 FPGA 设计流程中的关键环节:先在较高层次上描述硬件行为,再综合为实际的 FPGA 配置。针对无 MatMul LM 的定制 RTL 设计确保 FPGA 能高效处理这些轻量运算,降低功耗并提高吞吐量。
来源:Rui-Jie Zhu 等
该图展示了定制 FPGA 加速器的 RTL 实现。您可以在 Register Router(寄存器路由器)右侧看到其实现的功能。作者还开发了自有汇编器,将带有自定义指令的汇编文件转换为指令 ROM,如图右侧所示。指令被送入 Register Router,由其管理内存(寄存器文件)并执行指令。
此外,作者在一条 GitHub 议题 的评论中提到,其 FPGA 实现的完整规格仍在优化中,SystemVerilog 代码将于后续公开。
下表给出了无 MatMul 生成 token 的 FPGA 实现所用资源与性能指标。
来源:Rui-Jie Zhu 等
数据显示,随着 FPGA 内部核心(处理单元)数量增加,总体时延最初相对稳定。但当核心数从 16 增至 26 时,时延显著上升,表明负责数据传输的 DDR4 接口在核心数增多、数据传输需求上升时正成为瓶颈。
尽管目前三值矩阵乘法单元主导了总体时延,作者预计在未来版本中优化该单元后,瓶颈将转移到 DDR4 接口。
论文最引人注目的论断之一是,无 MatMul 方法在计算与能耗方面让 LLM 更接近类脑效率。作者认为,其模型在一定程度上模拟了生物神经网络的高效性,并达到了类人阅读速度。
不过,将这些模型的效率与生物神经网络的精妙机制直接比较,是一个复杂且有待深入研究的问题。大脑的计算机制与无 MatMul LM 所用的简化运算有着本质差异且复杂得多。
无 MatMul:影响与未来方向
“Scalable MatMul-free Language Modeling” 这篇论文挑战了自然语言处理中的一个基本假设:矩阵乘法(MatMul)是构建高性能 LLM 的必要条件。
通过论证无 MatMul 架构的可行性,这项研究为 LLM 设计开辟了新前沿,鼓励探索替代性运算与计算范式。这可能引发一波创新浪潮,促使研究人员开发新的模型架构。
面向轻量模型的硬件加速
向无 MatMul 模型的转变不仅关乎软件——也关乎硬件。传统 GPU 等芯片擅长矩阵乘法,但未必最适配这些新型轻量模型。
研究人员打造的定制 FPGA 加速器,展示了 AI 硬件的未来图景——专为从高效模型中榨取每一分性能而设计的特定芯片。这或将催生新一代更快、更节能、并能触及更广泛用户的 AI 设备。
环境影响与可持续性
作为关注环境的人,我对无 MatMul 模型有望降低 AI 碳足迹尤其感到振奋。如今大语言模型巨大的能耗令人担忧。通过显著降低计算需求,这项研究有望为更节能、环境负担更小的 AI 技术铺路。
开放研究问题与未来方向
尽管 “Scalable MatMul-free Language Modeling” 代表着重大进步,它也开启了多条后续研究路径——探索不同的无 MatMul 架构、在更广泛任务上评估其表现、以及从数学上理解此方法的理论极限,都是令人期待的方向。
此外,专门为无 MatMul 模型制定标准化基准与评估指标,将有助于公平比较并加速该领域的进展。迈向真正高效且可及的 AI 的旅程才刚刚开始,前景广阔。我个人也非常期待未来的无 MatMul 助手机器人!
总结
“Scalable MatMul-free Language Modeling” 论文通过引入一种消除矩阵乘法(MatMul)运算的新方法,为 LLM 领域做出了重要贡献。
这一突破解决了传统 LLM 的计算与内存瓶颈,为更高效、更可扩展的模型铺平道路。通过利用加法性运算与三值权重,作者展示了在显著降低资源需求的同时,仍可保持有竞争力的性能。
此研究对 LLM 的未来开发与部署具有深远影响。无 MatMul 模型为传统架构提供了可行替代,能够打造轻量高效、适合边缘设备与移动平台等资源受限环境的模型。
如果您想进一步学习人工智能,欢迎查看这些AI 课程。