Chi phí tính toán để huấn luyện các mô hình ngôn ngữ lớn (LLM) ngày càng vượt ngoài tầm kiểm soát. Chẳng hạn, việc huấn luyện GPT-4 tiêu tốn của OpenAI khoảng 100 triệu đô la. Chi phí chủ yếu đến từ các phép nhân ma trận (viết tắt là MatMul), nên việc các nhà nghiên cứu và nhà phát triển tìm cách loại bỏ hoàn toàn hoặc làm cho chúng hiệu quả hơn là điều tự nhiên.
Bài báo "Scalable MatMul-free Language Modeling" giới thiệu một cách tiếp cận đột phá giải quyết trực diện vấn đề này. Bằng cách loại bỏ hoàn toàn MatMul khỏi LLM, các tác giả đã phát triển một mô hình vẫn giữ được hiệu năng cạnh tranh đồng thời giảm đáng kể yêu cầu về tính toán và bộ nhớ.
Nguồn: Rui-Jie Zhu và cộng sự
Tất cả các mô hình trong bài báo đều có sẵn trên HuggingFace—bạn có thể thử trực tuyến hoặc cục bộ bằng thư viện của HuggingFace. Ngoài ra, các nhà nghiên cứu đã cung cấp mã trên GitHub, cho phép người khác huấn luyện mô hình của họ.
Nếu bạn muốn hiểu rõ hơn về độ phức tạp thời gian bậc ba của phép nhân ma trận, tôi khuyên bạn nên xem phần giới thiệu về Ký hiệu Big-O và Độ phức tạp thời gian, trong đó có một mục riêng về độ phức tạp thời gian của các LLM dùng MatMul.
Tôi cũng đã thực hiện so sánh giữa các LLM không dùng MatMul và dùng MatMul—bạn có thể xem trong bài viết này: Matmul-Free vs MatMul LLMs: Tốc độ và Mức tiêu thụ bộ nhớ.
Nút thắt MatMul trong các mô hình ngôn ngữ lớn
Các LLM hiện đại dựa trên transformer phụ thuộc nhiều vào các phép nhân ma trận, vốn là trung tâm của các thành phần cốt lõi như cơ chế attention và các lớp feedforward. Chi phí tính toán và bộ nhớ liên quan đến các phép MatMul là đáng kể, ảnh hưởng đến cả giai đoạn huấn luyện lẫn suy luận. Khi kích thước LLM tăng lên, số lượng tham số và độ phức tạp tính toán cũng tăng, biến MatMul thành nút thắt lớn.
Ví dụ phổ biến là khi VRAM của GPU không đủ để xử lý kích thước mô hình, buộc người dùng phải huấn luyện hoặc suy luận trên CPU. CPU không được tối ưu cho các phép MatMul song song như GPU, dẫn đến tính toán chậm hơn đáng kể. Điều này tạo ra một vòng lặp gây thất vọng khi phần cứng sẵn có không thể được tận dụng hết do hạn chế bộ nhớ, ngay cả khi sức mạnh tính toán là đủ.
Trong nhiều năm, các nhà nghiên cứu đã khám phá nhiều chiến lược để giảm gánh nặng tính toán của MatMul. Lượng tử hóa, tức giảm độ chính xác của trọng số và kích hoạt, là một cách tiếp cận phổ biến. Bằng cách biểu diễn số với ít bit hơn, lượng tử hóa có thể giảm chi phí tính toán và dấu chân bộ nhớ của các phép MatMul.
Tuy nhiên, phương pháp này thường đánh đổi độ chính xác của mô hình và không loại bỏ hoàn toàn MatMul. Những nỗ lực đáng chú ý như BitNet của Microsoft cho thấy có thể mở rộng LLM bằng lượng tử hóa nhị phân hoặc tam phân, nhưng các mô hình này vẫn dựa vào MatMul cho một số phần, chẳng hạn cơ chế self-attention.
Những kiến trúc thay thế cũng đã được đề xuất để xử lý sự kém hiệu quả của MatMul. Các cách tiếp cận như AdderNet thay phép nhân bằng phép cộng ở một số thành phần mạng, và mạng nơ-ron nhị phân/tam phân sử dụng các phép toán số học đơn giản hóa
Mặc dù các phương pháp này mang lại một số cải thiện, chúng thường không thể loại bỏ hoàn toàn MatMul và chỉ nhắm tới những phần cụ thể của mô hình. Do đó, chi phí tính toán tổng thể vẫn cao, hạn chế khả năng mở rộng và hiệu suất của LLM.
Cách các mô hình ngôn ngữ không dùng MatMul hoạt động
Để hiểu các LM không dùng MatMul hoạt động thế nào, hãy xem xét kiến trúc nền tảng và các thành phần chính.
Thay MatMul bằng các phép toán tam phân
Trong mạng nơ-ron truyền thống, các lớp dày (kết nối tất cả neuron giữa hai lớp liên tiếp) dựa vào MatMul để biến đổi dữ liệu đầu vào. Các tác giả thay thế chúng bằng các lớp BitLinear, sử dụng trọng số tam phân. Thay vì trọng số có thể là bất kỳ số thực nào, chúng bị ràng buộc chỉ còn ba giá trị: -1, 0 hoặc 1.
Các trọng số ban đầu được huấn luyện ở độ chính xác đầy đủ, sau đó trong quá trình huấn luyện, chúng được lượng tử hóa sang giá trị tam phân bằng một quy trình gọi là "lượng tử hóa trị tuyệt đối trung bình" (absmean quantization). Quy trình này nhân ma trận trọng số với giá trị tuyệt đối trung bình của nó rồi làm tròn từng phần tử về số nguyên tam phân gần nhất (-1, 0 hoặc 1).
Sự đơn giản hóa này cho phép thay các phép nhân trong MatMul bằng phép cộng và trừ. Ví dụ, nhân một số với -1 tương đương đổi dấu, nhân với 0 cho kết quả 0, và nhân với 1 giữ nguyên số đó.
Các thành phần lõi: MLGRU và GLU
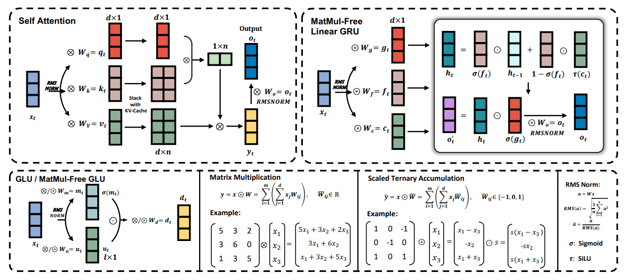
Hình dưới đây cung cấp cái nhìn tổng quan về các thành phần chính của Mô hình Ngôn ngữ Không dùng MatMul, gồm Đơn vị Hồi quy Có cổng Tuyến tính Không dùng MatMul (MLGRU) và Đơn vị Tuyến tính Có cổng Không dùng MatMul (GLU):
Nguồn: Rui-Jie Zhu và cộng sự
Hình được chia thành nhiều phần (từ trên trái xuống dưới phải):
- Self-attention: Phần này cho thấy cơ chế self-attention truyền thống hoạt động với các phép nhân ma trận như thế nào.
- GRU tuyến tính không dùng MatMul: Phần này minh họa kiến trúc MLGRU, nhấn mạnh cách nó xử lý chuỗi đầu vào bằng các phép toán theo phần tử và cơ chế cổng thay vì MatMul.
- GLU / GLU không dùng MatMul: Phần này cho thấy GLU trộn thông tin qua các chiều khác nhau của embedding của mô hình, sử dụng trọng số tam phân để loại bỏ MatMul.
- Phép nhân ma trận so với tích lũy tam phân có tỉ lệ: So sánh này cho thấy cách phép nhân ma trận tiêu chuẩn được thay bằng tích lũy tam phân có tỉ lệ, đơn giản hóa tính toán.
- RMS norm: Phần này mô tả phép RMSNorm, dùng để chuẩn hóa kích hoạt trước khi lượng tử hóa.
MLGRU hoạt động bằng cách xử lý chuỗi đầu vào từng token một. Ở mỗi bước, nó nhận embedding của token hiện tại và trạng thái ẩn trước đó làm đầu vào. Trạng thái ẩn đóng vai trò bộ nhớ, lưu trữ thông tin từ các token trước. MLGRU sau đó cập nhật trạng thái ẩn này bằng một loạt phép toán theo phần tử và cơ chế cổng. Các cổng này, về bản chất là các vector số nằm giữa 0 và 1, kiểm soát luồng thông tin bằng cách xác định phần nào của trạng thái ẩn trước đó và embedding của token hiện tại là quan trọng nhất cho bước kế tiếp. Quá trình này tiếp tục cho đến khi toàn bộ chuỗi được xử lý.
Đơn vị tuyến tính có cổng không dùng MatMul (GLU) là một thành phần chủ chốt khác của mô hình ngôn ngữ không dùng MatMul. Nó trộn thông tin qua các chiều khác nhau của biểu diễn nội bộ về từ (embedding) của mô hình. Nói đơn giản, nó giúp mô hình hiểu các khía cạnh hay đặc trưng khác nhau của mỗi từ.
GLU đạt được điều này bằng cách dùng cơ chế cổng để kiểm soát luồng thông tin giữa các kênh embedding. Cơ chế cổng này tương tự các cổng trong MLGRU, nhưng hoạt động trên chiều kênh thay vì chiều token.
GLU không dùng MatMul là phiên bản điều chỉnh của GLU tiêu chuẩn, được thích ứng để loại bỏ các phép nhân ma trận bằng cách sử dụng các lớp BitLinear, tức các lớp dày dùng trọng số tam phân (trọng số chỉ có thể nhận các giá trị -1, 0 hoặc 1). Trong GLU không dùng MatMul, đầu vào trước hết được biến đổi bằng hai lớp BitLinear riêng biệt. Đầu ra của một lớp đi qua hàm kích hoạt SiLU rồi nhân theo phần tử với đầu ra của lớp còn lại. Kết quả có cổng này sau đó đi qua một lớp BitLinear khác để tạo ra đầu ra cuối cùng.
Đây chỉ là phần giải thích ở mức cao về các thành phần MLGRU và GLU. Tôi khuyến khích bạn tham khảo bài báo nghiên cứu gốc để hiểu chi tiết hơn về cơ chế nội tại và các công thức toán học.
Nghiên cứu khảo sát các quy luật mở rộng (scaling laws) của các mô hình không dùng MatMul, so sánh hiệu năng của chúng với kiến trúc Transformer truyền thống khi kích thước mô hình tăng lên.
Hiệu năng và khả năng mở rộng
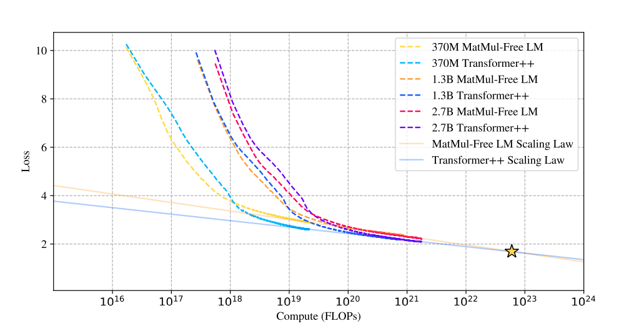
Đáng ngạc nhiên, kết quả cho thấy khoảng cách hiệu năng giữa hai cách tiếp cận này thu hẹp lại khi kích thước mô hình tăng. Đây là một quan sát quan trọng vì nó gợi ý rằng các mô hình không dùng MatMul ngày càng cạnh tranh với Transformer truyền thống khi mở rộng, và có thể vượt trội ở quy mô rất lớn.
Nguồn: Rui-Jie Zhu và cộng sự
Biểu đồ so sánh quy luật mở rộng này cho thấy các đường cong loss của LMs không dùng MatMul và transformer truyền thống hội tụ khi số lượng phép toán dấu chấm động (FLOPs) tăng.
Ban đầu, LMs không dùng MatMul có loss cao hơn do ràng buộc về trọng số tam phân. Tuy nhiên, khoảng cách này giảm dần khi kích thước mô hình tăng, và tại một thời điểm (ngôi sao), các đường cong giao nhau, cho thấy hiệu năng tương đương. Điều này gợi ý quy luật mở rộng dốc hơn cho các mô hình không dùng MatMul, tức hiệu năng của chúng cải thiện nhanh hơn khi tăng kích thước so với Transformer truyền thống.
Kết quả benchmark
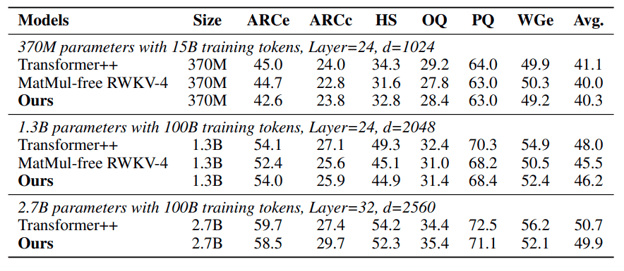
Hiệu năng cạnh tranh của LMs không dùng MatMul còn được củng cố bởi kết quả mạnh mẽ trên nhiều benchmark học zero-shot. Trong các tác vụ như ARC-Easy, ARC-Challenge, Hellaswag, Winogrande, PIQA và OpenbookQA, các mô hình này thường đạt kết quả ngang bằng hoặc vượt Transformer truyền thống, dù độ phức tạp tính toán giảm đi đáng kể. Đây là minh chứng cho hiệu quả của các phép toán thay thế và lựa chọn kiến trúc trong LMs không dùng MatMul.
Nguồn: Rui-Jie Zhu và cộng sự
Bảng về độ chính xác zero-shot cho thấy LMs không dùng MatMul có hiệu năng cạnh tranh trên nhiều tác vụ. Chẳng hạn, ở ARC-Challenge, một benchmark đặc biệt khó, mô hình không dùng MatMul 2,7B tham số đạt độ chính xác cao hơn một mô hình transformer truyền thống.
Tương tự, trên các tác vụ Winogrande và OpenbookQA, các LMs không dùng MatMul thể hiện hiệu năng vững vàng, cho thấy việc loại bỏ MatMul không làm suy giảm khả năng hiểu và sinh ngôn ngữ của mô hình.
Hiệu quả bộ nhớ
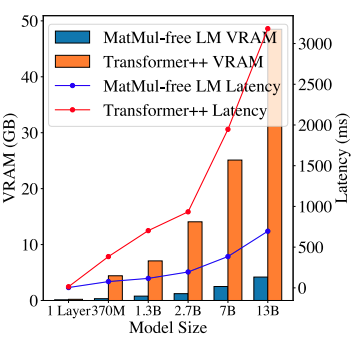
Một trong những lợi thế nổi bật nhất của LMs không dùng MatMul là hiệu quả bộ nhớ vượt trội. Bằng cách thay các phép toán nặng về nhân bằng những phép cộng và trừ đơn giản nhờ trọng số tam phân, các mô hình này giảm đáng kể mức sử dụng bộ nhớ.
Trong huấn luyện, một triển khai GPU tối ưu hóa có thể giảm tiêu thụ bộ nhớ tới 61% so với các mô hình chưa tối ưu. Khi suy luận, mức tiết kiệm bộ nhớ còn ấn tượng hơn, với mức giảm hơn mười lần. Điều này khiến LMs không dùng MatMul đặc biệt hấp dẫn để triển khai trên các thiết bị hạn chế tài nguyên như điện thoại thông minh, nơi bộ nhớ thường là yếu tố giới hạn.
Nguồn: Rui-Jie Zhu và cộng sự
Biểu đồ so sánh bộ nhớ GPU và độ trễ minh họa mức tăng hiệu quả của LMs không dùng MatMul. Mức tiêu thụ bộ nhớ suy luận của mô hình 2,7B tham số không dùng MatMul thấp hơn đáng kể so với Transformer truyền thống tương đương. Dấu chân bộ nhớ nhỏ hơn này không chỉ cho phép triển khai các mô hình lớn hơn trên phần cứng hạn chế mà còn chuyển thành độ trễ thấp hơn, giúp các mô hình này phù hợp hơn cho các ứng dụng thời gian thực đòi hỏi khả năng phản hồi nhanh.
Từ GPU tối ưu đến thiết kế FPGA tùy chỉnh
Một trong những tiến bộ then chốt trình bày trong bài báo là triển khai GPU tối ưu hóa cho các LMs không dùng MatMul. Các tác giả đạt mức tăng 25,6% tốc độ huấn luyện và giảm tới 61,0% mức dùng bộ nhớ bằng cách sử dụng các kernel hợp nhất trong triển khai GPU của riêng họ. Các kernel này kết hợp nhiều phép toán thành một quy trình đơn, hiệu quả hơn, giảm chi phí truy cập bộ nhớ và di chuyển dữ liệu.
Để khai thác sâu hơn các phép toán nhẹ của LMs không dùng MatMul, các tác giả phát triển một bộ gia tốc FPGA tùy chỉnh bằng SystemVerilog. FPGA (Field-Programmable Gate Arrays) cung cấp nền tảng phần cứng linh hoạt và hiệu quả để hiện thực các tác vụ tính toán chuyên biệt.
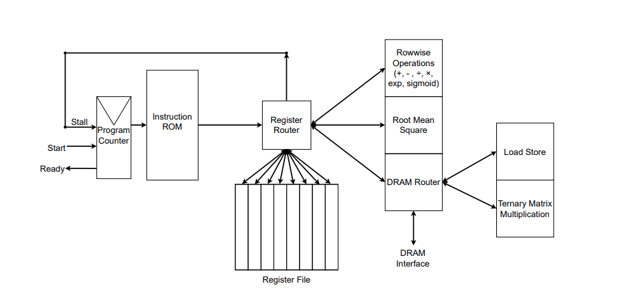
Bộ gia tốc tùy chỉnh được thiết kế để tận dụng sự đơn giản của các phép toán tam phân và tích theo phần tử, đạt được mức tăng hiệu quả đáng kể. Triển khai RTL (Register Transfer Level) là bước quan trọng trong quy trình thiết kế FPGA. Nó bao gồm việc đặc tả hành vi phần cứng ở mức cao, sau đó được tổng hợp thành cấu hình FPGA thực tế. Thiết kế RTL tùy chỉnh cho LMs không dùng MatMul đảm bảo FPGA có thể xử lý hiệu quả các phép toán nhẹ, giảm tiêu thụ điện và tăng thông lượng.
Nguồn: Rui-Jie Zhu và cộng sự
Hình minh họa triển khai RTL của bộ gia tốc FPGA tùy chỉnh. Bạn có thể thấy các chức năng mà nó hiện thực ở bên phải Register Router. Các tác giả cũng phát triển assembler của riêng họ để chuyển các tệp assembly với tập lệnh tùy chỉnh thành ROM lệnh, bạn có thể thấy ở bên phải hình. Các lệnh được đưa vào Register Router, thành phần quản lý bộ nhớ (Register File) và thực thi lệnh.
Hơn nữa, các tác giả đề cập trong một bình luận tại vấn đề trên GitHub rằng thông số kỹ thuật đầy đủ của triển khai FPGA vẫn đang được tối ưu hóa và mã SystemVerilog sẽ được công khai sau.
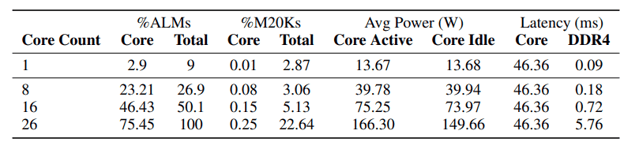
Bảng dưới đây hiển thị mức sử dụng tài nguyên và các chỉ số hiệu năng cho triển khai FPGA của quá trình sinh token không dùng MatMul.
Nguồn: Rui-Jie Zhu và cộng sự
Dữ liệu cho thấy khi số lượng lõi (đơn vị xử lý) trong FPGA tăng, độ trễ tổng thể ban đầu vẫn tương đối ổn định. Tuy nhiên, độ trễ tăng đáng kể từ 16 lên 26 lõi, cho thấy giao diện DDR4, chịu trách nhiệm truyền dữ liệu, đang trở thành nút thắt khi nhu cầu truyền dữ liệu tăng cùng số lõi.
Trong khi phép toán nhân ma trận tam phân hiện đang chiếm ưu thế trong độ trễ tổng thể, các tác giả kỳ vọng rằng việc tối ưu hóa đơn vị này trong các triển khai tương lai sẽ chuyển nút thắt sang giao diện DDR4.
Một trong những tuyên bố thú vị nhất của bài báo là cách tiếp cận không dùng MatMul đưa LLM tiến gần hơn đến hiệu quả giống não bộ về mặt tính toán và tiêu thụ năng lượng. Các tác giả lập luận rằng mô hình của họ mô phỏng hiệu quả của mạng nơ-ron sinh học và đạt tốc độ đọc giống con người.
Tuy nhiên, so sánh trực tiếp hiệu quả của các mô hình này với sự hoạt động phức tạp của mạng nơ-ron sinh học là một vấn đề phức tạp cần được nghiên cứu thêm. Cơ chế tính toán của não bộ rất khác và phức tạp hơn nhiều so với các phép toán đơn giản hóa dùng trong LMs không dùng MatMul.
Không dùng MatMul: Hệ quả và hướng đi tương lai
Bài báo "Scalable MatMul-free Language Modeling" thách thức một giả định nền tảng trong xử lý ngôn ngữ tự nhiên: rằng phép nhân ma trận (MatMul) là thiết yếu để xây dựng các LLM hiệu năng cao.
Bằng cách chứng minh tính khả thi của các kiến trúc không dùng MatMul, nghiên cứu này mở ra một biên giới mới trong thiết kế LLM, khuyến khích khám phá những phép toán và mô hình tính toán thay thế. Điều này có thể dẫn tới làn sóng đổi mới, với việc các nhà nghiên cứu phát triển những kiến trúc mô hình mới.
Tăng tốc phần cứng cho mô hình nhẹ
Sự dịch chuyển sang các mô hình không dùng MatMul không chỉ là vấn đề phần mềm—mà còn là phần cứng. Các chip truyền thống như GPU rất mạnh ở phép nhân ma trận nhưng không nhất thiết là phù hợp nhất cho các mô hình nhẹ, mới này.
Bộ gia tốc FPGA tùy chỉnh do các nhà nghiên cứu xây dựng là một cái nhìn thoáng qua về tương lai phần cứng AI—các chip chuyên dụng được thiết kế để khai thác tối đa hiệu năng từ những mô hình hiệu quả này. Điều đó có thể dẫn tới một thế hệ thiết bị hỗ trợ AI hoàn toàn mới, nhanh hơn, tiết kiệm năng lượng hơn và tiếp cận được với nhiều đối tượng hơn.
Tác động môi trường và tính bền vững
Là người quan tâm đến môi trường, tôi đặc biệt hào hứng với tiềm năng của các mô hình không dùng MatMul trong việc giảm dấu chân carbon của AI. Mức tiêu thụ năng lượng khổng lồ của các mô hình ngôn ngữ lớn hiện nay là mối quan ngại thực sự. Bằng cách giảm đáng kể nhu cầu tính toán, nghiên cứu này có thể mở đường cho các công nghệ AI tiết kiệm năng lượng hơn với dấu chân môi trường nhỏ hơn.
Câu hỏi nghiên cứu mở và hướng phát triển
Mặc dù bài báo "Scalable MatMul-free Language Modeling" là một bước nhảy vọt, nó cũng mở ra nhiều hướng nghiên cứu tiếp theo—khám phá các kiến trúc không dùng MatMul khác nhau, đánh giá hiệu năng của chúng trên phạm vi tác vụ rộng hơn, và hiểu toán học về các giới hạn lý thuyết của cách tiếp cận này chỉ là vài hướng thú vị.
Ngoài ra, việc phát triển các benchmark và thước đo đánh giá tiêu chuẩn dành riêng cho mô hình không dùng MatMul sẽ tạo điều kiện cho so sánh công bằng và thúc đẩy tiến bộ trong lĩnh vực này. Hành trình hướng tới AI thực sự hiệu quả và dễ tiếp cận mới chỉ bắt đầu, và các khả năng là vô hạn. Cá nhân tôi cũng rất háo hức được thử các chatbot trợ lý không dùng MatMul trong tương lai!
Kết luận
Bài báo "Scalable MatMul-free Language Modeling" đóng góp đáng kể cho lĩnh vực LLM bằng cách giới thiệu một cách tiếp cận mới loại bỏ các phép nhân ma trận (MatMul).
Đột phá này giải quyết các nút thắt về tính toán và bộ nhớ gắn liền với LLM truyền thống, mở đường cho những mô hình hiệu quả và có khả năng mở rộng hơn. Bằng cách tận dụng các phép toán cộng/trừ và trọng số tam phân, các tác giả chứng minh rằng có thể duy trì hiệu năng cạnh tranh đồng thời giảm đáng kể nhu cầu tài nguyên.
Tác động tiềm năng của nghiên cứu này đối với tương lai phát triển và triển khai LLM là sâu rộng. Các mô hình không dùng MatMul mang đến một lựa chọn khả thi thay cho kiến trúc thông thường, cho phép tạo ra những mô hình nhẹ, hiệu quả, phù hợp với môi trường hạn chế tài nguyên như thiết bị biên và nền tảng di động.
Nếu bạn muốn tìm hiểu thêm về trí tuệ nhân tạo, hãy khám phá các khóa học AI này.




Chi phí tính toán để huấn luyện các mô hình ngôn ngữ lớn (LLM) ngày càng vượt ngoài tầm kiểm soát. Chẳng hạn, việc huấn luyện GPT-4 tiêu tốn của OpenAI khoảng 100 triệu đô la. Chi phí chủ yếu đến từ các phép nhân ma trận (viết tắt là MatMul), nên việc các nhà nghiên cứu và nhà phát triển tìm cách loại bỏ hoàn toàn hoặc làm cho chúng hiệu quả hơn là điều tự nhiên.
Bài báo "Scalable MatMul-free Language Modeling" giới thiệu một cách tiếp cận đột phá giải quyết trực diện vấn đề này. Bằng cách loại bỏ hoàn toàn MatMul khỏi LLM, các tác giả đã phát triển một mô hình vẫn giữ được hiệu năng cạnh tranh đồng thời giảm đáng kể yêu cầu về tính toán và bộ nhớ.
Nguồn: Rui-Jie Zhu và cộng sự
Tất cả các mô hình trong bài báo đều có sẵn trên HuggingFace—bạn có thể thử trực tuyến hoặc cục bộ bằng thư viện của HuggingFace. Ngoài ra, các nhà nghiên cứu đã cung cấp mã trên GitHub, cho phép người khác huấn luyện mô hình của họ.
Nếu bạn muốn hiểu rõ hơn về độ phức tạp thời gian bậc ba của phép nhân ma trận, tôi khuyên bạn nên xem phần giới thiệu về Ký hiệu Big-O và Độ phức tạp thời gian, trong đó có một mục riêng về độ phức tạp thời gian của các LLM dùng MatMul.
Tôi cũng đã thực hiện so sánh giữa các LLM không dùng MatMul và dùng MatMul—bạn có thể xem trong bài viết này: Matmul-Free vs MatMul LLMs: Tốc độ và Mức tiêu thụ bộ nhớ.
Nút thắt MatMul trong các mô hình ngôn ngữ lớn
Các LLM hiện đại dựa trên transformer phụ thuộc nhiều vào các phép nhân ma trận, vốn là trung tâm của các thành phần cốt lõi như cơ chế attention và các lớp feedforward. Chi phí tính toán và bộ nhớ liên quan đến các phép MatMul là đáng kể, ảnh hưởng đến cả giai đoạn huấn luyện lẫn suy luận. Khi kích thước LLM tăng lên, số lượng tham số và độ phức tạp tính toán cũng tăng, biến MatMul thành nút thắt lớn.
Ví dụ phổ biến là khi VRAM của GPU không đủ để xử lý kích thước mô hình, buộc người dùng phải huấn luyện hoặc suy luận trên CPU. CPU không được tối ưu cho các phép MatMul song song như GPU, dẫn đến tính toán chậm hơn đáng kể. Điều này tạo ra một vòng lặp gây thất vọng khi phần cứng sẵn có không thể được tận dụng hết do hạn chế bộ nhớ, ngay cả khi sức mạnh tính toán là đủ.
Trong nhiều năm, các nhà nghiên cứu đã khám phá nhiều chiến lược để giảm gánh nặng tính toán của MatMul. Lượng tử hóa, tức giảm độ chính xác của trọng số và kích hoạt, là một cách tiếp cận phổ biến. Bằng cách biểu diễn số với ít bit hơn, lượng tử hóa có thể giảm chi phí tính toán và dấu chân bộ nhớ của các phép MatMul.
Tuy nhiên, phương pháp này thường đánh đổi độ chính xác của mô hình và không loại bỏ hoàn toàn MatMul. Những nỗ lực đáng chú ý như BitNet của Microsoft cho thấy có thể mở rộng LLM bằng lượng tử hóa nhị phân hoặc tam phân, nhưng các mô hình này vẫn dựa vào MatMul cho một số phần, chẳng hạn cơ chế self-attention.
Những kiến trúc thay thế cũng đã được đề xuất để xử lý sự kém hiệu quả của MatMul. Các cách tiếp cận như AdderNet thay phép nhân bằng phép cộng ở một số thành phần mạng, và mạng nơ-ron nhị phân/tam phân sử dụng các phép toán số học đơn giản hóa
Mặc dù các phương pháp này mang lại một số cải thiện, chúng thường không thể loại bỏ hoàn toàn MatMul và chỉ nhắm tới những phần cụ thể của mô hình. Do đó, chi phí tính toán tổng thể vẫn cao, hạn chế khả năng mở rộng và hiệu suất của LLM.
Cách các mô hình ngôn ngữ không dùng MatMul hoạt động
Để hiểu các LM không dùng MatMul hoạt động thế nào, hãy xem xét kiến trúc nền tảng và các thành phần chính.
Thay MatMul bằng các phép toán tam phân
Trong mạng nơ-ron truyền thống, các lớp dày (kết nối tất cả neuron giữa hai lớp liên tiếp) dựa vào MatMul để biến đổi dữ liệu đầu vào. Các tác giả thay thế chúng bằng các lớp BitLinear, sử dụng trọng số tam phân. Thay vì trọng số có thể là bất kỳ số thực nào, chúng bị ràng buộc chỉ còn ba giá trị: -1, 0 hoặc 1.
Các trọng số ban đầu được huấn luyện ở độ chính xác đầy đủ, sau đó trong quá trình huấn luyện, chúng được lượng tử hóa sang giá trị tam phân bằng một quy trình gọi là "lượng tử hóa trị tuyệt đối trung bình" (absmean quantization). Quy trình này nhân ma trận trọng số với giá trị tuyệt đối trung bình của nó rồi làm tròn từng phần tử về số nguyên tam phân gần nhất (-1, 0 hoặc 1).
Sự đơn giản hóa này cho phép thay các phép nhân trong MatMul bằng phép cộng và trừ. Ví dụ, nhân một số với -1 tương đương đổi dấu, nhân với 0 cho kết quả 0, và nhân với 1 giữ nguyên số đó.
Các thành phần lõi: MLGRU và GLU
Hình dưới đây cung cấp cái nhìn tổng quan về các thành phần chính của Mô hình Ngôn ngữ Không dùng MatMul, gồm Đơn vị Hồi quy Có cổng Tuyến tính Không dùng MatMul (MLGRU) và Đơn vị Tuyến tính Có cổng Không dùng MatMul (GLU):
Nguồn: Rui-Jie Zhu và cộng sự
Hình được chia thành nhiều phần (từ trên trái xuống dưới phải):
MLGRU hoạt động bằng cách xử lý chuỗi đầu vào từng token một. Ở mỗi bước, nó nhận embedding của token hiện tại và trạng thái ẩn trước đó làm đầu vào. Trạng thái ẩn đóng vai trò bộ nhớ, lưu trữ thông tin từ các token trước. MLGRU sau đó cập nhật trạng thái ẩn này bằng một loạt phép toán theo phần tử và cơ chế cổng. Các cổng này, về bản chất là các vector số nằm giữa 0 và 1, kiểm soát luồng thông tin bằng cách xác định phần nào của trạng thái ẩn trước đó và embedding của token hiện tại là quan trọng nhất cho bước kế tiếp. Quá trình này tiếp tục cho đến khi toàn bộ chuỗi được xử lý.
Đơn vị tuyến tính có cổng không dùng MatMul (GLU) là một thành phần chủ chốt khác của mô hình ngôn ngữ không dùng MatMul. Nó trộn thông tin qua các chiều khác nhau của biểu diễn nội bộ về từ (embedding) của mô hình. Nói đơn giản, nó giúp mô hình hiểu các khía cạnh hay đặc trưng khác nhau của mỗi từ.
GLU đạt được điều này bằng cách dùng cơ chế cổng để kiểm soát luồng thông tin giữa các kênh embedding. Cơ chế cổng này tương tự các cổng trong MLGRU, nhưng hoạt động trên chiều kênh thay vì chiều token.
GLU không dùng MatMul là phiên bản điều chỉnh của GLU tiêu chuẩn, được thích ứng để loại bỏ các phép nhân ma trận bằng cách sử dụng các lớp BitLinear, tức các lớp dày dùng trọng số tam phân (trọng số chỉ có thể nhận các giá trị -1, 0 hoặc 1). Trong GLU không dùng MatMul, đầu vào trước hết được biến đổi bằng hai lớp BitLinear riêng biệt. Đầu ra của một lớp đi qua hàm kích hoạt SiLU rồi nhân theo phần tử với đầu ra của lớp còn lại. Kết quả có cổng này sau đó đi qua một lớp BitLinear khác để tạo ra đầu ra cuối cùng.
Đây chỉ là phần giải thích ở mức cao về các thành phần MLGRU và GLU. Tôi khuyến khích bạn tham khảo bài báo nghiên cứu gốc để hiểu chi tiết hơn về cơ chế nội tại và các công thức toán học.
Không dùng MatMul so với Transformer
Nghiên cứu khảo sát các quy luật mở rộng (scaling laws) của các mô hình không dùng MatMul, so sánh hiệu năng của chúng với kiến trúc Transformer truyền thống khi kích thước mô hình tăng lên.
Hiệu năng và khả năng mở rộng
Đáng ngạc nhiên, kết quả cho thấy khoảng cách hiệu năng giữa hai cách tiếp cận này thu hẹp lại khi kích thước mô hình tăng. Đây là một quan sát quan trọng vì nó gợi ý rằng các mô hình không dùng MatMul ngày càng cạnh tranh với Transformer truyền thống khi mở rộng, và có thể vượt trội ở quy mô rất lớn.
Nguồn: Rui-Jie Zhu và cộng sự
Biểu đồ so sánh quy luật mở rộng này cho thấy các đường cong loss của LMs không dùng MatMul và transformer truyền thống hội tụ khi số lượng phép toán dấu chấm động (FLOPs) tăng.
Ban đầu, LMs không dùng MatMul có loss cao hơn do ràng buộc về trọng số tam phân. Tuy nhiên, khoảng cách này giảm dần khi kích thước mô hình tăng, và tại một thời điểm (ngôi sao), các đường cong giao nhau, cho thấy hiệu năng tương đương. Điều này gợi ý quy luật mở rộng dốc hơn cho các mô hình không dùng MatMul, tức hiệu năng của chúng cải thiện nhanh hơn khi tăng kích thước so với Transformer truyền thống.
Kết quả benchmark
Hiệu năng cạnh tranh của LMs không dùng MatMul còn được củng cố bởi kết quả mạnh mẽ trên nhiều benchmark học zero-shot. Trong các tác vụ như ARC-Easy, ARC-Challenge, Hellaswag, Winogrande, PIQA và OpenbookQA, các mô hình này thường đạt kết quả ngang bằng hoặc vượt Transformer truyền thống, dù độ phức tạp tính toán giảm đi đáng kể. Đây là minh chứng cho hiệu quả của các phép toán thay thế và lựa chọn kiến trúc trong LMs không dùng MatMul.
Nguồn: Rui-Jie Zhu và cộng sự
Bảng về độ chính xác zero-shot cho thấy LMs không dùng MatMul có hiệu năng cạnh tranh trên nhiều tác vụ. Chẳng hạn, ở ARC-Challenge, một benchmark đặc biệt khó, mô hình không dùng MatMul 2,7B tham số đạt độ chính xác cao hơn một mô hình transformer truyền thống.
Tương tự, trên các tác vụ Winogrande và OpenbookQA, các LMs không dùng MatMul thể hiện hiệu năng vững vàng, cho thấy việc loại bỏ MatMul không làm suy giảm khả năng hiểu và sinh ngôn ngữ của mô hình.
Hiệu quả bộ nhớ
Một trong những lợi thế nổi bật nhất của LMs không dùng MatMul là hiệu quả bộ nhớ vượt trội. Bằng cách thay các phép toán nặng về nhân bằng những phép cộng và trừ đơn giản nhờ trọng số tam phân, các mô hình này giảm đáng kể mức sử dụng bộ nhớ.
Trong huấn luyện, một triển khai GPU tối ưu hóa có thể giảm tiêu thụ bộ nhớ tới 61% so với các mô hình chưa tối ưu. Khi suy luận, mức tiết kiệm bộ nhớ còn ấn tượng hơn, với mức giảm hơn mười lần. Điều này khiến LMs không dùng MatMul đặc biệt hấp dẫn để triển khai trên các thiết bị hạn chế tài nguyên như điện thoại thông minh, nơi bộ nhớ thường là yếu tố giới hạn.
Nguồn: Rui-Jie Zhu và cộng sự
Biểu đồ so sánh bộ nhớ GPU và độ trễ minh họa mức tăng hiệu quả của LMs không dùng MatMul. Mức tiêu thụ bộ nhớ suy luận của mô hình 2,7B tham số không dùng MatMul thấp hơn đáng kể so với Transformer truyền thống tương đương. Dấu chân bộ nhớ nhỏ hơn này không chỉ cho phép triển khai các mô hình lớn hơn trên phần cứng hạn chế mà còn chuyển thành độ trễ thấp hơn, giúp các mô hình này phù hợp hơn cho các ứng dụng thời gian thực đòi hỏi khả năng phản hồi nhanh.
Từ GPU tối ưu đến thiết kế FPGA tùy chỉnh
Một trong những tiến bộ then chốt trình bày trong bài báo là triển khai GPU tối ưu hóa cho các LMs không dùng MatMul. Các tác giả đạt mức tăng 25,6% tốc độ huấn luyện và giảm tới 61,0% mức dùng bộ nhớ bằng cách sử dụng các kernel hợp nhất trong triển khai GPU của riêng họ. Các kernel này kết hợp nhiều phép toán thành một quy trình đơn, hiệu quả hơn, giảm chi phí truy cập bộ nhớ và di chuyển dữ liệu.
Để khai thác sâu hơn các phép toán nhẹ của LMs không dùng MatMul, các tác giả phát triển một bộ gia tốc FPGA tùy chỉnh bằng SystemVerilog. FPGA (Field-Programmable Gate Arrays) cung cấp nền tảng phần cứng linh hoạt và hiệu quả để hiện thực các tác vụ tính toán chuyên biệt.
Bộ gia tốc tùy chỉnh được thiết kế để tận dụng sự đơn giản của các phép toán tam phân và tích theo phần tử, đạt được mức tăng hiệu quả đáng kể. Triển khai RTL (Register Transfer Level) là bước quan trọng trong quy trình thiết kế FPGA. Nó bao gồm việc đặc tả hành vi phần cứng ở mức cao, sau đó được tổng hợp thành cấu hình FPGA thực tế. Thiết kế RTL tùy chỉnh cho LMs không dùng MatMul đảm bảo FPGA có thể xử lý hiệu quả các phép toán nhẹ, giảm tiêu thụ điện và tăng thông lượng.
Nguồn: Rui-Jie Zhu và cộng sự
Hình minh họa triển khai RTL của bộ gia tốc FPGA tùy chỉnh. Bạn có thể thấy các chức năng mà nó hiện thực ở bên phải Register Router. Các tác giả cũng phát triển assembler của riêng họ để chuyển các tệp assembly với tập lệnh tùy chỉnh thành ROM lệnh, bạn có thể thấy ở bên phải hình. Các lệnh được đưa vào Register Router, thành phần quản lý bộ nhớ (Register File) và thực thi lệnh.
Hơn nữa, các tác giả đề cập trong một bình luận tại vấn đề trên GitHub rằng thông số kỹ thuật đầy đủ của triển khai FPGA vẫn đang được tối ưu hóa và mã SystemVerilog sẽ được công khai sau.
Bảng dưới đây hiển thị mức sử dụng tài nguyên và các chỉ số hiệu năng cho triển khai FPGA của quá trình sinh token không dùng MatMul.
Nguồn: Rui-Jie Zhu và cộng sự
Dữ liệu cho thấy khi số lượng lõi (đơn vị xử lý) trong FPGA tăng, độ trễ tổng thể ban đầu vẫn tương đối ổn định. Tuy nhiên, độ trễ tăng đáng kể từ 16 lên 26 lõi, cho thấy giao diện DDR4, chịu trách nhiệm truyền dữ liệu, đang trở thành nút thắt khi nhu cầu truyền dữ liệu tăng cùng số lõi.
Trong khi phép toán nhân ma trận tam phân hiện đang chiếm ưu thế trong độ trễ tổng thể, các tác giả kỳ vọng rằng việc tối ưu hóa đơn vị này trong các triển khai tương lai sẽ chuyển nút thắt sang giao diện DDR4.
Một trong những tuyên bố thú vị nhất của bài báo là cách tiếp cận không dùng MatMul đưa LLM tiến gần hơn đến hiệu quả giống não bộ về mặt tính toán và tiêu thụ năng lượng. Các tác giả lập luận rằng mô hình của họ mô phỏng hiệu quả của mạng nơ-ron sinh học và đạt tốc độ đọc giống con người.
Tuy nhiên, so sánh trực tiếp hiệu quả của các mô hình này với sự hoạt động phức tạp của mạng nơ-ron sinh học là một vấn đề phức tạp cần được nghiên cứu thêm. Cơ chế tính toán của não bộ rất khác và phức tạp hơn nhiều so với các phép toán đơn giản hóa dùng trong LMs không dùng MatMul.
Không dùng MatMul: Hệ quả và hướng đi tương lai
Bài báo "Scalable MatMul-free Language Modeling" thách thức một giả định nền tảng trong xử lý ngôn ngữ tự nhiên: rằng phép nhân ma trận (MatMul) là thiết yếu để xây dựng các LLM hiệu năng cao.
Bằng cách chứng minh tính khả thi của các kiến trúc không dùng MatMul, nghiên cứu này mở ra một biên giới mới trong thiết kế LLM, khuyến khích khám phá những phép toán và mô hình tính toán thay thế. Điều này có thể dẫn tới làn sóng đổi mới, với việc các nhà nghiên cứu phát triển những kiến trúc mô hình mới.
Tăng tốc phần cứng cho mô hình nhẹ
Sự dịch chuyển sang các mô hình không dùng MatMul không chỉ là vấn đề phần mềm—mà còn là phần cứng. Các chip truyền thống như GPU rất mạnh ở phép nhân ma trận nhưng không nhất thiết là phù hợp nhất cho các mô hình nhẹ, mới này.
Bộ gia tốc FPGA tùy chỉnh do các nhà nghiên cứu xây dựng là một cái nhìn thoáng qua về tương lai phần cứng AI—các chip chuyên dụng được thiết kế để khai thác tối đa hiệu năng từ những mô hình hiệu quả này. Điều đó có thể dẫn tới một thế hệ thiết bị hỗ trợ AI hoàn toàn mới, nhanh hơn, tiết kiệm năng lượng hơn và tiếp cận được với nhiều đối tượng hơn.
Tác động môi trường và tính bền vững
Là người quan tâm đến môi trường, tôi đặc biệt hào hứng với tiềm năng của các mô hình không dùng MatMul trong việc giảm dấu chân carbon của AI. Mức tiêu thụ năng lượng khổng lồ của các mô hình ngôn ngữ lớn hiện nay là mối quan ngại thực sự. Bằng cách giảm đáng kể nhu cầu tính toán, nghiên cứu này có thể mở đường cho các công nghệ AI tiết kiệm năng lượng hơn với dấu chân môi trường nhỏ hơn.
Câu hỏi nghiên cứu mở và hướng phát triển
Mặc dù bài báo "Scalable MatMul-free Language Modeling" là một bước nhảy vọt, nó cũng mở ra nhiều hướng nghiên cứu tiếp theo—khám phá các kiến trúc không dùng MatMul khác nhau, đánh giá hiệu năng của chúng trên phạm vi tác vụ rộng hơn, và hiểu toán học về các giới hạn lý thuyết của cách tiếp cận này chỉ là vài hướng thú vị.
Ngoài ra, việc phát triển các benchmark và thước đo đánh giá tiêu chuẩn dành riêng cho mô hình không dùng MatMul sẽ tạo điều kiện cho so sánh công bằng và thúc đẩy tiến bộ trong lĩnh vực này. Hành trình hướng tới AI thực sự hiệu quả và dễ tiếp cận mới chỉ bắt đầu, và các khả năng là vô hạn. Cá nhân tôi cũng rất háo hức được thử các chatbot trợ lý không dùng MatMul trong tương lai!
Kết luận
Bài báo "Scalable MatMul-free Language Modeling" đóng góp đáng kể cho lĩnh vực LLM bằng cách giới thiệu một cách tiếp cận mới loại bỏ các phép nhân ma trận (MatMul).
Đột phá này giải quyết các nút thắt về tính toán và bộ nhớ gắn liền với LLM truyền thống, mở đường cho những mô hình hiệu quả và có khả năng mở rộng hơn. Bằng cách tận dụng các phép toán cộng/trừ và trọng số tam phân, các tác giả chứng minh rằng có thể duy trì hiệu năng cạnh tranh đồng thời giảm đáng kể nhu cầu tài nguyên.
Tác động tiềm năng của nghiên cứu này đối với tương lai phát triển và triển khai LLM là sâu rộng. Các mô hình không dùng MatMul mang đến một lựa chọn khả thi thay cho kiến trúc thông thường, cho phép tạo ra những mô hình nhẹ, hiệu quả, phù hợp với môi trường hạn chế tài nguyên như thiết bị biên và nền tảng di động.
Nếu bạn muốn tìm hiểu thêm về trí tuệ nhân tạo, hãy khám phá các khóa học AI này.