Büyük dil modellerinin (LLM’ler) eğitiminin hesaplama maliyeti giderek kontrolden çıkıyor. Örneğin, GPT-4’ün eğitimi OpenAI’a yaklaşık 100 milyon dolara mal oldu. Maliyet ağırlıklı olarak matris çarpımı işlemlerinden (kısaca MatMul) kaynaklanıyor ve araştırmacıların ve geliştiricilerin bunu tamamen ortadan kaldırmaya veya daha verimli hale getirmeye çalışmaları doğal.
"Scalable MatMul-free Language Modeling" makalesi, bu sorunu doğrudan ele alan çığır açıcı bir yaklaşım sunuyor. Yazarlar, LLM’lerden MatMul’u tamamen çıkararak, rekabetçi performansı korurken hesaplama ve bellek gereksinimlerini önemli ölçüde azaltan bir model geliştirdiler.
Kaynak: Rui-Jie Zhu vd.
Makalede sunulan tüm modeller HuggingFace’te mevcut—onları HuggingFace kütüphanelerini kullanarak çevrimiçi veya yerelde deneyebilirsiniz. Ayrıca, araştırmacılar kodlarını GitHub’da paylaşarak başkalarının da modellerini eğitmesine olanak tanıyor.
Matris çarpımının kübik zaman karmaşıklığını daha iyi anlamak isterseniz, MatMul LLM’lerin zaman karmaşıklığına özel bir bölüm içeren Büyük-O Gösterimi ve Zaman Karmaşıklığı girişini öneririm.
Ayrıca MatMul’suz ve MatMul LLM’leri karşılaştırdım—bunu şu makalede bulabilirsiniz: MatMul’suz vs MatMul LLM’ler: Hız ve Bellek Tüketimi.
Büyük Dil Modellerinde MatMul Darboğazı
Modern, transformer tabanlı LLM’ler; dikkat (attention) mekanizmaları ve beslemeli (feedforward) katmanlar gibi çekirdek bileşenlerinde merkezi rol oynayan matris çarpımına büyük ölçüde dayanır. MatMul işlemlerinin getirdiği hesaplama ve bellek maliyetleri, eğitim ve çıkarım aşamalarını etkiler. LLM’lerin boyutu büyüdükçe, parametre sayısı ve hesaplama karmaşıklığı artar ve MatMul büyük bir darboğaza dönüşür.
Buna yaygın bir örnek, bir GPU’nun VRAM’inin model boyutunu karşılamada yetersiz kalması ve kullanıcıların eğitimi veya çıkarımı CPU’larda yürütmek zorunda olmasıdır. CPU’lar, GPU’lar gibi paralelleştirilmiş MatMul işlemlerine optimize edilmemiştir; bu da hesaplamaların belirgin şekilde yavaşlamasına yol açar. Bu da, hesaplama gücü yeterli olsa bile bellek kısıtları nedeniyle mevcut donanımın tam olarak kullanılamadığı can sıkıcı bir döngü yaratır.
Yıllar içinde araştırmacılar, MatMul’un hesaplama yükünü azaltmak için çeşitli stratejiler keşfettiler. Ağırlıkların ve aktivasyonların hassasiyetini düşürmeyi içeren quantization (niceleme) popüler bir yaklaşımdır. Sayıları daha az bit ile temsil ederek, quantization MatMul işlemlerinin hesaplama maliyetini ve bellek ayak izini azaltabilir.
Ancak bu yöntem genellikle model doğruluğundan ödün verir ve MatMul’u tamamen ortadan kaldırmaz. Microsoft’un BitNet gibi dikkate değer çalışmaları, LLM’lerin ikili veya üçlü niceleme ile ölçeklenebileceğini gösterse de bu modeller hâlâ öz-dikkat (self-attention) gibi bazı bölümlerde MatMul işlemlerine dayanır.
MatMul’un verimsizliklerini gidermek için alternatif mimariler de önerilmiştir. AdderNet gibi yaklaşımlar ağın belirli bileşenlerinde çarpmaları toplamalarla değiştirirken, ikili/üçlü sinir ağları basitleştirilmiş aritmetik işlemler kullanır
Bu yöntemler bazı iyileştirmeler sunsa da genellikle MatMul’u tamamen kaldıramaz ve modelin yalnızca belirli kısımlarını hedefler. Sonuç olarak, toplam hesaplama maliyeti yüksek kalır; bu da LLM’lerin ölçeklenebilirliğini ve verimliliğini sınırlar.
MatMul’suz Dil Modelleri Nasıl Çalışır?
MatMul’suz LM’lerin nasıl çalıştığını anlamak için, altta yatan mimariyi ve temel bileşenleri inceleyelim.
MatMul’un üçlü işlemlerle değiştirilmesi
Geleneksel sinir ağlarında, iki ardışık katmandaki tüm nöronları birbirine bağlayan yoğun katmanlar, girdiyi dönüştürmek için MatMul’a dayanır. Yazarlar bunların yerine, üçlü ağırlıklar kullanan BitLinear katmanları getiriyor. Ağırlıkların herhangi bir reel sayı yerine yalnızca üç değerden biri olmasına kısıtlandığını düşünün: -1, 0 veya 1.
Ağırlıklar başlangıçta tam hassasiyetli değerler olarak eğitilir ve eğitim sırasında "absmean quantization" adı verilen bir süreçle üçlü değerlere nice edilir. Bu süreç, ağırlık matrisini ortalama mutlak değeriyle ölçekler ve ardından her bir öğeyi en yakın üçlü tam sayıya (-1, 0 veya 1) yuvarlar.
Bu basitleştirme, MatMul’daki çarpmaların toplama ve çıkarmalarla değiştirilmesine olanak tanır. Örneğin, bir sayıyı -1 ile çarpmak onu işaret çevirmeye eşdeğerdir, 0 ile çarpmak 0 verir ve 1 ile çarpmak sayıyı değiştirmez.
Temel bileşenler: MLGRU VE GLU
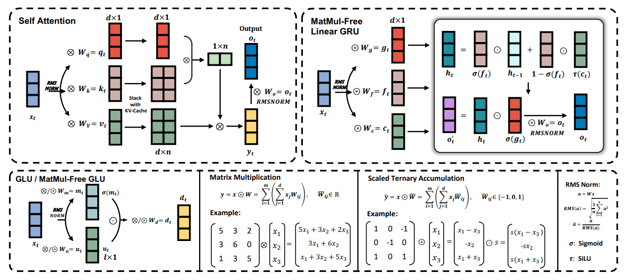
Aşağıdaki şekil, MatMul’suz Dil Modelinin temel bileşenlerine genel bir bakış sunar; MatMul’suz Doğrusal Kapılı Tekrarlayan Birim (MLGRU) ve MatMul’suz Kapılı Doğrusal Birim (GLU) dahil:
Kaynak: Rui-Jie Zhu vd.
Şekil birkaç bölüme ayrılmıştır (sol üstten sağ alta):
- Öz-dikkat: Bu bölüm, geleneksel öz-dikkat mekanizmasının matris çarpımlarıyla nasıl çalıştığını gösterir.
- MatMul’suz doğrusal GRU: Bu kısım, MLGRU’nun mimarisini; MatMul yerine eleman düzeyinde işlemler ve kapılama mekanizmaları kullanarak girdi dizilerini nasıl işlediğini vurgular.
- GLU / MatMul’suz GLU: Bu bölüm, GLU’nun modelin gömlemelerinin farklı boyutları arasında bilgiyi nasıl harmanladığını ve MatMul’u ortadan kaldırmak için üçlü ağırlıklar kullandığını gösterir.
- Matris çarpımı vs. ölçekli üçlü biriktirme: Bu karşılaştırma, standart matris çarpımının nasıl ölçekli üçlü biriktirme ile değiştirildiğini ve hesaplamaların nasıl basitleştirildiğini gösterir.
- RMS normu: Bu bölüm, nicelemeden önce aktivasyonları normalize eden RMSNorm işlemini açıklar.
MLGRU, girdi dizisini bir seferde bir token olacak şekilde işler. Her adımda, mevcut token’ın gömlemesini ve önceki gizli durumu girdi olarak alır. Gizli durum bir bellek gibi davranır ve önceki token’lardan gelen bilgileri saklar. MLGRU daha sonra bu gizli durumu, bir dizi eleman düzeyinde işlem ve kapılama mekanizmasıyla günceller. Esasen 0 ile 1 arasında sayılardan oluşan bu kapılar, önceki gizli durumun ve mevcut token’ın gömlemesinin hangi kısımlarının bir sonraki adım için daha ilgili olduğuna karar vererek bilgi akışını kontrol eder. Bu süreç, tüm dizi işlenene kadar devam eder.
MatMul’suz kapılı doğrusal birim (GLU), MatMul’suz dil modelinin bir diğer kilit bileşenidir. Modelin sözcüklerin iç temsiline (gömlemeler) ait farklı boyutlar arasında bilgiyi harmanlar. Daha basit bir ifadeyle, her bir kelimenin farklı yönlerini ya da özelliklerini anlamasına yardımcı olur.
GLU, farklı gömme kanalları arasındaki bilgi akışını kontrol etmek için bir kapılama mekanizması kullanarak bunu başarır. Bu kapılama mekanizması MLGRU’daki kapılara benzer, ancak token boyutu yerine kanal boyutunda çalışır.
MatMul’suz GLU, BitLinear katmanları kullanan; yani ağırlıkları yalnızca -1, 0 veya 1 değerlerini alabilen üçlü ağırlıklardan oluşan yoğun katmanlara sahip, standart GLU’nun MatMul’u ortadan kaldıracak şekilde uyarlanmış bir sürümüdür. MatMul’suz GLU’da, giriş önce iki ayrı BitLinear katmanıyla dönüştürülür. Katmanlardan birinin çıktısı SiLU aktivasyonundan geçirilir ve ardından diğer katmanın çıktısıyla eleman düzeyinde çarpılır. Bu kapılı çıktı daha sonra nihai çıktıyı üretmek üzere başka bir BitLinear katmanından geçirilir.
Bu, MLGRU ve GLU bileşenlerinin yalnızca üst düzey bir açıklamasıdır. İç işleyişleri ve matematiksel formülasyonları hakkında daha ayrıntılı bir anlayış için orijinal araştırma makalesine başvurmanızı öneririm.
Araştırma, model boyutu arttıkça MatMul’suz modellerin ölçekleme yasalarını inceleyerek performanslarını geleneksel Transformer mimarileriyle karşılaştırıyor.
Şaşırtıcı biçimde, bulgular bu iki yaklaşım arasındaki performans farkının model boyutu büyüdükçe daraldığını ortaya koyuyor. Bu, MatMul’suz modellerin ölçeklendikçe geleneksel Transformer’larla giderek daha rekabetçi hale geldiğini ve çok büyük ölçeklerde potansiyel olarak onları geride bırakabileceğini gösteren önemli bir gözlemdir.
Kaynak: Rui-Jie Zhu vd.
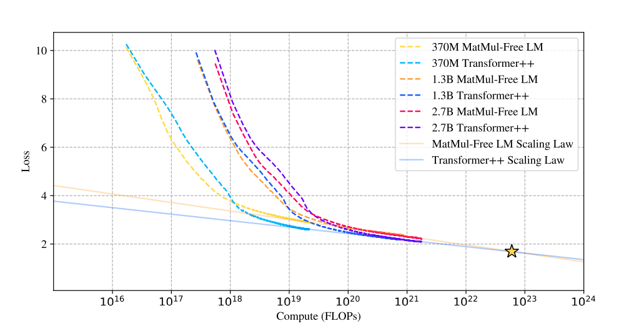
Bu ölçekleme yasası karşılaştırma grafiği, kayan nokta işlemleri (FLOP) sayısı arttıkça MatMul’suz LM’lerin ve geleneksel transformer’ların kayıp eğrilerinin yakınsadığını gösteriyor.
Başlangıçta, üçlü ağırlıkların kısıtları nedeniyle MatMul’suz LM’ler daha yüksek kayıp sergiler. Ancak model boyutu arttıkça bu fark azalır ve belirli bir noktada (yıldız) kayıp eğrileri kesişir; bu da karşılaştırılabilir performansa işaret eder. Bu durum, MatMul’suz modeller için daha dik bir ölçekleme yasasını; yani performanslarının, geleneksel Transformer’lara kıyasla artan boyutla daha hızlı iyileştiğini düşündürür.
Kıyaslama sonuçları
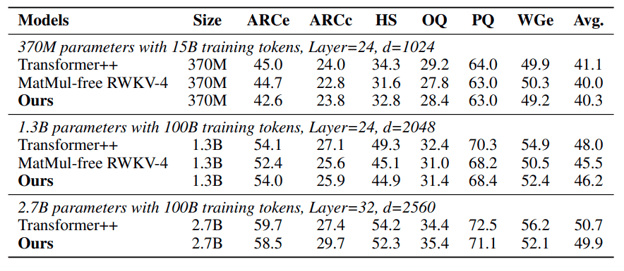
MatMul’suz LM’lerin rekabetçi performansı, çeşitli sıfır-atış (zero-shot) öğrenme kıyaslarında elde ettikleri güçlü sonuçlarla daha da pekişiyor. ARC-Easy, ARC-Challenge, Hellaswag, Winogrande, PIQA ve OpenbookQA gibi görevlerde, bu modeller; önemli ölçüde azaltılmış hesaplama karmaşıklığına rağmen, çoğu zaman geleneksel Transformer’larla boy ölçüşüyor veya onları geride bırakıyor. Bu da MatMul’suz LM’lerde kullanılan alternatif işlemlerin ve mimari tercihlerin etkinliğine bir kanıt niteliğinde.
Kaynak: Rui-Jie Zhu vd.
Sıfır-atış doğruluk tablosu, MatMul’suz LM’lerin çeşitli görevlerde rekabetçi performans gösterdiğini ortaya koyuyor. Örneğin, özellikle zorlu bir kıyas olan ARC-Challenge’da, 2,7B parametreli MatMul’suz LM, geleneksel bir transformer modelinden daha yüksek bir doğruluk elde ediyor.
Benzer şekilde, Winogrande ve OpenbookQA görevlerinde de MatMul’suz LM’ler güçlü bir performans sergileyerek, MatMul’un ortadan kaldırılmasının modelin dili anlama ve üretme becerisini zayıflatmadığını gösteriyor.
Bellek verimliliği
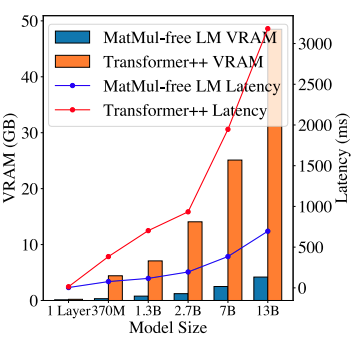
MatMul’suz LM’lerin en çarpıcı avantajlarından biri olağanüstü bellek verimliliğidir. Çarpmaya dayalı ağır işlemleri, üçlü ağırlıkların mümkün kıldığı basit toplama ve çıkarma işlemleriyle değiştirerek, bu modeller bellek kullanımında kayda değer azalmalar sağlar.
Eğitim sırasında, optimize edilmiş bir GPU uygulaması; optimize edilmemiş modellere kıyasla bellek tüketimini %61’e varan oranda azaltabilir. Çıkarımda ise bellek tasarrufu çok daha çarpıcıdır ve on kattan fazla azalma görülebilir. Bu da MatMul’suz LM’leri, belleğin çoğu zaman sınırlayıcı bir faktör olduğu akıllı telefonlar gibi kaynak kısıtlı cihazlarda dağıtım için özellikle cazip kılar.
Kaynak: Rui-Jie Zhu vd.
Bu GPU bellek ve gecikme karşılaştırma grafiği, MatMul’suz LM’lerin sağladığı verimlilik kazanımlarını gösteriyor. 2,7B parametreli bir MatMul’suz LM’nin çıkarım bellek tüketimi, karşılaştırılabilir bir geleneksel Transformer’a kıyasla belirgin derecede daha düşüktür. Bu azalan bellek ayak izi yalnızca sınırlı donanımda daha büyük modellerin dağıtımına olanak sağlamakla kalmaz, aynı zamanda daha düşük gecikmeye de dönüşerek, tepki süresinin kritik olduğu gerçek zamanlı uygulamalar için bu modelleri daha uygun hale getirir.
Optimize Edilmiş GPU’lardan Özel FPGA Tasarımına
Makalede sunulan başlıca ilerlemelerden biri, MatMul’suz LM’lerin optimize edilmiş GPU uygulamasıdır. Yazarlar, kendi GPU uygulamalarında birleştirilmiş çekirdekler kullanarak eğitim hızında %25,6 artış ve bellek kullanımında %61,0’a varan azalma sağlamıştır. Bu çekirdekler, birden çok işlemi tek ve daha verimli bir sürece birleştirerek bellek erişimi ve veri taşımaya ilişkin ek yükü azaltır.
MatMul’suz LM’lerin hafif işlemlerinden daha fazla yararlanmak için, yazarlar SystemVerilog ile özel bir FPGA hızlandırıcı geliştirdi. FPGA’lar (Saha Programlanabilir Kapı Dizileri), özel hesaplama görevlerini uygulamak için esnek ve verimli bir donanım platformu sunar.
Özel hızlandırıcı, üçlü işlemlerin ve eleman düzeyi çarpımların basitliğinden yararlanacak şekilde tasarlanmış ve önemli verimlilik kazanımları elde etmiştir. RTL (Register Transfer Level) uygulaması, FPGA tasarım sürecinde kritik öneme sahiptir. Donanım davranışının yüksek düzeyde belirtilmesini içerir ve bu, daha sonra gerçek FPGA yapılandırmasına dönüştürülür. MatMul’suz LM’ler için özel RTL tasarımı, FPGA’nın hafif işlemleri verimli biçimde yönetmesini sağlayarak güç tüketimini azaltır ve verimi (throughput) artırır.
Kaynak: Rui-Jie Zhu vd.
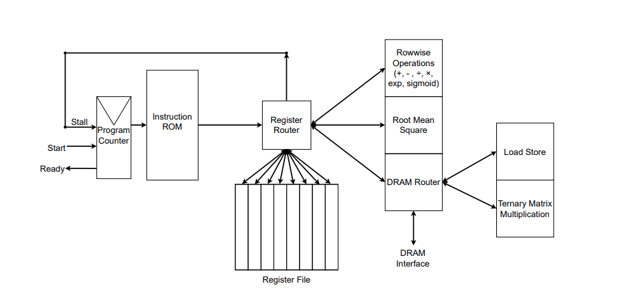
Şekil, özel FPGA hızlandırıcısının RTL uygulamasını göstermektedir. Register Router’ın sağında uyguladığı işlevleri görebilirsiniz. Yazarlar ayrıca, özel talimatlara sahip assembly dosyalarını bir talimat ROM’una dönüştürmek için kendi derleyicilerini de geliştirdiler; bunu şeklin sağında görebilirsiniz. Talimatlar, belleği (Register File) yöneten ve talimat yürütümünü gerçekleştiren Register Router’a verilir.
Ayrıca yazarlar, bir GitHub konusu altındaki yorumda, FPGA uygulamalarının tam özelliklerinin hâlâ optimize edildiğini ve SystemVerilog kodunun daha sonra kamuya açılacağını belirttiler.
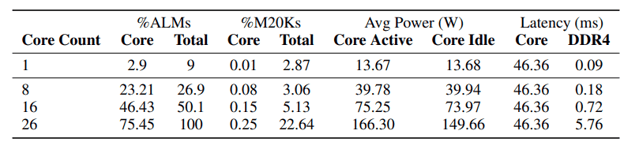
Aşağıdaki tablo, MatMul’suz token üretiminin FPGA uygulaması için kaynak kullanımını ve performans metriklerini göstermektedir.
Kaynak: Rui-Jie Zhu vd.
Veriler, FPGA içindeki çekirdek (işlem birimi) sayısı arttıkça toplam gecikmenin başlangıçta nispeten sabit kaldığını göstermektedir. Ancak 16’dan 26 çekirdeğe geçişte gecikme önemli ölçüde artmaktadır; bu da veri transferinden sorumlu DDR4 arayüzünün, çekirdek sayısıyla artan veri aktarım talebi karşısında bir darboğaz haline geldiğini düşündürmektedir.
Üçlü matris çarpımı işlemi şu anda toplam gecikmeye en çok hakim olsa da yazarlar, gelecekte bu birimin optimize edilmesiyle darboğazın DDR4 arayüzüne kayacağını öngörmektedir.
Makalenin en ilgi çekici iddialarından biri, MatMul’suz yaklaşımının LLM’leri hesaplama ve enerji tüketimi açısından beyin benzeri verimliliğe yaklaştırdığıdır. Yazarlar, modellerinin biyolojik sinir ağlarının verimliliğini taklit ettiğini ve insan benzeri okuma hızına ulaştığını savunuyor.
Bununla birlikte, bu modellerin verimliliğini biyolojik sinir ağlarının karmaşık işleyişiyle doğrudan karşılaştırmak, daha fazla inceleme gerektiren karmaşık bir konudur. Beynin hesaplama mekanizmaları, MatMul’suz LM’lerde kullanılan basitleştirilmiş işlemlerden son derece farklı ve çok daha karmaşıktır.
MatMul’suz: Sonuçları ve Gelecek Yönelimleri
"Scalable MatMul-free Language Modeling" makalesi, doğal dil işlemede temel bir varsayımı sorguluyor: yüksek performanslı LLM’ler inşa etmek için matris çarpımının (MatMul) zorunlu olduğu varsayımı.
MatMul’suz mimarilerin uygulanabilirliğini göstererek, bu araştırma LLM tasarımında yeni bir ufuk açıyor ve alternatif işlemlerin ve hesaplama paradigmalarının keşfini teşvik ediyor. Bu da araştırmacıların yenilikçi model mimarileri geliştirmesiyle bir inovasyon dalgasına yol açabilir.
Hafif modeller için donanım hızlandırma
MatMul’suz modellere geçiş yalnızca yazılımla ilgili değil—donanımla da ilgili. GPU gibi geleneksel yongalar matris çarpımında harikadır ancak bu yeni, hafif modeller için her zaman en iyi uyum değildir.
Araştırmacıların inşa ettiği özel FPGA hızlandırıcı, yapay zekâ donanımının geleceğine bir bakış sunuyor—bu verimli modellerden azami performansı elde etmek üzere tasarlanmış uzmanlaşmış yongalar. Bu, daha hızlı, daha enerji verimli ve daha geniş bir kitle tarafından erişilebilir yeni bir yapay zekâ destekli cihaz nesline yol açabilir.
Çevresel etki ve sürdürülebilirlik
Çevreyi önemseyen biri olarak, MatMul’suz modellerin yapay zekânın karbon ayak izini azaltma potansiyeli beni özellikle heyecanlandırıyor. Günümüzün büyük dil modellerinin muazzam enerji tüketimi gerçek bir endişe kaynağı. Bu araştırma, hesaplama gereksinimlerini önemli ölçüde azaltarak, daha enerji verimli ve çevresel ayak izi daha küçük yapay zekâ teknolojilerinin önünü açabilir.
Açık araştırma soruları ve gelecek yönelimleri
"Scalable MatMul-free Language Modeling" makalesi önemli bir ilerleme sunsa da aynı zamanda daha fazla araştırma için birkaç yol da açıyor—farklı MatMul’suz mimarilerin keşfi, bunların daha geniş bir görev yelpazesinde değerlendirilmesi ve bu yaklaşımın teorik sınırlarının matematiksel olarak anlaşılması heyecan verici araştırma yönelimlerinden sadece birkaçı.
Ek olarak, özellikle MatMul’suz modeller için standartlaştırılmış kıyaslar ve değerlendirme metrikleri geliştirmek, adil karşılaştırmaları kolaylaştırır ve bu alandaki ilerlemeyi hızlandırır. Gerçekten verimli ve erişilebilir yapay zekâya doğru yolculuk daha yeni başladı ve olasılıklar sınırsız. Ayrıca, gelecekteki MatMul’suz asistan sohbet botlarını denemek için kişisel olarak çok heyecanlıyım!
Sonuç
"Scalable MatMul-free Language Modeling" makalesi, matris çarpımı (MatMul) işlemlerini ortadan kaldıran yeni bir yaklaşım sunarak LLM alanına önemli bir katkı sağlıyor.
Bu atılım, geleneksel LLM’lerle ilişkili hesaplama ve bellek darboğazlarını gidererek daha verimli ve ölçeklenebilir modellere giden yolu açıyor. Toplayıcı işlemler ve üçlü ağırlıklardan yararlanarak, kaynak gereksinimlerini önemli ölçüde azaltırken rekabetçi performansın korunabileceğini gösteriyorlar.
Bu araştırmanın, gelecekteki LLM geliştirme ve dağıtımı üzerindeki potansiyel etkisi derindir. MatMul’suz modeller, geleneksel mimarilere uygulanabilir bir alternatif sunarak; uç cihazlar ve mobil platformlar gibi kaynak kısıtlı ortamlar için uygun, hafif ve verimli modellerin oluşturulmasını mümkün kılar.
Yapay zekâ hakkında daha fazla bilgi edinmek isterseniz, şu AI kurslarına göz atın.





Büyük dil modellerinin (LLM’ler) eğitiminin hesaplama maliyeti giderek kontrolden çıkıyor. Örneğin, GPT-4’ün eğitimi OpenAI’a yaklaşık 100 milyon dolara mal oldu. Maliyet ağırlıklı olarak matris çarpımı işlemlerinden (kısaca MatMul) kaynaklanıyor ve araştırmacıların ve geliştiricilerin bunu tamamen ortadan kaldırmaya veya daha verimli hale getirmeye çalışmaları doğal.
"Scalable MatMul-free Language Modeling" makalesi, bu sorunu doğrudan ele alan çığır açıcı bir yaklaşım sunuyor. Yazarlar, LLM’lerden MatMul’u tamamen çıkararak, rekabetçi performansı korurken hesaplama ve bellek gereksinimlerini önemli ölçüde azaltan bir model geliştirdiler.
Kaynak: Rui-Jie Zhu vd.
Makalede sunulan tüm modeller HuggingFace’te mevcut—onları HuggingFace kütüphanelerini kullanarak çevrimiçi veya yerelde deneyebilirsiniz. Ayrıca, araştırmacılar kodlarını GitHub’da paylaşarak başkalarının da modellerini eğitmesine olanak tanıyor.
Matris çarpımının kübik zaman karmaşıklığını daha iyi anlamak isterseniz, MatMul LLM’lerin zaman karmaşıklığına özel bir bölüm içeren Büyük-O Gösterimi ve Zaman Karmaşıklığı girişini öneririm.
Ayrıca MatMul’suz ve MatMul LLM’leri karşılaştırdım—bunu şu makalede bulabilirsiniz: MatMul’suz vs MatMul LLM’ler: Hız ve Bellek Tüketimi.
Büyük Dil Modellerinde MatMul Darboğazı
Modern, transformer tabanlı LLM’ler; dikkat (attention) mekanizmaları ve beslemeli (feedforward) katmanlar gibi çekirdek bileşenlerinde merkezi rol oynayan matris çarpımına büyük ölçüde dayanır. MatMul işlemlerinin getirdiği hesaplama ve bellek maliyetleri, eğitim ve çıkarım aşamalarını etkiler. LLM’lerin boyutu büyüdükçe, parametre sayısı ve hesaplama karmaşıklığı artar ve MatMul büyük bir darboğaza dönüşür.
Buna yaygın bir örnek, bir GPU’nun VRAM’inin model boyutunu karşılamada yetersiz kalması ve kullanıcıların eğitimi veya çıkarımı CPU’larda yürütmek zorunda olmasıdır. CPU’lar, GPU’lar gibi paralelleştirilmiş MatMul işlemlerine optimize edilmemiştir; bu da hesaplamaların belirgin şekilde yavaşlamasına yol açar. Bu da, hesaplama gücü yeterli olsa bile bellek kısıtları nedeniyle mevcut donanımın tam olarak kullanılamadığı can sıkıcı bir döngü yaratır.
Yıllar içinde araştırmacılar, MatMul’un hesaplama yükünü azaltmak için çeşitli stratejiler keşfettiler. Ağırlıkların ve aktivasyonların hassasiyetini düşürmeyi içeren quantization (niceleme) popüler bir yaklaşımdır. Sayıları daha az bit ile temsil ederek, quantization MatMul işlemlerinin hesaplama maliyetini ve bellek ayak izini azaltabilir.
Ancak bu yöntem genellikle model doğruluğundan ödün verir ve MatMul’u tamamen ortadan kaldırmaz. Microsoft’un BitNet gibi dikkate değer çalışmaları, LLM’lerin ikili veya üçlü niceleme ile ölçeklenebileceğini gösterse de bu modeller hâlâ öz-dikkat (self-attention) gibi bazı bölümlerde MatMul işlemlerine dayanır.
MatMul’un verimsizliklerini gidermek için alternatif mimariler de önerilmiştir. AdderNet gibi yaklaşımlar ağın belirli bileşenlerinde çarpmaları toplamalarla değiştirirken, ikili/üçlü sinir ağları basitleştirilmiş aritmetik işlemler kullanır
Bu yöntemler bazı iyileştirmeler sunsa da genellikle MatMul’u tamamen kaldıramaz ve modelin yalnızca belirli kısımlarını hedefler. Sonuç olarak, toplam hesaplama maliyeti yüksek kalır; bu da LLM’lerin ölçeklenebilirliğini ve verimliliğini sınırlar.
MatMul’suz Dil Modelleri Nasıl Çalışır?
MatMul’suz LM’lerin nasıl çalıştığını anlamak için, altta yatan mimariyi ve temel bileşenleri inceleyelim.
MatMul’un üçlü işlemlerle değiştirilmesi
Geleneksel sinir ağlarında, iki ardışık katmandaki tüm nöronları birbirine bağlayan yoğun katmanlar, girdiyi dönüştürmek için MatMul’a dayanır. Yazarlar bunların yerine, üçlü ağırlıklar kullanan BitLinear katmanları getiriyor. Ağırlıkların herhangi bir reel sayı yerine yalnızca üç değerden biri olmasına kısıtlandığını düşünün: -1, 0 veya 1.
Ağırlıklar başlangıçta tam hassasiyetli değerler olarak eğitilir ve eğitim sırasında "absmean quantization" adı verilen bir süreçle üçlü değerlere nice edilir. Bu süreç, ağırlık matrisini ortalama mutlak değeriyle ölçekler ve ardından her bir öğeyi en yakın üçlü tam sayıya (-1, 0 veya 1) yuvarlar.
Bu basitleştirme, MatMul’daki çarpmaların toplama ve çıkarmalarla değiştirilmesine olanak tanır. Örneğin, bir sayıyı -1 ile çarpmak onu işaret çevirmeye eşdeğerdir, 0 ile çarpmak 0 verir ve 1 ile çarpmak sayıyı değiştirmez.
Temel bileşenler: MLGRU VE GLU
Aşağıdaki şekil, MatMul’suz Dil Modelinin temel bileşenlerine genel bir bakış sunar; MatMul’suz Doğrusal Kapılı Tekrarlayan Birim (MLGRU) ve MatMul’suz Kapılı Doğrusal Birim (GLU) dahil:
Kaynak: Rui-Jie Zhu vd.
Şekil birkaç bölüme ayrılmıştır (sol üstten sağ alta):
MLGRU, girdi dizisini bir seferde bir token olacak şekilde işler. Her adımda, mevcut token’ın gömlemesini ve önceki gizli durumu girdi olarak alır. Gizli durum bir bellek gibi davranır ve önceki token’lardan gelen bilgileri saklar. MLGRU daha sonra bu gizli durumu, bir dizi eleman düzeyinde işlem ve kapılama mekanizmasıyla günceller. Esasen 0 ile 1 arasında sayılardan oluşan bu kapılar, önceki gizli durumun ve mevcut token’ın gömlemesinin hangi kısımlarının bir sonraki adım için daha ilgili olduğuna karar vererek bilgi akışını kontrol eder. Bu süreç, tüm dizi işlenene kadar devam eder.
MatMul’suz kapılı doğrusal birim (GLU), MatMul’suz dil modelinin bir diğer kilit bileşenidir. Modelin sözcüklerin iç temsiline (gömlemeler) ait farklı boyutlar arasında bilgiyi harmanlar. Daha basit bir ifadeyle, her bir kelimenin farklı yönlerini ya da özelliklerini anlamasına yardımcı olur.
GLU, farklı gömme kanalları arasındaki bilgi akışını kontrol etmek için bir kapılama mekanizması kullanarak bunu başarır. Bu kapılama mekanizması MLGRU’daki kapılara benzer, ancak token boyutu yerine kanal boyutunda çalışır.
MatMul’suz GLU, BitLinear katmanları kullanan; yani ağırlıkları yalnızca -1, 0 veya 1 değerlerini alabilen üçlü ağırlıklardan oluşan yoğun katmanlara sahip, standart GLU’nun MatMul’u ortadan kaldıracak şekilde uyarlanmış bir sürümüdür. MatMul’suz GLU’da, giriş önce iki ayrı BitLinear katmanıyla dönüştürülür. Katmanlardan birinin çıktısı SiLU aktivasyonundan geçirilir ve ardından diğer katmanın çıktısıyla eleman düzeyinde çarpılır. Bu kapılı çıktı daha sonra nihai çıktıyı üretmek üzere başka bir BitLinear katmanından geçirilir.
Bu, MLGRU ve GLU bileşenlerinin yalnızca üst düzey bir açıklamasıdır. İç işleyişleri ve matematiksel formülasyonları hakkında daha ayrıntılı bir anlayış için orijinal araştırma makalesine başvurmanızı öneririm.
MatMul’suz ve Transformer’lar
Araştırma, model boyutu arttıkça MatMul’suz modellerin ölçekleme yasalarını inceleyerek performanslarını geleneksel Transformer mimarileriyle karşılaştırıyor.
Performans ve ölçeklenebilirlik
Şaşırtıcı biçimde, bulgular bu iki yaklaşım arasındaki performans farkının model boyutu büyüdükçe daraldığını ortaya koyuyor. Bu, MatMul’suz modellerin ölçeklendikçe geleneksel Transformer’larla giderek daha rekabetçi hale geldiğini ve çok büyük ölçeklerde potansiyel olarak onları geride bırakabileceğini gösteren önemli bir gözlemdir.
Kaynak: Rui-Jie Zhu vd.
Bu ölçekleme yasası karşılaştırma grafiği, kayan nokta işlemleri (FLOP) sayısı arttıkça MatMul’suz LM’lerin ve geleneksel transformer’ların kayıp eğrilerinin yakınsadığını gösteriyor.
Başlangıçta, üçlü ağırlıkların kısıtları nedeniyle MatMul’suz LM’ler daha yüksek kayıp sergiler. Ancak model boyutu arttıkça bu fark azalır ve belirli bir noktada (yıldız) kayıp eğrileri kesişir; bu da karşılaştırılabilir performansa işaret eder. Bu durum, MatMul’suz modeller için daha dik bir ölçekleme yasasını; yani performanslarının, geleneksel Transformer’lara kıyasla artan boyutla daha hızlı iyileştiğini düşündürür.
Kıyaslama sonuçları
MatMul’suz LM’lerin rekabetçi performansı, çeşitli sıfır-atış (zero-shot) öğrenme kıyaslarında elde ettikleri güçlü sonuçlarla daha da pekişiyor. ARC-Easy, ARC-Challenge, Hellaswag, Winogrande, PIQA ve OpenbookQA gibi görevlerde, bu modeller; önemli ölçüde azaltılmış hesaplama karmaşıklığına rağmen, çoğu zaman geleneksel Transformer’larla boy ölçüşüyor veya onları geride bırakıyor. Bu da MatMul’suz LM’lerde kullanılan alternatif işlemlerin ve mimari tercihlerin etkinliğine bir kanıt niteliğinde.
Kaynak: Rui-Jie Zhu vd.
Sıfır-atış doğruluk tablosu, MatMul’suz LM’lerin çeşitli görevlerde rekabetçi performans gösterdiğini ortaya koyuyor. Örneğin, özellikle zorlu bir kıyas olan ARC-Challenge’da, 2,7B parametreli MatMul’suz LM, geleneksel bir transformer modelinden daha yüksek bir doğruluk elde ediyor.
Benzer şekilde, Winogrande ve OpenbookQA görevlerinde de MatMul’suz LM’ler güçlü bir performans sergileyerek, MatMul’un ortadan kaldırılmasının modelin dili anlama ve üretme becerisini zayıflatmadığını gösteriyor.
Bellek verimliliği
MatMul’suz LM’lerin en çarpıcı avantajlarından biri olağanüstü bellek verimliliğidir. Çarpmaya dayalı ağır işlemleri, üçlü ağırlıkların mümkün kıldığı basit toplama ve çıkarma işlemleriyle değiştirerek, bu modeller bellek kullanımında kayda değer azalmalar sağlar.
Eğitim sırasında, optimize edilmiş bir GPU uygulaması; optimize edilmemiş modellere kıyasla bellek tüketimini %61’e varan oranda azaltabilir. Çıkarımda ise bellek tasarrufu çok daha çarpıcıdır ve on kattan fazla azalma görülebilir. Bu da MatMul’suz LM’leri, belleğin çoğu zaman sınırlayıcı bir faktör olduğu akıllı telefonlar gibi kaynak kısıtlı cihazlarda dağıtım için özellikle cazip kılar.
Kaynak: Rui-Jie Zhu vd.
Bu GPU bellek ve gecikme karşılaştırma grafiği, MatMul’suz LM’lerin sağladığı verimlilik kazanımlarını gösteriyor. 2,7B parametreli bir MatMul’suz LM’nin çıkarım bellek tüketimi, karşılaştırılabilir bir geleneksel Transformer’a kıyasla belirgin derecede daha düşüktür. Bu azalan bellek ayak izi yalnızca sınırlı donanımda daha büyük modellerin dağıtımına olanak sağlamakla kalmaz, aynı zamanda daha düşük gecikmeye de dönüşerek, tepki süresinin kritik olduğu gerçek zamanlı uygulamalar için bu modelleri daha uygun hale getirir.
Optimize Edilmiş GPU’lardan Özel FPGA Tasarımına
Makalede sunulan başlıca ilerlemelerden biri, MatMul’suz LM’lerin optimize edilmiş GPU uygulamasıdır. Yazarlar, kendi GPU uygulamalarında birleştirilmiş çekirdekler kullanarak eğitim hızında %25,6 artış ve bellek kullanımında %61,0’a varan azalma sağlamıştır. Bu çekirdekler, birden çok işlemi tek ve daha verimli bir sürece birleştirerek bellek erişimi ve veri taşımaya ilişkin ek yükü azaltır.
MatMul’suz LM’lerin hafif işlemlerinden daha fazla yararlanmak için, yazarlar SystemVerilog ile özel bir FPGA hızlandırıcı geliştirdi. FPGA’lar (Saha Programlanabilir Kapı Dizileri), özel hesaplama görevlerini uygulamak için esnek ve verimli bir donanım platformu sunar.
Özel hızlandırıcı, üçlü işlemlerin ve eleman düzeyi çarpımların basitliğinden yararlanacak şekilde tasarlanmış ve önemli verimlilik kazanımları elde etmiştir. RTL (Register Transfer Level) uygulaması, FPGA tasarım sürecinde kritik öneme sahiptir. Donanım davranışının yüksek düzeyde belirtilmesini içerir ve bu, daha sonra gerçek FPGA yapılandırmasına dönüştürülür. MatMul’suz LM’ler için özel RTL tasarımı, FPGA’nın hafif işlemleri verimli biçimde yönetmesini sağlayarak güç tüketimini azaltır ve verimi (throughput) artırır.
Kaynak: Rui-Jie Zhu vd.
Şekil, özel FPGA hızlandırıcısının RTL uygulamasını göstermektedir. Register Router’ın sağında uyguladığı işlevleri görebilirsiniz. Yazarlar ayrıca, özel talimatlara sahip assembly dosyalarını bir talimat ROM’una dönüştürmek için kendi derleyicilerini de geliştirdiler; bunu şeklin sağında görebilirsiniz. Talimatlar, belleği (Register File) yöneten ve talimat yürütümünü gerçekleştiren Register Router’a verilir.
Ayrıca yazarlar, bir GitHub konusu altındaki yorumda, FPGA uygulamalarının tam özelliklerinin hâlâ optimize edildiğini ve SystemVerilog kodunun daha sonra kamuya açılacağını belirttiler.
Aşağıdaki tablo, MatMul’suz token üretiminin FPGA uygulaması için kaynak kullanımını ve performans metriklerini göstermektedir.
Kaynak: Rui-Jie Zhu vd.
Veriler, FPGA içindeki çekirdek (işlem birimi) sayısı arttıkça toplam gecikmenin başlangıçta nispeten sabit kaldığını göstermektedir. Ancak 16’dan 26 çekirdeğe geçişte gecikme önemli ölçüde artmaktadır; bu da veri transferinden sorumlu DDR4 arayüzünün, çekirdek sayısıyla artan veri aktarım talebi karşısında bir darboğaz haline geldiğini düşündürmektedir.
Üçlü matris çarpımı işlemi şu anda toplam gecikmeye en çok hakim olsa da yazarlar, gelecekte bu birimin optimize edilmesiyle darboğazın DDR4 arayüzüne kayacağını öngörmektedir.
Makalenin en ilgi çekici iddialarından biri, MatMul’suz yaklaşımının LLM’leri hesaplama ve enerji tüketimi açısından beyin benzeri verimliliğe yaklaştırdığıdır. Yazarlar, modellerinin biyolojik sinir ağlarının verimliliğini taklit ettiğini ve insan benzeri okuma hızına ulaştığını savunuyor.
Bununla birlikte, bu modellerin verimliliğini biyolojik sinir ağlarının karmaşık işleyişiyle doğrudan karşılaştırmak, daha fazla inceleme gerektiren karmaşık bir konudur. Beynin hesaplama mekanizmaları, MatMul’suz LM’lerde kullanılan basitleştirilmiş işlemlerden son derece farklı ve çok daha karmaşıktır.
MatMul’suz: Sonuçları ve Gelecek Yönelimleri
"Scalable MatMul-free Language Modeling" makalesi, doğal dil işlemede temel bir varsayımı sorguluyor: yüksek performanslı LLM’ler inşa etmek için matris çarpımının (MatMul) zorunlu olduğu varsayımı.
MatMul’suz mimarilerin uygulanabilirliğini göstererek, bu araştırma LLM tasarımında yeni bir ufuk açıyor ve alternatif işlemlerin ve hesaplama paradigmalarının keşfini teşvik ediyor. Bu da araştırmacıların yenilikçi model mimarileri geliştirmesiyle bir inovasyon dalgasına yol açabilir.
Hafif modeller için donanım hızlandırma
MatMul’suz modellere geçiş yalnızca yazılımla ilgili değil—donanımla da ilgili. GPU gibi geleneksel yongalar matris çarpımında harikadır ancak bu yeni, hafif modeller için her zaman en iyi uyum değildir.
Araştırmacıların inşa ettiği özel FPGA hızlandırıcı, yapay zekâ donanımının geleceğine bir bakış sunuyor—bu verimli modellerden azami performansı elde etmek üzere tasarlanmış uzmanlaşmış yongalar. Bu, daha hızlı, daha enerji verimli ve daha geniş bir kitle tarafından erişilebilir yeni bir yapay zekâ destekli cihaz nesline yol açabilir.
Çevresel etki ve sürdürülebilirlik
Çevreyi önemseyen biri olarak, MatMul’suz modellerin yapay zekânın karbon ayak izini azaltma potansiyeli beni özellikle heyecanlandırıyor. Günümüzün büyük dil modellerinin muazzam enerji tüketimi gerçek bir endişe kaynağı. Bu araştırma, hesaplama gereksinimlerini önemli ölçüde azaltarak, daha enerji verimli ve çevresel ayak izi daha küçük yapay zekâ teknolojilerinin önünü açabilir.
Açık araştırma soruları ve gelecek yönelimleri
"Scalable MatMul-free Language Modeling" makalesi önemli bir ilerleme sunsa da aynı zamanda daha fazla araştırma için birkaç yol da açıyor—farklı MatMul’suz mimarilerin keşfi, bunların daha geniş bir görev yelpazesinde değerlendirilmesi ve bu yaklaşımın teorik sınırlarının matematiksel olarak anlaşılması heyecan verici araştırma yönelimlerinden sadece birkaçı.
Ek olarak, özellikle MatMul’suz modeller için standartlaştırılmış kıyaslar ve değerlendirme metrikleri geliştirmek, adil karşılaştırmaları kolaylaştırır ve bu alandaki ilerlemeyi hızlandırır. Gerçekten verimli ve erişilebilir yapay zekâya doğru yolculuk daha yeni başladı ve olasılıklar sınırsız. Ayrıca, gelecekteki MatMul’suz asistan sohbet botlarını denemek için kişisel olarak çok heyecanlıyım!
Sonuç
"Scalable MatMul-free Language Modeling" makalesi, matris çarpımı (MatMul) işlemlerini ortadan kaldıran yeni bir yaklaşım sunarak LLM alanına önemli bir katkı sağlıyor.
Bu atılım, geleneksel LLM’lerle ilişkili hesaplama ve bellek darboğazlarını gidererek daha verimli ve ölçeklenebilir modellere giden yolu açıyor. Toplayıcı işlemler ve üçlü ağırlıklardan yararlanarak, kaynak gereksinimlerini önemli ölçüde azaltırken rekabetçi performansın korunabileceğini gösteriyorlar.
Bu araştırmanın, gelecekteki LLM geliştirme ve dağıtımı üzerindeki potansiyel etkisi derindir. MatMul’suz modeller, geleneksel mimarilere uygulanabilir bir alternatif sunarak; uç cihazlar ve mobil platformlar gibi kaynak kısıtlı ortamlar için uygun, hafif ve verimli modellerin oluşturulmasını mümkün kılar.
Yapay zekâ hakkında daha fazla bilgi edinmek isterseniz, şu AI kurslarına göz atın.