Kurs
KI-Lösungen im Unternehmen implementieren
2 Std.
54.8K
Die Rechenkosten für das Training großer Sprachmodelle (LLMs) geraten zunehmend aus dem Ruder. So kostete das Training von GPT-4 OpenAI rund 100 Millionen US-Dollar. Der große Kostenblock entsteht vor allem durch Matrixmultiplikationen (kurz MatMul). Entsprechend versuchen Forschende und Entwicklerin schon lange, diese Operationen ganz zu eliminieren oder zumindest deutlich effizienter zu machen.
Das Paper "Scalable MatMul-free Language Modeling" geht dieses Problem radikal an. Durch die vollständige Eliminierung von MatMul in LLMs präsentieren die Autornen ein Modell, das bei deutlich geringerem Rechen- und Speicherbedarf eine konkurrenzfähige Leistung hält.
Quelle: Rui-Jie Zhu et. al
Alle im Paper beschriebenen Modelle findest du auf HuggingFace—du kannst sie dort online testen oder lokal mit den Bibliotheken von HuggingFace ausführen. Außerdem haben die Forschenden ihren Code auf GitHub veröffentlicht, sodass andere eigene Modelle trainieren können.
Wenn du die kubische Zeitkomplexität der Matrixmultiplikation besser verstehen willst, empfehle ich diese Einführung zu Big-O-Notation und Zeitkomplexität mit einem eigenen Abschnitt zur Zeitkomplexität von MatMul in LLMs.
Ich habe zudem einen Vergleich zwischen MatMul-freien und MatMul-LLMs durchgeführt—du findest ihn hier: MatMul-free vs. MatMul LLMs: Geschwindigkeit und Speicherverbrauch.
Moderne, transformerbasierte LLMs stützen sich stark auf Matrixmultiplikationen, die für Kernbausteine wie Aufmerksamkeitsmechanismen und Feedforward-Schichten zentral sind. Die damit verbundenen Rechen- und Speicheranforderungen sind erheblich und betreffen Training wie Inferenz. Mit wachsender Modellgröße steigen die Parameterzahl und die Komplexität der Berechnungen—MatMul wird zum Engpass.
Ein typisches Beispiel: Reicht der VRAM einer GPU nicht für die Modellgröße, müssen Training oder Inferenz auf die CPU ausweichen. CPUs sind jedoch nicht für hochparallelisierte MatMul-Operationen optimiert wie GPUs, was die Berechnung stark verlangsamt. So entsteht eine frustrierende Schleife: Die verfügbare Hardware lässt sich wegen Speichergrenzen nicht ausnutzen, obwohl genug Rechenleistung vorhanden wäre.
Um die Rechenlast von MatMul zu senken, wurden über die Jahre viele Strategien untersucht. Weit verbreitet ist Quantisierung, also die Reduzierung der Genauigkeit von Gewichten und Aktivierungen. Durch weniger Bits sinken Rechenkosten und Speicherbedarf von MatMul-Operationen.
Das geht jedoch oft zulasten der Genauigkeit und entfernt MatMul nicht vollständig. Beachtliche Ansätze wie BitNet von Microsoft zeigen zwar, dass sich LLMs mit binärer oder ternärer Quantisierung skalieren lassen, aber auch diese Modelle verlassen sich in Teilen wie der Self-Attention weiterhin auf MatMul.
Auch alternative Architekturen adressieren die Ineffizienzen von MatMul. Ansätze wie AdderNet ersetzen Multiplikationen in bestimmten Netzkomponenten durch Additionen, und binäre/ternäre neuronale Netze nutzen vereinfachte Arithmetik.
Diese Methoden bringen zwar Verbesserungen, schaffen MatMul aber meist nicht vollständig ab und zielen nur auf Teile des Modells. Der Gesamtaufwand bleibt hoch und begrenzt Skalierbarkeit und Effizienz von LLMs.
Um zu verstehen, wie MatMul-freie LMs arbeiten, schauen wir uns die Architektur und ihre Schlüsselkomponenten an.
In klassischen neuronalen Netzen transformieren dichte Schichten (vollständig verbundene Layer) Eingabedaten via MatMul. Die Autornen ersetzen sie durch BitLinear-Schichten mit ternären Gewichten. Anstatt beliebiger reeller Zahlen dürfen Gewichte nur drei Werte annehmen: -1, 0 oder 1.
Die Gewichte werden zunächst in voller Präzision trainiert und während des Trainings per "Absmean-Quantisierung" auf ternäre Werte abgebildet. Dabei wird die Gewichtsmatrix mit ihrem durchschnittlichen Absolutwert skaliert und jedes Element auf die nächste ternäre Ganzzahl (-1, 0 oder 1) gerundet.
So lassen sich Multiplikationen in MatMul durch Additionen und Subtraktionen ersetzen. Ein Beispiel: Eine Zahl mit -1 zu multiplizieren entspricht der Negation, mit 0 ergibt 0, mit 1 bleibt sie unverändert.
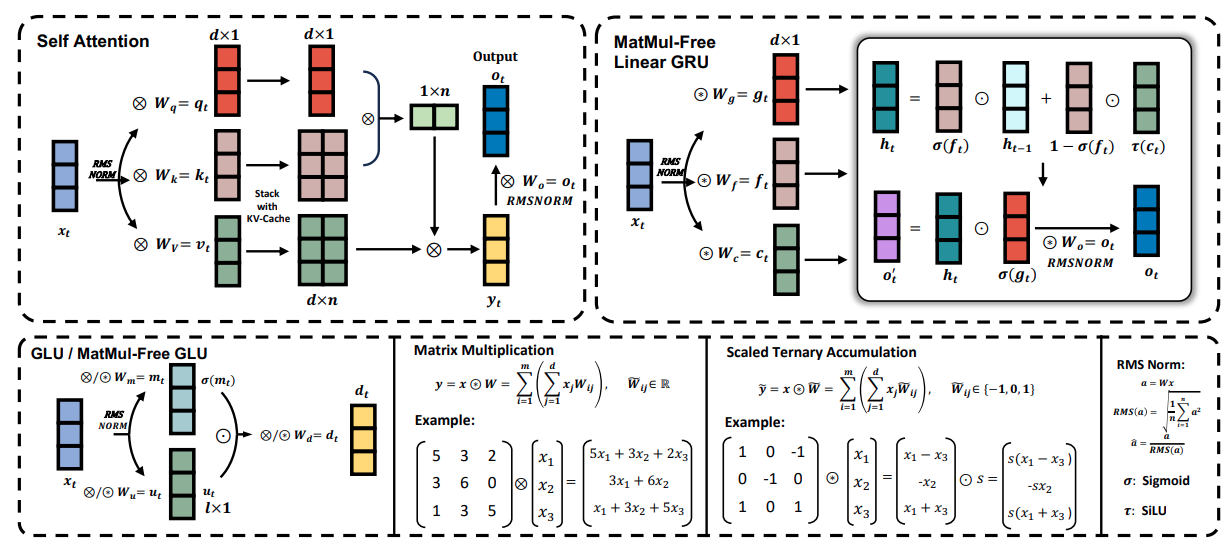
Die folgende Abbildung zeigt die wichtigsten Bausteine des MatMul-freien Sprachmodells: die MatMul-Free Linear Gated Recurrent Unit (MLGRU) und die MatMul-Free Gated Linear Unit (GLU):
Quelle: Rui-Jie Zhu et. al
Die Grafik ist in mehrere Bereiche gegliedert (von links oben nach rechts unten):
Die MLGRU verarbeitet die Eingabesequenz Token für Token. In jedem Schritt erhält sie die Einbettung des aktuellen Tokens und den vorherigen Hidden State als Eingabe. Dieser dient als Speicher für Informationen aus früheren Tokens. Die MLGRU aktualisiert den Hidden State mithilfe elementweiser Operationen und Gate-Mechanismen. Diese Gates—Vektoren mit Werten zwischen 0 und 1—steuern den Informationsfluss, indem sie gewichten, welche Teile des vorherigen Hidden States und der aktuellen Token-Einbettung für den nächsten Schritt relevant sind. So wird die gesamte Sequenz schrittweise verarbeitet.
Die MatMul-freie Gated Linear Unit (GLU) ist eine weitere Schlüsselkomponente. Sie mischt Informationen über die verschiedenen Dimensionen der internen Wortrepräsentation (Einbettungen) und hilft dem Modell damit, unterschiedliche Merkmale eines Wortes zu erfassen.
Die GLU nutzt dazu ein Gate, das den Informationsfluss zwischen Einbettungskanälen steuert. Dieses Gate ähnelt den Gates in der MLGRU, wirkt jedoch auf der Kanal- statt auf der Token-Dimension.
Die MatMul-freie GLU ist eine angepasste Variante der Standard-GLU, die Matrixmultiplikationen über BitLinear-Schichten mit ternären Gewichten (-1, 0 oder 1) eliminiert. Zunächst wird die Eingabe durch zwei getrennte BitLinear-Schichten transformiert. Der Output der einen Schicht durchläuft die SiLU-Aktivierung und wird elementweise mit dem Output der anderen Schicht multipliziert. Dieses gegatete Signal geht dann durch eine weitere BitLinear-Schicht und ergibt den Endoutput.
Das ist nur eine Einordnung auf hoher Ebene zu MLGRU und GLU. Für Details zu innerem Aufbau und mathematischer Formulierung lohnt sich der Blick ins Originalpaper.
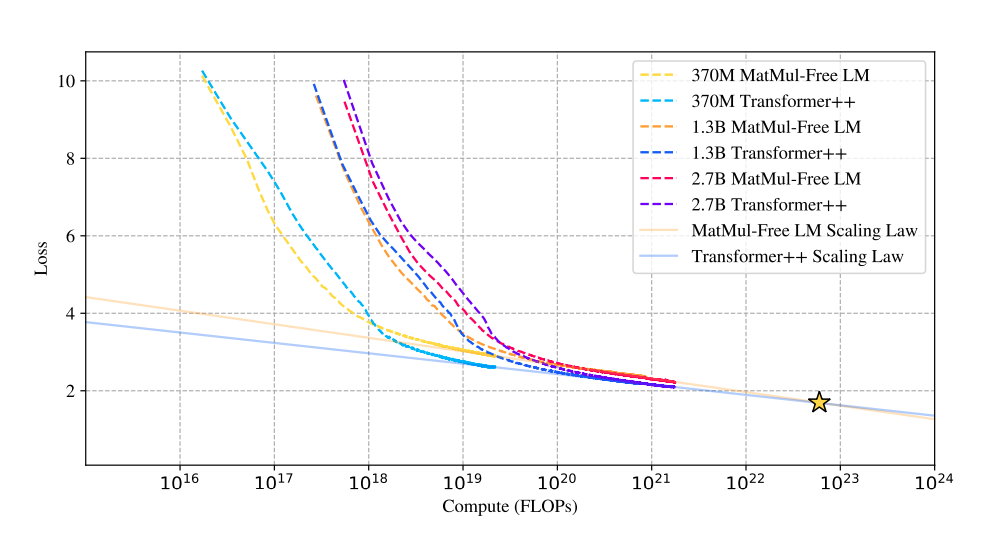
Die Studie untersucht die Skalierungsgesetze MatMul-freier Modelle und vergleicht ihre Leistung mit klassischen Transformer-Architekturen bei wachsender Modellgröße.
Erstaunlicherweise schrumpft der Performance-Abstand mit steigender Modellgröße. Das ist bemerkenswert, denn es deutet darauf hin, dass MatMul-freie Modelle beim Skalieren immer wettbewerbsfähiger werden und konventionelle Transformer bei sehr großen Modellen sogar übertreffen könnten.
Quelle: Rui-Jie Zhu et. al
Die Grafik zum Vergleich der Skalierungsgesetze zeigt, dass sich die Verlustkurven MatMul-freier LMs und klassischer Transformer mit steigender Zahl der Floating-Point-Operationen (FLOPs) annähern.
Anfangs ist der Verlust der MatMul-freien LMs wegen der Einschränkungen ternärer Gewichte höher. Mit wachsender Modellgröße schrumpft die Lücke jedoch, und ab einem Punkt (Stern) schneiden sich die Kurven—ein Hinweis auf vergleichbare Leistung. Das spricht für ein steileres Skalierungsgesetz MatMul-freier Modelle: Ihre Leistung verbessert sich bei größerer Modellgröße schneller als bei klassischen Transformern.
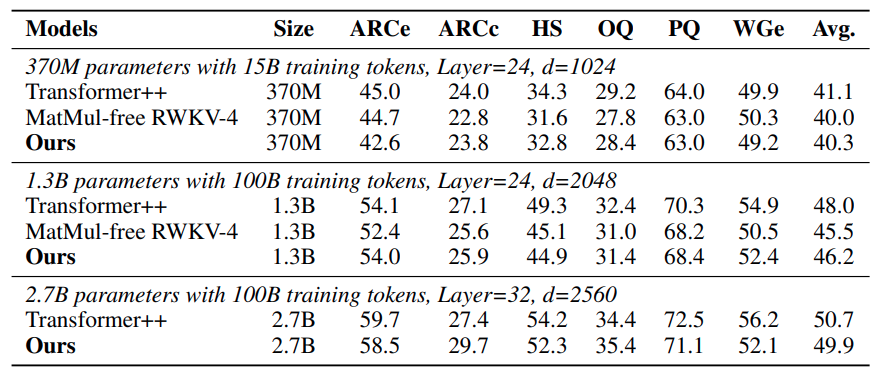
Die Konkurrenzfähigkeit MatMul-freier LMs bestätigt sich auch in Zero-Shot-Benchmarks. In Aufgaben wie ARC-Easy, ARC-Challenge, Hellaswag, Winogrande, PIQA und OpenbookQA erreichen sie häufig vergleichbare oder bessere Werte als Transformer—trotz deutlich geringerer Rechenkomplexität. Das unterstreicht die Wirksamkeit der alternativen Operationen und Architekturentscheidungen.
Quelle: Rui-Jie Zhu et. al
Die Tabelle zur Zero-Shot-Genauigkeit zeigt: MatMul-freie LMs schneiden über viele Aufgaben hinweg wettbewerbsfähig ab. So erzielt das 2,7B-Parameter-Modell in der anspruchsvollen ARC-Challenge eine höhere Genauigkeit als ein klassischer Transformer.
Auch bei Winogrande und OpenbookQA liefern MatMul-freie LMs starke Ergebnisse. Das Entfernen von MatMul schmälert also nicht die Fähigkeit, Sprache zu verstehen und zu generieren.
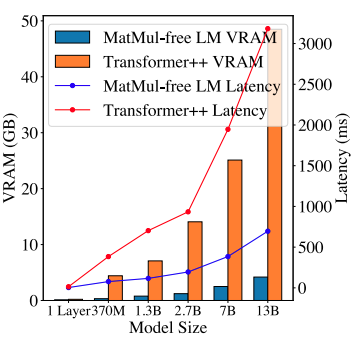
Ein besonders starkes Argument für MatMul-freie LMs ist ihre hervorragende Speichereffizienz. Durch den Ersatz rechenintensiver Multiplikationen durch einfache Additionen und Subtraktionen mit ternären Gewichten sinkt der Speicherbedarf deutlich.
Im Training reduziert eine optimierte GPU-Implementierung den Speicherverbrauch um bis zu 61% gegenüber nicht optimierten Modellen. In der Inferenz fallen die Einsparungen noch drastischer aus—teils um mehr als den Faktor 10. Dadurch eignen sich MatMul-freie LMs besonders für den Einsatz auf ressourcenbeschränkten Geräten wie Smartphones, wo Speicher oft der limitierende Faktor ist.
Quelle: Rui-Jie Zhu et. al
Die Grafik zum Vergleich von GPU-Speicher und Latenz verdeutlicht die Effizienzgewinne: Das Inferenzspeicherprofil eines 2,7B-Parameter-Modells liegt deutlich unter dem eines vergleichbaren Transformers. Der geringere Speicherbedarf ermöglicht nicht nur größere Modelle auf begrenzter Hardware, sondern senkt auch die Latenz—ideal für Echtzeit-Anwendungen, in denen Reaktionszeit entscheidend ist.
Ein wichtiger Beitrag des Papers ist die optimierte GPU-Implementierung MatMul-freier LMs. Durch Fused-Kernels in der eigenen GPU-Implementierung erzielten die Autornen 25,6% mehr Trainingsdurchsatz und bis zu 61,0% weniger Speicherverbrauch. Diese Kernel bündeln mehrere Operationen in einem effizienteren Schritt und reduzieren so Overhead durch Speicherzugriffe und Datenbewegungen.
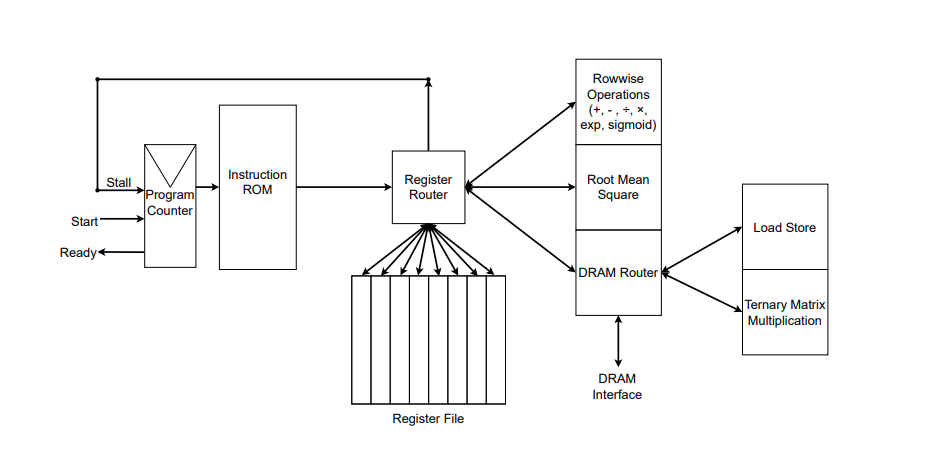
Um die leichten Operationen MatMul-freier LMs weiter auszureizen, entwickelten die Autornen einen eigenen FPGA-Beschleuniger in SystemVerilog. FPGAs (Field-Programmable Gate Arrays) bieten eine flexible, effiziente Hardwareplattform für spezialisierte Rechenaufgaben.
Der Accelerator ist darauf ausgelegt, die Einfachheit ternärer Operationen und elementweiser Produkte zu nutzen und so deutliche Effizienzgewinne zu erzielen. Die RTL-Implementierung (Register Transfer Level) ist dabei zentral: Sie beschreibt das Hardwareverhalten auf hoher Ebene und wird anschließend in die FPGA-Konfiguration synthetisiert. Das maßgeschneiderte RTL-Design für MatMul-freie LMs stellt sicher, dass der FPGA die leichten Operationen effizient ausführt, mit geringerem Stromverbrauch und höherem Durchsatz.
Quelle: Rui-Jie Zhu et. al
Die Abbildung zeigt die RTL-Implementierung des FPGA-Beschleunigers. Rechts neben dem Register Router sind die implementierten Funktionen zu sehen. Zudem entwickelten die Autornen einen eigenen Assembler, der Assembly-Dateien mit kundenspezifischen Instruktionen in ein Instruction-ROM übersetzt, das du rechts in der Grafik siehst. Die Instruktionen gehen an den Register Router, der den Speicher (Register File) verwaltet und die Ausführung steuert.
Außerdem erwähnten die Autornen in einem Kommentar zu einem GitHub-Issue, dass die vollständigen Spezifikationen der FPGA-Implementierung noch optimiert werden und der SystemVerilog-Code später veröffentlicht wird.
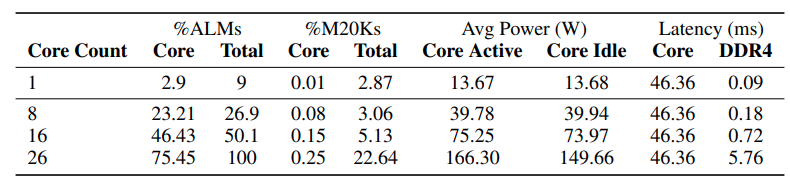
Die folgende Tabelle zeigt Ressourcennutzung und Leistungskennzahlen für die FPGA-Implementierung der MatMul-freien Tokengenerierung.
Quelle: Rui-Jie Zhu et. al
Die Daten zeigen: Mit steigender Zahl der Cores (Recheneinheiten) im FPGA bleibt die Gesamtlatenz zunächst relativ stabil. Ab 16 bis 26 Cores steigt sie jedoch deutlich an—ein Hinweis darauf, dass das für Datenübertragung zuständige DDR4-Interface zum Flaschenhals wird, je mehr Cores Daten anfordern.
Derzeit dominiert die ternäre Matrixmultiplikation die Gesamtlatenz. Die Autornen erwarten jedoch, dass nach einer Optimierung dieser Einheit das DDR4-Interface zum hauptsächlichen Engpass wird.
Besonders spannend ist die These, dass der MatMul-freie Ansatz LLMs hinsichtlich Rechen- und Energieeffizienz näher an die des Gehirns bringt. Die Autornen argumentieren, ihre Modelle würden die Effizienz biologischer neuronaler Netze nachahmen und eine menschenähnliche Lesegeschwindigkeit erreichen.
Ein direkter Vergleich mit der komplexen Funktionsweise biologischer neuronaler Netze ist jedoch schwierig und erfordert weitere Forschung. Die Mechanismen des Gehirns unterscheiden sich grundlegend und sind weitaus komplexer als die vereinfachten Operationen MatMul-freier LMs.
Das Paper "Scalable MatMul-free Language Modeling" stellt eine Grundannahme der Sprachverarbeitung infrage: dass Matrixmultiplikation für leistungsfähige LLMs unverzichtbar ist.
Die nachgewiesene Machbarkeit MatMul-freier Architekturen öffnet ein neues Feld für LLM-Designs und ermutigt, alternative Operationen und Rechenparadigmen zu erforschen. Das könnte eine Welle neuer Modellarchitekturen lostreten.
Der Wandel hin zu MatMul-freien Modellen betrifft nicht nur Software, sondern auch Hardware. Klassische Chips wie GPUs sind exzellent in Matrixmultiplikationen, aber nicht zwingend die beste Wahl für diese neuen, leichten Modelle.
Der von den Forschenden entwickelte FPGA-Beschleuniger gibt einen Ausblick auf die Zukunft der KI-Hardware: spezialisierte Chips, die aus diesen effizienten Modellen maximale Leistung herausholen. Das könnte eine neue Generation KI-gestützter Geräte ermöglichen—schneller, energieeffizienter und breiter zugänglich.
Als jemand, dem die Umwelt am Herzen liegt, freue ich mich besonders über das Potenzial MatMul-freier Modelle, den CO₂-Fußabdruck von KI zu reduzieren. Der enorme Energieverbrauch heutiger LLMs ist ein echtes Problem. Durch deutlich geringere Rechenanforderungen könnte diese Forschung den Weg für energieeffizientere KI mit kleinerem ökologischen Fußabdruck ebnen.
Trotz des großen Schritts nach vorn wirft das Paper auch neue Fragen auf: weitere MatMul-freie Architekturen, breitere Aufgabenfelder für Evaluierungen und ein besseres theoretisches Verständnis der Grenzen dieses Ansatzes sind nur einige spannende Richtungen.
Standardisierte Benchmarks und Metriken speziell für MatMul-freie Modelle würden faire Vergleiche erleichtern und den Fortschritt beschleunigen. Die Reise hin zu wirklich effizienter, zugänglicher KI hat erst begonnen—und die Möglichkeiten sind riesig. Ich persönlich freue mich sehr auf zukünftige MatMul-freie Assistenz-Chatbots!
Das Paper "Scalable MatMul-free Language Modeling" leistet einen wichtigen Beitrag zur LLM-Forschung, indem es einen Ansatz vorstellt, der Matrixmultiplikationen (MatMul) eliminiert.
Dieser Durchbruch adressiert die Rechen- und Speicherengpässe klassischer LLMs und ebnet den Weg für effizientere, besser skalierende Modelle. Durch additive Operationen und ternäre Gewichte zeigen die Autornen, dass sich bei deutlich geringerem Ressourcenbedarf eine konkurrenzfähige Performance halten lässt.
Die Auswirkungen auf Entwicklung und Einsatz künftiger LLMs könnten enorm sein. MatMul-freie Modelle sind eine echte Alternative zu herkömmlichen Architekturen und ermöglichen leichte, effiziente Modelle für ressourcenarme Umgebungen wie Edge-Geräte und mobile Plattformen.
Wenn du mehr über Künstliche Intelligenz lernen willst, schau dir diese KI-Kurse an.
Lerne KI mit diesen Kursen!
Kurs
Kurs
Kurs