Il costo computazionale dell'addestramento dei large language model (LLM) sta diventando sempre più fuori controllo. Per esempio, l'addestramento di GPT-4 è costato a OpenAI circa 100 milioni di dollari. Il costo deriva principalmente dalle operazioni di moltiplicazione di matrici (in breve MatMul) ed è naturale che ricercatori e sviluppatori abbiano cercato di eliminarle del tutto o renderle più efficienti.
L'articolo "Scalable MatMul-free Language Modeling" introduce un approccio innovativo che affronta il problema di petto. Eliminando completamente MatMul dagli LLM, gli autori hanno sviluppato un modello che mantiene prestazioni competitive riducendo in modo significativo i requisiti computazionali e di memoria.
Fonte: Rui-Jie Zhu et. al
Tutti i modelli descritti nell'articolo sono disponibili su HuggingFace: puoi provarli online o in locale usando le librerie di HuggingFace. Inoltre, i ricercatori hanno pubblicato il loro codice su GitHub, consentendo ad altri di addestrare i propri modelli.
Se vuoi capire meglio la complessità temporale cubica della moltiplicazione di matrici, ti consiglio questa introduzione alla notazione Big-O e alla complessità temporale, che include una sezione dedicata alla complessità temporale degli LLM con MatMul.
Ho anche realizzato un confronto tra LLM senza MatMul e con MatMul: lo trovi in questo articolo: Matmul-Free vs MatMul LLMs: velocità e consumo di memoria.
Il collo di bottiglia del MatMul nei large language model
Gli LLM moderni basati su transformer si affidano fortemente alle operazioni di moltiplicazione di matrici, centrali per componenti fondamentali come i meccanismi di attenzione e i layer feedforward. I costi computazionali e di memoria associati alle operazioni MatMul sono ingenti e incidono sia sulle fasi di addestramento sia su quelle di inferenza. Man mano che la dimensione degli LLM aumenta, cresce il numero di parametri e la complessità dei calcoli, rendendo MatMul un importante collo di bottiglia.
Un esempio comune di questo problema si verifica quando la VRAM di una GPU non è sufficiente a gestire la dimensione del modello, costringendo gli utenti ad addestrare o eseguire l'inferenza su CPU. Le CPU non sono ottimizzate per le operazioni MatMul parallelizzate come le GPU, con conseguente rallentamento significativo dei calcoli. Si crea così un circolo vizioso in cui l'hardware disponibile non può essere sfruttato appieno a causa dei vincoli di memoria, anche quando la potenza di calcolo sarebbe adeguata.
Nel corso degli anni, i ricercatori hanno esplorato varie strategie per ridurre il carico computazionale di MatMul. La quantizzazione, che consiste nel ridurre la precisione dei pesi e delle attivazioni, è stata un approccio popolare. Rappresentando i numeri con meno bit, la quantizzazione può abbassare il costo computazionale e l'impronta di memoria delle operazioni MatMul.
Tuttavia, questo metodo spesso sacrifica l'accuratezza del modello e non elimina completamente MatMul. Sforzi degni di nota come BitNet di Microsoft hanno mostrato che è possibile scalare gli LLM con quantizzazione binaria o ternaria, ma questi modelli si affidano comunque a operazioni MatMul per alcune parti, come il meccanismo di self-attention.
Sono state proposte anche architetture alternative per affrontare le inefficienze di MatMul. Approcci come AdderNet sostituiscono le moltiplicazioni con addizioni in alcuni componenti della rete, e le reti neurali binarie/ternarie utilizzano operazioni aritmetiche semplificate
Sebbene questi metodi offrano alcuni miglioramenti, in genere non riescono a rimuovere completamente MatMul e si concentrano solo su parti specifiche del modello. Di conseguenza, il costo computazionale complessivo rimane elevato, limitando scalabilità ed efficienza degli LLM.
Come funzionano i modelli linguistici senza MatMul
Per capire come funzionano gli LM senza MatMul, esaminiamo l'architettura sottostante e i componenti chiave.
Sostituire MatMul con operazioni ternarie
Nelle reti neurali tradizionali, i layer densi (che collegano tutti i neuroni tra due layer consecutivi) si basano su MatMul per trasformare i dati in input. Gli autori li sostituiscono con layer BitLinear, che utilizzano pesi ternari. Invece di avere pesi che possono assumere qualsiasi numero reale, sono vincolati a soli tre valori: -1, 0 o 1.
I pesi vengono inizialmente addestrati in piena precisione e poi, durante l'addestramento, quantizzati a valori ternari tramite un processo chiamato "absmean quantization". Questo processo scala la matrice dei pesi per il suo valore assoluto medio e poi arrotonda ogni elemento all'intero ternario più vicino (-1, 0 o 1).
Questa semplificazione consente di sostituire le moltiplicazioni in MatMul con addizioni e sottrazioni. Per esempio, moltiplicare un numero per -1 equivale a negarlo, moltiplicarlo per 0 dà 0 e moltiplicarlo per 1 lascia il numero invariato.
Componenti principali: MLGRU E GLU
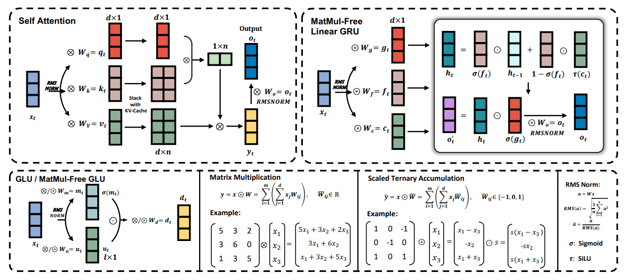
La figura seguente offre una panoramica dei componenti chiave del MatMul-Free Language Model, inclusi la MatMul-Free Linear Gated Recurrent Unit (MLGRU) e la MatMul-Free Gated Linear Unit (GLU):
Fonte: Rui-Jie Zhu et. al
La figura è suddivisa in diverse sezioni (dall'alto a sinistra in basso a destra):
- Self-attention: Questa sezione mostra come funziona il meccanismo tradizionale di self-attention con moltiplicazioni di matrici.
- GRU lineare senza MatMul: Questa parte illustra l'architettura della MLGRU, evidenziando come elabora le sequenze in input usando operazioni elemento per elemento e meccanismi di gating al posto di MatMul.
- GLU / GLU senza MatMul: Questa sezione mostra come la GLU mescola le informazioni tra le diverse dimensioni degli embedding del modello, usando pesi ternari per eliminare MatMul.
- Moltiplicazione di matrici vs. accumulo ternario scalato: Questo confronto mostra come la moltiplicazione di matrici standard venga sostituita dall'accumulo ternario scalato, semplificando i calcoli.
- RMS norm: Questa sezione illustra l'operazione RMSNorm, che normalizza le attivazioni prima della quantizzazione.
La MLGRU opera elaborando la sequenza di input un token alla volta. A ogni passo prende l'embedding del token corrente e lo stato nascosto precedente come input. Lo stato nascosto funge da memoria, conservando informazioni dai token precedenti. La MLGRU quindi aggiorna questo stato nascosto usando una serie di operazioni elemento per elemento e meccanismi di gating. Questi gate, in sostanza vettori di numeri tra 0 e 1, controllano il flusso di informazioni determinando quali parti dello stato nascosto precedente e dell'embedding del token corrente sono più rilevanti per il passo successivo. Questo processo continua finché l'intera sequenza non è stata elaborata.
La gated linear unit (GLU) senza MatMul è un altro componente chiave del modello linguistico senza MatMul. Mescola le informazioni tra le diverse dimensioni della rappresentazione interna delle parole (embedding) del modello. In parole più semplici, aiuta il modello a cogliere i diversi aspetti o caratteristiche di ciascuna parola.
La GLU ottiene questo risultato usando un meccanismo di gating per controllare il flusso di informazioni tra i diversi canali di embedding. Questo meccanismo di gating è simile a quello della MLGRU, ma opera sulla dimensione dei canali invece che su quella dei token.
La GLU senza MatMul è una versione modificata della GLU standard, adattata per eliminare le moltiplicazioni di matrici usando layer BitLinear, ossia layer densi che impiegano pesi ternari (pesi che possono assumere solo i valori -1, 0 o 1). Nella GLU senza MatMul, l'input viene prima trasformato usando due layer BitLinear separati. L'output di un layer viene fatto passare attraverso la funzione di attivazione SiLU e poi moltiplicato elemento per elemento con l'output dell'altro layer. Questo output "gated" viene quindi fatto passare attraverso un altro layer BitLinear per produrre l'output finale.
Questa è solo una spiegazione ad alto livello dei componenti MLGRU e GLU. Ti invito a consultare l'articolo di ricerca originale per comprendere più in dettaglio il loro funzionamento interno e le formulazioni matematiche.
La ricerca indaga le leggi di scalabilità dei modelli senza MatMul, confrontandone le prestazioni con le architetture Transformer tradizionali man mano che aumenta la dimensione del modello.
Prestazioni e scalabilità
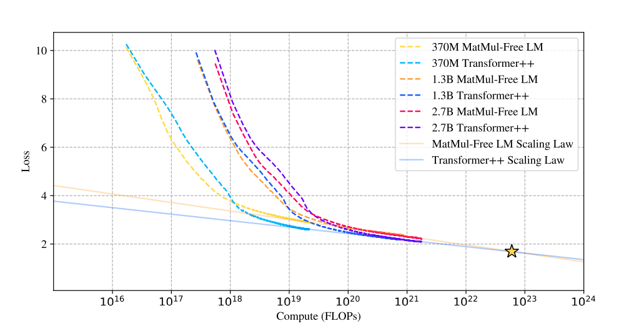
Sorprendentemente, i risultati rivelano che il divario di prestazioni tra i due approcci si riduce all'aumentare della dimensione del modello. Si tratta di un'osservazione significativa perché suggerisce che i modelli senza MatMul diventano sempre più competitivi rispetto ai Transformer tradizionali man mano che scalano, potenzialmente superandoli a scale molto grandi.
Fonte: Rui-Jie Zhu et. al
Questo grafico sul confronto delle leggi di scalabilità mostra che le curve della loss degli LM senza MatMul e dei transformer tradizionali convergono all'aumentare del numero di operazioni in virgola mobile (FLOP).
Inizialmente, gli LM senza MatMul mostrano una loss più alta a causa dei vincoli dei pesi ternari. Tuttavia, questo divario diminuisce con l'aumentare della dimensione del modello e a un certo punto (stella) le curve della loss si intersecano, indicando prestazioni comparabili. Ciò suggerisce una legge di scalabilità più ripida per i modelli senza MatMul, il che significa che le loro prestazioni migliorano più rapidamente all'aumentare della dimensione rispetto ai Transformer tradizionali.
Risultati ai benchmark
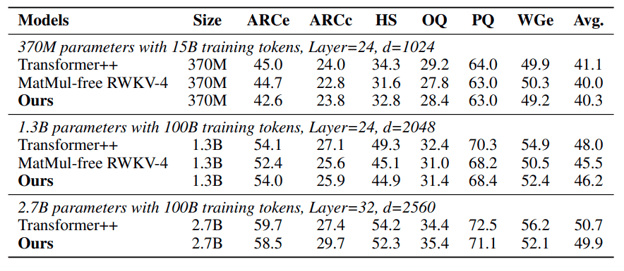
Le prestazioni competitive degli LM senza MatMul sono ulteriormente confermate dai buoni risultati in vari benchmark di apprendimento zero-shot. In compiti come ARC-Easy, ARC-Challenge, Hellaswag, Winogrande, PIQA e OpenbookQA, questi modelli spesso sono alla pari o superano i Transformer tradizionali, nonostante la complessità computazionale significativamente ridotta. Questo testimonia l'efficacia delle operazioni alternative e delle scelte architetturali adottate negli LM senza MatMul.
Fonte: Rui-Jie Zhu et. al
La tabella sull'accuratezza zero-shot mostra che gli LM senza MatMul sono competitivi su vari task. Per esempio, in ARC-Challenge, un benchmark particolarmente difficile, l'LM senza MatMul da 2,7B di parametri ottiene un'accuratezza superiore a quella di un modello transformer tradizionale.
Analogamente, nei task Winogrande e OpenbookQA, gli LM senza MatMul mostrano prestazioni robuste, indicando che eliminare MatMul non compromette la capacità del modello di comprendere e generare linguaggio.
Efficienza della memoria
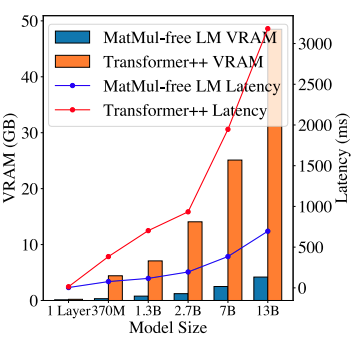
Uno dei vantaggi più evidenti degli LM senza MatMul è la straordinaria efficienza in termini di memoria. Sostituendo le operazioni ad alta intensità di moltiplicazioni con semplici addizioni e sottrazioni abilitate dai pesi ternari, questi modelli ottengono riduzioni sostanziali nell'uso della memoria.
Durante l'addestramento, un'implementazione GPU ottimizzata può ridurre il consumo di memoria fino al 61% rispetto ai modelli non ottimizzati. In inferenza, i risparmi di memoria sono ancora più marcati, con riduzioni superiori a dieci volte. Questo rende gli LM senza MatMul particolarmente allettanti per il deployment su dispositivi con risorse limitate come gli smartphone, dove la memoria è spesso un fattore limitante.
Fonte: Rui-Jie Zhu et. al
Questo grafico sul confronto tra memoria GPU e latenza illustra i guadagni di efficienza degli LM senza MatMul. Il consumo di memoria in inferenza di un LM senza MatMul da 2,7B di parametri è significativamente inferiore rispetto a quello di un Transformer tradizionale comparabile. Questa impronta di memoria ridotta non solo consente il deployment di modelli più grandi su hardware limitato, ma si traduce anche in una latenza inferiore, rendendo questi modelli più adatti ad applicazioni in tempo reale in cui la reattività è cruciale.
Dalle GPU ottimizzate al design FPGA personalizzato
Uno dei progressi chiave presentati nell'articolo è l'implementazione GPU ottimizzata degli LM senza MatMul. Gli autori hanno ottenuto un aumento della velocità di addestramento del 25,6% e una riduzione dell'uso di memoria fino al 61,0% utilizzando kernel fusi nella loro implementazione GPU. Questi kernel combinano più operazioni in un unico processo più efficiente, riducendo l'overhead associato all'accesso alla memoria e allo spostamento dei dati.
Per sfruttare ulteriormente le operazioni leggere degli LM senza MatMul, gli autori hanno sviluppato un acceleratore FPGA personalizzato in SystemVerilog. Gli FPGA (Field-Programmable Gate Array) offrono una piattaforma hardware flessibile ed efficiente per implementare compiti computazionali specializzati.
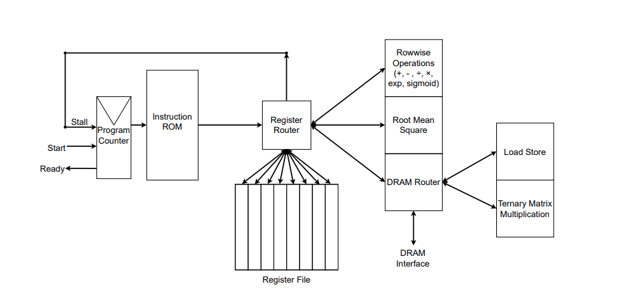
L'acceleratore personalizzato è stato progettato per sfruttare la semplicità delle operazioni ternarie e dei prodotti elemento per elemento, ottenendo notevoli guadagni di efficienza. L'implementazione RTL (Register Transfer Level) è fondamentale nel processo di progettazione FPGA. Comporta la specifica del comportamento hardware a un livello alto, che viene poi sintetizzato nella configurazione effettiva dell'FPGA. Il design RTL personalizzato per gli LM senza MatMul assicura che l'FPGA possa gestire in modo efficiente le operazioni leggere, riducendo i consumi energetici e aumentando il throughput.
Fonte: Rui-Jie Zhu et. al
La figura illustra l'implementazione RTL dell'acceleratore FPGA personalizzato. A destra del Register Router si vedono le funzioni che implementa. Gli autori hanno anche sviluppato un proprio assembler per convertire file assembly con istruzioni personalizzate in una instruction ROM, che si può vedere sulla destra della figura. Le istruzioni vengono fornite al Register Router, che gestisce la memoria (Register File) ed esegue le istruzioni.
Inoltre, gli autori hanno menzionato in un commento a una issue su GitHub che le specifiche complete della loro implementazione FPGA sono ancora in fase di ottimizzazione e il codice SystemVerilog sarà reso pubblico più avanti.
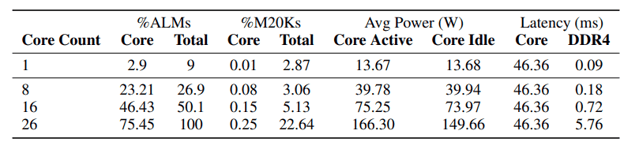
La tabella seguente mostra l'utilizzo delle risorse e le metriche di prestazioni per l'implementazione FPGA della generazione di token senza MatMul.
Fonte: Rui-Jie Zhu et. al
I dati dimostrano che, all'aumentare del numero di core (unità di elaborazione) all'interno dell'FPGA, la latenza complessiva inizialmente rimane relativamente stabile. Tuttavia, la latenza aumenta in modo significativo passando da 16 a 26 core, suggerendo che l'interfaccia DDR4, responsabile del trasferimento dati, stia diventando un collo di bottiglia man mano che la domanda di trasferimento cresce con il numero di core.
Sebbene l'operazione di moltiplicazione di matrici ternaria domini attualmente la latenza complessiva, gli autori prevedono che l'ottimizzazione di questa unità nelle implementazioni future sposterà il collo di bottiglia sull'interfaccia DDR4.
Una delle affermazioni più intriganti dell'articolo è che l'approccio senza MatMul avvicina gli LLM all'efficienza cerebrale in termini di calcolo e consumo energetico. Gli autori sostengono che i loro modelli imitino l'efficienza delle reti neurali biologiche e raggiungano una velocità di lettura simile a quella umana.
Tuttavia, confrontare direttamente l'efficienza di questi modelli con i complessi meccanismi delle reti neurali biologiche è una questione articolata che richiede ulteriori indagini. I meccanismi computazionali del cervello sono radicalmente diversi e molto più complessi delle operazioni semplificate utilizzate negli LM senza MatMul.
Senza MatMul: implicazioni e direzioni future
L'articolo "Scalable MatMul-free Language Modeling" mette in discussione un presupposto fondamentale dell'elaborazione del linguaggio naturale: che la moltiplicazione di matrici (MatMul) sia essenziale per costruire LLM ad alte prestazioni.
Dimostrando la fattibilità di architetture senza MatMul, questa ricerca apre una nuova frontiera nel design degli LLM, incoraggiando l'esplorazione di operazioni alternative e paradigmi computazionali. Ciò potrebbe portare a un'ondata di innovazione, con ricercatori impegnati a sviluppare nuove architetture di modelli.
Accelerazione hardware per modelli leggeri
Questo passaggio verso modelli senza MatMul non riguarda solo il software, ma anche l'hardware. I chip tradizionali come le GPU sono ottimi nelle moltiplicazioni di matrici, ma non sono necessariamente la scelta migliore per questi nuovi modelli leggeri.
L'acceleratore FPGA personalizzato costruito dai ricercatori offre uno scorcio sul futuro dell'hardware per l'IA: chip specializzati progettati per spremere ogni goccia di prestazioni da questi modelli efficienti. Questo potrebbe portare a una nuova generazione di dispositivi basati sull'IA più veloci, più efficienti dal punto di vista energetico e accessibili a un pubblico più ampio.
Impatto ambientale e sostenibilità
Da persona attenta all'ambiente, sono particolarmente entusiasta del potenziale dei modelli senza MatMul nel ridurre l'impronta di carbonio dell'IA. L'enorme consumo energetico dei grandi modelli linguistici di oggi è un problema reale. Riducendo in modo significativo le richieste computazionali, questa ricerca potrebbe aprire la strada a tecnologie di IA più efficienti dal punto di vista energetico e con una minore impronta ambientale.
Questioni di ricerca aperte e direzioni future
Sebbene l'articolo "Scalable MatMul-free Language Modeling" rappresenti un passo avanti significativo, apre anche diverse strade per ulteriori ricerche: esplorare diverse architetture senza MatMul, valutarne le prestazioni su una gamma più ampia di task e comprendere matematicamente i limiti teorici di questo approccio sono solo alcune delle direzioni di ricerca più interessanti.
Inoltre, sviluppare benchmark e metriche di valutazione standardizzati specifici per i modelli senza MatMul faciliterebbe confronti equi e accelererebbe i progressi in questo campo. Il percorso verso un'IA davvero efficiente e accessibile è appena iniziato e le possibilità sono infinite. E personalmente non vedo l'ora di provare futuri chatbot assistenti senza MatMul!
Conclusione
L'articolo "Scalable MatMul-free Language Modeling" offre un contributo significativo al campo degli LLM introducendo un approccio innovativo che elimina le operazioni di moltiplicazione di matrici (MatMul).
Questa svolta affronta i colli di bottiglia computazionali e di memoria associati agli LLM tradizionali, aprendo la strada a modelli più efficienti e scalabili. Sfruttando operazioni additive e pesi ternari, gli autori dimostrano che è possibile mantenere prestazioni competitive riducendo in modo significativo le risorse richieste.
L'impatto potenziale di questa ricerca sul futuro dello sviluppo e del deployment degli LLM è profondo. I modelli senza MatMul offrono un'alternativa valida alle architetture convenzionali, consentendo la creazione di modelli leggeri ed efficienti, ideali per ambienti con risorse limitate come i dispositivi edge e le piattaforme mobili.
Se vuoi saperne di più sull'intelligenza artificiale, dai un'occhiata a questi corsi di IA.







Il costo computazionale dell'addestramento dei large language model (LLM) sta diventando sempre più fuori controllo. Per esempio, l'addestramento di GPT-4 è costato a OpenAI circa 100 milioni di dollari. Il costo deriva principalmente dalle operazioni di moltiplicazione di matrici (in breve MatMul) ed è naturale che ricercatori e sviluppatori abbiano cercato di eliminarle del tutto o renderle più efficienti.
L'articolo "Scalable MatMul-free Language Modeling" introduce un approccio innovativo che affronta il problema di petto. Eliminando completamente MatMul dagli LLM, gli autori hanno sviluppato un modello che mantiene prestazioni competitive riducendo in modo significativo i requisiti computazionali e di memoria.
Fonte: Rui-Jie Zhu et. al
Tutti i modelli descritti nell'articolo sono disponibili su HuggingFace: puoi provarli online o in locale usando le librerie di HuggingFace. Inoltre, i ricercatori hanno pubblicato il loro codice su GitHub, consentendo ad altri di addestrare i propri modelli.
Se vuoi capire meglio la complessità temporale cubica della moltiplicazione di matrici, ti consiglio questa introduzione alla notazione Big-O e alla complessità temporale, che include una sezione dedicata alla complessità temporale degli LLM con MatMul.
Ho anche realizzato un confronto tra LLM senza MatMul e con MatMul: lo trovi in questo articolo: Matmul-Free vs MatMul LLMs: velocità e consumo di memoria.
Il collo di bottiglia del MatMul nei large language model
Gli LLM moderni basati su transformer si affidano fortemente alle operazioni di moltiplicazione di matrici, centrali per componenti fondamentali come i meccanismi di attenzione e i layer feedforward. I costi computazionali e di memoria associati alle operazioni MatMul sono ingenti e incidono sia sulle fasi di addestramento sia su quelle di inferenza. Man mano che la dimensione degli LLM aumenta, cresce il numero di parametri e la complessità dei calcoli, rendendo MatMul un importante collo di bottiglia.
Un esempio comune di questo problema si verifica quando la VRAM di una GPU non è sufficiente a gestire la dimensione del modello, costringendo gli utenti ad addestrare o eseguire l'inferenza su CPU. Le CPU non sono ottimizzate per le operazioni MatMul parallelizzate come le GPU, con conseguente rallentamento significativo dei calcoli. Si crea così un circolo vizioso in cui l'hardware disponibile non può essere sfruttato appieno a causa dei vincoli di memoria, anche quando la potenza di calcolo sarebbe adeguata.
Nel corso degli anni, i ricercatori hanno esplorato varie strategie per ridurre il carico computazionale di MatMul. La quantizzazione, che consiste nel ridurre la precisione dei pesi e delle attivazioni, è stata un approccio popolare. Rappresentando i numeri con meno bit, la quantizzazione può abbassare il costo computazionale e l'impronta di memoria delle operazioni MatMul.
Tuttavia, questo metodo spesso sacrifica l'accuratezza del modello e non elimina completamente MatMul. Sforzi degni di nota come BitNet di Microsoft hanno mostrato che è possibile scalare gli LLM con quantizzazione binaria o ternaria, ma questi modelli si affidano comunque a operazioni MatMul per alcune parti, come il meccanismo di self-attention.
Sono state proposte anche architetture alternative per affrontare le inefficienze di MatMul. Approcci come AdderNet sostituiscono le moltiplicazioni con addizioni in alcuni componenti della rete, e le reti neurali binarie/ternarie utilizzano operazioni aritmetiche semplificate
Sebbene questi metodi offrano alcuni miglioramenti, in genere non riescono a rimuovere completamente MatMul e si concentrano solo su parti specifiche del modello. Di conseguenza, il costo computazionale complessivo rimane elevato, limitando scalabilità ed efficienza degli LLM.
Come funzionano i modelli linguistici senza MatMul
Per capire come funzionano gli LM senza MatMul, esaminiamo l'architettura sottostante e i componenti chiave.
Sostituire MatMul con operazioni ternarie
Nelle reti neurali tradizionali, i layer densi (che collegano tutti i neuroni tra due layer consecutivi) si basano su MatMul per trasformare i dati in input. Gli autori li sostituiscono con layer BitLinear, che utilizzano pesi ternari. Invece di avere pesi che possono assumere qualsiasi numero reale, sono vincolati a soli tre valori: -1, 0 o 1.
I pesi vengono inizialmente addestrati in piena precisione e poi, durante l'addestramento, quantizzati a valori ternari tramite un processo chiamato "absmean quantization". Questo processo scala la matrice dei pesi per il suo valore assoluto medio e poi arrotonda ogni elemento all'intero ternario più vicino (-1, 0 o 1).
Questa semplificazione consente di sostituire le moltiplicazioni in MatMul con addizioni e sottrazioni. Per esempio, moltiplicare un numero per -1 equivale a negarlo, moltiplicarlo per 0 dà 0 e moltiplicarlo per 1 lascia il numero invariato.
Componenti principali: MLGRU E GLU
La figura seguente offre una panoramica dei componenti chiave del MatMul-Free Language Model, inclusi la MatMul-Free Linear Gated Recurrent Unit (MLGRU) e la MatMul-Free Gated Linear Unit (GLU):
Fonte: Rui-Jie Zhu et. al
La figura è suddivisa in diverse sezioni (dall'alto a sinistra in basso a destra):
La MLGRU opera elaborando la sequenza di input un token alla volta. A ogni passo prende l'embedding del token corrente e lo stato nascosto precedente come input. Lo stato nascosto funge da memoria, conservando informazioni dai token precedenti. La MLGRU quindi aggiorna questo stato nascosto usando una serie di operazioni elemento per elemento e meccanismi di gating. Questi gate, in sostanza vettori di numeri tra 0 e 1, controllano il flusso di informazioni determinando quali parti dello stato nascosto precedente e dell'embedding del token corrente sono più rilevanti per il passo successivo. Questo processo continua finché l'intera sequenza non è stata elaborata.
La gated linear unit (GLU) senza MatMul è un altro componente chiave del modello linguistico senza MatMul. Mescola le informazioni tra le diverse dimensioni della rappresentazione interna delle parole (embedding) del modello. In parole più semplici, aiuta il modello a cogliere i diversi aspetti o caratteristiche di ciascuna parola.
La GLU ottiene questo risultato usando un meccanismo di gating per controllare il flusso di informazioni tra i diversi canali di embedding. Questo meccanismo di gating è simile a quello della MLGRU, ma opera sulla dimensione dei canali invece che su quella dei token.
La GLU senza MatMul è una versione modificata della GLU standard, adattata per eliminare le moltiplicazioni di matrici usando layer BitLinear, ossia layer densi che impiegano pesi ternari (pesi che possono assumere solo i valori -1, 0 o 1). Nella GLU senza MatMul, l'input viene prima trasformato usando due layer BitLinear separati. L'output di un layer viene fatto passare attraverso la funzione di attivazione SiLU e poi moltiplicato elemento per elemento con l'output dell'altro layer. Questo output "gated" viene quindi fatto passare attraverso un altro layer BitLinear per produrre l'output finale.
Questa è solo una spiegazione ad alto livello dei componenti MLGRU e GLU. Ti invito a consultare l'articolo di ricerca originale per comprendere più in dettaglio il loro funzionamento interno e le formulazioni matematiche.
Senza MatMul vs. Transformer
La ricerca indaga le leggi di scalabilità dei modelli senza MatMul, confrontandone le prestazioni con le architetture Transformer tradizionali man mano che aumenta la dimensione del modello.
Prestazioni e scalabilità
Sorprendentemente, i risultati rivelano che il divario di prestazioni tra i due approcci si riduce all'aumentare della dimensione del modello. Si tratta di un'osservazione significativa perché suggerisce che i modelli senza MatMul diventano sempre più competitivi rispetto ai Transformer tradizionali man mano che scalano, potenzialmente superandoli a scale molto grandi.
Fonte: Rui-Jie Zhu et. al
Questo grafico sul confronto delle leggi di scalabilità mostra che le curve della loss degli LM senza MatMul e dei transformer tradizionali convergono all'aumentare del numero di operazioni in virgola mobile (FLOP).
Inizialmente, gli LM senza MatMul mostrano una loss più alta a causa dei vincoli dei pesi ternari. Tuttavia, questo divario diminuisce con l'aumentare della dimensione del modello e a un certo punto (stella) le curve della loss si intersecano, indicando prestazioni comparabili. Ciò suggerisce una legge di scalabilità più ripida per i modelli senza MatMul, il che significa che le loro prestazioni migliorano più rapidamente all'aumentare della dimensione rispetto ai Transformer tradizionali.
Risultati ai benchmark
Le prestazioni competitive degli LM senza MatMul sono ulteriormente confermate dai buoni risultati in vari benchmark di apprendimento zero-shot. In compiti come ARC-Easy, ARC-Challenge, Hellaswag, Winogrande, PIQA e OpenbookQA, questi modelli spesso sono alla pari o superano i Transformer tradizionali, nonostante la complessità computazionale significativamente ridotta. Questo testimonia l'efficacia delle operazioni alternative e delle scelte architetturali adottate negli LM senza MatMul.
Fonte: Rui-Jie Zhu et. al
La tabella sull'accuratezza zero-shot mostra che gli LM senza MatMul sono competitivi su vari task. Per esempio, in ARC-Challenge, un benchmark particolarmente difficile, l'LM senza MatMul da 2,7B di parametri ottiene un'accuratezza superiore a quella di un modello transformer tradizionale.
Analogamente, nei task Winogrande e OpenbookQA, gli LM senza MatMul mostrano prestazioni robuste, indicando che eliminare MatMul non compromette la capacità del modello di comprendere e generare linguaggio.
Efficienza della memoria
Uno dei vantaggi più evidenti degli LM senza MatMul è la straordinaria efficienza in termini di memoria. Sostituendo le operazioni ad alta intensità di moltiplicazioni con semplici addizioni e sottrazioni abilitate dai pesi ternari, questi modelli ottengono riduzioni sostanziali nell'uso della memoria.
Durante l'addestramento, un'implementazione GPU ottimizzata può ridurre il consumo di memoria fino al 61% rispetto ai modelli non ottimizzati. In inferenza, i risparmi di memoria sono ancora più marcati, con riduzioni superiori a dieci volte. Questo rende gli LM senza MatMul particolarmente allettanti per il deployment su dispositivi con risorse limitate come gli smartphone, dove la memoria è spesso un fattore limitante.
Fonte: Rui-Jie Zhu et. al
Questo grafico sul confronto tra memoria GPU e latenza illustra i guadagni di efficienza degli LM senza MatMul. Il consumo di memoria in inferenza di un LM senza MatMul da 2,7B di parametri è significativamente inferiore rispetto a quello di un Transformer tradizionale comparabile. Questa impronta di memoria ridotta non solo consente il deployment di modelli più grandi su hardware limitato, ma si traduce anche in una latenza inferiore, rendendo questi modelli più adatti ad applicazioni in tempo reale in cui la reattività è cruciale.
Dalle GPU ottimizzate al design FPGA personalizzato
Uno dei progressi chiave presentati nell'articolo è l'implementazione GPU ottimizzata degli LM senza MatMul. Gli autori hanno ottenuto un aumento della velocità di addestramento del 25,6% e una riduzione dell'uso di memoria fino al 61,0% utilizzando kernel fusi nella loro implementazione GPU. Questi kernel combinano più operazioni in un unico processo più efficiente, riducendo l'overhead associato all'accesso alla memoria e allo spostamento dei dati.
Per sfruttare ulteriormente le operazioni leggere degli LM senza MatMul, gli autori hanno sviluppato un acceleratore FPGA personalizzato in SystemVerilog. Gli FPGA (Field-Programmable Gate Array) offrono una piattaforma hardware flessibile ed efficiente per implementare compiti computazionali specializzati.
L'acceleratore personalizzato è stato progettato per sfruttare la semplicità delle operazioni ternarie e dei prodotti elemento per elemento, ottenendo notevoli guadagni di efficienza. L'implementazione RTL (Register Transfer Level) è fondamentale nel processo di progettazione FPGA. Comporta la specifica del comportamento hardware a un livello alto, che viene poi sintetizzato nella configurazione effettiva dell'FPGA. Il design RTL personalizzato per gli LM senza MatMul assicura che l'FPGA possa gestire in modo efficiente le operazioni leggere, riducendo i consumi energetici e aumentando il throughput.
Fonte: Rui-Jie Zhu et. al
La figura illustra l'implementazione RTL dell'acceleratore FPGA personalizzato. A destra del Register Router si vedono le funzioni che implementa. Gli autori hanno anche sviluppato un proprio assembler per convertire file assembly con istruzioni personalizzate in una instruction ROM, che si può vedere sulla destra della figura. Le istruzioni vengono fornite al Register Router, che gestisce la memoria (Register File) ed esegue le istruzioni.
Inoltre, gli autori hanno menzionato in un commento a una issue su GitHub che le specifiche complete della loro implementazione FPGA sono ancora in fase di ottimizzazione e il codice SystemVerilog sarà reso pubblico più avanti.
La tabella seguente mostra l'utilizzo delle risorse e le metriche di prestazioni per l'implementazione FPGA della generazione di token senza MatMul.
Fonte: Rui-Jie Zhu et. al
I dati dimostrano che, all'aumentare del numero di core (unità di elaborazione) all'interno dell'FPGA, la latenza complessiva inizialmente rimane relativamente stabile. Tuttavia, la latenza aumenta in modo significativo passando da 16 a 26 core, suggerendo che l'interfaccia DDR4, responsabile del trasferimento dati, stia diventando un collo di bottiglia man mano che la domanda di trasferimento cresce con il numero di core.
Sebbene l'operazione di moltiplicazione di matrici ternaria domini attualmente la latenza complessiva, gli autori prevedono che l'ottimizzazione di questa unità nelle implementazioni future sposterà il collo di bottiglia sull'interfaccia DDR4.
Una delle affermazioni più intriganti dell'articolo è che l'approccio senza MatMul avvicina gli LLM all'efficienza cerebrale in termini di calcolo e consumo energetico. Gli autori sostengono che i loro modelli imitino l'efficienza delle reti neurali biologiche e raggiungano una velocità di lettura simile a quella umana.
Tuttavia, confrontare direttamente l'efficienza di questi modelli con i complessi meccanismi delle reti neurali biologiche è una questione articolata che richiede ulteriori indagini. I meccanismi computazionali del cervello sono radicalmente diversi e molto più complessi delle operazioni semplificate utilizzate negli LM senza MatMul.
Senza MatMul: implicazioni e direzioni future
L'articolo "Scalable MatMul-free Language Modeling" mette in discussione un presupposto fondamentale dell'elaborazione del linguaggio naturale: che la moltiplicazione di matrici (MatMul) sia essenziale per costruire LLM ad alte prestazioni.
Dimostrando la fattibilità di architetture senza MatMul, questa ricerca apre una nuova frontiera nel design degli LLM, incoraggiando l'esplorazione di operazioni alternative e paradigmi computazionali. Ciò potrebbe portare a un'ondata di innovazione, con ricercatori impegnati a sviluppare nuove architetture di modelli.
Accelerazione hardware per modelli leggeri
Questo passaggio verso modelli senza MatMul non riguarda solo il software, ma anche l'hardware. I chip tradizionali come le GPU sono ottimi nelle moltiplicazioni di matrici, ma non sono necessariamente la scelta migliore per questi nuovi modelli leggeri.
L'acceleratore FPGA personalizzato costruito dai ricercatori offre uno scorcio sul futuro dell'hardware per l'IA: chip specializzati progettati per spremere ogni goccia di prestazioni da questi modelli efficienti. Questo potrebbe portare a una nuova generazione di dispositivi basati sull'IA più veloci, più efficienti dal punto di vista energetico e accessibili a un pubblico più ampio.
Impatto ambientale e sostenibilità
Da persona attenta all'ambiente, sono particolarmente entusiasta del potenziale dei modelli senza MatMul nel ridurre l'impronta di carbonio dell'IA. L'enorme consumo energetico dei grandi modelli linguistici di oggi è un problema reale. Riducendo in modo significativo le richieste computazionali, questa ricerca potrebbe aprire la strada a tecnologie di IA più efficienti dal punto di vista energetico e con una minore impronta ambientale.
Questioni di ricerca aperte e direzioni future
Sebbene l'articolo "Scalable MatMul-free Language Modeling" rappresenti un passo avanti significativo, apre anche diverse strade per ulteriori ricerche: esplorare diverse architetture senza MatMul, valutarne le prestazioni su una gamma più ampia di task e comprendere matematicamente i limiti teorici di questo approccio sono solo alcune delle direzioni di ricerca più interessanti.
Inoltre, sviluppare benchmark e metriche di valutazione standardizzati specifici per i modelli senza MatMul faciliterebbe confronti equi e accelererebbe i progressi in questo campo. Il percorso verso un'IA davvero efficiente e accessibile è appena iniziato e le possibilità sono infinite. E personalmente non vedo l'ora di provare futuri chatbot assistenti senza MatMul!
Conclusione
L'articolo "Scalable MatMul-free Language Modeling" offre un contributo significativo al campo degli LLM introducendo un approccio innovativo che elimina le operazioni di moltiplicazione di matrici (MatMul).
Questa svolta affronta i colli di bottiglia computazionali e di memoria associati agli LLM tradizionali, aprendo la strada a modelli più efficienti e scalabili. Sfruttando operazioni additive e pesi ternari, gli autori dimostrano che è possibile mantenere prestazioni competitive riducendo in modo significativo le risorse richieste.
L'impatto potenziale di questa ricerca sul futuro dello sviluppo e del deployment degli LLM è profondo. I modelli senza MatMul offrono un'alternativa valida alle architetture convenzionali, consentendo la creazione di modelli leggeri ed efficienti, ideali per ambienti con risorse limitate come i dispositivi edge e le piattaforme mobili.
Se vuoi saperne di più sull'intelligenza artificiale, dai un'occhiata a questi corsi di IA.