बड़े भाषा मॉडलों (LLMs) को प्रशिक्षित करने की संगणकीय लागत तेजी से नियंत्रण से बाहर होती जा रही है। उदाहरण के लिए, GPT-4 के प्रशिक्षण में OpenAI को लगभग 100 मिलियन डॉलर का खर्च आया। यह लागत मुख्य रूप से मैट्रिक्स गुणा (संक्षेप में MatMul) से आती है, और स्वाभाविक है कि शोधकर्ताओं और डेवलपरों ने इसे पूरी तरह खत्म करने या अधिक कुशल बनाने की कोशिश की है।
"Scalable MatMul-free Language Modeling" पेपर इस समस्या को सीधे संबोधित करते हुए एक क्रांतिकारी दृष्टिकोण प्रस्तुत करता है। LLMs से MatMul को पूरी तरह हटाकर लेखकों ने ऐसा मॉडल विकसित किया है जो प्रतिस्पर्धी प्रदर्शन बनाए रखते हुए संगणकीय और मेमोरी आवश्यकताओं को उल्लेखनीय रूप से कम करता है।
स्रोत: Rui-Jie Zhu व अन्य
पेपर के सभी मॉडल HuggingFace पर उपलब्ध हैं—आप उन्हें ऑनलाइन या स्थानीय रूप से HuggingFace की लाइब्रेरीज का उपयोग करके आज़मा सकते हैं। साथ ही, शोधकर्ताओं ने अपना कोड GitHub पर उपलब्ध कराया है, जिससे अन्य लोग अपने मॉडल प्रशिक्षित कर सकते हैं।
यदि आप मैट्रिक्स गुणा की घनात्मक समय-जटिलता को बेहतर ढंग से समझना चाहते हैं, तो मैं Big-O Notation और समय-जटिलता का यह परिचय सुझाता हूँ, जिसमें MatMul LLMs की समय-जटिलता पर एक विशेष अनुभाग है।
मैंने MatMul-रहित और MatMul LLMs के बीच एक तुलना भी की है—आप इसे इस लेख में पा सकते हैं: Matmul-Free बनाम MatMul LLMs: गति और मेमोरी खपत।
बड़े भाषा मॉडलों में MatMul की बाधा
आधुनिक ट्रांसफॉर्मर-आधारित LLMs अपनी मूल इकाइयों—जैसे कि अटेंशन मैकेनिज्म और फीडफॉरवर्ड लेयर्स—में मैट्रिक्स गुणा पर बहुत अधिक निर्भर करते हैं। MatMul ऑपरेशनों से जुड़ी संगणकीय और मेमोरी लागत काफी अधिक होती है, जो प्रशिक्षण और इन्फरेंस दोनों चरणों को प्रभावित करती है। जैसे-जैसे LLMs का आकार बढ़ता है, पैरामीटर्स की संख्या और गणनाओं की जटिलता बढ़ती है, जिससे MatMul एक बड़ी बाधा बन जाता है।
इस समस्या का एक सामान्य उदाहरण तब है जब GPU का VRAM मॉडल के आकार को संभालने के लिए अपर्याप्त होता है, जिससे उपयोगकर्ताओं को CPU पर प्रशिक्षण या इन्फरेंस चलाने के लिए मजबूर होना पड़ता है। CPU, GPU की तरह पैरेललाइज़्ड MatMul ऑपरेशनों के लिए अनुकूलित नहीं होते, जिसके कारण गणनाएँ काफी धीमी हो जाती हैं। इससे एक निराशाजनक स्थिति पैदा होती है जहाँ उपलब्ध हार्डवेयर, संगणकीय शक्ति पर्याप्त होने के बावजूद, मेमोरी सीमाओं के कारण पूरी तरह से उपयोग नहीं हो पाता।
वर्षों से, शोधकर्ताओं ने MatMul के संगणकीय बोझ को कम करने के लिए विभिन्न रणनीतियों का पता लगाया है। क्वांटाइज़ेशन—जिसमें वेट्स और एक्टिवेशनों की परिशुद्धता कम की जाती है—एक लोकप्रिय तरीका रहा है। कम बिट्स में संख्याएँ दर्शाकर, क्वांटाइज़ेशन MatMul ऑपरेशनों की संगणकीय लागत और मेमोरी फ़ुटप्रिंट को घटा सकता है।
हालाँकि, यह तरीका अक्सर मॉडल की शुद्धता से समझौता करता है और MatMul को पूरी तरह समाप्त नहीं करता। Microsoft के BitNet जैसे उल्लेखनीय प्रयासों ने दिखाया है कि बाइनरी या टर्नरी क्वांटाइज़ेशन के साथ LLMs को स्केल करना संभव है, लेकिन ये मॉडल अभी भी कुछ हिस्सों—जैसे कि सेल्फ-अटेंशन मैकेनिज्म—के लिए MatMul पर निर्भर रहते हैं।
MatMul की अक्षमताओं को संबोधित करने के लिए वैकल्पिक आर्किटेक्चर भी प्रस्तावित किए गए हैं। AdderNet जैसी विधियाँ नेटवर्क के कुछ घटकों में गुणा को जोड़ से बदलती हैं, और बाइनरी/टर्नरी न्यूरल नेटवर्क सरलीकृत अंकगणितीय ऑपरेशनों का उपयोग करते हैं।
यद्यपि ये तरीके कुछ सुधार प्रदान करते हैं, वे आमतौर पर MatMul को पूरी तरह हटाने में विफल रहते हैं और केवल मॉडल के विशिष्ट हिस्सों को लक्षित करते हैं। परिणामस्वरूप, कुल संगणकीय लागत उच्च बनी रहती है, जिससे LLMs की स्केलेबिलिटी और दक्षता सीमित होती है।
MatMul-रहित भाषा मॉडल कैसे काम करते हैं
यह समझने के लिए कि MatMul-रहित LMs कैसे काम करते हैं, आइए उनकी मूल वास्तुकला और प्रमुख घटकों की जाँच करें।
MatMul को टर्नरी ऑपरेशनों से बदलना
पारंपरिक न्यूरल नेटवर्क में, डेंस लेयर्स (जो दो क्रमिक लेयर्स के सभी न्यूरॉनों को जोड़ती हैं) इनपुट डेटा को रूपांतरित करने के लिए MatMul पर निर्भर होती हैं। लेखक इन्हें BitLinear लेयर्स से बदलते हैं, जो टर्नरी वेट्स का उपयोग करती हैं। वेट्स किसी भी वास्तविक संख्या के बजाय केवल तीन मान ले सकते हैं: -1, 0, या 1।
वेट्स प्रारंभ में पूर्ण-परिशुद्धता मानों के रूप में प्रशिक्षित किए जाते हैं, और फिर प्रशिक्षण के दौरान उन्हें "absmean quantization" नामक प्रक्रिया का उपयोग करके टर्नरी मानों में क्वांटाइज़ किया जाता है। इस प्रक्रिया में वेट मैट्रिक्स को उसके औसत परिमाण मान से स्केल किया जाता है और फिर प्रत्येक तत्व को निकटतम टर्नरी पूर्णांक (-1, 0, या 1) पर राउंड किया जाता है।
यह सरलीकरण उन्हें MatMul में गुणाओं को जोड़ और घटाव से बदलने की अनुमति देता है। उदाहरण के लिए, किसी संख्या को -1 से गुणा करना उसे नेगेट करने के बराबर है, 0 से गुणा करने पर 0 मिलता है, और 1 से गुणा करने पर संख्या अपरिवर्तित रहती है।
मुख्य घटक: MLGRU और GLU
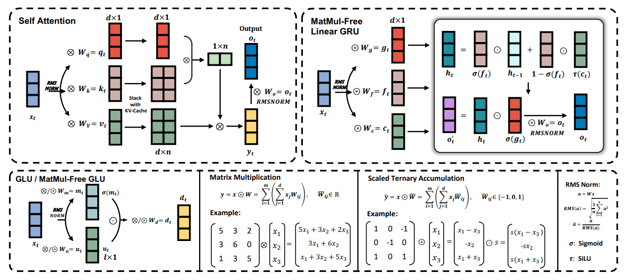
नीचे दिया गया चित्र MatMul-रहित भाषा मॉडल के प्रमुख घटकों का अवलोकन प्रस्तुत करता है, जिनमें MatMul-रहित Linear Gated Recurrent Unit (MLGRU) और MatMul-रहित Gated Linear Unit (GLU) शामिल हैं:
स्रोत: Rui-Jie Zhu व अन्य
चित्र को कई वर्गों में बाँटा गया है (ऊपर बाएँ से नीचे दाएँ):
- सेल्फ-अटेंशन: यह भाग दिखाता है कि पारंपरिक सेल्फ-अटेंशन मैकेनिज्म मैट्रिक्स गुणाओं के साथ कैसे कार्य करता है।
- MatMul-रहित लीनियर GRU: यह भाग MLGRU की संरचना को दर्शाता है, यह रेखांकित करते हुए कि यह MatMul के बजाय एलिमेंट-वाइज़ ऑपरेशनों और गेटिंग मैकेनिज्म से इनपुट सीक्वेंस को कैसे प्रोसेस करता है।
- GLU / MatMul-रहित GLU: यह भाग दिखाता है कि GLU कैसे मॉडल के एम्बेडिंग्स के विभिन्न आयामों में जानकारी का मिश्रण करता है, MatMul को खत्म करने के लिए टर्नरी वेट्स का उपयोग करते हुए।
- मैट्रिक्स गुणा बनाम स्केल्ड टर्नरी एक्यूमुलेशन: यह तुलना दिखाती है कि मानक मैट्रिक्स गुणा को स्केल्ड टर्नरी एक्यूमुलेशन से कैसे बदला जाता है, जिससे गणनाएँ सरल हो जाती हैं।
- RMS नॉर्म: यह भाग RMSNorm ऑपरेशन का विवरण देता है, जो क्वांटाइज़ेशन से पहले एक्टिवेशनों को सामान्यीकृत करता है।
MLGRU इनपुट सीक्वेंस को एक समय में एक टोकन प्रोसेस करके काम करता है। प्रत्येक चरण में, यह वर्तमान टोकन के एम्बेडिंग और पिछले हिडन स्टेट को इनपुट के रूप में लेता है। हिडन स्टेट मेमोरी की तरह कार्य करता है, जो पिछले टोकनों की जानकारी संग्रहीत करता है। इसके बाद MLGRU एलिमेंट-वाइज़ ऑपरेशनों और गेटिंग मैकेनिज्म की एक शृंखला का उपयोग करके इस हिडन स्टेट को अपडेट करता है। ये गेट्स, मूल रूप से 0 और 1 के बीच संख्याओं के वेक्टर, सूचना के प्रवाह को नियंत्रित करते हैं, यह तय करके कि पिछले हिडन स्टेट और वर्तमान टोकन के एम्बेडिंग के कौन से हिस्से अगले चरण के लिए सबसे अधिक प्रासंगिक हैं। यह प्रक्रिया तब तक चलती रहती है जब तक पूरी सीक्वेंस प्रोसेस नहीं हो जाती।
MatMul-रहित गेटेड लीनियर यूनिट (GLU) MatMul-रहित भाषा मॉडल का एक और प्रमुख घटक है। यह शब्दों के मॉडल के आंतरिक निरूपण (एम्बेडिंग्स) के विभिन्न आयामों में जानकारी का मिश्रण करता है। सरल शब्दों में, यह मॉडल को प्रत्येक शब्द के विभिन्न पक्षों या विशेषताओं को समझने में मदद करता है।
GLU, विभिन्न एम्बेडिंग चैनलों के बीच सूचना के प्रवाह को नियंत्रित करने के लिए गेटिंग मैकेनिज्म का उपयोग करता है। यह गेटिंग मैकेनिज्म MLGRU के गेट्स के समान है, लेकिन यह टोकन आयाम के बजाय चैनल आयाम पर कार्य करता है।
MatMul-रहित GLU मानक GLU का एक परिवर्तित संस्करण है, जिसे BitLinear लेयर्स का उपयोग करके मैट्रिक्स गुणाओं को समाप्त करने हेतु अनुकूलित किया गया है। BitLinear लेयर्स ऐसी डेंस लेयर्स हैं जो टर्नरी वेट्स (केवल -1, 0, या 1) अपनाती हैं। MatMul-रहित GLU में, इनपुट को पहले दो अलग-अलग BitLinear लेयर्स से रूपांतरित किया जाता है। एक लेयर के आउटपुट को SiLU एक्टिवेशन फंक्शन से गुजारा जाता है और फिर उसे दूसरी लेयर के आउटपुट के साथ एलिमेंट-वाइज़ गुणा किया जाता है। इस गेटेड आउटपुट को फिर अंतिम आउटपुट उत्पन्न करने के लिए एक और BitLinear लेयर से पास किया जाता है।
यह MLGRU और GLU घटकों का केवल एक उच्च-स्तरीय स्पष्टीकरण है। मैं आपको उनके आंतरिक कार्यप्रणाली और गणितीय सूत्रीकरण की अधिक विस्तृत समझ के लिए मूल शोध-पत्र देखने के लिए प्रोत्साहित करता हूँ।
MatMul-रहित बनाम ट्रांसफॉर्मर्स
अनुसंधान MatMul-रहित मॉडलों के स्केलिंग नियमों की जाँच करता है, और मॉडल के आकार बढ़ने के साथ उनकी प्रदर्शन क्षमता की तुलना पारंपरिक ट्रांसफॉर्मर आर्किटेक्चर से करता है।
प्रदर्शन और स्केलेबिलिटी
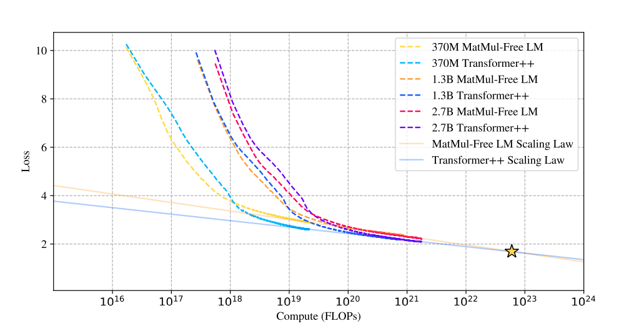
चौंकाने वाली बात यह सामने आई कि जैसे-जैसे मॉडल का आकार बढ़ता है, इन दोनों दृष्टिकोणों के बीच प्रदर्शन-अंतर घटता जाता है। यह एक महत्वपूर्ण अवलोकन है क्योंकि यह संकेत देता है कि बड़े पैमाने पर स्केलिंग के साथ MatMul-रहित मॉडल पारंपरिक ट्रांसफॉर्मर्स के साथ तेजी से प्रतिस्पर्धी होते जाते हैं, और बहुत बड़े स्केल पर संभवतः उनसे बेहतर कर सकते हैं।
स्रोत: Rui-Jie Zhu व अन्य
स्केलिंग लॉ तुलना वाला यह ग्राफ दिखाता है कि जैसे-जैसे फ्लोटिंग-पॉइंट ऑपरेशनों (FLOPs) की संख्या बढ़ती है, MatMul-रहित LMs और पारंपरिक ट्रांसफॉर्मर्स की लॉस वक्रें एक-दूसरे के करीब आती जाती हैं।
शुरुआत में, टर्नरी वेट्स की सीमाओं के कारण MatMul-रहित LMs में लॉस अधिक होता है। हालाँकि, जैसे-जैसे मॉडल का आकार बढ़ता है, यह अंतर कम होता जाता है, और एक बिंदु (सितारा) पर लॉस वक्रें एक-दूसरे को काटती हैं, जो तुलनीय प्रदर्शन का संकेत देती हैं। यह MatMul-रहित मॉडलों के लिए अधिक तीव्र स्केलिंग लॉ का संकेत देता है, अर्थात् पारंपरिक ट्रांसफॉर्मर्स की तुलना में आकार बढ़ने के साथ उनका प्रदर्शन अधिक तेज़ी से सुधरता है।
बेंचमार्क परिणाम
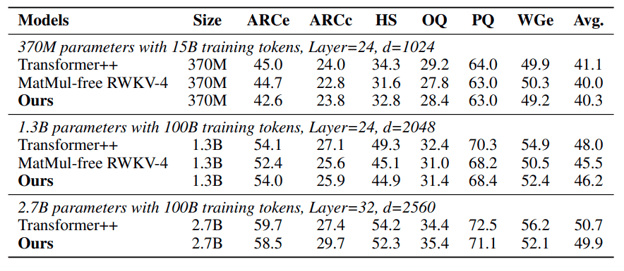
विभिन्न ज़ीरो-शॉट लर्निंग बेंचमार्क्स पर मजबूत प्रदर्शन के कारण MatMul-रहित LMs की प्रतिस्पर्धी क्षमता और सुदृढ़ होती है। ARC-Easy, ARC-Challenge, Hellaswag, Winogrande, PIQA, और OpenbookQA जैसे कार्यों में, ये मॉडल अक्सर पारंपरिक ट्रांसफॉर्मर्स के बराबर या उनसे बेहतर प्रदर्शन करते हैं, जबकि उनकी संगणकीय जटिलता काफी कम होती है। यह MatMul-रहित LMs में अपनाए गए वैकल्पिक ऑपरेशनों और आर्किटेक्चरल विकल्पों की प्रभावशीलता का प्रमाण है।
स्रोत: Rui-Jie Zhu व अन्य
ज़ीरो-शॉट एक्यूरेसी वाली यह तालिका दिखाती है कि MatMul-रहित LMs विभिन्न कार्यों में प्रतिस्पर्धी प्रदर्शन करते हैं। उदाहरण के लिए, ARC-Challenge—जो विशेष रूप से कठिन बेंचमार्क है—में 2.7B पैरामीटर वाला MatMul-रहित LM एक पारंपरिक ट्रांसफॉर्मर मॉडल से अधिक सटीकता प्राप्त करता है।
इसी तरह, Winogrande और OpenbookQA कार्यों पर भी MatMul-रहित LMs मजबूत प्रदर्शन दिखाते हैं, जो दर्शाता है कि MatMul को हटाने से मॉडल की भाषा को समझने और उत्पन्न करने की क्षमता से समझौता नहीं होता।
मेमोरी दक्षता
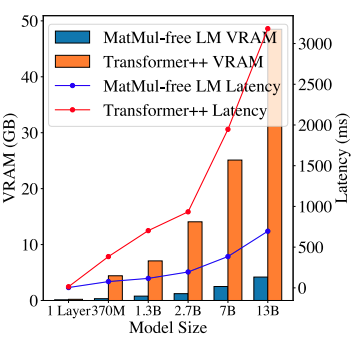
MatMul-रहित LMs का सबसे आकर्षक लाभ उनकी असाधारण मेमोरी दक्षता है। टर्नरी वेट्स द्वारा सक्षम सरल जोड़-घटाव का उपयोग करके ये मॉडल मेमोरी उपयोग में पर्याप्त कमी हासिल करते हैं।
प्रशिक्षण के दौरान, एक अनुकूलित GPU इम्प्लीमेंटेशन, बिना अनुकूलित मॉडलों की तुलना में, मेमोरी खपत को 61% तक घटा सकता है। इन्फरेंस में, मेमोरी की बचत और भी अधिक नाटकीय होती है, दस गुना से अधिक की कमी के साथ। यह MatMul-रहित LMs को स्मार्टफोन्स जैसे संसाधन-सीमित उपकरणों पर परिनियोजन के लिए विशेष रूप से आकर्षक बनाता है, जहाँ मेमोरी अक्सर एक सीमित कारक होती है।
स्रोत: Rui-Jie Zhu व अन्य
GPU मेमोरी और लेटेंसी तुलना वाला यह ग्राफ MatMul-रहित LMs की दक्षता में हुए लाभों को दर्शाता है। 2.7B पैरामीटर वाले MatMul-रहित LM की इन्फरेंस मेमोरी खपत, तुलनीय पारंपरिक ट्रांसफॉर्मर की तुलना में, उल्लेखनीय रूप से कम है। यह कम मेमोरी फ़ुटप्रिंट न केवल सीमित हार्डवेयर पर बड़े मॉडलों के परिनियोजन की अनुमति देता है, बल्कि कम लेटेंसी में भी तब्दील होता है, जिससे ये मॉडल वास्तविक-समय के अनुप्रयोगों के लिए अधिक उपयुक्त बनते हैं, जहाँ प्रतिसादशीलता महत्वपूर्ण होती है।
ऑप्टिमाइज़्ड GPUs से कस्टम FPGA डिज़ाइन तक
पेपर में प्रस्तुत प्रमुख प्रगतियों में से एक MatMul-रहित LMs का ऑप्टिमाइज़्ड GPU इम्प्लीमेंटेशन है। लेखकों ने अपनी स्वयं की GPU इम्प्लीमेंटेशन में फ्यूज़्ड कर्नलों का उपयोग करके प्रशिक्षण गति में 25.6% की वृद्धि और मेमोरी उपयोग में 61.0% तक की कमी हासिल की। ये कर्नल्स कई ऑपरेशनों को एक एकल, अधिक कुशल प्रक्रिया में संयोजित करते हैं, जिससे मेमोरी एक्सेस और डेटा मूवमेंट से जुड़ा ओवरहेड कम होता है।
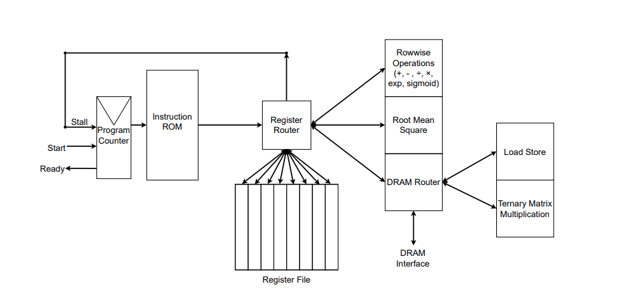
MatMul-रहित LMs के हल्के ऑपरेशनों का और अधिक लाभ उठाने के लिए, लेखकों ने SystemVerilog में एक कस्टम FPGA एक्सेलरेटर विकसित किया। FPGA (Field-Programmable Gate Arrays) विशेष संगणकीय कार्यों को लागू करने के लिए एक लचीला और कुशल हार्डवेयर प्लेटफॉर्म प्रदान करते हैं।
कस्टम एक्सेलरेटर को टर्नरी ऑपरेशनों और एलिमेंट-वाइज़ प्रोडक्ट्स की सरलता का लाभ उठाने के लिए डिज़ाइन किया गया, जिससे पर्याप्त दक्षता लाभ प्राप्त हुए। RTL (Register Transfer Level) इम्प्लीमेंटेशन FPGA डिज़ाइन प्रक्रिया में महत्वपूर्ण है। इसमें हार्डवेयर के व्यवहार को उच्च स्तर पर निर्दिष्ट करना शामिल होता है, जिसे बाद में वास्तविक FPGA कॉन्फ़िगरेशन में संश्लेषित किया जाता है। MatMul-रहित LMs के लिए कस्टम RTL डिज़ाइन यह सुनिश्चित करता है कि FPGA हल्के ऑपरेशनों को कुशलतापूर्वक संभाल सके, जिससे ऊर्जा खपत कम होती है और थ्रूपुट बढ़ता है।
स्रोत: Rui-Jie Zhu व अन्य
चित्र कस्टम FPGA एक्सेलरेटर की RTL इम्प्लीमेंटेशन को दर्शाता है। आप Register Router के दाईं ओर वे फ़ंक्शन्स देख सकते हैं जिन्हें यह लागू करता है। लेखकों ने अपना स्वयं का असेंबलर भी विकसित किया जो कस्टम इंस्ट्रक्शनों के साथ असेंबली फ़ाइलों को इंस्ट्रक्शन ROM में कन्वर्ट करता है, जिसे आप चित्र के दाईं ओर देख सकते हैं। इंस्ट्रक्शन्स Register Router को दिए जाते हैं जो मेमोरी (Register File) का प्रबंधन करता है और इंस्ट्रक्शन्स को निष्पादित करता है।
इसके अलावा, लेखकों ने एक GitHub इश्यू पर टिप्पणी में उल्लेख किया कि उनके FPGA इम्प्लीमेंटेशन की पूर्ण विशिष्टताएँ अभी भी ऑप्टिमाइज़ की जा रही हैं, और SystemVerilog कोड बाद में सार्वजनिक किया जाएगा।
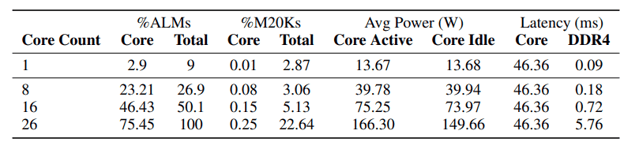
नीचे दी गई तालिका MatMul-रहित टोकन जनरेशन की FPGA इम्प्लीमेंटेशन के लिए संसाधन-उपयोग और प्रदर्शन मीट्रिक्स दिखाती है।
स्रोत: Rui-Jie Zhu व अन्य
डाटा से पता चलता है कि जैसे-जैसे FPGA के भीतर कोरों (प्रोसेसिंग यूनिट्स) की संख्या बढ़ती है, समग्र लेटेंसी प्रारंभ में अपेक्षाकृत स्थिर रहती है। हालाँकि, 16 से 26 कोर तक लेटेंसी में उल्लेखनीय वृद्धि होती है, जो यह सुझाती है कि DDR4 इंटरफ़ेस—जो डेटा ट्रांसफ़र के लिए ज़िम्मेदार है—कोरों की संख्या के साथ डेटा ट्रांसफ़र की माँग बढ़ने पर एक बाधा बन रहा है।
फिलहाल, कुल लेटेंसी में टर्नरी मैट्रिक्स गुणा ऑपरेशन का प्रभुत्व है, लेकिन लेखक अनुमान लगाते हैं कि भविष्य के इम्प्लीमेंटेशनों में इस यूनिट का ऑप्टिमाइज़ेशन करने पर बाधा DDR4 इंटरफ़ेस पर शिफ्ट हो जाएगी।
पेपर के सबसे रोचक दावों में से एक यह है कि MatMul-रहित दृष्टिकोण गणना और ऊर्जा खपत के मामले में LLMs को मस्तिष्क जैसी दक्षता के करीब लाता है। लेखक तर्क देते हैं कि उनके मॉडल जैविक न्यूरल नेटवर्क्स की दक्षता की नकल करते हैं और मानव-समान पढ़ने की गति प्राप्त करते हैं।
हालाँकि, इन मॉडलों की दक्षता की तुलना जैविक न्यूरल नेटवर्क्स के जटिल कार्यप्रणाली से सीधे करना एक जटिल मुद्दा है, जिसके लिए और जाँच की आवश्यकता है। मस्तिष्क के संगणकीय तंत्र MatMul-रहित LMs में प्रयुक्त सरलीकृत ऑपरेशनों की तुलना में बहुत भिन्न और अधिक जटिल हैं।
MatMul-रहित: निहितार्थ और भविष्य की दिशाएँ
"Scalable MatMul-free Language Modeling" पेपर प्राकृतिक भाषा प्रसंस्करण में एक बुनियादी धारणा को चुनौती देता है: कि उच्च-प्रदर्शन LLMs बनाने के लिए मैट्रिक्स गुणा (MatMul) आवश्यक है।
MatMul-रहित आर्किटेक्चर की व्यवहारिकता प्रदर्शित करके, यह शोध LLM डिज़ाइन में एक नया क्षितिज खोलता है, जो वैकल्पिक ऑपरेशनों और संगणकीय प्रतिमानों की खोज को प्रोत्साहित करता है। इससे नवाचार की एक नई लहर आ सकती है, जहाँ शोधकर्ता नए मॉडल आर्किटेक्चर विकसित करें।
हल्के मॉडलों के लिए हार्डवेयर त्वरण
MatMul-रहित मॉडलों की ओर यह बदलाव केवल सॉफ्टवेयर की बात नहीं है—यह हार्डवेयर की भी बात है। GPU जैसे पारंपरिक चिप्स मैट्रिक्स गुणा में बेहतरीन हैं, लेकिन ये नए, हल्के मॉडलों के लिए जरूरी नहीं कि सबसे उपयुक्त हों।
शोधकर्ताओं द्वारा बनाया गया कस्टम FPGA एक्सेलरेटर AI हार्डवेयर के भविष्य की एक झलक है—विशेषीकृत चिप्स जो इन कुशल मॉडलों से अधिकतम प्रदर्शन निकालने के लिए डिज़ाइन किए गए हैं। इससे AI-संचालित उपकरणों की एक नई पीढ़ी आ सकती है जो तेज़, अधिक ऊर्जा-कुशल और व्यापक दर्शकों के लिए सुलभ हो।
पर्यावरणीय प्रभाव और स्थिरता
एक ऐसे व्यक्ति के रूप में जो पर्यावरण की परवाह करता है, मैं विशेष रूप से इस संभावना को लेकर उत्साहित हूँ कि MatMul-रहित मॉडल AI के कार्बन फ़ुटप्रिंट को कम कर सकते हैं। आज के बड़े भाषा मॉडलों की भारी ऊर्जा खपत वास्तव में चिंता का विषय है। संगणकीय माँगों को उल्लेखनीय रूप से घटाकर, यह शोध अधिक ऊर्जा-कुशल AI तकनीकों का मार्ग प्रशस्त कर सकता है जिनका पर्यावरणीय पदचिह्न छोटा हो।
खुले शोध प्रश्न और भविष्य की दिशाएँ
"Scalable MatMul-free Language Modeling" पेपर एक बड़ा कदम आगे बढ़ाता है, लेकिन यह आगे के शोध के कई रास्ते भी खोलता है—विभिन्न MatMul-रहित आर्किटेक्चर का अन्वेषण, उनके प्रदर्शन का व्यापक कार्यों पर मूल्यांकन, और इस दृष्टिकोण की सैद्धांतिक सीमाओं को गणितीय रूप से समझना—ये कुछ रोमांचक शोध दिशाएँ हैं।
इसके अतिरिक्त, विशेष रूप से MatMul-रहित मॉडलों के लिए मानकीकृत बेंचमार्क्स और मूल्यांकन मीट्रिक्स विकसित करना निष्पक्ष तुलना को सुगम बनाएगा और इस क्षेत्र में प्रगति को तेज करेगा। सचमुच कुशल और सुलभ AI की यात्रा अभी शुरू हुई है, और संभावनाएँ असीम हैं। साथ ही, मैं व्यक्तिगत रूप से भविष्य के MatMul-रहित सहायक चैटबॉट्स को आज़माने के लिए बहुत उत्साहित हूँ!
निष्कर्ष
"Scalable MatMul-free Language Modeling" पेपर MatMul (मैट्रिक्स गुणा) ऑपरेशनों को समाप्त करने वाला एक नया दृष्टिकोण प्रस्तुत करके LLMs के क्षेत्र में एक महत्वपूर्ण योगदान देता है।
यह प्रगति पारंपरिक LLMs से जुड़ी संगणकीय और मेमोरी बाधाओं को संबोधित करती है, जिससे अधिक कुशल और स्केलेबल मॉडलों का मार्ग प्रशस्त होता है। योगात्मक ऑपरेशनों और टर्नरी वेट्स का लाभ उठाकर, लेखक दिखाते हैं कि संसाधन माँगों को उल्लेखनीय रूप से घटाते हुए प्रतिस्पर्धी प्रदर्शन बनाए रखना संभव है।
LLM के विकास और परिनियोजन के भविष्य पर इस शोध का संभावित प्रभाव गहरा है। MatMul-रहित मॉडल पारंपरिक आर्किटेक्चर का एक व्यावहारिक विकल्प प्रदान करते हैं, जो हल्के, कुशल मॉडलों के निर्माण को सक्षम बनाते हैं, जो एज डिवाइसों और मोबाइल प्लेटफॉर्म जैसे संसाधन-सीमित परिवेशों के लिए उपयुक्त हैं।
यदि आप कृत्रिम बुद्धिमत्ता के बारे में और सीखना चाहते हैं, तो ये AI कोर्स देखें।


बड़े भाषा मॉडलों (LLMs) को प्रशिक्षित करने की संगणकीय लागत तेजी से नियंत्रण से बाहर होती जा रही है। उदाहरण के लिए, GPT-4 के प्रशिक्षण में OpenAI को लगभग 100 मिलियन डॉलर का खर्च आया। यह लागत मुख्य रूप से मैट्रिक्स गुणा (संक्षेप में MatMul) से आती है, और स्वाभाविक है कि शोधकर्ताओं और डेवलपरों ने इसे पूरी तरह खत्म करने या अधिक कुशल बनाने की कोशिश की है।
"Scalable MatMul-free Language Modeling" पेपर इस समस्या को सीधे संबोधित करते हुए एक क्रांतिकारी दृष्टिकोण प्रस्तुत करता है। LLMs से MatMul को पूरी तरह हटाकर लेखकों ने ऐसा मॉडल विकसित किया है जो प्रतिस्पर्धी प्रदर्शन बनाए रखते हुए संगणकीय और मेमोरी आवश्यकताओं को उल्लेखनीय रूप से कम करता है।
स्रोत: Rui-Jie Zhu व अन्य
पेपर के सभी मॉडल HuggingFace पर उपलब्ध हैं—आप उन्हें ऑनलाइन या स्थानीय रूप से HuggingFace की लाइब्रेरीज का उपयोग करके आज़मा सकते हैं। साथ ही, शोधकर्ताओं ने अपना कोड GitHub पर उपलब्ध कराया है, जिससे अन्य लोग अपने मॉडल प्रशिक्षित कर सकते हैं।
यदि आप मैट्रिक्स गुणा की घनात्मक समय-जटिलता को बेहतर ढंग से समझना चाहते हैं, तो मैं Big-O Notation और समय-जटिलता का यह परिचय सुझाता हूँ, जिसमें MatMul LLMs की समय-जटिलता पर एक विशेष अनुभाग है।
मैंने MatMul-रहित और MatMul LLMs के बीच एक तुलना भी की है—आप इसे इस लेख में पा सकते हैं: Matmul-Free बनाम MatMul LLMs: गति और मेमोरी खपत।
बड़े भाषा मॉडलों में MatMul की बाधा
आधुनिक ट्रांसफॉर्मर-आधारित LLMs अपनी मूल इकाइयों—जैसे कि अटेंशन मैकेनिज्म और फीडफॉरवर्ड लेयर्स—में मैट्रिक्स गुणा पर बहुत अधिक निर्भर करते हैं। MatMul ऑपरेशनों से जुड़ी संगणकीय और मेमोरी लागत काफी अधिक होती है, जो प्रशिक्षण और इन्फरेंस दोनों चरणों को प्रभावित करती है। जैसे-जैसे LLMs का आकार बढ़ता है, पैरामीटर्स की संख्या और गणनाओं की जटिलता बढ़ती है, जिससे MatMul एक बड़ी बाधा बन जाता है।
इस समस्या का एक सामान्य उदाहरण तब है जब GPU का VRAM मॉडल के आकार को संभालने के लिए अपर्याप्त होता है, जिससे उपयोगकर्ताओं को CPU पर प्रशिक्षण या इन्फरेंस चलाने के लिए मजबूर होना पड़ता है। CPU, GPU की तरह पैरेललाइज़्ड MatMul ऑपरेशनों के लिए अनुकूलित नहीं होते, जिसके कारण गणनाएँ काफी धीमी हो जाती हैं। इससे एक निराशाजनक स्थिति पैदा होती है जहाँ उपलब्ध हार्डवेयर, संगणकीय शक्ति पर्याप्त होने के बावजूद, मेमोरी सीमाओं के कारण पूरी तरह से उपयोग नहीं हो पाता।
वर्षों से, शोधकर्ताओं ने MatMul के संगणकीय बोझ को कम करने के लिए विभिन्न रणनीतियों का पता लगाया है। क्वांटाइज़ेशन—जिसमें वेट्स और एक्टिवेशनों की परिशुद्धता कम की जाती है—एक लोकप्रिय तरीका रहा है। कम बिट्स में संख्याएँ दर्शाकर, क्वांटाइज़ेशन MatMul ऑपरेशनों की संगणकीय लागत और मेमोरी फ़ुटप्रिंट को घटा सकता है।
हालाँकि, यह तरीका अक्सर मॉडल की शुद्धता से समझौता करता है और MatMul को पूरी तरह समाप्त नहीं करता। Microsoft के BitNet जैसे उल्लेखनीय प्रयासों ने दिखाया है कि बाइनरी या टर्नरी क्वांटाइज़ेशन के साथ LLMs को स्केल करना संभव है, लेकिन ये मॉडल अभी भी कुछ हिस्सों—जैसे कि सेल्फ-अटेंशन मैकेनिज्म—के लिए MatMul पर निर्भर रहते हैं।
MatMul की अक्षमताओं को संबोधित करने के लिए वैकल्पिक आर्किटेक्चर भी प्रस्तावित किए गए हैं। AdderNet जैसी विधियाँ नेटवर्क के कुछ घटकों में गुणा को जोड़ से बदलती हैं, और बाइनरी/टर्नरी न्यूरल नेटवर्क सरलीकृत अंकगणितीय ऑपरेशनों का उपयोग करते हैं।
यद्यपि ये तरीके कुछ सुधार प्रदान करते हैं, वे आमतौर पर MatMul को पूरी तरह हटाने में विफल रहते हैं और केवल मॉडल के विशिष्ट हिस्सों को लक्षित करते हैं। परिणामस्वरूप, कुल संगणकीय लागत उच्च बनी रहती है, जिससे LLMs की स्केलेबिलिटी और दक्षता सीमित होती है।
MatMul-रहित भाषा मॉडल कैसे काम करते हैं
यह समझने के लिए कि MatMul-रहित LMs कैसे काम करते हैं, आइए उनकी मूल वास्तुकला और प्रमुख घटकों की जाँच करें।
MatMul को टर्नरी ऑपरेशनों से बदलना
पारंपरिक न्यूरल नेटवर्क में, डेंस लेयर्स (जो दो क्रमिक लेयर्स के सभी न्यूरॉनों को जोड़ती हैं) इनपुट डेटा को रूपांतरित करने के लिए MatMul पर निर्भर होती हैं। लेखक इन्हें BitLinear लेयर्स से बदलते हैं, जो टर्नरी वेट्स का उपयोग करती हैं। वेट्स किसी भी वास्तविक संख्या के बजाय केवल तीन मान ले सकते हैं: -1, 0, या 1।
वेट्स प्रारंभ में पूर्ण-परिशुद्धता मानों के रूप में प्रशिक्षित किए जाते हैं, और फिर प्रशिक्षण के दौरान उन्हें "absmean quantization" नामक प्रक्रिया का उपयोग करके टर्नरी मानों में क्वांटाइज़ किया जाता है। इस प्रक्रिया में वेट मैट्रिक्स को उसके औसत परिमाण मान से स्केल किया जाता है और फिर प्रत्येक तत्व को निकटतम टर्नरी पूर्णांक (-1, 0, या 1) पर राउंड किया जाता है।
यह सरलीकरण उन्हें MatMul में गुणाओं को जोड़ और घटाव से बदलने की अनुमति देता है। उदाहरण के लिए, किसी संख्या को -1 से गुणा करना उसे नेगेट करने के बराबर है, 0 से गुणा करने पर 0 मिलता है, और 1 से गुणा करने पर संख्या अपरिवर्तित रहती है।
मुख्य घटक: MLGRU और GLU
नीचे दिया गया चित्र MatMul-रहित भाषा मॉडल के प्रमुख घटकों का अवलोकन प्रस्तुत करता है, जिनमें MatMul-रहित Linear Gated Recurrent Unit (MLGRU) और MatMul-रहित Gated Linear Unit (GLU) शामिल हैं:
स्रोत: Rui-Jie Zhu व अन्य
चित्र को कई वर्गों में बाँटा गया है (ऊपर बाएँ से नीचे दाएँ):
MLGRU इनपुट सीक्वेंस को एक समय में एक टोकन प्रोसेस करके काम करता है। प्रत्येक चरण में, यह वर्तमान टोकन के एम्बेडिंग और पिछले हिडन स्टेट को इनपुट के रूप में लेता है। हिडन स्टेट मेमोरी की तरह कार्य करता है, जो पिछले टोकनों की जानकारी संग्रहीत करता है। इसके बाद MLGRU एलिमेंट-वाइज़ ऑपरेशनों और गेटिंग मैकेनिज्म की एक शृंखला का उपयोग करके इस हिडन स्टेट को अपडेट करता है। ये गेट्स, मूल रूप से 0 और 1 के बीच संख्याओं के वेक्टर, सूचना के प्रवाह को नियंत्रित करते हैं, यह तय करके कि पिछले हिडन स्टेट और वर्तमान टोकन के एम्बेडिंग के कौन से हिस्से अगले चरण के लिए सबसे अधिक प्रासंगिक हैं। यह प्रक्रिया तब तक चलती रहती है जब तक पूरी सीक्वेंस प्रोसेस नहीं हो जाती।
MatMul-रहित गेटेड लीनियर यूनिट (GLU) MatMul-रहित भाषा मॉडल का एक और प्रमुख घटक है। यह शब्दों के मॉडल के आंतरिक निरूपण (एम्बेडिंग्स) के विभिन्न आयामों में जानकारी का मिश्रण करता है। सरल शब्दों में, यह मॉडल को प्रत्येक शब्द के विभिन्न पक्षों या विशेषताओं को समझने में मदद करता है।
GLU, विभिन्न एम्बेडिंग चैनलों के बीच सूचना के प्रवाह को नियंत्रित करने के लिए गेटिंग मैकेनिज्म का उपयोग करता है। यह गेटिंग मैकेनिज्म MLGRU के गेट्स के समान है, लेकिन यह टोकन आयाम के बजाय चैनल आयाम पर कार्य करता है।
MatMul-रहित GLU मानक GLU का एक परिवर्तित संस्करण है, जिसे BitLinear लेयर्स का उपयोग करके मैट्रिक्स गुणाओं को समाप्त करने हेतु अनुकूलित किया गया है। BitLinear लेयर्स ऐसी डेंस लेयर्स हैं जो टर्नरी वेट्स (केवल -1, 0, या 1) अपनाती हैं। MatMul-रहित GLU में, इनपुट को पहले दो अलग-अलग BitLinear लेयर्स से रूपांतरित किया जाता है। एक लेयर के आउटपुट को SiLU एक्टिवेशन फंक्शन से गुजारा जाता है और फिर उसे दूसरी लेयर के आउटपुट के साथ एलिमेंट-वाइज़ गुणा किया जाता है। इस गेटेड आउटपुट को फिर अंतिम आउटपुट उत्पन्न करने के लिए एक और BitLinear लेयर से पास किया जाता है।
यह MLGRU और GLU घटकों का केवल एक उच्च-स्तरीय स्पष्टीकरण है। मैं आपको उनके आंतरिक कार्यप्रणाली और गणितीय सूत्रीकरण की अधिक विस्तृत समझ के लिए मूल शोध-पत्र देखने के लिए प्रोत्साहित करता हूँ।
MatMul-रहित बनाम ट्रांसफॉर्मर्स
अनुसंधान MatMul-रहित मॉडलों के स्केलिंग नियमों की जाँच करता है, और मॉडल के आकार बढ़ने के साथ उनकी प्रदर्शन क्षमता की तुलना पारंपरिक ट्रांसफॉर्मर आर्किटेक्चर से करता है।
प्रदर्शन और स्केलेबिलिटी
चौंकाने वाली बात यह सामने आई कि जैसे-जैसे मॉडल का आकार बढ़ता है, इन दोनों दृष्टिकोणों के बीच प्रदर्शन-अंतर घटता जाता है। यह एक महत्वपूर्ण अवलोकन है क्योंकि यह संकेत देता है कि बड़े पैमाने पर स्केलिंग के साथ MatMul-रहित मॉडल पारंपरिक ट्रांसफॉर्मर्स के साथ तेजी से प्रतिस्पर्धी होते जाते हैं, और बहुत बड़े स्केल पर संभवतः उनसे बेहतर कर सकते हैं।
स्रोत: Rui-Jie Zhu व अन्य
स्केलिंग लॉ तुलना वाला यह ग्राफ दिखाता है कि जैसे-जैसे फ्लोटिंग-पॉइंट ऑपरेशनों (FLOPs) की संख्या बढ़ती है, MatMul-रहित LMs और पारंपरिक ट्रांसफॉर्मर्स की लॉस वक्रें एक-दूसरे के करीब आती जाती हैं।
शुरुआत में, टर्नरी वेट्स की सीमाओं के कारण MatMul-रहित LMs में लॉस अधिक होता है। हालाँकि, जैसे-जैसे मॉडल का आकार बढ़ता है, यह अंतर कम होता जाता है, और एक बिंदु (सितारा) पर लॉस वक्रें एक-दूसरे को काटती हैं, जो तुलनीय प्रदर्शन का संकेत देती हैं। यह MatMul-रहित मॉडलों के लिए अधिक तीव्र स्केलिंग लॉ का संकेत देता है, अर्थात् पारंपरिक ट्रांसफॉर्मर्स की तुलना में आकार बढ़ने के साथ उनका प्रदर्शन अधिक तेज़ी से सुधरता है।
बेंचमार्क परिणाम
विभिन्न ज़ीरो-शॉट लर्निंग बेंचमार्क्स पर मजबूत प्रदर्शन के कारण MatMul-रहित LMs की प्रतिस्पर्धी क्षमता और सुदृढ़ होती है। ARC-Easy, ARC-Challenge, Hellaswag, Winogrande, PIQA, और OpenbookQA जैसे कार्यों में, ये मॉडल अक्सर पारंपरिक ट्रांसफॉर्मर्स के बराबर या उनसे बेहतर प्रदर्शन करते हैं, जबकि उनकी संगणकीय जटिलता काफी कम होती है। यह MatMul-रहित LMs में अपनाए गए वैकल्पिक ऑपरेशनों और आर्किटेक्चरल विकल्पों की प्रभावशीलता का प्रमाण है।
स्रोत: Rui-Jie Zhu व अन्य
ज़ीरो-शॉट एक्यूरेसी वाली यह तालिका दिखाती है कि MatMul-रहित LMs विभिन्न कार्यों में प्रतिस्पर्धी प्रदर्शन करते हैं। उदाहरण के लिए, ARC-Challenge—जो विशेष रूप से कठिन बेंचमार्क है—में 2.7B पैरामीटर वाला MatMul-रहित LM एक पारंपरिक ट्रांसफॉर्मर मॉडल से अधिक सटीकता प्राप्त करता है।
इसी तरह, Winogrande और OpenbookQA कार्यों पर भी MatMul-रहित LMs मजबूत प्रदर्शन दिखाते हैं, जो दर्शाता है कि MatMul को हटाने से मॉडल की भाषा को समझने और उत्पन्न करने की क्षमता से समझौता नहीं होता।
मेमोरी दक्षता
MatMul-रहित LMs का सबसे आकर्षक लाभ उनकी असाधारण मेमोरी दक्षता है। टर्नरी वेट्स द्वारा सक्षम सरल जोड़-घटाव का उपयोग करके ये मॉडल मेमोरी उपयोग में पर्याप्त कमी हासिल करते हैं।
प्रशिक्षण के दौरान, एक अनुकूलित GPU इम्प्लीमेंटेशन, बिना अनुकूलित मॉडलों की तुलना में, मेमोरी खपत को 61% तक घटा सकता है। इन्फरेंस में, मेमोरी की बचत और भी अधिक नाटकीय होती है, दस गुना से अधिक की कमी के साथ। यह MatMul-रहित LMs को स्मार्टफोन्स जैसे संसाधन-सीमित उपकरणों पर परिनियोजन के लिए विशेष रूप से आकर्षक बनाता है, जहाँ मेमोरी अक्सर एक सीमित कारक होती है।
स्रोत: Rui-Jie Zhu व अन्य
GPU मेमोरी और लेटेंसी तुलना वाला यह ग्राफ MatMul-रहित LMs की दक्षता में हुए लाभों को दर्शाता है। 2.7B पैरामीटर वाले MatMul-रहित LM की इन्फरेंस मेमोरी खपत, तुलनीय पारंपरिक ट्रांसफॉर्मर की तुलना में, उल्लेखनीय रूप से कम है। यह कम मेमोरी फ़ुटप्रिंट न केवल सीमित हार्डवेयर पर बड़े मॉडलों के परिनियोजन की अनुमति देता है, बल्कि कम लेटेंसी में भी तब्दील होता है, जिससे ये मॉडल वास्तविक-समय के अनुप्रयोगों के लिए अधिक उपयुक्त बनते हैं, जहाँ प्रतिसादशीलता महत्वपूर्ण होती है।
ऑप्टिमाइज़्ड GPUs से कस्टम FPGA डिज़ाइन तक
पेपर में प्रस्तुत प्रमुख प्रगतियों में से एक MatMul-रहित LMs का ऑप्टिमाइज़्ड GPU इम्प्लीमेंटेशन है। लेखकों ने अपनी स्वयं की GPU इम्प्लीमेंटेशन में फ्यूज़्ड कर्नलों का उपयोग करके प्रशिक्षण गति में 25.6% की वृद्धि और मेमोरी उपयोग में 61.0% तक की कमी हासिल की। ये कर्नल्स कई ऑपरेशनों को एक एकल, अधिक कुशल प्रक्रिया में संयोजित करते हैं, जिससे मेमोरी एक्सेस और डेटा मूवमेंट से जुड़ा ओवरहेड कम होता है।
MatMul-रहित LMs के हल्के ऑपरेशनों का और अधिक लाभ उठाने के लिए, लेखकों ने SystemVerilog में एक कस्टम FPGA एक्सेलरेटर विकसित किया। FPGA (Field-Programmable Gate Arrays) विशेष संगणकीय कार्यों को लागू करने के लिए एक लचीला और कुशल हार्डवेयर प्लेटफॉर्म प्रदान करते हैं।
कस्टम एक्सेलरेटर को टर्नरी ऑपरेशनों और एलिमेंट-वाइज़ प्रोडक्ट्स की सरलता का लाभ उठाने के लिए डिज़ाइन किया गया, जिससे पर्याप्त दक्षता लाभ प्राप्त हुए। RTL (Register Transfer Level) इम्प्लीमेंटेशन FPGA डिज़ाइन प्रक्रिया में महत्वपूर्ण है। इसमें हार्डवेयर के व्यवहार को उच्च स्तर पर निर्दिष्ट करना शामिल होता है, जिसे बाद में वास्तविक FPGA कॉन्फ़िगरेशन में संश्लेषित किया जाता है। MatMul-रहित LMs के लिए कस्टम RTL डिज़ाइन यह सुनिश्चित करता है कि FPGA हल्के ऑपरेशनों को कुशलतापूर्वक संभाल सके, जिससे ऊर्जा खपत कम होती है और थ्रूपुट बढ़ता है।
स्रोत: Rui-Jie Zhu व अन्य
चित्र कस्टम FPGA एक्सेलरेटर की RTL इम्प्लीमेंटेशन को दर्शाता है। आप Register Router के दाईं ओर वे फ़ंक्शन्स देख सकते हैं जिन्हें यह लागू करता है। लेखकों ने अपना स्वयं का असेंबलर भी विकसित किया जो कस्टम इंस्ट्रक्शनों के साथ असेंबली फ़ाइलों को इंस्ट्रक्शन ROM में कन्वर्ट करता है, जिसे आप चित्र के दाईं ओर देख सकते हैं। इंस्ट्रक्शन्स Register Router को दिए जाते हैं जो मेमोरी (Register File) का प्रबंधन करता है और इंस्ट्रक्शन्स को निष्पादित करता है।
इसके अलावा, लेखकों ने एक GitHub इश्यू पर टिप्पणी में उल्लेख किया कि उनके FPGA इम्प्लीमेंटेशन की पूर्ण विशिष्टताएँ अभी भी ऑप्टिमाइज़ की जा रही हैं, और SystemVerilog कोड बाद में सार्वजनिक किया जाएगा।
नीचे दी गई तालिका MatMul-रहित टोकन जनरेशन की FPGA इम्प्लीमेंटेशन के लिए संसाधन-उपयोग और प्रदर्शन मीट्रिक्स दिखाती है।
स्रोत: Rui-Jie Zhu व अन्य
डाटा से पता चलता है कि जैसे-जैसे FPGA के भीतर कोरों (प्रोसेसिंग यूनिट्स) की संख्या बढ़ती है, समग्र लेटेंसी प्रारंभ में अपेक्षाकृत स्थिर रहती है। हालाँकि, 16 से 26 कोर तक लेटेंसी में उल्लेखनीय वृद्धि होती है, जो यह सुझाती है कि DDR4 इंटरफ़ेस—जो डेटा ट्रांसफ़र के लिए ज़िम्मेदार है—कोरों की संख्या के साथ डेटा ट्रांसफ़र की माँग बढ़ने पर एक बाधा बन रहा है।
फिलहाल, कुल लेटेंसी में टर्नरी मैट्रिक्स गुणा ऑपरेशन का प्रभुत्व है, लेकिन लेखक अनुमान लगाते हैं कि भविष्य के इम्प्लीमेंटेशनों में इस यूनिट का ऑप्टिमाइज़ेशन करने पर बाधा DDR4 इंटरफ़ेस पर शिफ्ट हो जाएगी।
पेपर के सबसे रोचक दावों में से एक यह है कि MatMul-रहित दृष्टिकोण गणना और ऊर्जा खपत के मामले में LLMs को मस्तिष्क जैसी दक्षता के करीब लाता है। लेखक तर्क देते हैं कि उनके मॉडल जैविक न्यूरल नेटवर्क्स की दक्षता की नकल करते हैं और मानव-समान पढ़ने की गति प्राप्त करते हैं।
हालाँकि, इन मॉडलों की दक्षता की तुलना जैविक न्यूरल नेटवर्क्स के जटिल कार्यप्रणाली से सीधे करना एक जटिल मुद्दा है, जिसके लिए और जाँच की आवश्यकता है। मस्तिष्क के संगणकीय तंत्र MatMul-रहित LMs में प्रयुक्त सरलीकृत ऑपरेशनों की तुलना में बहुत भिन्न और अधिक जटिल हैं।
MatMul-रहित: निहितार्थ और भविष्य की दिशाएँ
"Scalable MatMul-free Language Modeling" पेपर प्राकृतिक भाषा प्रसंस्करण में एक बुनियादी धारणा को चुनौती देता है: कि उच्च-प्रदर्शन LLMs बनाने के लिए मैट्रिक्स गुणा (MatMul) आवश्यक है।
MatMul-रहित आर्किटेक्चर की व्यवहारिकता प्रदर्शित करके, यह शोध LLM डिज़ाइन में एक नया क्षितिज खोलता है, जो वैकल्पिक ऑपरेशनों और संगणकीय प्रतिमानों की खोज को प्रोत्साहित करता है। इससे नवाचार की एक नई लहर आ सकती है, जहाँ शोधकर्ता नए मॉडल आर्किटेक्चर विकसित करें।
हल्के मॉडलों के लिए हार्डवेयर त्वरण
MatMul-रहित मॉडलों की ओर यह बदलाव केवल सॉफ्टवेयर की बात नहीं है—यह हार्डवेयर की भी बात है। GPU जैसे पारंपरिक चिप्स मैट्रिक्स गुणा में बेहतरीन हैं, लेकिन ये नए, हल्के मॉडलों के लिए जरूरी नहीं कि सबसे उपयुक्त हों।
शोधकर्ताओं द्वारा बनाया गया कस्टम FPGA एक्सेलरेटर AI हार्डवेयर के भविष्य की एक झलक है—विशेषीकृत चिप्स जो इन कुशल मॉडलों से अधिकतम प्रदर्शन निकालने के लिए डिज़ाइन किए गए हैं। इससे AI-संचालित उपकरणों की एक नई पीढ़ी आ सकती है जो तेज़, अधिक ऊर्जा-कुशल और व्यापक दर्शकों के लिए सुलभ हो।
पर्यावरणीय प्रभाव और स्थिरता
एक ऐसे व्यक्ति के रूप में जो पर्यावरण की परवाह करता है, मैं विशेष रूप से इस संभावना को लेकर उत्साहित हूँ कि MatMul-रहित मॉडल AI के कार्बन फ़ुटप्रिंट को कम कर सकते हैं। आज के बड़े भाषा मॉडलों की भारी ऊर्जा खपत वास्तव में चिंता का विषय है। संगणकीय माँगों को उल्लेखनीय रूप से घटाकर, यह शोध अधिक ऊर्जा-कुशल AI तकनीकों का मार्ग प्रशस्त कर सकता है जिनका पर्यावरणीय पदचिह्न छोटा हो।
खुले शोध प्रश्न और भविष्य की दिशाएँ
"Scalable MatMul-free Language Modeling" पेपर एक बड़ा कदम आगे बढ़ाता है, लेकिन यह आगे के शोध के कई रास्ते भी खोलता है—विभिन्न MatMul-रहित आर्किटेक्चर का अन्वेषण, उनके प्रदर्शन का व्यापक कार्यों पर मूल्यांकन, और इस दृष्टिकोण की सैद्धांतिक सीमाओं को गणितीय रूप से समझना—ये कुछ रोमांचक शोध दिशाएँ हैं।
इसके अतिरिक्त, विशेष रूप से MatMul-रहित मॉडलों के लिए मानकीकृत बेंचमार्क्स और मूल्यांकन मीट्रिक्स विकसित करना निष्पक्ष तुलना को सुगम बनाएगा और इस क्षेत्र में प्रगति को तेज करेगा। सचमुच कुशल और सुलभ AI की यात्रा अभी शुरू हुई है, और संभावनाएँ असीम हैं। साथ ही, मैं व्यक्तिगत रूप से भविष्य के MatMul-रहित सहायक चैटबॉट्स को आज़माने के लिए बहुत उत्साहित हूँ!
निष्कर्ष
"Scalable MatMul-free Language Modeling" पेपर MatMul (मैट्रिक्स गुणा) ऑपरेशनों को समाप्त करने वाला एक नया दृष्टिकोण प्रस्तुत करके LLMs के क्षेत्र में एक महत्वपूर्ण योगदान देता है।
यह प्रगति पारंपरिक LLMs से जुड़ी संगणकीय और मेमोरी बाधाओं को संबोधित करती है, जिससे अधिक कुशल और स्केलेबल मॉडलों का मार्ग प्रशस्त होता है। योगात्मक ऑपरेशनों और टर्नरी वेट्स का लाभ उठाकर, लेखक दिखाते हैं कि संसाधन माँगों को उल्लेखनीय रूप से घटाते हुए प्रतिस्पर्धी प्रदर्शन बनाए रखना संभव है।
LLM के विकास और परिनियोजन के भविष्य पर इस शोध का संभावित प्रभाव गहरा है। MatMul-रहित मॉडल पारंपरिक आर्किटेक्चर का एक व्यावहारिक विकल्प प्रदान करते हैं, जो हल्के, कुशल मॉडलों के निर्माण को सक्षम बनाते हैं, जो एज डिवाइसों और मोबाइल प्लेटफॉर्म जैसे संसाधन-सीमित परिवेशों के लिए उपयुक्त हैं।
यदि आप कृत्रिम बुद्धिमत्ता के बारे में और सीखना चाहते हैं, तो ये AI कोर्स देखें।