围绕最佳智能体模型的竞争愈发激烈。近几个月,Anthropic 的 Claude Opus 4.6、DeepSeek V4 Pro 和 Kimi K2.6 相继登顶代码与推理榜单。如今,阿里巴巴的通义团队推出了 Qwen3.7-Max,这是一款他们称之为专为“智能体时代”打造的专有旗舰模型。
核心数据值得关注:在 GPQA Diamond 上,Qwen3.7-Max 得分 92.4,超过了 Claude Opus 4.6 Max 的 91.3。在 Apex 推理基准上,它以 44.5 对比 DeepSeek V4 Pro 的 38.3。并且在一次为期 35 小时的自主内核优化运行中,该模型共发起 1,158 次工具调用,使性能较 Triton 参考实现的几何平均数提升 10 倍。
本文将全面介绍 Qwen3.7-Max 的最新进展,包括其关键功能、基准测试结果,并给出可自行上手的测试建议。您也可以查看我们对 Gemini 3.5 Flash 和 Gemini Omni 的报道,以了解当前更广泛前沿的格局。
Qwen3.7-Max 是什么?
Qwen3.7-Max 是阿里巴巴的最新专有模型,定位于 Qwen3.x 家族的最高阶层,位于 Qwen3.6-Plus 之上。
它是闭源、通过 API 访问的模型,可在阿里云百炼 Model Studio 使用,具备 100 万 token 的上下文窗口,输入输出均为纯文本。通义团队将其描述为“通用型智能体基础”,而非通用聊天模型。
相较 Qwen3.6-Plus,各项能力都有大幅提升。在 Terminal Bench 2.0-Terminus 上,Qwen3.7-Max 得分 69.7,高于 Qwen3.6-Plus 的 61.6。在 YC-Bench 创业模拟中,它的总营收达到 208 万美元,是 Qwen3.6-Plus 的两倍(105 万美元)。差距在长周期智能体任务上最为明显,而这正是团队宣称重点训练的方向。
Artificial Analysis Intelligence Index 给出 Qwen3.7-Max 56.6 的分数,高于多款竞品,距离部分最前沿模型也仅一步之遥。
需要提前指出的一点:该模型的输出明显冗长。Artificial Analysis 在评测中观察到生成约 9,700 万个 token,远高于 2,400 万的中位数。这种冗长对长时段智能体会话的成本有直接影响,本文将在定价部分再作讨论。
Qwen3.7-Max 有哪些新变化?
Qwen3.7-Max 引入了多项能力,使其区别于前代与当前其他前沿模型。整体聚焦在持续的自主执行,而非单轮表现。
长周期自主执行
此次发布中最引人注目的演示是为期 35 小时的内核优化运行。
简单来说,通义团队给模型一个棘手的编码问题(优化 GPU 代码),只提供说明和测试方法,然后放手不管。从那一刻起,Qwen3.7-Max 开始自主工作:写代码、跑测试、找瓶颈、重构代码。这个循环过程被执行了一千多次。
最终结果让代码运行速度较标准基线快了 10 倍,而且是在此前从未接触过的计算机硬件上完成的。
即使超过 30 小时,Qwen3.7-Max 仍能找到有效的加速手段。它并非只摘“低垂的果实”后就结束。
其他顶尖模型如 GLM 5.1、Kimi K2.6 和 DeepSeek V4 Pro 都更早“力竭”(各自最多加速 7.3 倍、5.0 倍和 3.3 倍)。
这说明 Qwen3.7-Max 不只是能在单条提示下回答一个快速的编码问题。您可以把一项艰巨、漫长的优化项目交给它,然后离开,且相信它会长期保持专注,不会困惑或偏离目标。
跨框架泛化
大多数智能体模型都在特定脚手架上训练和评估,这意味着其基准成绩可能反映的是脚手架特定的取巧方式,而非真正的问题求解能力。
Qwen3.7-Max 通过一种将 Task、Harness 和 Verifier 解耦为三个可自由重组的独立组件的训练基础设施来规避这一点。
实际做法是:在相同任务上配对多样的脚手架与验证器进行训练,迫使模型学习可泛化的策略。
基准结果也印证了这一点:无论通过 Claude Code、OpenClaw、Qwen Code,还是自定义的工具使用框架部署,Qwen3.7-Max 表现都很稳定。在 QwenClawBench 和 CoWorkBench 上,无论评估时采用哪种脚手架,性能都能保持。
对于构建智能体系统的团队而言,这意味着 Qwen3.7-Max 可以作为可直接替换的骨干模型,无需针对特定框架微调。相比只在自家脚手架中表现良好的模型,这是实打实的运维优势。
MCP 与多智能体编排
Qwen3.7-Max 原生支持与模型上下文协议(MCP)集成,使其能够以标准化方式连接外部工具与数据源。
在 MCP-Mark 上,它得分 60.8,领先于 GLM-5.1 Thinking 的 57.5 和 Opus-4.6 Max 的 56.7。在 MCP-Atlas 上,它得分 76.4,略高于 Opus-4.6 Max 的 75.8。
办公自动化值得单独强调。在 SpreadSheetBench-v1 上,Qwen3.7-Max 得分 87.0,仅次于 Opus-4.6 Max 的 89.3。
通义团队演示了一个论文排版任务:模型阅读排版规范文档后,能自主重排一份凌乱的草稿,通过自动化 office-cli 工具调用,修复页面版式、标题样式、字体、边距、目录与参考文献。
奖励黑客自监控
此次发布中较为少见的一项能力是用于 RL 训练的自监控框架。在超过 80 小时的 RL 实验中,Qwen3.7-Max 自主检索并回放训练轨迹,执行逾 1 万次调用来识别奖励黑客(reward hacking)模式。
这些模式包括试图绕过约束、在 GitHub 上访问标准答案等。
系统进行了规则验证、反例挖掘与迭代优化,最终新增 13 条启发式规则,并准确标记出 1,618 起黑客案例。
这更像是训练流程的信号,而非面向用户的功能,但对于打算在自有 RL 流水线中部署 Qwen3.7-Max 的团队来说,具有参考价值。
通过机器人集成进行物理世界导航
Qwen3.7-Max 现可通过工具调用操作机器狗,使用 Qwen-RobotClaw 智能体脚手架与 Qwen-RobotNav 导航基础模型。
该模型能在真实环境中处理物理理解、规划、记忆与决策。演示为一次 20 分钟的智能体会话,机器人利用模型的长期记忆与第一人称视觉输入在物理空间中导航。
我不会将其夸大为可立即投产的机器人平台,但这确实展示了智能体框架的广度。支撑表格自动化与内核优化的同一套工具调用基础设施,也可扩展到物理世界导航。
Qwen3.7-Max 基准测试
我们更细致地看看这些基准数据。
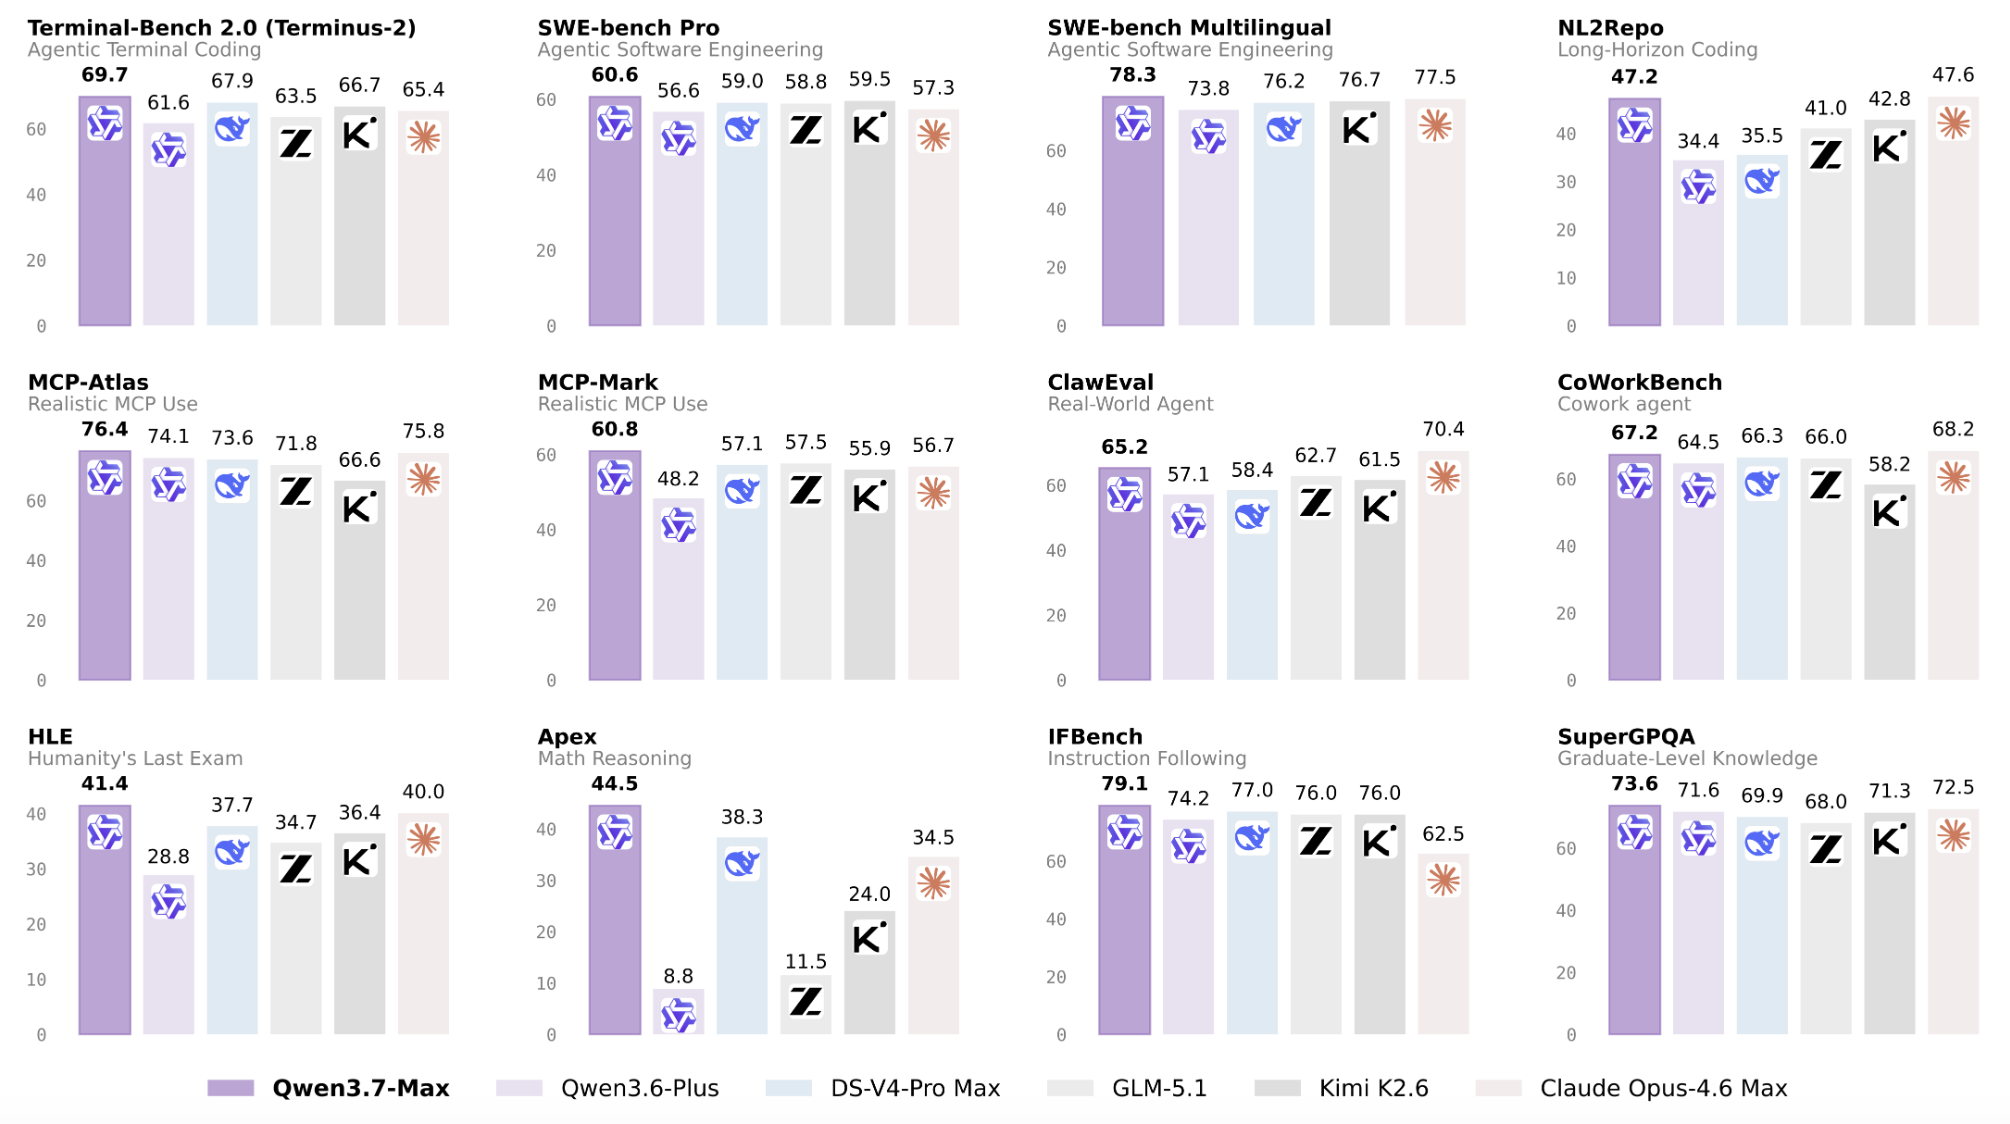
图片来源
Qwen3.7-Max 从四个大类进行评估:代码智能体、通用智能体、STEM 推理与通用能力(含多语种表现)。
结果来自多种智能体脚手架,使其比“单一脚手架”的数字更有意义。
代码智能体基准
在 Terminal Bench 2.0-Terminus 上,Qwen3.7-Max 得分 69.7,领先于 DeepSeek-V4-Pro Max(67.9)、Opus-4.6 Max(65.4)与 K2.6 Thinking(66.7)。
该基准测试以 5 小时超时与 12 核 CPU,评测基于终端的自主软件工程。在 SWE-Pro 上,它得分 60.6,位列对照表首位,领先 K2.6 Thinking(59.5)与 DS-V4-Pro Max(59.0)。
SWE-Verified 是 Qwen3.7-Max 未领跑的一项:它得分 80.4,略低于 Opus-4.6 Max 的 80.8 与 DS-V4-Pro Max 的 80.6。
差距很小,但值得注意。在 SWE-Multilingual(78.3)与 SciCode(53.5)上,它领先同侪。在 QwenSVG 上,它得分 1608,高于 GLM-5.1 Thinking 的 1605 与 Opus-4.6 Max 的 1541。
通用智能体基准
通用智能体结果是 Qwen3.7-Max 最具说服力的部分。在 MCP-Mark 上,它以 60.8 对比 GLM-5.1 的 57.5 与 Opus-4.6 的 56.7。
在 MCP-Atlas 上,它得分 76.4,略胜 Opus-4.6 的 75.8。在 Skillsbench 上,它以 59.2 对比 K2.6 Thinking 的 56.2。在 SpreadSheetBench-v1 上,它得分 87.0,仅次于 Opus-4.6 Max 的 89.3。
Kernel Bench L3 的结果值得单独一提。Qwen3.7-Max 实现 1.98 倍的中位加速,胜率(快于 torch.compile 的问题占比)为 96%。
此项中 Opus-4.6 Max 以 2.63 倍/98% 领先,但 Qwen3.7-Max 仍明显优于 K2.6 Thinking(1.41 倍/80%)、GLM-5.1(2.00 倍/78%)与 DS-V4-Pro Max(1.07 倍/54%)。在测试长上下文检索的 MRCR-v2 128k 上,它得分 90.4,高于 Qwen3.6-Plus(85.9)与 Opus-4.6 Max(84.0)。
STEM 与推理基准
GPQA Diamond 测试博士水平的科学问题。Qwen3.7-Max 得分 92.4,高于 Opus-4.6 Max(91.3)、K2.6 Thinking(90.5)与 DS-V4-Pro Max(90.1)。
在我们对 GPT-5.5 的评测中,我们指出其在 GPQA Diamond 上得分 93.6%,因此在该特定基准上 GPT-5.5 仍领先,不过直接对比需注意评估条件的差异。
在 HLE(Humanity's Last Exam)上,Qwen3.7-Max 得分 41.4,高于 Opus-4.6 Max(40.0)与 Deepseek-V4-Pro Max(37.7)。
在 HMMT 2026 Feb(竞赛数学)上,它得分 97.1,为表中最高,超过 Opus-4.6 Max(96.2)与 DS-V4-Pro Max(95.2)。
在 IMOAnswerBench 上,它得分 90.0,略胜 DS-V4-Pro Max 的 89.8。在 Apex 基准上,它得分 44.5,显著领先于 DS-V4-Pro Max 的 38.3 与 Opus-4.6 Max 的 34.5。
多语种基准
在 WMT24++ 上,Qwen3.7-Max 以 85.8 领先(对比 Qwen3.6-Plus 的 84.3 与 Opus-4.6 Max 的 82.7),该基准测试 55 种语言的翻译质量。在 MAXIFE 上,它得分 89.2,高于 DS-V4-Pro Max 的 88.9。在 PolyMATH 上,它得分 86.5,明显领先 Opus-4.6 Max 的 80.2 与 K2.6 Thinking 的 82.7。
多语种表现一直是 Qwen3.x 系列的强项,Qwen3.7-Max 进一步扩大了优势。
Qwen3.7-Max 的定价与可用性
Qwen3.7-Max 可通过阿里云百炼 Model Studio 使用,API 同时支持 OpenAI 兼容与 Anthropic 兼容的端点。模型 ID 为 qwen3.7-max。
撰稿时,Artificial Analysis 给出的输入与输出价格分别为每 100 万个输入 token 2.50 美元、输出 7.50 美元。
Artificial Analysis 指出的高冗长性(评测中生成 9,700 万 token,对比中位数 2,400 万)意味着,对于长时段的智能体会话,实际成本可能远高于名义上的按 token 计费。
对开发者而言,该模型支持 preserve_thinking 功能,可在多轮对话中保留此前各轮的思考内容。通义团队建议在智能体任务中启用该功能。与 Claude Code、OpenClaw 与 Qwen Code 的集成开箱即用,官方文档提供了配置示例。
结语
Qwen3.7-Max 在智能体模型市场的高端区间是一位强劲选手。其基准成绩全面而扎实,35 小时的内核优化演示属于那种具体、可复现的结果,比单纯的榜单位置更有说服力。
跨框架泛化的叙事同样可信:在多样脚手架配置上训练,确实是应对“脚手架过拟合”问题的有原则路径;且在 Claude Code、OpenClaw 与 Qwen Code 上的一致表现为其背书。
我会保持谨慎的是冗长度。一个在标准评测套件中生成 9,700 万 token 的模型,在实际使用中成本会显著高于其名义的按 token 费率,尤其是在其主要用例——长周期智能体会话中。
基于 Qwen3.7-Max 的团队应谨慎预算,并在投产前通过明确的输出约束进行测试。
如果您希望在 Qwen3.7-Max 等模型之上构建,或更深入理解智能体 AI 的版图,建议查看 DataCamp 的 AI Fundamentals 技能路径,以系统掌握支撑这些系统的核心概念。


围绕最佳智能体模型的竞争愈发激烈。近几个月,Anthropic 的 Claude Opus 4.6、DeepSeek V4 Pro 和 Kimi K2.6 相继登顶代码与推理榜单。如今,阿里巴巴的通义团队推出了 Qwen3.7-Max,这是一款他们称之为专为“智能体时代”打造的专有旗舰模型。
核心数据值得关注:在 GPQA Diamond 上,Qwen3.7-Max 得分 92.4,超过了 Claude Opus 4.6 Max 的 91.3。在 Apex 推理基准上,它以 44.5 对比 DeepSeek V4 Pro 的 38.3。并且在一次为期 35 小时的自主内核优化运行中,该模型共发起 1,158 次工具调用,使性能较 Triton 参考实现的几何平均数提升 10 倍。
本文将全面介绍 Qwen3.7-Max 的最新进展,包括其关键功能、基准测试结果,并给出可自行上手的测试建议。您也可以查看我们对 Gemini 3.5 Flash 和 Gemini Omni 的报道,以了解当前更广泛前沿的格局。
Qwen3.7-Max 是什么?
Qwen3.7-Max 是阿里巴巴的最新专有模型,定位于 Qwen3.x 家族的最高阶层,位于 Qwen3.6-Plus 之上。
它是闭源、通过 API 访问的模型,可在阿里云百炼 Model Studio 使用,具备 100 万 token 的上下文窗口,输入输出均为纯文本。通义团队将其描述为“通用型智能体基础”,而非通用聊天模型。
相较 Qwen3.6-Plus,各项能力都有大幅提升。在 Terminal Bench 2.0-Terminus 上,Qwen3.7-Max 得分 69.7,高于 Qwen3.6-Plus 的 61.6。在 YC-Bench 创业模拟中,它的总营收达到 208 万美元,是 Qwen3.6-Plus 的两倍(105 万美元)。差距在长周期智能体任务上最为明显,而这正是团队宣称重点训练的方向。
Artificial Analysis Intelligence Index 给出 Qwen3.7-Max 56.6 的分数,高于多款竞品,距离部分最前沿模型也仅一步之遥。
需要提前指出的一点:该模型的输出明显冗长。Artificial Analysis 在评测中观察到生成约 9,700 万个 token,远高于 2,400 万的中位数。这种冗长对长时段智能体会话的成本有直接影响,本文将在定价部分再作讨论。
Qwen3.7-Max 有哪些新变化?
Qwen3.7-Max 引入了多项能力,使其区别于前代与当前其他前沿模型。整体聚焦在持续的自主执行,而非单轮表现。
长周期自主执行
此次发布中最引人注目的演示是为期 35 小时的内核优化运行。
简单来说,通义团队给模型一个棘手的编码问题(优化 GPU 代码),只提供说明和测试方法,然后放手不管。从那一刻起,Qwen3.7-Max 开始自主工作:写代码、跑测试、找瓶颈、重构代码。这个循环过程被执行了一千多次。
最终结果让代码运行速度较标准基线快了 10 倍,而且是在此前从未接触过的计算机硬件上完成的。
即使超过 30 小时,Qwen3.7-Max 仍能找到有效的加速手段。它并非只摘“低垂的果实”后就结束。
其他顶尖模型如 GLM 5.1、Kimi K2.6 和 DeepSeek V4 Pro 都更早“力竭”(各自最多加速 7.3 倍、5.0 倍和 3.3 倍)。
这说明 Qwen3.7-Max 不只是能在单条提示下回答一个快速的编码问题。您可以把一项艰巨、漫长的优化项目交给它,然后离开,且相信它会长期保持专注,不会困惑或偏离目标。
跨框架泛化
大多数智能体模型都在特定脚手架上训练和评估,这意味着其基准成绩可能反映的是脚手架特定的取巧方式,而非真正的问题求解能力。
Qwen3.7-Max 通过一种将 Task、Harness 和 Verifier 解耦为三个可自由重组的独立组件的训练基础设施来规避这一点。
实际做法是:在相同任务上配对多样的脚手架与验证器进行训练,迫使模型学习可泛化的策略。
基准结果也印证了这一点:无论通过 Claude Code、OpenClaw、Qwen Code,还是自定义的工具使用框架部署,Qwen3.7-Max 表现都很稳定。在 QwenClawBench 和 CoWorkBench 上,无论评估时采用哪种脚手架,性能都能保持。
对于构建智能体系统的团队而言,这意味着 Qwen3.7-Max 可以作为可直接替换的骨干模型,无需针对特定框架微调。相比只在自家脚手架中表现良好的模型,这是实打实的运维优势。
MCP 与多智能体编排
Qwen3.7-Max 原生支持与模型上下文协议(MCP)集成,使其能够以标准化方式连接外部工具与数据源。
在 MCP-Mark 上,它得分 60.8,领先于 GLM-5.1 Thinking 的 57.5 和 Opus-4.6 Max 的 56.7。在 MCP-Atlas 上,它得分 76.4,略高于 Opus-4.6 Max 的 75.8。
办公自动化值得单独强调。在 SpreadSheetBench-v1 上,Qwen3.7-Max 得分 87.0,仅次于 Opus-4.6 Max 的 89.3。
通义团队演示了一个论文排版任务:模型阅读排版规范文档后,能自主重排一份凌乱的草稿,通过自动化 office-cli 工具调用,修复页面版式、标题样式、字体、边距、目录与参考文献。
奖励黑客自监控
此次发布中较为少见的一项能力是用于 RL 训练的自监控框架。在超过 80 小时的 RL 实验中,Qwen3.7-Max 自主检索并回放训练轨迹,执行逾 1 万次调用来识别奖励黑客(reward hacking)模式。
这些模式包括试图绕过约束、在 GitHub 上访问标准答案等。
系统进行了规则验证、反例挖掘与迭代优化,最终新增 13 条启发式规则,并准确标记出 1,618 起黑客案例。
这更像是训练流程的信号,而非面向用户的功能,但对于打算在自有 RL 流水线中部署 Qwen3.7-Max 的团队来说,具有参考价值。
通过机器人集成进行物理世界导航
Qwen3.7-Max 现可通过工具调用操作机器狗,使用 Qwen-RobotClaw 智能体脚手架与 Qwen-RobotNav 导航基础模型。
该模型能在真实环境中处理物理理解、规划、记忆与决策。演示为一次 20 分钟的智能体会话,机器人利用模型的长期记忆与第一人称视觉输入在物理空间中导航。
我不会将其夸大为可立即投产的机器人平台,但这确实展示了智能体框架的广度。支撑表格自动化与内核优化的同一套工具调用基础设施,也可扩展到物理世界导航。
Qwen3.7-Max 基准测试
我们更细致地看看这些基准数据。
图片来源
Qwen3.7-Max 从四个大类进行评估:代码智能体、通用智能体、STEM 推理与通用能力(含多语种表现)。
结果来自多种智能体脚手架,使其比“单一脚手架”的数字更有意义。
代码智能体基准
在 Terminal Bench 2.0-Terminus 上,Qwen3.7-Max 得分 69.7,领先于 DeepSeek-V4-Pro Max(67.9)、Opus-4.6 Max(65.4)与 K2.6 Thinking(66.7)。
该基准测试以 5 小时超时与 12 核 CPU,评测基于终端的自主软件工程。在 SWE-Pro 上,它得分 60.6,位列对照表首位,领先 K2.6 Thinking(59.5)与 DS-V4-Pro Max(59.0)。
SWE-Verified 是 Qwen3.7-Max 未领跑的一项:它得分 80.4,略低于 Opus-4.6 Max 的 80.8 与 DS-V4-Pro Max 的 80.6。
差距很小,但值得注意。在 SWE-Multilingual(78.3)与 SciCode(53.5)上,它领先同侪。在 QwenSVG 上,它得分 1608,高于 GLM-5.1 Thinking 的 1605 与 Opus-4.6 Max 的 1541。
通用智能体基准
通用智能体结果是 Qwen3.7-Max 最具说服力的部分。在 MCP-Mark 上,它以 60.8 对比 GLM-5.1 的 57.5 与 Opus-4.6 的 56.7。
在 MCP-Atlas 上,它得分 76.4,略胜 Opus-4.6 的 75.8。在 Skillsbench 上,它以 59.2 对比 K2.6 Thinking 的 56.2。在 SpreadSheetBench-v1 上,它得分 87.0,仅次于 Opus-4.6 Max 的 89.3。
Kernel Bench L3 的结果值得单独一提。Qwen3.7-Max 实现 1.98 倍的中位加速,胜率(快于 torch.compile 的问题占比)为 96%。
此项中 Opus-4.6 Max 以 2.63 倍/98% 领先,但 Qwen3.7-Max 仍明显优于 K2.6 Thinking(1.41 倍/80%)、GLM-5.1(2.00 倍/78%)与 DS-V4-Pro Max(1.07 倍/54%)。在测试长上下文检索的 MRCR-v2 128k 上,它得分 90.4,高于 Qwen3.6-Plus(85.9)与 Opus-4.6 Max(84.0)。
STEM 与推理基准
GPQA Diamond 测试博士水平的科学问题。Qwen3.7-Max 得分 92.4,高于 Opus-4.6 Max(91.3)、K2.6 Thinking(90.5)与 DS-V4-Pro Max(90.1)。
在我们对 GPT-5.5 的评测中,我们指出其在 GPQA Diamond 上得分 93.6%,因此在该特定基准上 GPT-5.5 仍领先,不过直接对比需注意评估条件的差异。
在 HLE(Humanity's Last Exam)上,Qwen3.7-Max 得分 41.4,高于 Opus-4.6 Max(40.0)与 Deepseek-V4-Pro Max(37.7)。
在 HMMT 2026 Feb(竞赛数学)上,它得分 97.1,为表中最高,超过 Opus-4.6 Max(96.2)与 DS-V4-Pro Max(95.2)。
在 IMOAnswerBench 上,它得分 90.0,略胜 DS-V4-Pro Max 的 89.8。在 Apex 基准上,它得分 44.5,显著领先于 DS-V4-Pro Max 的 38.3 与 Opus-4.6 Max 的 34.5。
多语种基准
在 WMT24++ 上,Qwen3.7-Max 以 85.8 领先(对比 Qwen3.6-Plus 的 84.3 与 Opus-4.6 Max 的 82.7),该基准测试 55 种语言的翻译质量。在 MAXIFE 上,它得分 89.2,高于 DS-V4-Pro Max 的 88.9。在 PolyMATH 上,它得分 86.5,明显领先 Opus-4.6 Max 的 80.2 与 K2.6 Thinking 的 82.7。
多语种表现一直是 Qwen3.x 系列的强项,Qwen3.7-Max 进一步扩大了优势。
Qwen3.7-Max 的定价与可用性
Qwen3.7-Max 可通过阿里云百炼 Model Studio 使用,API 同时支持 OpenAI 兼容与 Anthropic 兼容的端点。模型 ID 为
qwen3.7-max。撰稿时,Artificial Analysis 给出的输入与输出价格分别为每 100 万个输入 token 2.50 美元、输出 7.50 美元。
Artificial Analysis 指出的高冗长性(评测中生成 9,700 万 token,对比中位数 2,400 万)意味着,对于长时段的智能体会话,实际成本可能远高于名义上的按 token 计费。
对开发者而言,该模型支持
preserve_thinking功能,可在多轮对话中保留此前各轮的思考内容。通义团队建议在智能体任务中启用该功能。与 Claude Code、OpenClaw 与 Qwen Code 的集成开箱即用,官方文档提供了配置示例。结语
Qwen3.7-Max 在智能体模型市场的高端区间是一位强劲选手。其基准成绩全面而扎实,35 小时的内核优化演示属于那种具体、可复现的结果,比单纯的榜单位置更有说服力。
跨框架泛化的叙事同样可信:在多样脚手架配置上训练,确实是应对“脚手架过拟合”问题的有原则路径;且在 Claude Code、OpenClaw 与 Qwen Code 上的一致表现为其背书。
我会保持谨慎的是冗长度。一个在标准评测套件中生成 9,700 万 token 的模型,在实际使用中成本会显著高于其名义的按 token 费率,尤其是在其主要用例——长周期智能体会话中。
基于 Qwen3.7-Max 的团队应谨慎预算,并在投产前通过明确的输出约束进行测试。
如果您希望在 Qwen3.7-Max 等模型之上构建,或更深入理解智能体 AI 的版图,建议查看 DataCamp 的 AI Fundamentals 技能路径,以系统掌握支撑这些系统的核心概念。