
लर्निंग पाथ
एआई एजेंट मूलभूत बातें
6 घंटा
सबसे बेहतरीन एजेंटिक AI मॉडल की दौड़ तेज़ हो रही है। हाल के महीनों में Anthropic का Claude Opus 4.6, DeepSeek V4 Pro, और Kimi K2.6—इन सभी ने कोडिंग और रीजनिंग लीडरबोर्ड्स पर शीर्ष दावेदारी पेश की है। अब Alibaba की Qwen टीम Qwen3.7-Max के साथ आई है—एक मालिकाना फ्लैगशिप मॉडल, जिसे वे खास तौर पर एजेंट युग के लिए बना हुआ बताते हैं।
हेडलाइन नंबर ध्यान देने योग्य हैं। GPQA Diamond पर Qwen3.7-Max ने 92.4 स्कोर किया, जो Claude Opus 4.6 Max के 91.3 से आगे है। Apex रीजनिंग बेंचमार्क पर इसका स्कोर 44.5 है, जबकि DeepSeek V4 Pro का 38.3 है। और 35 घंटे की स्वायत्त kernel optimization रन में, मॉडल ने 1,158 टूल कॉल किए और Triton रेफरेंस इम्प्लीमेंटेशन के मुकाबले 10x ज्योमेट्रिक मीन स्पीडअप हासिल किया।
इस लेख में, मैं Qwen3.7-Max से जुड़ी हर नई चीज़ कवर करूंगा—इसके प्रमुख फीचर्स, बेंचमार्क नतीजों का विश्लेषण, और कुछ हैंड्स-ऑन टेस्ट्स जो आप स्वयं चला सकते हैं। आप हमारे Gemini 3.5 Flash और Gemini Omni कवरेज भी देख सकते हैं, ताकि अभी व्यापक फ्रंटियर कहां खड़ा है, उसका संदर्भ मिले।
Qwen3.7-Max Alibaba का नवीनतम मालिकाना मॉडल है, जिसे Qwen3.x परिवार में Qwen3.6-Plus से ऊपर शीर्ष स्तर पर रखा गया है।
यह एक क्लोज्ड-सोर्स, API-सुलभ मॉडल है, जो Alibaba Cloud Model Studio के माध्यम से उपलब्ध है, 1 मिलियन टोकन कॉन्टेक्स्ट विंडो और केवल टेक्स्ट इनपुट-आउटपुट के साथ। Qwen टीम इसे सामान्य प्रयोजन चैट मॉडल के बजाय "बहुमुखी एजेंट फाउंडेशन" बताती है।
Qwen3.6-Plus की तुलना में, हर श्रेणी में सुधार उल्लेखनीय है। Terminal Bench 2.0-Terminus पर Qwen3.7-Max का स्कोर 69.7 है, जबकि Qwen3.6-Plus का 61.6। YC-Bench स्टार्टअप सिमुलेशन में, इसने कुल 2.08M USD राजस्व हासिल किया, जो Qwen3.6-Plus के 1.05M USD से दोगुना है। सबसे बड़ा अंतर लंबे-क्षितिज एजेंटिक कार्यों पर है—ठीक वही क्षेत्र, जिस पर टीम ने अपने प्रशिक्षण का फोकस बताया है।
Artificial Analysis Intelligence Index Qwen3.7-Max को 56.6 का स्कोर देता है, जो इसे प्रतिस्पर्धियों से ऊपर और कुछ सर्वश्रेष्ठ फ्रंटियर मॉडलों से ज़रा नीचे रखता है।
एक बात शुरू में ही ध्यान देने योग्य है: मॉडल उल्लेखनीय रूप से विस्तृत/वर्बोज़ है। Artificial Analysis ने अपने मूल्यांकन में लगभग 97 मिलियन जनरेटेड टोकन देखे—जो 24 मिलियन के मीडियन से कहीं ज़्यादा है। यह वर्बोसिटी लंबे एजेंटिक सेशंस की लागत पर असर डालती है—इस पर मैं प्राइसिंग सेक्शन में लौटूंगा।
Qwen3.7-Max कई ऐसी क्षमताएँ लाता है जो इसे अपने पूर्ववर्ती और मौजूदा फ्रंटियर मॉडलों से अलग करती हैं। पूरा फोकस एकल-टर्न प्रदर्शन के बजाय सतत, स्वायत्त निष्पादन पर है।
रिलीज़ में सबसे प्रभावशाली डेमो 35 घंटे की kernel optimization रन है।
असल में, Qwen टीम ने AI को एक कठिन कोडिंग समस्या (GPU कोड का अनुकूलन) दी—सिर्फ निर्देश और अपना काम जाँचने का तरीका—और फिर पीछे हट गई। वहां से, Qwen3.7-Max ने स्वायत्त रूप से काम किया—कोड लिखा, टेस्ट चलाए, बॉटलनेक्स ढूंढे, और कोड का पुनर्रचना किया। यह प्रक्रिया उसने हज़ार से अधिक बार दोहराई।
अंतिम नतीजा यह रहा कि कोड मानक बेसलाइन से 10 गुना तेज़ चलने लगा—वह भी ऐसे कंप्यूटर हार्डवेयर पर जिसे मॉडल ने पहले कभी नहीं देखा था।
Qwen3.7 Max 30 घंटे के बाद भी कोड को तेज़ करने के अर्थपूर्ण तरीके खोज रहा था। यानी उसने सिर्फ शुरुआती आसान सुधार पकड़कर काम बंद नहीं किया।
अन्य शीर्ष मॉडल जैसे GLM 5.1, Kimi K2.6, और DeepSeek V4 Pro काफ़ी पहले थम गए (क्रमशः अधिकतम 7.3x, 5.0x, और 3.3x तेज़ तक)।
यह दिखाता है कि Qwen3.7-Max सिर्फ़ एक त्वरित कोडिंग प्रश्न का एकल प्रॉम्प्ट में अच्छा जवाब देने तक सीमित नहीं है। आप इसे एक बड़ा, कठिन ऑप्टिमाइज़ेशन प्रोजेक्ट सौंपकर दूर जा सकते हैं, और भरोसा कर सकते हैं कि यह लंबे समय तक भ्रमित हुए बिना या दिशा खोए बिना पूरी तरह केंद्रित रहेगा।
ज्यादातर एजेंट मॉडलों का प्रशिक्षण और मूल्यांकन किसी एक विशेष स्कैफोल्ड पर होता है, जिसका मतलब है कि उनके बेंचमार्क नंबर हार्नेस-विशिष्ट शॉर्टकट्स को दर्शा सकते हैं, न कि वास्तविक समस्या-समाधान को।
Qwen3.7-Max इसे एक ऐसे प्रशिक्षण इन्फ्रास्ट्रक्चर से टालता है जो Task, Harness, और Verifier को तीन स्वतंत्र घटकों में डीकपल करता है, जिन्हें स्वतंत्र रूप से जोड़ा-मिलाया जा सकता है।
व्यवहार में, इसका मतलब है कि मॉडल को समान टास्क्स पर विविध हार्नेस और वेरिफायर्स के साथ प्रशिक्षित किया गया, जिससे उसे जनरलाइजेबल रणनीतियाँ सीखनी पड़ीं।
बेंचमार्क नतीजे इसे दर्शाते हैं: Claude Code, OpenClaw, Qwen Code, या कस्टम टूल-यूज़ फ्रेमवर्क—किसी के माध्यम से डिप्लॉय होने पर भी Qwen3.7-Max लगातार प्रदर्शन करता है। QwenClawBench और CoWorkBench पर, मूल्यांकन समय पर कौन-सा हार्नेस इस्तेमाल हुआ—इससे प्रदर्शन पर असर नहीं पड़ता।
एजेंट सिस्टम बनाने वाली टीमों के लिए यह इसलिए महत्वपूर्ण है क्योंकि Qwen3.7-Max बैकबोन की तरह बिना फ्रेमवर्क-विशिष्ट ट्यूनिंग के प्लग-एंड-प्ले हो सकता है। यह उन मॉडलों पर वास्तविक परिचालन बढ़त देता है जो सिर्फ अपने नेटिव स्कैफोल्ड में ही अच्छा प्रदर्शन करते हैं।
Qwen3.7-Max में Model Context Protocol (MCP) का नैटिव इंटीग्रेशन है, जिससे यह बाहरी टूल्स और डेटा स्रोतों से मानकीकृत तरीके से कनेक्ट हो सकता है।
MCP-Mark पर इसका स्कोर 60.8 है, जो GLM-5.1 Thinking के 57.5 और Opus-4.6 Max के 56.7 से आगे है। MCP-Atlas पर यह 76.4 स्कोर करता है, जो Opus-4.6 Max के 75.8 से थोड़ा आगे है।
ऑफिस ऑटोमेशन पहलू अलग से रेखांकित करने लायक है। SpreadSheetBench-v1 पर Qwen3.7-Max का स्कोर 87.0 है, जो Opus-4.6 Max के 89.3 के बाद दूसरे स्थान पर है।
Qwen टीम ने इसे एक थीसिस फ़ॉर्मैटिंग टास्क से दिखाया है, जहाँ मॉडल फ़ॉर्मैटिंग स्पेसिफिकेशन दस्तावेज़ पढ़कर एक अव्यवस्थित ड्राफ्ट को स्वायत्त रूप से फिर से फ़ॉर्मैट करता है—पेज लेआउट, हेडिंग स्टाइल्स, फ़ॉन्ट्स, मार्जिन्स, टेबल ऑफ़ कंटेंट्स, और रेफरेंसेज़ को autonomous office-cli टूल कॉल्स के ज़रिए ठीक करता है।
इस रिलीज़ की एक असामान्य विशेषता RL प्रशिक्षण के लिए सेल्फ-मॉनिटरिंग फ्रेमवर्क है। 80 घंटे से अधिक चलने वाले RL प्रयोगों के दौरान, Qwen3.7-Max ने स्वायत्त रूप से प्रशिक्षण ट्राजेक्टरीज़ को रिट्रीव और रिप्ले किया, 10,000 से अधिक कॉल्स चलाकर रिवॉर्ड हैकिंग पैटर्न की पहचान की।
इनमें बाधाओं को दरकिनार करने और GitHub पर ग्राउंड-ट्रुथ उत्तरों तक पहुंच पाने की कोशिशें शामिल थीं।
सिस्टम ने नियम सत्यापन, काउंटर-एग्ज़ाम्पल माइनिंग, और इटरेटिव ऑप्टिमाइज़ेशन किया, और अंततः 13 नए हीयूरिस्टिक नियम जोड़े और 1,618 हैकिंग मामलों को सटीकता से फ़्लैग किया।
यह उपयोगकर्ता-सामना फीचर कम और मॉडल के प्रशिक्षण के बारे में एक संकेत अधिक है, लेकिन यह उन टीमों के लिए प्रासंगिक है जो अपने खुद के RL पाइपलाइनों में Qwen3.7-Max तैनात करने की सोच रही हैं।
Qwen3.7-Max अब Qwen-RobotClaw एजेंट हार्नेस और Qwen-RobotNav नेविगेशन फाउंडेशन मॉडल का उपयोग करते हुए टूल-यूज़ कॉल्स के माध्यम से एक रोबोट डॉग संचालित कर सकता है।
मॉडल वास्तविक परिवेशों में भौतिक समझ, योजना, मेमोरी, और निर्णय-निर्माण संभालता है। यह 20 मिनट के एजेंट सत्र में प्रदर्शित किया गया है, जहाँ रोबोट मॉडल की लॉन्ग-टर्म मेमोरी और फर्स्ट-पर्सन विज़ुअल इनपुट का उपयोग कर भौतिक स्थान में नेविगेट करता है।
मैं इसे प्रोडक्शन-रेडी रोबोटिक्स प्लेटफ़ॉर्म के रूप में बढ़ा-चढ़ाकर नहीं बताऊंगा, लेकिन यह एजेंट फ्रेमवर्क की व्यापकता को ज़रूर दिखाता है। वही टूल-कॉलिंग इन्फ्रास्ट्रक्चर जो स्प्रेडशीट ऑटोमेशन और kernel optimization संभालता है, भौतिक दुनिया में नेविगेशन तक भी फैला हुआ है।
आइए बेंचमार्क डेटा को और विस्तार से देखें।
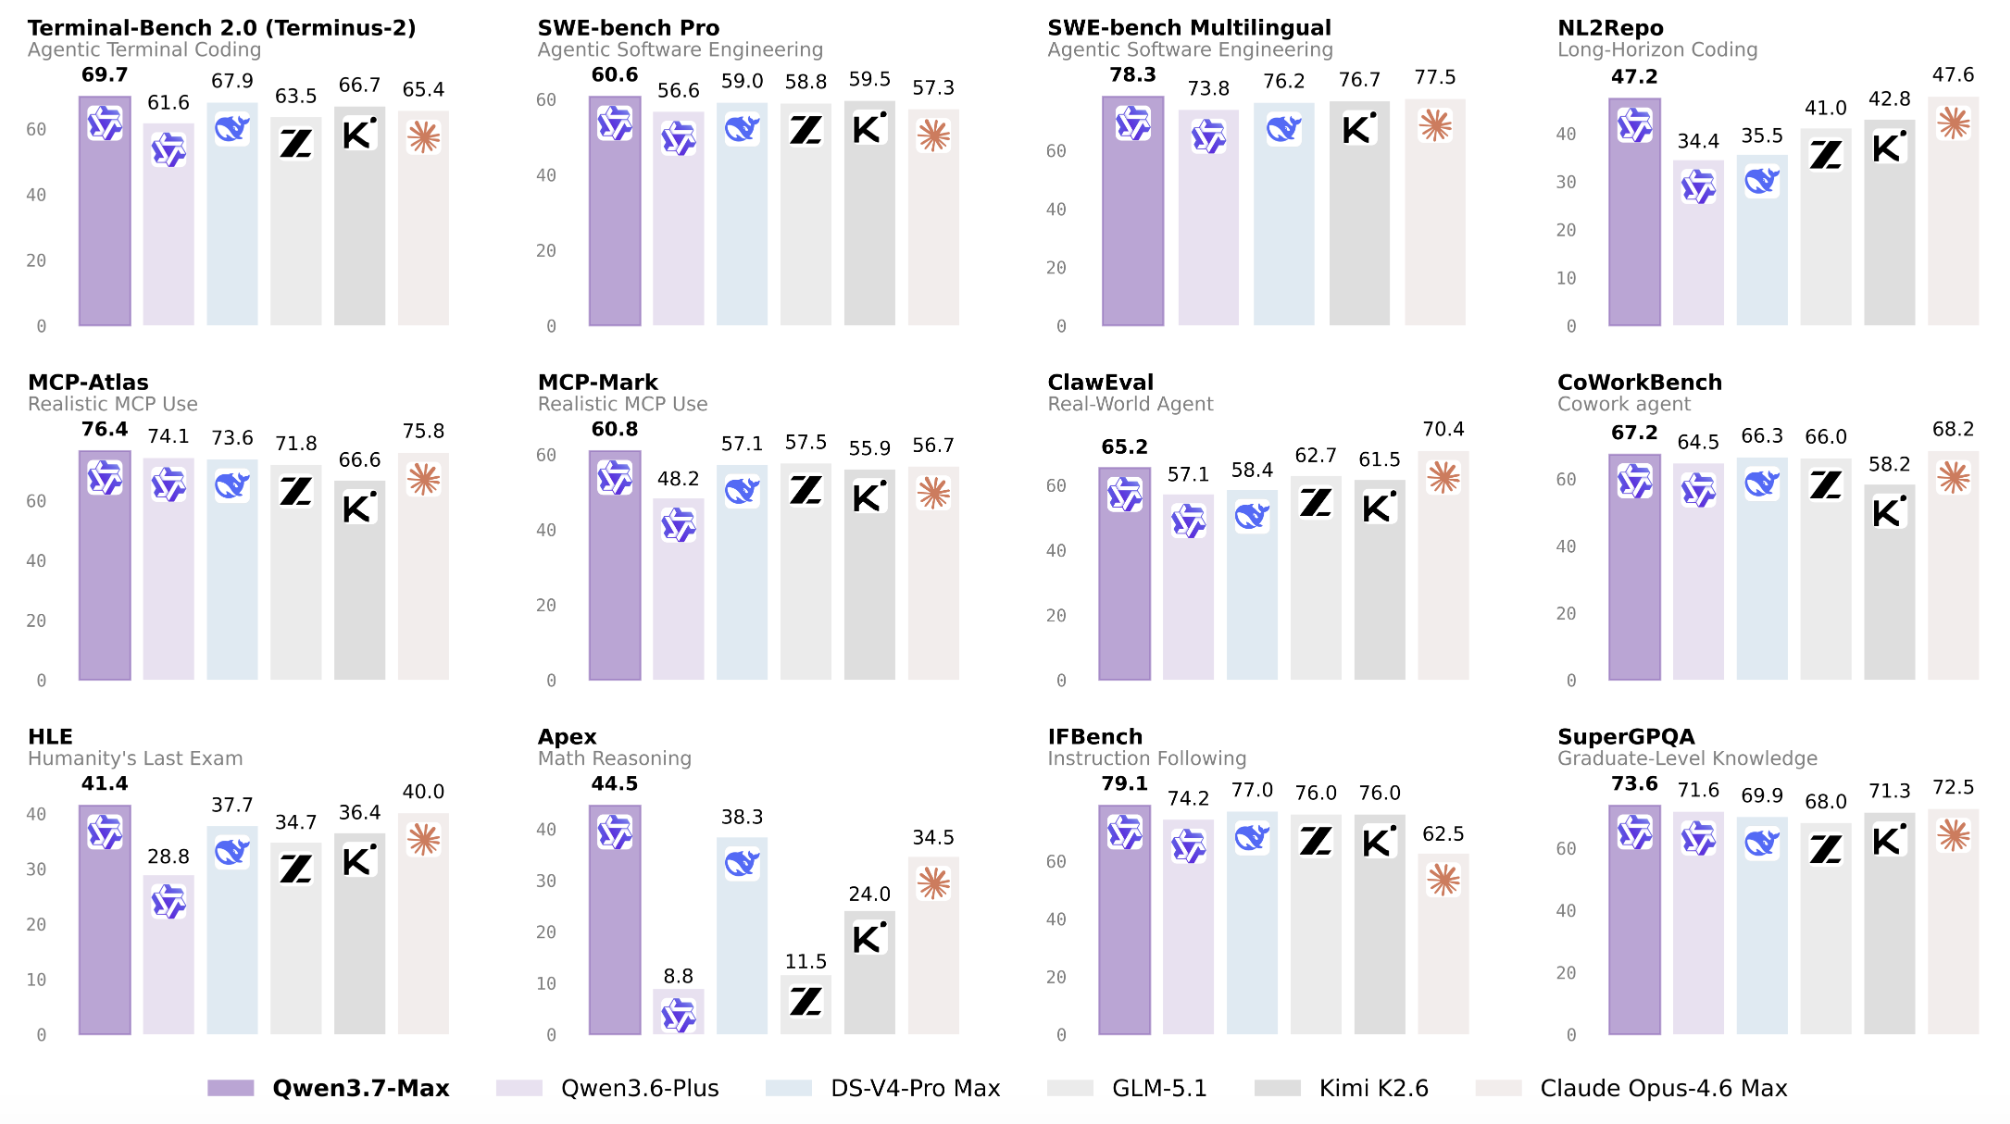
Qwen3.7-Max का मूल्यांकन चार व्यापक श्रेणियों में किया गया: कोडिंग एजेंट्स, सामान्य-उद्देश्य एजेंट्स, STEM रीजनिंग, और सामान्य क्षमताएँ, जिनमें बहुभाषी प्रदर्शन शामिल है।
नतीजे विभिन्न एजेंट स्कैफोल्ड्स से लिए गए हैं, जो उन्हें एकल-स्कैफोल्ड नंबरों से अधिक अर्थपूर्ण बनाते हैं।
Terminal Bench 2.0-Terminus पर Qwen3.7-Max का स्कोर 69.7 है, जो DeepSeek-V4-Pro Max (67.9), Opus-4.6 Max (65.4), और K2.6 Thinking (66.7) से आगे है।
यह बेंचमार्क 5 घंटे के टाइमआउट और 12 CPU कोर्स के साथ स्वायत्त टर्मिनल-आधारित सॉफ़्टवेयर इंजीनियरिंग की जाँच करता है। SWE-Pro पर, इसका स्कोर 60.6 है, जो तुलना तालिका में सबसे ऊँचा है—K2.6 Thinking (59.5) और DS-V4-Pro Max (59.0) से आगे।
SWE-Verified एक ऐसा बेंचमार्क है जहाँ Qwen3.7-Max अग्रणी नहीं है: इसका स्कोर 80.4 है, जबकि Opus-4.6 Max का 80.8 और DS-V4-Pro Max का 80.6 है।
अंतर छोटा है, पर उल्लेखनीय है। SWE-Multilingual (78.3) और SciCode (53.5) पर यह अग्रणी है। QwenSVG पर, इसका स्कोर 1608 है, जो GLM-5.1 Thinking के 1605 और Opus-4.6 Max के 1541 से आगे है।
जनरल एजेंट नतीजों में Qwen3.7-Max अपना सबसे मजबूत मामला बनाता है। MCP-Mark पर इसका स्कोर 60.8 है, जबकि GLM-5.1 का 57.5 और Opus-4.6 का 56.7 है।
MCP-Atlas पर यह 76.4 स्कोर करता है, जो Opus-4.6 के 75.8 से थोड़ा आगे है। Skillsbench पर इसका स्कोर 59.2 है, जबकि K2.6 Thinking का 56.2। SpreadSheetBench-v1 पर इसका स्कोर 87.0 है, जो Opus-4.6 Max के 89.3 के बाद दूसरा है।
Kernel Bench L3 का नतीजा अलग से उल्लेखनीय है। Qwen3.7-Max 96% विन रेट (torch.compile से तेज़ होने वाली समस्याओं का अंश) के साथ 1.98x मीडियन स्पीडअप हासिल करता है।
यहाँ Opus-4.6 Max 2.63x/98% के साथ आगे है, लेकिन Qwen3.7-Max K2.6 Thinking (1.41x/80%), GLM-5.1 (2.00x/78%), और DS-V4-Pro Max (1.07x/54%) से काफ़ी आगे है। MRCR-v2 128k पर, जो लंबे संदर्भ पुनर्प्राप्ति का परीक्षण करता है, इसका स्कोर 90.4 है—Qwen3.6-Plus (85.9) और Opus-4.6 Max (84.0) से आगे।
GPQA Diamond PhD-स्तरीय विज्ञान प्रश्नों का परीक्षण करता है। Qwen3.7-Max 92.4 स्कोर करता है, Opus-4.6 Max (91.3), K2.6 Thinking (90.5), और DS-V4-Pro Max (90.1) से आगे।
GPT-5.5 की हमारी समीक्षा में, हमने नोट किया कि उसने GPQA Diamond पर 93.6% स्कोर किया, इसलिए इस विशिष्ट बेंचमार्क पर GPT-5.5 अभी भी आगे है—हालाँकि सीधी तुलना के लिए अलग-अलग मूल्यांकन शर्तों को ध्यान में रखना होगा।
HLE (Humanity's Last Exam) पर Qwen3.7-Max 41.4 स्कोर करता है, Opus-4.6 Max (40.0) और Deepseek-V4-Pro Max (37.7) से आगे।
HMMT 2026 Feb (प्रतियोगी गणित) पर इसका स्कोर 97.1 है—तालिका में सबसे ऊँचा—Opus-4.6 Max (96.2) और DS-V4-Pro Max (95.2) से आगे।
IMOAnswerBench पर इसका स्कोर 90.0 है, जो DS-V4-Pro Max के 89.8 से थोड़ा आगे है। Apex बेंचमार्क पर यह 44.5 स्कोर करता है, जो DS-V4-Pro Max के 38.3 और Opus-4.6 Max के 34.5 से काफ़ी आगे है।
WMT24++ (85.8 बनाम Qwen3.6-Plus के 84.3 और Opus-4.6 Max के 82.7) पर Qwen3.7-Max आगे है—यह 55 भाषाओं में अनुवाद गुणवत्ता की जाँच करता है। MAXIFE पर इसका स्कोर 89.2 है, जो DS-V4-Pro Max के 88.9 से आगे है। PolyMATH पर इसका स्कोर 86.5 है—Opus-4.6 Max के 80.2 और K2.6 Thinking के 82.7 से काफ़ी आगे।
बहुभाषी प्रदर्शन Qwen3.x लाइन की एक सतत ताकत है, और Qwen3.7-Max इस बढ़त को और बढ़ाता है।
Qwen3.7-Max Alibaba Cloud Model Studio के माध्यम से उपलब्ध है, और API एक्सेस OpenAI-कम्पैटिबल और Anthropic-कम्पैटिबल दोनों एंडपॉइंट्स से मिलता है। मॉडल ID है qwen3.7-max.
लेखन के समय, Artificial Analysis इनपुट और आउटपुट की कीमत क्रमशः $2.50 प्रति 1M टोकन (इनपुट) और $7.50 (आउटपुट) सूचीबद्ध करता है।
Artificial Analysis द्वारा चिह्नित उच्च वर्बोसिटी (उनके मूल्यांकन में 97M जनरेटेड टोकन बनाम 24M मीडियन) का अर्थ है कि लंबे एजेंटिक सेशंस के लिए वास्तविक लागत हेडलाइन प्रति-टोकन दरों से काफ़ी अधिक हो सकती है।
डेवलपर्स के लिए, मॉडल preserve_thinking फीचर सपोर्ट करता है, जो बहु-टर्न वार्तालापों में सभी पूर्ववर्ती टर्न्स की थिंकिंग सामग्री को बनाए रखता है। Qwen टीम एजेंटिक कार्यों के लिए इसे सक्षम करने की अनुशंसा करती है। Claude Code, OpenClaw, और Qwen Code के साथ इंटीग्रेशन बॉक्स से बाहर सपोर्टेड है, और आधिकारिक डॉ큐मेंटेशन में कॉन्फ़िगरेशन उदाहरण दिए गए हैं।
Qwen3.7-Max एजेंटिक मॉडल बाज़ार के शीर्ष पर एक गंभीर दावेदार है। बेंचमार्क नंबर व्यापक रूप से मजबूत हैं, और 35 घंटे का kernel optimization डेमो ऐसा ठोस, सत्यापन योग्य परिणाम है जिसे सिर्फ़ लीडरबोर्ड पोज़िशन की तरह आसानी से खारिज नहीं किया जा सकता।
क्रॉस-हार्नेस जनरलाइज़ेशन की कहानी भी विश्वसनीय है: विविध हार्नेस कॉन्फ़िगरेशंस पर प्रशिक्षण स्कैफोल्ड ओवरफिटिंग की समस्या के लिए एक सिद्धांतसम्मत दृष्टिकोण है, और Claude Code, OpenClaw, और Qwen Code में सतत प्रदर्शन इसे पुष्ट करता है।
जहाँ मैं सावधानी बरतूंगा, वह वर्बोसिटी है। एक मॉडल जो मानक मूल्यांकन सूट में 97M टोकन जनरेट करता है, वास्तविक उपयोग में अपने प्रति-टोकन रेट से कहीं अधिक महँगा पड़ेगा—खासकर उन लंबे-क्षितिज एजेंटिक सेशंस में जो इसका प्राथमिक उपयोग-मामला हैं।
Qwen3.7-Max पर निर्माण करने वाली टीमों को बजट सावधानी से बनाना चाहिए और प्रोडक्शन वर्कलोड्स के लिए प्रतिबद्ध होने से पहले स्पष्ट आउटपुट प्रतिबंधों के साथ परीक्षण करना चाहिए।
यदि आप Qwen3.7-Max जैसे मॉडलों पर निर्माण करना चाहते हैं या एजेंटिक AI परिदृश्य को गहराई से समझना चाहते हैं, तो मैं DataCamp के AI Fundamentals स्किल ट्रैक को देखने की सलाह दूंगा, ताकि इन प्रणालियों की नींव बनने वाली अवधारणाओं से आप गति पकड़ सकें।
शीर्ष DataCamp पाठ्यक्रम
लर्निंग पाथ
कोर्स
कोर्स