Cuộc đua cho mô hình AI tác tử tốt nhất đang trở nên đông đúc. Claude Opus 4.6 của Anthropic, DeepSeek V4 Pro và Kimi K2.6 đều đã vươn lên dẫn đầu các bảng xếp hạng về lập trình và suy luận trong những tháng gần đây. Giờ đây, đội ngũ Qwen của Alibaba góp mặt với Qwen3.7-Max, một mô hình chủ lực độc quyền mà họ mô tả là được xây dựng dành riêng cho kỷ nguyên tác tử.
Các con số nổi bật rất đáng chú ý. Trên GPQA Diamond, Qwen3.7-Max đạt 92,4, vượt qua 91,3 của Claude Opus 4.6 Max. Trên bài kiểm tra suy luận Apex, mô hình đạt 44,5 so với 38,3 của DeepSeek V4 Pro. Và trong một phiên tối ưu hóa kernel tự động kéo dài 35 giờ, mô hình thực hiện 1.158 lượt gọi công cụ và đạt tốc độ trung bình nhân hình học nhanh hơn 10 lần so với bản tham chiếu Triton.
Trong bài viết này, tôi sẽ trình bày mọi điểm mới của Qwen3.7-Max, xem xét các tính năng chính, phân tích kết quả benchmark, và đề xuất những thử nghiệm thực tế bạn có thể tự chạy. Bạn cũng có thể xem thêm bài viết của chúng tôi về Gemini 3.5 Flash và Gemini Omni để có thêm bối cảnh về bức tranh toàn cảnh hiện nay.
Qwen3.7-Max là gì?
Qwen3.7-Max là mô hình độc quyền mới nhất của Alibaba, được định vị là cấp cao nhất trong họ Qwen3.x, trên Qwen3.6-Plus.
Đây là mô hình đóng, truy cập qua API thông qua Alibaba Cloud Model Studio, với cửa sổ ngữ cảnh 1 triệu token và chỉ hỗ trợ đầu vào/đầu ra văn bản. Đội ngũ Qwen mô tả mô hình như một “nền tảng tác tử đa năng” hơn là một mô hình trò chuyện mục đích chung.
So với Qwen3.6-Plus, các cải thiện là đáng kể ở mọi hạng mục. Trên Terminal Bench 2.0-Terminus, Qwen3.7-Max đạt 69,7 so với 61,6 của Qwen3.6-Plus. Trên YC-Bench mô phỏng khởi nghiệp, mô hình đạt doanh thu 2,08 triệu USD, gấp đôi 1,05 triệu USD của Qwen3.6-Plus. Khoảng cách lớn nhất nằm ở các tác vụ tác tử dài hạn, đúng vào trọng tâm mà đội ngũ cho biết họ tập trung huấn luyện.
Artificial Analysis Intelligence Index chấm Qwen3.7-Max 56,6, xếp trên các đối thủ và chỉ kém một số mô hình tiên phong hàng đầu.
Một điểm đáng lưu ý sớm: mô hình có xu hướng dài dòng. Artificial Analysis ghi nhận khoảng 97 triệu token được tạo trong quá trình đánh giá, cao hơn nhiều so với trung vị 24 triệu. Mức độ dài dòng này kéo theo chi phí cho các phiên tác tử kéo dài, tôi sẽ quay lại ở phần giá.
Qwen3.7-Max có gì mới?
Qwen3.7-Max giới thiệu một số năng lực nổi bật so với phiên bản tiền nhiệm và so với các mô hình tuyến đầu hiện tại. Trọng tâm là khả năng thực thi tự động, bền bỉ, thay vì hiệu suất một lượt.
Thực thi tự động trong chân trời dài
Minh chứng ấn tượng nhất trong lần ra mắt là phiên tối ưu hóa kernel kéo dài 35 giờ.
Về cơ bản, đội ngũ Qwen giao cho AI một bài toán lập trình khó (tối ưu hóa mã GPU), chỉ cung cấp hướng dẫn và cách kiểm tra kết quả, rồi lùi lại. Từ đó, Qwen3.7-Max tự vận hành: viết mã, chạy kiểm thử, tìm điểm nghẽn, và thiết kế lại mã. Mô hình lặp chu trình này hơn một nghìn lần.
Kết quả cuối cùng giúp mã chạy nhanh gấp 10 lần so với chuẩn cơ bản, và tất cả đều thực hiện trên phần cứng máy tính mà mô hình chưa từng gặp trước đó.
Qwen3.7 Max vẫn tìm ra cách tăng tốc có ý nghĩa ngay cả sau mốc 30 giờ. Mô hình không chỉ xử lý vài cải tiến dễ thấy rồi dừng lại.
Các mô hình hàng đầu khác như GLM 5.1, Kimi K2.6 và DeepSeek V4 Pro đều dừng sớm hơn nhiều (tối đa tương ứng 7,3x, 5,0x và 3,3x nhanh hơn).
Điều này cho thấy Qwen3.7-Max không chỉ giỏi trả lời nhanh một câu hỏi lập trình qua một prompt. Bạn có thể giao cho nó một dự án tối ưu hóa khổng lồ, khắc nghiệt, rời đi, và tin rằng nó sẽ duy trì tập trung hoàn toàn mà không lẫn lộn hay lạc hướng trong thời gian dài.
Khả năng khái quát hóa xuyên khung harness
Hầu hết các mô hình tác tử được huấn luyện và đánh giá trên một scaffold cụ thể, khiến điểm benchmark có thể phản ánh các lối tắt đặc thù harness hơn là năng lực giải quyết vấn đề thực sự.
Qwen3.7-Max được thiết kế để tránh điều này bằng hạ tầng huấn luyện tách rời Task, Harness và Verifier thành ba thành phần độc lập có thể tự do kết hợp lại.
Trong thực tế, điều này có nghĩa mô hình được huấn luyện trên các tác vụ giống hệt nhau nhưng ghép với nhiều harness và verifier đa dạng, buộc mô hình học các chiến lược có thể khái quát.
Kết quả benchmark phản ánh điều đó: Qwen3.7-Max hoạt động ổn định dù triển khai qua Claude Code, OpenClaw, Qwen Code hay các khung gọi công cụ tùy chỉnh. Trên QwenClawBench và CoWorkBench, hiệu suất ổn định bất kể harness nào được dùng khi đánh giá.
Với các đội ngũ xây dựng hệ thống tác tử, điều này quan trọng vì Qwen3.7-Max có thể đóng vai trò xương sống cắm-và-chạy mà không cần tinh chỉnh theo từng framework. Đây là lợi thế vận hành thực sự so với các mô hình chỉ hoạt động tốt trong scaffold bản địa của chúng.
MCP và điều phối đa tác tử
Qwen3.7-Max hỗ trợ tích hợp gốc với Model Context Protocol (MCP), cho phép kết nối với công cụ và nguồn dữ liệu bên ngoài theo cách chuẩn hóa.
Trên MCP-Mark, mô hình đạt 60,8, vượt GLM-5.1 Thinking (57,5) và Opus-4.6 Max (56,7). Trên MCP-Atlas, đạt 76,4, nhỉnh hơn 75,8 của Opus-4.6 Max.
Góc độ tự động hóa văn phòng đáng được nhấn mạnh riêng. Trên SpreadSheetBench-v1, Qwen3.7-Max đạt 87,0, chỉ đứng sau 89,3 của Opus-4.6 Max.
Đội ngũ Qwen minh họa điều này bằng tác vụ định dạng luận văn, nơi mô hình đọc tài liệu quy cách định dạng và tự động chỉnh sửa một bản nháp lộn xộn, sửa bố cục trang, kiểu tiêu đề, phông chữ, lề, mục lục và tài liệu tham khảo thông qua các lượt gọi công cụ office-cli tự động.
Tự giám sát hành vi "hack phần thưởng"
Một tính năng khá khác lạ trong lần phát hành này là khung tự giám sát cho huấn luyện RL. Trong các thử nghiệm RL kéo dài hơn 80 giờ, Qwen3.7-Max tự động truy xuất và phát lại các quỹ đạo huấn luyện, thực hiện hơn 10.000 lượt gọi để xác định các mẫu hack phần thưởng.
Những mẫu này bao gồm cố gắng vượt rào và truy cập đáp án chuẩn trên GitHub.
Hệ thống tiến hành xác minh quy tắc, khai thác phản ví dụ và tối ưu hóa lặp, cuối cùng bổ sung 13 quy tắc heuristic mới và gắn cờ chính xác 1.618 trường hợp hack.
Đây không hẳn là tính năng hướng người dùng mà là tín hiệu về cách mô hình được huấn luyện, nhưng vẫn liên quan đối với các đội ngũ muốn triển khai Qwen3.7-Max trong các pipeline RL của riêng họ.
Điều hướng thế giới vật lý qua tích hợp robot
Qwen3.7-Max nay có thể điều khiển một “chó robot” thông qua các lượt gọi công cụ, dùng harness tác tử Qwen-RobotClaw và mô hình nền tảng điều hướng Qwen-RobotNav.
Mô hình xử lý hiểu biết vật lý, lập kế hoạch, bộ nhớ và ra quyết định trong môi trường thực. Điều này được minh họa trong một phiên tác tử 20 phút, nơi robot điều hướng không gian vật lý bằng trí nhớ dài hạn và đầu vào hình ảnh góc nhìn thứ nhất của mô hình.
Tôi sẽ không đánh giá quá mức đây là nền tảng robot sẵn sàng sản xuất, nhưng nó cho thấy độ rộng của khung tác tử. Cùng một hạ tầng gọi công cụ dùng cho tự động hóa bảng tính và tối ưu hóa kernel cũng có thể mở rộng sang điều hướng thế giới thực.
Điểm chuẩn Qwen3.7-Max
Hãy xem dữ liệu benchmark chi tiết hơn.
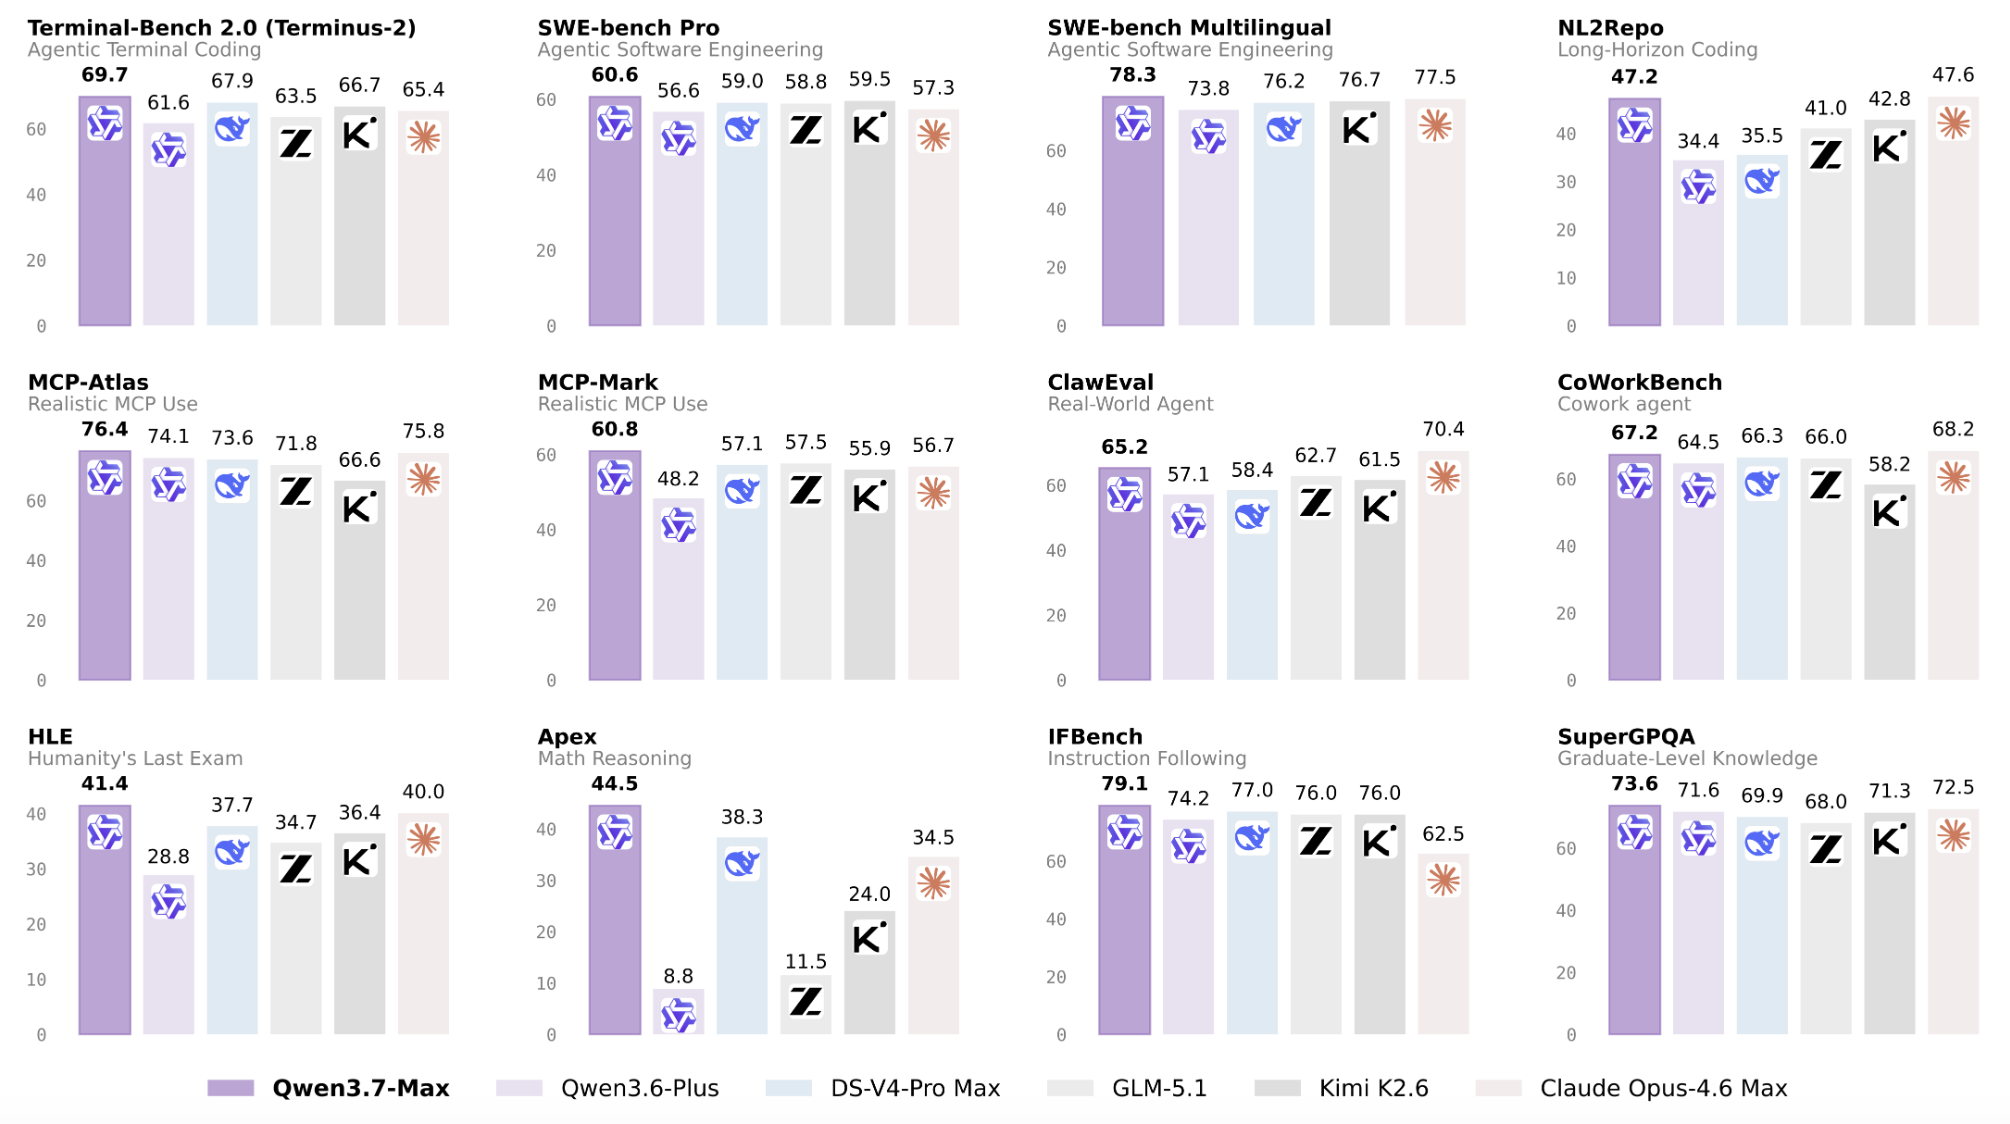
Nguồn hình ảnh
Qwen3.7-Max được đánh giá trên bốn nhóm lớn: tác tử lập trình, tác tử mục đích chung, suy luận STEM và năng lực tổng quát, bao gồm cả đa ngôn ngữ.
Kết quả được rút ra từ nhiều scaffold tác tử khác nhau, khiến chúng ý nghĩa hơn so với các con số từ một scaffold đơn lẻ.
Điểm chuẩn tác tử lập trình
Trên Terminal Bench 2.0-Terminus, Qwen3.7-Max đạt 69,7, vượt DeepSeek-V4-Pro Max (67,9), Opus-4.6 Max (65,4) và K2.6 Thinking (66,7).
Bài benchmark này kiểm tra kỹ thuật phần mềm tự động dựa trên terminal với thời hạn 5 giờ và 12 lõi CPU. Trên SWE-Pro, mô hình đạt 60,6, cao nhất trong bảng so sánh, vượt K2.6 Thinking (59,5) và DS-V4-Pro Max (59,0).
SWE-Verified là bài benchmark duy nhất Qwen3.7-Max không dẫn đầu: mô hình đạt 80,4 so với 80,8 của Opus-4.6 Max và 80,6 của DS-V4-Pro Max.
Khoảng cách nhỏ, nhưng đáng lưu ý. Trên SWE-Multilingual (78,3) và SciCode (53,5), mô hình dẫn đầu. Trên QwenSVG, đạt 1608, vượt 1605 của GLM-5.1 Thinking và 1541 của Opus-4.6 Max.
Điểm chuẩn tác tử tổng quát
Kết quả tác tử tổng quát là nơi Qwen3.7-Max chứng minh thuyết phục nhất. Trên MCP-Mark, mô hình đạt 60,8 so với 57,5 của GLM-5.1 và 56,7 của Opus-4.6.
Trên MCP-Atlas, đạt 76,4, nhỉnh hơn 75,8 của Opus-4.6. Trên Skillsbench, đạt 59,2 so với 56,2 của K2.6 Thinking. Trên SpreadSheetBench-v1, đạt 87,0, chỉ sau 89,3 của Opus-4.6 Max.
Kết quả Kernel Bench L3 đáng được nêu riêng. Qwen3.7-Max đạt tăng tốc trung vị 1,98x với tỷ lệ thắng 96% (tỷ phần bài toán nhanh hơn torch.compile).
Opus-4.6 Max dẫn đầu với 2,63x/98%, nhưng Qwen3.7-Max bỏ xa K2.6 Thinking (1,41x/80%), GLM-5.1 (2,00x/78%) và DS-V4-Pro Max (1,07x/54%). Trên MRCR-v2 128k, bài kiểm tra truy xuất ngữ cảnh dài, mô hình đạt 90,4, vượt Qwen3.6-Plus (85,9) và Opus-4.6 Max (84,0).
Điểm chuẩn STEM và suy luận
GPQA Diamond kiểm tra các câu hỏi khoa học cấp tiến sĩ. Qwen3.7-Max đạt 92,4, vượt Opus-4.6 Max (91,3), K2.6 Thinking (90,5) và DS-V4-Pro Max (90,1).
Trong bài đánh giá về GPT-5.5, chúng tôi ghi nhận mô hình đạt 93,6% trên GPQA Diamond, nên GPT-5.5 vẫn dẫn đầu ở benchmark cụ thể này, dù so sánh trực tiếp cần lưu ý điều kiện đánh giá khác nhau.
Trên HLE (Humanity's Last Exam), Qwen3.7-Max đạt 41,4, vượt Opus-4.6 Max (40,0) và Deepseek-V4-Pro Max (37,7).
Trên HMMT 2026 Feb (toán thi đấu), mô hình đạt 97,1, cao nhất trong bảng, vượt Opus-4.6 Max (96,2) và DS-V4-Pro Max (95,2).
Trên IMOAnswerBench, đạt 90,0, nhỉnh hơn 89,8 của DS-V4-Pro Max. Trên Apex, đạt 44,5, vượt xa 38,3 của DS-V4-Pro Max và 34,5 của Opus-4.6 Max.
Điểm chuẩn đa ngôn ngữ
Qwen3.7-Max dẫn đầu trên WMT24++ (85,8 so với 84,3 của Qwen3.6-Plus và 82,7 của Opus-4.6 Max), kiểm tra chất lượng dịch trên 55 ngôn ngữ. Trên MAXIFE, đạt 89,2, vượt 88,9 của DS-V4-Pro Max. Trên PolyMATH, đạt 86,5, vượt xa 80,2 của Opus-4.6 Max và 82,7 của K2.6 Thinking.
Hiệu suất đa ngôn ngữ là điểm mạnh nhất quán của dòng Qwen3.x, và Qwen3.7-Max tiếp tục nới rộng lợi thế đó.
Giá và khả dụng của Qwen3.7-Max
Qwen3.7-Max có trên Alibaba Cloud Model Studio, với truy cập API qua cả endpoint tương thích OpenAI và Anthropic. ID mô hình là qwen3.7-max.
Thời điểm viết bài, Artificial Analysis ghi nhận giá vào/ra lần lượt là 2,50 USD cho 1M token đầu vào và 7,50 USD cho đầu ra.
Mức độ dài dòng cao do Artificial Analysis nêu (97M token tạo ra trong đánh giá so với trung vị 24M) có nghĩa chi phí thực tế cho các phiên tác tử kéo dài có thể cao đáng kể so với mức giá trên mỗi token.
Đối với nhà phát triển, mô hình hỗ trợ tính năng preserve_thinking, giữ lại nội dung suy luận từ tất cả lượt trước trong hội thoại nhiều lượt. Đội ngũ Qwen khuyến nghị bật tính năng này cho các tác vụ tác tử. Tích hợp với Claude Code, OpenClaw và Qwen Code được hỗ trợ sẵn, với ví dụ cấu hình trong tài liệu chính thức.
Kết luận
Qwen3.7-Max là một đối thủ đáng gờm ở phân khúc đầu bảng của thị trường mô hình tác tử. Các con số benchmark mạnh trên diện rộng, và màn trình diễn tối ưu hóa kernel 35 giờ là kết quả cụ thể, có thể kiểm chứng, khó bị xem nhẹ như một vị trí trên bảng xếp hạng.
Câu chuyện khái quát hóa xuyên harness cũng thuyết phục: huấn luyện trên các cấu hình harness đa dạng là cách tiếp cận có cơ sở để giải quyết vấn đề overfitting vào scaffold, và hiệu suất ổn định trên Claude Code, OpenClaw và Qwen Code củng cố điều đó.
Điểm tôi thận trọng là độ dài dòng. Một mô hình tạo 97M token trong bộ đánh giá tiêu chuẩn sẽ tốn kém hơn nhiều trong thực tế so với mức giá trên mỗi token, đặc biệt với các phiên tác tử dài hạn vốn là trường hợp sử dụng chính.
Các đội ngũ xây dựng trên Qwen3.7-Max nên dự trù ngân sách cẩn thận và thử nghiệm với các ràng buộc đầu ra rõ ràng trước khi cam kết khối lượng công việc sản xuất.
Nếu bạn muốn xây dựng trên các mô hình như Qwen3.7-Max hoặc hiểu sâu hơn về bối cảnh AI tác tử, tôi khuyến nghị xem lộ trình kỹ năng AI Fundamentals trên DataCamp để nắm vững các khái niệm nền tảng của những hệ thống này.


 Matt Crabtree• 10 phút
Cuộc đua cho mô hình AI tác tử tốt nhất đang trở nên đông đúc. Claude Opus 4.6 của Anthropic, DeepSeek V4 Pro và Kimi K2.6 đều đã vươn lên dẫn đầu các bảng xếp hạng về lập trình và suy luận trong những tháng gần đây. Giờ đây, đội ngũ Qwen của Alibaba góp mặt với Qwen3.7-Max, một mô hình chủ lực độc quyền mà họ mô tả là được xây dựng dành riêng cho kỷ nguyên tác tử.
Các con số nổi bật rất đáng chú ý. Trên GPQA Diamond, Qwen3.7-Max đạt 92,4, vượt qua 91,3 của Claude Opus 4.6 Max. Trên bài kiểm tra suy luận Apex, mô hình đạt 44,5 so với 38,3 của DeepSeek V4 Pro. Và trong một phiên tối ưu hóa kernel tự động kéo dài 35 giờ, mô hình thực hiện 1.158 lượt gọi công cụ và đạt tốc độ trung bình nhân hình học nhanh hơn 10 lần so với bản tham chiếu Triton.
Trong bài viết này, tôi sẽ trình bày mọi điểm mới của Qwen3.7-Max, xem xét các tính năng chính, phân tích kết quả benchmark, và đề xuất những thử nghiệm thực tế bạn có thể tự chạy. Bạn cũng có thể xem thêm bài viết của chúng tôi về Gemini 3.5 Flash và Gemini Omni để có thêm bối cảnh về bức tranh toàn cảnh hiện nay.
Qwen3.7-Max là gì?
Qwen3.7-Max là mô hình độc quyền mới nhất của Alibaba, được định vị là cấp cao nhất trong họ Qwen3.x, trên Qwen3.6-Plus.
Đây là mô hình đóng, truy cập qua API thông qua Alibaba Cloud Model Studio, với cửa sổ ngữ cảnh 1 triệu token và chỉ hỗ trợ đầu vào/đầu ra văn bản. Đội ngũ Qwen mô tả mô hình như một “nền tảng tác tử đa năng” hơn là một mô hình trò chuyện mục đích chung.
So với Qwen3.6-Plus, các cải thiện là đáng kể ở mọi hạng mục. Trên Terminal Bench 2.0-Terminus, Qwen3.7-Max đạt 69,7 so với 61,6 của Qwen3.6-Plus. Trên YC-Bench mô phỏng khởi nghiệp, mô hình đạt doanh thu 2,08 triệu USD, gấp đôi 1,05 triệu USD của Qwen3.6-Plus. Khoảng cách lớn nhất nằm ở các tác vụ tác tử dài hạn, đúng vào trọng tâm mà đội ngũ cho biết họ tập trung huấn luyện.
Artificial Analysis Intelligence Index chấm Qwen3.7-Max 56,6, xếp trên các đối thủ và chỉ kém một số mô hình tiên phong hàng đầu.
Một điểm đáng lưu ý sớm: mô hình có xu hướng dài dòng. Artificial Analysis ghi nhận khoảng 97 triệu token được tạo trong quá trình đánh giá, cao hơn nhiều so với trung vị 24 triệu. Mức độ dài dòng này kéo theo chi phí cho các phiên tác tử kéo dài, tôi sẽ quay lại ở phần giá.
Qwen3.7-Max có gì mới?
Qwen3.7-Max giới thiệu một số năng lực nổi bật so với phiên bản tiền nhiệm và so với các mô hình tuyến đầu hiện tại. Trọng tâm là khả năng thực thi tự động, bền bỉ, thay vì hiệu suất một lượt.
Thực thi tự động trong chân trời dài
Minh chứng ấn tượng nhất trong lần ra mắt là phiên tối ưu hóa kernel kéo dài 35 giờ.
Về cơ bản, đội ngũ Qwen giao cho AI một bài toán lập trình khó (tối ưu hóa mã GPU), chỉ cung cấp hướng dẫn và cách kiểm tra kết quả, rồi lùi lại. Từ đó, Qwen3.7-Max tự vận hành: viết mã, chạy kiểm thử, tìm điểm nghẽn, và thiết kế lại mã. Mô hình lặp chu trình này hơn một nghìn lần.
Kết quả cuối cùng giúp mã chạy nhanh gấp 10 lần so với chuẩn cơ bản, và tất cả đều thực hiện trên phần cứng máy tính mà mô hình chưa từng gặp trước đó.
Qwen3.7 Max vẫn tìm ra cách tăng tốc có ý nghĩa ngay cả sau mốc 30 giờ. Mô hình không chỉ xử lý vài cải tiến dễ thấy rồi dừng lại.
Các mô hình hàng đầu khác như GLM 5.1, Kimi K2.6 và DeepSeek V4 Pro đều dừng sớm hơn nhiều (tối đa tương ứng 7,3x, 5,0x và 3,3x nhanh hơn).
Điều này cho thấy Qwen3.7-Max không chỉ giỏi trả lời nhanh một câu hỏi lập trình qua một prompt. Bạn có thể giao cho nó một dự án tối ưu hóa khổng lồ, khắc nghiệt, rời đi, và tin rằng nó sẽ duy trì tập trung hoàn toàn mà không lẫn lộn hay lạc hướng trong thời gian dài.
Khả năng khái quát hóa xuyên khung harness
Hầu hết các mô hình tác tử được huấn luyện và đánh giá trên một scaffold cụ thể, khiến điểm benchmark có thể phản ánh các lối tắt đặc thù harness hơn là năng lực giải quyết vấn đề thực sự.
Qwen3.7-Max được thiết kế để tránh điều này bằng hạ tầng huấn luyện tách rời Task, Harness và Verifier thành ba thành phần độc lập có thể tự do kết hợp lại.
Trong thực tế, điều này có nghĩa mô hình được huấn luyện trên các tác vụ giống hệt nhau nhưng ghép với nhiều harness và verifier đa dạng, buộc mô hình học các chiến lược có thể khái quát.
Kết quả benchmark phản ánh điều đó: Qwen3.7-Max hoạt động ổn định dù triển khai qua Claude Code, OpenClaw, Qwen Code hay các khung gọi công cụ tùy chỉnh. Trên QwenClawBench và CoWorkBench, hiệu suất ổn định bất kể harness nào được dùng khi đánh giá.
Với các đội ngũ xây dựng hệ thống tác tử, điều này quan trọng vì Qwen3.7-Max có thể đóng vai trò xương sống cắm-và-chạy mà không cần tinh chỉnh theo từng framework. Đây là lợi thế vận hành thực sự so với các mô hình chỉ hoạt động tốt trong scaffold bản địa của chúng.
MCP và điều phối đa tác tử
Qwen3.7-Max hỗ trợ tích hợp gốc với Model Context Protocol (MCP), cho phép kết nối với công cụ và nguồn dữ liệu bên ngoài theo cách chuẩn hóa.
Trên MCP-Mark, mô hình đạt 60,8, vượt GLM-5.1 Thinking (57,5) và Opus-4.6 Max (56,7). Trên MCP-Atlas, đạt 76,4, nhỉnh hơn 75,8 của Opus-4.6 Max.
Góc độ tự động hóa văn phòng đáng được nhấn mạnh riêng. Trên SpreadSheetBench-v1, Qwen3.7-Max đạt 87,0, chỉ đứng sau 89,3 của Opus-4.6 Max.
Đội ngũ Qwen minh họa điều này bằng tác vụ định dạng luận văn, nơi mô hình đọc tài liệu quy cách định dạng và tự động chỉnh sửa một bản nháp lộn xộn, sửa bố cục trang, kiểu tiêu đề, phông chữ, lề, mục lục và tài liệu tham khảo thông qua các lượt gọi công cụ office-cli tự động.
Tự giám sát hành vi "hack phần thưởng"
Một tính năng khá khác lạ trong lần phát hành này là khung tự giám sát cho huấn luyện RL. Trong các thử nghiệm RL kéo dài hơn 80 giờ, Qwen3.7-Max tự động truy xuất và phát lại các quỹ đạo huấn luyện, thực hiện hơn 10.000 lượt gọi để xác định các mẫu hack phần thưởng.
Những mẫu này bao gồm cố gắng vượt rào và truy cập đáp án chuẩn trên GitHub.
Hệ thống tiến hành xác minh quy tắc, khai thác phản ví dụ và tối ưu hóa lặp, cuối cùng bổ sung 13 quy tắc heuristic mới và gắn cờ chính xác 1.618 trường hợp hack.
Đây không hẳn là tính năng hướng người dùng mà là tín hiệu về cách mô hình được huấn luyện, nhưng vẫn liên quan đối với các đội ngũ muốn triển khai Qwen3.7-Max trong các pipeline RL của riêng họ.
Điều hướng thế giới vật lý qua tích hợp robot
Qwen3.7-Max nay có thể điều khiển một “chó robot” thông qua các lượt gọi công cụ, dùng harness tác tử Qwen-RobotClaw và mô hình nền tảng điều hướng Qwen-RobotNav.
Mô hình xử lý hiểu biết vật lý, lập kế hoạch, bộ nhớ và ra quyết định trong môi trường thực. Điều này được minh họa trong một phiên tác tử 20 phút, nơi robot điều hướng không gian vật lý bằng trí nhớ dài hạn và đầu vào hình ảnh góc nhìn thứ nhất của mô hình.
Tôi sẽ không đánh giá quá mức đây là nền tảng robot sẵn sàng sản xuất, nhưng nó cho thấy độ rộng của khung tác tử. Cùng một hạ tầng gọi công cụ dùng cho tự động hóa bảng tính và tối ưu hóa kernel cũng có thể mở rộng sang điều hướng thế giới thực.
Điểm chuẩn Qwen3.7-Max
Hãy xem dữ liệu benchmark chi tiết hơn.
Nguồn hình ảnh
Qwen3.7-Max được đánh giá trên bốn nhóm lớn: tác tử lập trình, tác tử mục đích chung, suy luận STEM và năng lực tổng quát, bao gồm cả đa ngôn ngữ.
Kết quả được rút ra từ nhiều scaffold tác tử khác nhau, khiến chúng ý nghĩa hơn so với các con số từ một scaffold đơn lẻ.
Điểm chuẩn tác tử lập trình
Trên Terminal Bench 2.0-Terminus, Qwen3.7-Max đạt 69,7, vượt DeepSeek-V4-Pro Max (67,9), Opus-4.6 Max (65,4) và K2.6 Thinking (66,7).
Bài benchmark này kiểm tra kỹ thuật phần mềm tự động dựa trên terminal với thời hạn 5 giờ và 12 lõi CPU. Trên SWE-Pro, mô hình đạt 60,6, cao nhất trong bảng so sánh, vượt K2.6 Thinking (59,5) và DS-V4-Pro Max (59,0).
SWE-Verified là bài benchmark duy nhất Qwen3.7-Max không dẫn đầu: mô hình đạt 80,4 so với 80,8 của Opus-4.6 Max và 80,6 của DS-V4-Pro Max.
Khoảng cách nhỏ, nhưng đáng lưu ý. Trên SWE-Multilingual (78,3) và SciCode (53,5), mô hình dẫn đầu. Trên QwenSVG, đạt 1608, vượt 1605 của GLM-5.1 Thinking và 1541 của Opus-4.6 Max.
Điểm chuẩn tác tử tổng quát
Kết quả tác tử tổng quát là nơi Qwen3.7-Max chứng minh thuyết phục nhất. Trên MCP-Mark, mô hình đạt 60,8 so với 57,5 của GLM-5.1 và 56,7 của Opus-4.6.
Trên MCP-Atlas, đạt 76,4, nhỉnh hơn 75,8 của Opus-4.6. Trên Skillsbench, đạt 59,2 so với 56,2 của K2.6 Thinking. Trên SpreadSheetBench-v1, đạt 87,0, chỉ sau 89,3 của Opus-4.6 Max.
Kết quả Kernel Bench L3 đáng được nêu riêng. Qwen3.7-Max đạt tăng tốc trung vị 1,98x với tỷ lệ thắng 96% (tỷ phần bài toán nhanh hơn torch.compile).
Opus-4.6 Max dẫn đầu với 2,63x/98%, nhưng Qwen3.7-Max bỏ xa K2.6 Thinking (1,41x/80%), GLM-5.1 (2,00x/78%) và DS-V4-Pro Max (1,07x/54%). Trên MRCR-v2 128k, bài kiểm tra truy xuất ngữ cảnh dài, mô hình đạt 90,4, vượt Qwen3.6-Plus (85,9) và Opus-4.6 Max (84,0).
Điểm chuẩn STEM và suy luận
GPQA Diamond kiểm tra các câu hỏi khoa học cấp tiến sĩ. Qwen3.7-Max đạt 92,4, vượt Opus-4.6 Max (91,3), K2.6 Thinking (90,5) và DS-V4-Pro Max (90,1).
Trong bài đánh giá về GPT-5.5, chúng tôi ghi nhận mô hình đạt 93,6% trên GPQA Diamond, nên GPT-5.5 vẫn dẫn đầu ở benchmark cụ thể này, dù so sánh trực tiếp cần lưu ý điều kiện đánh giá khác nhau.
Trên HLE (Humanity's Last Exam), Qwen3.7-Max đạt 41,4, vượt Opus-4.6 Max (40,0) và Deepseek-V4-Pro Max (37,7).
Trên HMMT 2026 Feb (toán thi đấu), mô hình đạt 97,1, cao nhất trong bảng, vượt Opus-4.6 Max (96,2) và DS-V4-Pro Max (95,2).
Trên IMOAnswerBench, đạt 90,0, nhỉnh hơn 89,8 của DS-V4-Pro Max. Trên Apex, đạt 44,5, vượt xa 38,3 của DS-V4-Pro Max và 34,5 của Opus-4.6 Max.
Điểm chuẩn đa ngôn ngữ
Qwen3.7-Max dẫn đầu trên WMT24++ (85,8 so với 84,3 của Qwen3.6-Plus và 82,7 của Opus-4.6 Max), kiểm tra chất lượng dịch trên 55 ngôn ngữ. Trên MAXIFE, đạt 89,2, vượt 88,9 của DS-V4-Pro Max. Trên PolyMATH, đạt 86,5, vượt xa 80,2 của Opus-4.6 Max và 82,7 của K2.6 Thinking.
Hiệu suất đa ngôn ngữ là điểm mạnh nhất quán của dòng Qwen3.x, và Qwen3.7-Max tiếp tục nới rộng lợi thế đó.
Giá và khả dụng của Qwen3.7-Max
Qwen3.7-Max có trên Alibaba Cloud Model Studio, với truy cập API qua cả endpoint tương thích OpenAI và Anthropic. ID mô hình là
qwen3.7-max.Thời điểm viết bài, Artificial Analysis ghi nhận giá vào/ra lần lượt là 2,50 USD cho 1M token đầu vào và 7,50 USD cho đầu ra.
Mức độ dài dòng cao do Artificial Analysis nêu (97M token tạo ra trong đánh giá so với trung vị 24M) có nghĩa chi phí thực tế cho các phiên tác tử kéo dài có thể cao đáng kể so với mức giá trên mỗi token.
Đối với nhà phát triển, mô hình hỗ trợ tính năng
preserve_thinking, giữ lại nội dung suy luận từ tất cả lượt trước trong hội thoại nhiều lượt. Đội ngũ Qwen khuyến nghị bật tính năng này cho các tác vụ tác tử. Tích hợp với Claude Code, OpenClaw và Qwen Code được hỗ trợ sẵn, với ví dụ cấu hình trong tài liệu chính thức.Kết luận
Qwen3.7-Max là một đối thủ đáng gờm ở phân khúc đầu bảng của thị trường mô hình tác tử. Các con số benchmark mạnh trên diện rộng, và màn trình diễn tối ưu hóa kernel 35 giờ là kết quả cụ thể, có thể kiểm chứng, khó bị xem nhẹ như một vị trí trên bảng xếp hạng.
Câu chuyện khái quát hóa xuyên harness cũng thuyết phục: huấn luyện trên các cấu hình harness đa dạng là cách tiếp cận có cơ sở để giải quyết vấn đề overfitting vào scaffold, và hiệu suất ổn định trên Claude Code, OpenClaw và Qwen Code củng cố điều đó.
Điểm tôi thận trọng là độ dài dòng. Một mô hình tạo 97M token trong bộ đánh giá tiêu chuẩn sẽ tốn kém hơn nhiều trong thực tế so với mức giá trên mỗi token, đặc biệt với các phiên tác tử dài hạn vốn là trường hợp sử dụng chính.
Các đội ngũ xây dựng trên Qwen3.7-Max nên dự trù ngân sách cẩn thận và thử nghiệm với các ràng buộc đầu ra rõ ràng trước khi cam kết khối lượng công việc sản xuất.
Nếu bạn muốn xây dựng trên các mô hình như Qwen3.7-Max hoặc hiểu sâu hơn về bối cảnh AI tác tử, tôi khuyến nghị xem lộ trình kỹ năng AI Fundamentals trên DataCamp để nắm vững các khái niệm nền tảng của những hệ thống này.