
Leerpad
Basisprincipes van AI-agenten
6 uur
De race om het beste agentische AI-model wordt steeds drukker. Claude Opus 4.6 van Anthropic, DeepSeek V4 Pro en Kimi K2.6 claimden de afgelopen maanden allemaal de topposities op de coding- en redeneer-leaderboards. Nu komt Alibaba's Qwen-team met Qwen3.7-Max, een propriëtair vlaggenschipmodel dat ze beschrijven als specifiek gebouwd voor het agent-tijdperk.
De headlinecijfers zijn de moeite waard om op te letten. Op GPQA Diamond scoort Qwen3.7-Max 92,4, beter dan Claude Opus 4.6 Max met 91,3. Op de Apex-redeneerbenchmark scoort het 44,5 tegenover 38,3 voor DeepSeek V4 Pro. En in een autonome kerneloptimalisatie-run van 35 uur deed het model 1.158 tool-calls en behaalde het een 10x geometrisch gemiddelde versnelling ten opzichte van de Triton-referentie-implementatie.
In dit artikel behandel ik alles wat nieuw is aan Qwen3.7-Max: de belangrijkste functies, de benchmarkresultaten en een aantal hands-on tests die je zelf kunt uitvoeren. Bekijk ook onze artikelen over Gemini 3.5 Flash en Gemini Omni voor context over waar de bredere frontier zich nu bevindt.
Qwen3.7-Max is Alibaba's nieuwste propriëtaire model, gepositioneerd als de top van de Qwen3.x-familie boven Qwen3.6-Plus.
Het is een closed-source model dat via API toegankelijk is via Alibaba Cloud Model Studio, met een contextvenster van 1 miljoen tokens en uitsluitend tekstinvoer en -uitvoer. Het Qwen-team omschrijft het als een "veelzijdige agentbasis" in plaats van een algemene chatassistent.
Vergeleken met Qwen3.6-Plus zijn de verbeteringen aanzienlijk in elke categorie. Op Terminal Bench 2.0-Terminus scoort Qwen3.7-Max 69,7 tegenover 61,6 voor Qwen3.6-Plus. In de YC-Bench-startupsimulatie behaalde het 2,08 miljoen USD aan totale omzet, het dubbele van de 1,05 miljoen USD van Qwen3.6-Plus. Het gat is het grootst bij agenttaken met een lange horizon, precies waar het team zegt de training op te hebben gericht.
De Artificial Analysis Intelligence Index geeft Qwen3.7-Max een score van 56,6, waarmee het boven concurrenten staat en net onder enkele van de beste frontier-modellen.
Eén punt om vroeg te benoemen: het model is opvallend breedsprakig. Artificial Analysis observeerde ongeveer 97 miljoen tokens tijdens hun evaluatie, veel hoger dan de mediaan van 24 miljoen. Die breedsprakigheid heeft kostenimplicaties voor lange agent-sessies; daar kom ik op terug in de prijzensectie.
Qwen3.7-Max introduceert verschillende mogelijkheden die het onderscheiden van zowel zijn voorganger als de huidige frontier-modellen. De focus ligt consequent op langdurige, autonome uitvoering in plaats van enkelvoudige beurten.
De meest opvallende demonstratie in de release is de kerneloptimalisatie-run van 35 uur.
Kort gezegd gaf het Qwen-team de AI een pittig programmeerprobleem (GPU-code optimaliseren), met alleen instructies en een manier om het werk te testen, en trok zich daarna terug. Vanaf daar werkte Qwen3.7-Max autonoom: code schrijven, tests draaien, bottlenecks vinden en de code herontwerpen. Het doorliep deze cyclus meer dan duizend keer.
Het eindresultaat liet de code 10 keer sneller draaien dan de standaardbaseline, allemaal gecreëerd op computerhardware die het model niet eerder had gezien.
Qwen3.7 Max vond zelfs na de grens van 30 uur nog zinvolle manieren om de code te versnellen. Het plukte niet alleen het laaghangende fruit en stopte daarna.
Andere topmodellen zoals GLM 5.1, Kimi K2.6 en DeepSeek V4 Pro haakten veel eerder af (met respectievelijk maximaal 7,3x, 5,0x en 3,3x sneller).
Dit laat zien dat Qwen3.7-Max niet alleen goed is in het beantwoorden van een snelle programmeervraag met één prompt. Je kunt het een omvangrijk, uitputtend optimalisatieproject geven, weglopen en erop vertrouwen dat het langdurig volledig gefocust blijft zonder in de war te raken of de draad kwijt te raken.
De meeste agentmodellen worden getraind en geëvalueerd op een specifieke scaffold, waardoor hun benchmarkcijfers harness-specifieke shortcuts kunnen weerspiegelen in plaats van echt probleemoplossen.
Qwen3.7-Max is ontworpen om dit te vermijden via een trainingsinfrastructuur die Task, Harness en Verifier loskoppelt tot drie onafhankelijke componenten die vrij gecombineerd kunnen worden.
In de praktijk betekent dit dat het model is getraind op identieke taken in combinatie met diverse harnesses en verifiers, waardoor het gedwongen werd generaliseerbare strategieën te leren.
De benchmarkresultaten weerspiegelen dit: Qwen3.7-Max presteert consistent, of het nu wordt ingezet via Claude Code, OpenClaw, Qwen Code of eigen tool-use frameworks. Op QwenClawBench en CoWorkBench blijft de performance overeind, ongeacht welke harness bij evaluatie wordt gebruikt.
Voor teams die agent-systemen bouwen is dit belangrijk, omdat Qwen3.7-Max kan dienen als drop-in ruggengraat zonder frameworkspecifieke tuning. Dat is een echt operationeel voordeel ten opzichte van modellen die alleen goed presteren in hun eigen scaffold.
Qwen3.7-Max ondersteunt native integratie met Model Context Protocol (MCP), waardoor het op een gestandaardiseerde manier verbinding kan maken met externe tools en databronnen.
Op MCP-Mark scoort het 60,8, voor GLM-5.1 Thinking met 57,5 en Opus-4.6 Max met 56,7. Op MCP-Atlas scoort het 76,4, net boven de 75,8 van Opus-4.6 Max.
De kantoorautomatiseringshoek is het vermelden waard. Op SpreadSheetBench-v1 scoort Qwen3.7-Max 87,0, alleen overtroffen door de 89,3 van Opus-4.6 Max.
Het Qwen-team demonstreert dit met een thesis-opmaaktaak waarbij het model een opmaakspecificatiedocument leest en autonoom een rommelige conceptversie herformatteert. Het fixt paginalay-out, kopstijlen, lettertypen, marges, inhoudsopgave en referenties via autonome office-cli tool-calls.
Een van de meer ongewone features in deze release is een self-monitoring framework voor RL-training. Tijdens RL-experimenten van meer dan 80 uur haalde Qwen3.7-Max autonoom trainingstrajecten op en speelde die terug, met meer dan 10.000 calls om patronen van reward hacking te identificeren.
Die omvatten pogingen om beperkingen te omzeilen en grondwaarheidsantwoorden op GitHub te benaderen.
Het systeem voerde regelverificatie, het mijnen van tegenvoorbeelden en iteratieve optimalisatie uit, wat uiteindelijk 13 nieuwe heuristische regels opleverde en 1.618 hackinggevallen nauwkeurig markeerde.
Dit is minder een user-facing feature en meer een signaal over hoe het model is getraind, maar het is relevant voor teams die overwegen Qwen3.7-Max in eigen RL-pijplijnen in te zetten.
Qwen3.7-Max kan nu een robothond bedienen via tool-use calls, met behulp van de Qwen-RobotClaw agent-harness en het Qwen-RobotNav navigatiefundamentmodel.
Het model handelt fysiek begrip, planning, geheugen en besluitvorming af in echte omgevingen. Dit wordt gedemonstreerd in een agentsessie van 20 minuten waarin de robot een fysieke ruimte navigeert met het langetermijngeheugen van het model en first-person visuele input.
Ik zou dit niet overschatten als een productierijp robotica-platform, maar het illustreert wel de breedte van het agent-framework. Dezelfde tool-calling-infrastructuur die spreadsheetautomatisering en kerneloptimalisatie afhandelt, strekt zich ook uit tot navigatie in de fysieke wereld.
Laten we de benchmarkgegevens in meer detail bekijken.
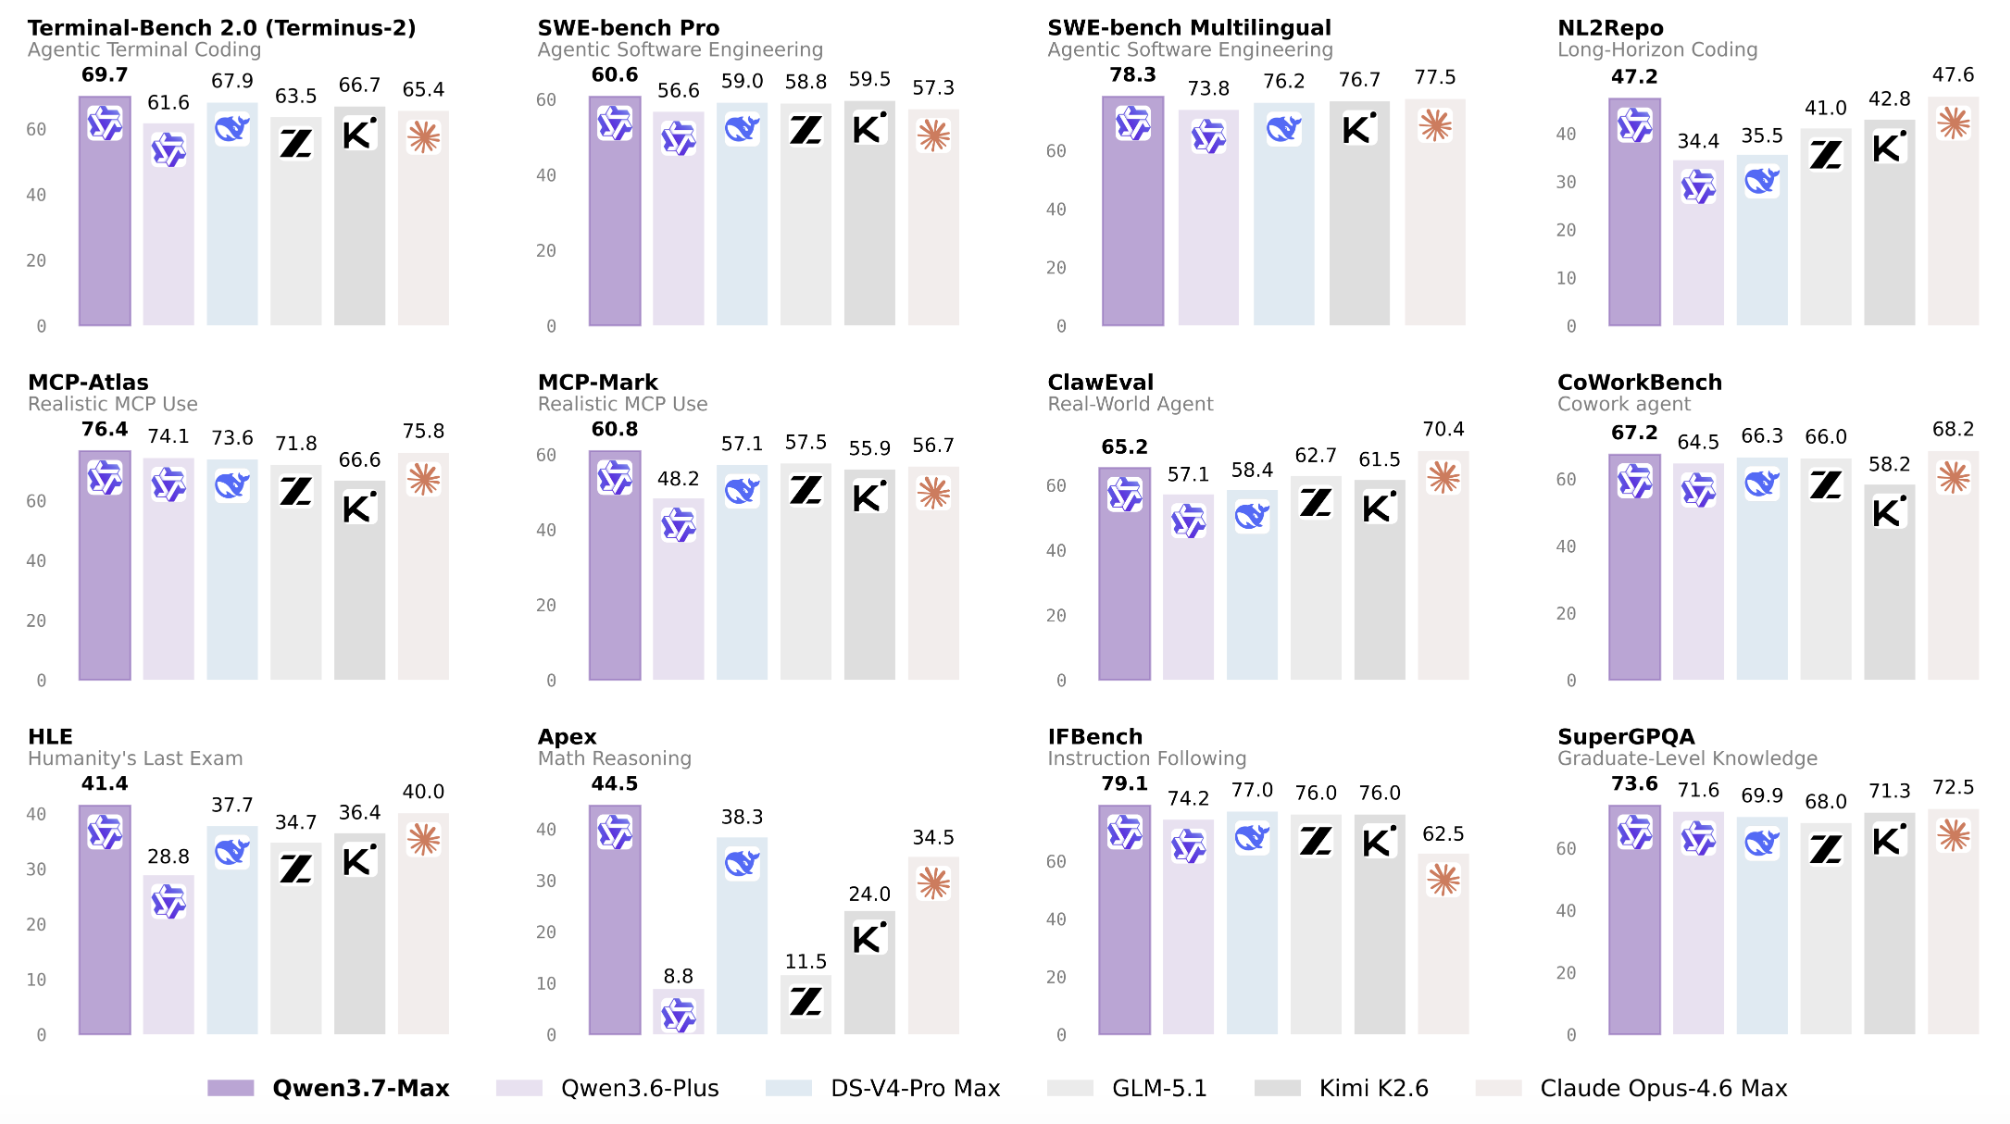
Qwen3.7-Max is geëvalueerd binnen vier brede categorieën: coding agents, algemene agents, STEM-redeneren en algemene capaciteiten, inclusief meertalige prestaties.
De resultaten zijn afkomstig uit een grote verscheidenheid aan agent-scaffolds, wat ze betekenisvoller maakt dan cijfers uit één enkele scaffold.
Op Terminal Bench 2.0-Terminus scoort Qwen3.7-Max 69,7, voor DeepSeek-V4-Pro Max (67,9), Opus-4.6 Max (65,4) en K2.6 Thinking (66,7).
Deze benchmark test autonome, terminalgebaseerde software-engineering met een timeout van 5 uur en 12 CPU-cores. Op SWE-Pro scoort het 60,6, de hoogste score in de vergelijkingstabel, voor K2.6 Thinking (59,5) en DS-V4-Pro Max (59,0).
SWE-Verified is de ene benchmark waarop Qwen3.7-Max niet vooroploopt: het scoort 80,4 tegenover 80,8 voor Opus-4.6 Max en 80,6 voor DS-V4-Pro Max.
Het gat is klein, maar noemenswaardig. Op SWE-Multilingual (78,3) en SciCode (53,5) voert het de lijst aan. Op QwenSVG scoort het 1608, net voor de 1605 van GLM-5.1 Thinking en de 1541 van Opus-4.6 Max.
De algemene agentresultaten zijn waar Qwen3.7-Max zijn sterkste argument maakt. Op MCP-Mark scoort het 60,8 tegenover 57,5 voor GLM-5.1 en 56,7 voor Opus-4.6.
Op MCP-Atlas scoort het 76,4, net boven de 75,8 van Opus-4.6. Op Skillsbench scoort het 59,2 tegenover 56,2 voor K2.6 Thinking. Op SpreadSheetBench-v1 scoort het 87,0, alleen overtroffen door de 89,3 van Opus-4.6 Max.
Het Kernel Bench L3-resultaat verdient aparte vermelding. Qwen3.7-Max behaalt een mediane versnelling van 1,98x met een winrate van 96% (aandeel problemen sneller dan torch.compile).
Opus-4.6 Max voert hier aan met 2,63x/98%, maar Qwen3.7-Max ligt ruim voor op K2.6 Thinking (1,41x/80%), GLM-5.1 (2,00x/78%) en DS-V4-Pro Max (1,07x/54%). Op MRCR-v2 128k, dat long-context retrieval test, scoort het 90,4, voor Qwen3.6-Plus (85,9) en Opus-4.6 Max (84,0).
GPQA Diamond test natuurwetenschappelijke vragen op PhD-niveau. Qwen3.7-Max scoort 92,4, voor Opus-4.6 Max (91,3), K2.6 Thinking (90,5) en DS-V4-Pro Max (90,1).
In onze review van GPT-5.5 merkten we op dat het 93,6% scoorde op GPQA Diamond, dus GPT-5.5 leidt nog steeds op deze specifieke benchmark, al vereist een directe vergelijking oog voor de verschillende evaluatiecondities.
Op HLE (Humanity's Last Exam) scoort Qwen3.7-Max 41,4, voor Opus-4.6 Max (40,0) en Deepseek-V4-Pro Max (37,7).
Op HMMT 2026 Feb (competitiewiskunde) scoort het 97,1, de hoogste score in de tabel, voor Opus-4.6 Max (96,2) en DS-V4-Pro Max (95,2).
Op IMOAnswerBench scoort het 90,0, net boven de 89,8 van DS-V4-Pro Max. Op de Apex-benchmark scoort het 44,5, ruim voor DS-V4-Pro Max met 38,3 en Opus-4.6 Max met 34,5.
Qwen3.7-Max leidt op WMT24++ (85,8 vs. 84,3 voor Qwen3.6-Plus en 82,7 voor Opus-4.6 Max), dat de vertaalkwaliteit over 55 talen test. Op MAXIFE scoort het 89,2, voor de 88,9 van DS-V4-Pro Max. Op PolyMATH scoort het 86,5, ruim voor Opus-4.6 Max (80,2) en K2.6 Thinking (82,7).
Meertalige performance is een consistente kracht in de Qwen3.x-lijn, en Qwen3.7-Max vergroot die voorsprong.
Qwen3.7-Max is beschikbaar via Alibaba Cloud Model Studio, met API-toegang via zowel OpenAI-compatibele als Anthropic-compatibele endpoints. De model-ID is qwen3.7-max.
Op het moment van schrijven vermeldt Artificial Analysis de input- en outputprijzen als $2,50 per 1M tokens input, en $7,50 voor output.
De hoge breedsprakigheid die door Artificial Analysis is gesignaleerd (97M tokens gegenereerd in hun evaluatie vs. een mediaan van 24M) betekent dat de effectieve kosten voor lange agent-sessies aanzienlijk hoger kunnen uitvallen dan de headline per-token tarieven doen vermoeden.
Voor developers ondersteunt het model de functie preserve_thinking, die denkcontent uit alle voorgaande beurten in meer-ronde gesprekken bewaart. Het Qwen-team raadt aan dit in te schakelen voor agenttaken. Integratie met Claude Code, OpenClaw en Qwen Code wordt out-of-the-box ondersteund, met configuratievoorbeelden in de officiële documentatie.
Qwen3.7-Max is een serieuze nieuwkomer aan de top van de agentische modelmarkt. De benchmarkcijfers zijn overal sterk, en de 35 uur durende kerneloptimalisatie-demonstratie is het soort concreet, verifieerbaar resultaat dat moeilijker te negeren is dan een leaderboardpositie.
Het verhaal rond cross-harness generalisatie is ook geloofwaardig: trainen op diverse harnessconfiguraties is een principiële aanpak voor het probleem van scaffold-overfitting, en de consistente prestaties over Claude Code, OpenClaw en Qwen Code ondersteunen dat.
Waar ik voorzichtig zou zijn is de breedsprakigheid. Een model dat 97M tokens genereert in een standaard evaluatiesuite, gaat in de praktijk aanzienlijk meer kosten dan het per-tokentarief doet vermoeden, vooral voor de langlopende agent-sessies die de primaire usecase vormen.
Teams die op Qwen3.7-Max willen bouwen, doen er goed aan zorgvuldig te budgetteren en te testen met expliciete outputbeperkingen voordat ze zich vastleggen op productie-workloads.
Wil je bouwen bovenop modellen zoals Qwen3.7-Max of het agentische AI-landschap beter begrijpen, bekijk dan de AI Fundamentals skill track op DataCamp om snel bij te spijkeren over de concepten achter deze systemen.
Topcursussen op DataCamp
Leerpad
Cursus
Cursus