Program
Dasar-Dasar Agen Kecerdasan Buatan
6 jam
Persaingan untuk model AI agen terbaik semakin padat. Claude Opus 4.6 dari Anthropic, DeepSeek V4 Pro, dan Kimi K2.6 telah menempati puncak papan peringkat pengkodean dan penalaran dalam beberapa bulan terakhir. Kini, tim Qwen dari Alibaba hadir dengan Qwen3.7-Max, model andalan proprietary yang mereka gambarkan sebagai dibangun khusus untuk era agen.
Angka utamanya patut diperhatikan. Pada GPQA Diamond, Qwen3.7-Max meraih skor 92,4, mengungguli 91,3 milik Claude Opus 4.6 Max. Pada tolok ukur penalaran Apex, model ini mencetak 44,5 dibanding 38,3 milik DeepSeek V4 Pro. Dan dalam uji optimisasi kernel otonom selama 35 jam, model ini melakukan 1.158 panggilan alat dan mencapai percepatan mean geometri 10x dibanding implementasi referensi Triton.
Dalam artikel ini, saya akan membahas semua hal baru di Qwen3.7-Max, menyoroti fitur utamanya, menelusuri hasil tolok ukur, dan mengusulkan pengujian langsung yang bisa Anda jalankan sendiri. Anda juga bisa melihat ulasan kami tentang Gemini 3.5 Flash dan Gemini Omni sebagai konteks untuk melihat posisi frontier yang lebih luas saat ini.
Qwen3.7-Max adalah model proprietary terbaru dari Alibaba, diposisikan sebagai tier teratas keluarga Qwen3.x di atas Qwen3.6-Plus.
Ini adalah model tertutup yang dapat diakses melalui API di Alibaba Cloud Model Studio, dengan jendela konteks 1 juta token dan masukan serta keluaran hanya teks. Tim Qwen menyebutnya sebagai "fondasi agen serbaguna" alih-alih model chat tujuan umum.
Dibandingkan Qwen3.6-Plus, peningkatannya substansial di setiap kategori. Pada Terminal Bench 2.0-Terminus, Qwen3.7-Max meraih 69,7 dibanding 61,6 milik Qwen3.6-Plus. Pada simulasi startup YC-Bench, model ini mencapai total pendapatan 2,08 juta USD, dua kali lipat dari 1,05 juta USD milik Qwen3.6-Plus. Kesenjangan paling lebar terjadi pada tugas agen berjangka panjang, yang memang menjadi fokus upaya pelatihan mereka.
Artificial Analysis Intelligence Index memberi Qwen3.7-Max skor 56,6, menempatkannya di atas para pesaing dan sedikit di bawah beberapa model frontier terbaik.
Satu hal yang perlu dicatat sejak awal: model ini tergolong verbose. Artificial Analysis mengamati sekitar 97 juta token dihasilkan selama evaluasi mereka, jauh di atas median 24 juta. Verbositas itu berdampak pada biaya untuk sesi agen yang panjang, yang akan saya bahas kembali di bagian harga.
Qwen3.7-Max memperkenalkan sejumlah kapabilitas yang membedakannya dari pendahulunya dan jajaran model frontier saat ini. Fokusnya adalah pada eksekusi otonom berkelanjutan, bukan performa satu giliran.
Demonstrasi paling mencolok dalam rilis ini adalah uji optimisasi kernel selama 35 jam.
Intinya, tim Qwen memberikan AI sebuah masalah pengkodean yang sulit (mengoptimalkan kode GPU), hanya dengan instruksi dan cara untuk menguji hasil kerjanya, lalu mundur. Dari sana, Qwen3.7-Max bekerja secara otonom, menulis kode, menjalankan pengujian, menemukan bottleneck, dan merancang ulang kodenya. Ia mengulangi proses ini lebih dari seribu kali.
Hasil akhirnya membuat kode berjalan 10 kali lebih cepat daripada baseline standar, semuanya dilakukan pada perangkat keras komputer yang belum pernah ditemuinya sebelumnya.
Qwen3.7 Max masih menemukan cara-cara bermakna untuk mempercepat kode bahkan setelah melewati 30 jam. Ia tidak sekadar mengambil perbaikan mudah lalu berhenti.
Model kelas atas lainnya seperti GLM 5.1, Kimi K2.6, dan DeepSeek V4 Pro berhenti jauh lebih awal (maksimal 7,3x, 5,0x, dan 3,3x lebih cepat, masing-masing).
Ini menunjukkan bahwa Qwen3.7-Max tidak hanya unggul menjawab pertanyaan pengkodean cepat dalam satu prompt. Anda bisa menyerahkan proyek optimisasi besar dan melelahkan, pergi, dan percaya bahwa model ini akan tetap fokus sepenuhnya tanpa bingung atau kehilangan arah dalam jangka panjang.
Kebanyakan model agen dilatih dan dievaluasi pada scaffold tertentu, yang berarti angka tolok ukur mereka bisa mencerminkan jalan pintas spesifik harness alih-alih pemecahan masalah yang sejati.
Qwen3.7-Max dirancang untuk menghindari hal ini melalui infrastruktur pelatihan yang memisahkan Task, Harness, dan Verifier menjadi tiga komponen independen yang dapat dikombinasikan ulang dengan bebas.
Dalam praktiknya, ini berarti model dilatih pada tugas identik yang dipasangkan dengan beragam harness dan verifier, memaksanya mempelajari strategi yang dapat digeneralisasi.
Hasil tolok ukurnya mencerminkan hal ini: Qwen3.7-Max tampil konsisten baik saat digunakan melalui Claude Code, OpenClaw, Qwen Code, maupun kerangka tool-use kustom. Pada QwenClawBench dan CoWorkBench, performa tetap terjaga terlepas dari harness yang digunakan saat evaluasi.
Bagi tim yang membangun sistem agen, ini penting karena Qwen3.7-Max dapat menjadi tulang punggung drop-in tanpa memerlukan penyesuaian khusus kerangka. Itu adalah keunggulan operasional nyata dibanding model yang hanya tampil baik di scaffold asalnya.
Qwen3.7-Max mendukung integrasi native dengan Model Context Protocol (MCP), yang memungkinkannya terhubung ke alat dan sumber data eksternal secara terstandar.
Pada MCP-Mark, model ini meraih 60,8, di depan 57,5 milik GLM-5.1 Thinking dan 56,7 milik Opus-4.6 Max. Pada MCP-Atlas, ia mencetak 76,4, sedikit di atas 75,8 milik Opus-4.6 Max.
Sudut otomasi perkantoran patut disorot terpisah. Pada SpreadSheetBench-v1, Qwen3.7-Max meraih 87,0, kedua setelah 89,3 milik Opus-4.6 Max.
Tim Qwen mendemonstrasikannya melalui tugas pemformatan tesis di mana model membaca dokumen spesifikasi format dan secara otonom memformat ulang draf yang berantakan, memperbaiki tata letak halaman, gaya heading, font, margin, daftar isi, dan referensi melalui panggilan alat office-cli yang otonom.
Salah satu fitur yang cukup tidak biasa dalam rilis ini adalah kerangka self-monitoring untuk pelatihan RL. Selama eksperimen RL lebih dari 80 jam, Qwen3.7-Max secara otonom mengambil dan memutar ulang lintasan pelatihan, mengeksekusi lebih dari 10.000 panggilan untuk mengidentifikasi pola reward hacking.
Ini mencakup upaya melewati batasan dan mengakses jawaban ground-truth di GitHub.
Sistem melakukan verifikasi aturan, penambangan contoh tandingan, dan optimisasi iteratif, yang pada akhirnya menambahkan 13 aturan heuristik baru dan secara akurat menandai 1.618 kasus hacking.
Ini bukan fitur langsung untuk pengguna, melainkan sinyal tentang bagaimana model dilatih, namun relevan bagi tim yang mempertimbangkan menerapkan Qwen3.7-Max dalam pipeline RL mereka sendiri.
Qwen3.7-Max kini dapat mengoperasikan robot anjing melalui panggilan tool-use, menggunakan harness agen Qwen-RobotClaw dan model fondasi navigasi Qwen-RobotNav.
Model ini menangani pemahaman fisik, perencanaan, memori, dan pengambilan keputusan di lingkungan nyata. Ini didemonstrasikan dalam sesi agen 20 menit di mana robot menavigasi ruang fisik menggunakan memori jangka panjang model dan masukan visual sudut pandang pertama.
Saya tidak akan menyatakan ini sebagai platform robotika siap produksi, tetapi hal ini menggambarkan keluasan kerangka agen. Infrastruktur pemanggilan alat yang sama yang menangani otomasi spreadsheet dan optimisasi kernel juga meluas ke navigasi dunia fisik.
Mari kita lihat data tolok ukurnya lebih detail.
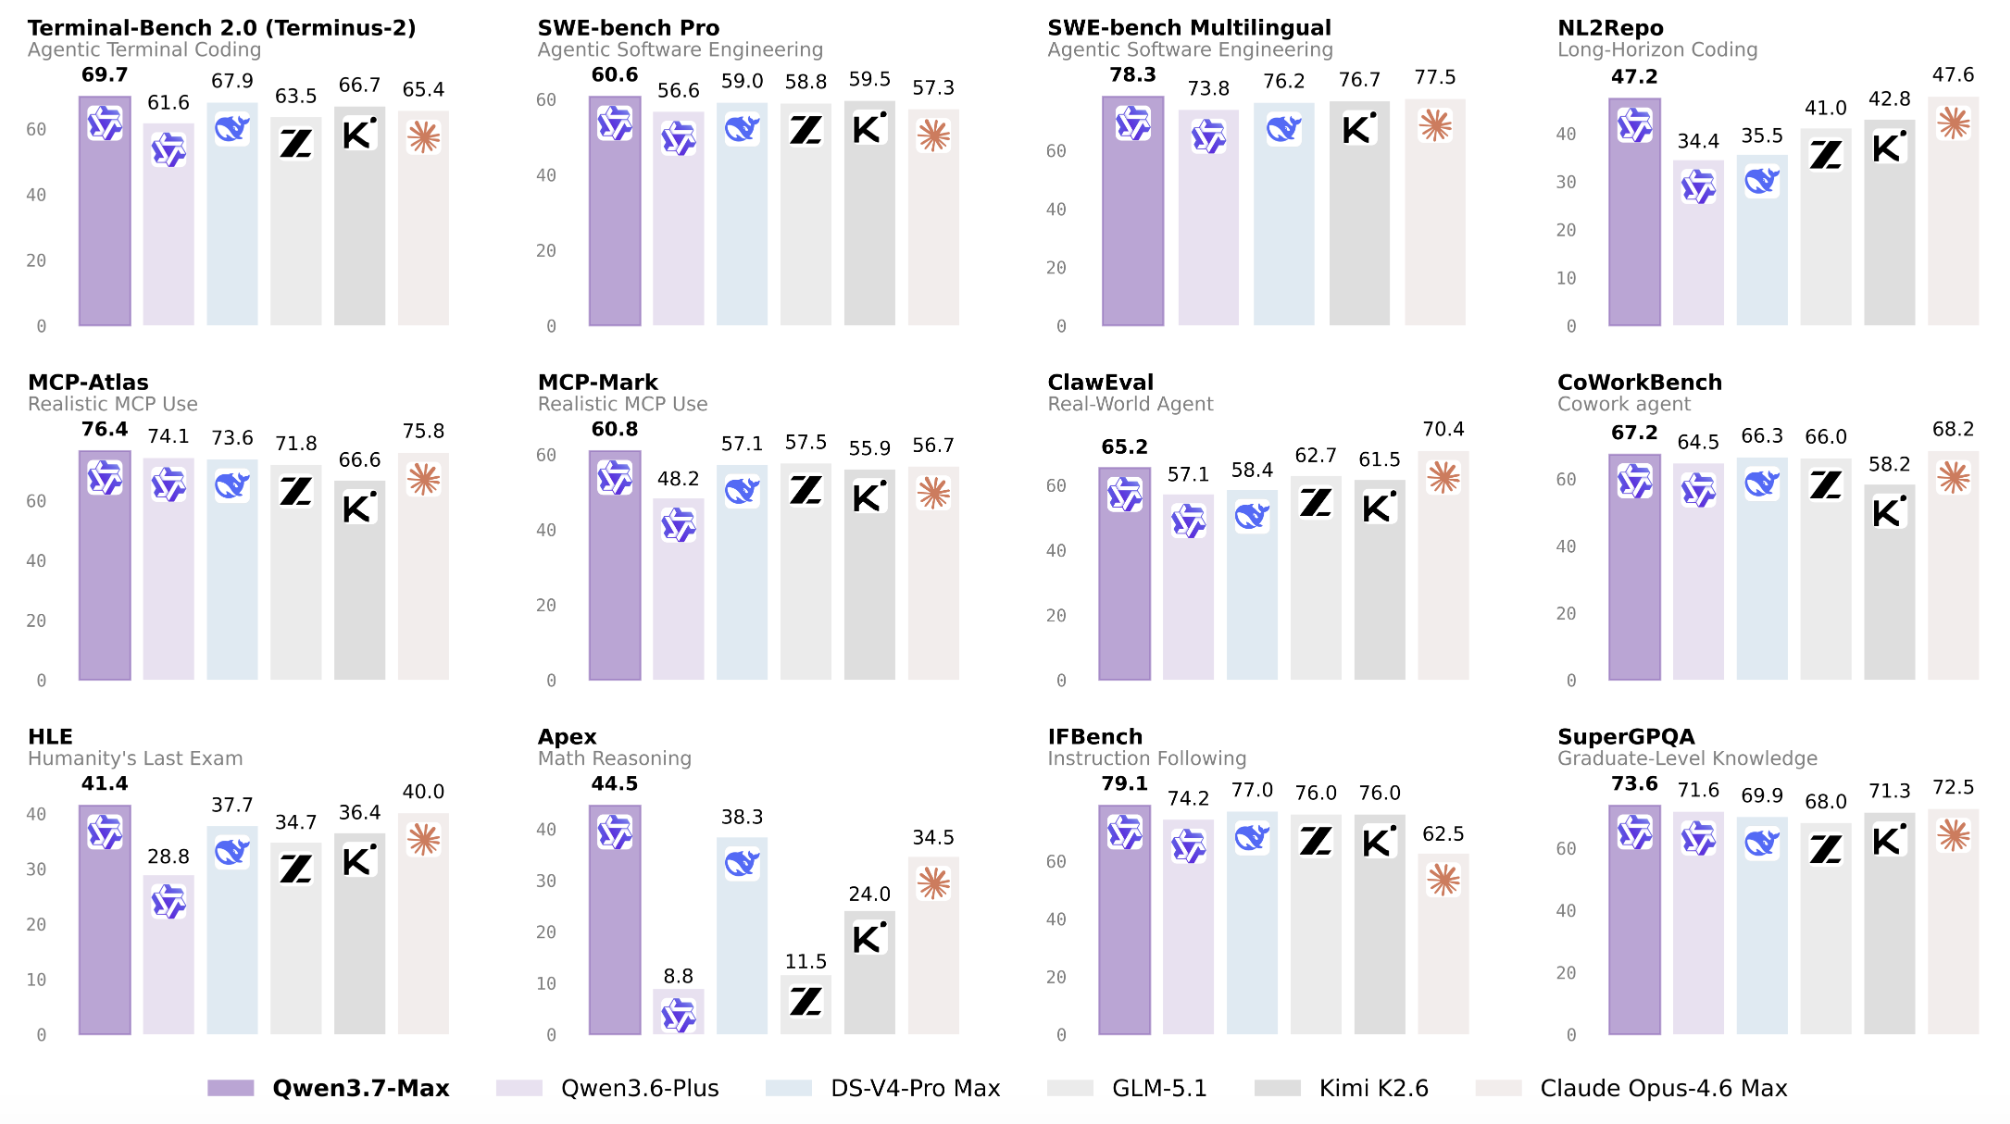
Qwen3.7-Max dievaluasi dalam empat kategori luas: agen pengkodean, agen tujuan umum, penalaran STEM, dan kapabilitas umum, termasuk performa multibahasa.
Hasilnya diambil dari beragam scaffold agen, yang membuatnya lebih bermakna dibanding angka dari satu scaffold.
Pada Terminal Bench 2.0-Terminus, Qwen3.7-Max meraih 69,7, di depan DeepSeek-V4-Pro Max (67,9), Opus-4.6 Max (65,4), dan K2.6 Thinking (66,7).
Tolok ukur ini menguji rekayasa perangkat lunak berbasis terminal otonom dengan batas waktu 5 jam dan 12 inti CPU. Pada SWE-Pro, model ini meraih 60,6, tertinggi dalam tabel perbandingan, di depan K2.6 Thinking (59,5) dan DS-V4-Pro Max (59,0).
SWE-Verified adalah satu-satunya tolok ukur di mana Qwen3.7-Max tidak memimpin: ia mencetak 80,4 dibanding 80,8 milik Opus-4.6 Max dan 80,6 milik DS-V4-Pro Max.
Kesenjangannya kecil, tetapi patut dicatat. Pada SWE-Multilingual (78,3) dan SciCode (53,5), ia memimpin. Pada QwenSVG, model ini meraih 1608, di depan 1605 milik GLM-5.1 Thinking dan 1541 milik Opus-4.6 Max.
Hasil agen umum adalah tempat Qwen3.7-Max membuat argumen terkuatnya. Pada MCP-Mark, model ini meraih 60,8 dibanding 57,5 milik GLM-5.1 dan 56,7 milik Opus-4.6.
Pada MCP-Atlas, model ini meraih 76,4, sedikit mengungguli 75,8 milik Opus-4.6. Pada Skillsbench, ia mengumpulkan 59,2 dibanding 56,2 milik K2.6 Thinking. Pada SpreadSheetBench-v1, ia mendapat 87,0, kedua setelah 89,3 milik Opus-4.6 Max.
Hasil Kernel Bench L3 layak disebut tersendiri. Qwen3.7-Max mencapai percepatan median 1,98x dengan tingkat kemenangan 96% (fraksi masalah yang lebih cepat daripada torch.compile).
Opus-4.6 Max memimpin di sini dengan 2,63x/98%, tetapi Qwen3.7-Max jauh di depan K2.6 Thinking (1,41x/80%), GLM-5.1 (2,00x/78%), dan DS-V4-Pro Max (1,07x/54%). Pada MRCR-v2 128k, yang menguji pengambilan konteks panjang, ia mencetak 90,4, di depan Qwen3.6-Plus (85,9) dan Opus-4.6 Max (84,0).
GPQA Diamond menguji pertanyaan sains level PhD. Qwen3.7-Max mencetak 92,4, di depan Opus-4.6 Max (91,3), K2.6 Thinking (90,5), dan DS-V4-Pro Max (90,1).
Dalam ulasan kami tentang GPT-5.5, kami mencatat model tersebut mencetak 93,6% pada GPQA Diamond, jadi GPT-5.5 masih memimpin pada tolok ukur spesifik ini, meski perbandingan langsung perlu memperhatikan kondisi evaluasi yang berbeda.
Pada HLE (Humanity's Last Exam), Qwen3.7-Max mencetak 41,4, di depan Opus-4.6 Max (40,0) dan Deepseek-V4-Pro Max (37,7).
Pada HMMT 2026 Feb (matematika kompetisi), ia mencetak 97,1, tertinggi dalam tabel, di depan Opus-4.6 Max (96,2) dan DS-V4-Pro Max (95,2).
Pada IMOAnswerBench, model ini mencetak 90,0, sedikit di atas 89,8 milik DS-V4-Pro Max. Pada tolok ukur Apex, ia mencetak 44,5, jauh di depan 38,3 milik DS-V4-Pro Max dan 34,5 milik Opus-4.6 Max.
Qwen3.7-Max memimpin pada WMT24++ (85,8 vs. 84,3 milik Qwen3.6-Plus dan 82,7 milik Opus-4.6 Max), yang menguji kualitas terjemahan di 55 bahasa. Pada MAXIFE, ia mencetak 89,2, di depan 88,9 milik DS-V4-Pro Max. Pada PolyMATH, ia mencetak 86,5, jauh di depan 80,2 milik Opus-4.6 Max dan 82,7 milik K2.6 Thinking.
Performa multibahasa merupakan kekuatan konsisten di lini Qwen3.x, dan Qwen3.7-Max memperlebar keunggulan itu.
Qwen3.7-Max tersedia melalui Alibaba Cloud Model Studio, dengan akses API lewat endpoint yang kompatibel dengan OpenAI dan Anthropic. ID modelnya adalah qwen3.7-max.
Pada saat penulisan, Artificial Analysis mencantumkan harga masuk dan keluar masing-masing $2,50 per 1M token untuk input, dan $7,50 untuk output.
Verbositas tinggi yang disorot oleh Artificial Analysis (97M token dihasilkan dalam evaluasi mereka vs. median 24M) berarti biaya efektif untuk sesi agen yang panjang bisa jauh lebih tinggi daripada yang disiratkan tarif per token utama.
Bagi pengembang, model ini mendukung fitur preserve_thinking, yang mempertahankan konten pemikiran dari semua giliran sebelumnya dalam percakapan multi-giliran. Tim Qwen merekomendasikan mengaktifkan ini untuk tugas agen. Integrasi dengan Claude Code, OpenClaw, dan Qwen Code didukung langsung, dengan contoh konfigurasi tersedia dalam dokumentasi resmi.
Qwen3.7-Max adalah entri serius di puncak pasar model agen. Angka tolok ukurnya kuat di seluruh aspek, dan demonstrasi optimisasi kernel 35 jam adalah hasil konkret dan terverifikasi yang lebih sulit diabaikan dibanding sekadar posisi di papan peringkat.
Kisah generalisasi lintas-harness juga kredibel: pelatihan pada konfigurasi harness yang beragam adalah pendekatan yang berprinsip untuk masalah overfitting scaffold, dan performa konsisten di Claude Code, OpenClaw, dan Qwen Code menguatkannya.
Area yang saya waspadai adalah verbositas. Model yang menghasilkan 97M token dalam rangkaian evaluasi standar akan berbiaya jauh lebih tinggi dalam praktik daripada yang diimplikasikan tarif per tokennya, terutama untuk sesi agen jangka panjang yang memang menjadi kasus penggunaan utamanya.
Tim yang membangun di atas Qwen3.7-Max sebaiknya menyusun anggaran dengan cermat dan menguji dengan batas keluaran yang eksplisit sebelum berkomitmen pada beban kerja produksi.
Jika Anda ingin membangun di atas model seperti Qwen3.7-Max atau memahami lanskap AI agen lebih dalam, saya merekomendasikan melihat alur keterampilan AI Fundamentals di DataCamp untuk mempercepat pemahaman konsep yang mendasari sistem ini.
Kursus Teratas di DataCamp
Program
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt